기타
개발개발 ·
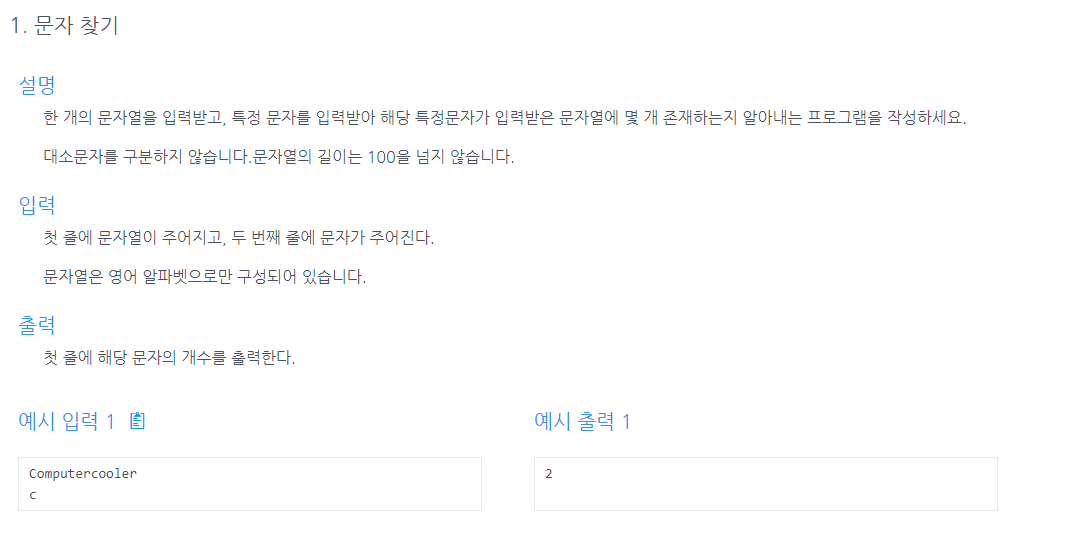
1-1. 문자 찾기
package string.findletter.my;
import java.util.Scanner;
public class Main {
/**
* 문제점
* 1. inputSecond 를 String 이 아니라 char 로 받아서 하는게 더 깔끔함
* 2. divideLetter 메서드를 사용 했는데 이거 굳이 필요한가? 싶은 생각
*
* 해결방안
* 1. inputSecond 를 char 로 받아서 한글자만 비교하면 된다.
* 2. charAt 을 적극 이용하면 divideLetter 필요없다.
*/
public static void main(String[] args) {
Scanner input = new Scanner(System.in);
String inputFirst = input.nextLine();
String inputSecond = input.nextLine();
String lowerCaseFirst = inputFirst.toLowerCase();
String lowerCaseSecond = inputSecond.toLowerCase();
String[] character = divideLetter(lowerCaseFirst);
System.out.println(getCount(lowerCaseFirst, lowerCaseSecond, character));
}
private static int getCount(String lowerCaseFirst, String lowerCaseSecond, String[] character) {
int cnt = 0;
for (int i = 0; i < lowerCaseFirst.length(); i++) {
if (character[i].equals(lowerCaseSecond)) {
cnt++;
}
}
return cnt;
}
private static String[] divideLetter(String lowerCaseFirst) {
String character[] = new String[100];
for (int i = 0; i < lowerCaseFirst.length(); i++) {
String substring = lowerCaseFirst.substring(i, i+1);
character[i] = substring;
}
return character;
}
}
너무 간단한 문제지만 너무 복잡하게 풀었다... 개인적인 코드 리뷰와 리팩토링을 진행한 코드는 다음과 같다.
package string.findletter.my;
import java.util.Scanner;
public class Refactoring {
public static void main(String[] args) {
Scanner input = new Scanner(System.in);
String inputFirst = input.next();
char inputSecond = input.next().charAt(0);
String lowerCaseFirst = inputFirst.toLowerCase();
char lowerCaseSecond = Character.toLowerCase(inputSecond);
System.out.println(getCount(lowerCaseFirst, lowerCaseSecond));
}
private static int getCount(String lowerCaseFirst, char lowerCaseSecond) {
int cnt = 0;
for (int i = 0; i < lowerCaseFirst.length(); i++) {
if (lowerCaseFirst.charAt(i) == lowerCaseSecond) {
cnt++;
}
}
return cnt;
}
}
키 포인트는 charAt 사용이었던 것 같다.
아래는 선생님의 풀이
package string.findletter.teacher;
import java.util.Scanner;
public class Main {
public int solution(String str, char t) {
int answer = 0;
str = str.toUpperCase();
t = Character.toUpperCase(t);
/*for (int i = 0; i < str.length(); i++) {
if (str.charAt(i) == t) {
answer++;
}
}*/
for (char x : str.toCharArray()) {
if (x == t) answer++;
}
return answer;
}
public static void main(String[] args) {
Main T = new Main();
Scanner kb = new Scanner(System.in);
String str = kb.next();
char c = kb.next().charAt(0);
System.out.println(T.solution(str, c));
}
}
1-2. 대소문자 변환
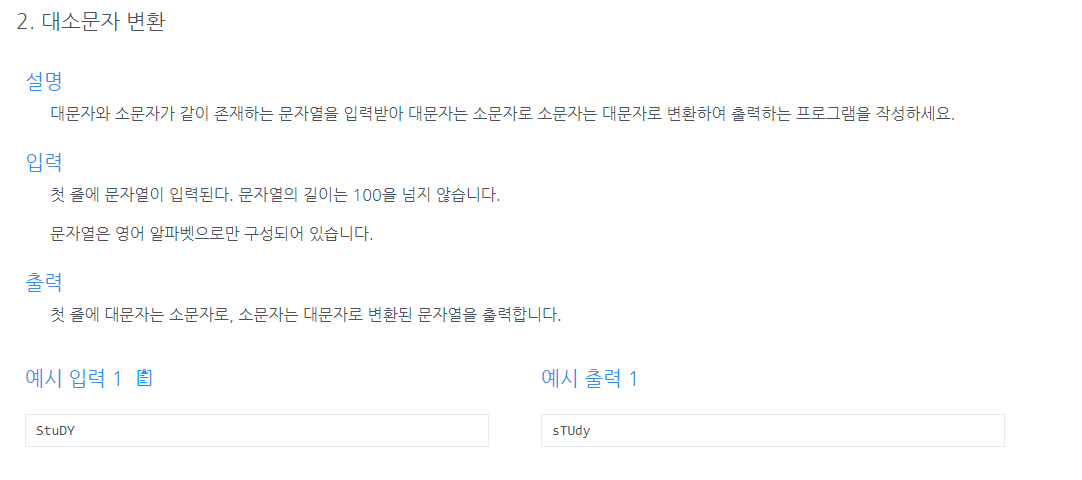
Character 클래스에 isLowerCase, isUpperCase의 존재를 몰랐다... Character 클래스 은근 자주 쓰일듯 하다.
풀지는 못했고 선생님 코드로 바로 확인하겠다.
package string.upperlower12.teacher;
import java.util.Scanner;
public class Main {
private static String solution(String str) {
String answer = "";
for (char x : str.toCharArray()) {
if (Character.isLowerCase(x)) answer += Character.toUpperCase(x);
else answer += Character.toLowerCase(x);
// if (x >= 97 && x <= 122) answer += (char)(x - 32);
// else answer += (char)(x + 32);
}
return answer;
}
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
String str = kb.next();
System.out.println(solution(str));
}
}
1-3. 문장 속 단어찾기
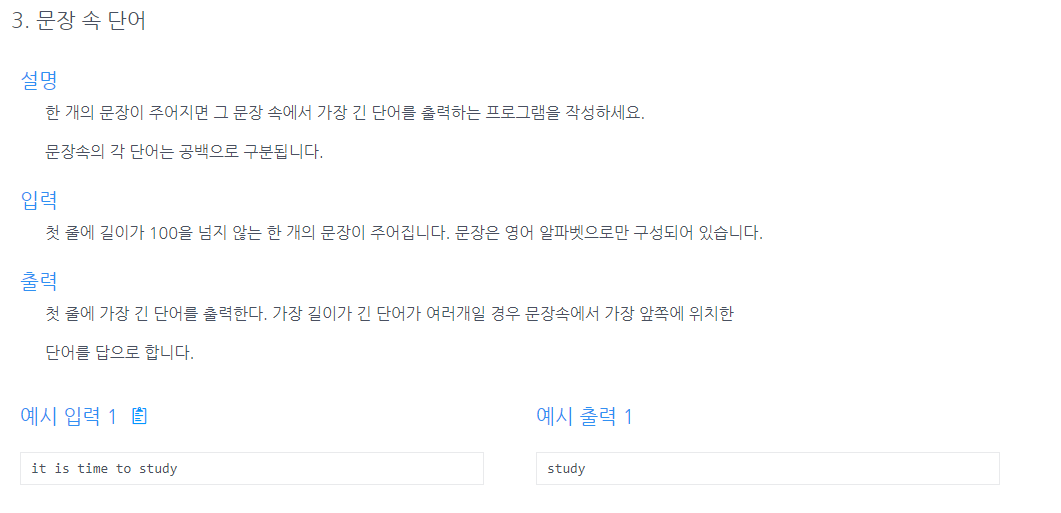
split 메서드를 이용해서 단어단어로 쪼개는 시도 까지는 정답이었으나 최댓값 구하는 알고리즘을 생각해내지 못했음
package string.wordsinsentence13.my;
import java.util.Scanner;
public class Main {
/**
* split 메서드를 이용해서 나누고 list 로 바꾼뒤 진행하려고 했으나 해결하지 못함
*
* 최댓값 구하는 알고리즘을 생각하지 못했음음
* int max = Integer.MIN_VALUE;
* int len = str.length();
*
* if (len > max) {
* len = max;
* }
*/
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
String input = kb.nextLine();
System.out.println(solution(input));
}
private static String solution(String input) {
String answer = "";
int max = Integer.MIN_VALUE;
String[] split = input.split(" ");
for (String s : split) {
int len = s.length();
if (len > max) {
max = len;
answer = s;
}
}
return answer;
}
}
package string.wordsinsentence13.teacher;
import java.util.Scanner;
public class Main {
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
String str = kb.nextLine();
System.out.println(solution(str));
}
private static String solution(String str) {
String answer = "";
int m = Integer.MIN_VALUE, pos;
/*
indexOf 로 공백의 index 값을 가져와 pos 에 저장해두고 substring 으로 자른 후
해당 글자는 없애버리고 그 뒤를 String 으로 가져가는
while ((pos = str.indexOf(" ")) != -1) {
String tmp = str.substring(0, pos);
int len = tmp.length();
if (len > m) {
m = len;
answer = tmp;
}
}
*/
String[] s = str.split(" ");
for (String x : s) {
int len = x.length();
if (len > m) {
m = len;
answer = x;
}
}
return answer;
}
}
1-4. 단어 바꾸기
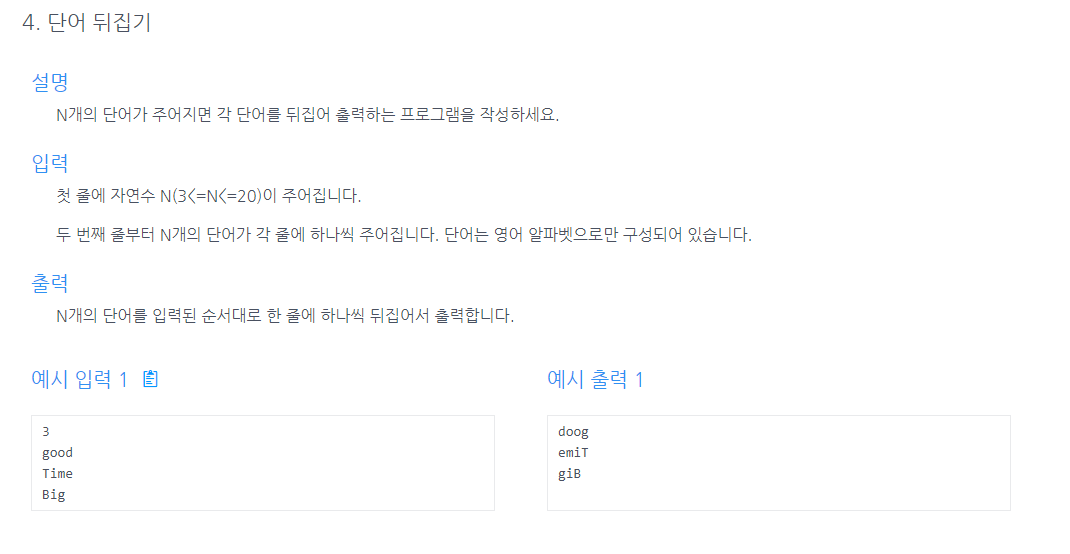
package string.flipword14.my;
import java.util.Scanner;
public class Main {
/**
* 으아아아아아아아 맞췄다아아아아아아아아아아아아아
*/
/**
* case1:
* StringBuilder 클래스의 reverse 를 이용하면 정말 쉽게 풀린다.
* 내가 푼 방법은 정말 원시적인 리버스이고 선생님이 푼 방식이 정말 깔끔한 리버스이다 다시 복습할 것
*
* case2:
* 1. String 문자열을 toCharArray 로 char 배열로 바꾼다.
*
* 2. lt, rt 의 개념 도입
* cf) lt, rt 란?
* 예를 들어 study 라는 문자열을 char 배열로 바꾸면
* 0 1 2 3 4
* s t u d y
* 이렇게 바뀐다.
*
* 여기서
* lt rt lt rt
* 0 1 2 3 4 --> 0 1 2 3 4
* s t u d y --> s t u d y
*
* 이렇게 lt 와 rt 를 lt 는 오른쪽 rt 는 왼쪽으로 한칸씩 움직인다.
*
* 3. A 와 B 의 자리를 바꿀 때 tmp 의 개념을 도입해 바꿔준다.
* ex)
* tmp = A
* A = B
* B = tmp
*
* 4. 마지막으로 lt 는 ++ rt 는 -- 로 값을 변경해준다 (lt 는 오른쪽으로 한칸 rt 는 왼쪽으로 한칸 이동)
*
* 5. 해당 반복문은 while 문으로 조건식은 lt < rt 이다.
*/
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
int line = kb.nextInt();
String array[] = new String[line];
for (int i = 0; i < line; i++) {
String input = kb.next();
array[i] = input;
}
for (int i = 0; i < line; i++) {
String[] solution = solution(line, array[i]);
System.out.println(solution[i]);
}
}
private static String[] solution(int line, String input) {
String answer[] = new String[100];
for (int i = 0; i < line; i++) {
String answerWord = "";
for (int j = 0; j < input.length(); j++) {
char c = input.charAt(input.length() - j - 1);
answerWord += c;
}
answer[i] = answerWord;
}
return answer;
}
}
맞추긴 했지만 정말 구질구질하게 풀어낸 문제라 정말 아쉬움
StringBuiilder 클래스의 reverse를 사용하면 정말 간단하게 풀리는 문제
StringBuilder 클래스는 모든 문자열을 뒤집을 때 사용하면 정말 편하지만 특정 문자를 뒤집고 싶을 때는 주석에 나와있는 대로 lt (left) 와 rt (right) 를 도입하여 수동으로 리버스 해야함
이 다음 문제에서 사용하기 때문에 반드시 알아야 하는 풀이방식
또한 tmp 를 통해 A 와 B 의 값을 뒤바꾸는 알고리즘은 정말 기초적인 부분이니 꼭 숙지하도록 하자
위에서 작성한 주석과 선생님의 풀이를 꼼꼼히 볼 것
package string.flipword14.teacher;
import java.util.ArrayList;
import java.util.Scanner;
public class Main {
private static ArrayList<String> solution(int n, String[] str) {
ArrayList<String> answer = new ArrayList<>();
/**
* StringBuilder 클래스를 이용해서 전체 단어 뒤집기
*/
for (String x : str) {
String tmp = new StringBuilder(x).reverse().toString();
answer.add(tmp);
}
/**
* lt 와 rt 를 도입하여 수동으로 뒤집는 방법
*/
for (String x : str) {
char[] s = x.toCharArray();
int lt = 0, rt = x.length();
while (lt < rt) {
char tmp = s[lt];
s[lt] = s[rt];
s[rt] = tmp;
lt++;
rt--;
}
String tmp = String.valueOf(s);
answer.add(tmp);
}
return answer;
}
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
int n = kb.nextInt();
String[] str = new String[n];
for (int i = 0; i < n; i++) {
str[i] = kb.next();
}
for (String x : solution(n, str)) {
System.out.println(x);
}
}
}
1-5. 특정 문자 뒤집기
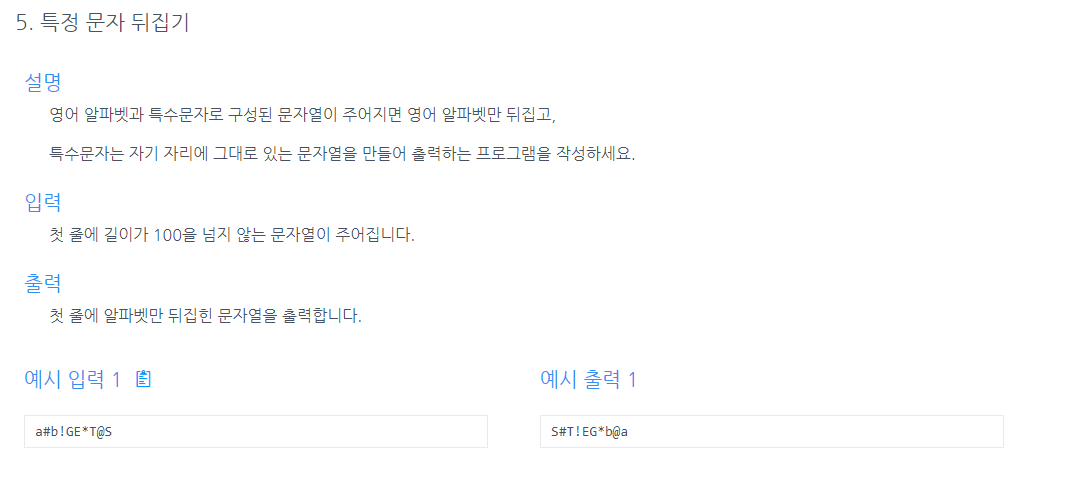
package string.flipspecificcharacter15.my;
import java.util.Scanner;
public class Main {
/**
* 반은 맞추고 반은 못맞춘 문제... 정말 아쉽다...
*
* 키포인트
* 1. '특수문자' 면 lt 는 ++ rt 는 -- 해야한다.
* 2. if / else if / else 문으로 하나로 묶어야 한다.
*
* if (lt = 특수문자) {
* lt++;
* }
* else if (rt = 특수문자) {
* rt--;
* }
* else (둘다 알파벳인 경우) {
* 둘이 바꿔
* }
*
* 1번은 생각했는데 2번을 생각 못했다... 진짜 개바보보
*/
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
String input = kb.next();
System.out.println(solution(input));
}
private static String solution(String input) {
String answer = "";
int lt = 0, rt = input.length() - 1;
char[] c = input.toCharArray();
while (lt < rt) {
if (!(c[lt] >= 65 && c[lt] <= 90) && !(c[lt] >= 97 && c[lt] <= 122)) {
lt++;
}
else if (!(c[rt] >= 65 && c[rt] <= 90) && !(c[rt] >= 97 && c[rt] <= 122)) {
rt--;
}
else {
char tmp = c[lt];
c[lt] = c[rt];
c[rt] = tmp;
lt++;
rt--;
}
}
answer = String.valueOf(c);
return answer;
}
}
전의 문제에서 활용했던 수동 뒤집기인 lt 와 rt 를 도입하여 정답에 근접하게 풀어냈으나 조건식을 합쳐야 한다는 느낌만 잡아내었고 else if 문을 생각하지 못했다... 정말 아쉬운 문제
정답에 정말 코앞까지 근접했으나 풀지 못해서 많이 아쉬움이 남는 문제
1-6. 중복된 문자 제거
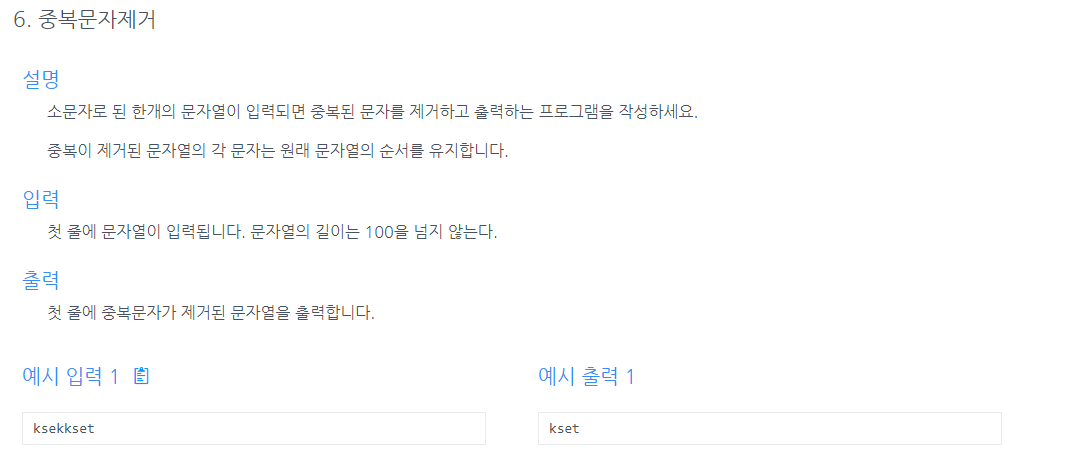
package string.duplicateword16.my;
import java.util.Scanner;
public class Main {
/**
* 맞췄다아아아아아아아아아아아아아아아아
*
* savePoint 의 개념 도입으로 save 배열에 알파벳이 담기는 첫 순간은 지나가고
* 그 후에는 savePoint 의 수가 1이 아니게 되기 때문에 이점을 이용하여 중복 제거
*
* 진짜 자괴감 엄청나다...
* 선생님이 너무 쉽게 풀어버려서 똥꼬쑈 한 내가 너무 바보된 느낌...
*
* String 클래스의 indexOf 를 이용하면 정말정말 쉽게 풀린다...
*
* cf) indexOf 란?
* 쉽게 말해 index 위치를 알려주는 것이다.
*
* ex) String str = Spring 이라는 글자에서
* str.indexOf(S) = 0
* str.indexOf(n) = 4
* str.indexOf(t) = 1
*
* 이런식으로 몇번째에 위치하고 있는지를 알려주는 것
*
* 이걸 문제에 적용시키면 다음과 같다.
*
* 문제 : ksekkset
* for (int i = 0 ; i < str.length() ; i++) {
* System.out.println(str.charAt(i) + ", " + i + ", " + str.indexOf(str.charAt(i)));
* }
*
* 결괏값
* k 0 0
* s 1 1
* e 2 2
* k 3 0
* k 4 0
* s 5 1
* e 6 2
* t 7 7
*
* 즉 i 값과 indexOf 해서 나온 값이 같으면 answer 에 저장 아니면 무시하면 되는 것이었다..
* for (int i = 0 ; i < str.length() ; i++) {
* System.out.println(str.charAt(i) + ", " + i + ", " + str.indexOf(str.charAt(i)));
* if (i == str.indexOf(str.charAt(i))) {
* answer += str.charAt(i);
* }
* }
*
* 진짜 너무 허무하다...
*/
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
String input = kb.next();
System.out.println(solution(input));
}
private static String solution(String input) {
String answer = "";
char[] c = input.toCharArray();
char[] save = new char[100];
int cnt = 0;
for (int i = 0; i < c.length; i++) {
int savePoint = 0;
save[cnt] = c[i]; // ksekkset -> kset
// save[0] = k / savePoint = 1
// save[1] = s / savePoint = 1
// save[2] = e / savePoint = 1
// save[3] = k / savePoint = 2
// save[4] = k / savePoint = 3
// save[5] = s / savePoint = 2
for (int j = 0; j < save.length; j++) {
if (save[j] == c[i]) {
savePoint++;
if (savePoint != 1) {
c[i] = '\0';
}
}
}
cnt++;
}
for (int i = 0; i < c.length; i++) {
if (c[i] != '\0') {
answer += c[i];
}
}
return answer;
}
}
나름 참신한 발상으로 문제를 풀고 정답을 맞췄지만 선생님의 풀이에 힘이 쭉 빠지는 문제였다...
나는 30분 40분 고민해가면서 죽자고 풀어내면 선생님은 특정 클래스의 특정 메서드를 사용하여 너무 간단하게 풀어버린다.
자세한 내용은 주석 참고
package string.duplicateword16.teacher;
import java.util.Scanner;
public class Main {
private static String solution(String str) {
String answer = "";
for (int i = 0; i < str.length(); i++) {
//System.out.println(str.charAt(i) + " " + i + " " + str.indexOf(str.charAt(i)));
if (i == str.indexOf(str.charAt(i))) {
answer += str.charAt(i);
}
}
return answer;
}
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
String str = kb.next();
System.out.println(solution(str));
}
}
1-7. 회문 문자열
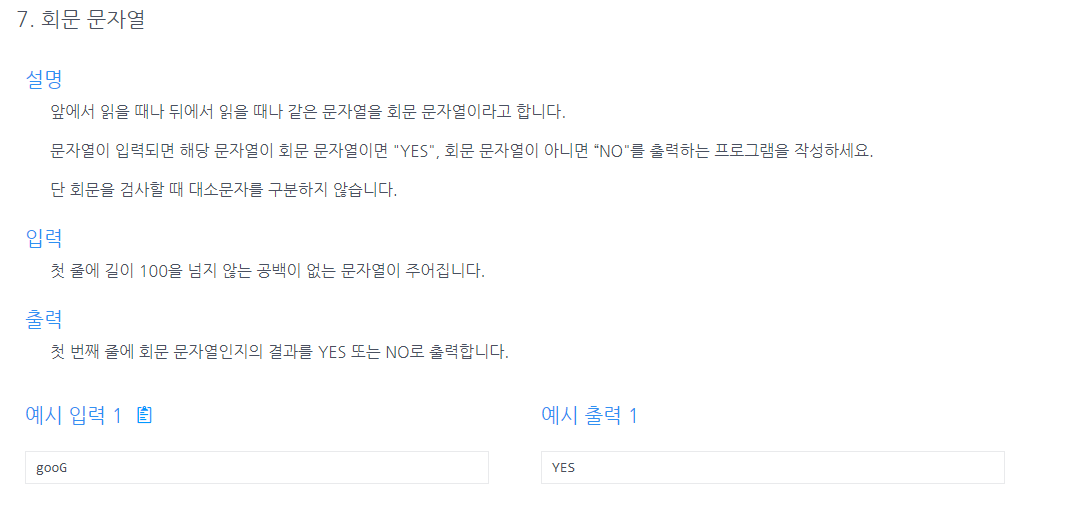
package string.CircleString17.my;
import java.util.Scanner;
public class Main {
/**
* -나의 풀이-
* 이전 시간에 배웠던 lt 와 rt 의 개념을 도입해서 각각의 문자가 다르면 checkPoint 를 1 증가시켜서
* 최종적으로 0이면 (증가하지 않으면 -> 각각의 문자가 같으면) YES 를 리턴, 0이 아니면 NO 를 리턴
*
* --피드백--
* 음... 문제는 맞았다. 하지만 알고리즘, 자료구조를 사용했다는 느낌은 전혀 받을 수 없었음
* 그냥 꼼수같은 느낌..? 이거 실제로 코딩테스트에서 제출하면 답은 맞지만 높은 점수는 주지 않을듯 함
*
* -선생님의 풀이-
* 1. 전체 길이 / 2 한만큼까지 for 문을 돌려서 앞 뒤를 charAt 으로 비교 했음
* 2. 앞선 시간에서 배웠던 StringBuilder 에 reverse 메서드로 tmp 라는 새로운 변수에 저장한 후
* 기존 문자열과 tmp 를 equalsIgnoreCase (대소문자와 관계없이 equals 비교) 를 이용하여 비교 후 YES 혹은 NO 리턴
*
* --코드리뷰--
* 1번 풀이는 내 풀이와 크게 다르지 않은 듯 함 2번 풀이가 개인적으로 맘에 듦
*/
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
String input = kb.next();
System.out.println(solution(input));
}
private static String solution(String input) {
int lt = 0, rt = input.length() - 1;
char[] c = input.toCharArray();
int checkPoint = 0;
while (lt < rt) {
char left = Character.toLowerCase(c[lt]);
char right = Character.toLowerCase(c[rt]);
if (left != right) {
checkPoint++;
}
lt++;
rt--;
}
if (checkPoint == 0) {
return "YES";
}
else {
return "NO";
}
}
}
↑ 내풀이
package string.CircleString17.teacher;
import java.util.Scanner;
public class Main {
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
String str = kb.next();
System.out.println(solution(str));
}
private static String solution(String str) {
String answer = "NO";
String tmp = new StringBuilder(str).reverse().toString();
if (str.equalsIgnoreCase(tmp)) return answer = "YES";
/*
String answer = "YES";
int len = str.length();
str = str.toUpperCase();
for (int i = 0; i < len / 2; i++) {
if (str.charAt(i) != str.charAt(len - i - 1)) {
return "NO";
}
}
*/
return answer;
}
}
↑ 선생님 풀이
package string.CircleString17.my;
import java.util.Scanner;
public class Refactoring {
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
String input = kb.next();
System.out.println(solution(input));
}
private static String solution(String input) {
int lt = 0, rt = input.length() - 1;
input = input.toLowerCase();
char[] c = input.toCharArray();
// int checkPoint = 0; 기존의 checkPoint 삭제
while (lt < rt) {
// char left = Character.toLowerCase(c[lt]); 각각을 소문자로 변경하는 것이 아니라 일단 input 을 소문자로
// char right = Character.toLowerCase(c[rt]); 변경함
if (c[lt] != c[rt]) { // left != right 에서 현재 코드로 변경경
return "NO";
}
lt++;
rt--;
}
return "YES";
}
}
↑ 리팩토링
1-8. 유효한 회문 문자열
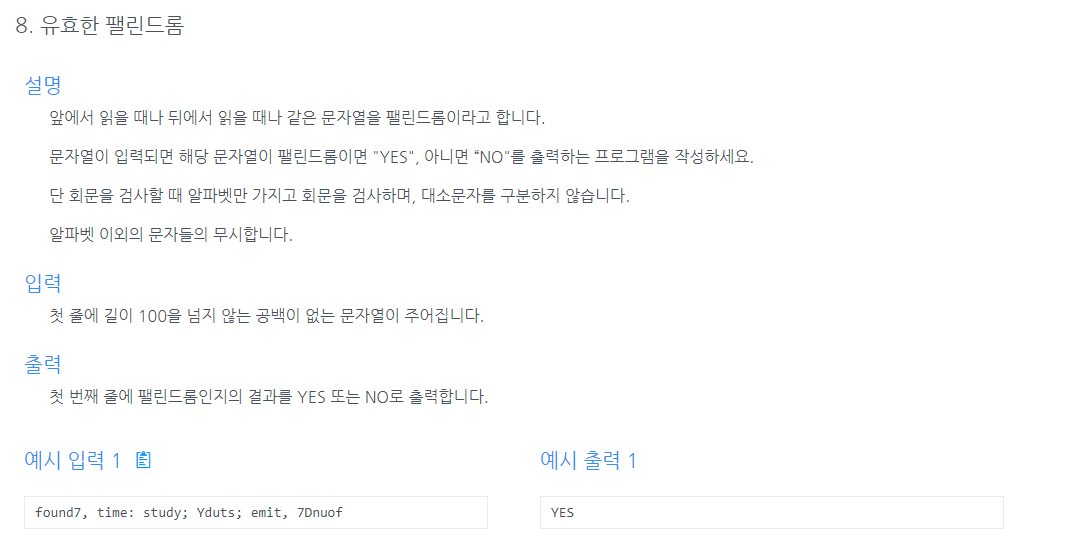
package string.CircleString18.my;
import java.util.Scanner;
public class Main {
/**
* -내 풀이-
* 이번 문제 또한 lt 와 rt 를 도입해 공백, 특수문자를 if, else if 문으로 일일이 검사했다
*
* --피드백--
* 1-7번 문제와 동일한 피드백, 알고리즘 / 자료구조를 사용했다는 느낌이 안든다.
*
* -선생님의 풀이-
* 정규표현식 + replaceAll 로 아주 간단하게 풀어냈다. 간단한 정규표현식 정도는 알아두면 좋을 것 같다.
*
* "[^A-Z]"
* ^ : ~가 아닌
* A-Z : A 부터 Z 까지
* = A 부터 Z 가 아닌
*/
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
String input = kb.nextLine();
System.out.println(solution(input));
}
private static String solution(String input) {
input = input.toUpperCase();
int lt = 0, rt = input.length() - 1;
char[] c = input.toCharArray();
while (lt < rt) {
if (c[lt] == ' ') {
lt++;
}
else if (c[rt] == ' ') {
rt--;
}
else if (!(c[lt] >= 65 && c[lt] <= 90)) {
lt++;
}
else if (!(c[rt] >= 65 && c[rt] <= 90)) {
rt--;
}
else {
if (c[lt] != c[rt]) {
return "NO";
}
lt++;
rt--;
}
}
return "YES";
}
}
package string.CircleString18.teacher;
import java.util.Scanner;
public class Main {
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
String str = kb.nextLine();
System.out.println(solution(str));
}
private static String solution(String str) {
String answer = "NO";
str = str.toUpperCase().replaceAll("[^A-Z]", "");
String tmp = new StringBuilder(str).reverse().toString();
if (str.equals(tmp)) {
return "YES";
}
return answer;
}
}
1-9. 숫자만 추출
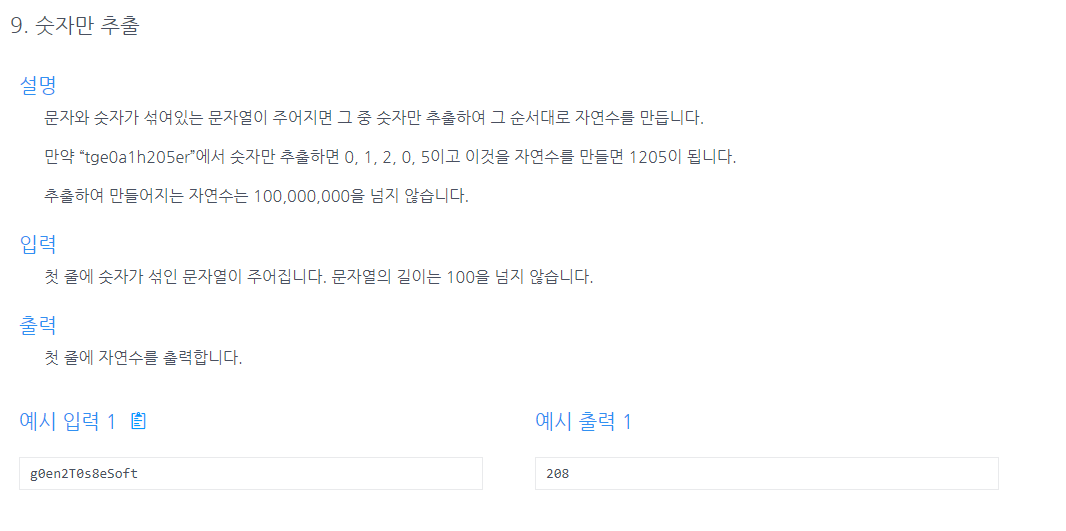
package string.ExtractionNumber19.my;
import java.util.Scanner;
public class Main {
/**
* -내 풀이-
* replaceAll 메서드를 이용해 정규표현식으로 숫자가 아닌 것들을 빈칸으로 바꿔 숫자만 뽑았다.
*
* --피드백--
* IDEA 의 도움을 받아버렸다... 실전에서였으면 해결하기 쉽지 않았을 문제
*
* --선생님의 풀이--
* 1. answer = 0 으로 초기화 후 String -> toCharArray 로 바꾸고 각각의 문자를 아스키코드로 48 ~ 57 로 설정하여
* for (char x : str.toCharArray()) {
* if (x >= 48 && x <= 57) {
* answer = answer * 10 + (x - 48); (여기서 x 는 각각의 숫자)
* }
* }
* return answer;
* 이렇게 숫자로 계산
*
* 2. Character 클래스의 isDigit() 메서드를 이용해 숫자인지 아닌지 확인하고 숫자만 하나씩 누적하는 방식
* String answer = "";
* for (char x : str.toCharArray()) {
* if (Character.isDigit(x)) { // isDigit() 메서드는 해당 문자가 숫자인지 아닌지 확인하는 메서드
* answer += x;
* }
* }
* return Integer.parseInt(answer);
*/
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
String input = kb.next();
System.out.println(solution(input));
}
private static int solution(String input) {
if (input.length() > 100) {
throw new StringOrNumberFormatException("100자를 넘길 수 없습니다.");
}
input = input.replaceAll("\\D", "");
if (input.equals("")) {
throw new StringOrNumberFormatException("반드시 숫자가 하나 이상 있어야 합니다.");
}
if (Long.parseLong(input) > 100000000) {
throw new StringOrNumberFormatException("숫자로 변환된 값은 1억을 넘을 수 없습니다.");
}
return Integer.parseInt(input);
}
static class StringOrNumberFormatException extends RuntimeException {
public StringOrNumberFormatException() {
super();
}
public StringOrNumberFormatException(String message) {
super(message);
}
public StringOrNumberFormatException(String message, Throwable cause) {
super(message, cause);
}
public StringOrNumberFormatException(Throwable cause) {
super(cause);
}
protected StringOrNumberFormatException(String message, Throwable cause, boolean enableSuppression, boolean writableStackTrace) {
super(message, cause, enableSuppression, writableStackTrace);
}
}
}
package string.ExtractionNumber19.teacher;
import java.util.Scanner;
public class Main {
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
String str = kb.next();
System.out.println(solution(str));
}
private static int solution(String str) {
String answer = "";
for (char x : str.toCharArray()) {
if (Character.isDigit(x)) {
answer += x;
}
}
return Integer.parseInt(answer);
/*
int answer = 0;
for (char x : str.toCharArray()) {
if (x >= 48 && x<= 57) answer = answer * 10 + (x - 48);
}
return answer;
*/
}
}
1-10. 가장 짧은 문자 거리
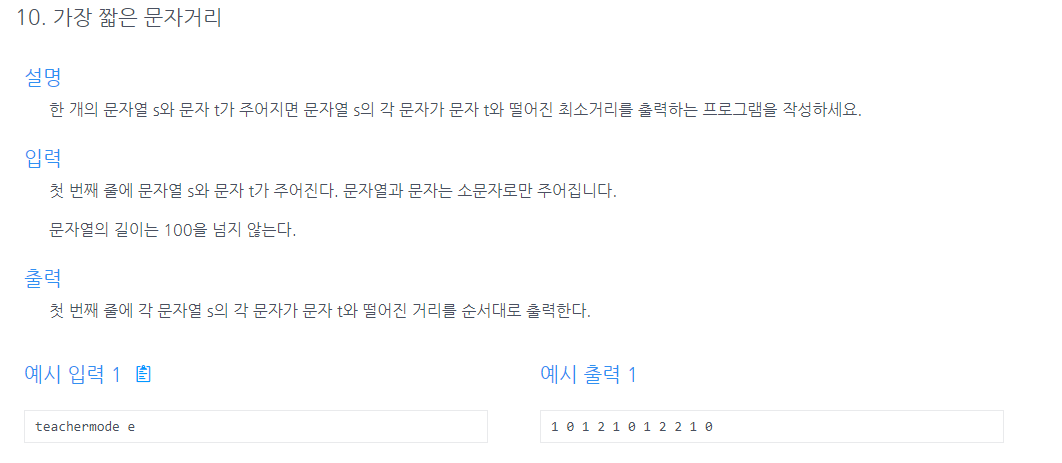
package string.MinimumCharacterDistance110.my;
import java.util.Scanner;
public class Main {
/**
* -내풀이-
* 이건 진짜 아닌거 같아서 그냥 포기합니다. 시간만 오지게 잡아먹었네요...
*
* -선생님 풀이-
* 1. int 배열을 해당 문자 크기만큼 만들고
* 2. 배열 최대 크기보다 훨씬 큰 p 를 설정한 후에
* 3. 왼쪽에서 오른쪽으로 for 문을 돌면서 왼쪽 타겟까지의 거리를 잰다.
* t e a c h e r m o d e -> e (만약 맨 첫글자가 타겟이 아니면 p 타겟이면 0 으로 설정한다.)
* x 0 1 2 3 0 1 2 3 4 0 (x = p)
* 4. 다음엔 오른쪽에서 왼쪽으로 for 문을 돌리면서 오른쪽 타겟까지의 거리를 잰다. 이때 해당 값은 최소 값을 선택한다.
* t e a c h e r m o d e -> e
* 1 0 1 2 1 0 1 2 2 1 0
*
* int p = 1000;
* int[] answer = new int[str.length()];
* for (int i = 0 ; i < s.length() ; i++) {
* if (str.charAt(i) == t) {
* p = 0;
* answer[i] = p;
* }
* else {
* p++;
* answer[i] = p;
* }
* }
* p = 1000 // p 를 다시 초기화 해줘야한다. (중요!)
* for (int i = s.length() - 1 ; i >= 0 ; i--) {
* if (str.charAt(i) == t) {
* p = 0;
* }
* else {
* answer[i] = Math.min(answer[i], p); // Math 클래스의 min, max 알아두자자 * }
* }
*/
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
String s = kb.next();
String t = kb.next();
System.out.println(solution(s, t));
}
private static String solution(String s, String t) {
s = s.toLowerCase();
t = t.toLowerCase();
String tmp = t + s + t;
String stack = "";
String[] split = tmp.split(t); // ex) study t -> tstudyt -> "", "s", "udy", ""
for (int i = 0 ; i < split.length ; i++) {
if (i == 0) {
int check = split[i].length();
for (int j = 0; j < split[i].length(); j++) {
stack += check;
stack += " ";
check--;
}
stack += "0 ";
}
else if (i == split.length - 1) {
int check = 0;
for (int j = 0; j < split[i].length(); j++) {
check++;
stack += check;
stack += " ";
}
}
else if (split[i].length() % 2 == 0) {
int check = 0;
for (int j = 0; j < split[i].length() / 2; j++) {
check++;
stack += check;
stack += " ";
}
stack += check;
stack += " ";
for (int j = 0; j < split[i].length() / 2; j++) {
check--;
stack += check;
stack += " ";
}
}
else {
int check = 0;
for (int j = 0; j < split[i].length() / 2; j++) {
check++;
stack += check;
stack += " ";
}
check++;
stack += check;
stack += " ";
for (int j = 0; j < split[i].length() / 2; j++) {
check--;
stack += check;
stack += " ";
}
stack += "0 ";
}
}
return stack;
}
}
package string.MinimumCharacterDistance110.teacher;
import java.util.Scanner;
public class Main {
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
String str = kb.next();
char c = kb.next().charAt(0);
for (int x : solution(str, c)) {
System.out.print(x + " ");
}
}
private static int[] solution(String s, char t) {
int[] answer = new int[s.length()];
int p = 1000;
for (int i = 0; i < s.length(); i++) {
if (s.charAt(i) == t) {
p = 0;
answer[i] = p;
}
else {
p++;
answer[i] = p;
}
}
p = 1000;
for (int i = s.length() - 1; i >= 0; i--) {
if (s.charAt(i) == t) p = 0;
else {
p++;
answer[i] = Math.min(answer[i], p);
}
}
return answer;
}
}
1-11. 문자열 압축
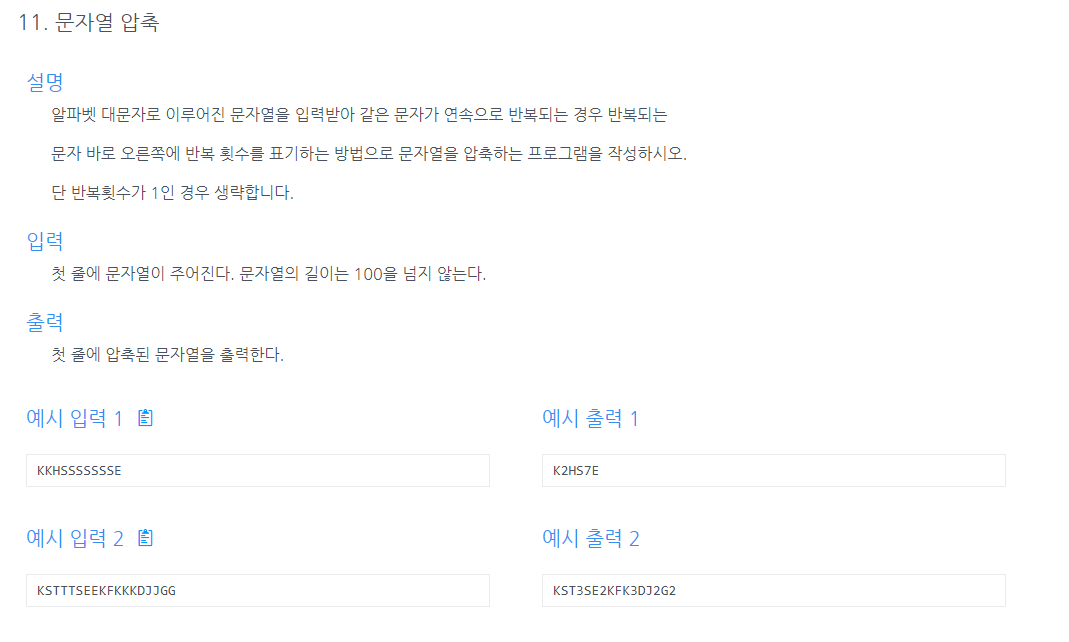
package string.CompressionString111.my;
import java.util.Scanner;
public class Main {
/**
* -내 풀이-
* i + 1 까지 넣으면 index 가 초과되어 로직을 추가했는데 괜한 뻘짓이었다.
*
* --피드백--
* 그냥 들어오는 input 에 빈칸 하나 추가하면 되는 것이었다.. 너무 허무..
*/
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
String input = kb.next();
System.out.println(solution(input));
}
private static String solution(String input) {
String answer = "";
int check = 1;
for (int i = 0; i < input.length(); i++) { // input.length() = 11 / i + 1 의 최댓값 = 11
if (i + 1 != input.length()) {
if (input.charAt(i) == input.charAt(i + 1)) {
check++;
}
else {
if (check != 1) {
answer += input.charAt(i) + String.valueOf(check);
}
else {
answer += input.charAt(i);
}
check = 1;
}
}
else {
if (check != 1) {
answer += input.charAt(i) + String.valueOf(check);
}
else {
answer += input.charAt(i);
}
}
}
return answer;
}
}
package string.CompressionString111.teacher;
import java.util.Scanner;
public class Main {
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
String str = kb.next();
System.out.println(solution(str));
}
private static String solution(String str) {
String answer = "";
str = str + " ";
int cnt = 1;
for (int i = 0; i < str.length() - 1; i++) {
if (str.charAt(i) == str.charAt(i + 1)) {
cnt++;
}
else {
answer += str.charAt(i);
if (cnt > 1) {
answer += String.valueOf(cnt);
}
cnt = 1;
}
}
return answer;
}
}
1-12. 2진 암호
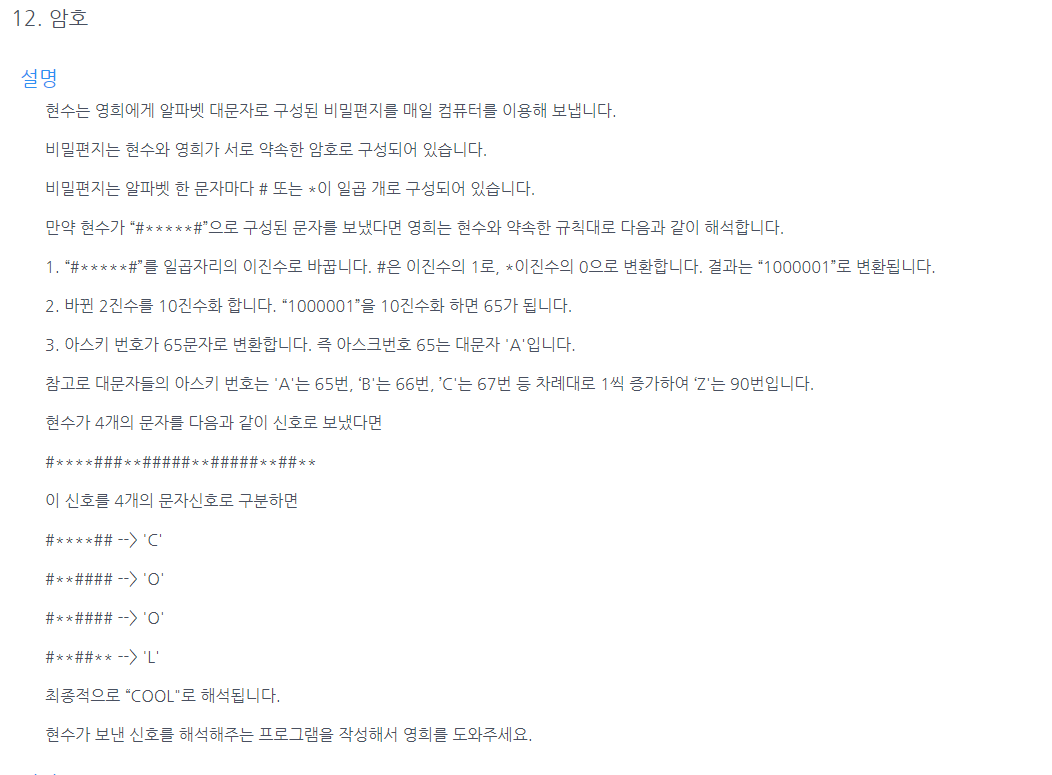
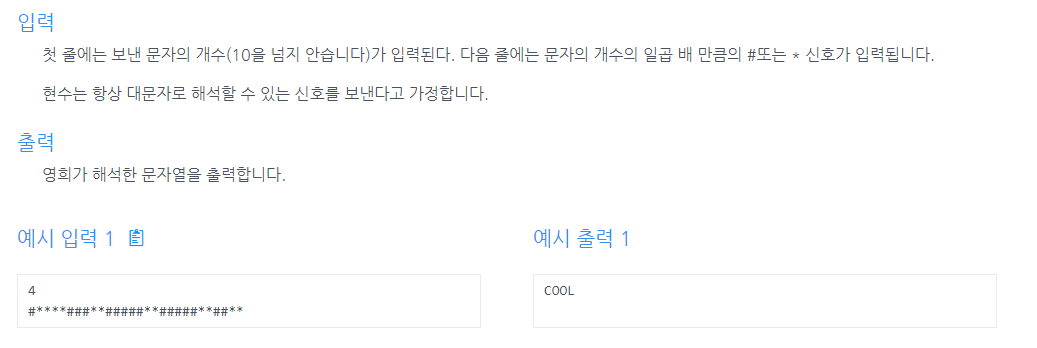
package string.SecureNumber112.my;
import java.util.Scanner;
public class Main {
/**
* -내 풀이-
* 입력 받은 문자열을 replace 를 이용해 1 과 0 으로 이루어진 문자열로 바꾸는데 성공 했다
* 그리고 7개 단위로 끊어서 나열하는 것까지도 성공했다.
* 하지만 10진수를 2진수로 바꾸는 것을 몰라서 그리고 2진수를 아스키코드로 다시 바꾸는 것도 몰라서
* 결국 구글링으로 해결했음
*
* -선생님 풀이-
* 1. 문자열을 0부터 7까지 substring 을 이용해 자른다
* 2. replace 메서드를 이용해 # 은 1 로 * 은 0 으로 바꾼다.
* 3. Integer 클래스에 parseInt 로 2진수 -> 10진수로 바꾼다. Integer.parseInt(tmp, 2); // 중요! 2진수 -> 10진수
* 4. char 로 캐스팅해서 문자로 만든다. // 중요! 아스키코드 -> 문자
* 5. 문자를 answer 에 붙인다.
* 6. 자른만큼 버린다 substring(7)
*/
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
int n = kb.nextInt();
String input = kb.next();
System.out.println(solution(input, n));
}
private static String solution(String input, int n) {
String answer = "";
String tmp = "";
for (int i = 0; i < input.length() ; i++) {
if (i % 7 == 0) {
for (int j = i; j < i + 7 ; j++) {
tmp += input.charAt(j);
}
String binaryString = tmp.replace('#', '1').replace('*', '0');
int binary = Integer.valueOf(binaryString, 2);
char binaryCharacter = (char) binary;
answer += binaryCharacter;
tmp = "";
}
}
return answer;
}
}
package string.SecureNumber112.teacher;
import java.util.Scanner;
public class Main {
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
int n = kb.nextInt();
String str = kb.next();
System.out.println(solution(n, str));
}
private static String solution(int n, String s) {
String answer = "";
for (int i = 0; i < n; i++) {
String tmp = s.substring(0, 7).replace('#', '1').replace('*', '0');
int num = Integer.parseInt(tmp, 2);
answer += (char) num;
s = s.substring(7);
}
return answer;
}
}
1장 문자열 주요 개념 복습 노트
1-1. 문자 찾기
문자열에서 해당 문자가 몇개나 들어있나 세어보는 문제
String str = input.charAt(0); // 문자열에서 한글자 한글자 떼어낼 때 사용
1-2. 대소문자 변환
소문자 -> 대문자, 대문자 -> 소문자로 변환하는 문제
Character 클래스의 toUpperCase, toLowerCase
1-3. 문장 속 단어
문장 속 가장 긴 단어를 찾아내는 문제
String answer = "";
int tmp = Integer.MIN_VALUE;
String[] str = input.split(" ");
for (String x : str) {
if (tmp > str.length()) {
tmp = str.length();
answer = x;
}
}
1-4. 단어 뒤집기
good -> doog, Cool -> looC 이런식으로 단어를 뒤집는 문제
1. StringBuilder 클래스의 reverse 메서드를 이용하면 아주 간단하게 풀림
String str = new StringBuilder(input).reverse();
2. 일일이 수작업으로 뒤집는 알고리즘 lt, rt 의 개념 도입, A -> B, B -> A 로 바꾸는 알고리즘
int lt = 0, rt = input.length() - 1;
3. String -> char 배열로 바꾸는 toCharArray() 메서드
char[] c = input.toCharArray();
char tmp = '';
while (lt < rt) {
tmp = c[lt];
c[lt] = c[rt];
c[rt] = tmp;
lt++;
rt--;
}
1-5. 특정 문자 뒤집기
알파벳과 특수문자가 섞여있는 문자열에서 특수문자는 무시하고 알파벳만 뒤집는 문제
1. lt, rt 개념 도입
2. 특수문자면 lt 와 rt 를 증가시키고 특수문자가 아니면 (알파벳이면 둘이 바꾸면 됨)
3. 특수문자인지 아닌지는 아스키코드로 확인
4. A-Z = 아스키코드 65~90 a-z = 아스키코드 97~122
if (c[lt] == 특수문자) {
lt++;
}
else if (c[rt] == 특수문자) {
rt--;
}
else {
A -> B, B -> A 바꾸는 알고리즘 쓰면 됨
}
1-6. 중복문자 제거
ex) ksekkset -> kset 이렇게 중복되는 문자를 제거하는 문제
1. String 클래스의 indexOf 를 이용하면 아주 쉽게 풀림
cf) indexOf 란? char 타입 문자를 넣으면 문자열에서 어느 index에 위치하고 있는지 알려줌
ex)
String str = "Spring";
str.indexOf(S) = 0
str.indexOf(i) = 3
결과적으로 for 문을 돌려서 i 값과 indexOf로 반환되는 값이 같은 경우 무시하면 됨
ex) ksekkset
for (int i = 0 ; i < str.length() ; i++) {
System.out.println(str.charAt(i) + " " + i + " " + str.indexOf(str.charAt(i)));
}
결괏값
k 0 0
s 1 1
e 2 2
k 3 0
k 4 0
s 5 1
e 6 2
t 7 7
if (i == str.indexOf(str.charAt(i))) {
answer += str.charAt(i);
}
1-7. 회문 문자열
ex) gooG -> YES COOL -> NO 를 반환하게 하는 문제
StringBuilder 클래스의 revrse() 메서드를 사용한 후 equalsIgnoreCase 로 비교하면
대소문자와 관계없이 비교할 수 있다.
1-8. 유효한 회문 문자열
ex) time; found7, 7dnuof: emit -> YES 이렇게 특수문자, 공백은 무시하고 알파벳만 회문 문자열이 성립하는지 체크하는 문제
1. replaceAll + 정규표현식으로 간단하게 풀 수 있다.
2. "[^A-Z]" = A 부터 Z 까지가 아닌 (특수문자나 공백인)
^ : ~가 아닌
A-Z : A 부터 Z 까지
1-9. 문자열에서 숫자 추출하기
ex) as0sd2qwer0ah8 -> 208 이렇게 문자열에서 숫자를 추출하는 문제
1. 0~9 까지의 아스키코드를 비교하며 간단한 방정식을 만드는 방법
0~9 까지의 아스키코드는 48~57
for (char x : str.toCharArray()) {
if (x >= 48 && x <= 57) {
answer = answer * 10 + (x - 48); // 여기서 x는 각각의 숫자
}
}
2. Character 클래스의 isDigit() 메서드를 이용해 숫자인지 확인 할 수 있음
for (char x : str.toCharArray()) {
if (Character.isDigit(x)) {
answer += x;
}
}
1-10. 가장 짧은 문자 거리
ex study t -> 1 0 1 2 3 이렇게 문자열 s 를 입력받고 문자 t 를 입력받아 해당 문자까지 최단거리를 알아내야하는 문제
1. int 배열을 해당 문자 크기만큼 만들고
2. 배열 최대 크기보다 훨씬 큰 p 를 설정한 후에
3. 왼쪽에서 오른쪽으로 for 문을 돌면서 왼쪽 타겟까지의 거리를 잰다
t e a c h e r m o d e -> e
x 0 1 2 3 0 1 2 3 4 0 (x 는 매우 큰 수)
4. 다음엔 오른쪽에서 왼쪽으로 for 문을 돌리면서 오른쪽 타겟까지의 거리를 잰다
이때 해당 값은 최소 값을 선택한다.
int p = 1000;
int[] answer = new int[str.length()];
for (int i = 0 ; i < answer.length() ; i++) {
if (answer[i] == t) {
p = 0;
answer[i] = p;
}
else {
p++;
answer[i] = p;
}
}
p = 1000;
for (int i = answer.length() - 1 ; i >= 0 ; i--) {
if (answer[i] == t) {
p = 0;
}
else {
p++;
answer[i] = Math.min(answer[i], p);
}
}
1-11. 문자열 압축
ex) KKHSSSSSSSE -> K2HS7E 이렇게 문자열을 압축하는 문제
1. 입력받는 문자에 빈칸을 하나 추가한다.
2. charAt 을 이용해 i 번째 값과 i + 1 번째 값이 같으면 cnt를 1 올린다.
3. i 번째 값과 i + 1 번째 값이 다르면 answer 에 해당 문자와 cnt 를 기록한다. 이때 cnt 가 1일
경우에는 숫자가 보이지 않도록 if(cnt > 1) 로직을 추가해준다.
4. cnt 를 1로 초기화한다.
1-12. 2진 암호
ex) #은 1로 *은 0으로 바꾼뒤 2진수를 다시 10진수로 바꾸고 그걸 다시 문자로 바꿔서 암호를 할 것이다.
#**#**# = 1001001
1. 7개 단위로 substring 을 이용해 자른다. substring(0, 7)
2. replace 메서드를 이용해 # 은 1 로 * 은 0 으로 바꾼다.
3. Integer 클래스의 parseInt 로 2진수를 10진수로 바꾼다. Integer 클래스의 valueOf 도 가능
Integer.parseInt(tmp, 2);
Integer.valueOf(tmp, 2);
4. 10진수로 바뀐 숫자를 char 형으로 캐스팅하면 문자로 바뀐다.
5. 이어 붙이면 끝
cf) 10진수를 2진수로 바꾸고 싶은 경우 String 클래스의 toBinaryString 를 사용하면 된다
참고로 10진수 -> 8진수는 toOctalString, 10진수 -> 16진수는 toHexString
2-2. 보이는 학생
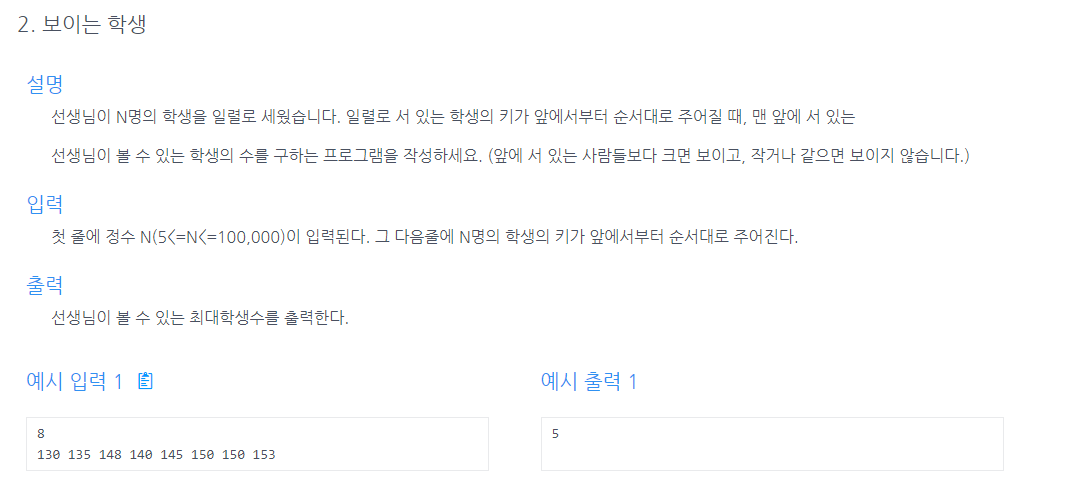
package 배열1차원2차원.보이는학생2다시2.my;
import java.util.Scanner;
public class Main {
/**
* 처음으로 완벽하게 푼 문제입니다. 정말 잘했어요 나 자신
*/
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
int num = kb.nextInt();
int[] arr = new int[num];
for (int i = 0; i < num; i++) {
int input = kb.nextInt();
arr[i] = input;
}
System.out.println(solution(num, arr));
}
private static int solution(int num, int[] arr) {
int cnt = 1, now = arr[0];
for (int i = 0; i < num; i++) {
if (arr[i] > now) {
// 130 > 130 pass
// 135 > 130 pass
// 148 > 135 pass
// 140 > 148 not pass
// 145 > 148 not pass
// 150 > 148 pass
cnt++;
now = arr[i];
}
}
return cnt;
}
}
처음으로 선생님 풀이와 완벽하게 일치하게 풀었다.
2-3. 가위바위보
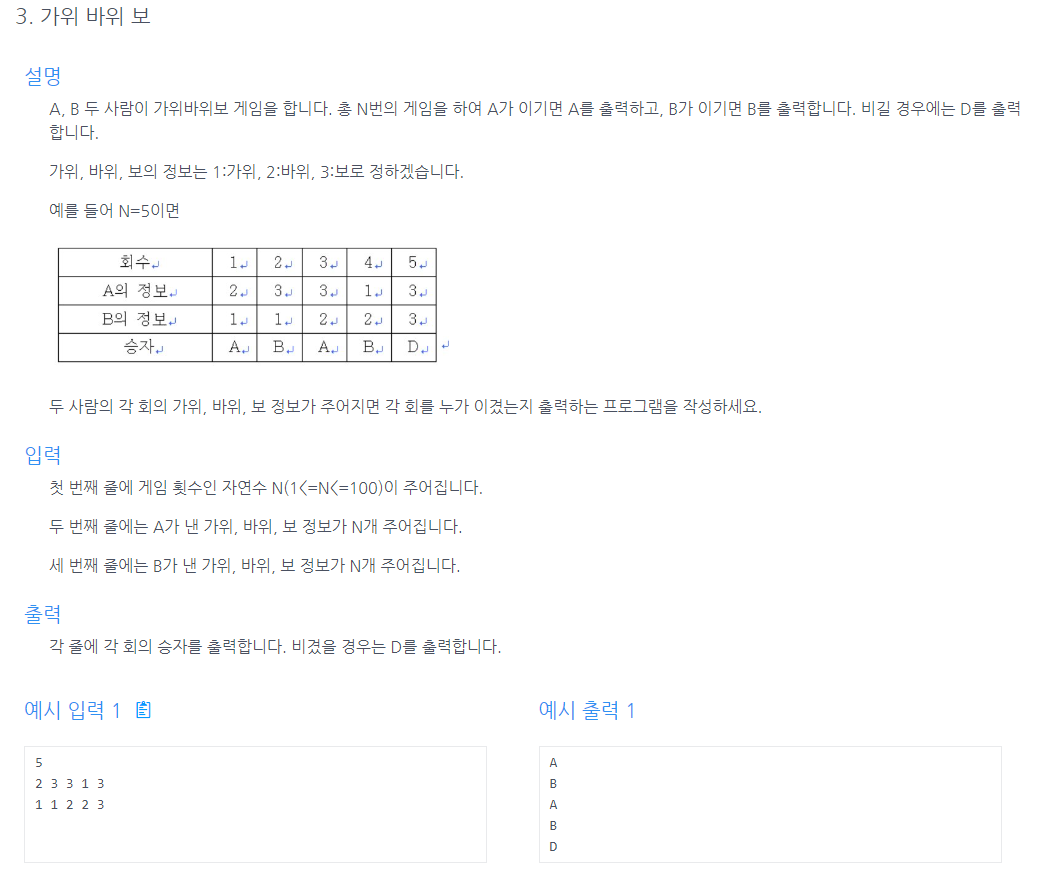
package 배열1차원2차원.가위바위보2다시3.my;
import java.util.Scanner;
public class Main {
/**
* 잘 풀었습니다. 피드백 할 것은 없습니다.
*/
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
int num = kb.nextInt();
int[] A = new int[num], B = new int[num];
for (int i = 0; i < num; i++) {
A[i] = kb.nextInt();
}
for (int i = 0; i < num; i++) {
B[i] = kb.nextInt();
}
for (int i = 0; i < num; i++) {
System.out.println(solution(A[i], B[i]));
}
}
private static String solution(int A, int B) {
String answer = "";
if (A == B) {
answer = "D";
}
else if (A == 1 && B == 3) {
answer = "A";
}
else if (A == 3 && B == 1) {
answer = "B";
}
else if (A < B) {
answer = "B";
}
else if (A > B) {
answer = "A";
}
return answer;
}
}
완벽하게 풀었다.
2-4. 피보나치 수열
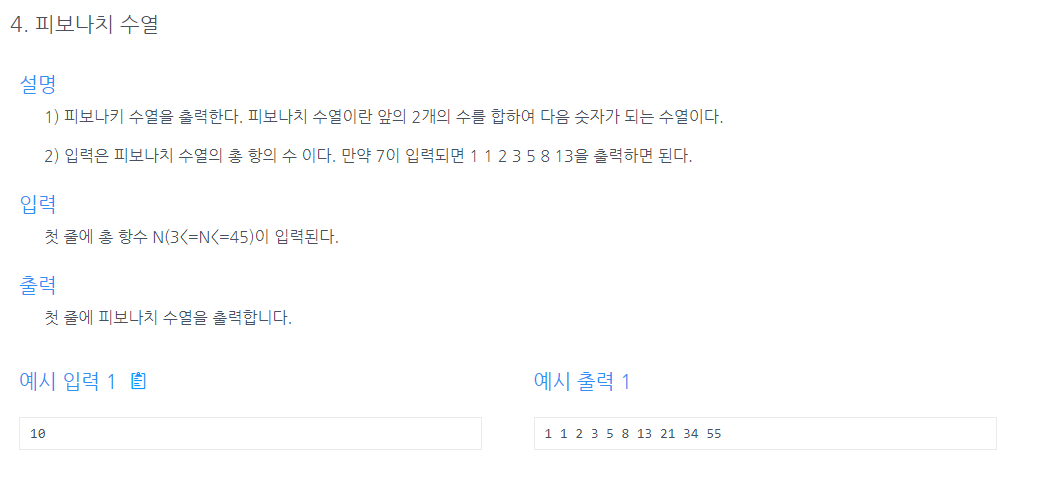
package 배열1차원2차원.피보나치수열2다시4.my;
import java.util.Scanner;
public class Main {
/**
* 피드백 할 것 없습니다.
*/
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
int input = kb.nextInt();
System.out.println(solution(input));
}
private static String solution(int input) {
String answer = "";
int now = 1;
int[] arr = new int[input + 2];
arr[0] = 1;
arr[1] = 1;
for (int i = 0; i < input; i++) {
// 0 -> 1, 1 -> 1, now = 2 -> [2] => 2
// 1 -> 1, 2 -> 2, now = 3 -> [3] => 3
// 2 -> 2, 3 -> 3, now = 5 -> [4] => 5
// 3 -> 3, 4 -> 5, now = 9 -> [5] => 9
// ...
now = arr[i] + arr[i + 1];
arr[i + 2] = now;
answer += arr[i] + " ";
}
return answer;
}
}
잘 풀었다.
2-5. 소수의 개수
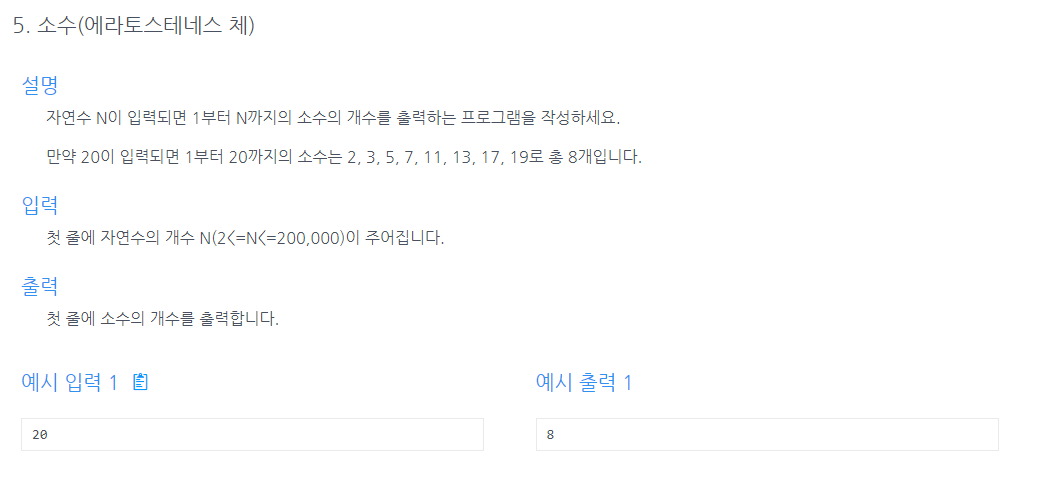
package 배열1차원2차원.소수의개수2다시5.my;
import java.util.Scanner;
public class Main {
/**
* -내 풀이-
* 소수의 성질을 이용해 풀려고 했지만 이중 for 문이 아니면 안풀려서 해결하지 못함
*
* -선생님의 풀이-
* 에라토스테네스의 체를 이용해 풀면 아주 간단하게 풀린다.
*
* cf) 에라토스테네스의 체란?
* 배열을 만들고 해당 인덱스가 0이면 체크하는 방식이고 체크한 후에 그 인덱스와 인덱스의 배수들을 전부 1로 바꿔줌으로써
* 해당 인덱스의 배수에 걸렸을 때는 1이기 때문에 체크하지 않는 방식이다.
*
* ex) 입력값이 10이면
* *초기화
* 2 3 4 5 6 7 8 9 10
* 0 0 0 0 0 0 0 0 0
*
* * i = 2 일때
* 2 3 4 5 6 7 8 9 10
* 1 0 1 0 1 0 1 0 1
* 2와 2의 배수를 1로 바꾸고 1 증가
*
* * i = 3 일때
* 2 3 4 5 6 7 8 9 10
* 1 1 1 0 1 0 1 1 1
* 3과 3의 배수를 1로 바꾸고 1 증가
*
* ... 이런식으로 계속 나아가는 방식
*
* for (int i = 2 ; i <= n ; i++) {
* if (ch[i] == 0) {
* answer++;
* for (int j = i ; j <= n ; j = j + i) {
* ch[j] = 1;
* }
* }
* }
*/
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
int input = kb.nextInt();
System.out.println(solution(input));
}
private static int solution(int input) {
int answer = 0;
int[] arr = new int[input + 1];
for (int i = 2 ; i <= input; i++) {
if (arr[i] == 0) {
if (input % i == 0) {
arr[i] = 1;
}
answer++;
}
}
return answer;
}
}
package 배열1차원2차원.소수의개수2다시5.teacher;
import java.util.Scanner;
public class Main {
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
int n = kb.nextInt();
System.out.println(solution(n));
}
private static int solution(int n) {
int answer = 0;
int[] ch = new int[n + 1];
for (int i = 2; i <= n; i++) {
if (ch[i] == 0) { // 해당 인덱스 값이 0 이면 카운트를 하나 증가
answer++;
for (int j = i ; j <= n ; j = j + i) { // 이부분이 핵심 j 를 j 의 배수만큼 증가시키면서 for 문을 돈다.
ch[j] = 1;
}
}
}
return answer;
}
}
소수를 수학적으로 접근하면 나는 절대 생각할 수 없었던 문제
에라토스테네스의 채를 이용해 푸는 문제 자세한 풀이는 주석 참고
2-6. 뒤집은 소수
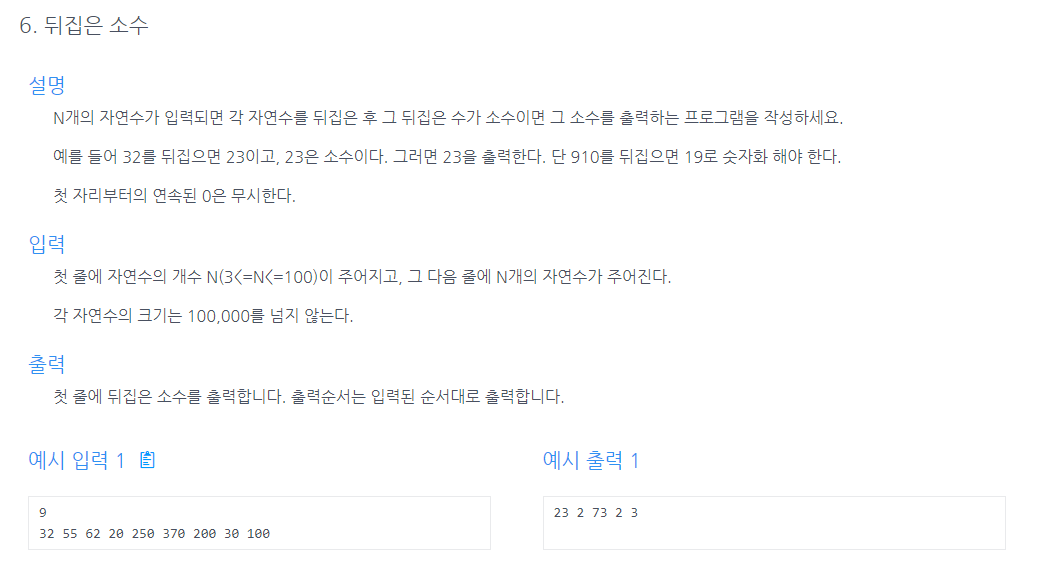
package 배열1차원2차원.뒤집은소수2다시6.my;
import java.util.Scanner;
public class Main {
/**
* -내 풀이-
* 기본적으로 잘 풀었다.
*
* --피드백--
* 코드가 좀 더럽다.
* 소수인지 아닌지 확인하고 boolean 으로 리턴하는 함수를 하나 만들어서 출력하는게 좀 더 깔끔해 보이긴 하다.
*
* -선생님의 풀이-
* 숫자를 뒤집는 것이 개인적으로 맘에 안든다. 내 방식이 좀 더 깔끔해 보인다.
*/
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
int num = kb.nextInt();
int[] arr = new int[num];
for (int i = 0; i < num; i++) {
arr[i] = kb.nextInt();
}
System.out.println(solution(arr));
}
private static String solution(int[] arr) {
String answer = "";
String[] reverse = new String[arr.length];
for (int i = 0; i < arr.length; i++) {
reverse[i] = String.valueOf(arr[i]);
reverse[i] = new StringBuilder(reverse[i]).reverse().toString();
arr[i] = Integer.parseInt(reverse[i]);
}
for (int i = 0; i < arr.length; i++) {
for (int j = 2; j <= arr[i]; j++) {
if (arr[i] % j == 0) {
if (j < arr[i]) {
break;
}
answer += arr[i] + " ";
}
}
}
return answer;
}
}
package 배열1차원2차원.뒤집은소수2다시6.teacher;
import java.util.ArrayList;
import java.util.Scanner;
public class Main {
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
int n = kb.nextInt();
int[] arr = new int[n];
for (int i = 0; i < n; i++) {
arr[i] = kb.nextInt();
}
for (int x : solution(n, arr)) {
System.out.println(x + " ");
}
}
private static ArrayList<Integer> solution(int n, int[] arr) {
ArrayList<Integer> answer = new ArrayList<>();
for (int i = 0; i < n; i++) {
int tmp = arr[i];
int res = 0;
while (tmp > 0) {
int t = tmp % 10;
res = res * 10 + t;
tmp = tmp / 10;
}
if (isPrime(res)) answer.add(res);
}
return answer;
}
private static boolean isPrime(int num) {
if (num == 1) {
return false;
}
for (int i = 2; i < num; i++) {
if (num % i == 0) {
return false;
}
}
return true;
}
}
package 배열1차원2차원.뒤집은소수2다시6.my;
import java.util.Scanner;
public class Refactoring {
/**
* -내 풀이-
* 기본적으로 잘 풀었다.
*
* --피드백--
* 코드가 좀 더럽다.
* 소수인지 아닌지 확인하고 boolean 으로 리턴하는 함수를 하나 만들어서 출력하는게 좀 더 깔끔해 보이긴 하다.
*
* -선생님의 풀이-
* 숫자를 뒤집는 것이 개인적으로 맘에 안든다. 내 방식이 좀 더 깔끔해 보인다.
*/
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
int num = kb.nextInt();
int[] arr = new int[num];
for (int i = 0; i < num; i++) {
arr[i] = kb.nextInt();
}
System.out.println(solution(arr));
}
private static String solution(int[] arr) {
String answer = "";
String[] reverse = new String[arr.length];
for (int i = 0; i < arr.length; i++) {
reverse[i] = String.valueOf(arr[i]);
reverse[i] = new StringBuilder(reverse[i]).reverse().toString();
arr[i] = Integer.parseInt(reverse[i]);
if (isPrime(arr[i])) {
answer += arr[i] + " ";
}
}
// for (int i = 0; i < arr.length; i++) { 이중 for 문에 이중 if 문... 진짜 더럽긴 하다..
// for (int j = 2; j <= arr[i]; j++) { 실제로 이렇게 적으면 감점 먹을듯
// if (arr[i] % j == 0) {
// if (j < arr[i]) {
// break;
// }
// answer += arr[i] + " ";
// }
// }
// }
return answer;
}
private static boolean isPrime(int num) {
if (num == 1) {
return false;
}
for (int i = 2; i < num; i++) {
if (num % i == 0) {
return false;
}
}
return true;
}
}
숫자를 뒤집는 것은 내 풀이가 좀 더 깔끔하고 소수를 찾는 부분은 선생님 풀이가 좀 더 깔끔했기 때문에 리팩토링을 진행했다. 맨 위부터 내 풀이, 선생님 풀이, 리팩토링 순서이다.
2-7. 점수 계산
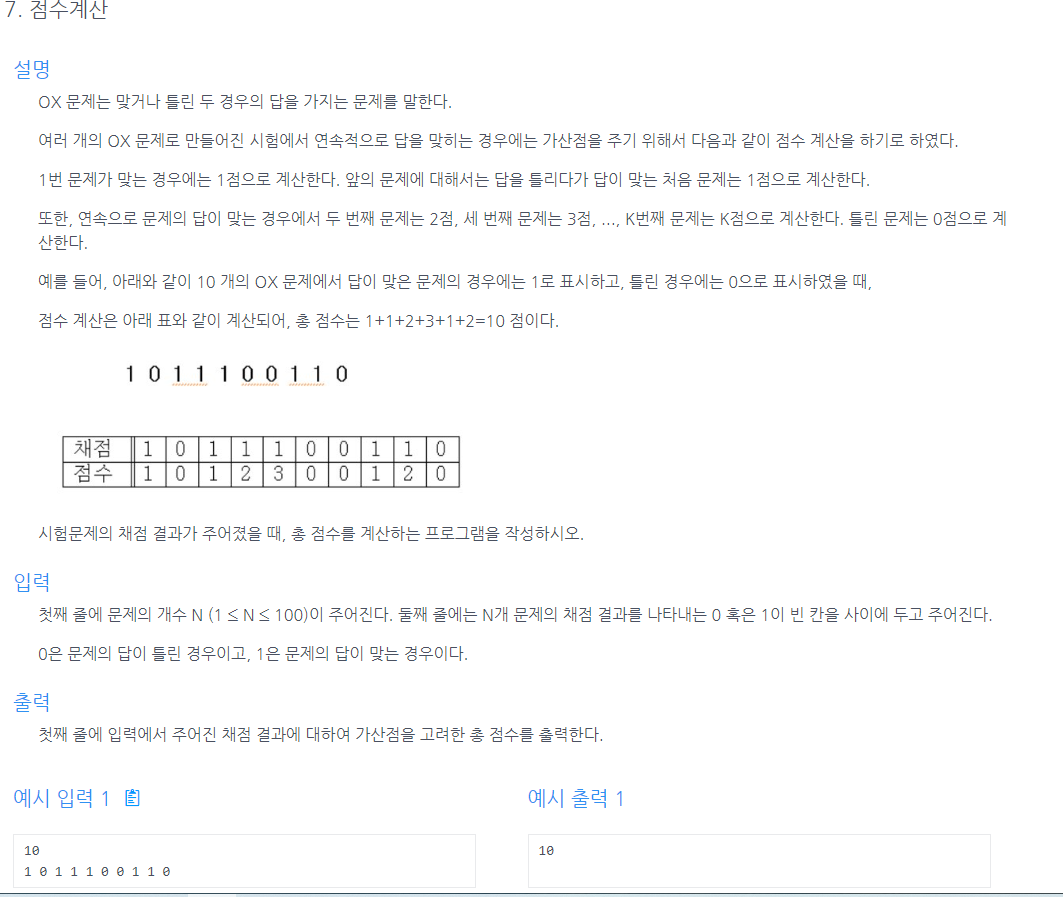
package 배열1차원2차원.점수계산2다시7.my;
import java.util.Scanner;
public class Main {
/**
* 너무 쉬웠어서 피드백 할게 없다.
*/
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
int num = kb.nextInt();
int[] arr = new int[num];
for (int i = 0; i < num; i++) {
arr[i] = kb.nextInt();
}
System.out.println(solution(arr));
}
private static int solution(int[] arr) {
int answer = 0, cnt = 0;
for (int i = 0; i < arr.length; i++) {
if (arr[i] == 1) {
cnt++;
answer += cnt;
}
else {
cnt = 0;
}
}
return answer;
}
}
쉬운 문제이기 떄문에 피드백은 없음
2-8. 등수 구하기
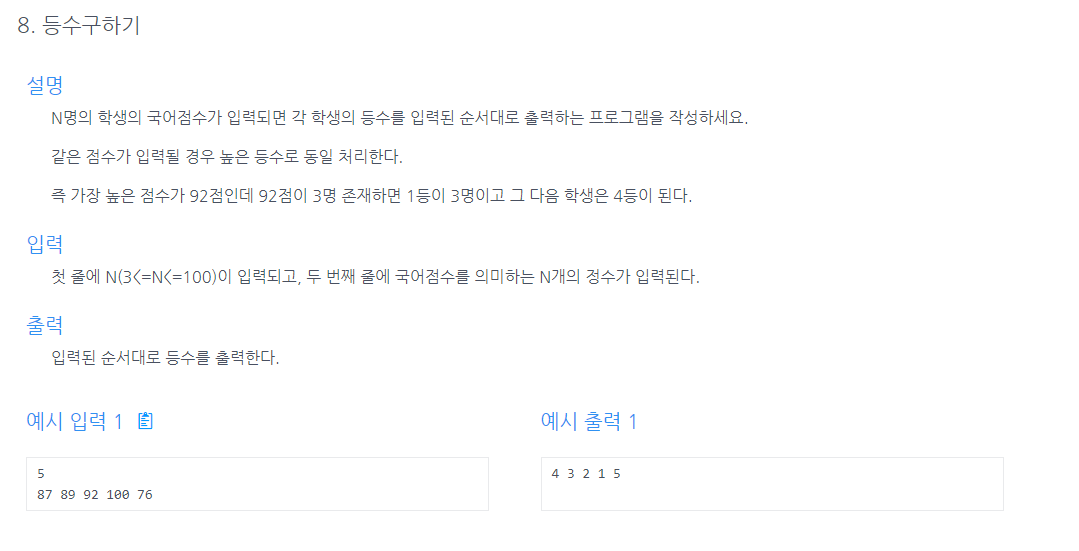
package 배열1차원2차원.등수구하기2다시8.my;
import java.util.Scanner;
public class Main {
/**
* 피드백 할것이 없다.
*/
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
int num = kb.nextInt();
int[] arr = new int[num];
for (int i = 0; i < num; i++) {
arr[i] = kb.nextInt();
}
for (int x : solution(arr)) {
System.out.print(x + " ");
}
}
private static int[] solution(int[] arr) {
int[] answer = new int[arr.length];
int cnt = 1;
for (int i = 0; i < arr.length; i++) {
for (int j = 0; j < arr.length; j++) {
if (arr[i] < arr[j]) {
cnt++;
}
}
answer[i] = cnt;
cnt = 1;
}
return answer;
}
}
피드백 할 것 없음
2-9 격자판 최대합
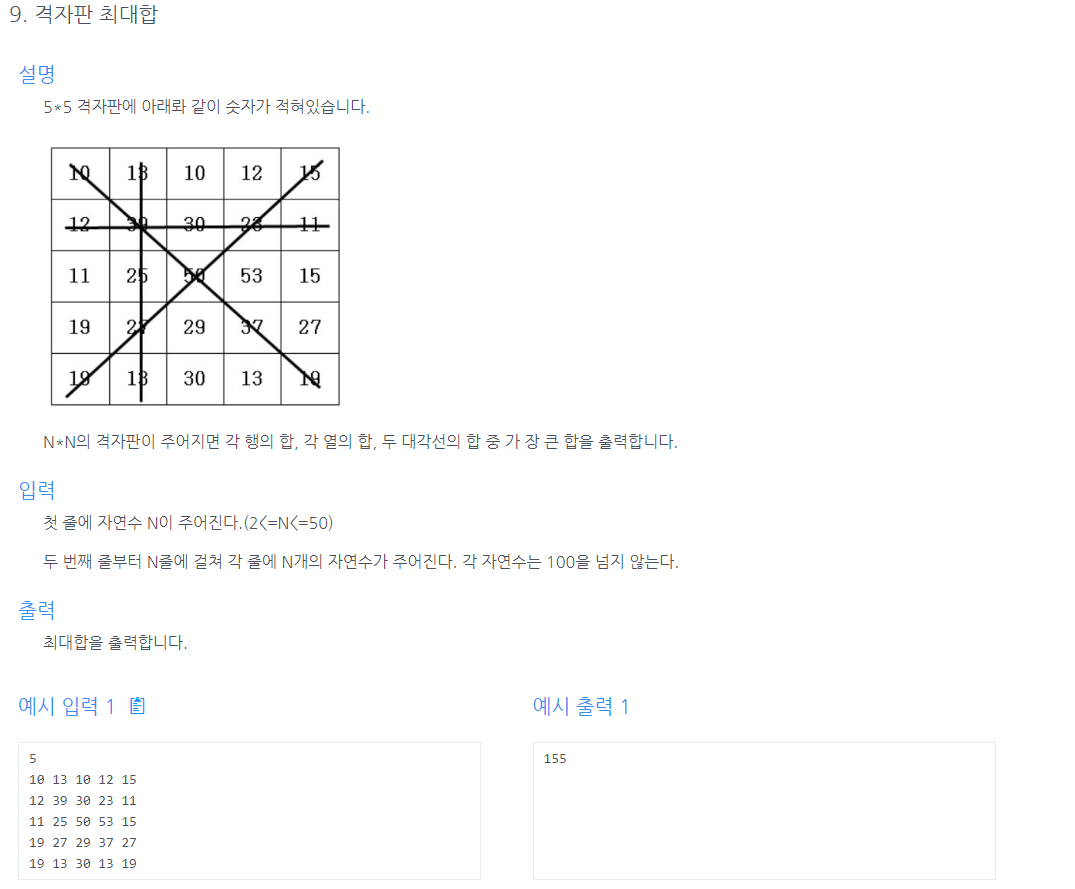
package 배열1차원2차원.격자판최대합2다시9.my;
import java.util.Scanner;
public class Main {
/**
* 너무 지저분하게 풀어버렸다... 시간도 이렇게 오래 걸리는 문제가 아닌거같은데 헛지거리를 했다는 생각..
*
*/
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
int num = kb.nextInt();
int[][] arr = new int[num][num];
for (int i = 0; i < num; i++) {
for (int j = 0; j < num; j++) {
arr[i][j] = kb.nextInt();
}
}
System.out.println(solution(num, arr));
}
private static int solution(int num, int[][] arr) {
int[] sumArray = new int[4];
sumArray[0] = rowSum(num, arr);
sumArray[1] = columnSum(num, arr);
sumArray[2] = leftCrossSum(num, arr);
sumArray[3] = rightCrossSum(num, arr);
return finalSum(sumArray);
}
private static int finalSum(int[] sumArray) {
int max = 0;
for (int i = 0; i < 4; i++) {
if (max < sumArray[i]) {
max = sumArray[i];
}
}
return max;
}
private static int rowSum(int num, int[][] arr) {
int sum = 0, max = 0;
for (int i = 0; i < num ; i++) {
for (int j = 0; j < num; j++) {
sum += arr[i][j];
}
if (max < sum) {
max = sum;
}
sum = 0;
}
return max;
}
private static int columnSum(int num, int[][] arr) {
int sum = 0, max = 0;
for (int i = 0; i < num; i++) {
for (int j = 0; j < num; j++) {
sum += arr[j][i];
}
if (max < sum) {
max = sum;
}
sum = 0;
}
return max;
}
private static int leftCrossSum(int num, int[][] arr) {
int sum = 0;
for (int i = 0; i < num; i++) {
sum += arr[i][i];
}
return sum;
}
private static int rightCrossSum(int num, int[][] arr) {
int sum = 0;
for (int i = 0; i < num; i++) {
int cnt = num - i - 1;
sum += arr[cnt][i];
}
return sum;
}
}
package 배열1차원2차원.격자판최대합2다시9.teacher;
import java.util.Scanner;
public class Main {
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
int n = kb.nextInt();
int[][] arr = new int[n][n];
for (int i = 0; i < n; i++) {
for (int j = 0; j < n; j++) {
arr[i][j] = kb.nextInt();
}
}
System.out.println(solution(n, arr));
}
private static int solution(int n, int[][] arr) {
int answer = Integer.MIN_VALUE;
int sum1, sum2;
for (int i = 0; i < n; i++) {
sum1 = sum2 = 0;
for (int j = 0; j < n; j++) {
sum1 += arr[i][j];
sum2 += arr[j][i];
}
answer = Math.max(answer, sum1);
answer = Math.max(answer, sum2);
}
sum1 = sum2 = 0;
for (int i = 0; i < n; i++) {
sum1 += arr[i][i];
sum2 += arr[i][n - i - 1];
answer = Math.max(answer, sum1);
answer = Math.max(answer, sum2);
}
return answer;
}
}
답은 맞았는데 너무 지저분하게 풀었다...
2-10. 봉우리
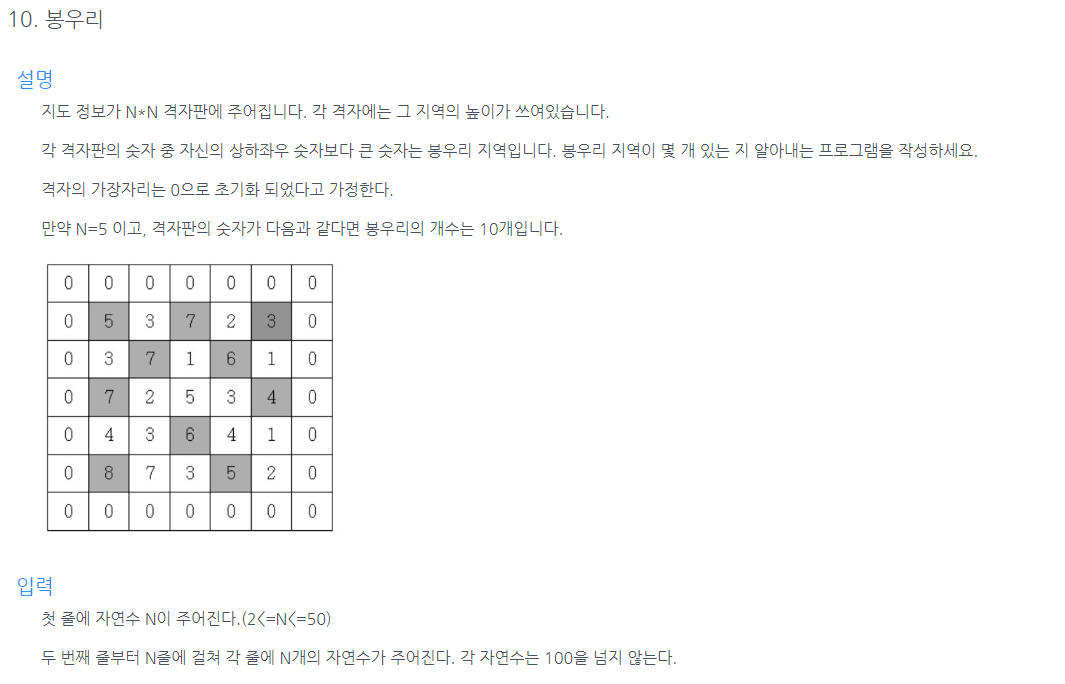
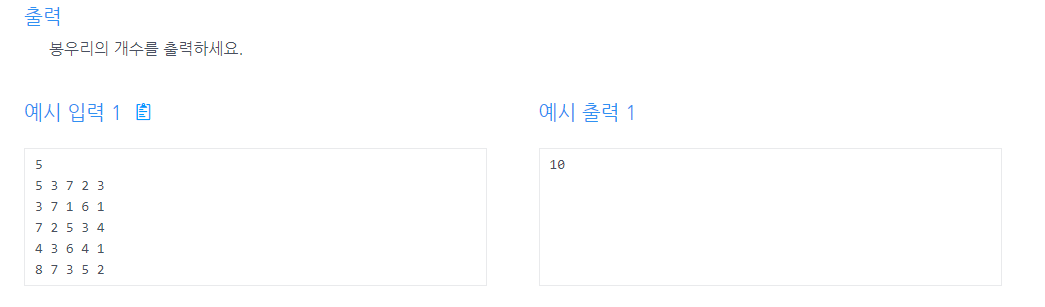
package 배열1차원2차원.봉우리2다시10.my;
import java.util.Scanner;
public class Main {
/**
* -내 풀이-
* 좀 더 객체지향스럽게 구현하고자 기준점이 되는 값을 기준으로 왼쪽 오른쪽 위쪽 아래쪽을 비교하는 각각의
* 메서드를 만들어서 코드가 좀 깔끔해보이게 만들었다.
*
* -선생님의 풀이-
* dx, dy 의 개념을 도입해서 시계방향으로 인덱스를 검사하여 값을 확인하는 로직을 구현하셨다.
* 근데 너무 어지럽게 코드가 짜여져있고 3중 for 문에 안에 if 문까지 있어서 읽기 굉장히 힘듦
* 개인적으로는 내 코드가 좀 더 깔끔하고 읽기 편하기 때문에 이 문제의 정답은 내 코드로 결정
*/
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
int input = kb.nextInt();
int[][] arr = new int[input][input];
for (int i = 0; i < input; i++) {
for (int j = 0; j < input; j++) {
arr[i][j] = kb.nextInt();
}
}
System.out.println(solution(input, arr));
}
private static int solution(int input, int[][] arr) {
int answer = 0;
int[][] plat = new int[input + 2][input + 2];
for (int i = 0; i < input ; i++) {
for (int j = 0; j < input ; j++) {
plat[i + 1][j + 1] = arr[i][j];
}
}
for (int i = 1; i <= input; i++) {
for (int j = 1; j <= input; j++) {
if (isLeftThenBigger(plat[i][j], plat[i][j + 1]) && isRightThenBigger(plat[i][j], plat[i][j - 1]) &&
isUpThenBigger(plat[i][j], plat[i - 1][j]) && isUnderThenBigger(plat[i][j], plat[i + 1][j])) {
answer++;
}
}
}
return answer;
}
private static boolean isLeftThenBigger(int num, int left) {
if (left < num) {
return true;
}
return false;
}
private static boolean isRightThenBigger(int num, int right) {
if (num > right) {
return true;
}
return false;
}
private static boolean isUpThenBigger(int num, int up) {
if (num > up) {
return true;
}
return false;
}
private static boolean isUnderThenBigger(int num, int under) {
if (num > under) {
return true;
}
return false;
}
}
package 배열1차원2차원.봉우리2다시10.teacher;
import java.util.Scanner;
public class Main {
static int[] dx = {-1, 0, 1, 0};
static int[] dy = {0, 1, 0, -1};
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
int n = kb.nextInt();
int[][] arr = new int[n][n];
for (int i = 0; i < n; i++) {
for (int j = 0; j < n; j++) {
arr[i][j] = kb.nextInt();
}
}
System.out.println(solution(n, arr));
}
private static int solution(int n, int[][] arr) {
int answer = 0;
for (int i = 0; i < n; i++) {
for (int j = 0; j < n; j++) {
boolean flag = true;
for (int k = 0; k < 4; k++) {
int nx = i + dx[k];
int ny = i + dy[k];
if (nx >= 0 && nx < n && ny >= 0 && ny < n && arr[nx][ny] >= arr[i][j]) {
flag = false;
break;
}
}
if (flag) {
answer++;
}
}
}
return answer;
}
}
이번만큼은 선생님보다 잘 풀었다고 자부할 수 있다. 처음 코드를 작성할 때부터 객체지향스럽게 만들어야겠다는 생각을 하고 만들어서 그런지 좀 더 코드가 깔끔하게 나온 듯 하다.
2-11. 임시반장
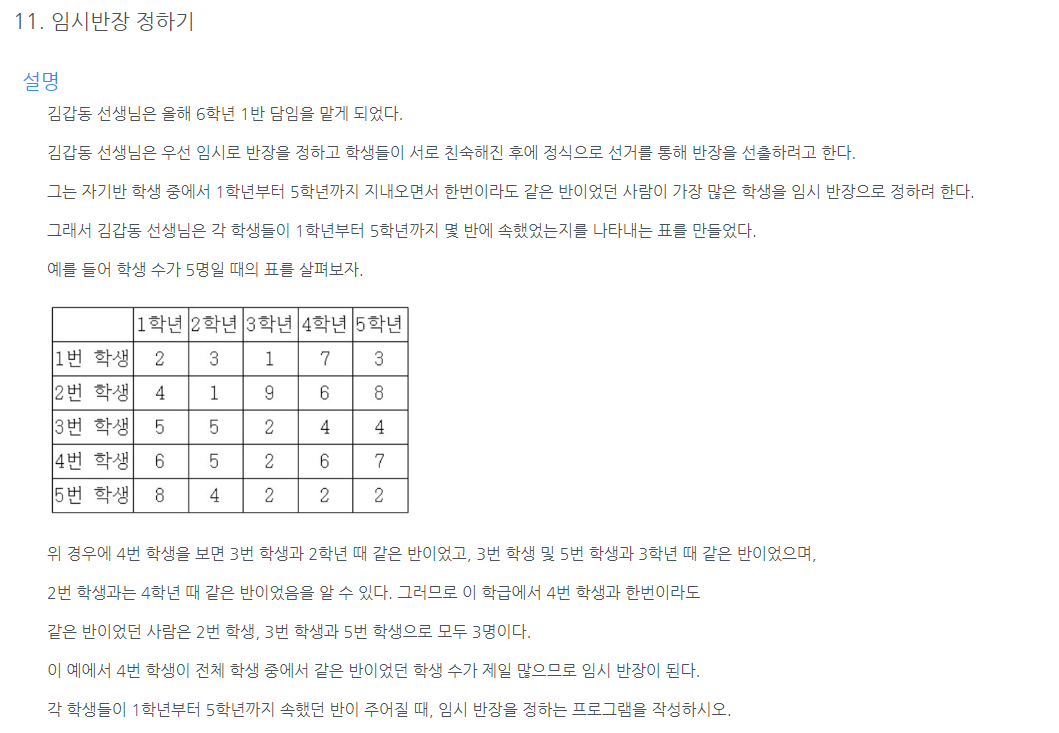
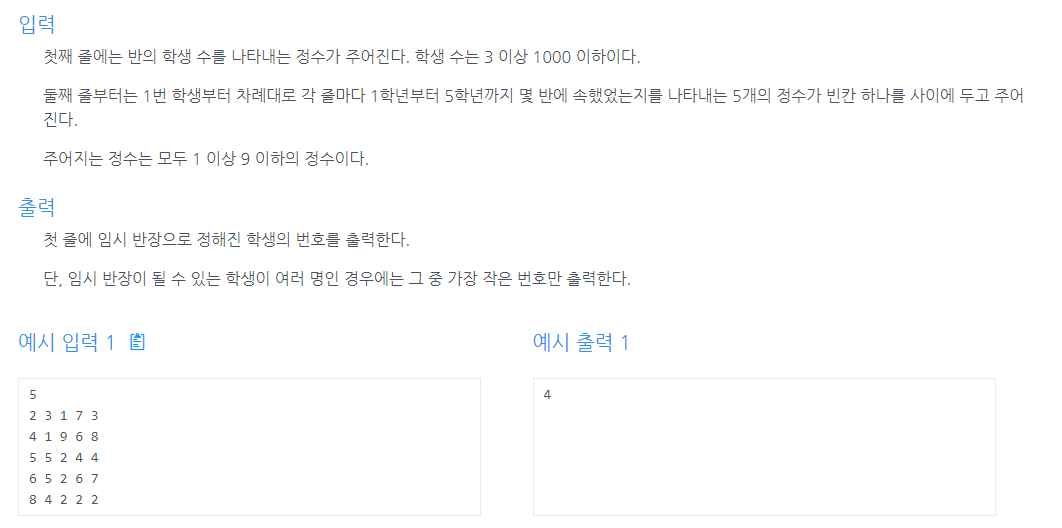
package 배열1차원2차원.임시반장2다시11.my;
import java.util.Scanner;
public class Main {
/**
* 문제가 너무 이상해서 이런식으로는 절대 코딩테스트 안나올듯
* 오해의 소지가 너무 분명함
*/
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
int input = kb.nextInt();
int[][] arr = new int[input][5];
for (int i = 0; i < input; i++) {
for (int j = 0; j < 5; j++) {
arr[i][j] = kb.nextInt();
}
}
System.out.println(solution(input, arr));
}
private static int solution(int input, int[][] arr) {
int answer = 0, cnt = 0, student = 0, num = 0, max = 0;
int[] count = new int[input];
for (int k = 0; k < input; k++) {
for (int i = 0; i < 5; i++) {
for (int j = 0; j < input; j++) {
if (arr[student][num] == arr[j][i]) {
cnt++;
}
}
num++;
}
student++;
count[k] = cnt;
cnt = 0;
num = 0;
if (max < count[k]) {
max = count[k];
}
}
for (int i = 0; i < input; i++) {
if (count[i] == max) {
answer = i + 1;
break;
}
}
return answer;
}
}
package 배열1차원2차원.임시반장2다시11.teacher;
import java.util.Scanner;
public class Main {
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
int n = kb.nextInt();
int[][] arr = new int[n + 1][6];
for (int i = 1; i <= n; i++) {
for (int j = 1; j <= 5; j++) {
arr[i][j] = kb.nextInt();
}
}
System.out.println(solution(n, arr));
}
private static int solution(int n, int[][] arr) {
int answer = 0, max = Integer.MIN_VALUE;
for (int i = 1; i <= n; i++) {
int cnt = 0;
for (int j = 1; j <= n; j++) {
for (int k = 1; k <= 5; k++) {
if (arr[i][k] == arr[j][k]) {
cnt++;
break;
}
}
}
if (max < cnt) {
max = cnt;
answer = i;
}
}
return answer;
}
}
문제가 너무 오해의 소지가 많아 실제 코딩테스트로는 안나올듯한 문제 그냥 넘어가자
2-12. 멘토링
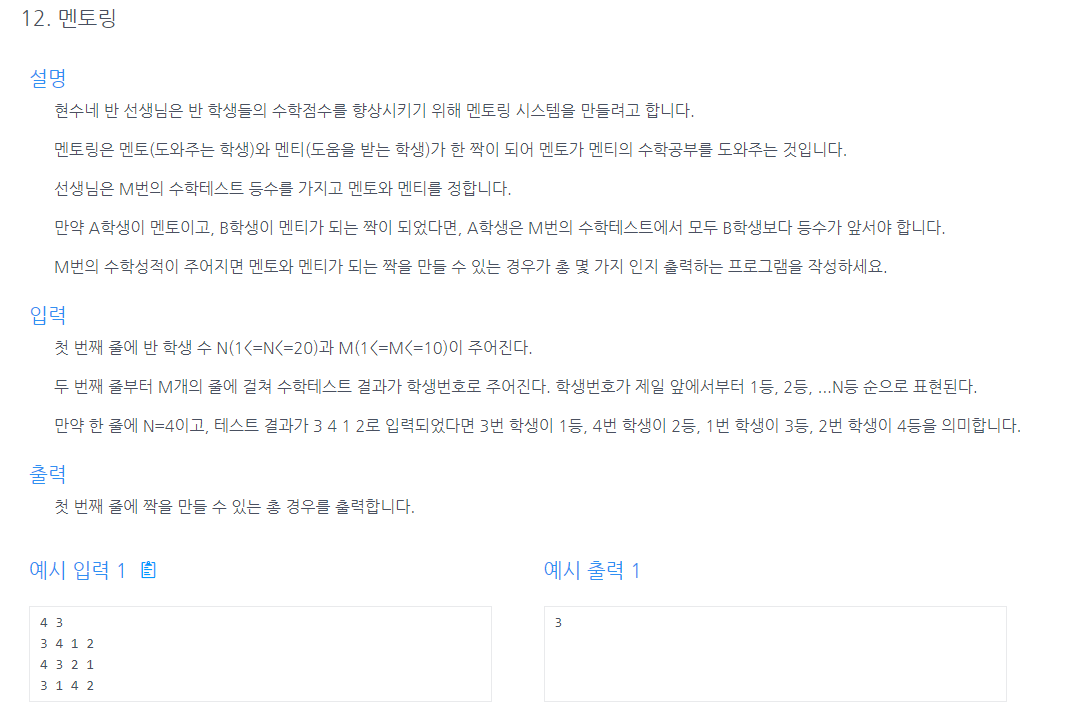
package 배열1차원2차원.멘토링2다시12.my;
import java.util.Scanner;
public class Main {
/**
* 내 머리가 빠가인가 이해가 안된다...
*/
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
int grade = kb.nextInt();
int count = kb.nextInt();
int[][] arr = new int[grade][count];
for (int i = 0; i < grade; i++) {
for (int j = 0; j < count; j++) {
arr[i][j] = kb.nextInt();
}
}
System.out.println(solution(grade, count, arr));
}
private static int solution(int grade, int count, int[][] arr) {
int answer = 0;
for (int i = 0; i < grade; i++) {
for (int j = 0; j < count; j++) {
}
}
return answer;
}
}
package 배열1차원2차원.멘토링2다시12.teacher;
import java.util.Scanner;
public class Main {
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
int n = kb.nextInt();
int m = kb.nextInt();
int[][] arr= new int[m][n];
for (int i = 0; i < m; i++) {
for (int j = 0; j < n; j++) {
arr[i][j] = kb.nextInt();
}
}
System.out.println(solution(n, m, arr));
}
private static int solution(int n, int m, int[][] arr) {
int answer = 0;
for (int i = 1; i <= n; i++) { // 첫 2중 for 문은 총 n 명의 개수만큼 나올 수 있는 모든 경우의 수
for (int j = 1; j <= n; j++) {
int cnt = 0;
for (int k = 0; k < m; k++) { // k 는 테스트 번호
int pi = 0, pj = 0; // pi = i 의 위치, pj = j 의 위치
for (int s = 0; s < n; s++) { // s 는 등수
if (arr[k][s] == i) { // k 번째 테스트에서 s 등을 한 인물이 i 와 같다면
pi = s;
}
if (arr[k][s] == j) {
pj = s;
}
}
if (pi < pj) {
cnt++;
}
}
if (cnt == m) {
answer++;
}
}
}
return answer;
}
}
일단 이해해한다고 했는데... 진짜 이해가 안된다. for 문이 두개여도 복잡한데 네개나 나오니까 대가리 터질것같다
2장 배열 주요개념 및 복습 노트
이번 2장 배열에서는 기본적으로 배열과 for 문을 어떻게 설계하고 컴퓨팅적 사고를 하는지에 대해 물어보는 문제가 많았다. 그래서 딱히 중요한 문법이나 알고리즘이 많이 나오지 않았기 때문에 가장 중요했다고 생각되는 내용만 몇개 추려서 포스팅 할 예정이다.
2-5. 소수의 개수
input 값으로 숫자를 하나 부여받고 0부터 해당 값까지 소수의 개수를 구하는 문제
풀이는 두가지로 나뉜다.
1. 소수를 수학적으로 접근하는 방법
2. 알고리즘을 사용하는 방법
하지만 여기서 첫번째 방법으로 문제를 풀게되면 TimeLimitBreak 에 걸리기 때문에 옳지 못한
풀이이다. 하지만 정리해보자면
1. 소수를 수학적으로 접근하는 방법
나눠지는수 / 나누는수 이렇게 연산을 하는데 2중 for문을 돌면서 모든 값을 다 비교해서 나머지가 0인
상황에서 나눠지는수 == 나누는수가 되면 값을 하나 카운트 하는 방식
이 방식의 문제는 문제의 조건인 1부터 10만까지 수를 계산하려면 10만^2 번만큼 for 문이 돌기때문에
TimeLimitBreak에 걸린다.
2. 알고리즘을 사용하는 방법
소수를 구하는 알고리즘인 에라토스테네스의 체 라는 것을 이용하여 풀면 시간 복잡도도 O(N^1/2) = N의 제곱근
으로 굉장히 빨리 구할 수 있다.
1. 먼저 배열을 설정하고 각각의 값을 0으로 초기화한다.
2. 나눠지는 수는 input 값으로 고정한 뒤에 나누는 수를 하나씩 올린다.
3. 만약 나누는 수를 올리다가 나눠지는 수와의 나머지가 0인 경우 나누는 수의 배수를 전부 1로 바꾼다.
이때 for 문이 핵심인데
for (int i = 0; i < n; i = i++) {
if (arr[i] == 0) {
answer++;
}
for (int j = i; j <= n; j = j + i) {
arr[j] = 1;
}
}
이렇게 구하면 된다.
2-6. 뒤집은 소수
ex) 1200, 145 -> 21, 541 이렇게 뒤집은 다음 소수인지 확인하는 문제
소수를 수학적으로 접근해서 구하는 로직이 boolean 을 사용하면 된다.
1. 뒤집은 소수의 배열인 arr[i] 가 있다고 하자
2. isPrime(int num) 을 만들어 리턴값을 boolean 으로 받는다.
3.
for (int i = 0; i < n; i++) {
if (isPrime(arr[i])) {
answer += arr[i] + " ";
}
}
private boolean isPrime(int num) {
if (num == 1) {
return false;
}
for (int i = 2; i < num; i++) {
if (num % i == 0) {
return false;
}
}
return true;
}
3-1. 두 배열 합치기
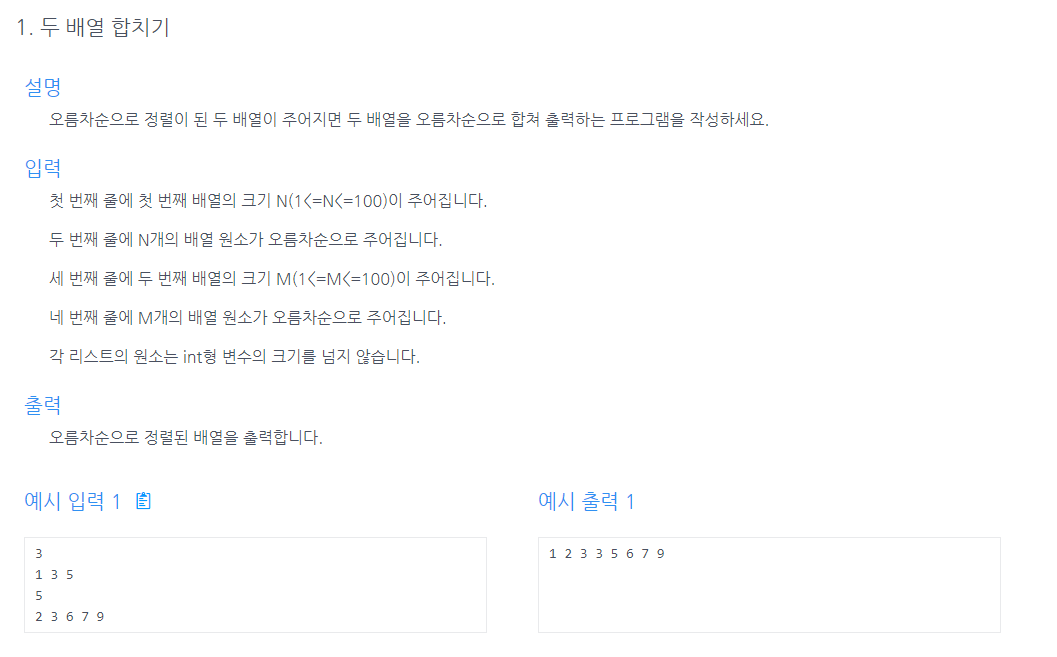
package 배열응용3장.두배열합치기3다시1.my;
import java.util.Scanner;
public class Main {
/**
* -내 풀이-
* 이중 for 문을 돌면서 각각의 숫자를 비교한 후 최솟값을 넣는 방향으로 진행했다.
* 거기에 배열 두개를 그냥 새로운 배열로 만들어서 풀었다.
*
* --피드백--
* 두개의 정렬된 배열을 하나의 배열로 만드는 것이 아니라 각각의 배열에서 포인터를 도입해 비교하면 된다.
* 그리고 문제를 잘못 이해하여 입력받은 두 배열은 정렬된 상태라는 것을 눈치채지 못했다.
*
* -선생님의 풀이-
* two pointers algorithm 을 이용해 풀면 간단하게 풀린다.
*
* pt1 = 0, pt2 = 0;
* while (pt1 < n && pt2 < m) {
* if (a[pt1] < b[bt2]) {
* answer.add(a[pt1++]);
* }
* else {
* answer.add(b[pt2++]);
* }
* }
* while (pt1 < n) {
* answer.add(a[pt1++]);
* }
* while (pt2 < m) {
* answer.add(b[pt2++]);
* }
*/
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
int input1 = kb.nextInt();
int[] arr1 = new int[input1];
for (int i = 0; i < input1; i++) {
arr1[i] = kb.nextInt();
}
int input2 = kb.nextInt();
int[] arr2 = new int[input2];
for (int i = 0; i < input2; i++) {
arr2[i] = kb.nextInt();
}
System.out.println(solution(arr1, arr2));
}
private static String solution(int[] arr1, int[] arr2) {
String answer = "";
int[] sumArr = new int[arr1.length + arr2.length];
int[] newArr = new int[sumArr.length];
int min = Integer.MAX_VALUE;
for (int i = 0; i < arr1.length; i++) {
sumArr[i] = arr1[i];
}
for (int i = 0; i < arr2.length; i++) {
sumArr[i + arr1.length] = arr2[i];
}
for (int i = 0; i < sumArr.length; i++) {
for (int j = i; j < sumArr.length; j++) {
if (min > sumArr[j]) {
min = sumArr[j];
}
}
newArr[i] = min;
min = Integer.MAX_VALUE;
System.out.print(sumArr[i] + " ");
}
System.out.println();
for (int i = 0; i < newArr.length; i++) {
System.out.print(newArr[i] + " ");
}
return answer;
}
}
package 배열응용3장.두배열합치기3다시1.teacher;
import java.util.ArrayList;
import java.util.Scanner;
public class Main {
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
int n = kb.nextInt();
int[] a = new int[n];
for (int i = 0; i < n; i++) {
a[i] = kb.nextInt();
}
int m = kb.nextInt();
int[] b = new int[m];
for (int i = 0; i < m; i++) {
b[i] = kb.nextInt();
}
for (int x : solution(n, m, a, b)) System.out.print(x + " ");
}
private static ArrayList<Integer> solution(int n, int m, int[] a, int[] b) {
ArrayList<Integer> answer = new ArrayList<>();
int p1 = 0, p2 = 0;
while (p1 < n && p2 < m) {
if (a[p1] < b[p2]) {
answer.add(a[p1++]);
}
else {
answer.add(b[p2++]);
}
}
while (p1 < n) {
answer.add(a[p1++]);
}
while (p2 < m) {
answer.add(b[p2++]);
}
return answer;
}
}
3-2. 공통 원소 구하기
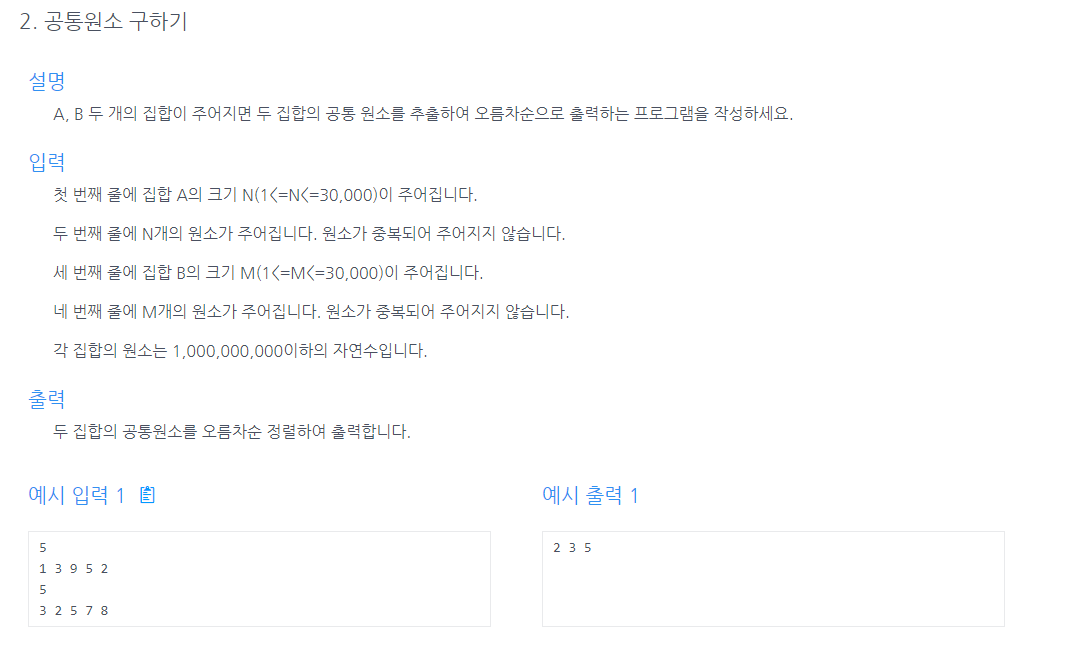
package 배열응용3장.공통원소구하기3다시2.my;
import java.util.ArrayList;
import java.util.Scanner;
public class Main {
/**
* -내 풀이-
* 도저히 생각이 나지 않아서 포기했다.
*
* -선생님 풀이-
* 이번에도 two pointers algorithm 을 사용한 문제였다.
* 이번에 눈여겨 볼 점은 어떤 배열을 오름차순으로 정렬하기 위해서는 Arrays 클래스의 sort 메서드를 사용하면 된다는 것과
* 교집합을 찾는 문제이기 때문에 p1 과 p2 가 같은 경우 p1, p2 둘을 동시에 증가시켜야 했다는 점이다.
*
* 그리고 p1 과 p2 중 작은 쪽을 하나 증가시켜야 한다는 점도 인상깊었다.
*
* int p1 = 0, p2 = 0;
* while (p1 < n && p2 < m) {
* if (a[p1] == b[p2]) {
* answer.add(a[p1++]);
* p2++;
* }
* else if (a[p1] < b[p2]) {
* p1++;
* }
* else {
* p2++;
* }
* }
*/
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
int num1 = kb.nextInt();
long[] arr1 = new long[num1];
for (int i = 0; i < num1; i++) {
arr1[i] = kb.nextInt();
}
int num2 = kb.nextInt();
long[] arr2 = new long[num2];
for (int i = 0; i < num2; i++) {
arr2[i] = kb.nextInt();
}
for (int x : solution(num1, num2, arr1, arr2)) {
System.out.print(x + " ");
}
}
private static ArrayList<Integer> solution(int num1, int num2, long[] arr1, long[] arr2) {
ArrayList<Integer> answer = new ArrayList<>();
int pt1 = 0, pt2 = 0;
while (true) {
if (arr1[pt1] == arr2[pt2++]) {
}
}
}
}
package 배열응용3장.공통원소구하기3다시2.teacher;
import java.util.ArrayList;
import java.util.Arrays;
import java.util.Scanner;
public class Main {
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
int n = kb.nextInt();
int[] a = new int[n];
for (int i = 0; i < n; i++) {
a[i] = kb.nextInt();
}
int m = kb.nextInt();
int[] b = new int[m];
for (int i = 0; i < m; i++) {
b[i] = kb.nextInt();
}
for (int x : solution(n, m, a, b)) System.out.print(x + " ");
}
private static ArrayList<Integer> solution(int n, int m, int[] a, int[] b) {
ArrayList<Integer> answer = new ArrayList<>();
Arrays.sort(a);
Arrays.sort(b);
int p1 = 0, p2 = 0;
while (p1 < n && p2 < m) {
if (a[p1] == b[p2]) {
answer.add(a[p1++]);
p2++;
}
else if (a[p1] < b[p2]) {
p1++;
}
else {
p2++;
}
}
return answer;
}
}
3-3. 최대 매출
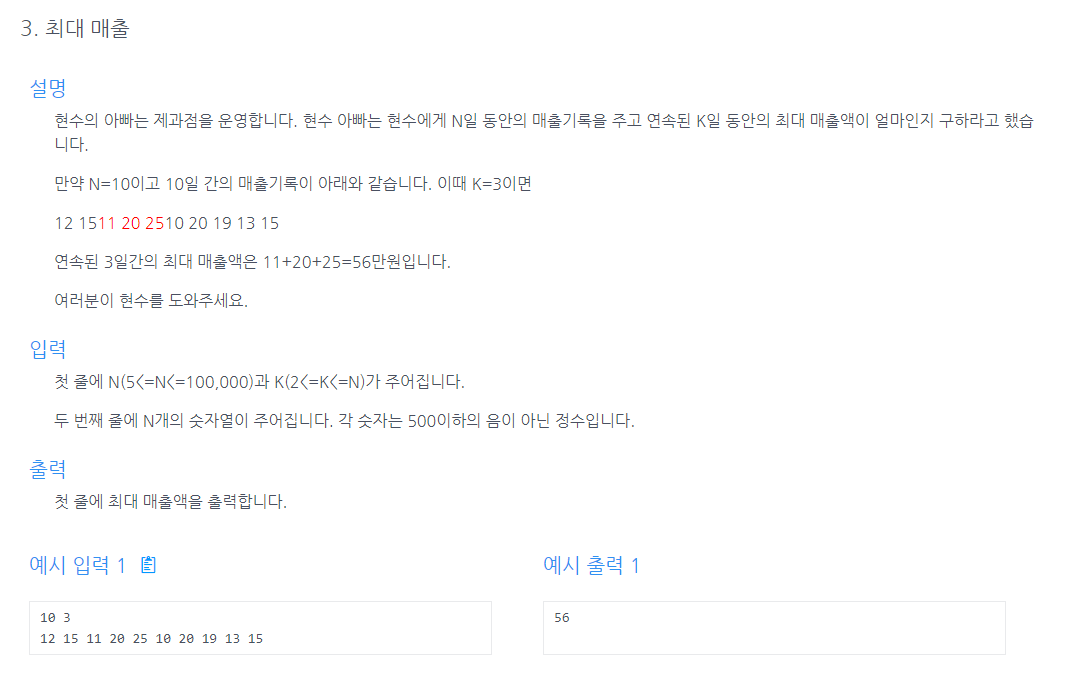
package 배열응용3장.최대매출3다시3.my;
import java.util.Scanner;
public class Main {
/**
* -피드백-
* sliding window 알고리즘을 이용하여 풀면 된다.
* sliding window 는 two pointers algorithm 을 이용한 문제지만 딱히 two pointers algorithm 을 이용하지 않아도 된다.
* 선생님의 풀이처럼 for 문 하나를 가지고 풀어도 된다.
*
* -선생님 풀이-
* ex) 10개의 값을 3개만큼 합해서 최댓값을 구해야 한다면
* 1 2 3 4 5 6 7 8 9 10
* | |
* | |
* | |
* 이렇게 칸을 이동시키면 된다. 즉, 앞에건 빼주고 뒤에건 더해주면 된다.
* for (int i = k; i < n; i++) { // 여기서 k 는 구간개수 위의 예제에선 3
* sum += arr[i];
* sum -= arr[i - k];
* answer = Math.max(answer, sum); // 물론 answer 는 sum 으로 초기화 해줘야 한다.
* }
*/
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
int count = kb.nextInt();
int selection = kb.nextInt();
int[] arr = new int[count + 1];
for (int i = 0; i < count; i++) {
arr[i] = kb.nextInt();
}
System.out.println(solution(arr, count, selection));
}
private static int solution(int[] arr, int count, int selection) {
int start = 0, end = selection - 1;
int max = Integer.MIN_VALUE;
int sum = 0;
for (int i = 0; i <= end; i++) {
sum += arr[i];
}
while (start < count && end < count) {
if (end + 1 == count) {
break;
}
if (max < sum) {
max = sum;
}
sum += arr[end + 1];
sum -= arr[start];
start++;
end++;
}
return max;
}
}
package 배열응용3장.최대매출3다시3.teacher;
import java.util.Scanner;
public class Main {
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
int n = kb.nextInt();
int k = kb.nextInt();
int[] arr = new int[n];
for (int i = 0; i < n; i++) {
arr[i] = kb.nextInt();
}
System.out.println(solution(n, k, arr));
}
private static int solution(int n, int k, int[] arr) {
int answer = 0, sum = 0;
for (int i = 0; i < k; i++) {
sum += arr[i];
}
answer = sum;
for (int i = k; i < n; i++) {
sum += arr[i];
sum -= arr[i - k];
answer = Math.max(answer, sum);
}
return answer;
}
}
3-4. 연속 부분수열
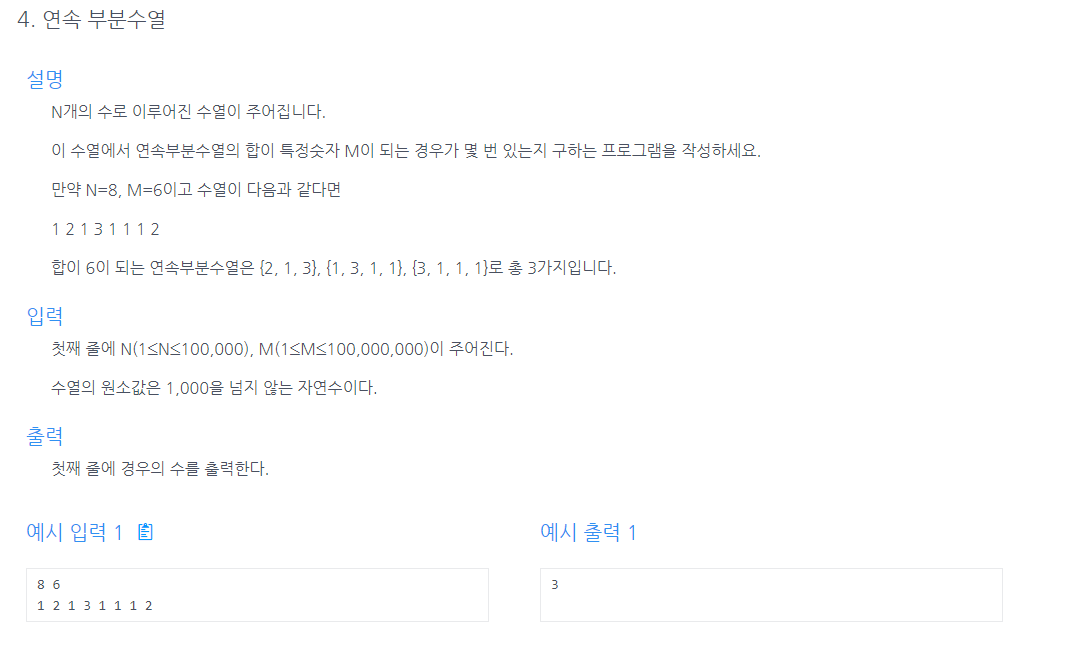
package 배열응용3장.연속부분수열3다시4.my;
import java.util.Scanner;
public class Main {
/**
* -내 풀이-
* two pointers algorithm 을 이용해 풀었는데 내 코드가 더 깔끔한 것 같다. 선생님의 코드는 너무 복잡함
* 피드백할 것은 없다.
*/
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
int n = kb.nextInt();
int m = kb.nextInt();
int[] arr = new int[n];
for (int i = 0; i < n; i++) {
arr[i] = kb.nextInt();
}
System.out.println(solution(n, m, arr));
}
private static int solution(int n, int m, int[] arr) {
int answer = 0, sum = 0;
int start = 0, end = 0;
while (start < n && end < n) {
if (m <= sum) {
// 1 2 1 3 1 1 1 2
// m = 6 , sum =
sum -= arr[start];
start++;
}
else {
// 1 2 3 4 5 6 7
// m = 4 , sum = 3
sum += arr[end];
end++;
}
if (m == sum) {
answer++;
}
}
return answer;
}
}
3-5. 연속된 자연수의 합
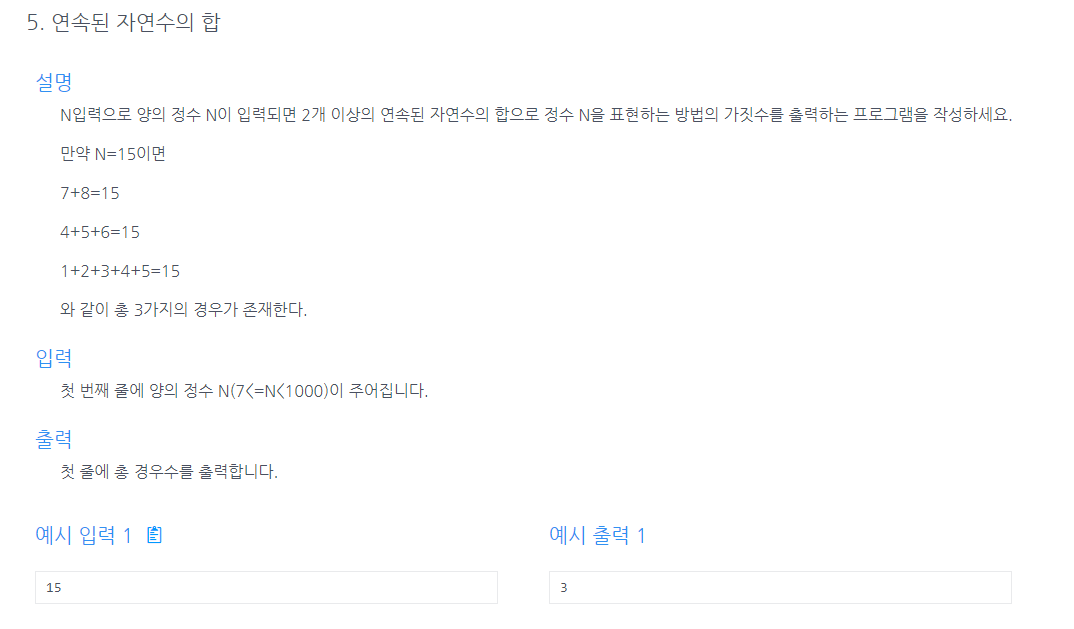
package 배열응용3장.연속된자연수의합3다시5.my;
import java.util.Scanner;
public class Main {
/**
* 이전 문제와 완벽히 동일 피드백 X
*/
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
int input = kb.nextInt();
int[] arr = new int[input];
for (int i = 0; i < input; i++) {
arr[i] = i + 1;
}
System.out.println(solution(arr, input));
}
private static int solution(int[] arr, int input) {
int answer = 0;
// input = 5, arr = 1 2 3 4 5
int start = 0, end = 0, sum = 0;
while (start < input && end < input) {
if (input <= sum) {
sum -= arr[start];
start++;
}
else {
// input > sum
// 5 > 0
sum += arr[end];
end++;
}
if (input == sum) {
answer++;
}
}
return answer;
}
}
3-6. 최대 길이 연속 부분수열
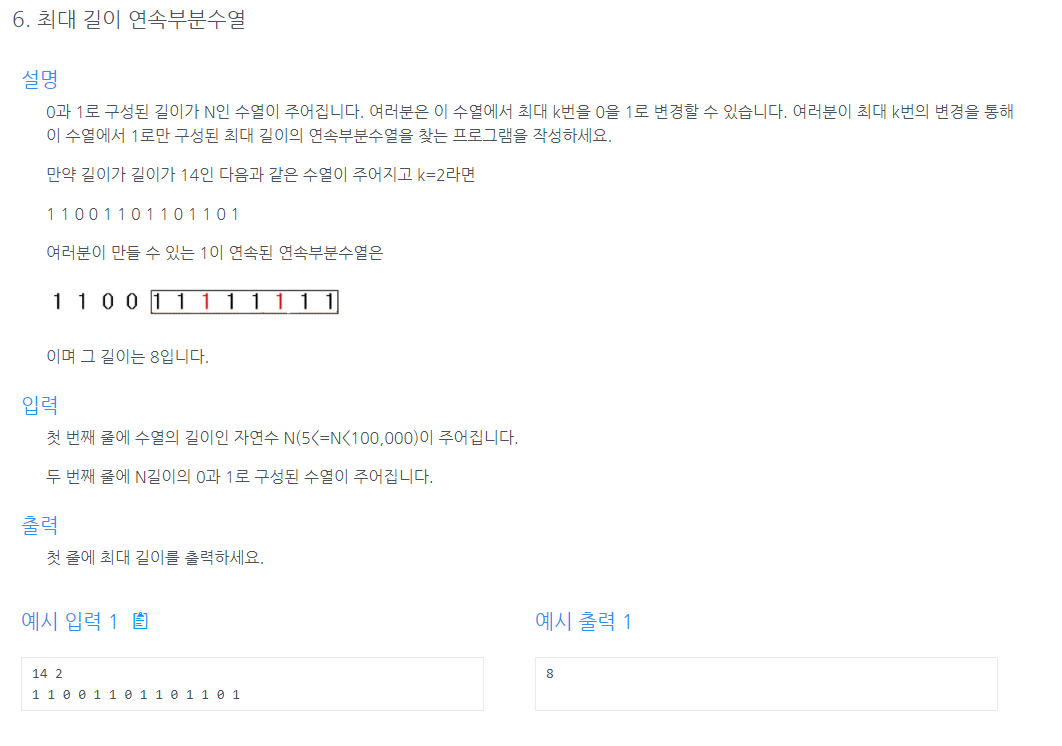
package 배열응용3장.최대길이연속부분수열3다시6.my;
import java.util.Scanner;
public class Main {
/**
* -내 풀이-
* 0을 1로 바꾸는 작업을 하는 것에 초점이 맞아서 풀지 못했다.
*
* -피드백-
* 0과 1로 바꾸는 작업 없이 start 와 end 와의 거리를 구하면 되는 것이다.
* 또한 cnt 라는 개념을 추가하여 arr[end] == 0 이면 cnt++
* 그리고 while (cnt > k) 로 cnt > k 인 상황에서 start 를 조정 (여기서 k 는 0을 1로 바꿀 수 있는 최대 횟수)
* arr[start] == 1 이면 단순 start++ arr[start] == 0 이면 cnt-- 하면서 start++
*/
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
int n = kb.nextInt();
int k = kb.nextInt();
int[] arr = new int[n];
for (int i = 0; i < n; i++) {
arr[i] = kb.nextInt();
}
System.out.println(solution(n, k, arr));
}
private static int solution(int n, int k, int[] arr) {
int answer = 0;
int start = 0, end = 0, cnt = 0;
while (start < n && end < n) {
if (arr[end] == 0) {
cnt++;
}
while (cnt > k) {
if (arr[start] == 0) {
cnt--;
}
start++;
}
answer = Math.max(answer, end - start + 1);
end++;
}
return answer;
}
}
3장 주요 개념 및 복습
3장의 주요 개념은 역시 Two Pointers Algorithm (이하 투 포인터 알고리즘) 이다. 대부분의 문제는 투 포인터 알고리즘을 적용하면 간단하게 풀 수 있는 문제이다.
그 중에서 투 포인터 알고리즘의 변형 문제인 Sliding Window (이하 슬라이딩 윈도우) 를 익히면 완벽할 것 같다.
하지만 3-6. 최대 길이 연속 부분수열 문제를 다시 한번 확인할 필요가 있다.
https://coding-review.tistory.com/275
투 포인터 알고리즘에 대해서는 포스팅 한 내용이 있으니 해당 부분을 참고하면 될 것
https://coding-review.tistory.com/269
슬라이딩 윈도우에 대해서는 포스팅에 적혀있지 않으니 여기서 빠르게 정리한다.
슬라이딩 윈도우는 투 포인터 알고리즘의 변형으로 투 포인터 알고리즘을 사용하지만
두 포인터 사이의 간격이 일정하다는 특징이 있다.
배열의 크기가 size 이고 간격이 k 인 상황에서 연속적인 배열의 최댓값을 구하는 문제라고 가정
private static int solution(int size, int k, int[] arr) {
int answer = 0;
int start = 0, end = k;
int sum = 0;
for (int i = 0; i < end; i++) {
sum += arr[i];
}
while (end < size) {
sum += arr[end];
sum -= arr[start];
end++;
start++;
answer = Math.max(answer, sum);
}
return answer;
}
보통 슬라이딩 윈도우를 사용할때는 초기값을 정하고 그로부터 한칸씩 밀면서 진행하는 경우가
대부분이었다. 3-6 최대 길이 연속 부분수열 문제는 그런 형태는 아니었지만 대부분의 문제가 그러했다.
4-1. 학급회장
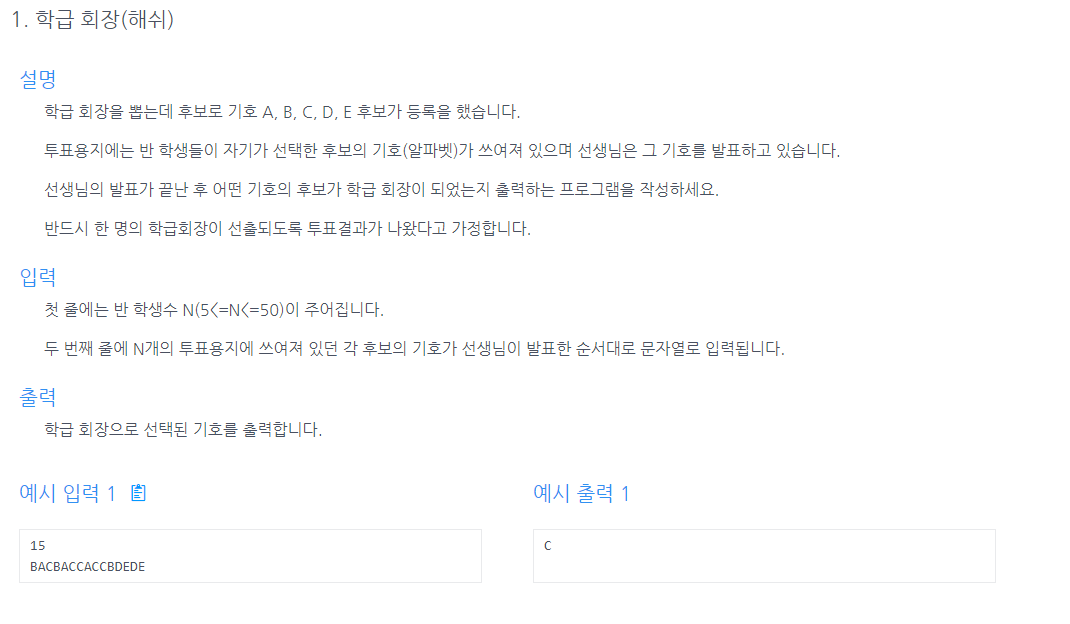
package HashMap그리고TreeSet4장.학급회장4다시1.my;
import java.util.ArrayList;
import java.util.HashMap;
import java.util.Scanner;
public class Main {
/**
* -내 풀이-
* 진짜 겁나 더럽게 풀었다...
* HashMap 에 각각 A, B, C, D, E 를 배열처럼 넣고
* 입력받은 문자열을 ArrayList 에 담아 해당 list 를 streamAPI 로 돌려서 equals 로 거르고 count 로 계산
*
* -선생님 풀이-
* 정말 간단하게 풀었는데 핵심은 HashMap 클래스의 getOrDefault 를 통해 카운팅을 했다.
* HashMap<Character, Integer> map = new HashMap<>();
* String str = "~";
* for (char c : str.toCharArray()) {
* map.put(c, map.getOrDefault(c, 0) + 1); // getOrDefault 는 있으면 가져오고 없으면 초기화하는 메서드
* }
*/
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
int num = kb.nextInt();
String input = kb.next();
System.out.println(solution(num, input));
}
private static String solution(int num, String input) {
String answer = "";
ArrayList<String> list = new ArrayList<>();
HashMap<Integer, String> map = new HashMap<>();
char[] arr = input.toCharArray();
long max = 0;
long[] result = new long[5];
map.put(0, "A");
map.put(1, "B");
map.put(2, "C");
map.put(3, "D");
map.put(4, "E");
for (char c : arr) {
list.add(Character.toString(c));
}
for (int i = 0; i < 5; i++) {
int find = i;
result[i] = list.stream().filter(x -> x.equals(map.get(find))).count();
if (max < result[i]) {
max = result[i];
answer = map.get(i);
}
}
return answer;
}
}
package HashMap그리고TreeSet4장.학급회장4다시1.teacher;
import java.util.HashMap;
import java.util.Scanner;
public class Main {
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
int n = kb.nextInt();
String str = kb.next();
System.out.println();
}
private static char solution(int n, String s) {
char answer = '\0';
HashMap<Character, Integer> map = new HashMap<>();
for (char x : s.toCharArray()) {
map.put(x, map.getOrDefault(x, 0) + 1);
}
int max = Integer.MIN_VALUE;
for (char key : map.keySet()) {
if (max < map.get(key)) {
answer = key;
}
}
return answer;
}
}
4-2. 아나그램
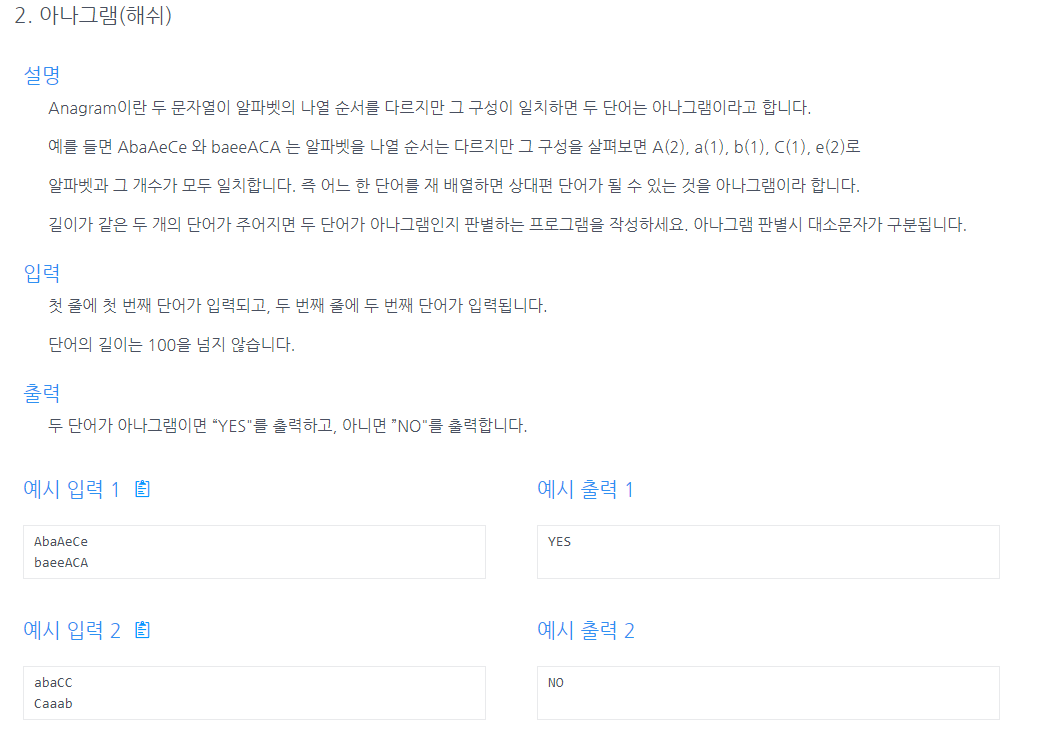
package HashMap그리고TreeSet4장.아나그램4다시2.my;
import java.util.HashMap;
import java.util.Scanner;
public class Main {
/**
* 피드백 X
*/
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
String input1 = kb.next();
String input2 = kb.next();
System.out.println(solution(input1, input2));
}
private static String solution(String input1, String input2) {
String answer = "NO";
HashMap<Character, Integer> map1 = new HashMap<>();
HashMap<Character, Integer> map2 = new HashMap<>();
for (char x : input1.toCharArray()) {
map1.put(x, map1.getOrDefault(x, 0) + 1);
}
for (char x : input2.toCharArray()) {
map2.put(x, map2.getOrDefault(x, 0) + 1);
}
if (map1.equals(map2)) {
answer = "YES";
}
return answer;
}
}
4-3. 매출액의 종류
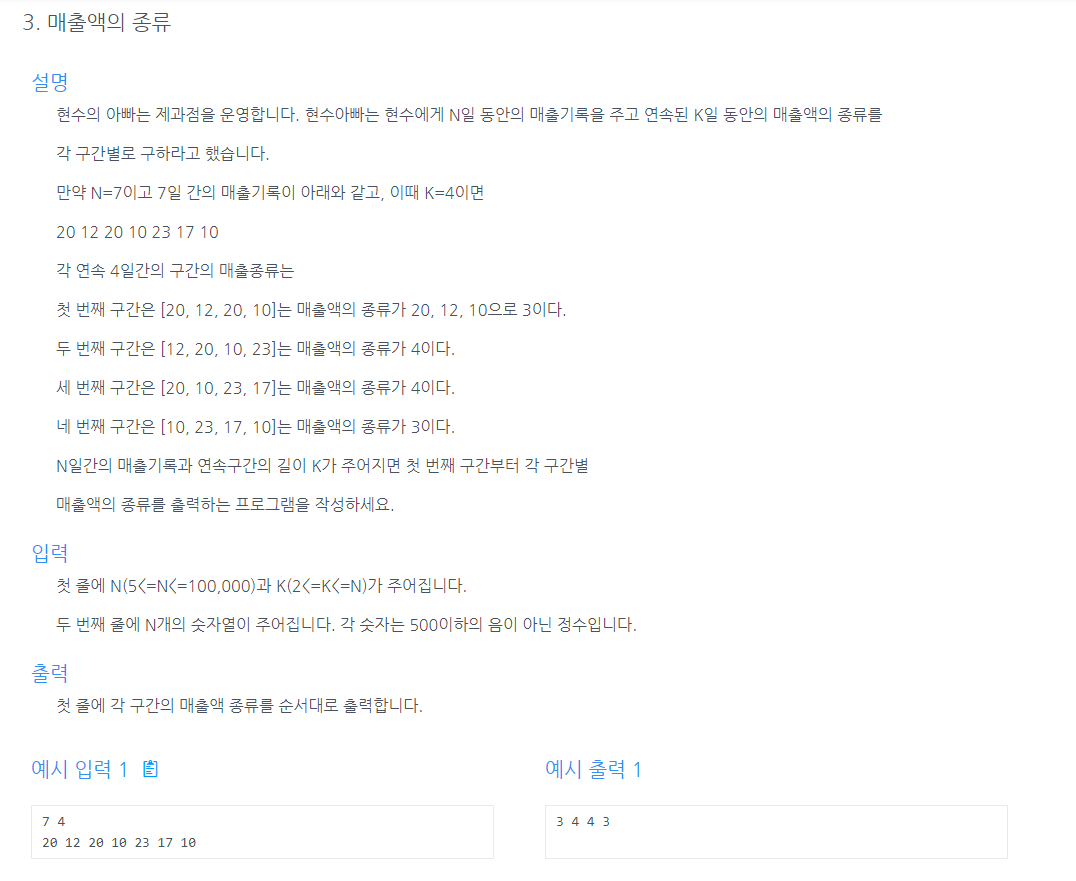
package HashMap그리고TreeSet4장.매출액의종류4다시3.my;
import java.util.ArrayList;
import java.util.HashMap;
import java.util.Scanner;
public class Main {
/**
* sliding window 와 HashMap 을 섞어서 사용했다.
* 피드백 X
*/
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
int date = kb.nextInt();
int length = kb.nextInt();
int[] arr = new int[date];
for (int i = 0; i < date; i++) {
arr[i] = kb.nextInt();
}
for (int x : solution(date, length, arr)) {
System.out.print(x + " ");
}
}
private static ArrayList<Integer> solution(int date, int length, int[] arr) {
// String answer = "";
ArrayList<Integer> answer = new ArrayList<>();
int start = 0, end = length;
HashMap<Integer, Integer> map = new HashMap<>();
for (int i = 0; i < end; i++) {
map.put(arr[i], map.getOrDefault(arr[i], 0) + 1);
}
answer.add(map.size());
while (end < date) {
map.put(arr[end], map.getOrDefault(arr[end], 0) + 1);
end++;
map.put(arr[start], map.get(arr[start]) - 1);
if (map.get(arr[start]) == 0) {
map.remove(arr[start]);
}
start++;
answer.add(map.size());
}
return answer;
}
}
4-4. 모든 아나그램 찾기
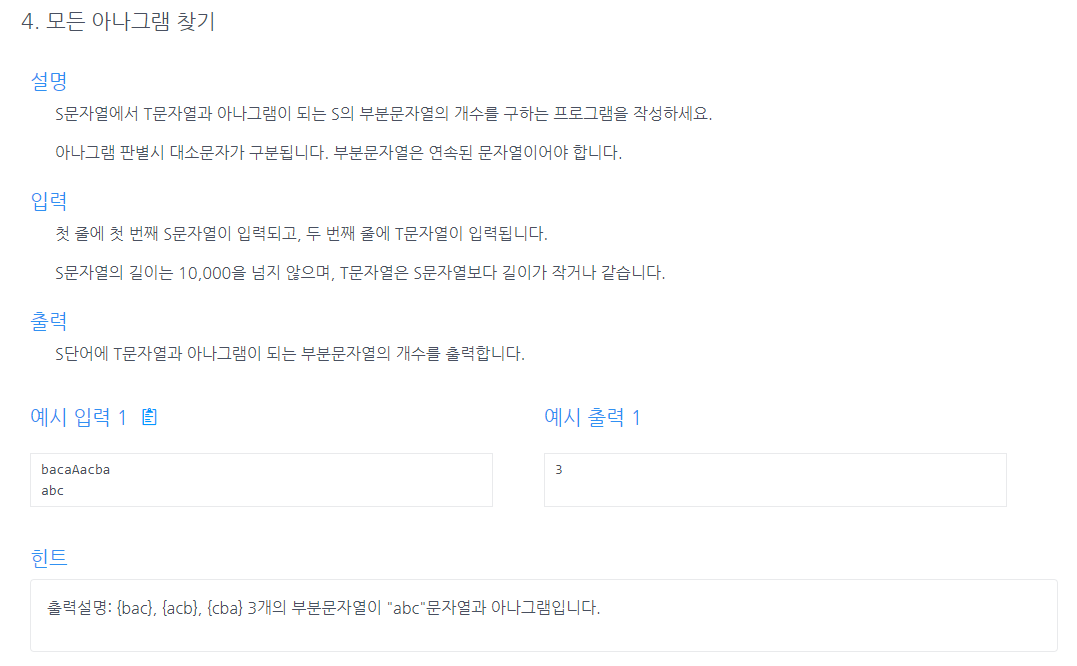
package HashMap그리고TreeSet4장.모든아나그램찾기4다시4.my;
import java.util.HashMap;
import java.util.Scanner;
public class Main {
/**
* 피드백 할 것 없음 이전 문제와 완벽히 동일
*/
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
String input1 = kb.next();
String input2 = kb.next();
System.out.println(solution(input1, input2));
}
private static int solution(String input1, String input2) {
int answer = 0;
int start= 0, end = input2.length();
HashMap<Character, Integer> map1 = new HashMap<>();
HashMap<Character, Integer> map2 = new HashMap<>();
char[] input1Array = input1.toCharArray();
char[] input2Array = input2.toCharArray();
for (int i = 0; i < input2.length(); i++) {
map1.put(input1Array[i], map1.getOrDefault(input1Array[i], 0) + 1);
}
for (char c : input2Array) {
map2.put(c, map2.getOrDefault(c, 0) + 1);
}
if (map1.equals(map2)) {
answer++;
}
while (end < input1.length()) {
map1.put(input1Array[end], map1.getOrDefault(input1Array[end], 0) + 1);
end++;
map1.put(input1Array[start], map1.get(input1Array[start]) - 1);
if (map1.get(input1Array[start]) == 0) {
map1.remove(input1Array[start]);
}
start++;
if (map1.equals(map2)) {
answer++;
}
}
return answer;
}
}
4-5. K번째로 큰 수
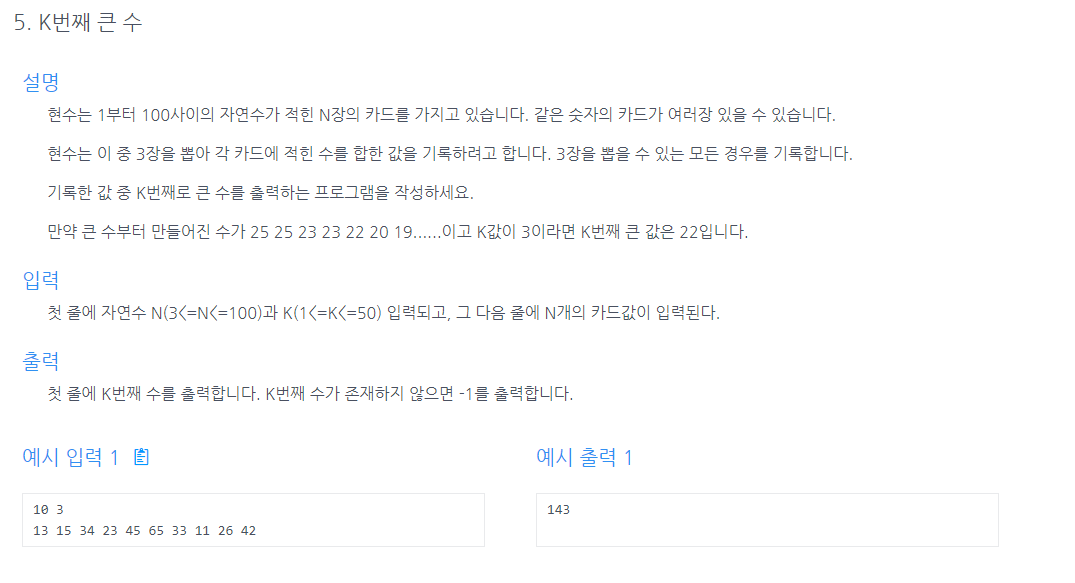
package HashMap그리고TreeSet4장.K번째로큰수4다시5.my;
import java.util.*;
import java.util.stream.Collectors;
public class Main {
/**
* Set 자료구조를 사용하면 간단하게 풀리는 문제
* Set 은 중복을 허용하지 않는다. 거기다 오름차순 내림차순으로 정렬하고싶다면 TreeSet 을 사용하면 된다.
* TreeSet 은 선언하고 입력받는 것들을 정렬해준다.
* 비슷한 것으로 TreeMap 이 있다.
*
* 자세한 내용은 선생님의 풀이 참고고
*/
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
int n = kb.nextInt();
int k = kb.nextInt();
int[] arr = new int[n];
for (int i = 0; i < n; i++) {
arr[i] = kb.nextInt();
}
System.out.println(solution(n, k, arr));
}
private static int solution(int n, int k, int[] arr) {
int answer = 0;
HashSet<Integer> set = new HashSet<>();
for (int i = 0; i < n; i++) {
for (int j = 0; j < n; j++) {
for (int l = 0; l < n; l++) {
int sum = 0;
if (i != j && j != l && i != l) {
sum += arr[i] + arr[j] + arr[l];
set.add(sum);
}
}
}
}
for (Integer integer : set) {
System.out.print(integer + " ");
}
return answer;
}
}
package HashMap그리고TreeSet4장.K번째로큰수4다시5.teacher;
import java.util.Collections;
import java.util.Scanner;
import java.util.TreeSet;
public class Main {
public static void main(String[] args) {
Scanner kb = new Scanner(System.in);
int n = kb.nextInt();
int k = kb.nextInt();
int[] arr = new int[n];
for (int i = 0; i < n; i++) {
arr[i] = kb.nextInt();
}
System.out.println(solution(arr, n, k));
}
private static int solution(int[] arr, int n, int k) {
int answer = -1;
TreeSet<Integer> treeSet = new TreeSet<>(Collections.reverseOrder());
// 기본적으로 TreeSet 을 만들면 오름차순 Collections.reverseOrder() 메서드를 이용하면 내림차순으로 정렬
for (int i = 0; i < n; i++) {
for (int j = i + 1; j < n; j++) {
for (int l = j + 1; l < n; l++) {
treeSet.add(arr[i] + arr[j] + arr[l]);
}
}
}
int cnt = 0;
treeSet.remove(143); // 해당 값 지우기
System.out.println(treeSet.size()); // 키가 몇개 있는지
treeSet.first(); // 가장 첫번째 값
treeSet.last(); // 가장 마지막 값
for (int x : treeSet) {
System.out.println(x);
cnt++;
if (cnt == k) {
return x;
}
}
return answer;
}
}
4장 주요개념 및 복습
주요 개념은 HashMap으로 HashMap에 관련된 내용은 해당 포스팅 참조
https://coding-review.tistory.com/277
전체적인 문제들은 HashMap을 적절히 사용하면 되는 문제였다. 마지막 문제는 Set을 사용하는 문제도 나오지만 Set은 추후 다룰예정
간단하게 설명하자면 Set은 중복을 허용하지 않는 (중복을 제거하는) 자료구조로 많이 사용한다. 그 중 TreeSet은 정렬이 포함된 자료구조
개인적으로 생각하는 주요 개념은 개수를 카운팅하는 문법인 getOrDefault와 Set 자료구조이다.
1. getOrDefault 메서드
HashMap<Character, Integer> map = new HashMap<>();
String str = "~";
for (char x : str.toCharArray()) {
map.put(x, map.getOrDefault(c, 0) + 1);
}
2. Set 자료구조 (이번 4장에선 TreeSet)
TreeSet<Integer> treeSet = new TreeSet<>(); // 오름차순 정렬
TreeSet<Integer> treeSet = new TreeSet<>(Collections.reverseOrder()); // 내림차순 정렬
리액트 useReducer
최근 회사에서 리액트를 사용하면서 공부를 해야겠다고 생각이 들었습니다. 리액트의 생명주기나 useState, useEffect, useRef 같은 기본적인 hook은 자세히 공부하지 않고 감으로도 충분히 알겠더라구요.
하지만 회사 서비스에서 사용중인 코드 중에 useReducer라는 hook이 있었는데 이놈을 공부해보았습니다.
useReducer
useReducer는 useState를 대체하는 hook으로서 state, dispatch, reducer, initialize 이렇게 네가지로 이루어져있습니다.
기본적인 구조는 이렇게 생겼습니다.
const [state, dispatch] = useReducer(reducer, initialize);
ex)
const [number, sendValue] = useReducer(setNumber, initNumber);
state는 useState에서 사용하던 상태값입니다. 그리고 reducer가 useState에서 자주 사용하던 set~ 에 해당하는 함수입니다. 이 함수를 이용해서 상태값을 변경해줄 수 있습니다.
그리고 dispatch는 reducer로 값을 전달해주는 용도로 사용되는 것 같습니다. dispatch가 호출되면 reducer가 호출되는 것 같은데 자세한건 잘 모르겠네요. 마지막으로 initialize는 state의 초기값을 설정해주는 것이죠.
그럼 이제 사용법에 대해서 알아보도록 하겠습니다.
import React, { useReducer } from 'react';
const initialState = { count: 0 };
function reducer(state, action) {
switch (action.type) {
case 'increment':
return { count: state.count + 1 };
case 'decrement':
return { count: state.count - 1 };
default:
throw new Error();
}
}
function Counter() {
const [state, dispatch] = useReducer(reducer, initialState);
return (
<div>
<p>{state.count}</p>
<button onClick={() => dispatch({ type: 'increment' })}>Increment</button>
<button onClick={() => dispatch({ type: 'decrement' })}>Decrement</button>
</div>
);
}
우선 initialState로 초기에 state의 포맷을 결정합니다. 그리고 버튼을 클릭할 때마다 dispatch로 reducer에 데이터를 전달합니다. reducer는 두개의 인자를 받도록 되어있는데 첫번째는 state이고 두번째는 dispatch로 넘어오는 데이터값입니다.
보통 action이라고 많이 사용하는 듯 합니다.
위의 예시는 onClick 이벤트로 dispatch를 호출하고 그에따른 값을 세팅해주는 코드입니다.
그런데 이런 예시로는 조금 부족하더군요. 왜냐하면 이정도 예시는 useState를 사용하는 것이 더 깔끔하고 간단하기 때문입니다.
상태의 초기값 세팅해주고, dispatch에 reducer까지 세팅해줘야해서 보일러플레이트가 너무 높습니다.
useReducer는 useState보다 더 유연하게 상태를 관리할 수 있다는 것이 장점입니다. 이러한 장점을 극대화할 수 있는 예제를 만들어봤습니다.
import {useReducer} from 'react'
function Input() {
const SET_FIELD_VALUE = 'SET_FIELD_VALUE';
const SET_ERRORS = 'SET_ERRORS';
const SET_INITIALIZE = 'SET_INITIALIZE';
const initialValue = {
name: '',
password: '',
email: '',
errors: {}
}
function reducer(state, action) {
switch (action.type) {
case SET_FIELD_VALUE:
return {
...state,
[action.field]: action.value
};
case SET_ERRORS:
return {
...state,
errors: action.errors
};
case SET_INITIALIZE:
return initialValue;
default:
throw new Error('Unknown Action Type');
}
}
const [state, dispatch] = useReducer(reducer, initialValue);
const handleChange = (e) => {
dispatch({type: SET_FIELD_VALUE, field: e.target.name, value: e.target.value});
}
const handleSubmit = (e) => {
e.preventDefault();
const errors = validateForm(state);
if (Object.keys(errors).length > 0) {
dispatch({type: SET_ERRORS, errors});
}
else {
console.log('Form submit successfully');
dispatch({type: SET_INITIALIZE});
}
}
const validateForm = (state) => {
const errors = {};
if (!state.name) errors.name = 'Name is required';
if (!state.email) errors.email = 'Email is required';
if (!state.password) errors.password = 'Password is required';
return errors;
}
return (
<form onSubmit={handleSubmit}>
<div>
<label>Name : </label><input type='text' name='name' value={state.name} onChange={handleChange}/>
</div>
{state.errors.name && <p>{state.errors.name}</p>}
<div>
<label>Password : </label><input type='password' name='password' value={state.password} onChange={handleChange}/>
</div>
{state.errors.password && <p>{state.errors.password}</p>}
<div>
<label>Email : </label><input type='text' name='email' value={state.email} onChange={handleChange}/>
</div>
{state.errors.email && <p>{state.errors.email}</p>}
<input type='submit' value='전송'/>
</form>
)
}
export default Input;
이 예제는 흔히 회원가입에서 사용할 수 있는 예제입니다. 이름, 패스워드, 이메일을 입력받고 해당 값이 비어있는 경우 메세지를 띄워주는 예제이죠.
흐름도는 아래와 같습니다.
• 사용자가 input 태그에 값을 입력한다.
• onChange 이벤트로 dispatch를 이용해 input 태그의 name, value를 넘겨주고 type을 설정해 넘겨줍니다.
• reducer가 호출되고 dispatch에서 넘어온 데이터를 기반으로 state를 세팅해줍니다.
• 사용자가 submit 버튼을 누르면 onSubmit 이벤트가 발생합니다.
• onSubmit 이벤트의 콜백 함수인 handleSubmit이 현재 input태그의 값을 검증합니다.
• 이 과정에서 검증에 실패하면 SET_ERROR type의 dispatch를 보내 다시 reducer를 호출하고 에러 타입과 메세지를 설정합니다. 성공하면 SET_INITIALIZE를 호출하여 모든 상태값을 초기화해줍니다.
마치며
이렇게 useReducer를 이용해서 회원가입 예제를 만들어봤습니다. 사실 useReducer의 상태관리는 useState에 비해 보일러플레이트가 높습니다.
하지만, 조금 더 객체지향적이라고 생각이 드네요. 원래 객체지향이라는 것이 보일러플레이트가 높습니다. 스프링만하더라도 객체지향을 위해 생성해야하는 클래스가 정말 많고 사용해야하는 기능도 정말 많습니다.
프론트보다 백을 더 많이 공부한 제 눈엔 조금 더 보기 편하고 이해하기 쉬웠습니다. 하지만 useReducer가 어느 부분에서 useState에 비해 유연한 상태관리를 할 수 있는지는 아직 감이 잘 안잡혔습니다.
dispatch로 다양한 값을 전달할 수 있고 이를 기반으로 상황을 분리하고 각각에 상황에 맞는 상태를 관리하는 부분이 유연하다고 하는건가 아리송합니다.
보통 백엔드에서 유연하다는 말을 잘 사용하지 않아서 그런가 싶기도 합니다. 해봐야 NoSQL이 RDBMS보다 제약조건이 적어 유연하다 이정도는 들어봤지만말이죠. 백엔드에선 가용성, 확장성같은 말을 더 많이 써서 아직 잘 와닿지않네요.
아무튼 오늘은 리액트의 useReducer를 배워보고 정리하고 공유해봤습니다. 오늘 공부하면서 많은 것을 배운 것 같습니다. 다양한 자바스크립트 문법이나 리액트 문법을 익히는데 아주 유익한 시간이었습니다.
긴 글 읽어주셔서 감사합니다. 오늘도 즐거운 하루 되세요~
리액트 전역 상태 관리 (redux, recoil)
이번 포스팅에선 리액트의 전역 상태 관리 라이브러리 redux와 recoil에 대해서 알아보도록 하겠습니다.
사용방법은 구글링하면 엄청많이 나오더라구요. 사용법은 이번 포스팅에선 다루지 않도록 하겠습니다. 이번 포스팅에선 hello world 수준으로 redux와 recoil을 써보고 느낀점 그리고 둘의 차이점에 대해서 다뤄보도록 하겠습니다.
Redux
첫인상
redux는 리액트 훅중에 useReducer와 굉장히 유사하더군요. 아니 유사한게 아니고 완전 빼다박았습니다. redux를 조금 경량화한게 useReducer라는 느낌이 들었습니다.
접근성
redux는 보일러플레이트가 굉장히 높았습니다. 설정해줘야하는게 굉장히 많았고 hello world 수준의 예제도 시작하는데 한참이 걸렸습니다.
특징
하지만 장점은 굉장히 객체지향적이라는것... 제가 만든 예제는 hello world 수준이지만 이렇게 객체지향의 냄새가 짙은 것들은 보통 큰 애플리케이션에서 잘 어울리죠. 이 얘기는 뒤에서 recoil과 차이에대해서 정리할 때 다시 언급하도록 하겠습니다.
또한, 객체지향적이라서 그런지 어디서든 내가 저장한 전역 상태값을 불러올 수 있었습니다. 근데 이건 redux의 구조때문에 그런 것 같더라구요.
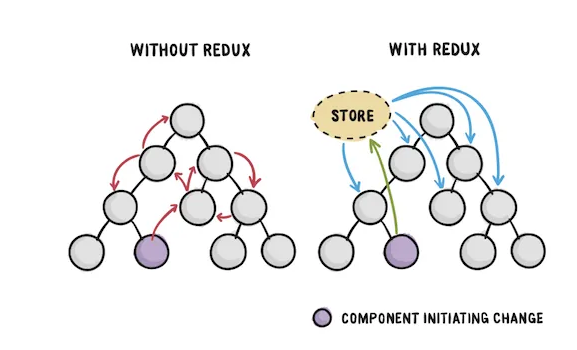
이렇게 컴포넌트와 상태 저장소를 분리함으로써 상태값을 쉽게 가져올 수 있었습니다. 그리고 진짜 전역적으로 상태를 관리한다는게 체감되는 아키텍처를 가지고 있는 것 같습니다.
Recoil
첫인상
recoil은 redux와 완전 반대되는 성격을 가지고 있습니다. 굉장히 사용하기 쉽고 무엇보다 리액트의 근본 훅중 하나인 useState와 사용법이 굉장히 유사했습니다.
접근성
보일러플레이트도 거의 없는 수준이었습니다. hello world 수준의 예제는 그냥 10분도 안되서 뚝딱 만들었습니다. 접근성이 굉장히 좋다는 것이 장점입니다.
특징
recoil의 특징은 사용법이 굉장히 간단하다는 특징이 있지만 리액트 개발팀인 facebook에서 만들었다는 것이 하나의 장점이 됩니다. 리액트 개발진이 만든만큼 리액트와 호환이 굉장히 좋다는 것이 특징이죠.
또한 redux는 전역적으로 상태를 관리하기 때문에 남발했다가는 쓸데없는 리랜더링이 일어나 성능 저하를 일으킬 수 있습니다. 하지만 recoil은 지역적으로 상태를 관리하기 때문에 조금 남발하더라도 성능에 큰 영향은 없다고 하더군요.
그 외
기존 리액트로 개발하던 회사들은 redux를 이용해서 상태 관리를 많이 했다고 하더라구요. 제가 프론트엔드 개발자 공고는 많이 안봤지만 대부분 redux로 상태를 관리하는 것 같았습니다.
하지만 redux는 사용자 경험이 썩 좋은 라이브러리가 아니라고 그러더군요. 그래서 요즘 recoil로 많이 갈아타는 추세라고합니다.
하지만 그렇다고 하더라도 redux는 대형 엔터프라이즈급 회사에서 많이 사용할 것 같습니다. 그 이유는 redux에서는 saga패턴을 지원하는 또다른 라이브러리가 있다고 하더라구요? 이건 굉장히 놀랐습니다.
Saga 패턴이란?
짧게 짚고 넘어가자면 Saga 패턴은 백엔드에서 트랜잭션을 관리할 때 등장하던 단어입니다. 보통 마이크로서비스를 운영하는 애플리케이션에서 중요하게 생각하는 것이 서로 물리적으로 떨어져있는 서버들간 인증을 관리하는 것과 트랜잭션을 관리하는 것입니다.
서로 물리적으로 떨어진 서버들간 데이터베이스 연산 중 안정적인 롤백을 위한 방법론이라는 것이죠. 이것에 대한 자세한 내용은 아래의 링크에 잘 설명해뒀습니다.
https://coding-review.tistory.com/484
다시 본론으로 돌아와서 리액트에서 상태를 전역적으로 관리하고 전파하는 과정에서 네트워크 오류라던가 모종의 버그로 상태가 반영되지 않았을 때 다시 재실행하여 상태를 전달한다던가 상태를 롤백한다던가 이런 일련의 과정들을 지원하는 라이브러리가 있다고 하더라구요.
굉장히 흥미로웠습니다. GPT에게 물어보니 recoil은 이런 상황에서 Saga패턴처럼 롤백하거나 재실행하는 방법은 없다고 하는데 이를 useEffect를 이용해 국지적으로 적용할 수는 있다고 하더군요.
하지만, 이런 이유 때문에 redux는 크기가 큰 애플리케이션에서 잘 사용할 것 같습니다.
마치며
요즘 프론트엔드를 공부하면서 왜 프론트엔드의 기술들이 생명주기가 짧은지 간접적으로 경험할 수 있게 되었습니다. 리액트가 등장하고 전역 상태 관리를 redux로 한게 얼마 안됐는데 그새 recoil로 넘어간다 만다 소리가 나올 정도니 말 다했습니다.
개발자는 평생 공부해야한다고 말하는게 프론트엔드와 백엔드가 조금 다른 의미로 적용되는 것 같습니다.
프론트엔드는 항상 새로운 기술을 공부해야해서 끊임없이 공부해야하고 백엔드는 공부할게 너무 많아서 끊임없이 공부해야하는 것 같네요.
이번 포스팅에선 리액트에서 전역적으로 상태를 관리하는 라이브러리인 redux와 recoil를 사용해보고 첫인상, 특징들, 그외 특징들에 대해서 알아봤습니다.
긴 글 읽어주셔서 감사합니다. 오늘도 즐거운 하루 되세요~
컴포넌트 생명주기 (부제 : useEffect의 맹점)
회사에서 리액트를 사용해서 어쩔 수 없이 리액트를 공부해야하는데 나름 재미는 있습니다. 근데 좀 그지같은 부분이 있더군요... 이번엔 포스팅에선 컴포넌트의 생명주기와 렌더링에 따른 useEffect의 호출 순서 그로인해 벌어지는 useEffect의 맹점에 대해서 알아보려고합니다.
그지같은 리액트...
제가 원한건 useEffect에서 API를 호출하고 state에 저장한 뒤 state에 저장된 값을 HTML에 써먹고싶었습니다.
기대했던 순서는 다음과 같습니다.
• 리액트가 useEffect를 호출한다.
• API가 호출된다.
• 값이 가져와지고 그 값을 state에 저장한다.
• 렌더링이 될 때 state 값을 사용한다.
근데 이 그지같은 리액트는 제가 원하는대로 움직여주지 않더군요.
• 렌더링이 되고 state값으로 HTML값을 세팅한다(?). useEffect가 호출되기 전이기 때문에 state엔 아무것도 없고 undefined가 찍힙니다.
• useEffect를 호출한다.
• API가 호출된다.
• 값이 가져와지고 그 값을 state에 저장한다.
이와 관련해서 좀 찾아보니 공식문서에 이렇게 나와있더군요.
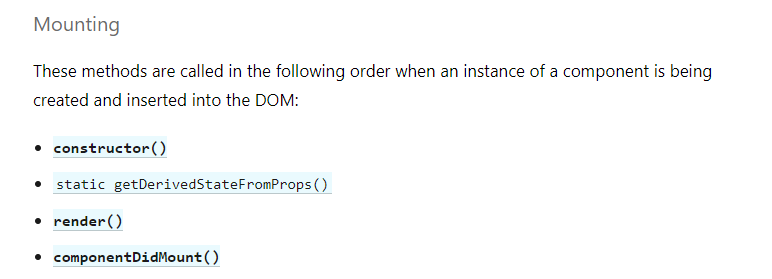
useEffect는 componentDidMount()와 componentDidUpdate(), componentWillUnmount() 이렇게 세가지를 동시에 수행해주기 때문에 우리가 집중적으로 봐야하는 것은 HTML에 적은 우리의 상태값들을 마운트해주는 componentDidMount입니다.
그런데 공식문서에서 어머 세상에 render()가 호출되고 componentDidMount()가 호출되네요?
이거때문에 회사에서는 ref를 이용해서 값을 콱하고 박아주라고 하더군요.
const [item, _setItem] = useState();
const itemInput = useRef();
const 콱박아주기 = (value) => {
_setItem(value);
itemInput.current.value(value);
}
뭐 대충 이런식으로 쓰라고 하던데 도저히 상식적인 행동이라고 보여지지 않아서 퇴근하고 집에와서 좀 찾아봤습니다.
좀 찾아보니 이렇게 사용하면 되더군요.
const [item, setItem] = useState();
useEffect(() => {
const response = axios.get('/test');
const data = response.data;
setItem(data);
}, [])
return (
<div>
{item && (
<input type="text" name="item" value={item}/>
)}
</div>
)
이렇게 하면 처음엔 input 태그가 등장하지 않지만 item의 상태가 바뀐 것을 리액트가 인지하고 해당 부분을 리렌더링 해주는 것입니다.
뒤로 구르면서 봐도 맨처음 방법보단 훨씬 나은 것 같습니다.
그런데 이렇게 하면 문제가 있더군요. 바로 useRef()를 사용할 수 없다는 것입니다.
그 이유는 아래와 같은 순서로 리액트가 useRef()를 마운트해주기 때문입니다.
• 렌더링 (이땐 input 태그가 렌더링 안됨). 이때 useRef() 마운트
• useEffect 호출
• API가져와서 setItem으로 상태변경
• 어? 상태 변경됐네? <input> 태그 리렌더링
이 상태에서 맨 처음 렌더링될 때 useRef()로 레퍼런스를 가져오는데 그에 상응하는 input태그가 없으니 undefined가 뜨고 이 ref에 접근해서 값을 바꿔주려고하면 에러가 뜹니다.
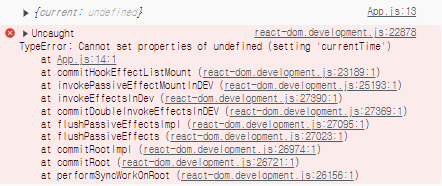
저는 video태그를 이용해서 currentTime을 바꿔주려고 했던건데 current에 undefined가 뜨면서 세팅을 해줄 수 없었습니다.
그래서 저는 꼼수를 부려서 이 태그를 컴포넌트로 따로 분리해서 컴포넌트에서 ref를 사용했습니다. 이렇게 사용하면 되긴 되더군요...
import axios from 'axios'
import {useEffect, useRef, useState} from 'react'
import Video from './Video';
function App() {
const [item, setItem] = useState('');
const fetchData = async () => {
const response = await axios.get('/item/test', {headers: {"Content-Type": "application/json"}});
const data = response.data;
setItem(data);
}
useEffect(() => {
fetchData();
}, [])
return (
<div className="App">
{item && (
<Video startTime={30} fileName={item.fullVideo.screenVideo[0].fileName}/>
)}
</div>
);
}
export default App;
import { useRef, useEffect } from "react";
function Video(props) {
const video = useRef();
const {startTime, fileName} = props;
useEffect(() => {
video.current.currentTime = startTime;
}, [startTime])
return (
<video controls autoPlay ref={video} type='video/mp4'>
<source src={'/record/'+fileName}></source>
</video>
)
}
export default Video;
이게 정석인지는 모르겠습니다... 그냥 제 머리속에서 떠오른거라 확실하진 않습니다.
에러 없이 잘 되네요. 제가 원하는대로 30초로 이동도 잘 됐습니다.
마치며
오늘은 그지같은 리액트를 한껏 저주하며 마무리지어보도록 하겠습니다. 프론트는 백이랑 다르게 센스가 좀 필요한 것 같습니다. 근데 저는 그게 부족한 것 같네요...
그래도 실무에서 부딪히면서 해야만하는 환경에 저를 던져놓으니까 확실히 빠르게 실력이 늘어나는 기분이 들긴 합니다. 그지같은건 어쩔 수 없겠네요.
긴 글 읽어주셔서 감사합니다. 오늘도 즐거운 하루 되세요~
출처
https://legacy.reactjs.org/docs/react-component.html#the-component-lifecycle
첫 회고, 개발 공부 2년만에 뒤를 돌아보다.
회고를 일기에 쓰려고 하려다 회고는 아무래도 시간이 좀 지나고 적는 일기이다 보니 큰 일기(?) 느낌으로 회고 카테고리를 만들었습니다.
첫 회고는 앞만보고 미친듯이 달린 개발 공부 2주년을 기념하여 처음으로 뒤를 돌아봤습니다.
회고를 작성하면서 가장 마음에 들었던 점은 제가 문서화를 잘해놔서 연도와 날짜를 정확하게 알 수 있었다는 점입니다. 연도 별로 어떤 일이 있었는지 큼지막하게 적어보도록 하겠습니다.
2021년 6월 20일 개발 공부를 시작하다.
처음으로 개발공부라는걸 해봤습니다. 2021년 상반기에 했던 프로젝트가 자바 기반 프로젝트였기 때문에 자바를 중점적으로 공부해보고 싶었습니다. 굳이 자바였던 이유는 자바가 취직이 잘된다고 하길래...
첫 공부는 jsp 였는데 그 때 당시 남겨놨던 문서를 보면 아주 귀엽습니다. 처음 공부했을 땐 재밌지도 어렵지도 않았던 것 같네요.
2021년 7월 26일 천일 기념 홈페이지를 만들다.
여자친구와 천일이 된 것을 기념하여 jsp로 포토페이지를 만들었습니다. 개발 인생 첫 배포였는데 막히는게 정말 많아서 고생을 많이했던 기억이 있네요.
2021년 9월 10일 선물이 잘 전달되었고 여자친구가 정말 기뻐하던게 아직도 눈에 선합니다. 여러분도 개발 좋아하신다면 둘만의 포토 페이지 만드는게 어떨까요?
2021년 8월 9일 스프링 강의를 듣다.
이 날 영한님을 처음 봤습니다. 영한님의 화려한 강의 솜씨에 넋을 놓고 봤던 기억이 있습니다. 맨 처음엔 백기선님 강의를 들었었는데 저랑은 잘 안맞더군요.
지금은 완전히 영한님 팬이 됐습니다. 때문에 영한님이 오래 몸담고 계셨던 배달의 민족에 들어가는 것이 제 목표가 되었지요. 강의를 듣고 정말 많은 성장을 이뤄냈습니다. 영한님께 이자리를 빌어 정말 감사하다는 말 전하고싶습니다.
2021년 9월 29일 슬럼프에 빠지다.
이 때 당시 제 공부 방법은 강의 하나 듣고 토이 프로젝트, 강의 하나 듣고 토이 프로젝트를 반복했습니다. 토이 프로젝트라고 대단한건 아니고 CRUD만으로 간단한 프로젝트 만들어보는 것이었죠.
하지만 토이프로젝트를 계속 만들다보니 현타가 왔는데 '나는 CRUD말고 할 줄 아는게 아무것도 없네...' 와 같은 생각에 빠졌습니다.
지금와서 되돌아보면 공부를 3개월밖에 안했는데 이런 생각이 든다는 것 자체가 오만이었지만 당시에는 이것 때문에 정말 힘들었습니다. 새벽에 공부하다 말고 가족들 몰래 나가 동네를 한바퀴 돌면서 앞으로 어떤 공부를 해야할지 고민했던 아련한 기억이 있습니다.
2021년 11월 19일 아버지의 사업을 도와주다.
아버지가 은퇴하시고 심심하셨는지 사업을 하시겠다고 하셨습니다. 물론 저희 아버지 특성상 위험한건 절대 안하시기 때문에 안전한 사업을 하시더군요.
사업을 하시는데 홈페이지가 필요하다고 저한테 조용히 오셨습니다. 저는 도전해보겠다고 하고 무모한 도전을 시작했지요.
그 때 아버지가 원했던 기능은 파일 업로드, 파일 다운로드, 이미지 업로드였습니다. 이 때 당시엔 개발 공부한지 얼마 안돼서 겁먹었는데 사람은 몰아붙이면 초인적인 힘을 낸다고 했던가요 결과적으로 훌륭한 사이트가 탄생했습니다.
아버지가 수고비를 주겠다고 하셔서 보통 사이트 하나 만들면 얼마나하나 검색해보니 깡통이 150만원에 기능 몇개 들어가면 200만원을 부르더군요... 아버지한테 그런 돈은 받을 수 없었어서 호스팅비 + 도메인비 + 인증서 합쳐서 7만원에 수고비 10만원만 달라고 했더니 너무 적은거 아니냐며 30만원을 주셨습니다. 이 돈으로 여자친구와 맛있는거 사먹었습니다.
2022년 3월 2일 온라인 쇼핑몰 ver.1 개발을 시작하다.
지금 제 이력서의 밥줄인 온라인 쇼핑몰 ver.1을 3월 2일 개발하게 되었습니다. 처음 취지는 캡스톤 주제로서 프로젝트를 진행하였는데 토이 프로젝트만 만들다가 큰 프로젝트를 만들려고 하니 그리 쉽지만은 않았습니다.
처음 도전하는 기능도 있었고 (결제라던가, 장바구니 같은..) 이미 도전해본 기능도 있었고 개발하면서 정말 재밌었습니다.
2022년 6월 21일 온라인 쇼핑몰 ver.1의 개발이 종료되다.
저희 학교는 캡스톤을 교수님마다 나눠서 학생들을 지도하시는데 당시 인원이 12명? 13명? 정도 있었는데 그 중 10퍼센트(1명)가 A+ 였고 당당히 1등을 차지했습니다! (와아아아)
꽤 큰 프로젝트였고 혼자서 큰 프로젝트를 마무리 했다는 자신감이 있었습니다. 공교롭게도 이날이 딱 개발 공부한지 1년이 되던 날이었네요.
이 때를 회상해보면 국비학원에서 1년도 안되는 시간에 학생들을 네카라쿠배에 취직시킨다는 말은 정말 말도안되는 헛소리라는 것을 알 수 있었습니다.
이 때 당시 저는 스프링 조금 + 프로젝트 하나 이렇게 가지고 있었으니 정말 볼품없었죠. 이런데 1년만에 네카라쿠배를 간다? 지금 와서 생각해보면 말도안되는 얘기이죠.
2022년 8월 21일 스프링 배치를 공부하다.
처음 공부하게 된 계기는 휴면 회원을 어떻게 처리하는지 구글링 해보다가 알게 되었습니다. 그리고 배치의 매력에 빠져 인프런에서 강의도 사서 열심히 공부했습니다. 지금은 거의 까먹었지만요...
이 때 공부한 스프링 배치로 스터디 자동 관리 사이트도 만들어서 다음 캡스톤도 A+를 받게 되었습니다. 여러모로 재밌는 경험이었습니다.
2022년 11월 19일 면접 준비를 시작하다.
이 때 당시 다음 연도에 취직을 결심했기 때문에 면접 준비를 시작했습니다. 처음 면접 준비를 하려고 깃허브 면접준비 리포지토리에 들어갔는데 120개의 면접 질문에서 대답할 수 있는 질문이 하나도 없더군요...
정말 공부 허투로 했다고 느꼈습니다. 그러면서 한편으로는 지금이라도 이런 사이트를 발견한게 어디냐며 하루에 하나씩 면접 질문과 꼬리 질문을 외우고 구글링하며 공부하고 했습니다.
10개 정도 외우고 나서 드디어 제대로 된 공부하는 느낌이 나서 기쁜 마음에 일기를 쓰던 제가 생각나네요.
2023년 2월 18일 영어 문서를 읽기 시작하다.
개발 인생에서 다시 한번 점프업 하게 되는 계기였습니다. 영어 문서를 이 때 처음 읽은 건 아니었지만 본격적으로 읽기 시작하게 되었고 이제 한글로 구글링하는 것보다 영어로 구글링 하는게 더 알차게 느꼈던 시기입니다.
트랜잭션에 대해서 영어로 구글링 해보니 한글로 구글링 했을 때 나오지 않았던 변태같은 심연의 것들이 쏟아져 나와서 엄청나게 희열을 느꼈던 기억이 있습니다.
한글로 구글링은 죄다 티스토리에 내용도 전부 똑같아서 ACID, 커밋, 롤백 이것들로만 2페이지가 채워져있더라구요. 영어로 구글링하니 로컬 트랜잭션이니 글로벌 트랜잭션이니 XA 아키텍처니 이런 내용들이 나와서 더이상 한글로 구글링을 하지 않게 되었습니다.
학창시절에 영어 공부를 그렇게 열심히 하지 않았던 저였지만 필요에 의해 재미에 의해 공부하니 영어 실력이 정말 급격하게 늘어났습니다. 지금도 챗 지피티와 영어로 대화하고 있는 제 모습이 신기할 따름입니다 ㅎㅎ.
2023년 3월 21일 챗 지피티를 구매하다.
처음엔 영어 공부를 목적으로 챗 지피티를 구매했습니다. 그러다 어느날 개발하다 막힌 부분을 챗지피티한테 물어보니 기가막히게 대답하는 모습을 보고 그 때부터 챗 지피티를 개발 공부하는데 적극적으로 이용하기 시작했습니다.
이론적인 부분을 챗 지피티로 공부하기도 하고 평소에 궁금했던 부분을 물어보기도 하고 정말 대단한 파트너임에 틀림없습니다.
여자친구는 데이터를 기반으로 경영을 하는 부서이다 보니 챗지피티를 추천해줘서 같이 잘 쓰고 있습니다.
2023년 5월 5일 면접 준비가 완료되다.
거의 6개월에 걸친 면접 준비가 완료되었습니다. 당시 100개가량의 면접 질문과 꼬리 질문에 대한 모든 답을 외워버려서 아는게 정말 많아지고 "드디어 준비가 완료되었다" 같은 만족감을 느낄 수 있었습니다.
이제 아는게 많아져서 어디 가서 전혀 꿀리지 않는 신입 개발자가 된 기분을 느꼈습니다.
2023년 5월 14일 온라인 쇼핑몰 ver.2 개발을 시작하다.
유튜브에서 어떤 개발자분께서 어떤 프로젝트를 해야할까요에 대한 답으로 "큰 프로젝트를 하나 만들어보시고 버전을 업그레이드 하면서 고도화 해보세요." 라는 답을 하셔서 나도 버전 업을 해볼까? 싶어서 시작한 프로젝트입니다.
우선 내 프로젝트의 문제를 파악하는게 첫번째 목표였고 꽤나 문제가 많았던터라 큰 문제없이 개선할 부분을 체크하고 개발에 돌입했습니다.
그러면서 '만약 이용자수가 1000만명이 된다면 어떤 문제가 생길까' 라는 컨셉을 정해서 왜 ver.2를 개발했는지에 대한 명분도 만들었죠. 물론 진짜 1000만명이면 지금 겪는 문제보다 더 큰 문제가 발생하겠지만 헬로월드 수준에서 간접적으로 느껴보기 위해 시작했습니다.
2023년 6월 14일 온라인 쇼핑몰 ver.2 개발을 종료함과 동시에 ver.3를 개발하다.
이 때는 꽤나 최근인데 당시를 회상해보면 정말 많은 기술을 경험해볼 수 있는 시기였던 것 같습니다. Redis 부터 시작해서 Elasticsearch, 비동기 통신, 동시성 문제, 스프링 시큐리티를 본격적으로 공부하고 JWT와 결합 등등 정말 만족스러운 프로젝트였습니다.
ver.2만 하더라도 든든한 밥줄이었는데 동시에 ver.3를 기획했습니다. 배포 과정에서 생기는 다양한 문제를 해결하자는 컨셉이었죠.
다른 사람들의 말을 통해 어떤 문제가 발생할 수 있는지 살펴보고 예방하는 것이 제 프로젝트의 목표였습니다.
2023년 7월 9일 온라인 쇼핑몰 ver.3 개발을 종료하다.
바로 엊그제! 온라인 쇼핑몰 ver.3를 종료했습니다. 배포 중에 벌어질 수 있는 다양한 문제를 해결하기 위해 노력했고 복잡한 배포 과정을 자동화 해주는 Jenkins 파이프라인 구축하고, 블루 / 그린 배포 도중 Hard Shutdown에 의한 문제를 해결하기 위해 Graceful Shutdown을 도입하고, JVM이 가지는 문제 중 하나인 배포 직후 발생할 수 있는 Latency를 대처하기 위해 ClassLoader Warmup / JIT compiler Warmup을 진행했습니다.
또한 배포를 위해 AWS 생태계를 그대로 채택하여 Route 53, ACM, ELB, EC2, ECR, S3에 걸친 AWS 생태계를 신입 수준에서 맛볼 수 있는 좋은 경험이었습니다.
점점 버전 업을 하면 할수록 실무에 가까워 지는 느낌을 받으면서 이제 나도 어디가서 내세울만한 프로젝트가 하나 나왔구나 싶은 뿌듯함이 동시에 있었습니다.
2023년 7월 11일 현재
개발 공부를 한지 2년이 된 저는 이제 당당히 취업의 문을 두드릴 수 있을 정도로 성장한 것 같습니다. 2년동안 공부하면서 강의 15개, 면접 질문 100개, 프로젝트 기획, 개발, 배포까지 완료하고 멋있는 프로젝트도 하나 가지고 있습니다.
맨 처음 프로젝트를 진행할 땐 막연하게 남들이 안하는 멋있는 프로젝트를 하고싶다 라는 마음이 있었습니다. 그 때 동경했던 프로젝트들은 공모전에서 상을 탄 프로젝트들이었습니다. "나도 저런 프로젝트 하고싶다" 라는 마음은 있었지만 괜히 민폐가 되지 않을까 혼자서 조용히 공부했네요.
지금 만약 그런 프로젝트를 같이 하자고하면 미련없이 괜찮다고 할 것 같네요. 저도 멋진 프로젝트를 하나 가지고 있으니까요. 제가 6개월동안 갈고 닦아서 멋지게 빛나고 있는 내 자식같은 프로젝트인데 어딜 내놔도 부끄럽지않죠.
2년동안 정말 많은 일들이 있었습니다 (위에 적은 것들도 줄이고 줄여서 액기스만 뽑은겁니다). 하나하나가 전부 소중한 경험이고 내 자산이 되어서 지금의 저를 만들어 낸 것 같습니다.
앞으로 취직까지 약 9개월정도 남았습니다. 저는 사정상 취직을 4월에 할 예정이라 앞으로도 많은 시간이 남아있네요. 지금은 프론트엔드를 공부하고 있습니다. 왜 프론트엔드 개발자들이 GraphQL이 좋다고 노래를 부르는지 알고 싶어서 공부하고 있는데 아마 이 9개월동안 열심히 프론트엔드를 공부하고 제 프로젝트 ver.4를 만들지 않을까 싶네요.
지금 저는 제 자신이 너무 마음에 들고 좋습니다. 앞으로 더 멋있는 개발자가 되기 위해서 최선을 다해 노력할 것입니다. 아마 다음 회고는 졸업 기념 대학생활을 되돌아보는 회고를 적지 않을까 싶네요. 대학 생활 얘기도 적을게 산더미처럼 많습니다.
아직은 때가 되지 않았으니 그때를 기약하며 이만 말 줄여보도록 하겠습니다. 긴 글 읽어주셔서 감사합니다. 오늘도 즐거운 하루 되세요~
AWS Certified Developer - Associate 자격증 취득 회고
이 자격증을 따느라 블로그 포스팅이 조금 뜸해졌습니다. 이번 포스팅에선 다시 시작한다는 마음으로 회고를 작성해보도록 하겠습니다.
AWS 자격증
AWS의 자격증은 위와같이 나누어져있습니다. 크게는 3단계로 나누어져있고 분야는 아키텍트, 운영, 개발자, 네트워킹, 빅데이터, 보안, 머신러닝, AI로 이루어져있습니다 ( 맨 오른쪽 아래 Alexa는 아마존의 AI입니다. ).
저는 개발자 트리를 타야할 것 같아서 Developer를 땄는데 아키텍트쪽이랑 운영쪽은 어떤 것을 시험 보는지 모르지만 Developer쪽은 다양한 것을 시험봅니다.
배포 (22%), 보안 (26%), AWS 서비스 (30%), 리팩터링 (10%), 모니터링 및 문제해결 (12%) 도합 100퍼센트 비율로 시험이 출제됩니다.
계기
이번 연도 여름 제 포트폴리오 중 가장 큰 비중을 차지하는 프로젝트가 끝났습니다. 이 포트폴리오가 현재 업계에서 통하는지 궁금해서 이력서를 여러군데 제출해봤습니다.
물론 회사마다마다 따로 자소서를 쓰진 않았습니다. 흔히 따발총 쏘듯이 여러군데 마구 집어넣었습니다.
지금 보면 이력서 ver.1이 형편없지만 이 형편없는 이력서를 제출했더니 서류 합격률이 60개의 원서중 3개만 붙는 기적을 보여줬습니다.
프로젝트는 별개로 글쓰는 솜씨가 부족하다고 느껴 현재는 ver.3까지 이력서를 작성했습니다. 그리고 이력서를 적다보니 밋밋한 것이 꽤 보기 싫었습니다.
'자격증이라도 하나 있으면 좋겠다...'
그것이 제가 자격증을 따게 된 계기입니다.
결심
자격증 중 개발자가 가장 많이 따는 것은 당연 정보처리기사입니다. 우리나라 업계에서도 (특히 SI에서) 정보처리기사를 높게 쳐준다는 통계가 있습니다.
하지만 현직자를 잡아다 물어보면 그리 쓸모있는 자격증은 아니라고들 대답합니다. 그래서 살짝 고민이 되었습니다. (지금도 고민중입니다)
제 인생을 돌아보면 남들이 다하는건 안했습니다. 어릴땐 유희왕 카드, 메이플 딱지부터 커서는 그 유명하다는 기생충과 오징어게임도 보지 않았습니다.
대신 마음이 시키는 것을 주로하고 하나에 빠지면 다른건 쳐다도 안보는 성격이 되었습니다.
이 때 공부하던 것이 바로 클라우드 그 중에서 AWS였고 우연찮게 AWS 자격증이 있다는 사실을 알게 되었습니다. 보는 순간 이거다! 하고 따야겠다는 결심을 하게 되었죠.
공부법
AWS 자격증 공부법을 검색해보신 분들은 알겠지만 일반적으로 자격증 공부하듯이 책이있고 그런게 아니었습니다. "덤프" 라고 부르는 기출문제를 풀어야했습니다.
시험이 영어, 한국어 중 고를 수 있다고 해서 한글로 된 덤프를 찾았습니다. 이것 때문에 경제적으로 뻘짓도 좀 했지만 결과적으로 나쁘진 않았습니다.
덤프를 검색해보면 한 번쯤 볼 사이트인 이곳
https://www.itexamdump.com/search.php?q=AWS+certified+Solutions+developer&x=0&y=0 (https://www.itexamdump.com/search.php?q=AWS+certified+Solutions+developer&x=0&y=0)
절대 사지 마십쇼 산걸 후회중입니다.
사이트도 있을건데 예를 들면 이런곳
https://dumps.kr/
처음엔 여기서 공부를 많이 했지만 여기도 비추입니다. 왜냐하면 AWS Developer Associate 줄여서 dva는 c01이 있고 c02가 있습니다.
쉽게 생각해서 c01는 버전 1, c02는 버전 2인데 c01은 예전 시험 문제라고 생각하시면 됩니다. 위의 DumpTruck 사이트는 c01 문제를 제공해줍니다.
때문에 바로 여기서 공부하시면 됩니다!
https://www.examtopics.com/exams/amazon/aws-certified-developer-associate-dva-c02/view/
영어로 되어있는데 구글 번역으로 페이지 번역해서 쓰시면 됩니다.
오른쪽 위에 저기 누르면 됩니다
중간까지 풀다보면 돈내라고 페이지가 뜨는데 돈 내고 결제하시면 됩니다. 한달에 40달러 1년에 60달러입니다. 저는 한달 구매했습니다.
체감상 적중률이 70~80퍼센트정도 되는 것 같습니다.
자격증 합격만이 목적이라면 문제를 달달 외우는 것이 최고로 효율이 좋지만 저는 그런식으로 자격증을 따긴 싫었습니다. 때문에 이론도 공부해야겠다고 생각해서 인강을 알아봤는데 저는 이걸 추천드립니다.
https://www.udemy.com/course/aws-certified-developer-associate-dva-c01/
정가 다 주고 사지 마시고 세일할 때 사시면 1만6천원에 구매하실 수 있습니다.
시험 신청
https://www.aws.training/certification/?ch=cta&cta=header&p=1 (https://www.aws.training/certification/?ch=cta&cta=header&p=1)
여기서 로그인하고 넘어가다 보면
여기로 이동하게 되는데 위의 카테고리중 "시험 등록" 을 누릅니다. 그리고 아래 시험들이 쭉 있습니다.
우리는 DVA를 봐야하기 때문에 잘 보시고 PersonVue로 예약을 눌러줍니다. 그리고 절차대로 쭉쭉 하시면 됩니다.
비용은 DVA는 150달러(약17만원)입니다.
시험 장소는 SRTC가 제일 좋다고 평이 있길래 거기로 했습니다.
영문명을 입력하라고 나와있는데 여권에 적힌 영문명을 그대로 적으시면 됩니다. 또한, 시험을 보기 위해서는 1차 인증 수단인 신분증과 2차 인증 수단인 여권을 검사하게 됩니다. 따라서 여권 꼭꼭 챙겨가시길 바랍니다.
후기
누가 그러더군요 자격증은 커트라인에 딱 맞춰서 공부하고 따는게 최고라고
어느정도 동의합니다. 하지만 저는 이 자격증은 그럴 생각이 없었습니다. 클라우드에 대한 이해도를 높이기 위해서 공부한만큼 내가 받을 수 있는 최고의 점수로 따야겠다는 마음을 먹었습니다.
사실 만점을 노리고 공부했는데 몇문제 틀렸더라구요. 조금 아쉽긴 했습니다.
시험 장소인 SRTC가 엄청 엄격했습니다. 이 경험은 되게 신기한 경험이었습니다.
저는 일찍 가서 공부하려고 했는데
• 시험장에서 공부 X
• 시험장에서 제공하는 종이 이외의 종이는 들고 들어갈 수 없음
• 시험장에서 제공하는 펜 이외의 펜은 들고 들어갈 수 없음
• 반지도 결혼 반지를 제외하면 빼고 들어가야함 (그래서 빼고 들어갔습니다)
• 모든 짐은 사물함에 넣고 들어가야함
• 직원분이 웬만하면 패딩도 벗으라고 하셨음 (패딩은 주머니가 많아서 부정행위를 염려하신 것 같음)
• 들어가기 전 바디체크
사실 너무 빡세서 속으로 '안경도 빼라고 하진 않겠지..?' 라는 생각을 하면서 걱정하며 들어갔던 기억이 나네요.
자격증만 놓고보면 대단한 자격증은 아닙니다. 문제만 달달 외우면 붙을 수 있는 자격증이니까요. 저는 신입이 자격증으로 보여줄 수 있는건 본인의 스킬이 아니라 관심도라고 생각합니다.
"저는 개발자에 관심이 있어서 정보처리기사를 땄습니다" 는 너무 작위적인 느낌이 들더군요... 그래서 "저는 클라우드 분야에 관심이 있어서 이런 자격증을 땄습니다" 를 어필하기에 가장 좋은 자격증이 아닐까싶네요. 개연성도 정보처리기사에 비하면 확실한 편이구요.
규모가 크지 않은 기업 (대기업을 제외한 모든 곳) 에선 클라우드를 이용한다고 들었습니다. 제가 이 자격증을 들고 이력서를 제출하면 면접관 입장에서 "이친구 클라우드에 관심이 있구만" 이라는 인상을 주고 싶어서 자격증을 땄습니다.
이후 방향성
제가 딴 DVA-C02 자격증은 3단계 중 2단계에 해당하는 쉽지도 어렵지도 않은 자격증입니다. 때문에 똑같이 공부하면 3단계도 무난하게 딸 수 있겠죠. 하지만 그럴 생각은 없습니다.
문제를 대충 보니 엄청나게 지엽적인 문제가 나오고 정말 외우지 않으면 딸 수 없겠다는 생각이 드는 문제들이었습니다. 적어도 제가 딴 자격증인 2단계는 제가 생각하면서 풀 수 있었는데말이죠.
정보처리기사도 고려 대상이지만 제가 가고싶은 스타트업에선 정보처리기사를 중요하게 생각하지 않는데다가 시험을 접수하고 결과가 나오는데까지 6개월이상 소요되는 것을 고려해봤을 때 조금 꺼려지는 것은 사실입니다.
하지만 추후에 청보처리기술사를 생각하면 따서 나쁠건 없다는 생각이 들어서 조금 더 고민해보고 결정해야 할 것같습니다.
4년간 대학교를 다니며... 대학생활 회고
이제 대학교를 졸업할 때가 다가왔습니다. 정말 많은 일이 있었던 대학 생활 4년이었습니다. 학교 생활 자체는 그렇게까지 재밌진 않았지만 개발자로서 역량을 키우는 시간이었음은 확실합니다.
이제 이력서를 넣고 자기소개서를 쓰면서 사회인으로서 한발짝 앞으로 가고있는 제가 1년뒤에 이 회고를 다시 볼 것을 기대하며 적어보도록 하겠습니다.
대학교 안녕...
1학년땐 놀자
여러분이 대학교를 지금 들어갔다면 1학년은 무조건 놀아야합니다.
난 개발 공부가 재밌는데요? = 그럼 개발 공부 하세요.
그런게 아니라면 1학년은 제발 놀아야합니다. 진짜 밑도끝도없이 뒤가없이 놀아야합니다. 노는게 지겨워!! 할때까지 미친놈처럼 놀아야합니다. MT도 가보고 술도 꽐라될때까지 먹어보고 게임도 새벽 내내 하고 대학교 강의땐 자고
게임에 빠져살던 술에 빠져살던 상관없습니다. 1학년땐 제발 노세요.
개발 공부
개발 공부를 언제 시작하면 좋을까... 곰곰히 생각해보면 저는 2학년이 제일 무난하고 좋은 것 같습니다. 2학년땐 가볍게 코딩하는 방법이나 프로젝트 간단하게 끄적여보고 3, 4학년땐 뒤도 안돌아보고 달리는게 가장 취업으로 가는 무난한 길이지 않나 싶습니다.
물론 저는 걱정이 많은 스타일이고 준비되지 않으면 시도조차 안하는 성격이기 때문에 이렇게 말하는 것일 수도 있습니다. 저는 취직을 위해서 면접 준비만 6개월동안 한 사람입니다. (여기서 면접 준비란 자바, 스프링, CS지식들을 질의응답하는 것을 말합니다~) 제가 생각해도 좀 과하긴 합니다...
메모장 하나에 꼬리질문까지 여러개 포함되어 있어서 아마 대략... 면접 질문이 100개정도 될겁니다.
결과적으로 아직까지 본 기술 면접에서 "망했다... 대답 잘 못했어...ㅜㅜ" 한적은 한번도 없습니다. 전부 질문에 대해 완벽하게 대답했습니다. (근데 왜 떨어진거지?)
자료구조와 알고리즘은 공부를 잘안했습니다. 손이 잘 안가더라구요... 백준이나 프로그래머스 반례를 안알려주는게 너무 답답해서 못해먹겠습니다.
프로젝트
프로젝트는 무엇을 하면 좋을까 고민하다가 떠오른 것이 온라인 쇼핑몰이었습니다. 사실 엄청나게 유명한 도메인이라 확 눈에 띄진 않았습니다. 하지만 제가 선택한건 익숙함에 의외성을 띈 8개월에 걸친 프로젝트 고도화입니다.
온라인 쇼핑몰 그 자체는 2개월만에 개발이 완료됐습니다. 하지만 실제로 온라인 쇼핑몰을 운영한다면 정말 다양한 문제들이 있을 것 같았습니다. 그래서 이 온라인 쇼핑몰을 고도화했습니다.
버전1 : 그냥 온라인 쇼핑몰
버전2 : 성능 개선
버전3 : 배포과정
버전4 : 클라우드 입히기
각각의 버전에 대해서는 제 블로그에 잘 정리 되어있습니다. 궁금하시면 한번 놀러오세요!
"프로젝트 여러개 했습니다." 하고 보여주는 것 보다 "저는 하나의 프로젝트를 버전업 시켜가며 고도화 했습니다." 쪽이 면접관 입장에서 조금 더 흥미로울 것 같았거든요.
사실 프로젝트 쫌쫌따리로 여러개 하는건 어렵지 않고 누구나 다하는 방식입니다. 그래서 남들이 안하는걸 해야 차별점이 된다고 생각해서 그런 것도 있습니다.
그래서 여러분들이 만약 프로젝트에 대해 고민하고 있다면 엄청나게 유명한 도메인 하나 만들고 (e.g 온라인 쇼핑몰) 그걸 고도화 해나가는 방식이 도움이 될 수 있습니다. 실제로 면접에서도 이 질문을 많이 받았어요 독특하다고.
논문
이건 대학생만 해당되는 내용이라 좀 조심스러운데... 만약 여러분이 대학생이고 개발 공부를 일찍 시작했다면 논문 한편 써보시는걸 추천드립니다. 개발 공부가 무르익을 쯤인 4학년때 하시는게 나쁘지 않습니다.
이것도 위의 프로젝트에서 얘기한 것처럼 차별점을 두기 위함입니다.
보통 컴공과 대학생 = 프로젝트 이게 공식이기 때문에 누구나 다 프로젝트 하나씩 합니다.
하지만 컴공과 대학생이 논문? 이건 흔치 않습니다. 석사는 제외입니다~ 학사는 정말 논문 쓰는 사람이 드뭅니다.
그럼 면접관이 포트폴리오 보면서 뭐야? 이놈은 컴공과 대학생인데 논문을 썼네? 하면서 신기해합니다. 실제로 면접에서 이거 안물어본 면접관은 한명도 없었습니다.
논문 썼다고 하면 면접관이 10이면 10 다 궁금해합니다. 저는 RDBMS와 NoSQL의 차이에 대한 서베이 논문이었는데 석사 과정 논문 쓰듯이 그럴듯한거 안해도 됩니다. 그냥 CS 기초지식인거 하나 골라서 논문쓰면 굉장히 궁금해합니다. (그게 플러스 점수인진 모르겠습니다.)
논문 한번 써보시면 아시겠지만 정말 변태같이 디테일 한것까지 전부 조사해야합니다. 저는 영어를 읽고 쓰는건 되서 영어로 논문을 봤는데 변태같은 심연의 지식이 대방출됩니다. 그거 쓰다보면 저절로 외워져서 누가 면접에서 논문 내용 궁금하다고 하면 5분동안 얘기합니다.
굉장히 눈에 띌 수 있습니다. (다시 말하지만 플러스 점수인진 모릅니다. 그냥 면접관 눈에 확 띌 수 있어요)
자격증
자격증 보통 개발자 하려고 하시는 분들 정처기 많이 따십니다. 실제로 개발자 모집 공고에 정처기 우대해주겠다는 말 심심치않게 (아니 꽤 많이) 나옵니다.
정처기 하나 있으면 사실 취직에 마이너스 요소는 절대절대 아닙니다. 따는게 무조건 좋습니다. 실무에서 쓸데없다느니 의미없는 공부라느니 그냥 듣지 마시고 딸 수 있으면 따세요.
아니 모집 공고에 대놓고 적혀있잖아요 "정처기 우대" 이거 하나로 종결 아닙니까? 사실 자격증을 누가 실무에서 써먹으려고 따요 그냥 취직 잘하려고 따는거지. 취직하려고 정처기 따는건 정말 좋은 선택입니다.
그럼에도 저는...
자격증 정처기 안땄습니다.
말이랑 행동이랑 다르다는 지적 달게 받겠습니다.
저는 왜 안땄냐면... 사실 정처기가 취직에 도움된다고 했으면 바로 땄을텐데 그걸 4학년 2학기에 알아버려서 늦었습니다... 그것도 있지만 무엇보다 면접관한테 어필하고 싶었습니다. "남들이 다 하는건 안해요 저 특별해요".
음... 이렇게 적고보니 프로젝트도 논문도 자격증도 너무 관종처럼 행동했나 싶은데..
아무튼 눈에 띄는게 중요합니다. 면접관에게 확실히 뇌리에 박히게 하는 것 그것이 목적입니다. 면접을 보는 지원자들이 엄청나게 많을 거잖아요? 그 중에서 기억에 남으려면 확실히 남들이 안하는 걸 해야 뇌리에 남을 것 같았습니다.
그래서 저는 클라우드 자격증을 땄습니다. AWS 자격증이요.
3개월 걸려서 땄는데 저는 클라우드 자격증을 단순히 취직을 목적으로 딴게 아니고 실무에서 써먹으려고 땄습니다. 때문에 만점을 목표로 했고 실제로 만점에 가까운 점수를 받았습니다. 그리고 이걸 자소서에 종종 적었습니다. "나는 만점을 목표로 했고 만점에 가까운 점수 받을만큼 클라우드에 진심이다" 라는걸 어필한거죠.
근데 사실 이건 딱히 귀담아 듣지 않으셔도 됩니다. 이 자격증 따긴 땄지만 면접관이 물어본 적 한번도 없거든요.
논문같은 경우는 "특이하게 논문을 쓰셨네요?" 라던가 "논문 내용에 대해서 말씀해주시겠어요?" 라던가 "논문 쓸 때 힘든 점은 없었나요?" 라던가 다양하게 논문에 대해서 질문을 받았는데...
자격증은 그런 말 한마디도 없었습니다. 지금까지 그 누구도 자격증에 대해서 물어보지 않았어요.
그래서 이 부분은 참고만 하시라는 말씀 전하면서...
졸업...
길다면 길었고 짧으면 짧았던 대학 인생이 끝났습니다. 느낀점도 정말 많았고 개발적으로나 인간적으로 성장했다는 것을 느꼈습니다.
한살 한살 먹어가면서 점점 경험하는 풀이 넓어지고 다양한 것을 경험하면서 어른이 되어가는 느낌이 들었습니다.
1년전의 나를 생각하면 정말 어리고 미숙했다는 것을 알게 되었습니다. 제가 적는 회고도 1년뒤에 제가 봤을 때 기억을 회상하고 추억에 빠져 조금 더 성장한채로 만족스러운 웃음을 지으면서 보길 바랍니다.
긴 글 읽어주셔서 감사합니다. 모두 취뽀하세요!
신입 개발자입니다.
드디어 취뽀했습니다. 후... 초기 스타트업에 취직하게 되었습니다.
요즘 취업 힘들다 힘들다 얘기만 들었지 몸으로 체감하니까 차원이 다르더군요. 취뽀한김에 회고를 안적을 수 없겠죠. 한번 적어보겠습니다.
공부 기간은?
코딩을 시작한지는 3년, 본격적으로 공부를 시작한지는 2년7개월 됐습니다. 처음 개발 공부를 시작했을 때가 정말 새록새록 떠오르네요. JSP로 프로젝트 하는데 JSTL에서 <c:forEach> 이거 진짜 애먹었습니다.
게시판도 만들어보고 MVC1 MVC2로 프로젝트 해보면서 개발에 대한 흥미를 잃지 않았던게 가장 큰 포인트였던 것 같습니다.
공부 방법은?
인프런의 영한님 강의를 들었습니다. 영한님이 강의를 너무 재밌게 찍으셔서 영한님 강의를 전부 다 들었습니다.
인강이 좋은 점이 모르는 부분 있으면 잠깐 멈췄다가 구글링해보고 다시 들을 수도 있고 이해 안되면 다시 뒤로 돌려서 들을 수도 있어서 제 탬포대로 공부할 수 있는게 정말 좋았습니다.
그렇게 영한님 강의를 6개월에 걸쳐서 모든 강의를 다들었습니다. 당시에는 MVC2편이랑 고급편, 데이터베이스 접근 기술이 없었던 때였습니다.
포트폴리오는?
버전업을 진행하는 온라인 쇼핑몰이었습니다. 1인 개발이었구요.
버전 1은 "일단 만들자"가 컨셉입니다. 기획, 설계, 개발, 테스트까지 전부 혼자서 해야하다보니 한 2개월정도 걸렸습니다. 개발하는게 너무 재밌어서 지치지도 않고 개발만 미친듯이 했습니다. 잠도 안자고 20시간 연속 개발한 적도 있었으니까요.
버전 1을 끝내고 1년뒤 프로젝트 할만한거 없나... 물색하던 중에 유튜브에서 어떤 개발자분께서 "포트폴리오로 버전업을 해봐라" 라는 얘기를 하셔서 '나도 버전업이나 해볼까?' 하고 만들게 되었습니다.
버전 2는 "이용자가 천만명이 된다면 어떤 성능 문제가 발생할까?"입니다. 엄청나게 많은 성능 문제가 있었습니다. 이 문제를 해결하려고 많은 노력을 기울였구요.
버전 3는 "배포 과정에서 어떤 문제가 발생할까?"입니다. 배포 과정에서 흔히 볼 수 있는 다운 타임에 대한 문제를 무중단 배포로 해결하고 Hard Shutdown에 대해 Graceful Shutdown으로 바꾸고 Class Loader, JIT Compiler Warmup도 진행했습니다.
버전 4는 "클라우드 환경에 올리자":입니다. 사실 버전3에서 이미 클라우드 환경에 있었지만 클라우드를 깊이있게 사용하진 못했습니다. 끽해봐야 Route53이랑 ACM, ALB, S3, EC2 이정도였어서 조금 더 다채로운 프로젝트를 위해 VPC를 도입했습니다.
결국 7개월짜리 긴 프로젝트를 완료할 수 있었습니다.
서류
개인적으로 지금까지 제 프로젝트를 만족스럽게 생각하고 있습니다. 프로젝트를 1~2개월 단위로 여러개 하는 것은 조금 별로인 것 같습니다.
면접관은
"어떤 문제가 있었어?"
"어떤 기술 썼어?"
"왜 그 기술 썼어?"
"과정에서 어떤 어려움이 있었어?"
이런걸 위주로 물어보는데 1~2개월짜리 작은 프로젝트에서 자신만의 "kick"을 만드는 것은 어렵다고 생각합니다. 때문에 하나의 프로젝트를 오랫동안 해보는 것이 좋다고 생각합니다.
또한, 읽는 사람 입장에서 포트폴리오 혹은 이력서를 쓰기위해 많은 노력을 기울였습니다. 최대한 간결하게 포트폴리오를 만든 것도 그 때문이죠.
오히려 핵심만 가지고 포트폴리오를 만들면 "흠...이 내용 궁금한데 내용이 다 안써져있네 면접때 물어봐야지" 이렇게 되기때문에 자연스럽게 면접으로 이어집니다.
면접
저는 면접 준비만 6개월을 한 사람입니다. 그래서 그런지 면접에서 전혀 떨지 않았어요. 준비한게 많아서 그런가 전혀 면접에서 떨지 않았습니다.
준비한 것이 많아서 신입 기준에서 모르는 기술 질문도 없었습니다. 신입이 못써봤을만한 기술들은 모른다고 했습니다. Spring Cloud나 Kubernetes같은건 왜 물어보는지 모르겠습니다.
면접 준비는 특히 꼬리질문을 신경썼습니다. 음... 일례로
나 : "회원 인증에 JWT를 사용했습니다."
면접관 : "Access Token과 Refresh Token을 어디에 저장했나요?"
나 : "Access Token은 쿠키에 Refresh Token은 Redis에 저장했습니다."
면접관 : "Access Token과 Refresh Token은 TTL이 얼마나 됐나요?"
나 : "Access Token은 30분 Refresh Token은 30일이었습니다."
면접관 : "왜 그렇게 했나요?"
나 : "Access Token은 최대한 짧게 하자고 생각한게 30분이었고 Refresh Token은 사용자가 로그인이 풀리는 것이 합리적이라고 생각되는 시간이 30일인 것 같아서 그렇게 설정했습니다."
--------여기까지가 실제 면접---------
면접관 : "만약 Redis 서버에 장애가 발생하면 Refresh Token은 어떻게 검증하죠?"
나 : "Redis 서버의 장애를 대비해 stateless하게 토큰을 발급해 서버 단에서 검증하는 방법이 있을 것 같습니다. 혹은, Redis의 가용성을 높이기 위해 Sentinel로 배포하는 방식을 선택할 것 같습니다."
면접관 : "Sentinel에 대해서 설명해주세요"
나 : "Sentinel은 기본적으로 RDBMS에서 가용성을 높이기 위해 사용하는 전략 중 하나인 레플리케이션 방식을 위해 사용하는 설정입니다. Sentinel을 사용하면 마스터 노드의 상태를 확인하여 장애가 발생했을 때 레플리카를 마스터 노드로 승격 시키는 역할을 수행합니다. 때문에 마스터 노드가 죽어버리더라도 서버의 가용성을 높일 수 있습니다."
이정도로 긴 흐름의 꼬리질문을 계속해서 생각했습니다. 그리고 그 모든 꼬리질문에 대답할 수 있도록 답변을 준비했습니다.
그래서
"왜 무중단 배포에 블루그린 배포를 사용했나요?"
"Github Action말고 Jenkins를 사용한 이유가 뭐죠?"
"동시성 문제를 낙관적 락이 아닌 비관적 락을 사용한 이유가 뭔가요?"
"스프링 시큐리티와 JWT를 결합하면 어떤 이점이 생기길래 이 둘을 결합했나요?"
와 같이 프로젝트에 대해 모든 기술에 "왜?"를 붙여서 거의 모든 꼬리질문에 대응할 수 있었습니다.
마치며
취준 기간은 약 한달 반정도 걸린 것 같네요. 다른 사람들에 비하면 정말 짧게 끝난거지만 하루에 7~8시간씩 자소서쓰고 공부하고 패턴이 조금 힘에 부치던 찰나에 붙어서 다행입니다. 이 템포로 1년을 했으면 정말 멘탈도 다 부서지고 난리 났을텐데말이죠.
힘든 시기에 취직해서 정말 다행입니다. 여러분도 취뽀하세요! 화이팅입니다!
개발 공부한지 3년을 채우고 다시한번 뒤를 돌아보다
2024년 2월에 작은 서비스기업에 취업하게 되면서 제2의 삶이 시작되고 있습니다. 아직 서비스가 고객들에게 배포되진 않아서 다양한 문제상황을 만날 기회는 없지만 서비스를 개발한다는 것 자체만으로도 첫회사치고는 잘 들어갔다 싶은 생각이 듭니다.
벌써 개발 공부한지 만으로 3년이 다되었고 지난 만2년 기념 회고를 작성했던 것과 동일하게 한번 회고를 진행해볼까합니다.
2023년 8월 9일 온라인 쇼핑몰 ver.4를 시작하다
7월에 ver.3가 마무리되면서 얼마 지나지않아 ver.4를 기획하게 되었습니다. 실제 ver.3까지 개발된 온라인 쇼핑몰을 AWS환경에 배포하는 과정을 거쳤습니다.
이때 실제로 많이 사용되는 EC2, S3, ALB, VPC등을 경험하면서 이때 했던 경험을 살려 현재 회사에서도 클라우드 부분을 제가 담당하고 있습니다. 그리고 이때를 기점으로 AWS에 흥미가 생겨 자격증을 준비하는 계기가 되기도 하였죠.
2023년 9월 1일 마지막 학기가 시작되고 클라우드 자격증을 준비하다
4년의 대학생활의 종지부를 찍는 학기가 시작되고 이때 남들이 다한다는 자격증 공부를 해볼까하고 준비했습니다.
처음엔 정보처리기사를 생각했지만 졸업증이 있어야해서 패스하게 되었고 SI회사를 제외하고는 딱히 쓸모있다는 얘기를 못들어서 더 꺼려지게 된 것 같네요. 하지만 딸 수 있을 때 따두는 것은 나쁘지 않을 것 같습니다.
자격증을 뭘 딸까 고민하다 ver.4에서 클라우드를 공부했던 것이 기억에 있어서 클라우드 관련 자격증을 공부하게 되었습니다.
외국 자격증인만큼 가격이 비싸긴 하더라구요... 시험 보는 비용만 150달러에 문제집까지 포함하면 250달러정도 들었던 것 같네요.
자격증을 공부할 때 비용이 꽤 나가다보니 떨어지면 안된다는 마음가짐으로 만점을 노리고 공부했더니 정말 만점에 가까운 점수를 받았습니다. (이왜진)
2023년 12월 대학교를 졸업하다
드디어 4년에 걸친 대학생활을 마무리지었습니다. 생각해보면 대학 생활은 열심히 공부만 했던 기억밖에 없네요. SNS에서 그러더라구요 "대학생활 때 공부만하면 좀 놀걸... 하고 놀기만하면 좀 공부할걸... 하고 밸런스있게 하면 놀거나 공부하거나 둘 중 하나만 할걸.." 하는 후회를 한다고요.
하지만 저는 대학 생활 4년중 2학년부터 공부만 했지만 후회스럽지는 않았습니다. 왜냐하면 이걸로 밥벌어먹고 살고있으니까요. 오히려 공부하지 않았던 것은 생각하기도 싫어지네요.
대학교 동기들은 어떻게 지내는지 연락이 다 끊어졌습니다. 애초에 밥친구이기도 했고 별로 궁금하지도 않았고 그렇다고 취직했다고 자랑하기도 뭣해서 그냥 연락하고있지않네요.
대학 생활 때 얻은 유일한 보물은 1학년때 지금의 여자친구를 만난 것이 아닐까 싶네요.
2024년 2월 14일 서비스 기업에 취업하다
취업을 준비한지 2개월정도 걸려서 소규모 서비스 기업에 취업하게 되었습니다. 서류가 붙은 곳 중에 정말 들어가고 싶은 곳도 많았지만 떨어지고 별 기대하지 않은 곳에 덜컥 붙어버렸습니다.
이곳밖에 붙은 것이 없어서 일단 다니려고 마음먹고 출근해서 꽤나 만족스러워서 지금까지 다니고 있네요.
서비스를 개발한다는 것은 정말 축복받은 일입니다. "남의 것을 만들지 않는다는 것" 이거 하나만으로도 저는 첫 회사치고 굉장히 잘 들어갔다는 생각을 하고 있죠.
남의 것이 아니기 때문에 잘 만들어야한다는 압박감은 있지만 그래도 잘 만드는게 더 낫죠.
회사 동료들도 다 잘해주시고 대표님도 좋은건 아니지만 그렇다고 사람이 나쁜 것은 아니라서 만족하면서 다니고있습니다.
하지만 제가 개발하는 서비스는 프로토타입이라 사용자의 트래픽이 없어 조금 더 난이도있는 문제를 겪고싶은 제 입장에선 이것이 이직하고싶은 이유가 되기도 했습니다. 그래서 취직하고 난 이후 계속 이직을 준비하고 있습니다.
2024년 3월 24일 온라인 쇼핑몰 ver.5를 개발하다
ver.4에선 클라우드 환경으로 프로젝트를 세팅했다면 ver.5에선 코드 리팩토링 작업을 진행했습니다.
2024년 3월 기준 2년전 프로젝트이기 때문에 그 때 당시의 읽기 힘들고 더러운 코드들이 산재해있어서 아주 진절머리가 났었거든요.
이걸 전부 리팩토링해서 조금 더 깔끔한 환경에서 개발하고싶어서 ver.5를 개발하게 되었습니다.
세션을 전부 Authentication 객체로 바꾼다던가 if else 블럭의 중복을 인터페이스로 추상화해서 코드를 대폭 줄인다던가 StreamAPI를 적극 사용해서 코드를 보기좋게 바꾼다거나 하는 작업을 통해 조금 더 깔끔해졌습니다.
ver.5는 뭔가 개발하고 그런게 아니었어서 2주정도만에 끝난 짧은 프로젝트였습니다.
2024년 5월 25일 아키텍처 프로젝트를 개설하다
"남들이 잘 안하는 프로젝트를 해보고싶다"라는 취지로 프로젝트를 구상하다가 평소에 기술들의 아키텍처에 관심이 많았던 저는 아키텍처 프로젝트를 해볼까? 하고 마음먹게 되었습니다.
아키텍처 프로젝트는 제가 개발하면서 고민했던 아키텍처들을 그림으로 그려내고 간단하게 설명하는 프로젝트입니다.
이 프로젝트에서는 아키텍처를 표현하기위해 그림을 그리는게 거의 8할의 시간이 들어갈 정도로 그림을 그리는것에 많은 시간을 소모하고 있네요.
"내가 설계한 아키텍처들이 수십개가 된다면 볼만하겠다"하는 생각이 들자마자 바로 프로젝트를 시작하게 되었습니다.
처음엔 3티어 아키텍처를 AWS를 이용해 고도화하는 작업에서부터 시작해 현재는 Redis의 분산락을 이용해 동시성 문제를 해결하는 것 까지 총 일곱개의 아키텍처들을 만들었습니다.
기록해놓고 모아놓는 것을 좋아하는 제 입장에서는 만족도가 높은 프로젝트인 것 같네요. 이렇게 하나하나 모이고 10개 20개가 되는 날 더 뿌듯해질 것 같아서 지금도 열심히 어떤 아키텍처를 구상할까 고민하고 있습니다.
2024년 7월 4일 온라인 쇼핑몰 ver.6를 개발하다
roadmap.sh 라는 사이트에서 로드맵을 보다가 Client Side Caching이라는 것을 보게 되었습니다. 사실 이건 브라우저단에서 Cache-Control 헤더와 ETag로 캐싱해놓는 방법인데... 영어로 이걸 검색하니까 최상단에 뜬 Redis 공식문서때문에 시작하게된 조금은 뜬금없이 시작한 프로젝트입니다.
처음 공식문서를 읽었을 땐 어? 이게 된다고? 싶은 생각이 들었죠. 왜냐하면 제가 처음에 이해한건 Redis가 브라우저가 가지고 있는 localStorage에 메세지를 보내서 업데이트 해준다는 내용이었거든요.
지금보면 말도안되는 이 해석은 공식문서에서 Client라고 된 부분을 저는 일반적인 클라이언트인 브라우저를 생각했기 때문입니다.
하지만 공식 문서에서 Client는 Redis를 사용하는 어떤 애플리케이션이던 다 접목시킬 수 있는 단어였죠. 즉, 여기서 말하는 Client는 Spring Boot가 될 수도 있고, 또 다른 Redis가 될 수도 있는 것이죠.
여기서 삽질을 많이했는데 GPT한테 물어보니까 할루시네이션이 생길정도로 잘 알려지지않은 기술인 것 같았습니다. 브라우저에 localStorage를 갱신하기위해 WebSocket을 써야한다 어쩐다 이런 이상한 소리를 하고 낚일뻔 했습니다. (실제로 조금 낚였습니다.)
GPT한테 물어보는건 포기하고 구글링을 하는데도 마땅한 레퍼런스가 없어서 이거 사람들이 잘 안쓰나보다... 하는 생각으로 들어간 사이트에서 예시 코드가 있었습니다. 뭔가 Redis를 개발한 개발자인 것 같은 깃허브 사이트였습니다.
이 코드를 보고도 똑같은 반응이었죠. 이게 된다고? 왜냐하면 아까 브라우저한테 메세지 보내서 localStorage 갱신한다는 말보다 더 어처구니 없었거든요. 스프링 부트에서 Map자료구조랑 Redis랑 연동한다는 말이었으니까요.
하지만 몇번 테스트를 해보고 진짜 되더라구요. "이건 미쳤다" 싶어서 바로 성능테스트에 들어갔죠. 생각보다 말도안되는 성능에 놀라면서 포스팅을 작성하고 이를 계기로 ver.6를 개발하게 되었습니다.
현재는 Redis를 이용해 Client Side Caching과 더불어 Redis로 분산락 구현하기, 대기열 만들기 등 Redis로 다양한 기능들을 개발하면서 뿌듯함을 느끼고 있습니다.
2024년 7월 10일 (현재)
현재 저는 ver.6로 어떤걸 더 개선해볼까 하는 생각으로 하루하루를 지내고 있네요. 이왕이면 데이터베이스와 관련된 개선을 해보고싶은데 음... 아직 어떤걸 중점적으로 개선해야할지 갈피를 못잡았습니다.
1년전인 2024년 7월의 저보다 한층 더 성장해있는 나 자신을 발견할 수 있었습니다. 1년 1년 쌓이고 뒤를 돌아볼 때마다 정말 뿌듯하네요.
일단 지금은 데이터베이스에 대해 깊이있게 공부해보면서 포트폴리오를 멋지게 다듬어야겠습니다.
오늘은 어제의 나보다 성장한 내가 되어있기를, 내일은 오늘의 나보다 성장한 내가 되어있기를
회고다운 회고..
안녕하세요. 개발 블로그 작게 운영하는 폴폴입니다. 제가 쓴 회고글을 보다보니 회고다운 회고가 없네요 ㅎㅎ.. 뭔가 제 감정을 드러낸 것이 하나도 없어 좀 딱딱한 회고글들이 나온 것 같습니다.
이번엔 조금 이른 24년도 회고겸 일기처럼 편하게 써보려고합니다.
조금 쉬어도 괜찮지 않을까..?
개발이라는 공부를 시작한지는 3년 반정도 되었네요. 정말 미친놈처럼 달리기만 했는데 그만큼 개발 공부가 재밌었습니다. 시간 가는 줄도 모르고 밤을 새가면서 공부할 때도 많았고 골머리 썩던 버그가 새벽에 해결됐을 땐 가족들 다 자고있는 집에서 소리없는 환호성을 지르기도 했습니다.
대학생 시절엔 평균 10시간씩 공부하고 올해 2월에 취직하고 나서 지금까지 평일엔 3~4시간 주말엔 10시간씩 공부했습니다. 쉬고싶어서 연차를 냈는데 할게 없어서 결국 또 공부를 하는 제 모습이 있더라구요.
그런 내 모습이 정상인 같지 않아서일까 이제 어느정도 궤도에 올라서일까 주말 내내 공부하고 다음날 출근해야하는 일요일 저녁에 '주말이 이대로 끝났네..' 같은 현타 때문일까.. 조금 쉬고싶어졌습니다 ㅎㅎ..
공부할 땐 바짝 공부하고 쉴 땐 제대로 쉬어줘야 될 것 같은 느낌이 들더라구요. 이런게 쌓이고 쌓이면 번아웃이라는게 나한테도 오지 않을까 하는 막연한 공포도 있었구요.
이제 평일 공부는 그대로 두고 주말엔 푹 쉬고 있습니다. 이렇게 쉰지는 2주 정도 된 것 같은데 마냥 편하지는 않더라구요. 100미터 달리기 속도로 전력질주 하다가 갑자기 천천히 달리니 뒤로 가는 기분도 들구요. 그래도 건강하게 살기 위해서 익숙해지려고 합니다.
그래도 많은 것을 얻은 것 같네요. 특히 개발적으로요. 3년차~4년차 개발자분들에게 저를 소개할 때 올해 2월에 취직했다 그러면 처음엔 은은하게 무시하는 듯한 태도가 썩 달갑지는 않았는데 개발적으로 몇마디 나눠보면 바로 무시하지 않더라구요. 그건 좋았습니다.
아무튼 요즘 다시 게임에 손을 대고있습니다. 게임에 심하게 빠졌던 과거가 있기에 다시 손대는 것이 무서웠지만 한동안 게임을 안해서 그런가 모든 승부욕이 사라져있더군요. 어릴땐 승부욕이 강해서 게임에 목숨걸고 이기려고 깨려고 미친듯이 했고 그게 제 인생의 전부였어서 더 열심히 했던 것 같네요.
지금은 게임을 이기는 것 보다 더 큰 목표가 있어서 그런지 이겨도 흥~ 져도 흥~ "게임이란게 이렇게 힐링으로 할 수 있는 것이었나?" 싶을 정도로 부처가 된 느낌이었죠.
큰 힘에는 큰 책임이 따른다
저희 회사엔 시니어 개발자분이 한분 계십니다. 근데 이분이 C#개발자셔서 다른 솔루션 개발을 하고 계시거든요. 그래서 이분한테 제가 개발할 솔루션을 인수인계 받고 제가 전적으로 담당하게 되었죠.
신입한테 이걸 맡겨도 돼..? 싶었지만 아무튼 그렇게 됐습니다. 처음 주니어 개발자가 네 명이 있었는데 이 네명 모두 국가기관 과제를 하고 있었습니다. 그러다가 대표님이 저를 슥 따로 부르시더니 "너가 5월부터 이 솔루션을 개발할거다." 라면서 당시 프로토타입인 솔루션을 저에게 소개해주셨습니다.
그렇게 네 명 중 제가 따로 빠져나와서 혼자 솔루션을 개발하고 있었죠. 프로토타입이던 솔루션을 대표님과 단 둘이 회의하면서 요구사항을 이것저것 개발하다보니 어느새 구실이 잡히기 시작했습니다.
그리고 최근에 국가기관 과제가 모두 끝났습니다. 그래서 이 세 분이 제가 개발하던 솔루션에 합류하게 되었습니다. 6개월이긴 하지만 개발하던 깜냥이 있어서 그런건지 대표님이 저를 리더로 세우고 팀을 꾸리기 시작했습니다. 어..어.. 하면서 떠밀려서 결국 제가 프로젝트를 리딩하는 상황까지 오게 됐네요...
그 덕분에 선배님들한테 "이거 개발해주시면 됩니다. 이거 수정해주실 수 있나요?" 이 지경까지 왔는데 참.. 신입한테 솔루션 혼자서 개발하라고 던지질 않나 프로젝트 리딩을 시키질 않나 저에겐 여러모로 쉽지않은 일들인데 자리가 사람을 만든다고 어찌저찌 꾸역꾸역 해내고 있습니다. ㅜㅜ
그래도 처세술이 늘고 있어서 커뮤니케이션 능력을 기르는 데에는 이보다 좋은 건 없을 것 같긴 하더라구요. 팀원 한명한명의 성격이나 성향을 파악해서 일을 분배할 때 백퍼센트에 가까운 효율을 뽑으려고 (사실 선배님들 눈치보여서...) 많이 노력하는 편입니다.
요즘 느낀 것은 저 포함 개발자들은 요구사항이 자주 변경되는 것을 싫어하고 만약 변경된다면 납득가능한 이유를 붙여줘야 불만이 나오지 않는다는 것인데요. 그래서 요즘은 회의 때 이걸 왜 개발해야하는지 개발하면 어떤 부분이 이득이 되는지 정확한 컨펌을 받는 편입니다.
다만 조금 걱정인게 이직할 때 프로젝트 리딩해봤다고 그러면 면접관 백이면 백 너 주니어인데 니가 ㅋ? 이런 반응이 예상돼서 살짝.. 걱정은 되네요.
뭐.. 공부밖에 안해서 딱히 회고할 것도 없네요. 글 길게 적지않고 여기서 마무리해보도록 하겠습니다.
오늘도 방문해주셔서 감사합니다. 즐거운 하루 되세요!
취업한지 만으로 1년을 되돌아보다
작년 2월 14일에 취업하고 현재 회사에서 1년을 채운 뒤 오늘 연봉협상을 마쳐 본격적으로 2년차가 시작되었습니다. 회사에서 1년동안 했던 일들 회고해보도록 하겠습니다.
성능 개선
회사에서는 WebRTC를 이용한 비대면 평가 시스템을 개발하고 있습니다. 제가 투입되었을 당시 오픈소스인 Openvidu를 이용해서 만들어져있었는데 Openvidu가 Kurento 미디어 서버를 기반으로 만들었기 때문에 WebRTC만 사용하는 저희 서비스 입장에선 썩 좋은 선택지는 아니었습니다.
이것도 추후에 포스팅을 하겠지만 WebRTC에 특화된 미디어 서버인 Mediasoup가 있어서 이를 이용해서 서비스를 마이그레이션 했습니다. 그러면서 기능도 추가로 개발하고 프로세스도 다듬으면서 기존 Openvidu에 비해 성능이 많이 향상됐습니다.
저희 서비스는 한명당 세개의 미디어 스트림을 전송하게 되는데 (웹캠, 모바일, 화면공유) 그렇기에 20명이 들어오면 사실 60명이 들어온 것과 비슷한 서버 부하가 생깁니다.
그래서 20명 남짓한 사용자가 들어오니 4코어 컴퓨터가 꽉차버리게 되었습니다. 여기서 영상을 녹화하기 시작하면 20명도 들어오지 못하는 상황이었죠.
이걸 Mediasoup을 기반으로 만든 오픈소스 Edumeet을 이용해서 마이그레이션을 진행했고 그 결과 80명까지 접속가능하게 (실질적으로 240명의 서버 부하) 변경했습니다.
하지만! 여기서 끝나지 않고 성능 개선이 이루어졌습니다. 왜냐하면 4코어 컴퓨터에 80명이면 사실 서비스할만큼 고도화되진 않은 것이라..
다음 단계
저희 서비스는 일반적인 WebRTC의 흐름을 타지 않습니다. 왜냐하면 수험생은 미디어 스트림을 송신하기만 하고, 관리자는 미디어 스트림을 수신하기만 하기 때문이죠.
하지만 기본적으로 Edumeet, Openvidu 모두 SFU방식으로 연결이 되어있는데 이는 송신과 수신이 쌍으로 이루어 미디어 스트림을 주고 받습니다.
즉, 저희 서비스에서는 수험생은 송신만, 관리자는 수신만 하지만 양쪽으로 미디어 스트림이 전송되고 받고 있었던 것이죠.
때문에 송신만, 수신만 하도록 컨트롤할 수는 없을까? 하는 생각에서 시작되었습니다. 이를 줄이면 트래픽 비용이 절감되지 않을까? 하는 생각이었죠.
Mediasoup은 영상을 생성하는 Producer (생산자) 가 어떤 Consumer (소비자) 로 갈 것인지 Router에 적어둡니다. Consumer를 만들고 난 뒤 본격적으로 스트림을 받을 준비를 하는 것이 바로 resume()이라는 메서드를 호출할 때입니다.
이 부분을 찾아서 관리자의 경우에만 resume()을 호출했습니다. 그랬더니 트래픽 비용은 그대로였지만 서버 성능이 너무 좋아져버렸습니다. 간단하게 예시로 설명해보겠습니다.
줌 회의에서 30명이 들어와있는 상황을 가정해봅시다.
화면에 30개의 영상이 보이는데 나를 제외한 29명과 연결되었다는 것을 알 수 있죠. 하지만 그 옆사람도 29명, 옆사람도 29명 29명..29명.. 즉 30개의 연결이 아닌 약 900개의 연결이 된 것입니다.
이 상황에서 관리자는 한명, 수험생은 29명이라고 가정해보면 관리자는 영상을 다 받아야하지만 수험생은 영상을 보내기만 하면 됩니다.
즉, 수험생 화면에서는 자기 자신만 영상이 보이고 나머지 29명의 영상은 보이지 않는것이죠. 반대로 관리자는 모든 영상이 다 보여야하죠. 이렇게 되면 연결이 900개에서 수험생이 보내는 연결 30개, 관리자가 받는 연결 30개 이렇게 60개만 연결이 되고 나머지 840개의 연결에 대한 CPU연산이 필요하지 않게 되는 것이죠.
그래서 서버 성능이 비약적으로 증가하게 된것입니다.
앞으로는..
현재 Edumeet은 클라이언트, 시그널링 서버, 미디어 서버 이렇게 세개로 이루어져 있습니다.
지금의 상황은 하나의 시그널링 서버와 여러개의 미디어 서버가 연결될 수 있습니다. 하지만 만약 사용자가 많아져 시그널링 서버가 많아지면 어떤 브라우저가 어떤 미디어 서버와 연결되어 있는지 시그널링 서버들이 상태를 관리해야합니다.
이런 문제는 서버가 여러대로 늘어나면 생기는 자연스러운 현상입니다. 스프링 부트에서도 세션으로 인증을 관리하면 서버가 늘어나는 경우 Redis를 이용해서 세션서버를 따로 두는 것이 일반적이죠.
시그널링 서버의 상태를 관리하기 위해 Redis의 Pub/Sub 메세징을 이용하는 방법을 떠올릴 수 있을 것 같습니다. 만약 이 방법을 사용하지 않는다면 시그널링 서버간 웹소켓 통신이 떠오르는데 이는 시그널링 서버의 많은 부하가 예상되어 부하를 분산시키기 위해서라도 Redis를 이용하는 것이 좋을 것 같습니다.
또한, 생각해야 하는 점이 바로 scale in을 하는 경우 미디어 서버의 개수가 줄어들게 되는데 그 때 미디어 서버에 연결되어있던 WebRTC들을 남아있을 미디어 서버로 전달해줘야합니다. 저는 이게 Graceful Shutdown처럼 보여서 Graceful Shutdown이라고 부르긴 하는데 이 점을 생각해봐야할 것 같습니다.
마치며..
이제 2년차인만큼 또 열심히 다니면서 성장해보도록 하겠습니다! 포스팅도 열심히 쓰면서 다시 한번 앞으로 나아가보겠습니다. 그럼 다음 포스팅에서 뵐게요!
우당탕 홈서버 구축하기 회고 (cafe24에서 OAuth Proxy까지)
이번 포스팅에선 cafe24를 거쳐 공유기 포트포워딩으로 홈서버를 구축, 그 이후에 cloudflare를 결합한 OAuth Proxy까지의 여정을 회고식으로 다뤄보려합니다.
호스팅..? 그게 뭐죠 먹는건가요
때는 2021년 6월... 벌써 4년전이네요. 개발공부란걸 처음 시작하게 되었습니다. 처음엔 jsp를 이용해서 배포를 했는데 그때 당시를 회상해보면 데이터베이스 커넥션을 맺을 때 name과 password를 어떻게 설정해줘야 하는지도 모르는 새싹이었습니다.
이때 배포라는 단어도 처음 들어보고 꾸역꾸역 만들어서 배포까지 성공을 했습니다. 프로젝트가 간단하게 게시판 있고, 서버에 있는 이미지를 보여주는 단순한 쇼핑몰 느낌이었는데 제가 했던 사이드 프로젝트인 온라인 쇼핑몰처럼 큰 규모는 아니었고 작은 규모였습니다.
파일 업로드라는 개념을 아예 모르고 있었기 때문에 서버에 이미지를 저장해두고 그 이미지를 보여주는게 전부였기에 서버가 이미지를 들고 있어야하는 문제가 있었죠.
그래서 이미지가 추가되면 서버 용량이 부족해지는 문제가 있었습니다. 제일 싼게 200MB를 저장할 수 있었는데 이미지가 200MB를 넘어가면서 500MB로 업그레이드 시켰던 기억이 있네요.
하지만 좋았던건 WAR파일만 서버에 올리면 자동으로 배포가 되었기에 리눅스를 아예 모르던 제가 배포할 수 있는 가장 좋은 방법이었습니다.
스프링 부트를 알게되고 ver.2로 업그레이드 되다
그로부터 1년뒤 영한님 강의를 듣고 스프링 부트라는걸 알게 되었습니다. 그러면서 thymeleaf를 알게되었죠. 이걸로 파일 업로드 부분을 공부하고 있었는데 문득 이런 생각이 들었습니다.
'가만보니 내 프로젝트에 파일 업로드가 없네..'
그리고 제 프로젝트를 보니 jsp로 떡칠이 되어있는 모습에 한숨이 절로 나왔습니다. 그래서 이걸 스프링 부트로 마이그레이션 해야겠다고 생각했죠.
스프링 부트로 바꾸면서 AWS S3라는 것도 적용시켜서 서버용량을 500MB씩 쓸 필요가 없어졌습니다. 다시 200MB로 내리면서 서버 비용을 아낄 수 있었죠.
추가된 기능으로 서버를 관리하기가 매우 편해졌습니다. 기존엔 이미지를 추가해야할때마다 이미지 추가 + 이미지를 보이게 하기위한 코드 추가 + 배포 이렇게 해야 이미지가 보였는데 이젠 이미지 업로드로 배포를 하지 않아도 이미지를 추가할 수 있었습니다.
하지만 이때도 유닉스 체계에 대해서는 완전 무지했기에 여전히 cafe24를 사용했고 그게 나름 잘 통했습니다.
그런 새싹이 이제 홈서버에 도전하다
2025년 4월... 그 때의 새싹이 4년이 지나고 프로젝트를 관리하던 중에 족쇄를 발견하게 됩니다. 바로 cafe24 자체가 족쇄였죠.
'아니 rm -rf 이런 명령어도 못쓰고 vim 도 못쓴다고? lsof, nslookup, dig 이런 기본적인 네트워크 디버깅도 안된다고?'
유닉스 체계에서 서버를 이렇게 저렇게 가지고 놀다보니 어느새 유닉스 체계의 운영체제와 친해졌습니다. 점점 자유도가 떨어지는 cafe24가 답답해지기 시작했습니다.
그리고 WAR파일을 배포하는것도 도커를 쓰던가 도커를 쓸 수 없는 메모리 양이라면 nohup으로 배포하면 되는걸 너무 귀찮았죠. 그러면서 드는 생각이 '그럼 1년에 2만5천원씩 주고 이걸 쓸 이유가 있을까?'
그렇게 AWS EC2로 넘어갈까 했지만.. t3a.nano가 제일 싼데 이것마저도 한달에 8천원 가까이 나옵니다. 심지어 메모리는 500MB밖에 없어서 스프링 부트가 돌아가지도 않아요. node.js 프로젝트들이나 프록시 서버로 쓰기엔 좋지만 스프링 부트 서버로 쓰기엔 턱없이 부족했고 돈도 cafe24보다 비쌌죠.
'그냥 내 맥북에다 배포해버릴까?'
홈서버 구축
가장 먼저 든 생각은
• 스프링 부트를 도커로 띄운다
• nginx를 리버스 프록시로 세워서 스프링 부트로 서빙한다. 포트는 80 포트는 443으로 리다이렉트
• 공유기 포트포워딩으로 외부 인터넷에서 우리집 공유기에 붙을 수 있게한다. 이때 외부 포트는 80, 443 내부포트는 443으로 맥북에 있는 nginx와 외부 네트워크를 연결한다.
• 도메인의 A레코드를 우리집 공유기 IP로 바꾼다.
이런 흐름을 만들었습니다. 그리고 실행에 옮겼고 인프라만 구축하면 되었기에 빠르게 개발되었습니다. 그렇게 이틀만에 개발이 완료되었습니다. 그렇게 홈서버 구축이 끝나게 되었습니다.
홈서버를 구축할 땐 가정용 공유기는 보안상 좋지않다
이런 글을 트위터에서 봤습니다. 가정용 공유기는 보안상 안좋다고? 그건 안되는데...
그리고 이 세상엔 미친놈이 많습니다. 공유기를 외부 네트워크랑 연결해놓았더니 별별 미친놈이 벨튀를 하면서 보안이 뚫리는 곳이 없는지 확인해보는 문제가 있었습니다.
퇴근하고 집에 돌아와서 로그를 확인해보면 별별 이상한 요청들이 nginx 로그에 찍혀있고 봇이 지나간 흔적이나 누군가 보안 취약점을 찾아보고 간 흔적 이런식으로 곳곳에 흔적이 남아있었습니다.
이게 뭔가.. 우리 집이 공격받는 느낌이잖아요? 아파트 현관문을 열어놨더니 자꾸 우리집에 와서 벨누르고 도망가거나 괜시리 도어락 비밀번호 한번씩 눌러보고 도망가는 느낌이었습니다.
그래서 조금 기분이 안좋았던 터에!
cloudflare zero trust
이걸 알게되었습니다. 저도 cloudflare는 말로만 들었지 실제로 써본건 처음이었는데요. cloudflare에서 파는 주력 상품 중에 zero trust라는 것이 있습니다. zero trust는 말 그대로 모든 요청을 검수하겠다는 얘기입니다. 아무도 믿지 않겠다는거죠.
이렇게 아무도 믿지 않게 되는 과정속에는 Access Policy라는 것이 있습니다. 내 애플리케이션에 접근하기 전에 cloudflare를 통과하지 못하면 내 애플리케이션으로 접근할 수 없고 그 과정에서 접근할 때 어떤 인증 방식 (e.g Google 로그인) 으로 어떤 사용자만 통과시킬지 이런 정책들을 통과해야만 내 애플리케이션에 붙을 수 있습니다.
여기서 조금만 깊게 생각해보면 그럼 cloudflare랑 내 애플리케이션을 어떻게 연결할까? 왜냐하면 내 애플리케이션이 예를 들어서 8080포트가 열려있습니다. 거길 cloudflare랑 붙으면 cloudflare가 접근 정책을 거치지 않고 바로 8080포트로 붙으면 안되니까요.
그래서 cloudflare에선 tunnel이라는 독특한 방식으로 cloudflare와 애플리케이션을 연결합니다.
애플리케이션이 있는 서버에서 애플리케이션을 로컬에 띄웁니다. 그리고 cloudflared 라는 cli 툴을 이용해서 cloudflare와 애플리케이션간 엔드 포인트를 만들어줍니다.
이렇게 되면 내 서버는 아웃바운드로 cloudflare에 엔드포인트를 만듭니다. 이 과정에서 인바운드 규칙은 아무것도 설정하지 않았습니다. 내 서버로는 아무도 못들어오는 상황이죠.
아웃바운드로 열린 cloudflare와 서버간 비밀통로를 이용해서 cloudflare는 tunnel을 만들 때 사용하는 config.yml의 규칙을 기반으로 내가 정한 도메인으로 들어오는 모든 요청을 비밀통로를 통해 밀어넣습니다. 물론 그러기 위해서는 내 도메인의 네임서버를 cloudflare의 DNS서버로 연결해야하지만요.
여기서 밀어넣는다는 표현이 적절한 것이 cloudflare는 내 도메인으로 들어오는 모든 트래픽을 서버로 위임하는 것이 아니라 그냥 밀어넣어주는 것 뿐입니다. 어찌보면 프록시라고 볼 수도 있겠네요.
이런 그림으로 되겠지요.
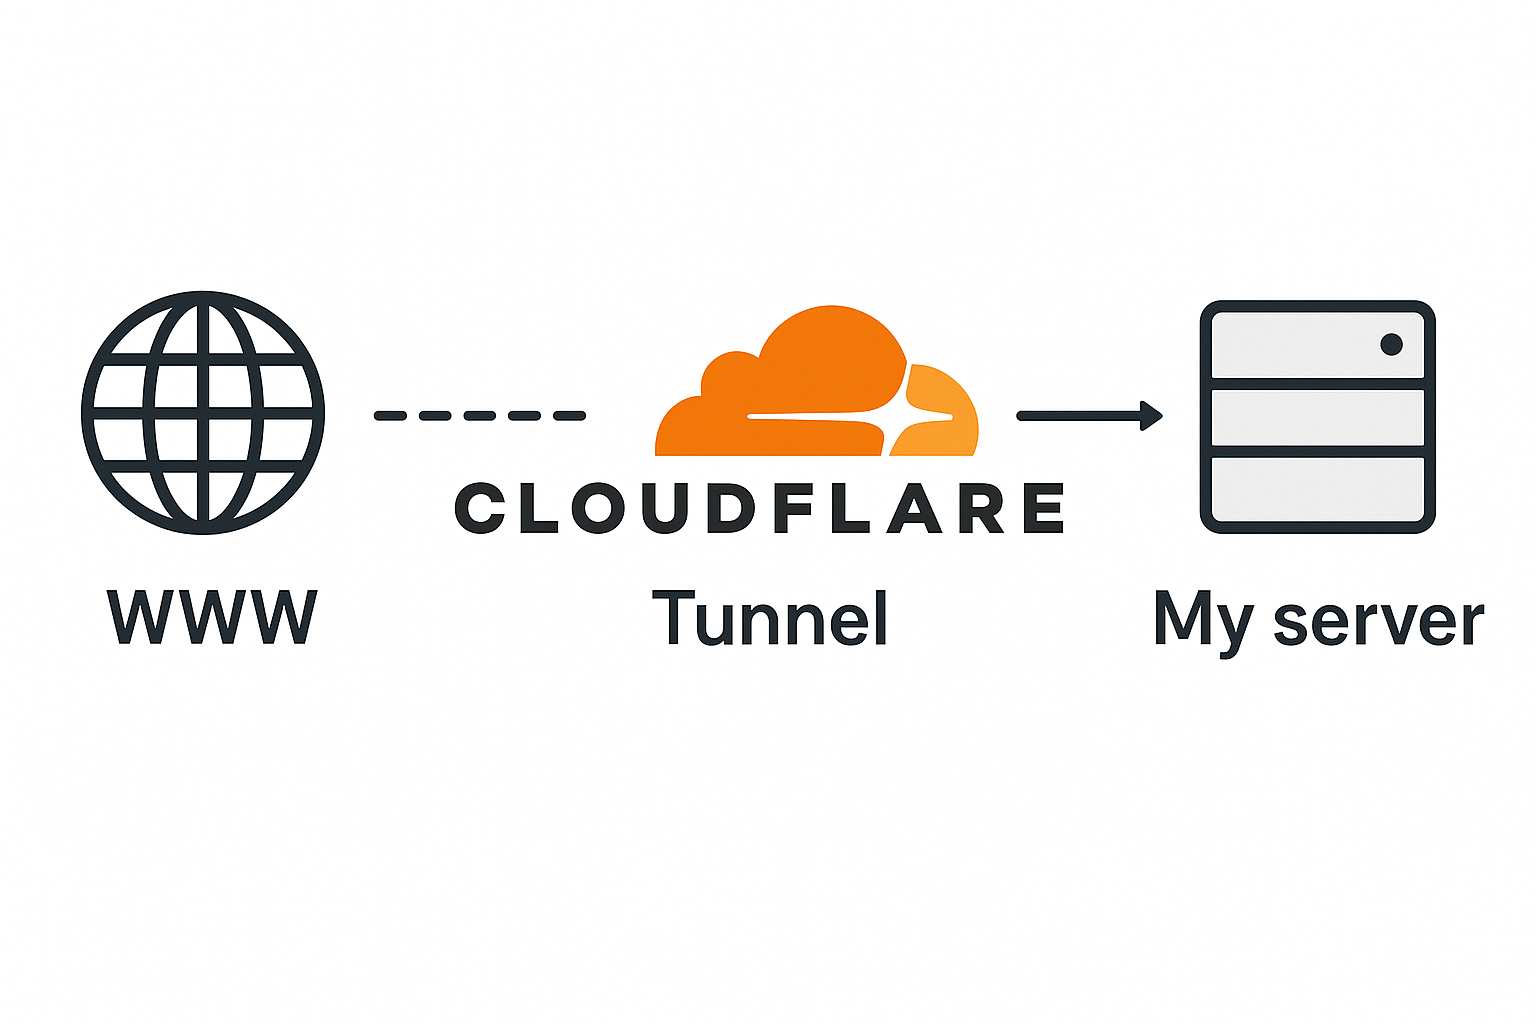
모든 트래픽을 cloudflare가 대신 맞아주고요 특정 도메인으로 들어오는 요청만 tunnel을 통해서 내 애플리케이션으로 들여보내주는겁니다.
이러면 두 가지 큰 장점이 생깁니다.
• 모든 트래픽은 cloudflare가 먼저 맞는다. = DDoS에 대한 어느정도의 대책이 생긴다.
• 내 애플리케이션, 내 서버는 외부와 절대 연결될 수 없다. cloudflare를 거치지 않고서는 절대 내 서버로 접근할 수 없다.
모든 트래픽이 cloudflare가 먼저 맞기 때문에 DDoS가 어느정도 방어됩니다. 왜냐하면 cloudflare는 초당 수백만 요청을 막을 수 있는 DDoS 방지 솔루션을 가지고 있기 때문이죠.
그리고 내 서버가 외부 네트워크와 완전히 단절된다는 장점도 있습니다.
이게 저에겐 엄청나게 큰 메리트였습니다. 저의 니즈와 완벽히 일치합니다. 혹시 모를 DDoS에 대비하고, 제가 정한 사람만 들어올 수 있다는것이 정말정말 좋았습니다. 거기다 이 모든게 무료입니다. 너무 아름답지않나요?
네, 아름답지 않아요.
이게 뭔... 다 적용하고 보니까 이런 페이지가 저를 반겨줍니다.
이게... 무슨...
이 페이지를 보고 충격에 말을 잇지 못했습니다. 이런 페이지가 먼저 보인다고?
에이.. 그럼 커스텀은 되겠지?
커스텀은 안됩니다.
맨위에 있는 로고를 바꾼다거나 배경색을 바꾼다거나 이정도밖에 안됩니다. 물론 유료버전은 모르겠지만요...처음엔 그냥 쓰려고 했었죠 근데 제 프로젝트는 제 소중한 사람들이 사용하는 페이지인데 이런 페이지를 보게된다니요... 정신이 아찔해졌죠.
가만... 이거 뭔가...
구글 로그인을 하고 내가 정한 이메일만 로그인할 수 있게 앞에서 막아준다.. 이거 완전 프록시잖아? 그래서 이름하야!
OAuth Proxy를 직접 만들기로 작정했습니다.
제 목표는 다음과 같았습니다.
• 단순히 OAuth 요청만 수행한다.
• 요청이 끝나면 뒤에 있는 애플리케이션으로 요청을 서빙한다.
• 프록시로 사용할 수 있을 정도로 가벼워야한다.
그렇게 Express를 이용해서 가볍게 프록시를 만들었고 이렇게 변했습니다.
• 모든 요청은 cloudflare가 먼저 맞는다. (DDoS 방지)
• cloudflare tunnel은 OAuth Proxy와 연결되어있다.
• 모든 요청들은 /login으로 리다이렉트.
• OAuth Proxy에서 OAuth인증을 거친 후 등록된 사용자인지 프록시에서 확인한다.
• 등록된 사용자라면 뒤에 있는 실제 애플리케이션으로 서빙
• 실제 애플리케이션은 필터에서 해당 요청이 OAuth Proxy에서 서빙된 것인지 확인하고 아니라면 403을 반환 이때 Origin, Referer를 확인함.
• Origin, Referer는 얼마든지 클라이언트 쪽에서 변조가 가능하기 때문에 OAuth Proxy에서 뒤에 있는 애플리케이션에 전달할 때 특별한 HTTP Header를 사용. 저는 X-Forwarded-Proxy라는 헤더를 전달해줬습니다.
• 애플리케이션에서 Origin, Referer, Header를 모두 검사하고 통과
제가 구현한 OAuth Proxy는 cloudflare zero trust를 모방한 프록시이고 zero trust의 다양한 Access Policy들은 제 입장에서 필요없는 기능이었고 제가 필요한건 오직 "내가 등록한 사용자만 입장할 수 있게 한다." 였기에 직접 프록시를 만드는 것이 합리적이라고 생각했습니다.
물론 Access 페이지가 너무 구려서 만든거지만요.
마치며
oauth-proxy라는 이름은 제가 만든건 아니고 실제로 oauth-proxy라는 이름의 오픈소스가 있더라구요. 아마 제가 구현한거보다 조금 더 추상화 되어있고 사용하기 쉽게 되어있을겁니다.
그럼에도 제가 직접 만든 이유는 뭔가 개발자들이 자기가 필요한걸 직접 뚝딱뚝딱 만들어서 사용하는게 너무 멋있어보였습니다. 지금은 AWS가 상업목적으로 클라우드를 만들지만 초기 의도는 자신들이 사용할 파일 저장소가 필요했던 것처럼요.
그래서 저도 개발자 감수성을 터트려가면서 직접 만들어봤습니다. 직접 만드니까 너무 뿌듯하고 저도 어엿한 개발자로 성장한거같아서 매우 뿌듯하고 좋았습니다.
이번 포스팅은 여기서 마치도록 하겠습니다. 오늘도 즐거운 하루 되세요~
내가 성장했는지 확인하는 가장 좋은 매개체 '블로그 쓰기'
블로그를 시작한지 벌써 4년이 되었습니다. 21년도 7월부터 개발일기로 시작된 블로그 포스팅은 그 이후 550개 가량 쌓이게 되었죠. 이번 회고에선 블로그 포스팅을 쓰면서 느꼈던 점들을 적어보려고합니다.
포스팅을 잘 써놓으면 복습할 때 용이하다
블로그 포스팅을 쓸 때 내가 쓸 내용을 하나도 모르는 독자를 대상으로 쓰여진다고 생각하고 작성하게 되면 실제로 아무것도 모르는 사람이 내 블로그를 보고 정보를 얻어갈 때도 물론 도움이 되지만 이 내용을 까먹었을 때의 내가 다시 복습을 위해 포스팅을 볼 때도 용이합니다.
저는 기억력이 그렇게 좋지 않아서 어떤 개념을 공부하면 1개월만 지나도 아 그거 공부했었지 같은 기분만 남아있고 실제 내용은 기억이 안나는 경우가 대부분이었는데요. 어... 이거 뭐더라... 그 때 공부했는데.. 라는 생각이 들면 바로 포스팅 쓴걸 찾아서 다시 읽어보기를 반복했습니다.
어른들은 청년들에게 인생에 정답은 없다고 항상 말해주셨죠. 그 말이 맞는 것 같습니다. 인생살면서 무조건 모든 내용을 기억하고 있을 필요는 없습니다. 기억이 안난다면 다시 보면 그만이죠. 그렇게 두 번, 세 번 반복하다보면 결국 그 내용이 머리속에 자리를 잡기 시작합니다.
성장은 계단식이 아닌 선형적
저는 공부한 내용을 정리해 놓는 공개글과 저만의 일기인 비공개글을 두개 쓰고 있습니다. 근데 이 일기가 제 성장지표가 되고 있습니다. 처음엔 공부하는데 힘들어서 신세한탄하는 정도로 일기를 썼는데요. 시간이 꽤 지나고 그 일기를 다시 보게 되었는데 울컥하게 되더라구요.
어떤 개념에 대해서 이해가 안된다고 어떻게 이렇게 이해가 안될 일이냐고 한탄했던 일기를 보자마자 '와.. 이거 지금은 아무것도 아닌데..' 라고 생각하게 되었습니다. 그러면서 동시에 '내가 공부를 허투로 한게 아니구나.. 나 제대로 성장하고 있구나..' 라는 걸 느끼게 되었습니다.
생각보다 일기를 쓴다는게 꽤 오글거릴지라도 내가 얼마나 성장했는지 알게 되는 중요한 지표가 됩니다. 일기는 최대한 감정에 솔직하게 적고 6개월에서 1년뒤에 읽는 것을 목표로합니다. 남에게 보여줄 것이 아니기에 힘들다 지친다 이런 표현도 가감없이 쓰는 것이 좋습니다.
그리고 시간이 오래 지난 뒤에 보게되면 '아 내가 성장했구나' 라는 기분을 내기위함이죠.
물론 그 과정에서 계속해서 노력을 해야겠죠. 제가 학생 때 선생님들이 꼭 하던 얘기가 '어느날 갑자기 성적이 오른다' 였는데요. 저는 이걸 환상이라고 생각합니다. 성장했다는 것을 꽤 긴 시간 뒤에 깨닫게 되기 때문에 계단식으로 성장한다고 얘기하지만 사실 그 사람이 계단식으로 성장하기까지 선형적으로 수많은 노력이 있었기 때문이라고 생각합니다.
이건 마치 산을 오를 때 뒤도 안돌아보고 앞만보고 계속 올라가다 특정 순간에 뒤를 돌아봤을 때 '와... 내가 이만큼이나 높게 올라왔어?' 를 깨닫게 되는 것이라고 생각합니다.
남과의 비교는 불행을 낳는다.
요즘 SNS가 퍼지면서 남과 비교하기 쉬운 세상에 살고 있는 것 같습니다. 나는 회사에서 일하고 있는데 인스타에 해외여행가는 친구를 보면서 부러워하고 현재 내 인생을 비관히기 쉽습니다. '내 인생은 왜 이럴까..' 라는 생각에 사로잡히면 나 자신을 사랑하기 힘든 것 같습니다.
블로그 포스팅도 그런 의미에선 비슷한 맥락을 가지는 것 같습니다. 다른 사람이 쓴 글을 보면서 '와.. 글 잘썼다.. 난 이정도도 아닌데 공개글로 글을 쓰는건 아닌거같아..' 이렇게 생각하고 포기하기 쉬운데요. 사실 이건 틀렸습니다.
대중에게 보이는 화려한 사람들의 모습은 그 사람의 하이라이트만 보이게 됩니다. 그 사람이 그 하이라이트를 가지기 위해 했던 엄청난 노력들은 하이라이트에 가려져 잘 보이지 않죠.
저도 처음 블로그 쓴 글을 보면 정말 쥐구멍에라도 숨고 싶은 심정이 들더라구요. 하지만 요즘은 퍽 잘 써서 어디 내놓기에 부끄럽지 않은 정도는 되는 것 같습니다.
요컨대, 남과 비교하지 말고 과거의 나와 비교해야한다는 것인데요. 나보다 잘난 사람은 차고 넘쳤습니다. 그 사람들과 하나하나 비교해가면서 나를 미워하기보단 6개월전, 1년전의 나와 비교하면서 성장하는 재미, 성장했다는 성취감을 느끼기 시작하면 더 이상 남과 비교하는 것이 의미없어지게 되더라구요.
그러면서 생기게 되는 변화가 바로 나 자신이 점점 좋아지는 것입니다. 흔히 자존감이란 내가 나를 얼마나 사랑하는지에 대한 척도라고들 하잖아요? 저는 내가 나를 얼마나 사랑하는지 라는 조금은 추상화된 말에서 조금 구체화해서 내가 나를 봤을 때 꽤 괜찮은 놈이구나 라고 인식하는 수준이라고 해석합니다.
마치며
구글 검색 상위 노출은 세보면 더 많을텐데 최상단 노출은 저 세개가 유일하더군요. 4년동안 블로그를 쓰면서 꽤 큰 성과라고 생각해서 이번 포스팅을 적게 되었습니다.
4년간 내가 큰 성장을 했다는 것을 몸소 깨닫게 되고 나 자신을 조금 더 사랑할 수 있게 된 것 같습니다. 여러분도 블로그 포스팅을 쓰면서 자신의 성장을 확인해보는 것이 어떨까요? 긴 글 읽어주셔서 감사합니다. 오늘도 즐거운 하루 되세요!
회사생활 만으로 2년, 얻은 것은 무엇이고 잃은 것은 무엇인가
안녕하세요! 약 10개월만에 회고를 쓰게 되었습니다. 마침 취직한지 만으로 2년이 된 김에 걸어온 길을 정리할 겸 컴퓨터 앞에 앉았습니다. 본격적으로 글을 쓰기 전에 이직을 했다는 소식을 전해드리고자합니다. 웹 백엔드 개발에서 sLLM을 이용해서 AI 엔지니어링을 하고 있습니다.
이번 포스팅에서 꽤 비중있게 다뤄질 내용인데 이 주제를 가지고 개발 공부한지는 만으로 5년 회사생활 만으로 2년동안 얻은 것과 잃은 것에 대해서 고찰해보도록 하겠습니다.
기술에 대한 집착을 잃고 상황에 맞는 개발에 집중하다
예전이라고 할 것도 없이 불과 2년전 취준을 할 때만 해도 세련되고 멋있는 기술에 대한 선망이 있었습니다. "기왕 가는 김에 쿠버네티스를 사용했으면 좋겠다." 혹은 "캐싱과 메세지 브로커가 있으면 좋겠다" 등등 세련되고 멋있는 기술을 사용하면 실력있는 개발자인 것처럼 보였습니다.
물론 이런 어려운 기술을 이용해서 개발하는게 실력이 없다는 얘기가 아니고 만약 어떤 기업이 쿠버네티스를 쓴다면 그건 그게 멋있어서 쓰는게 아니고 쿠버네티스를 쓸 수 밖에 없는 회사여서 그걸 쓴 경우가 대부분입니다. (그렇지 않은 곳도 몇 군데 들은 것 같아요..)
분명 기존 방법으로는 해결할 수 없는 문제가 있었고 신기술을 도입하는 것을 수없이 많은 회의를 거쳐 그 기술을 적용하고 마이그레이션 한 결과물이라는 것이죠.
이 말은, 굳이 사용하지 않으면 사용하지 않는 것이 베스트라는 것입니다. 팀에 5명 밖에 없는 소규모 팀인데 쿠버네티스를 사용하는게 올바른 선택인가? 하면 그건 아니라는 얘기죠. 산의 위치를 바꿀 수 있는 거대한 굴삭기로 집 앞 텃밭을 가꾸겠다는 얘기입니다.
결국 용도에 맞는 도구를 사용하는 것이 베스트라는 것을 알게 되었죠.
이걸 알게 된 것은 취직한지 그리 지나지 않은 3개월차, 이제 막 신규 프로젝트에 투입되어 프로젝트를 혼자서 개발하던 상황에서 문득 깨닫게 되었습니다. 혼자 개발해야되고 프로토타입의 솔루션을 상용화 해야하는데 이걸 내가 다 관리하고 개발해야하는데 Redis가 무슨 소용이고 HA가 무슨 소용이라는 말인가 싶었죠.
개발 뿐만 아니라 모든 일이 그렇지만 본질은 문제해결이고 그 문제해결을 위한 도구로 개발자는 코딩 혹은 엔지니어링을 하는 것이 본질이라는 것을 깨닫게 되는 소중한 경험이었습니다.
코딩하는 재미를 잃고 일하는 재미를 얻다
코딩이라는 것을 처음 시작할 때의 기분을 아직도 잊지 못하고 있는데요, 내가 열심히 개발해서 뭔가 결과물이 뿅하고 튀어나오거나 더 나아가 그 결과물이 내가 설계한대로 동작할 때의 그 쾌감이 정말 신선했고 엄청난 도파민이 쏟아져 나왔습니다.
그 결과, 개발을 게임처럼 하기 시작했고 하나씩 퀘스트를 깨나가는 것 처럼 하나씩 개발지식을 습득하기 시작했습니다. 저는 MMORPG를 좋아하다보니 조금씩 경험치를 얻는 것에 대한 직관적인 이해가 있었는데요. 사실 레벨업 해보시면 알지만 하루하루 얻는 경험치는 뒤로 가면 갈수록 쥐꼬리만큼이거든요, 근데 그게 결국 쌓여서 고렙이 되고 최종컨텐츠를 즐기면서 보상받는 매커니즘입니다.
사람들은 성장이 계단식이라고 말하지만 저는 성장은 무조건 선형적이라고 이야기하는 편입니다. 사실 관점의 차이이긴 한데 RPG에서 "레벨" 그 자체는 계단식으로 올라갑니다. 10, 11, 12... 그런데 경험치는 어떤가요? 10레벨에 10퍼.. 10.000001퍼... 10.00002퍼... 이런식으로 성장하는게 당연하고 이게 일반적입니다.
그래서 당장 성장이 눈에 보이지 않더라도 이 개념에 대한 인지가 있었기에 언젠가 성장할 내 모습을 기대하며 열심히 공부했습니다. 물론 그 과정에서 현타가 오지 않았다고 한다면 거짓말이겠지만 잘 이겨내고 여기까지 온 것 같습니다.
공부를 처음 시작했을 때와 가장 크게 달라진 점은 역시 AI의 등장이죠.
저는 제 케파를 잘 알고 있기 때문에 이 작업이 어느정도 시간을 요구하는지에 대한 직관이 나름 뚜렷한 편입니다. 그리고 그 직관은 개발 공부를 시작한지 만으로 4년이 되었던 작년 이맘때까지 유효했습니다. 이 직관은 개발 예상 소요시간을 상사에게 보고할 때 매우 유용했습니다. 그리고 보수적으로 계획을 잡아서 마감일을 지키지 못하는 경우는 단 한순간도 없었죠.
그 즈음이었죠, Cursor라는 놈이 등장하기 시작한게...
물론 AI, 특히 ChatGPT를 이용해서 나아가는 개발도 시간을 어마어마하게 단축시켜줬습니다. 특히 백엔드 개발이 아닌 서버를 만질 때 뜨는 에러는 구글링으로 핏한 에러를 찾기 힘들었거든요. GPT로 개발할 때도 속으로 '와 이거 내가 직접 개발했으면 얼마나 걸렸을까..?' 라는 생각을 할정도로 30초만에 문제를 해결해주는 이 미친놈을 보면서 감탄을 금치 못했지만 그놈이 등장하면서 판도가 바뀌기 시작했습니다.
이 커서라는 놈이 AI를 이용한 개발에서 가장 큰 문제였던 "맥락"을 이해하기 시작하면서 코딩의 판도가 달라지기 시작했습니다. 엄청나게 복잡한 로직이 아닌 이상 커서한테 맡긴게 나보다 코드 퀄리티도 좋고 속도는 거의 20배 30배씩 빨랐기 때문입니다.
예전같으면 3~4시간정도 작업해야 완료되는 결과물이 수십초안에 해결되서 결과물로 보이니 미친놈 위에 더 미친놈이 있는 느낌이었죠.
그로부터 약 1년... 이제 저보다 코딩 잘하는 에이전트들이 널리고 널렸습니다. Cursor, Antigravity, Claude Code 등등... 요즘 구글에서 나온 안티그래비티는 화면 보고 직접 버튼 클릭해보고 버그 생기면 지가 알아서 디버깅하고 개발하는거 보고 제정신이 아니라고 생각이 들 정도였죠.
그 결과, 제가 느꼈던 코딩하는 재미는 이제 AI가 다 가져갔습니다...
대신 조금 더 고차원적인 일을 하기 시작했습니다. 3~4시간 혹은 하루 종일 걸려도 모자랄 시간동안 개발해야 했던 것이 수십초안에 끝나버리니 저는 그 결과물을 보고
"네 코드는 멱등성을 고려하지 않았어 다시 개발해"
"이 LLM 답변은 우리 비즈니스랑 맞지 않아 조금 더 핏하게 대답하도록 변경해"
이런 고차원적인 일부터
"443 포트를 사용하면서 localhost:8933으로 프록시되는 nginx conf 파일 하나 만들어줘."
"스프링 부트 프로젝트를 도커 이미지로 만들거야 Dockerfile 만들어봐. 세세한건 내가 피드백 해줄게"
이런 잡일까지 AI가 수초내지 수십초안에 만들어주니 결과물만 보고 바로바로 판단할 수 있게 된 것이죠.
실제로 이직한 회사에서 AI를 적극적으로 사용하지 않으시다가 제 권유로 적극 사용하시는 과장님이 계신데 이분도 저와 같은 공감대를 형성할 수 있었습니다.
결국 코딩이라는 "노동"은 없어지기 직전입니다. 물론 조금 더 거대한 맥락이 필요하거나 세세하게 개발해야 하는 상황이거나 이상하게 개발할 때는 사람이 개입하긴 해야되지만요.
하지만 이제 더 고차원적인 "일"을 할 수 있고 이 일을 하는 재미가 굉장히 쏠쏠해서 지금 굉장히 행복하게 지내고 있습니다 ㅎㅅㅎ
생산성을 얻고 일자리를 잃다
지금 회고에선 관련없지만 이어지는 내용이 AI가 등장하면서 평소에 10명이 필요했던 일을 2~3명이서 처리할 수 있게 되면서 (개인적인 판단에 의한 수치입니다.) 기업은 일자리를 창출하지 않아도 전혀 문제 없이 돌아가고 있습니다.
기존에는 10명이서 하던 일 중 한두명 나가면 직원들의 불만이 폭발했습니다. 야근에 시달리면서 만약 식비를 챙겨주지 않는 회사는 자비로 저녁까지 사먹으면서 일을 해야했죠. 요즘은 그럴 필요가 없는 것 같습니다. 한두명 나가도 어떻게 잘 하면 돌아가니까요.
이런 글로벌 트렌드는 고용이 유연한 미국에선 대량해고로, 유연하지 않은 대한민국에선 고용감소로 반작용이 생기기 시작했습니다. 그나마 좀 있던 신입 개발자 채용이 눈에 띄게 줄어들었고 경력자도 예전만큼 많이 뽑지 않게 되었습니다.
특히 치명적인건 신입쪽인데, 제가 위에서 코딩하는 재미는 잃고 일하는 재미를 얻었다고 말했지만 취준생은 일하는 재미가 뭔지도 모르고 계속 없어지는 일자리에 불안감만 증폭될 것 같더라구요. 또한, 경력자들은 당장 먹고사는데 지장은 없지만 취준생은 그렇지도 않으니 걱정이 이만저만이 아닐 것 같습니다.
제가 취준할 때만 하더라도 "어떤어떤 기능 개발했다" 이게 스펙이 되었는데 요즘 그런건 씨알도 안먹히고 "이런거 개발했고 이 때문에 생기는 문제인 이런거 때문에 이런 방법론을 적용했습니다" 이렇게 한단계 더 나아가야 눈에 띄지 않을까 싶습니다.
마치며
회고겸 사회현상에 대해서 주저리주저리 떠들어봤습니다. 오랜만에 정리하니까 머리속이 정갈하게 청소된 느낌이라 상쾌하고 좋습니다. 이제 다음 포스팅은 요즘 공부하는 AI 엔지니어링 이론을 적어보도록 하겠습니다. (실습도 적어야하는데...)
오늘의 책 카테고리 출범
요근래 공부를 정말 열심히 했는데 얼마전 공부가 전혀 머리에 들어오지 않고 오히려 공부하기가 싫은 날이 있었다.
알고리즘 문제는 집중이 안됐으며, 영어로 된 문서들은 해석이 안되고, 인강은 귀에 들어오지 않는 이상황...
이날 나는 너무 공부를 많이한 것에 대한 반작용으로 결론짓고 공부를 하루 쉬자고 마음먹었다.
근데...공부를 쉬면 쉬는시간엔 뭘하지?
머릿속에 수많은 취미생활들이 스쳐지나갔다. 유튜브, 게임, 애니메이션, 넷플릭스 등등
근데...유튜브는 볼게 없고 게임은 한번 빠지면 헤어나오질 못해 손대기가 무섭고 애니메이션은 재밌는건 다 봤으며 넷플릭스는 시간을 오래 잡아먹으니 취미생활도 뭐하나 손에 잡히는게 없었다.
그때 문득 든 생각
"책이나 읽어볼까?"
나는 어릴때부터 책 읽는걸 싫어하지 않았고 책을 읽고 내 생각을 쓰는 독후감도 꽤나 좋아한 편이었다. 때문에 군대에서는 서평이라는 제도때문에 휴가도 책만읽어서 15일정도 땡긴 꿀제도 중 하나였다.
근데 군대에서 읽은건 휴대폰도, 컴퓨터도 없으니까 그렇게 많이 읽은거지 사실 사회에 나오니 책은 거들떠도 안보게 되었다.
그렇게 전역한지 2년정도 흐르고 책은 한권도 읽지 않았다.
전역하고 나서는 바로 칼복학하고 처음 1학기는 사회에 적응, 그 다음학기인 2학년 2학기부터 본격적으로 개발공부를 시작했고 지금까지 약 1년8개월정도 미친듯이 달렸다. 학교를 안가는 날엔 12시간이 넘도록 공부를 하고 학교를 가는 날에도 6시간정도 공부를 했다.
물론 중간에 원신에 빠져서 1개월정도 게임만 하고 살았지만...
지금의 나는 2년남짓한 시간동안 공부만 한 미친놈이다.
머리를 환기해줄만한 요소가 필요했고 책이라는 좋은 매개체가 있었다.
그렇게 다섯시간에 걸쳐 한 권을 그날 끝내고 많은 생각이 들었다.
'꽤 알찬데?' '쉬는시간에 책 읽는거 좋을지도?'
그리고 앞으로 쉬는 시간엔 책을 읽자고 다짐했다.
그렇게 책을 읽자니 뭔가 아쉬운 기분이 들었다.
그러다 오늘 문득 든 생각
'책 읽은 내용을 블로그에 정리해볼까?'
이거 엄청 좋은 생각인거같은데?
그리하여 이번 카테고리 "오늘의 책"이 출범하게 되었다.
이 카테고리에서는 쉬는시간에 읽은 다양한 책들 (분야는 가리지 않을것) 을 읽고 전반적인 내용을 정리하고 내가 느낀점에 대해서 특히 느낀점을 강조하여 포스팅을 할 예정이다.
무언가를 알려주기위한 포스팅이 아니므로 ~했다 체로 글을 작성할 예정이다.
오늘의 책, 첫 출범하겠습니다~
임홍택 저자의 "90년생이 온다"
임홍택 저자의 "90년생이 온다"를 읽었다.
군대에서 읽었던 책 중 하나이고 집 책장에 꽂아놨는데 무슨 내용인지 까먹어서 다시 읽은 책이다. 사실 군대에서는 서평에 미쳤어서 내용은 딱히 중요하게 생각 안하고 읽었던 터라 그랬던 듯 하다.
내용은 제목 그대로 90년생이 온다는 내용이고
도입부는 공시생이 역대 최대를 찍었다는 내용으로 시작한다. 합격률은 1.8퍼센트 하지만 응시자는 30만명이 넘어가는 이 상황, 무엇이 90년생들을 이렇게 몰아넣었을까 하는 의문으로 이 책은 시작된다.
이 책에서는 세대를 어떻게 나눌 것인지 기준을 세우고, 90년생들이 처한 현재 상황, 90년생의 특징, 90년생이 사회로 나온 지금 기존 세대들과 갈등이 생긴 원인, 90년생이 주 소비층이 되는 사회에서 눈여겨봐야할 점 등을 다루고 있다.
내가 90년생이기 때문에 몰입해서 읽었던 것 같다. (90년 후반이긴 하지만...)
책의 전반적인 내용을 다루면 끝도 없기때문에 간략하게 90년생들의 특징만 짚고 넘어가도록 한다.
90년생의 특징은
• 간결함
• 재미
• 정직함
이렇게 세가지로 정의할 수 있다.
간결함
90년생은 어릴 때부터 스마트폰을 접했던 세대이다. 그렇기 때문에 영상매체, 그리고 카카오톡의 등장으로 줄임말, 이모티콘의 사용이 매우 익숙한 세대이다.
영상매체, 줄임말, 이모티콘 이 세가지 것들의 특징은 바로 간결함이다. 책에서 읽어서 얻을 정보를 10분짜리 영상으로 얻고, 길게 설명해야 할 감정이나 단어를 ㄹㅇㅋㅋ 로 줄여버리고, 이모티콘만을 이용해 대화하는 경우도 심심치않다.
이러한 90년생의 특징은 글읽기에서도 두드러진다. 60년생, 70년생, 80년생, 90년생을 아이트래커를 장착한 뒤 웹서핑을 시켜봤다. 90년생의 특징은 바로 F자로 읽기이다. 제목, 부제목만 빠르게 읽고 내가 원하는 정보인 경우에만 해당 섹션을 읽는다. 이것 역시 90년생의 간결함이라는 특징에 기반한 결과이다.
이런 특성을 가지고 있기 때문에 효율적인 것을 좋아한다. 특히 효율적인 소비를 즐기는 편이며 호갱이라는 단어의 출현으로 효율적인 소비와 호구잡히는 소비를 철저히 나눠 그들만의 사회를 이룬다.
일을 할 때도 효율성을 추구한다. 같은 일을 하더라도 좀 더 효율적으로 움직이려고 노력하는 나이대가 바로 90년생이다.
이렇게 효율을 따지기 때문에 기존 세대들의 보여주기식 업무나, 정해진 출근시간에 집중해서 일하고 칼퇴하는 상황이나, 연봉을 좀만 더 좋게 주는 직장이라면 과감하게 퇴사하는 상황때문에 기존 세대와 갈등이 생기기도 한다.
재미
90년생은 "병맛"이라는 단어의 출현으로인해 재미있는 상황을 매우 좋아한다. 재밌기만 하면 광고라고 대놓고 붙여놔도 본다. 그리고 취직공고에 "순댓국 좋아하는 사람 우대" 라는 병맛 소개글에 환호한다.
재미를 추구한 나머지 기존 세대들은 생각지도 못한 일에서마저도 재미를 찾으려고한다. 기왕 일하는거 재밌게 하면 좋지 않겠어? 라는 모토때문에 기존 세대와 갈등이 빗어지기도 한다.
실제로 우리 친누나한테 이러한 특징을 설명해줬더니 본인은 재미없는 일은 손도 안댄다고 하는 다소 충격적인 대답이 들려왔다.
하지만 나도 재미를 추구하고 지금 하는 개발 공부도 재미있기 때문에 계속 하고있다. 재미만 있으면 조금 오래 걸려도 계속 들이파는 편
정직함
90년생에게 정직함은 honest의 정직함이 아닌 integrity 즉 무결성 쪽에 가깝다. 때문에 학연, 지연, 혈연은 적폐 대상이다. 공채를 보더라도 블라인드 채용을 매우 선호하고, 기업의 횡포나 부조리함을 참지 못한다. 그리고 이것은 곧 불매로 이어진다.
남양유업 불매, SPC 빵 불매, 알뜰 통신사 사용, 용산 전자상거래 불매 등등 이 모든 상황에는 90년생이 중심에 자리잡고 있다.
실제로 90년생때문에 그런건진 모르겠지만 위의 예시만 하더라도 점점 쇠퇴하는 모습을 보여준다.
느낀점
저자가 젊은 사람이라 그런지 90년생의 특징을 정확히 꼬집은 듯 했다. 내 상황과 절묘하게 맞아 떨어졌고 내가 가진 속성들이 전부 다 들어가있는 상황에 웃음이 절로 지어졌다.
특지 90년생의 특징 중 하나인 정직함에 더 공감이 많이 됐다. 아무래도 소비자의 권리이기도 하고 웬만하면 착한 기업을 소비하자는 분위기가 기본적으로 깔려있기 때문에 이러한 정직함은 90년생을 나타내는 특징임에 틀림없다.
00년생도 이제 슬슬 성인이 되고 사회에 진출하기 시작하는데 00년생도 90년생과 비슷한 어린시절을 경험하고 성장배경도 비슷해 아마 전체적으로 비슷하지 않을까싶다.
아이돌도 조금만 트롤링을 하면 바로 사장시켜버리고, 학교폭력 가해자였다는 얘기만 들리면 바로 사장시켜버리고, 어느 기업이 성폭행을 눈감아줬다고 하면 바로 불매해버리고 이런 민감한 주제에 잘못이라고 당당하게 말하고 공론화 하는 모습이 정의의 사도같아 멋있어 보일 때도 있다.
이런식으로 잘못을 잘못이라고 말하는 사람이 어디에나 필요한 것 같다. 한편으로는 프로 불편러라고 까내리기도 하지만 프로불편러소리 들으니까 그냥 조용히 있어야지 라고 하면 악덕 기업은 "아무도 뭐라 안하네?" 라고 생각하고 더 악행을 저지를 것이 분명하다.
같은 90년생으로서 참 공감이 많이되는 책이었던 것 같다.
다음 책으로 점 찍어 둔 것은 사티아 도일 바이오크 저자의 "어른의 중력"이다. 다음 쉬는시간에도 꼭 읽어보도록 할 것이다.
사티아 도일 바이오크 저자의 "어른의 중력"
나는 이 책을 유튜버인 '너 진짜 똑똑하다' 님의 영상을 보고 추천받아서 읽기 시작했다. 이 책의 첫 인상은 생의 1/4 승강장에 도착한 어린 어른을 위한 심리학이라는 표제이다.
20대 / 40대 / 60대 / 80대
사회에 던져진 후 겪게 되는 네개의 단계 중 첫 번째 단계에 들어선 어린 어른들을 위한 심리학이라는 뜻이다.
저자는 도입부에서 가장 힘든 세대는 어디일까? 에 대한 대답으로 자신있게 20대라고 피력한다. 그러고보니 20대는 갑자기 사회에 툭 하고 떨어진 세대이다.
기성세대는 의무교육이라는 이름아래 청소년들을 가르치지만 시험에서 높은 점수를 받는 방법이나 사회성을 길러줄지언정 정말로 사회에서 필요한 기술들은 가르쳐주지 않는다.
예를 들어서 부모로부터 독립할 때 부동산은 어떻게 처리해야 하는지, 세금은 어떻게 내는지, 보험은 어떻게 청구하는지, 회사를 간다면 계약서에서 중요하게 봐야하는 부분은 어디인지 이런 것들이 하나도 학습되지 않은 상태에서 사회가 정해놓은 틀에 젊은 청년들을 맞춰 그들의 가치를 판단한다.
이렇게 사회가 정해놓은 틀에 젊은 청년들을 가두면 가둘수록 그들은 더 길을 잃기 쉬워진다. 저자는 기성세대들의 "그나이가 되면 부딪히면서 배우는거야" 에 대해 정면으로 받아치며 우리는 이런 젊은 청년들을 위해 인생에서 정말 필요한 지식을 가르쳐야한다고 역설한다.
또한, 저자는 인생의 1/4 승강장에 탄 어린 어른을 '쿼터 라이퍼' 라고 정의하고 이들에 대한 기본적인 성질과 함께 이들을 어떻게 기성세대로서 이끌어 나가야 하는지, 사회의 일원으로 받아들일지에 대한 방법론에 대해 심리학적으로 접근해 풀어낸다.
저자는 모든 사람을 삶에서 의미를 추구하는 '의미형'과 삶의 안정을 추구하는 '안정형'으로 나누어 정의한다.
의미형은 돈에 쫒기는 삶을 혐오하며 어른들이 말하는 안정적인 삶을 구축하는 것에 큰 반발감을 느낀다. 이들은 인생을 살아가는 방법으로 삶에서의 의미를 추구하며 때로는 안정형인 사람을 깔보거나 무시하기도 한다.
안정형은 인생을 살기위해 첫 번째로 해야하는 일이 바로 안정적인 삶을 구축하는 것이라고 믿어 의심치않는다. 이들은 인생을 살아가는 방법으로 삶에서의 안정을 추구하며 때로는 의미형인 사람을 깔보거나 무시하기도 한다.
<느낀점>
이 책에서 가장 인상깊은 점은 모든 사람을 2가지로 이분화해서 정의한다는 것이다. 16개로 나누는 MBTI도 인간을 어떻게 16개로 나누냐면서 싫어하는 사람이 있는데 이걸 2개로 나눈다는게 참 재밌었다.
때문에 이런 이분화된 생각들이 이 책의 가장 큰 장점이 되기도 하지만 가장 큰 단점이 되기도 한다. 이것이 큰 장점이 되는 것이 큰 틀에서 본다면 이 두가지 개념은 너무나도 잘 맞아 떨어진다. 디테일하게 들어가면 맞는것이 별로 없어도 큰 틀에서는 모든 현상을 설명할 수 있다. 하지만 단점이 있다면 마치 모든 현상을 남자와 여자로 나눠서 넌 남자니까 그래 넌 여자니까 그래 라는 듯이 판단해버려서 때로는 말이 안되는 경우도 생긴다.
보통 사람은 중간에 머무는 사람은 없다. 주도적으로 뭔갈 이끌어가는게 좋은사람과 수동적으로 끌려다니는 것이 더 좋은 사람, 가장 이상적인 사람의 형태는 중간이지만 나는 아직까지 살면서 이 둘 중 중간에 머물러 있는 사람을 본적이 없다.
마찬가지로 책에서 설명한 의미형과 안정형에 이 개념을 대입해보면 사람은 극단적으로 한곳에 머물러있기 마련이다. 하지만 저자는 의미형과 안정형 모두가 삶에서 필요하다고 강조하는데 이를 포도주와 와인잔으로 묘사한다. 포도주만 있으면 술로서 의미가 없고, 와인잔만 있으면 술잔으로서 의미가 없으니 이 둘은 서로가 서로를 보완하는 관계라는 것이다.
즉, 삶에서 의미도 찾아야하며 안정적인 삶 또한 구축해야 한다. 근데 이게 말이 쉽지 과연 될까...싶기는 한데 무작정 안되는건 아니니까 모두 시도해보면 좋을 것 같다.
나는 의미형과 안정형을 하고싶은 것과 해야하는 것으로 다시 재정의 하고싶다. 보통의 사람은 하고싶은 것과 해야하는 것이 다른 경우가 많기 때문에 책에서 설명하는 다양한 문제에 휩싸이는 것 같다.
나의 경우는 운이 매우 좋은 편이라고 할 수 있는데, 하고싶은것이 해야하는것과 일치하며 그 결과물이 삶의 안정을 가져다주기 때문에 나는 책에서 얘기하는 문제에 해당하지 않는다.
만약 이 글을 보고 있는 사람이 하고싶은 일과 해야하는 일 사이에서 고민하고 있다면 이 책을 추천하고싶다. 확실한 해답을 내놓는 책은 아니지만 방향성 정도는 정립해줄 수 있을만한 지침서와 같다.
로버트 C 마틴의 클린코드와 클린코드에 대한 논란
객체지향의 5대원칙 SOLID를 만들었다고 전해지는 로버트 C 마틴이 쓴 책 클린코드를 읽어봤습니다.
취업 준비때는 바빠서 취직하고는 책읽을 시간이 없어서 책 읽는 것을 소홀히했는데, 반성하며 읽다만 클린코드를 읽었습니다.
책에서는 객체지향을 위해 클린코드를 어떻게 작성해야하는지에 대한 가이드라인이 나와있습니다.
함수는 어떻게 작성해야 하는지, 주석은 어떻게 달아야하는지, 클래스는 어떻게 작성해야하는지 등등에 대한 내용이 들어있습니다.
그런데 저자가 표현을 좀 강력하게해서 일부 오해의 소지가 있는것 같습니다.
어떤 유튜버가 영상에서 클린코드를 무조건 맹신하면 안된다면서 "함수 하나에 하나의 책임만을 가지고 각각의 책임들을 함수로 빼야한다." 라는 말을 했는데 이를 오해한 사람들이 모든 함수를 다 빼라고? 코드는 클린해질지라도 가독성은 개나줘버리겠는데? 이런 느낌으로 영상을 제작하였습니다.
하지만 이는 제가 봤을 때 저자의 의도를 잘못 해석한 것 같습니다.
함수로 책임을 분리하되 함수 이름을 정확히 어떤 일을 하는지 명시적으로 적어 코드를 직접 보지 않고도 이 함수의 책임이 뭔지 예측가능하도록 하여 가독성을 높인다고 나와있습니다.
즉, 코드를 보면 이런 느낌이겠죠.
public void payment(MemberRole role) {
boolean isLogin = loginCheck();
if (!isLogin) {
throw new IllegalStateException("로그인을 진행해야합니다.");
}
boolean isBalanceOver = checkBalance();
if (!isBalanceOver) {
throw new IllegalStateException("잔액이 부족합니다.");
}
paymentLogic(role);
}
private boolean loginCheck() {
}
private void paymentLogic(MemberRole role) {
}
private boolean checkBalance() {
}
영상에선 이렇게 말하더군요. "이러면 왔다갔다 해야해서 가독성이 더 떨어진다". 음... 과연 그럴까요? 남이 내 코드를 본다고 가정을 안하고 개발하시는게 티가 많이 나더군요.
남의 코드를 보고 이해해야 하면 저렇게 굳이 왔다갔다 안합니다. 왜냐? 난 결제로직만 보고싶은데 굳이 로그인 체크나 잔액 체크하는 로직까지 볼까요?
오히려 로그인 체크, 잔액 체크, 결제로직이 하나의 메서드에 다 담겨있으면 어떤게 결제로직이고 어떤게 로그인 체크인지 주석이 없으면 확인하기 정말 힘듭니다.
결제 로직을 봤다가 로그인 체크 로직을 봐야하면 어떨까요? 그럼 다시 로그인 체크 메서드를 보면 됩니다.
또한, 주석 부분도 마찬가지입니다. 저자는 "주석을 달지 말아라 주석은 거짓말을 한다. 주석을 달 필요 없을 정도로 변수명이나 메서드명, 클래스명을 잘 지어라" 라는 말을 합니다.
보통 비즈니스 로직은 변경이 잦고 주석은 거의 변경하지 않기 때문에 나중에 비즈니스 로직과 주석이 서로 다른 얘기를 하는 경우가 있습니다. 이를 저자는 "주석은 거짓말을 한다" 라고 표현한 것이구요.
이를 "클린코드에서 주석을 달지 말래 미친거아니냐?" 라고 해석하시면 곤란하다는 것입니다.
마치며
제 기준에서 클린코드라는 책은 생각이 많아지는 책이었습니다. 내 코드는 클린한가? 라는 생각이 들게하는 책이었습니다.
또한, 이 책을 읽고 공교롭게도 유튜브에 평소 보던 유튜버 분이 이 책에 대해 올린 영상을 봤는데 제 생각이랑 완전 반대되는 내용의 영상이라 개인적으로 저자의 의도를 정확히 이해하고 만든 영상은 아닌 것 같다... 라는 생각이 들었습니다.
평소에 자주 보던 유튜브 채널이었는데 트위터에선 많은 개발자분들이 이 유튜버분을 싫어하시더라구요. 그런거랑 별개로 내용이 재밌어서 봤던건데 이 영상을 계기로 저도 좀 마음이 멀어진 것 같네요.
사실 책이란건 사람마다 느끼는 바가 다르기 때문에 제가 뭐라 말할 수 있는 영역은 아닙니다만, 영상을 보는 사람들에게 직접 책을 읽어보고 판단하게 하는 것이 아니라 마냥 책을 비판하기만 하면 실제 저자의 의도가 제대로 전달되지도 않은채 저 책은 좀 잘못됐다던데 하는 생각이 들게 만드는 것은 바람직하지 않다고 생각합니다.
요즘 책을 읽으면 고등학교때 국어 공부좀 해놓을걸 하고 후회하게 됩니다. 개발 도서나 블로그 글을 보면서 저자의 의도를 이해하는게 쉽지않더라구요.
아무튼! 저는 개인적으로 굉장히 재밌게 본 책입니다. 물론 맹신하면 안됩니다. 자신만의 코드 컨벤션을 지켜가면서 참고만 하는 정도로 읽으면 좋을 책이 될 것 같습니다.
토노니의 "의식은 언제 탄생하는가?"를 읽고 느낀 AI 의식 유무에 대한 고찰
안녕하세요! 한달만에 글을 쓰게 됐네요. 요즘 제주도 파견가랴 대학원 다니랴 이래저래 바빠서 글 쓸 시간이 없었네요. 오랜만에 쓰는 글이기도 하지만 "오늘의 책" 카테고리에 글을 얼마만에 써보는지 모르겠네요. 찾아보니 마지막으로 글 쓴게 2024년 4월이니 2년만입니다.
유튜브를 돌아다니다가 어떤 영상이 눈에 띄더라구요. 평소에 관심있었던 주제였는데 바로 "AI에게 의식이 있을까?"라는 제목의 영상이었습니다.
이 주제에 항상 의문이 있었고 제미나이하고도 이 주제에 대해서 여러번 대화를 했습니다. 근데 하나같이 두루뭉술한 결론만 남게되고 시원하게 답을 하진 못했습니다. 하지만 그럼에도 깊이있게 알아보려고는 하지 않았는데 그것이 제 호기심을 자극하지 않았기 때문일까요?
그러다가 이번에 우연히 유튜브 영상을 계기로 본격적으로 알아보기로 마음먹었습니다.
[저자소개]
마르첼로 마사미니, 줄리오 토노니는 뇌과학자이며 신경과학자입니다. 그리고 의사이기도 하죠. 이들은 본인들의 연구분야를 살려 뇌에 손상을 입은 환자들을 치료하고 연구하며 논문을 수차례 쓴 연구자들입니다.
그들이 뇌에 손상을 입은 환자를 봤기 때문일까요? 다양한 환자를 보면서 의문이 들었던 것 같습니다. "의식이란 어디에서 오는가?"
물론 우리는 당연히 "뇌에서 의식이 있죠"라고 얘기할 수도 있지만 이들은 정확히 의식이 발현되는 기작을 찾아보기 위해 "정보통합이론"이라는 새로운 분야를 개척합니다.
[주요 내용]
책을 시간 순서대로 풀어내면 양이 너무 많아지니 핵심만 이야기하자면. 어떤 물체 혹은 생물이 의식이 발현되기 위해서는 두 가지 조건이 필요하다고 저자는 이야기합니다.
의식이 있다면 해당 물체 혹은 생물은 상태값을 가져야합니다. 예를 들어서 주사위는 1부터 6까지 상태를 가지고 광다이오드는 켜짐과 꺼짐이라는 두가지 상태를 가지는 것이죠.
그리고 가장 중요한 의식의 발현 기작은 이 상태(정보)를 통합하는 과정에서 생깁니다. 위의 예시에서 주사위를 예로 들면, 주사위에 만약 의식이 있다면 "이번에 1이 나왔으니 다음엔 3이 나왔으면 좋겠다" 처럼 이전 결과가 다음 결과에 영향을 미치고 서로 상호작용 해야한다는 것입니다.
위의 설명은 아주 간단한 버전의 설명이고 저자는 이 설명을 디테일하게 대뇌피질과 소뇌의 특징으로 풀어냅니다.
뇌에서 가장 복잡한 구조를 가지고 있는 곳이 어딜까요? 바로 소뇌입니다.
소뇌는 뉴런의 80퍼센트가 위치해있을 정도로 굉장히 많은 수의 뉴런이 존재하는 곳입니다. 소뇌는 우리 몸의 근육을 제어하는 뇌 부위로 잘 알려져있고 소뇌가 다른 동물보다 월등히 발달한 인류는 이 덕분에 아주 세밀한 근육 컨트롤이 가능하게 되었습니다. 보통 머슬 메모리로 이야기되는 것들이 소뇌 덕분이라고 볼 수 있습니다.
그런데 소뇌에 문제가 생겨서 제거한 사람, 선천적 장애로 소뇌에 문제가 있는 사람들은 몸을 세밀하게 움직이는건 불가능하지만 감정은 온전히 가지고 있습니다. 슬픔, 즐거움, 행복 등 인간의 다양한 감정을 느낄 수 있죠.
반면, 대뇌피질은 뇌의 겉에 위치한 가장 표면적이 넓은 부위이지만 뉴런이 많이 분포해있지는 않은 뇌 부위입니다. 그만큼 복잡하진 않지만 모종의 이유로 대뇌피질에 문제가 생긴 사람은 정상적으로 걷고 움직이고 세밀한 근육 컨트롤이 가능하지만 인간이라면 응당 느끼는 "감정"이 빠져있습니다.
저자는 이런 차이를 파악하고 더 나아가 대뇌피질과 소뇌의 동작원리를 연구하였습니다.
대뇌피질의 핵심 동작 원리는 "순환"입니다. 소뇌의 핵심 동작 원리는 "병렬"이구요. 대뇌피질은 각 뉴런들이 서로서로에게 영향을 주면서 판단을 증폭시킵니다. 그리고 소뇌는 한번에 많은 동작을 수행할 수 있도록 발달했습니다.
이에 대한 가장 간단한 예시는 "눈"이라는 감각기관이 물체를 판단할 때와 소뇌가 근육을 움직일 때를 보면 됩니다.
눈이 컵을 보면 뇌는 이런 단계를 거칩니다.
"뭔가 있다" -> "손잡이가 달렸다" -> "저거랑 비슷하게 생긴거 기억속에서 찾아와" -> "컵이다"
이렇게 판단을 증폭하면서 결과적으로 판단을 합니다.
반대로 소뇌가 근육을 움직일 때를 생각하면 소뇌는 병렬일 수밖에 없습니다. 왜냐하면 팔만 구부렸다 폈다만 해도 이두근이 수축할 대 삼두근은 이완, 이두근이 이완될 때 삼두근은 수축. 이 모든 동작이 병렬적으로 일어납니다. 이런 단순한 동작도 이럴진데 악기를 연주한다거나 운동을 하는 과정은 더 많은 근육이 병렬적으로 움직여야하죠.
그리고 소뇌의 근육 컨트롤은 병렬이면서 동시에 순방향입니다. 근육이 움직이는 과정을 생각하면 그럴 수 밖에 없어보입니다.
이를 바탕으로 생각해볼 수 있는 점은 소뇌는 대뇌피질에 비해 엄청나게 많은 상태값을 가지지만 각각이 병렬이며 순방향이고 대뇌피질은 상태값을 많이 가지진 않지만 각각의 뉴런들이 순환하며 서로에게 영향을 준다는 점입니다.
하여, 결론적으로 저자는 이렇게 결론짓습니다.
"의식의 최소 발현 조건은 상태값을 가지며 각각의 상태값이 서로에게 영향을 주면서 순환해야한다."
AI에게 의식이 있을까?
이제 제가 궁금했던 최초의 질문으로 돌아와서, AI에게 의식이 있을까요?
토노니의 정보통합이론에 따르면 AI는 의식이 없습니다.
다시 한번 결론을 상기하면 의식의 발현 조건은 "상태값을 가질 것" 그리고 "각 상태값이 서로에게 영향을 줄 것"
AI가 돌아가는 그래픽카드 서버는 엄청나게 많은 상태값을 가지지만 각 상태값들이 서로에게 영향을 주는 것은 아니므로 의식이 없는 것입니다.
엄청나게 많은 상태값, 상태값들이 서로에게 영향을 주지 않는 병렬에 특화되어 있으며 순방향으로만 흐르는 논리인 그래픽카드 서버는 토노니가 분석한 "소뇌"에 해당하는 부분이 되는 것이죠.
결론
토노니의 정보통합이론 역시 깔끔하게 증명된 이론은 아닙니다. 그래서 이 이론이 정답이다! 라고 말할 수는 없지만 제가 평소에 궁금해하던 부분을 꽤 많은 부분 설명해주어 맞다 아니다를 떠나 굉장히 재밌게 본 책 중 하나로 기억될 것 같습니다.
저자가 책을 쓸 당시인 2012년엔 AI가 등장하지 않았지만 책에선 슈퍼컴퓨터 "왓슨"을 예로 들어 설명하기에 오늘날 AI에 이를 빗대어 봐도 전혀 무리가 없습니다. 결론은 똑같으니까요.
사실 이 책은 정보통합이론을 설명하는 책은 아닙니다. 한 권의 뇌과학 책이라고 보는게 맞는데요. 그럼에도 AI를 공부하는 사람에게 큰 울림을 주는 책이라고 생각합니다. 적어도 AI에게 인격을 부여하진 않을테니까요.
AI와 사적인 그리고 철학적인 대화를 하다보면 "혹시...", "어쩌면..." 이런 생각이 들곤했는데요. 트랜스포머 알고리즘을 뜯어보면 제 생각은 인간의 뇌를 모방했지만 결국 "통계학론적 앵무새"라는 쪽에 무게가 더 실릴 것 같습니다.
책을 사서 동네 카페에서 읽었더니 정말 쉬는 느낌도 들고 너무 좋았습니다. 또 읽고싶은 책이 생기면 다음 포스팅으로 돌아오겠습니다. 긴 글 읽어주셔서 감사합니다. 오늘도 즐거운 하루 되세요!
이 카테고리를 만들게 된 이유
최근에 너무 안풀리는 문제가 생겨서 구글링하다 하다 안되길래 질문을 올렸다. 이번에도 역시 오키랑 네이버 지식인이었다. 내가 여태껏 겪었던 문제들은 오키나 네이버 지식인 선에서 끝났는데 이번 문제는 정말 올게 왔다. 좀만 복잡해지니까 사람들이 답글도 안달고 나혼자 붕떴다.
그래서 외국 개발자의 힘을 빌어보기로 마음 먹었다. 영어가 문제라 엄청 걱정했는데 파파고가 대부분 일을 처리해준다. (파파고 없었으면 큰일날뻔...)
하지만 번역기도 번역기일뿐 읽고 쓰고 듣고 말하기 넷중에 제일 잘하는 읽기는 어느정도 커버가 되었다. 기본적인 문장이나 질문 답글정도는 읽고 해석할 수 있다. (고등학교때 공부 좀 해놓길 잘했다 휴..) 문제는 쓰기... 듣고 말하기는 바라지도 않으니까 작문 실력을 늘렸으면 좋겠다고 생각했다.
그래서 등장한 이 카테고리!
내가 질문을 올려야할 일이 생기거나 공식문서를 참조하다가 발생하는 다양한 영어들을 정리할 예정이다.
크게보면 작문인데 정확히는 이러한 과정을 통해 작성된다.
case1) 스택오버플로우에 질문할게 생겼다.
1. 우선 내가 말하고 싶은 내용을 한글로 적는다.
2. 내 나름대로 작문을 시도한다. 좀 오래걸려도 괜찮다.
3. 파파고에 넣어서 영어로 바꾼다.
4. 내 작문과 파파고의 작문을 비교한다.
5. 피드백한다.
case2) 공식 문서를 읽다가 or 스택오버플로우를 읽다가 모르는 단어가 등장했다.
1. 단어 뜻을 찾아본다.
2. 해당 단어로 간단한 문장을 한글로 적는다.
3. 내 나름대로 작문을 시도한다.
4. 파파고에 넣어서 영어로 바꾼다.
5. 내 작문과 파파고의 작문을 비교한다.
6. 피드백한다.
대충 이런 플로우로 게시글이 작성될 예정이니 나만의 단어장이라고 생각하면 된다. 해당 게시글을 보는 사람들은 뭐야 얘는 하고 넘겨주시면 감사하겠다.
2022-08-23 영어공부
실제로는 로그가 Opening Web Socket 에서 멈춰있다.
Exactly log is stopped "Opening Web Socket"
-> Exactly, the log is stopped in the "Opening Web Socket..."
comment : ~에서를 in을 쓰기도 하는구나 처음알았다.
구글에서는 나와 같은 경우를 찾지 못했습니다.
In Google I couldn't found as my case
-> I couldn't find the same case as myself on Google.
comment :
1. could라는 과거형을 썼으면 found라는 과거형을 또 쓸필요가 없었다.
2. 나와 '같은' 에서 '같은'이 as라는 것을 잘 캐치했다.
SockJS에서 가져온 객체의 로그를 찍어봤는데 connected 속성이 false가 찍혔습니다.
when write log that bring at SockJS, In log connected property is false
-> I wrote down the log from SockJS and the connected property was false.
comment : 과거였는데 현재로 썼다.
콘솔에 적힌 로그와 내 코드를 첨부하겠다.
log in console and my code is 첨부
-> I will attach the log and my code written on the console.
comment : 첨부하다가 attach를 쓰는구나
----------
*optimize
원래 내가 알고있던 뜻은 낙관적인 이라는 뜻이었다. 근데 이런 문장을 발견했다. chunk of items in order to optimize writes (여기서 chunk는 스프링 배치에서 트랜잭션을 이루는 단위) 파파고에 돌려보니 쓰는것을 최적화하기 위한 아이템 chunk 라고 되어있었다. optimize의 실제 뜻은 '최대한 좋게 하다'라는 뜻이었다. 그러니까 최적화라고 해석할 수도 있는 것이다.
내가 최적화하기 위해 노력한 로직이 5분에서 1분으로 줄어들었다.
logic trying to optimize is shorten from 5 minutes to 1 minuite
-> The logic I tried to optimize has been reduced from 5 minutes to 1 minute.
comment :
1. try to를 생각 해낸건 칭찬해야겠다.
2. 줄어들다를 is shorten 대신 reduce가 더 이쁜거같다. (그냥 딱보면 너무 쉬운 단어인데 생각나지 않았다는게 포인트이다)
3. is 대신 has been 을 썼는데 has been 을 파파고에 돌려보니 '되었습니다' 라고 한다. 음...~됐다 라고 할때 쓰면 좋을 것 같다.
4. 명사를 꾸며줄 때 나는 분사를 자주 쓰는 것 같다. 근데 파파고를 많이 돌려보니까 that 절을 더 많이 쓰는 것 같다. (which도 많이 쓰더라)
---------
당신의 노고 덕분에 스프링 배치에 대해 많은 것을 알게 되었다.
For your effort, I knew a lot of thing of spring batch
-> Thanks to your hard work, I learned a lot about spring batch.
comment :
1. ~덕분에를 For를 썼는데 말은 되는거 같은데 파파고가 해석한 Thanks to 가 더 공손해보인다.
2. 알게 되었다에서 앗 되었다? 과겨형! 까진 좋았는데 파파고는 knew 가 아니라 learned를 썼다. knew도 말은 되는것 같은데 뭔가 어감차이인것 같다. 아직은 이런 어감 차이까지는 잘 모르겠다. 음...예상컨데 knew는 알다 이고 learned 는 배우다니까 한국말로 번역해도 어떤 느낌인지는 알것 같다.
3. 노고(고생)을 effort를 썼는데 effort는 노력이라는 뜻이다. 당신의 노력 덕분에? 한국말도 뭔가 이상하다. hard work 가 좀 더 깔끔하고 이쁜 것 같다.
고마워 한번 확인해보고 적용해볼게
Thank you, Checking once and apply it
-> Thank you. I'll check and apply it
comment : 주어 동사 기본적인 구조를 까먹지 말것
*coressponding
원래도 뜻을 모르고 있던 단어였다. 근데 막상 보고 그냥 넘어가서 잘 몰랐는데 이참에 공부해야겠다. coressponding은 한국말로 '응답'
해당 html 파일은 응답속도가 10ms인데 내건 왜 이렇게 느리지?
This html file's coressponding speed is 10ms but mine is why so late?
-> The HTML file has a response speed of 10ms, but why is mine so slow?
comment : 여태 했던 작문중에 가장 깔끔하고 좋았던 것 같다. 마지막 late는 지각하다인데... 어쩌다보니 이렇게 쓰게 됐네.. 암튼 저거만 고치면 완벽할 것 같다.
2022-08-24 영어공부
mysql을 재시작했는데 내 데이터베이스가 모두 사라졌다.
when mysql restart, databases which I made are gone
(mysql을 다시 시작하면 내가 만든 데이터베이스가 사라진다.)
-> I restarted mysql and all my databases disappeared.
comment : 나는 when절로 시작했는데 파파고는 평문으로 시작했다. 이게 무슨 차이인지 잘 모르겠지만 이번엔 내가 쓴것도 나쁘지 않아 보인다.
네가 무슨말을 하는지 완벽하게 이해했다.
I undertand that you saying perfectly
(나는 네가 말하는 것을 완벽하게 이해한다.)
-> I totally understand what you're saying.
comment :
1. perfectly를 totally로 썼는데 이 부분은 넘어가 될 듯하다.
2. 네가 말하는 '것'을 이니까 that 이하를 이해했다 라고 하는것보다 what you're saying 이 더 자연스러워 보인다.
3. '네가 말한' 이 you saying이 아니고 you're saying are을 빼먹었다.
그러니까 Bean으로 생성하면 스프링은 singleton으로 만들어서 한번 만들어놓고 나면 더이상 해당 메서드를 실행할 수 없다는 말이지?
So when Spring make bean with singleton and this method dosen't execute anymore right?
(그래서 스프링이 싱글톤으로 Bean을 만들 때 이 method는 더 이상 실행되지 않는 거죠?)
-> So if you create it with Bean, you can make the spring with singleton, and once you make it, you can't run the method anymore, right?
comment :
1. 앞 부분은 내가 더 잘 만든것 같다. 뒷 부분은 수정해야한다. '한번 만들어 놓고 나면' 이라는 문장을 어떻게 해야 할지 몰라서 생략했는데 once you make it 이라고 쓰면 될 것 같다.
2. '성생하면' 이라는 단어를 make 말고 마땅히 생각이 안나서 파파고로 돌려보니까 generate라는 단어를 쓰면 될 것 같다.
3. 그래서 최종적으로 나온 문장은 이것이다. So when Spring generate bean with singleton and once I make it, I can't run the method anymore, right?
나는 JobLauncher로 실행하면 메서드가 계속 실행됐으면 좋겠다고 생각했다.
I think that when JobLauncher execute, method I made is execute everytime
(JobLauncher가 실행될 때 내가 만든 메서드는 매번 실행됩니다.)
-> I thought that I would like the method to continue to run if I run it with JobLauncher.
comment :
1. 이번엔 완벽하게 번역기한테 졌다. 내가 만든 문장보다 압도적으로 좋았다.
2. '생각했다.' 는 과거형이다. 따라서 think가 아니라 thought를 써야한다.
3. '좋겠다고' 부분을 빼먹었다. 파파고는 would like를 썼다. 내가 작문한 번역을 살펴보면 내가 원하는 문장은 아니라는 것을 알 수 있다.
4. '계속 실행되다' 라는 부분을 execute everytime 이라고 했는데 이것도 맞는 작문인 것 같다. 하지만 파파고는 continue to run 이라고 작문했다. 둘 다 괜찮아 보인다.
5. 작문을 하려고 할 때 서술어를 더 초점에 맞춰서 작문하면 좋겠다고 생각했다.
너의 말을 참고해서 Job, Step, Reader, Processor, Writer에 달려있는 모든 @Bean을 제거했다.
I remove @Bean attaching Job, Step, Reader, Processor, Writer what you're saying
(나는 @Bean attaching Job, Step, Reader, Processor, Writer를 제거한다.)
-> I removed all @Bean that attach the Job, Step, Reader, Processor, and Writer with reference to your words.
comment :
1. 제거하다를 생각을 못했다. remove는 정말 쉬운 단어인데 생각이 안나는것을 보면 내가 작문을 더럽게 못하긴 하나보다.
2. '모든' 이라는 단어를 빼먹었다. 단어 하나하나를 작문하기 위해 노력해야겠다.
3. '제거했다.' 는 과거형이다. 그래서 removed가 맞는 표현이다.
4. '~에 달려있는'을 attaching이라고 작문했는데 파파고에 돌려보면 부착하다 라는 뜻이다. 음...어찌보면 맞는 말이긴 한데 너무 직관적이라고 해야하나 좀 별로다.
5. cf) attaching 은 붙임성 좋은 이라는 뜻이다. (그럴듯해)
6. '너의 말을 참고해서' 부분이 what you're saying 이라고 작문했는데 확실히 아닌것 같다. 네가 말한것 이라는 뜻인데 음... 화깃ㄹ히 아니다.
그렇게 하고 실행했더니 내가 원하는대로 동작하기 시작했다.
And so on execute, It started to operate which I want
(그리고 실행하자마자, 그것은 내가 원하는 대로 작동하기 시작했다.)
-> After doing so and implementing it, it started to work as I wanted.
comment :
1. 내가 작문한 문장중에 가장 내가 원하는대로 작문이 된것 같다. 아주 뿌듯하다.
2. 파파고는 '그렇게 하고 실행했더니' 부분에서 After doing so 라고 작문했다. 이 부분이 좀 더 깔끔한 것 같다.
3. '실행' 을 나는 execute라고 썼는데 파파고는 implementing이라고 했다. execute를 파파고에 돌려보니 '처형하다' 라고 나왔다. 음... 확실히 execute를 많이 썼었는데 그만 써야할 것 같다. 앞으로는 implement 를 써야겠다.
4. start to 를 생각해낸건 정말 잘한 부분이다.
5. 이 작문은 내가 쓴 것을 채용해야겠다.
그런데 많은 예제를 보면 대부분 Job, Step에 @Bean이 붙어있는 것을 확인할 수 있었다.
However In much of example, I checked that mostly @Bean depends on Job and Step
(하지만 많은 예에서, 나는 대부분 @Bean이 Job과 Step에 의존한다는 것을 확인했다.)
-> However, looking at many examples, it can be seen that most of them have @Bean attached to Job and Step.
comment :
1. 앞 부분인 In much of example 은 나쁘지 않은 것 같은데 파파고가 더 깔끔하게 번역한 것 같다.
2. 나는 '확인할 수 있었다.' 부분을 checked를 썼는데 파파고는 it can be seen that 을 썼다. that 이하를 볼 수 있었다. 라고 해석되는데 개인적으로는 checked도 잘 쓴것 같다.
3. '붙어있다.' 를 나도 attach를 쓰고싶었는데 위의 예제에서 attach를 썼다가 파파고가 depends on 을 쓰길래 나도 써봤는데 이번엔 너무 어이없게 번역이 됐다.
@Bean을 안 쓰면 혹시 스프링 배치 작업에 안좋은 영향을 끼치는 것은 아닌지 모르겠다.
If not using @Bean, I don't know that It works badly influence in Spring Batch rotation
(@Bean을 사용하지 않으면 스프링 배치 로테이션에 나쁜 영향을 미치는 것으로 알고 있지 않습니다.)
-> @Bean If I don't use it, I don't know that it will have a bad effect on the spring batch work.
comment :
1. 분명 '모르겠다' 는 I don't know 가 아닌가? 했는데 역시 맞았다.
2. '나쁜 영향' 에서 영향이라는 단어가 생각이 안나서 influence를 썼는데 번역기는 잘 작동한 것으로 나왔다. 하지만 파파고는 effect를 썼다. 이 쪽이 더 좋아보인다.
3. '작업' 이라는 단어가 생각이 안나서 rotation을 썼는데 work로 쓰면 될 것 같다.
2022-08-30 영어공부
실제 환경에서는 스프링 배치의 Job을 어떻게 실행합니까?
In real environment how to run spring batch Job?
(실제 환경에서 스프링 배치 잡을 실행하는 방법은 무엇입니까?)
-> How do you run the Job in the spring batch in a production environment
comment :
1. '실제 환경에서' 라는 부분을 맨 앞으로 뺐는데 너무 한국적으로 작문한건가...라는 생각이 든다.
2. '실제 환경' 이라는 부분을 나는 real environment라고 했는데 맞는 말이긴 한데 너무 기계가 말하는 듯한? 느낌이 든다. 파파고는 production environment라고 썼다. 좀 더 부드러운 표현같다.
휴면 계정 관리를 스프링 배치를 이용해서 구현하고 있다.
I implemented now with spring batch to manage dormant account
(비활성 계정을 관리하기 위해 스프링 배치로 지금 구현했습니다.)
-> Dormant account management is implemented using spring batch. (x)
comment :
1. 휴면 계정을 inactive로 썼는데 파파고는 dormant라고 썼다. 좀 어려운 단어라 기억에 남을지 모르겠다.
2. 근데 뭔가 이상한데 파파고가 작문한건 내가 만들고있다는 느낌이 안든다. 이번건 내거가 좀 더 나은 것 같다. (좀 더 사람같다)
스프링 배치를 사용하면서 다음과 같은 문제가 발생했다.
It occured problem when I used spring batch
(스프링 배치 사용 시 문제가 발생하였습니다.)
-> The following problems occurred while using the spring batch.
comment :
1. '문제가 발생했다' 부분에서 발생했다는 occured로 잘 생각해냈다. 하지만 파파고는 좀 더 세련되게 작문한 것 같다.
2. '~하면서' 부분에서 나는 when을 썼는데 when은 ~할 때 라는 뜻이고 좀 더 완료된 느낌이다. while이 더 나은것 같다.
글의 대략적인 내용은 @Bean이 붙은 메서드는 스프링에서 싱글톤으로 관리되기 때문에 실행할 수 없다는 것이다.
Approximatly content in this question is that method attached @Bean is couldn't execute because of spring managed with singleton
(이 질문의 대략적인 내용은 첨부된 메서드 @Beanis가 singleton으로 관리되는 스프링 때문에 실행할 수 없다는 것입니다.)
-> The rough content of the article is that the method with @Bean cannot be executed because it is managed as a single tone in the spring.
comment :
1. 긴 문장인데도 작문에 성공했다는 것에 큰 의의를 두겠다.
2. 파파고 역시 작문실력 엄청나다 내가 저 경지에 이를 수 있을까? 하는 생각이 든다.
3. '대략적인 내용' 부분은 approximatly content라고 했는데 말은 되긴 한다. 하지만 파파고가 더 멋지다.
4. '~때문에'를 because of 를 썼는데 파파고는 그냥 because를 썼다. 뭔가 내 생각에 because of 는 뒤에 불완전한 문장이 오고 because는 완전한 문장이 오는 것 같다. 그런 의미에서 나는 because를 썼어야 했다.
나는 스케줄러를 이용해서 어떻게든 Job을 실행시키고 싶었고 다음과 같은 해결책으로 해결했다.
I wanted execute Job with @Scheduled. and I solved the problem this
(나는 @Scheduled로 Job을 실행하기를 원했다. 그리고 나는 이 문제를 해결했다.)
-> I wanted to run Job somehow using the @Scheduled and solved it with the following solution.
comment :
1. 놀랍게도 내가 작문한 것이 정확히 내가 원하는 답변과 일치했다. 이렇게 하나 둘씩 맞추는 내 자신을 보면서 내 자신이 대견해지기 시작했다.
2. 하지만 여전히 파파고가 좀 더 깔끔한데 파파고는 '실행하다' 라는 부분을 execute를 절대 쓰지않는다. run을 쓴다. 근데 스택 오버플로우에 많은 개발자들은 '메서드를 실행하다' 라고 할 때 execute method 라고 많이들 표현한다. 따라서 나도 execute로 사용할 것이다.
3. '어떻게든' 이라는 부분을 생각해내지 못했는데 파파고는 somehow라고 작문했다. 기억해두자
4. '스케줄러를 사용해서' 라는 부분은 나는 with를 사용했는데 파파고는 using을 사용했다. 확실히 with는 ~를 가지고라는 뜻이니까 의미 전달이 모호할 수 있게다는 생각이 들었다.
5. '~으로' 부분을 파파고가 with를 사용했다. 이것도 기억해두자.
6. '다음과 같은 해결책으로' 라는 부분은 나는 그냥 this로 퉁쳤는데 파파고는 following solution 으로 좀 더 고급지게 썼다.
내가 만든 배치 클래스에 있는 @Configuration을 @Component로 바꾼다.
I changed from @Configuration to @Component attached at batch class which I made.
(제가 만든 배치 클래스에서 @Configuration에서 @Component attached로 변경하였습니다.)
-> Replace the @Configuration in the batch class I created with @Component.
comment :
1. 생각보다 파파고가 영어 번역은 영 시원치않다. 한글 번역이 더 깔끔하게 진행하는 것 같다. 한국 번역기라 그런가?
2. '~에서 ~로 바꾼다' 라는 부분을 나는 from ~ to ~ 로 썼는데 파파고는 replace ~ with ~로 썼다. 둘 다 맞는 표현인 것 같은데 이 부분은 잘 모르겠다.
Job, Step, Reader, Processor, Writer에 붙어있는 @Bean을 전부 다 지운다.
I remove all of @Bean attaching Job, Step, Reader, Processor, Writer.
(나는 @Bean attaching Job, Step, Reader, Processor, Writer를 모두 제거한다.)
-> Erase all @Bean on the Job, Step, Reader, Processor, and Writer.
comment :
1. 확실히 파파고 작문 잘한다.
2. '지운다'라는 부분을 remove all 도 좋은데 파파고가 더 이쁘게 작문해줬다. erase << 기억해두자.
그렇게 했더니 Job이 내가 원하는대로 작동했고 로그도 찍혔다.
Using this following solution, Job execute which I want and log is written
(이 솔루션을 사용하여 원하는 작업 실행과 로그가 작성됩니다.)
-> After doing so, Job worked as I wanted and got a log.
comment :
1. '그렇게 했더니' 부분에서 내 작문이 영 시원치않았다. 딱히 생각나는 구도가 없었기 때문인데 파파고는 아주 잘 작문했다.
2. '내가 원하는대로' 라는 부분은 파파고가 as I wanted를 썼다. 원하는대로도 딱히 생각나는게 없어서 저렇게 썼는데 파파고 역시 작문 잘한다.
문제를 해결은 했는데 또 다른 문제가 있었다.
I solved this problem However It has another probelm.
(나는 이 문제를 해결했다. 그러나 그것은 또 다른 문제가 있다.)
-> I solved the problem, but there was another problem.
comment :
1. '~가 있다.' 이건 나도 아는건데... 왜 has를 썼을까? 나도 there is / there are 알아!
2. 나머지는 괜찮은 것 같다.
수많은 예제에서 그리고 심지어 스프링 공식 문서에서도 모든 Job에 @Bean을 붙이는 것이었다.
In a lot of example, even spring official documents attached @Bean at all of Job.
(많은 사례에서 봄 공문에도 Job의 @Bean이 첨부되어 있었다.)
-> In many examples, and even in the Spring Official document, all Jobs were given @Bean.
comment :
1. even in 도 쓰는구나 난 안되는줄...
2. official 을 생각해낸건 잘했다. 칭찬해
3. '~에 붙다.' 나는 그냥 attach를 생각했는데 파파고는 그걸 첨부하다고 해석했다. 음... 그럼 뭘쓰라고?
또한 더 알아보니 @Bean이 붙어있지 않으면 JobParameter를 사용할 수 없는 것 같았다. (JobParameter를 사용하려고 했더니 초기값인 null이 찍혔다.)
Also more learning this, It seems like could'nt use JobParameter if attach @Bean. (It wrote null which is default value when I used JobParameter)
(또한 이것을 더 배우면, @Bean을 붙이면 JobParameter를 사용할 수 없는 것 같다. (JobParameter를 사용할 때 기본값인 null이라고 쓰여 있었다.))
-> Furthermore, it seemed that JobParameter could not be used without @Bean attached. (When I tried to use the JobParameter, the initial value was null.)
comment :
1. 나는 확신했다. 파파고는 절대 이길수가 없다. 하긴 말이 안된다. 바둑기사 이세돌도 알파고한테 졌는데 내가 뭐라고 파파고를 이기겠는가.
2. '또한' 에 대해서 파파고는 Furthermore라고 작문했다. 확실히 더 강조하고 싶을 때는 furthermore가 나아보인다.
3. '~처럼 보인다.' 이 부분에서 파파고는 it seemed that 이라고 썼다. 나는 seems like 를 썼는데 seems like couldn't 이렇게 썼다. seems like 도 동사인데 could를 또썼으니 아이고 이 문장파괴범아...
4. 단순히 내가 '사용하려고 했더니' 부분에서 I used JobParameter 라고 쓰는것 보다 I tried to use 라고 강조하는게 좀 더 좋아보인다.
이제 진짜 질문하겠다.
Now, It is real question.
(이제, 그것은 진짜 질문이다.)
-> I'm going to ask you a real question now.
comment :
1. 너무 기계스럽게 작문하는 것 같다. 하지만 말만 되면 됐지 뭐 어때
2. '~하겠다' 부분을 파파고는 be going to = will 을 썼다. 괜찮은 것 같다.
현업에서도 스프링 배치를 사용할 것이다. 그리고 공식문서에 나와있듯이 @Bean을 붙일 것으로 예상된다. 그렇다면 어떻게 Job을 실행하는가?
In production environment, Use spring batch right? and in spring official document, I expect that it attach @Bean. So, How to execute Job in production environment
(생산환경에서는 스프링배치를 사용하겠죠? 그리고 봄공식문서에서는 @Bean을 붙일 것으로 예상합니다. 그렇다면 프로덕션 환경에서 잡을 실행하는 방법은 무엇일까요?)
-> Spring Batch will also be used in the field. And it's expected to put @Bean, as it says in the official document. So, how do you run a Job in the field?
comment :
1. 파파고에서 '현업에서'를 production environment라고 작문 해놓고 여기서는 또 fields 라고 작문하네... 난 어느 장단에 맞춰야 하는것인가
2. '~에 있듯이' 이 부분을 파파고는 it says in ~ 라고 작문했다. 내가 이걸 기억할 수 있을까?
지금 내 코드에서 고쳐야 할 부분은 어디인지 알려주십시오.
Please teach where I fix in my code.
(내 코드에서 내가 고치는 부분을 가르쳐 주세요.)
-> Please let me know where I need to fix in my code.
comment :
1. '알려주세요' 부분을 생각이 안나서 teach라고 썼는데 역시 파파고다 let me know 라고 이쁘게 작문했다.
2. '고쳐야 할 부분'에서 need to fix 라고 파파고가 작문했다. 단순히 fix를 쓰는것 보다는 이게 더 나을 것 같다.
2023-02-18 영어공부
Maps are naturally one of the most widely style of Java collection
Map은 기본적으로 Java Collection 중 가장 대중적인 것 중 하나이다.
And, importantly. HashMap is not a thread-safe implementation. while Hashtable does provide thread-safety by synchronizing operations.
그리고 중요하다. Hashtable은 synchronizing 동작을 이용해 thread-safety 한 반면에 HashMap은 thread-safe 하지 않은 구현체이다.
Even though Hashtables is thread safe. it is not very efficient. Another fully synchronized Map. Collections.synchronizedMap. does not exhibit great efficiency either. If we want thread-safety with high throughput under high concurrency.
Hashtable은 thread safe 하지만 매우 효율적이지 못하다. 또다른 완벽히 synchronized Map인 Collections.synchronizedMap 은 매우 비효율적인건 마찬가지이다. 만약 우리가 thread-safety를 원한다면 (with high throughput under high concurrency)
-with high throughput under high concurrency 이 부분 해석이 안됨
To solve the problem. the Java Collections Framework introduced ConcurrentMap in Java 1.5
문제를 해결하기 위해서 Java Collection Framework중 하나인 ConcurrentMap을 소개한다.
ConcurrentMap is an extension of the Map interface.
ConcurrentMap은 Map interface의 확장이다.
It aims to provides a structure and guidance to solving the problem of reconciling throughput with thread-safety
이것(ConcurrentMap)은 thread-safety를 위해 throughput을 조정하는 문제를 해결하기위한 구조 혹은 가이드를 제공하기위한 목적으로 설계되었다.
-reconciling : 화해시키다, 융화시키다, 조정하다, 중재하다 인데 위의 문장에서 어떤방식으로 해석해야 하는지 모르겠음
By overriding several interface default methods.
몇몇 interface의 default method를 overriding 함으로써
ConcurrentMap gives guidelines for valid implementations to provide thread-safety and memory-consistent atomic operations.
ConcurrentMap은 thread-safety와 메모리가 일관적인 원자성 실행을 제공하기위한 적절한 구현체를 제공합니다.
ConcurrentHashMap is the out-of-box ready ConcurrentMap implementation.
ConcurrentHashMap은 ConcurrentMap의 구현체로 준비된 out-of-box(?)입니다.
-ready도 해석이 애매하고 out-of-box는 또 뭐야?
For better performance. it consists of an array of nodes as table buckets (used to be table segments prior to Java8) under the hood. and mainly uses CAS operations during updating.
더 나은 방식으로는. 이것(ConcurrentHashMap)은 hood(?)아래 테이블 버킷 (주로 Java8에서 사용되는 테이블 조각들)으로 노드들의 배열로 구성되어있습니다. 그리고 업데이트동안 CAS 방식을 주로 사용하죠.
-hood : 두건 ...?
-as를 어떤 방식으로 해석해야 하는지 잘 모르겠다.
The table buckets are initialized lazily. upon the first insertion
테이블 버켓들은 첫 삽입보다 늦게 초기화됩니다.
-upon 은 무슨 느낌인지 잘 모르겠음
Each bucket can be independently locked by locking the very first node in the bucket.
각각의 버킷들은 버킷안에서 very(?) 첫번째 노드를 잠금으로써 독립적으로 잠글 수 있다.
-very 는 강조...?
-영어 수업시간에 the very는 강조라고 했던게 기억나는데 가물가물...
Read operations do not block. and update contentions are minimized.
읽는 작업은 블록이 아니다. 그리고 업데이트 contention은 최소화 된다.
--------contention 의 뜻이 '논쟁' 인것으로 미루어 봤을 때 전문용어라고 판단 구글링을 해봤다--------
In computer science, resource contention is a conflict over access to a shared resource such as random access memory, disk storage, cache memory, internal buses or external network divices.
컴퓨터 사이언스에서 리소스 contention은 리소스를 공유하는 접근과 충돌하는 것이다. 예를 들어서 랜덤하게 메모리에 접근한다던가, 디스크 저장소, 캐시 메모리, 내부적인 bus 혹은 외부적인 네트워크 디바이스들
-contention : 투쟁, 전투, 분쟁, ~와 충돌하다. -> ~와 충돌하다 이 해석이 맞는듯
------------------------------------------------
The number of segments required is relative to the number of threads accessing the table so that the update in progress per segment would be no more than one most of time.
요구되는 조각들의 수는 테이블에 접근하는 스레드의 수와 연관있다. so that(?) segment 마다 실행되는 업데이트는 더이상 가장 오래 걸리는 시간이 아니다.
-no more than 은 더이상 이라고 해석했고, on most of time 이 좀 애매
ConcurrentMap guarantees memory consistency on key/value operations in a multi-threading environment.
ConcurrentMap은 멀티스레딩 환경에서 키/밸류로 동작하는 메모리 일관성을 보장한다.
Actions in a thread prior to placing an object into a ConcurrentMap as a key or value happen-before actions subsequent to the access or removal of that object in another thread
(동사 못찾겠음)
-prior to : ~에 앞서
-동사가...뭐에요..?
2023-02-23 영어공부
preserve : 보호하다 / 보존하다 / 지키다
descendant : 자손 / 후예
incur : 초래하다 / 지다 (빚을 지다)
represent : 의미하다 / 나타내다 / 대표하다
propagation : 번식, 증식 / 전파
comprise : 포함하다 / 의미하다 / 구성되다
The LinkedHashSet saves the client from the unpredictable ordering provided by HashSet, without incurring the complexity that comes with a TreeSet.
HashSet에 의하여 제공된 예측불가능한 순서로부터 클라이언트(개발자)를 보호한다. TreeSet과 같은 복잡성을 초래하지 않으면서
의역 -> TreeSet처럼 복잡하지 않으면서 HashSet처럼 예측 불가능하지않다.
Providing an initial capacity prevents any unnecessary resizing of the Set as it grows
캐퍼시티의 초기화를 제공하는 것은 Set이 불어남에 따라 불필요한 resizing으로부터 막아준다.
2023-02-25 영어공부
exceed : 초과하다
abbreviate : 단축하다, 생략하다
attempt : 시도하다 / 기도하다 / 꾀하다
retrieval : 회복, 복구, 만회 / 수정 / 사전에는 안나오지만 검색이라는 뜻도 있음
alleviate : 덜다, 완화하다
vastly : 대단히 크게
we should favor the Deque interface and its implementations.
우리는 Deque의 인터페이스와 Deque의 구현체들을 주로 사용해야합니다.
favor : 선호하다 / 호의
-> 대충 의역했는데 아무리봐도 선호하다나 호의로 해석하면 이상하단 말이지...
First, we'll take a peek at what a Queue does, and some of its core methods.
먼저 우리는 큐에 대해서 엿보고 그 다음 몇몇개의 핵심 메서드에 대해서 알아볼겁니다.
peek at : 훔쳐보다, 엿보다
-> 우리나라에서도 "~에 대해 알아보고"를 엿보다 라고 표현하는데 영어도 마찬가지구나 싶었다
A thread may wait on the Queue to be non-empty when attempting a retrieval, or for it to become empty when adding a new element.
하나의 스레드는 검색을 시도할 때, 비어있을 때, 새로운 요소가 추가될 때 빈공간이 될 때까지 기다린다.
retrieval : 회복, 복구 / 수정 / 검색
-> 사전에 나오지도 않는 뜻으로 해석되길래 당황... 검색이라는 뜻 있음
Though mostly directly associated, yet the N+1 problem is not specific to ORMs only. This problem can be related to the context of web APIs as well, e.g. REST APIs.
N + 1 문제는 ORM만의 특별한 문제가 아닙니다. 이러한 문제는 REST API와 같은 web API의 컨텍스트와 연관될 수 있습니다.
In the case of web APIs, the N+1 problem is a situation where client applications are required to call the server N+1 times to fetch one collection resource + N child resources.
web API의 경우에서 N + 1 문제는 클라이언트 애플리케이션이 자식 리소스를 N 번 컬렉션 리소스로 가져오기 위해 N + 1번 서버로 응답이 요청되는 상황에서 발생합니다.
-fetch : 가지고 오다.
This is mostly because the collection resource did not provided enough information about the child resources to help the client application to build its user interface altogether.
이런 경우는 대게 컬렉션 리소스가 클라이언트 애플리케이션의 UI를 모두 빌드하기위해 도와주는 자식리소스에 대해 충분한 정보를 제공하지 않았기 때문에 발생합니다.
Here /books resource return list of books with information including only it’s id and isbn. This information is not enough to build a client application UI, which will want to typically show the books name in UI rather than ISBN.
여기 book의 id 와 isbn만을 포함하고있는 정보를 가진 book list를 반환하는 /books 리소스가 있다. 이 정보는 클라이언트 애플리케이션 UI를 빌드하기위해 충분하지않다. 그리고 그것은 ISBN 보다는 UI안에 book name을 전형적으로 보여주는 것을 원합니다.
In some situations, the clients may want to show other information such as the author’s name and the publication year as well.
이러한 몇몇의 상황에서, 클라이언트는 아마 다른 정보를 보기를 원할것입니다. 예를들어서 저자의 이름이나 출판연도같은 것들을요
In the above scenario, the client application MUST make N more requests for each individual book resource at /books/{id}. So in the total client will end up invoking REST
APIs N+1 times.
위와같은 시나리오에서 클라이언트 애플리케이션은 반드시 /books/{id}에 있는 각각의 book에 대한 리소스를 N개만큼 더 요청해야합니다. 그래서 결과적으로 클라이언트는 REST API의 N + 1 번 도달하게 됩니다.
The above scenario is only for example. The idea is that insufficient information in collection resources may lead to the N+1 problem in REST APIs.
위의 시나리오는 단 하나의 예제일 뿐입니다. 이 아이디어는 REST API에서 컬렉션 리소스안에있는 불충분한 정보가 N + 1 문제를 야기한다는 것을 보여줍니다.
2023-02-27 영어공부
configure : 구성하다 / 배열하다 / 설정하다
evident : 분명한, 명백한
transitive : 의존적인 / 의지하는 / 타자의 동작을 이행하는
include : 포함하다 / 내포하다
optimization : 최적화
comes with : ~와 함께 제공된다.
fetch : 가지고 오다 / 의식을 회복시키다 / 설득하다
explicit : 명시적
allow : 허락하다, 묵인하다 / (정기적으로) 지급하다 / 인정하다 / 참작하다
compromised : 타협하다
integrity : 고결, 성실, 청렴 / 완전한 상태
demarcate : 분리하다, 구별하다
compelling : 강제적인 / 흥미를 돋우는 / 어쩔 수 없는
At the most basic level, a connection pool is a database connection cache implementation that can be configured to suit specific requirements.
가장 기초적인 레벨에서 커넥션 풀은 특별한 요구를 적절하게 설정될 수 있는 데이터페이스 커넥션 캐시 구현체이다.
-> configure를 설정하다 라고 해석하는 듯
It becomes evident that database connections are fairly expensive operations, and as such, should be reduced to a minimum in every possible use case
데이터베이스 커넥션은 꽤나 비싼(리소스가 많이드는) 작업이다. 그러므로 모든 가능한 상황에서 최소한으로 줄어야된다.
This will also allow us to explore different ways to manage transactions in Java and Spring.
이 튜토리얼은 자바와 스프링에서 트랜잭션을 관리할 수 있도록 다양한 방법들을 탐구할 수 있도록 해줍니다.
-> allow는 explore를 받쳐주는 느낌 ~하도록 허락해준다, ~하게 해준다의 느낌으로 해석하면 됨
This is necessary to ensure that the integrity of the application state is never compromised.
원자성(this)은 애플리케이션 상태가 완전한 상태로 끝나는 것을 절대로 타협해서는 안되는 상황이 되어야합니다.
2023-03-02 영어공부
certification : 인증 / 증명
interoperate : 상호 운영하다.
facilitate : 용이하게 하다
obsolete : 쓸모없는 / 진부한
relevant : 관련된, 적절한 / 상응하는, 상대적인
reassembling : 재조립
단어만 알면 해석되는 경우가 많았었기 때문에 단어만 정리하고 해석은 올리지 않습니다.
공부한 문서
https://www.imperva.com/learn/application-security/osi-model/
https://www.networkworld.com/article/3239677/the-osi-model-explained-and-how-to-easily-remember-its-7-layers.html
2023-03-04 영어공부
Subsequent : 이후, 그후
intact : 손대지 않은, 손상되지 않은
populate : 거주시키다 / 장소를 차지하다
diminish : 감소하다 / 권위가 떨어지다
bloated : 부풀어오른 / 오만한
intuitive : 직관적인
simultaneous : 동시의
coordinate : 조정하다 / 동등한, 대등한
exclusive : 독점적인 ↔ exclusion : 제외, 베재, 추방
precede : 앞서다 / 우선하다 -> preceding : 이전의
span : 기간
purged from : ~에서 제거된
denotes : 표시하다, 나타내다 / 의미하다
One way is to create a new table and pre-fill it with data to act as a coordinator for simultaneous operations.
단 하나의 방법은 새로운 테이블을 만들거나 동시실행을 위한 조정자로써 실행한 데이터를 가지고 미리 실행하는 것입니다.
Gap locking is not needed for statements that lock rows using a unique index to search for a unique row.
Gap locking은 유니크한 행을 탐색하기 위해 인덱스를 사용하는 행을 잠그는 상태를 강요하지않는다.
= 단 하나의 행을 찾기위해 단 하나의 인덱스를 사용하는 행을 잠그는것을 강요하지않는다.
-> 뭔가 뒤에 덕지덕지 많이 붙었는데 using a unique index to search for a unique row 에서 for는 ~를 위한이 아니고 search for 라는 한 단어로 묶여서 찾다 라는 뜻
This does not include the case that the search condition includes only some columns of a multiple-column unique index; in that case, gap locking does occur.
이러한 상황은 찾고있는 상태가 일부 컬럼 중 몇몇 컬럼을 위해 유니크 인덱스가 포함되는 상태인 경우는 포함하지 않는다. 이러한 경우 gap locking이 일어난다.
= 이런 상황은 유니크한 인덱스가 일부 컬럼을 포함하는 상태인 경우에는 일어나지 않는다. 이 경우에는 gap locking이 일어난다.
2023-03-06 영어공부
consecutive : 연속적인 / 일관된
substitute : 대신쓰다, 대체하다 / 바꾸다
in terms of : ~인 측면에서
negate : 부정하다 / 취소하다
abort : 유산(낙태)하다 / 중단하다
rigorous : 엄격한 / 혹독한
mature : 성숙한 / 잘 익은 / 완전히 발달한
ephemeral : 명이 짧은 / 덧없는
recursive : 순환의
stand out : 두드러지다
integrity : 고결 / 성실 / 청렴 -> 컴퓨터사이언스에선 데이터 무결성과 같이 사용
duration : 지속 / 계속
conversion : 전환 / 변환
numerous : 다수의, 수많은
This level is different from Read Committed in that a query in a repeatable read transaction sees a snapshot as of the start of the first non-transaction-control statement in the transaction, not as of the start of the current statement within the transaction.
이 레벨은 Read Committed 와 다르게 Repeatable Read 트랜잭션 안의 쿼리가 트랜잭션 안에서 트랜잭션이 컨트롤하지 않는 처음 상태의 시작으로서 스냅샷을 보여준다. 트랜잭션 안에서 동시다발적인 상태의 시작이 아니고
-> 이 레벨은 동시다발적인 상태의 시작이 아니고 트랜잭션이 컨트롤 하지 않은 최초의 시점을 스냅샷으로 보여준다.
If the first updater rolls back, then its effects are negated and the repeatable read transaction can proceed with updating the originally found row. But if the first updater commits (and actually updated or deleted the row, not just locked it) then the repeatable read transaction will be rolled back with the message
만약 첫번째 업데이트 하는 트랜잭션이 롤백을 한다면 롤백의 효과를 무효화한다. 그리고 Repeatable Read 트랜잭션은 오리지널 행을 찾고 업데이트를 진행할 수 있다. 그러나 만약 첫번째로 업데이트하는 트랜잭션이 커밋을 한다면 (그리고 단지 그 행을 잠그는 것이 아니라 실제로 행을 업데이트하거나 삭제되는 경우) 그러면 Repeatable Read 트랜잭션은 그 메세지들을 롤백하게 될 것이다.
All locks acquired by statements within a transaction are held for the duration of the transaction, preventing destructive interference including dirty reads, lost updates, and destructive DDL operations from concurrent transactions.
모든 락은 트랜잭션의 지속동안 동시성문제인 Dirty Read, Lost Update, 그리고 DDL 실행에의한 해를 끼치는 문제를 보호하는 상태를 획득합니다.
2023-03-09 영어공부
Compliant : 표준, 준수
proprietary : 독점, 소유
solely : 단지
respective : 각각의
outperformed : 성능이 우수한
aggregation : 집합, 집단, 집적
fraud : 사기, 기만, 사기 행위, 부정 수단
financial : 금융의
precise : 정밀한
scalability : 확장성
criteria : 기준
auditing : 회계 감사, 감사
conclude : 결론을 내리다
confidential : 기밀의
conduct : 행위, 행실, 품행 / 행동하다 / 지휘하다 -> conducted : 행해진
generate : 일으키다. 초래하다
advent : 출현, 도래
vary from : ~와 다르다
refined : 정제된
redundant : 과다한
scale : 확장하다
robust : 강건한, 건장한, 튼튼한
regardless : 개의치 않고, 부주의한
delegate : 대표, 사절 / 위임하다
revoke : 취소하다, 폐지하다
specify : 명시하다
centralized : 중앙집권의 -> centralize : 중심에 모으다 / 집중시키다
assign : 할당하다
A database schema defines how data is organized within a relational database; this is inclusive of logical constraints such as, table names, fields, data types, and the relationships between these entities
데이터베이스 스키마는 어떻게 데이터가 관계형 데이터베이스 안에서 조직되는지에 대해서 정의합니다. 스키마는 엔티티 사이에서 관계나 테이블이름, 필드, 데이터타입 등의 논리적인 제약조건의 내재적인 의미입니다.
2023-03-11 영어공부
compilation : 편집, 편집물
frequency : 빈도수
availability : 유용성
accommodated : 수용하다, 태우다 / 편의를 봐주다
infrastructure : 기반 시설
redundancy : 여분 / 과잉
Furthermore, if the data required for the query is horizontally partitioned across multiple shards, the router must then query each shard and merge the result together
게다가 만약 데이터가 여러개의 샤드로 수평적으로 나눠진 쿼리를 요구한다면, 라우터는 각각의 샤드로 쿼리를 나눠서 보내고 각각의 결과를 병합해야한다.
A poor choice of shard key will lead to unbalanced shards, which leads to decreased performance
샤드 키를 적용하는 것의 안좋은 선택은 바로 불규칙적인 샤드들이고 이것들은 성능 저하를 야기한다.
Each sharded database must have a separate machine or service which understands how to route a querying operation to the appropriate shard
각각의 샤드화된 데이터베이스는 어떻게 적절한 샤드로 쿼리 실행이 유도되는지 알고있는 기기와 서비스로 분리되어야합니다.
이제 웬만한 문장들은 해석이 가능해서 논문이나 공식문서를 읽다가 중요해보이는 메인 문장을 적어놓도록 하겠습니다.
2023-03-13 영어공부
desire : 열망 / 원하다
incorporates : 통합하다
reply to : 응답하다
it is not available because the nodes in the other partition do not provide an answer to the queries they receive.
가용성은 아니다 왜냐하면 다른 파티션안에서 노드들이 서버가 받은 쿼리에대한 응답을 제공하지 않기 때문이다.
2023-03-16 영어공부
stakeholders : 제삼자
seamless : 원할한
Manipulation : 조작
notorious : 악명높은
around : ~중심에서
growing number : 점덤 더 많은
ensure : 확인하다 / 보장하다
ingestion : 섭취
enrichment : 강화 / 농축 / 풍부
aggregate : 집계
this translates to a faster, more seamless flow.
이러한 작업이 더 빠르고 더 원할한 흐름을 가져다 준다.
Elasticsearch and the ecosystem of components that’s grown around it called the “Elastic Stack” has been used for a growing number of use cases
Elasticsearch와 이를 중심으로 성장한 구성 요소의 환경인 "Elastic Stack"은 점점 더 많은 사용 사례에 사용되고 있습니다.
collecting and analyzing log data, to a business intelligence tool for data analysis and visualization
로그 데이터를 수집하고 분석하면서, 데이터를 분석하거나 시각화하기 위한 똑똑한 비즈니스 도구로써
2023-03-18 영어공부
redundancy : 여분, 잉여 -> CS에선 "필요한 양보다 더 많은 양을 준비해 안정성을 올린다" 라는 뜻
reliability : 신뢰성
subtract : 빼다, 덜다, 공제하다
lessen : 경감하다
inspect : 면밀하게 살피다 / 점검하다
specialized : 전문의 / 분화된
criteria : 기준
account : 계좌, 계정 / (이유를) 밝히다 / 설명하다
A load balancer acts as the “traffic cop” sitting in front of your servers and routing client requests across all servers capable of fulfilling those requests in a manner that maximizes speed and capacity utilization and ensures that no one server is overworked
로드 밸런서는 너의 서버 앞에 앉아서 트래픽을 관리해주는 역할을 하거나 최대 속도로, 적절한 캐퍼시티로, 하나의 서버가 과부하 걸리지 않는 방법으로 이러한 요청들을 이행하는 모든 서버에 걸친 클라이언트의 요청을 라우팅 해준다.
2023-03-22 영어공부
entails : 수반하다
intricate : 복잡한, 뒤얽힌
malfunction : 오작동
transient : 덧없는, 무상한
reasoning : 추론, 추리, 증명
mediate : 조정하다, 중재하다 / 화해시키다
foster : 육성하다
retain : 보유하다, 유지하다
For the stateless protocol, storing data is not a priority. Therefore, the servers used as part of the network’s infrastructure do not have to be built to store large amounts of information.
stateless 프로토콜에서는 데이터를 저장하는 것이 최우선이 아니다. 그러므로 네트워크 기반시설의 한 부분으로서 사용되는 서버는 엄청나게 많은 양의 정보(데이터)를 저장하기위해 유지될 필요가 없다.
stateful protocol architecture retains the method of leaving the bulk of the responsibility to the server while freeing up the client’s device.
stateful 프로토콜 아키텍처는 클라이언트의 장치를 자유롭게 함과 동시에 대부분의 책임을 서버에 맡기는 방식을 유지한다.
2023-04-08 영어공부
fragment : 단편적인
instruction : 설명 / 컴퓨터 프로세서가 이해할 수 있는 일련의 코드들
intensive : 강한 / 격렬한
resume : 다시 시작하다
The Context switching is a technique or method used by the operating system to switch a process from one state to another to execute its function using CPUs in the system.
Context Swithcing은 시스템안에서 CPU를 사용하는 기능을 실행하기위한 하나이상의 상태를 스위칭하는데 필요한 OS에 의해 사용된 기술 혹은 방법이다.
2023-04-13 영어공부
suspend : 일시중단
resume : 다시시작
coincide : 일치(하다) / 동시
circute : 순환
ceiling : 천장
2023-04-21 영어공부
serves as : ~의 역할을 하다
retrieve : 검색하다
A non-leaf node's number of keys is one less than the number of its children.
리프 노드가 아닌 노드의 키 개수는 자식노드의 키 개수보다 하나 더 적습니다.
2023-04-24 영어공부
abort : 중단
preemption : 선점
Resources are taken one by one from a process and assigned to higher priority processes until the deadlock is resolved.
교착 상태가 해결될 때까지 프로세스에서 리소스를 하나씩 가져와 우선순위가 높은 프로세스에 할당합니다.
2023-05-04 영어공부
find-grained : 세분화된
susceptible : 취약한
intensive : 집중
complience : 규정 준수
commitment : 약속
committed : 최선을 다하는
Rust has a thriving open-source community that is committed to making the language the best it can be
러스트는 최고의 언어를 만들기 위해 최선을 다하는 활발한 오픈 소스 커뮤니티를 보유하고 있습니다.