JPA
개발개발 ·
JPA 시작하기
*JPA
JPA 시작하기
1. META-INF/persistence.xml에 정보를 입력한다. (jdbc드라이버, user, password, jdbc url, dialect 이렇게 설정을 해준다음에
2. JPA를 시작하려는 클래스에 EntityManagerFactory emf = persistence.createEntityManagerFactory(persistence.xml에 있는 persistence-unit 을 적어준다)
3. EntityManager em = emf.createEntityManager();
4. EntityTransaction tx = em.getTransaction();
5. DTO를 만들어주고 @Entity를 적어서 jpa가 이 클래스를 관리하도록 어노테이션을 적는다.
6. PK가 어떤건지 어노테이션을 달아준다.
7. 클래스 레벨에서 @Table(name = "테이블명")을 적어준다.
8. 필드에 있는 변수 위에 @Column(name = "컬럼명")을 적어준다.
9. tx.begin(); 코드 tx.commit();
10. em.close()
11. emf.close()
*문법
SELECT : Member findMember = em.find(Member.class, Primary Key);
INSERT : em.persist(member);
DELETE : em.remove(findMember);
UPDATE : findMember.setName("UserA");
JPA 영속성컨텍스트
*JPA에서 가장 중요한 2가지
1. 객체와 관계형 데이터베이스 매핑하기
2. 영속성 컨텍스트
*영속성 컨텍스트
정의 : 엔티티를 영구저장하는 환경
디비에 저장한다는 개념이 아니라 영속성 컨텍스트를 통해서 엔티티를 영속화를 한다는것 = 영속성 컨텍스트에 저장한다는 것
엔티티 매니저는 영속성컨텍스트를 1대1로 가지고 있다. 영속성컨텍스트는 눈에 보이지 않는 논리적인 개념이다.
*비영속
member 객체를 생성하고 엔티티매니저에 아무것도 넣지않은 상태
Member member = new Member();
member.setId("member1");
member.setUsername("회원1"); 이렇게 JPA가 관여하지 않은 객체 생성의 상태
*영속
em.persist(member); 이런식으로 객체를 저장한 상태를 영속 상태라고 한다. 이 상태는 단지 객체를 저장한 상태이지 디비에 저장한 것은 아니다 디비에 저장은 트랜젝션이 커밋될때이다.
*준영속
em.detach(member); 이 상태는 회원 엔티티를 영속성 컨텍스트에서 분리시키는 상태이다. 이 상태가 바로 준영속 상태
*삭제
em.remove(member); 이 상태가 바로 삭제 상태
*JPA 1차 캐시
Member findMember = em.find(Member.class, "member1"); 이렇게 조회를 하면 JPA는 1차캐시를 뒤져서 엔티티가 있으면 그것을 반환해준다. 엔티티가 없다면 디비에서 조회해서 1차캐시에 저장하고 저장한 값을 반환해준다.
*영속 엔티티의 동일성 보장
1차캐시로 반복 가능한 읽기 등급의 트랜잭션 격리 수준을 데이터베이스가 아닌 애플리케이션 차원에서 제공 = JPA에서 같은 트랜잭션 안에서는 같은 것을 조회하면 그 두개의 값이 같다는 것을 보장해준다.
*엔티티 등록 (트랜잭션을 지원하는 쓰기 지연)
트랜잭션을 커밋하기 전까지 디비에 적용이 안된다.
em.persist(memberA);
em.persist(memberB);
이렇게 영속성 컨텍스트에 1차캐시에 저장함과 동시에 쓰기지연 SQL저장소라는 곳에 SQL문들을 차곡차곡 쌓아놓는다. 그러다가 트랜잭션 커밋이 발동되면 그때 모아뒀던 SQL문들을 flush해서 디비에 저장한다.
*엔티티 수정 (변경 감지 = Dirty Checking)
영속 엔티티를 조회하고 영속 엔티티를 수정할 때 객체의 값만 바꿔주면 update쿼리를 자동으로 만들어준다. 원리가 뭘까?
1차 캐시에 엔티티를 모아둘 때 스냅샷이라는 것을 만들어 둔다. 스냅샷이 뭐냐하면 최초로 엔티티가 등록된 상태를 말한다. 즉 em.find(Member.class, 1) 이렇게 select쿼리로 1차 캐시에 값을 저장해둔 값이 혹여 setName을 사용해서 객체에 들어있는 값을 변경했다면 트랜잭션 커밋이 되는 순간 JPA는 이후에 엔티티랑 스냅샷을 일일히 비교하는 과정을 거친다. 그렇게 비교하다가 엔티티와 스냅샷이 일치하지 않으면 업데이트 쿼리를 만들어서 디비에 플러쉬한다.
*플러쉬
영속성 컨텍스트의 변경내용을 데이터베이스에 반영하는 것
영속성 컨텍스트를 플러쉬하는 방법
em.flush() = 직접 호출 (쓸일은 거의 없지만 나중에 테스트 할때 필요하다 알아두자)
트랜잭션 커밋 = 자동 호출
JPQL 쿼리 사용 = 자동 호출
플러쉬는
-영속성 컨텍스트를 비우지 않는다. (쓰기지연 SQL저장소에 있는 SQL문만 플러쉬하는 것이다)
-영속성 컨텍스트의 변경 내용을 데이터베이스에 동기화
-트랜잭션이라는 작업 단위가 중요 -> 커밋 직전에만 동기화 하면 됨
*준영속 상태
-영속 -> 준영속
-영속 상태의 엔티티가 영속성 컨텍스트에서 분리 (detached)
-영속성 컨텍스트가 제공하는 기능을 사용 못함
JPA Entity 매핑
*엔티티 매핑
@Entity
-@Entity가 붙은 클래스는 JPA가 관리, 엔티티라고 한다.
-JPA를 사용해서 테이블과 매핑할 클래스는 @Entity필수
-주의
1. 기본생성자 필수
2. final 클래스, enum, interface, inner 클래스 사용 X
3. 저장할 필드에 final 사용 X
*@Table(name = "Member")
-테이블 명과 매핑시킬 수 있음
-관례는 클래스 이름이 테이블 이름과 매핑됨
*@Column(name = "username")
-컬럼명을 매핑 시키는 어노테이션
-객체를 사용할 때 변순는 name으로 사용하고 싶고 실제 디비상에서의 컬럼은 username이라고 되어있을 때 매핑하기 위한 어노테이션
@Column의 속성
-name = "username" 필드와 매핑할 테이블의 칼럼 이름
-insertable = true or false 데이터베이스에 삽입 여부를 체크하는 속성, 기본값은 true
-updatable = true or false 데이터베이스에 업데이트 여부를 체크하는 속성, 기본값은 true
-nullable = true or false 처음 테이블이 create 될 때 notnull조건을 붙이는 속성, 기본값은 true notnull이 안붙는다. false를 붙이면 notnull이 붙는다. persistence.xml에서 hibernate.hbmddl.auto의 속성을 create로 하는 테스트 환경일 때 자주 쓰이는 것으로 보임
-unique = true or false 처음 테이블이 create 될 때 유니크키를 만들어준다 현업에서는 자주 쓰이진 않는 모양 (이름이 랜덤으로 붙이기 때문)
-length = 10 문자의 길이를 지정할 때 사용
-columnDefinition = "varchar(100) default 'EMPTY'" 칼럼의 정보를 커스텀할 수 있는 속성이다. 테스트 환경에서만 사용할 듯 보임
*@Id
-PK를 매핑하는 어노테이션
*@Enumerated(EnumType.STRING)
-Enum 클래스를 사용하고 싶을 때 디비와 매핑하기 위해서는 @Enumerated를 사용해야 한다.
-EnumType.STRING으로 하게되면 VARCHAR와 매핑된다.
-EnumType.ORDINAL은 사용하면 안됨 ORDINAL : enum 순서를 데이터베이스에 저장, STRING : enum 이름을 데이터베이스에 저장
*@Temporal(TemporalType.TIMESTMP or DATE or TIME)
-자바의 Date 타입을 디비에 매핑 시킬 때 쓰는 어노테이션
-자바의 Date 타입은 날짜와 시간 둘다 찍어주는데 디비에서는 날짜, 시간, 날짜와시간 이 세가지를 모두 구분해서 사용한다.
-날짜만 디비에서 매핑하고 싶으면 TemporalType.DATE, 시간을 매핑하고 싶으면 TemporalType.TIME, 날짜와 시간 모두 매핑하고 싶으면 TemporalType.TIMESTAMP
*@Lob
-VARCHAR를 넘어서는 큰 데이터를 매핑해야 할 때 사용하는 어노테이션
-@Lob private String name 이라면 MySql기준 LONGVARCHAR @Lob private int age 라면 MySql기준 BIGINT 이렇게 매핑해준다.
*@Transient
-디비와 관계없이 메모리에서만 사용하고 싶을 때 @Transient 어노테이션을 달아준다. (하지만 이런 경우는 드물듯)
JPA 기본키 매핑
*기본 키 매핑
기본 키 매핑 방법
1. 직접 할당 (@Id)
2. 자동 생성 (@GeneratedValue)
-IDENTITY : 데이터베이스에 위임, MYSQL
-SEQUENCE : 데이터베이스 시퀀스 오브젝트 사용, ORACLE (@SequenceGenerator 필요)
-TABLE : 키 생성용 테이블 사용, 모든 DB에서 사용 (@TableGenerator 필요)
-AUTO : 방언에 따라 자동 지정, 기본값
*IDENTITY 전략
-@GeneratedValue(strategy = GenerationType.IDENTITY)
-기본 키 생성을 데이터베이스에 위임
-주로 MySQL, PostgreSQL, SQL Server, DB2에서 사용 (ex) MySQL의 AUTO_INCREMENT)
-JPA는 보통 트랜잭션 커밋 시점에 INSERT SQL 실행
-AUTO_INCREMENT는 데이터베이스에 INSERT SQL을 실행항 이후에 ID 값을 알 수 있음
-IDENTITY전략은 em.persist() 시점에 즉시 INSERT SQL 실행하고 DB에서 식별자를 조회
IDENTITY전략 - 약점 (?)
영속성 컨텍스트에는 PK와 해당 PK와 맞는 객체를 저장하고 있다. 하지만 IDENTITY 전략의 경우 ID가 부여되는 시점이 디비에 값이 들어가는 시점이다. 디비에 값이 들어가려면 쓰기지연 SQL 저장소에서 플러쉬를 해야 디비로 넘어간다. 그럼 플러쉬를 하는 시점에 IDENTITY 전략에서는 ID 를 NULL을 입력하기 때문에 ID값을 저장할 수 없다. 그래서 IDENTITY 전략에 한해서만 em.persist()를 한 시점에 INSERT 쿼리를 날린 후에 SELECT 문으로 ID를 다시 끄집어 와야 한다. 버퍼링같은 영속성 컨텍스트의 기능을 사용할 수 없지만 약점이라고 하기엔 조금 애매한 부분이 이렇게 em.persist()에 INSERT쿼리를 날리고 다시 ID를 끄집어온다고 하더라도 성능에서 드라마틱한 변화가 있지 않다. 값이 영원히 바뀌지 않는 자연키는 찾기 힘드므로 대리키를 사용해야 하는데 대리키를 사용하려면 IDENTITY 전략이 필수이다. 성능이 아주 조금 안좋더라도 명확하게 하기 위해서는 IDENTITY 전략을 사용해야 할 것이다.
*SEQUENCE 전략
-데이터베이스 시퀀스는 유일한 값을 순서대로 생성하는 특별한 데이터베이스 오브젝트 (ex) 오라클 시퀀스)
-오라클, PostgreSQL, DB2, H2 데이터베이스에서 사용
SEQUENCE 전략 - 매핑
@SequenceGenerator(
name= "MEMBER_SEQ_GENERATOR",
sequenceName = "MEMBER_SEQ",
initialValue = 1, allocationSize = 1) 이걸 클래스레벨에 어노테이션에 적어준다.
@Id
@GeneratedValue(strategy = GenerationType.SEQUENCE, generator = "MEMBER_SEQ_GENERATOR" generator에는 위에 @SequenceGenerator의 속성중 name을 적으면 된다.
SEQUENCE 전략 - 성능개선
SEQUENCE 전략은 디비의 현재 SEQUENCE에서 다음 값을 가져옴으로 인해서 영속성 컨텍스트에 PK 값을 저장한다. IDENTITY 전략처럼 INSERT문을 날리지 않아도 되니 영속성 컨텍스트가 제공하는 버퍼링같은 기능을 사용할 수 있다. 하지만 디비에서 값을 가져와야 하므로 네트워크의 연결이 항상 이루어질 수 밖에 없다. 그럼 성능면에서 좀 떨어질 수 있는데, 이를 개선하기 위해서 @SequenceGenerator의 속성 중 하나인 allocationSize를 디폴트값인 50으로 설정하면 된다. 50으로 설정하게 되면 디비에서 현재 SEQUENCE값에서 50개를 미리 만들어 놓는다. 그리고 50까지 메모리에서 값을 하나씩 증가시키면서 사용한다. 50에 도달하게 되면 다시 50개를 미리 만들어서 메모리에서 사용하도록 만든다.
*TABLE 전략
-키 생성 전용 테이블을 하나 만들어서 데이터베이스 시퀀스를 흉내내는 전략
-장점 : 모든 데이터베이스에 적용 가능
-단점 : 성능문제
*권장하는 식별자 전략
-기본 키 제약 조건 : null 아님, 유일, 변하면 안된다.
-미래까지 이 조건을 만족하는 자연키는 찾기 어렵다. 대리키(대체키)를 사용하자
-예를 들어 주민등록번호도 기본 키로 적절하지 않다.
-권장 : Long형 + 대체키(Auto_increment or Sequence) + 키 생성전략 사용
JPA 연관관계의 주인
*연관관계의 주인
연관관계의 주인 딜레마는 양방향 연관관계에서 고민해야할 문제인데 양방향 매핑 규칙이 있다. 연관관계의 주인이란 단방향 연관관계를 두개를 만들어야하는 양방향 연관관계에서 둘 다 객체를 만들어버리면 예를들어 Member, Team 두개에서 Team클래스에서는 Member member로 단방향 매핑을 구축하고 Member 클래스에서는 Team team으로 단방향 매핑을 구축하면 둘 중 어떤 클래스에서 디비에 있는 FK를 수정할지 결정을 해야한다. 이것이 바로 연관관계의 주인이다.
양방향 매핑 규칙
1. 객채의 두 관계중 하나를 연관관계의 주인으로 지정
2. 연관관계의 주인만이 외래키를 관리 (등록, 수정)
3. 주인이 아닌 쪽은 읽기만 가능
4. 주인은 mappedBy 속성 사용 X
5. 주인이 아니면 mappedBy 속성으로 주인 지정
누구를 주인으로?
-외래키가 있는 곳을 주인으로 정해라
-여기서는 Member.team이 연관관계의 주인
외래키가 있는 쪽이 N이 되고 없는 쪽이 1이 된다. 외래키가 있는 N쪽이 연관관계의 주인이 된다. => 그럼 N : M은?
*주의사항
연관관계의 주인이 아닌 역방향에만 연관관계를 설정하면 null이 들어가기 때문에 연관관계의 주인의 객체 값들을 설정해 주어야 한다 > 은근히 많이 하는 실수
그냥 양쪽 다 값을 넣으면 된다. (객체지향 적으로 생각 했을 때 양쪽에 다 값을 넣는것이 좋다)
cf)연관관계 편의 메소드
연관관계의 주인되는 클래스에서 외래키의 데이터 값을 가공할 때 mappedBy를 쓰는 클래스의 값을 동시에 넣어주는 방법이다.
private void setTeam(Team team) {
this.team = team;
team.getMembers.add(this);
}
그리고 이런 역할이 큰(?) 메소드는 단순히 getter, setter를 쓰는 것 보다 특정한 이름을 지어주는 것이 명시성을 올려준다. 즉 private void changeTeam(Team team) 이라고 적는것이 다른 개발자가 봤을 때 아 팀을 바꾸는 특정한 메소드구나라고 생각할 수 있다.
일단 설계단계에서는 단방향 연관관계로 설계를 마치고 양방향 연관관계가 필요할 때 그때 추가하면 된다.
JPA 상속관계 매핑
*상속관계 매핑
테이블을 설계하는것에 있어서 공통된 칼럼이 계속 등장하면 어떻게해야할까? 방법은 크게 세가지로 나눌 수 있다.
1. 한 테이블에 다 때려박는 SINGLE_TABLE 전략
2. 각 테이블에 중복되는 칼럼을 그냥 집어넣는 TABLE_PER_CLASS 전략
3. 슈퍼타입와 서브타입를 이용하는 JOINED 전략
*JOINED 전략
관계형 데이터베이스에는 상속관계라는 것이 없다. 하지만 비슷한 모델링이 있는데 바로 슈퍼타입 서브타입이다. 예를 들어서 앨범, 책, 영화 테이블에 각각 공통 칼럼인 이름과 가격을 슈퍼타입인 아이템 테이블에 다 담는 것이다. 그리고 서브타입인 앨범, 책, 영화에는 슈퍼클래스의 PK값을 PK,FK값으로 사용함으로써 추후에 서브타입를 찾으려 할때는 조인을 사용해서 찾을 수 있게끔 만든다.
JPA로 구현할 때는 객체가 상속을 사용하듯이 설계하면 된다. 예를 들어 앨범, 책, 영화를 자식클래스로, 아이템이라는 부모클래스에는 필드에 이름과 가격을 넣고 extends로 마무리 지어주면 된다. 그리고 부모 클래스에는 @Inheritence(strategy = InheritanceType.JOINED)라는 어노테이션을 추가해주면 된다. 기본값이 InheritanceType.SINGLE_TABLE이기 때문에 전략을 적어넣어 주지 않으면 1번처럼 한 테이블에 모든 칼럼을 다 때려박게 된다.
@Inheritence 어노테이션과 같이 넣어줘야 하는 어노테이션이 있는데 바로 @DiscriminatorColumn이다. 부모 테이블에 넣어야 하며, 이 어노테이션을 넣게 되면 슈퍼타입에 DTYPE이라는 칼럼이 들어오게 되는데 이 칼럼의 값으로 서브타입의 테이블명이 들어오게 된다. 나중에 select쿼리로 찾을 때 이게 어디랑 연결된 데이터인지 쉽게 알아보게 하기 위해서 넣어주는 것이 좋다. @DiscriminatorValue라는 어노테이션도 있는데, 이 어노테이션은 자식클래스에 적는 것이다. 자식 클래스에 예를 들어 @DiscriminatorValue("M") 이라고 적으면 DTYPE에 들어가는 값이 테이블명이 아니라 지정해둔 문자열로 들어간다. 회사 지침상 바꿔야하는 경우도 있으므로 알아두자
JOINED 전략의 장점
1. 테이블이 정규화 되어있다.
2. 외래 키 참조 무결성 제약조건 활용이 가능하다.
3. 저장공간이 효율화되어있다.
JOINED 전략의 단점
1. 테이블을 여러개 사용해야 하기 때문에 INSERT 나 SELECT를 함에 있어서 SINGEL_TABLE전략보다 성능이 떨어질 수 있다.
2. 테이블이 여러개이기 때문에 복잡하다
*SINGLE_TABLE 전략
테이블 하나에 모든 칼럼을 다 집어넣고 DTYPE으로 구분하는 방법, 프로젝트가 별로 크지 않거나 JOINED전략이 복잡하다고 생각이 되면 이 싱글테이블 전략을 사용하는 것도 나쁘지 않은 선택이 될 것이다.
SINGLE_TABLE 전략의 장점
1. 조인이 필요 없으므로 일반적으로 조회 성능이 빠름
2. 조회 쿼리가 단순함
SINGLE_TABLE 전략의 단점
1. 자식 엔티티가 매핑한 칼럼은 모두 NULL을 허용해야한다. (치명적인 단점)
2. 단일 테이블에 모든 것을 저장하므로 테이블이 커질 수 있어서 상황에 따라서 조회 성능이 오히려 느려질 수 있다.
cf)@MappedSuperclass 어노테이션이 있는데 이것은 상속관계 매핑이 아니라 단순히 테이블에서 중복으로 사용하고 싶은 속성이 있을 때 ORM 개발자 기준에서 좀 더 객체지향적으로 설계할 수 있는 어노테이션이다. 만약 기본적인 CRUD에서 DBA가 모든 CRUD에 누가 했는지, 언제 했는지, 마지막 변경은 누가했는지, 마지막 변경이 언제인지 데이터 분석을 위해서 모두 추가해달라고 요청이 들어왔다고 가정해보면, 모든 테이블에 해당 속성을 전부 추가해야 한다. 하지만 이런 중복은 개발자들이 가장 피하고싶은 상황인데 그럴때 등장하는 것이 바로 @MappedSuperclass이다. 예를들어 부모 클래스인 BaseEntity에 속성을 집어넣고 클래스레벨의 어노테이션에서 @MappedSuperclass를 매핑한다. 그렇게 되면 이 부모 클래스를 사용하고 싶은 자식 클래스에 extends BaseEntity만 해주면 해당 테이블에 값이 전부 다 들어가게 된다.
@MappedSuperclass 정리
1. 상속관계 매핑 X
2. 엔티티 X, 테이블과 매핑 X
3. 부모 클래스를 상속 받는 자식 클래스에 매핑 정보만 제공
4. 조회, 검색 불가
5. 직접 생성해서 사용할 일이 없으므로 추상 클래스를 권장한다.
6. 테이블과 관계 없고, 단순히 엔티티가 공통으로 사용하는 매핑 정보를 모으는 역할
7. 주로 등록일, 수정일, 등록자, 수정자 같은 전체 엔티티에서 공통으로 적용하는 정보를 모을 때 사용
8. 참고 : @Entity 클래스는 엔티티나 @MappedSuperclass로 지정한 클래스만 상속이 가능하다.
지연로딩과 즉시로딩 (프록시)
*지연 로딩과 즉시 로딩
지연로딩과 즉시로딩을 알기 전에 프록시라는 것을 짚고 넘어가야 한다.
*프록시
프록시의 의미는 앞에서 대신 무언갈 중계해준다. 정도의 느낌이다. 프록시 서버도 마찬가지의 매커니즘이다. 그럼 지연로딩과 즉시로딩에서 프록시는 어떤 역할을 할까? 말 그대로 로딩 즉 데이터를 읽어오는 과정을 중계해준다.
예를 들어서 Member 엔티티와 Team 엔티티가 있다고 가정해보자, 비지니스 로직상 Member에 있는 데이터들만 조회하거나 입력할텐데 Team까지 필요하진 않을 것이다. 그런데 @ManyToOne 혹은 @OneToOne 어노테이션에서는 em.find(Member.class, member.getId()); 를 하면 Member 테이블은 물론이고 Team까지 조인해서 값을 가져온다. 만약 엮여있는 테이블이 한두개가 아니라 수십개라면 em.find로 Member만 조회하는 순간 엄청난 쿼리를 볼 수 있을 것이다.
그것을 미연에 방지하고자 JPA는 fetchType을 LAZY로 설정하면 Member엔티티를 조회하는 순간 연관관계로 매핑해놓은 나머지 엔티티들을 프록시 객체에 넣어놓는다. 그리고 실제 프록시 객체를 사용하려고 할 때 초기화(DB조회)를 한다.
실전에서는 모두 LAZY(지연로딩)로 바꿔야 한다. 즉시로딩의 단점이 치명적인데
1. 즉시 로딩을 적용하면 예상치 못한 SQL이 발생
2. 즉시 로딩은 JPQL에서 N + 1 문제를 일으킨다.
3. @ManyToOne, @OneToOne은 기본 fetchType이 EAGER(즉시로딩) 이기 때문에 LAZY로 설정해야한다.
4. @OneToMany, @ManyToMany는 기본이 LAZY
여기서 N + 1 문제란?
JPQL은 복잡한 쿼리를 대신 날려주는 기능이라고 보면 편한데, SQL문을 대신 날려주기 때문에 적혀있는 SQL문 이외에 일체 다른 행동을 하지 않는다. 만약 Member 엔티티와 Team엔티티가 연관관계 매핑이 되어있고 즉시로딩이 설정되어 있다면 JPQL로 createQuery("select m from Member m", Member.class)이렇게 날리면 JPA입장에선 어 Member 엔티티 가져오라는 거구나? 하고 Member 엔티티를 가져오면 Team이랑 연관관계가 매핑되어있는데 즉시로딩이네? 그럼 그때 다시 Team을 select 쿼리를 날려서 가져온다. 이렇게 즉시로딩으로 연결되어있는 테이블이 한두개가 아니고 N개라면 최초의 쿼리(1)를 내보내면 N개만큼 쿼리가 더 나간다고 해서 N + 1 문제라고 하는 것이다.
값 타입
*값 타입
JPA의 데이터 타입 분류에는 두가지 타입이 있다.
1. 엔티티 타입
2. 값 타입
1. 엔티티 타입 특징
1-1. @Entity로 정의하는 객체
1-2. 데이터가 변해도 식별자로 지속해서 추적 가능 (PK)
1-3. ex) 회원 엔티티의 키나 나이 값을 변경해도 식별자로 추적 가능
2. 값 타입 특징
2-1. int ,Integer, String 처럼 단순히 값으로 사용하는 자바 기본 타입이나 객체
2-2. 식별자가 없고 값만 있으므로 변경시 추적 불가
2-3. ex) 숫자 100을 200으로 변경하면 완전히 다른 값으로 대체
값 타입에는 세가지 분류가 있다
1. 기본값 타입
2. 임베디드 타입
3. 컬렉션 타입
1. 기본값 타입
자바에서 흔히 사용하는 타입으로 자바 기본타입인 int, double이 있고 래퍼 클래스인 Integer, Long 특수클래스인 String이 있다.
2. 임베디드 타입
임베디드 타입은 새로운 값 타입을 직접 정의할 수 있고, JPA는 임베디드 타입에 속한다. 주로 기본 값 타입을 모아서 만들어서 복합 값 타입이라고도 한다. 주로 임베디드 타입은 객체상에서 묶을만한 것들을 묶어서 하나로 따로 분류하는 방식이다. 예를 들면 회원 엔티티에 이름, 도시, 번지, 우편번호를 가진다고 한다면 도시, 번지, 우편번호만 따로 모아서 address라는 큰 묶음으로 만들 수 있을 것이다. 이렇게 한다면 더욱 객체지향적으로 만들 수 있다.
임베디드 타입을 사용하는 방법
1. 먼저 묶음으로 만들 수 있는 클래스를 만든다. ex) Address 그리고 클래스 레벨에 @Embeddable이라는 어노테이션을 달아준다.
2. 그리고 필드에 원하는 속성을 넣는다. ex) private String city; / private String street; / private String zipcode;
3. getter / setter를 만드는데 setter는 private 으로 외부에서의 접근을 막는다.
4. 필드에 있는 모든 변수들의 생성자를 만든다.
5. 기본 생성자를 만든다.
6. equals를 만든다.
ㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡAddress 클래스ㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡ
7. 이 해당 임베디드 타입을 사용하고 싶은 클래스에서 선언해준다. ex) private Address address;
8. 이 변수 위에 @Embedded 어노테이션을 달아준다.
9. member.setAddress(new Address("Seoul", "WorldCupStreet", "06125")); 이런식으로 사용하면 끝
왜 setter 를 private 으로 외부접근을 막을까?
만약 임베디드 타입을 수정하고 싶을 때 Address address = member.getAddress();로 꺼내서 address.setCity("newCity"); 라고 바꾸면 내가 저장했던 모든 Address들은 전부 다 newCity로 바뀌게 된다. 이는 객체 타입이 가지고 있는 한계점이다. 난 하나만 바꾸고 싶었는데 모든 것이 바뀌게 되는 것이다. 이를 컴파일 단계에서 원천 차단하는 것이 다른 개발자가 잘 모르는 상태에서 어 이 address 바꿔도 되는 값인가보네 하고 setCity("newCity") 이거 하는 순간 모든 값이 바뀌어버리는 대참사가 일어난다. 심지어 update쿼리는 잘 날아가고 오류가 뜨지 않기 때문에 이건 겉잡을 수 없는 버그로 이어지게 된다. 때문에 생성하거나 수정하는 것은 오로지 생성자를 통해서만 가능하도록(불변 객체로 설계하도록) 하는 것이 적절하다.
임베디드 타입을 수정하고 싶으면?
Member findMember = em.find(Member.class, member.getId());
Address oldAddress = findMember.getAddress();
findMember.setAddress(new Address("newCity", oldAddress.getStreet(), oldAddress.getZipcode());
이렇게 직접 한땀한땀 바꿔줘야한다.
임베디드 타입의 장점
1. 재사용 가능
2. 높은 응집도
3. 해당 값 타입만 사용하는 의미있는 메소드를 만들 수 있음
4. 임베디드 타입을 포함한 모든 값 타입은, 값 타입을 소유한 엔티티에 생명주기를 의존함.
3. 값 타입 컬렉션
디비에서는 컬렉션을 사용할 수 없다. 때문에 컬렉션을 이용하려면 별도의 테이블이 있어야 한다. ORM은 마치 디비에서 컬렉션을 사용하는 느낌을 주는 기능을 제공한다.
값 타입 컬렉션의 특징
3-1. 값 타입을 하나 이상 저장할 때 사용
3-2. @ElementCollection, @CollectionTable 사용
3-3. 데이터베이스는 컬렉션을 같은 테이블에 저장할 수 없다.
3-4. 컬렉션을 저장하기 위한 별도의 테이블이 필요하다.
값 타입 컬렉션의 사용
1. 먼저 변수를 생성한다. private Set<String> favoriteFood; or private List<String> favoriteFood;
2. 이 속성이 값 타입 컬렉션이라는 것을 JPA에게 알려줘야 한다. @ElementCollection 사용
3. 이 컬렉션이 들어갈 별도의 테이블을 매핑해준다. @CollectionTable(name = "favortie_food", joinColumn = @JoinColumn(name = "member_id"))
4. 필요하다면 칼럼 매핑까지 해준다. @Column(name = "favorite_food") 웬만하면 디비에 저장할 때는 언더스코어 방식을 사용
값 타입 컬렉션의 제약사항
-값 타입은 엔티티와 다르게 식별자 개념이 없다.
-때문에 값을 변경하면 추적하기가 어렵다.
-값 타입 컬렉션에 변경 사항이 발생하면, 주인 엔티티와 연관된 모든 데이터를 삭제하고, 값 타입 컬렉션에 있는 현재 값을 모두 다시 저장한다.
-값 타입 컬렉션을 매핑하는 테이블은 모든 칼럼을 묶어서 기본 키를 구성해야 한다 = null입력X, 중복저장X
값 타입 컬렉션의 대안
-실무에서는 상황에 따라 값 타입 컬렉션 대신에 일대다 관계를 고려한다.
-일대다 관계를 위한 엔티티를 만들고, 여기에 값 타입을 사용한다.
-영속성 전이 + 고아객체 제거를 사용해서 값 타입 컬렉션처럼 사용한다.
이 상황에서는 Entity를 새로 만들고 일대다를 매핑하는데
1. AddressEntity라는 엔티티를 만든다.
2. AddressEntity안에 private Long id; / private Address address를 만들고 id는 기본키 매핑을 address에는 @Embedded를 달아준다.
ㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡAddressEntity클래스ㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡ
3. 사용하고 싶은 클래스에 선언한다. List<AddressEntity> address = new ArrayList<>();
4. 일대다 매핑을 하고 캐스케이드와 orphanRemoval를 true로 한다. @OneToMany(cascade = CascadeType.ALL, orphanRemoval = true) / @JoinColumn(name = "member_id")
5. 다용도 메서드를 만든다.
public void changeAddress
JPQL 초급
*JPQL
-테이블이 아닌 객체를 대상으로 검색하는 객체 지향 쿼리
-SQL을 추상화해서 특정 데이터베이스 SQL에 의존X
-JPQL을 한마디로 정의하면 객체 지향 SQL
JPQL이 해결해야할 가장 큰 문제점 = 동적쿼리
그에 따른 해결책 = Criteria, Querydsl
Criteria의 특징
-문자가 아닌 자바코드로 JPQL을 작성할 수 있음
-JPQL 빌더 역할
-JPA 공식기능
-치명적인 단점 : 너무 복잡하고 실용성이 없다.
-Criteria대신 Querydsl 사용 권장
Querydsl의 특징
-문자가 아닌 자바코드로 JPQL을 작성할 수 있음
-JPQL 빌더 역할
-컴파일 시점에 문법 오류를 찾을 수 있음
-동적 쿼리 작성 편리함
-단순하고 쉬움
-실무 사용 권장
*JPQL 소개
-JPQL은 객체지향 쿼리 언어이다. 따라서 테이블을 대상으로 쿼리하는 것이 아니라 엔티티 객체를 대상으로 쿼리한다.
-JPQL은 SQL을 추상화해서 특정 데이터에비스 SQL에 의존하지 않는다.
-JPQL은 결국 SQL로 변환된다
*JPQL 문법
em.createQuery("select m from Member m where m.age > 20"), Member.class);
-엔티티와 속성은 대소문자를 구분한다. (Member, age)
-JPQL키워드는 대소문자를 구분하지 않는다. (select, from, where)
-엔티티 이름 사용, 테이블 이름이 아님(Member)
-엘리어스 필수 (as는 생략가능)
*TypeQuery vs Query
TypeQuery : 반환 타입이 명확할 때 사용
TypeQuery<Member> query = em.createQuery("select m from Member m"), Member.class); => Member엔티티에 대한 반환타입
Query : 반환 타입이 명확하지 않을 때 사용
Query query = em.createQuery("select m.username, m.age from Member m"); => username = String / age = int 타입이 명확하지 않음
*결과 조회 API
1. getResultList() : 결과가 하나 이상일 때, 리스트를 반환한다. 결과가 없으면 빈 리스트 반환
List<Member> findMember = em.createQuery("select m from Member m"), Member.class).getResultList();
2. getSingleResult() : 결과가 정확히 단 하나일 때 사용한다. 단일 객체 반환
Member findMember = em.createQuery("select m from Member m"), Member.class).getSingleResult();
getSingleResult를 주의해서 사용해야 하는 이유
-결과가 없으면 NoResultException이 발생하고
-둘 이상이면 NonUniqueResultException이 발생한다.
*파라미터 바인딩 - 이름기준, 위치기준
em.createQuery("select m from Member m where m.username = :username").setParameter("username", "member1"); 이런식으로 사용 마치 jdbc의 PreparedStatement를 사용 하듯이 사용하면 된다.
*프로젝션
-select 절에 조회할 대상을 지정하는 것
-프로젝션 대상 : 엔티티, 임베디드 타입, 스칼라 타입
ex)
select m from Member m -> 엔티티 프로젝션
select m.team from Member m -> 엔티티 프로젝션
select m.address from Member m -> 임베디드 타입 프로젝션
select m.username, m.age from Member m -> 스칼라 타입 프로젝션 (다 때려박은거)
*조인
1. 내부조인 (inner join)
2. 외부조인 (outer join)
1. 내부조인
조인을 했을 때 하나라도 null이 있으면 결과로 출력을 안해줌
select m from Member m (inner) join m.team t -> SQL문과 다른 점은 엔티티를 대상으로 쿼리를 한다는 것
2. 외부조인
조인 했을 때 null이 있어도 결과로 출력해줌
select m from Member m left (outer) join m.team t
cf) on 절
조인을 할때 조인 대상을 필터링해준다.
select m from Member m left (outer) join m.team t on t.name = 'teamA' -> 팀이름이 teamA인 튜플을 골라준다
*서브 쿼리
JPQL에서도 서브 쿼리를 지원한다. 단 from 절에서의 서브쿼리는 지원하지 않는다.
select m from Member m where m.age (select avg(m2.age) from Member m2)
서브쿼리 지원 함수
-exists(subquery) : 서브쿼리에 결과가 존재하면 참
select m from Member m left join m.team t where exists(select t from t where t.name = 'teamA')
-all(subquery) : 모두 만족하면 참
select o from Order o where o.orderAmount > all(select p.stockAmount from Product p)
-any, some(subquery) : 조건을 하나라도 만족하면 참
select m from Member m where m.team = any(select t from Team t)
-in(subquery) : 서브쿼리의 결과 중 하나라도 같은 것이 있으면 참
JPA 서브쿼리의 한계
-JPA는 where, having 절에서만 서브쿼리 사용 가능
-select 절도 가능 (하이버네이트에서 지원)
-from 절의 서브 쿼리는 현재 JPQL에서 불가능 (조인으로 풀 수 있으면 풀어서 해결)
*조건식 - case문
-기본 case문
select case when m.age <= 10 then '학생요금' when m.age >= 60 then '경로요금' else '일반요금' end from Member m
-단순 case문
select case t.name when 'teamA' then '인센티브110%' when 'teamB' then '인센티브120%' else '인텐티브105%' end from Team t
-coalesce : 하나씩 조회해서 null이 아니면 반환
select coalesce(m.name, '이름 없는 회원') from Member m
JPQL 중급
*경로표현식
경로표현식이란?
.(점)을 찍어 객체 그래프를 탐색하는 것
select m.name -> m.name = 상태 필드
from Member m
join m.team t -> m.team = 단일 값 연관 필드
join m.orders o where -> m.orders = 컬렉션 값 연관 필드
t.name = 'teamA'
상태필드 : 단순히 값을 저장하기 위한 필드 = 경로 탐색의 끝, 탐색 X
연관필드 : 연관관계를 위한 필드
-단일 값 연관 필드 (@ManyToOne, @OneToOne, 대상이 엔티티) = 묵시적 내부조인 발생, 탐색 O
-컬렉션 값 연관 필드 (@OneToMany, @ManyToMany, 대상이 컬렉션) = 묵시적 내부조인 발생, 탐색 X
묵시적 조인, 명시적 조인
묵시적 조인 : 경로 표현식에 의해 묵시적으로 SQL조인이 발생 (내부 조인만 가능) select m.team from Member m
명시적 조인 : join 키워드 직접 사용 select m from Member m join m.team t
cf) 가급적 묵시적 조인 대신 명시적 조인을 사용하는게 좋다. 왜냐하면 조인은 SQL 튜닝에 중요 포인트이기 때문이다. 묵시적 조인이 일어나는 상황은 한눈에 파악하기 어렵다.
*페치 조인 (fetch) (실무에서 매우매우 중요함)
-SQL의 조인 종류가 아니다
-JPQL에서 성능 최적화를 위해 제공하는 기능
-연관된 엔티티나 컬렉션을 SQL한번에 함께 조회하는 기능
-join fetch 명령어 사용
-join fetch 조인경로
회원을 조회하면서 연관된 팀도 함께 조회하고 싶을 때
select m from Member m join fetch m.team 이렇게 하면 SQL에서는 select m.*, t.* from Member m inner join Team t on m.team_id = t.id 이렇게 해석해서 해당 데이터를 다 퍼다 나른다.
컬렉션 페치 조인
일대다 관계에서 컬렉션 패치 조인을 하게 되면 데이터가 뻥튀기 된다. 예를들어서 회원이 1,2,3 있고 팀이 A,B가 있으면 회원 1,2는 팀A소속이고 회원3은 팀B소속일 때 팀에대하여 페치 조인이 일어나면(일대다 패치조인을 하게 되면) 실제로 팀에대한 데이터는 팀A, 팀B 두개지만 팀A에 소속된 회원이 1,2이기때문에 데이터가 총 세개가 나오게 된다.
페치 조인과 distinct
SQL의 distinct는 중복된 결과를 제거하는 명령이다. 하지만 JPQL에서는 2가지 기능을 제공하는데 SQL에 distinct를 추가해서 중복된 결과를 제거하도록 하고 애플리케이션 레벨에서 엔티티의 중복을 제거해준다. 컬렉션 페치 조인을 하게 되면 데이터가 뻥튀기 되는 현상이 있는데 팀ID와 이름이 팀A로 같은 두개의 데이터가 존재하게 된다. 이때 distinct를 추가해주면 같은 엔티티의 중복을 제거해 준다.
select distinct t from Team t join fetch t.members
*페치조인의 특징과 한계
특징
-연관된 엔티티들을 SQL한번으로 조회 - 성능 최적화
-엔티티에 직접 적용하는 글로벌 로딩 전략보다 우선함 @OneToMany(fetch = fetchType.LAZY) = 글로벌 전략
-실무에서 글로벌 로딩 전략은 모두 지연로딩
-최적화가 필요한 곳은 페치 조인 적용
한계
-페치 조인 대상에는 엘리어스(별칭)를 줄 수 없다.
-둘 이상의 컬렉션은 페치 조인 할 수 없다.
-컬렉션을 페치 조인하면 페이징API를 사용할 수 없다. (일대일, 다대일 같은 단일 값 연관 필드들은 페치 조인해도 페이징 가능)
컬렉션을 페치 조인 했을 때 페이징 API를 사용하는 방법
>해당 매핑에 @BatchSize(size = 1000이하의 숫자) 이렇게 적어주면 된다. 정 컬렉션 페치 조인을 했을 때 페이징을 해야 한다면 고려해보자 웬만하면 쓰지 말자
*다형성 쿼리
-type
상속관계 매핑에서 조회 대상을 특정 자식으로 한정하고 싶을 때 type을 사용하면 된다.
ex) Item 중에 Book, Movie를 조회해라
select i from Item i where type(i) in (Book, Movie)
-treat
상속 구조에서 부모 타입을 특정 자식 타입으로 다룰 때 사용한다.
ex) 부모인 Item과 자식인 Book이 있다.
select i from Item i where treat(i as Book).auther = 'kim'
*벌크 연산
ex) 재고가 10개 미만인 모든 상품의 가격을 10%상승하려면?
JPA 변강 감지 기능 (더티 체킹)으로 실행하려면 너무 많은 SQL을 실행하게 된다.
1. 재고가 10개 미만인 상품을 리스트로 조회한다.
2. 상품의 엔티티의 가격을 10% 증가한다.
3. 트랜잭션 커밋 시점에 변경감지가 동작한다.
->변경된 데이터가 100건이라면 100번의 update SQL을 실행한다.
쿼리 한번으로 여러 테이블의 엔티티들 변경할 수 있는데 executeUpdate()를 뒤에 넣어주기만 하면 된다.
String qlString = "update Product p set p.price = p.price * 1.1 where p.stockAmount < :stockAmount";
int resultCount = em.createQuery(qlString).setParameter("stockAmount", 10).executeUpdate();
이런 벌크연산의 주의할 점이 있는데 벌크 연산은 영속성 컨텍스트를 무시하고 데이터베이스에 직접 쿼리를 날리기 때문에 영속성 컨텍스트의 업데이트는 이뤄지지 않는다. 따라서 저렇게 executeUpdate()를 실행하고 영속성 컨텍트스에 있는 데이터를 찍어보면 데이터베이스에 있는 값과 전혀 다른 값이 들어있는 것을 확인할 수 있다. 때문에 벌크 연산을코드 시작할 때(영속성 컨텍스트에 아무것도 없을 때) 실행하거나, 벌크 연산 실행 후 영송성 컨텍스트를 초기화 하면 된다. (em.clear())
JPA를 활용한 (XToOne) Restful API설계
*Restful API 설계
앞으로 보여주는 예제들은 XToOne (ManyTonOne, OneToOne) 인 상황에서의 성능 최적화를 다루고 있다.
*version1 = 응답 값으로 엔티티를 직접 외부에 노출함
@GetMapping("/api/v1/simple-orders")
public List<Order> orderV1() {
List<Order> all = orderRepository.findAll(new OrderSearch());
return all;
}
문제점
1. 엔티티에 프레젠테이션 계층을 위한 로직이 추가된다.
2. 기본적으로 엔티티의 모든 값이 노출된다.
3. 응답 스펙을 맞추기 위한 로직이 추가된다. (@JsonIgnore, 별도에 뷰 로직 등등)
4. 실무에서는 같은 엔티티에 대해 API가 용도에 따라 다양하게 만들어지는데, 한 엔티티에 각각의 API를 위한 프레젠테이션 응답 로직을 담기는 어렵다.
5. 엔티티가 변경되면 API스펙이 변한다.
6. 추가로 컬렉션을 직접 반환하면 향후 API 스펙을 변경하기 어렵다.
*version2 = 엔티티를 DTO로 변환
@GetMapping("/api/v2/simple-orders")
public List<SimpleOrderDto> orderV2() {
List<Order> findAll = orderRepository.findAll(new OrderSearch());
return findAll.stream().map(o -> new SimpleOrderDto(o)).collect(Collectors.toList());
}
@Data
public class SimpleOrderDto {
private Long orderId;
private String name;
private LocalDateTime orderDate;
private OrderStatus orderStatus;
private Address address;
public SimpleOrderDto(Order order) {
orderId = order.getId();
name = order.getMember().getName(); //LAZY 초기화
orderDate = order.getOrderDate();
orderStatus = order.getStatus();
address = order.getDelivery().getAddress(); //LAZY 초기화
}
}
문제점
1. API를 유연하게 사용하지 못한다. 위의 방법대로 return 하면 json의 시작이 대괄호([] : 배열)이다. 대괄호가 되면 이 이상의 API를 추가할 수 없다. 예를들어서 해당 API를 사용하는 곳에서 member의 개수를 세어달라는 요청사항이 들어오게 되면 count라는 값을 추가해야 될텐데 대괄호(배열)는 값을 추가할 수 없다. 이럴 때를 대비해서 DTO를 Result에 한번 감싸서 return을 해야한다.
@Data
@AllArgsConstructor
static class Result<T> {
private T data;
}
이렇게 Result객체를 하나 만들어 두고
@GetMapping("/api/v2/simple-orders")
public Result orderV2() {
List<Order> findAll = orderRepository.findAll(new OrderSearch());
List<Order> collect = findAll.stream().map(o -> new SimpleOrderDto(o)).collect(Collectors.toList());
return Result(collect);
}
이렇게 한번 감싸서 return 하게 되면 json의 시작이 중괄호({})로 바뀐다. 이런 상황에서는 추가 요청사항이 있으면 유연하게 대처할 수 있다.
2. fetchType을 LAZY로 설정해야 하기 때문에 프록시가 초기화 될때마다 해당 쿼리를 날려서 N + 1 문제를 야기한다. 1은 내가 날린 최초의 쿼리이고 N은 최초의 쿼리로부터 나온 결과값의 개수이다. 만약 Order데이터가 2개가 들어있다면 N은 2가 되는것이고 위의 예제처럼 초기화가 두번 일어나는 경우 N이 하나 더 늘어 N + N + 1문제로 변한다(최악의 경우)
*version3
@GetMapping("/api/v3/simple-orders")
public List<SimpleOrderDto> orderV3() {
List<Order> orders = orderRepository.findAllWithMemberDelivery();
return orders.stream().map(o -> new SimpleOrderDto(o)).collect(Collectors.toList());
}
public List<Order> findAllWithMemberDelivery() {
return em.createQuery("select o from Order o join fetch o.member m join fetch o.delivery", Order.class)
.getResultList();
}
이렇게 내가 필요한 객체를 페치조인을 이용하여 한번에 끌어오게 되면 대부분의 성능문제가 해결이 된다.
Spring Data JPA
*스프링 데이터 JPA
*공통 인터페이스
1. 인터페이스로 repository를 만든다
2. JpaRepository를 상속받는다.
상속 받을 때 public interface MemberRepository extends JpaRepository<Member, Long> 이렇게 상속하는데 제네릭 첫번 째 부분은 매핑할 엔티티이고 두번 째는 해당 엔티티의 PK타입이다.
*메소드 이름으로 쿼리 생성
메소드 이름을 분석해서 JPQL 쿼리를 실행해주는 기능으로 파라미터가 많지않을 경우 (한두개) 해당 기능을 사용하면 좋다.
public List<Member> findByName(String name); 이렇게 선언만 해주면 스프링 데이터 JPA가 메소드 이름을 분석해 JPQL을 작성해준다.
위의 예제는 select m from Member m where m.name = :name 이다.
*리포지토리 메소드에 쿼리 정의하기
인터페이스 안에서 @Query 어노테이션을 사용하면 된다.
@Query("select m from Member m where m.name = :name and m.age = :age")
List<Member> findMember(@Param("name") String name, @Param("age") int age);
*@Query로 값, DTO 조회하기
-단순히 값 하나를 조회할 때
@Query("select m.name from Member m")
List<String> findNameList();
-DTO로 직접 조회할 때
@Query("select new study.datajpa.dto.MemberDto(m.id, m.name, t.name) from Member m join m.team t)
List<MemberDto> findMemberDto();
DTO로 직접 조회할 때에는 JPA의 new 명령어를 사용해야 한다. 그리고 다음과 같이 생성자가 맞는 DTO가 필요하다.
*파라미터 바인딩
-위치기반
select m from Member m where m.name = ?0
-이름기반
select m from Member m where m.name = :name
코드의 가독성과 유지보수를 위해 이름기반 파라미터 바인딩을 사용해야 한다.
cf) 컬렉션 파라미터 바인딩
컬렉션 타입으로 in절을 지원한다.
ex)
@Query("select m from Member m where m.name in :names")
List<Member> findByNames(@Param("names") List<String> names);
실제로 사용할 때에는
List<Member> result = memberRepository.findByNames(Arrays.asList("AAA", "BBB")); 이렇게 사용한다.
*스프링 데이터 JPA의 반환타입
스프링 데이터 JPA는 유연한 반환 타입을 지원한다.
스프링 데이터 JPA 공식 문서: https://docs.spring.io/spring-data/jpa/docs/current/reference/html/#repository-query-return-types
List<Member> findByName(String name); //컬렉션
Member findByName(String name); //단건조회
Optional<Member> findByName(String name); //단건조회 (Optional)
*스프링 데이터 JPA의 페이징
특별한 반환 타입
-org.springframework.data.domain.Page : totalCount쿼리 결과를 포함하는 페이징
-org.springframework.data.domain.Slice : totalCount쿼리 결과를 포함하지 않는 페이징 (다음 페이지 확인가능, 내부적으로 limit + 1조회)
Slice의 사용처
요즘 스마트폰에 많이 있는 기능으로 10개 조회하고 뒤에 더보기 버튼이 있는데 그 더보기 버튼을 구현할 때 사용한다.
사용방법
Page<Member> findByAge(int age, Pageable pageable);
Pageable의 구현체로 PageRequest를 사용한다.
PageRequest page = PageRequest.of(0, 3, Sort.by(Sort.Direction.DESC, "name"));
PageRequest.of의 속성 PageRequest.of(offset, limit, sorting)
page.getContent() //List타입으로 꺼내올 수 있다.
page.getTotalElements() //총 개수가 몇개인지
page.getNumber() //페이지 번호
page.getTotalPages() //페이지 개수
page.isFirst() //페이지가 첫번째인지 아닌지
page.hasNext() //페이지의 다음이 있는지
등등 사용할 수 있다.
cf) count 쿼리를 다음과 같이 분리할 수 있다.
@Query(value = "select m from Member m left join m.team t", countQuery = "select m from Member m")
Page<Member> findMemberAndTeam(Pageable, pageable);
count쿼리를 분리하는 이유 : count의 개수가 JPQL이 가져온 개수와 같을 때 countQuery가 없으면 count쿼리도 조인을 일일이 한다. 이는 곧 성능 저하로 이어질 수 있다. 그렇기 때문에 countQuery로 좀 단순한 쿼리를 만들어서 성능 저하를 피할 수 있다.
cf) 페이지를 유지하면서 엔티티를 DTO로 변환하기
Page, Slice, List 모두 스트림의 map과 같은 map을 제공한다.
page.map(m -> new MemberDto(m.getId(), m.getName(), m.getTeam());
*스프링 데이터 JPA를 사용한 벌크성 수정 쿼리
벌크성 수정 쿼리란?
update문을 날리면 영속성컨텍스트는 하나하나 일일이 update문을 날린다. 이는 데이터의 개수가 많아지면 엄청난 성능 저하로 이어진다. 그렇기 때문에 한방에 쿼리를 날려주는 기능을 제공하는데 그것이 바로 벌크성 수정 쿼리이다.
사용법
@Transactional
@Modifying(clearAutomatically = true)
@Query("update Member m set m.age = m.age + 1 where m.age >= :age)
int bulkAgePlus(@Param("age") int age);
Modifying해주는 이유 : Modifying이 없으면 해당 쿼리를 벌크 연산으로 인식을 못한다.
clearAutomatically 는 뭔가? : 벌크 연산에서의 가장 조심해야할 부분은 벌크 연산은 영속성 컨텍스트를 무시하고 곧장 DB로 달려가서 데이터를 업데이트 하는 것이기 때문에 영속성 컨텍스트가 데이터의 변동을 눈치채지 못한다. 데이터의 변동을 눈치채지 못한 영속성 컨텍스트는 해당 데이터의 값을 업데이트된 값이 아닌 이전에 등록한 값을 가지고 있기 때문에 영속성 컨텍스트를 깨끗하게 비우고 다시 작업을 해야한다.
*@EntityGragh
페치조인을 좀 쉽게 할 수 있는 장치이다. 하지만 직접 쿼리를 적는것이나 엔티티그래프를 사용하는것이나 크게 차이는 없으니 편한대로 사용하면 된다.
원래 페치조인 사용법
@Query("select m from Member m join fetch m.team t")
List<Member> findMemberAndTeam();
엔티티그래프 사용법
@EntityGraph(attributePaths = {"team"})
@Query("select m from Member m")
List<Member> findMemberAndTeam();
*사용자 정의 리포지토리 구현
만약에 findByName()이라는 인터페이스 하나만 구현을 하고싶은데 JpaRepository를 상속받은 MemberRepository에 findByName을 적고 구현하려 하면 MemberRepository 안에 있는 수많은 인터페이스를 전부 다 구현해야 한다. 나는 하나만 구현하고 싶은데... 이 때 필요한 것이 바로 사용자 정의 리포지토리이다.
사용법
1. MemberRepositoryCustom이라는 새로운 인터페이스를 만든다.
2. MemberRepository에서 MemberRepositoryCustom을 상속받는다.
3. MemberRepositoryCustom에 내가 구현하고싶은 것만 적는다.
4. MemberRepositoryImpl 이라는 구현체를 만들어서 구현한다.
이 때 주의!
4번에서 구현체를 만들 때 몇가지 규칙이 있는데 첫번 째로 JpaRepository를 상속받은 인터페이스명을 쓴다. 둘 째로 Impl 네글자를 붙여준다. 위의 예제대로면 MemberRepositoryImpl이 될것이다. 이렇게 규칙을 지켜야 스프링 데이터 JPA에서 알아서 연관관계로 묶어서 처리한다.
사용처
보통 JDBC template을 사용하거나 QueryDSL을 사용할 때 사용자 정의 리포지토리를 사용한다. 하지만 항상 사용자 정의 리포지토리가 필요한 것은 아니다. 임의의 리포지토리를 만들어도 된다. 위의 예제에서 예를 들어 MemberRepositoryCustom같은 인터페이스가 아니라 클래스로 만들고 스프링 빈으로 등록해서 직접 사용해도 된다. 물론 이 경우 스프링 데이터 JPA와는 아무런 관계 없이 별도로 동작한다.
*Auditing
Auditing은 등록일 수정일 등록자 수정자를 관리하는 것으로 실무에서 꼭 필요한 기능이다.
사용법
1. 스프링 부트 설정 클래스에 @EnableJpaAuditing 적용
2. 엔티티에 @EntityListeners(AuditingEntityListener.class) 적용
3. 사용할 어노테이션 : @CreatedDate, @LastModifiedDate, @CreatedBy, @LastModifiedBy
@EntityListeners(AuditingEntityListener.class)
@MappedSuperclass
@Getter
public class BaseTimeEntity {
@CreatedDate
@Column(updatable = false)
private LocalDateTime createdDate;
@LastModifiedDate
private LocalDateTime lastModifiedDate;
@CreatedBy
@Column(updatable = false)
private String createdBy;
@LastModifiedBy
private String lastModifiedBy;
}
이렇게 적용하고 사용할 엔티티에서 상속만 하면 된다. extends BaseTimeEntity
LocalDateTime은 자동으로 .now해서 찍어주면 되는 것 같은데 createdBy랑 lastModifiedBy는 어떻게 찍어주지?
스프링 부트 설정 클래스에서
@Bean
public AuditorAware<String> auditorProvider() {
return () -> Optional.of(UUID.randomUUID().toString());
}
원래대로라면 session에 있는거 꺼내서 Optional로 반환하면 된다.
*Web확장 - 페이징과 정렬
스프링 데이터가 제공하는 페이징과 정렬 기능을 스프링 MVC에서 편리하게 사용할 수 있다.
@GetMapping("/members")
public Page<Member> list(Pageable pageable) {
Page<Member> page = memberRepository.findAll(pageable);
return page;
}
localhost:8080/members?page=0&sort=name.desc 이런식으로 url 파라미터값으로 페이징을 할 수 있다. 주의할 점은 page가 0부터 시작이라는 점이다.
페이지 하나당 데이터는 20개가 디폴트값이며 이 디폴트 값을 변경하고 싶을 때는 글로벌하게 바꾸는 방법과 국소적으로 바꾸는 방법이 있는데 국소적으로 바꾸는 방법이 더 실용성 있다.
@GetMapping("/members")
public Page<Member> list(@PageableDefault(size = 5) Pageable pageable) {
Page<Member> page = memberRepository.findAll(pageable);
return page;
}
하지만 이러한 방법은 복잡한 sorting같은 것은 구현하기 힘들다.
AuditorAware
@Bean
public AuditingAware<String> auditorProvider() {
return () -> {
ServletRequestAttributes attr = (ServletRequestAttributes) RequestContextHolder.currentRequestAttributes();
String loginId = (String) attr.getRequest().getSessio().getAttribute("loginId");
if (loginId != null) {
return Optional.of(loginId);
}
else {
return Optional.of("Anonymous");
}
}
}
*JPA Auditing AuditorAware
Auditing에서 createdDate, lastModifiedDate는 @EnableJpaAuditing와 @CreatedDate, @LastModifiedDate를 이용하면 자동으로 값을 넣어준다. 하지만 @CreatedBy, @LastModifiedBy는 자동으로 값을 넣어주지 않는다. AuditorAware를 @Bean으로 스프링 빈에 올려서 직접 주입받아야 한다.
보통 createdBy, lastmodifiedBy의 값으로 세션값을 넣는 것이 보통이다. HttpServletRequest, HttpServletResponse, HttpSession과 같은 서블릿 객체를 얻기 위해서는 RequestContextHolder에서 현재 값을 받아온다.
@CreatedDate, @LastModifiedDate
데이터를 저장할 때 '생성된 시간 정보'와 '수정된 시간 정보'는 여러모로 많이 사용되고 또 중요합니다.
JPA를 사용하면서 @CreatedDate, @LastModifiedDate를 사용하여 생성된 시간 정보, 수정된 시간 정보를 자동으로 저장할 수 있는데요. 사용 방법과 동작 원리에 대해서 한번 알아보도록 하겠습니다.
import lombok.Getter;
import org.springframework.data.annotation.CreatedDate;
import org.springframework.data.annotation.LastModifiedDate;
import org.springframework.data.jpa.domain.support.AuditingEntityListener;
import javax.persistence.EntityListeners;
import javax.persistence.MappedSuperclass;
import java.time.LocalDateTime;
@Getter
@MappedSuperclass
@EntityListeners(AuditingEntityListener.class)
public class BaseTime {
@CreatedDate
private LocalDateTime createdDate;
@LastModifiedDate
private LocalDateTime modifiedDate;
}
많은 테이블에서 공통적으로 사용될 컬럼인 생성된 시간과 수정된 시간을 필드로 가지는 BaseTime Class 입니다.
대부분의 테이블에서 공통적으로 사용될 컬럼이니만큼 각각의 Entity에 생성하는 것보다 부모 클래스로 만들어 상속받아서 사용하는 것이 효율적이라 많이들 그렇게 사용하고 있습니다.
이제 하나씩 한번 보겠습니다.
@MappedSuperClass
해당 어노테이션은 객체의 입장에서 '생성 시간', '수정 시간'같은 공통 매핑 정보가 필요할 때 사용합니다. @MappedSuperClass 어노테이션을 사용함으로써 JPA Entity 클래스들이 BaseTime Class를 상속할 경우 BaseTime Class의 필드인 createdDate, modifiedDate를 인식하도록 합니다.
cf) @MappedSuperClass가 선언된 클래스는 Entity가 아니며 직접 생성해서 사용될 일이 없기 때문에 대부분 추상클래스로 만들어집니다. (위의 BaseTime도 public abstract class BaseTime으로 만드는 것이 원리적으로는 더 맞습니다.)
결론적으로 부모 클래스를 상속받는 자식 클래스에게 매핑 정보만을 제공하고 싶을 때 사용하는 어노테이션입니다.
@EntityListeners
EntityListeners란 JPA Entity에서 이벤트가 발생할 때마다 특정 로직을 실행시킬 수 있는 어노테이션입니다.
"Specifies the callback listener classes to be used for an entity or mapped superclass. This annotation may be applied to an entity class for mapped superclass."
(엔티티 클래스 또는 매핑된 슈퍼 클래스에 적용되며, 콜백될 클래스를 지정하는 어노테이션)
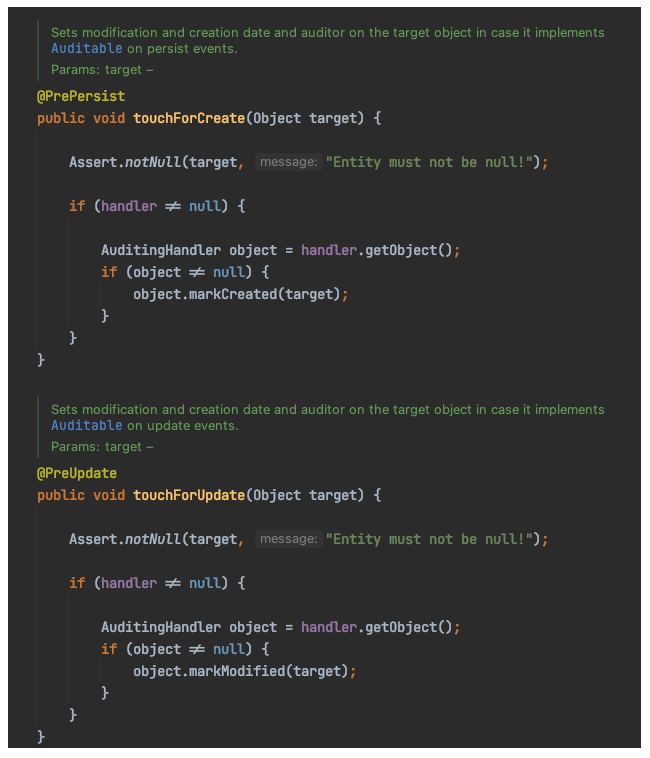
@EntityListeners(AuditingEntityListeners.class) 즉, AuditingEntityListener 클래스가 callback listener로 지정되어 Entity에서 이벤트가 발생할 때마다 특정 로직을 수행하게 됩니다.
AuditingEntityListener class
해당 클래스에 있는 touchForCreate(), touchForUpdate() 메서드입니다.
"Set modification and creation date and auditor on the target object in case it implements Auditable on update events."
(대상 개체에 업데이트 이벤트가 일어나느 ㄴ것을 auditing 하도록 설정된 경우에 생성된 날짜, 수정된 날짜, 생성자를 저장할 수 있도록 활성화)
@PrePersist: 해당 엔티티를 저장하기 전
@PreUpdate: 해당 엔티티를 업데이트 하기 전
+ 추가로
@PostLoad: 해당 엔티티를 새로 불러오거나 refresh 한 이후
@PostPersist: 해당 엔티티를 저장한 이후
@PostUpdate: 해당 엔티티를 업데이트 한 이후
@PreRemove: 해당 엔티티를 삭제하기 전
@PostRemove: 해당 엔티티를 삭제한 이후
그리고 결과적으로 @CreatedDate 어노테이션으로 인해 Entity가 생성되어 저장될 때 시간이 자동으로 저장되고, 마찬가지로 @LastModifiedDate는 조회한 Entity의 값을 변경할 때 시간이 자동으로 저장되게 됩니다.
마지막으로 빼먹으면 안되는 @EnableJpaAuditing
어플리케이션의 main method가 있는 클래스에 적용하며 JPA Auditing(감시, 감사) 기능을 활성화하기 위한 어노테이션입니다. 해당 어노테이션을 적용함으로써 createdDate, modifiedDate처럼 DB에 데이터가 저장되거나 수정될 때 언제, 누가 했는지를 자동으로 관리할 수 있게 됩니다.
N + 1 문제 해결 join fetch vs @EntityGraph
본 포스팅에선 N + 1 문제에 대해서 직접적으로 다루지 않습니다. N + 1 문제에 대한 개념적인 내용은 이미 많이 알려져 있기 때문에 다루지 않습니다.
그럼 이번 포스팅에선 무엇을 다룰것이냐
바로 join fetch 와 @EntityGraph에 대해서 알아볼 것입니다. 그리고 알아보면서 둘의 차이점과 각각을 사용할 때 주의 사항도 알아보도록 하겠습니다. 우선 join fetch부터 보겠습니다.
join fetch
대표적으로 알려진 N + 1 문제의 해결 방안입니다. 어떻게 사용하는지와 왜 사용하는지에 대해서는 말씀드렸다시피 다루지 않습니다.
대부분은 join fetch로 문제가 해결되기 때문에 만능이라고 생각하시는 분들이 있습니다. 하지만 join fetch도 만능은 아닙니다.
Native Query
우선 join fetch는 하드코딩 해야한다는 단점이 있습니다. 쓰는 방법을 잘 떠올려 보시면 native query로 만들어서 쿼리에 join fetch를 붙입니다.
native query의 문제점은 각종 휴먼 에러가 발생할 수 있다는 점입니다.
이를 해결하기 위해 Querydsl이라는 기술을 접목시킵니다. 이렇게 되면 자동완성이나 문법을 컴파일 단위로 체크할 수 있고 각종 휴먼 에러를 해결할 수있습니다.
그럼 native query가 해결됐으니 문제 업겠네요?
Pagination
또 다른 문제가 있습니다. 바로 ~ToMany 연관관계일 경우 Pagination을 조심해야 한다는 것입니다. 물론 Pagination을 진행할 때 ~ToOne인 연관관계는 조심하지 않아도 됩니다. 문제없이 페이징 쿼리가 날아갑니다.
하지만 문제는 ~ToMany일 때 입니다. ~ToMany 연관관계에서 페이징 쿼리를 넣으려 하면 잘 작동되는 것 같지만 로그에 WARN 로그가 찍힙니다. 내용인 즉슨 페이징 쿼리가 날아가지 않고 인메모리 페이징이 됐다는 내용입니다.
그렇다는 의미는 무엇일까요? 이 경고에는 두가지 홱심이 있습니다.
• 페이징 쿼리가 날아가지 않았다.
• 인메모리 페이징이 됐다.
이 둘은 서로 연관된 문제입니다. 둘로 보이지만 사실 하나의 문제라는 의미이죠. 한번 살펴보도록 하겠습니다.
우선 페이징 쿼리가 날아가지 않고 메모리에 모든 데이터가 올라갔다는 의미이기 때문에 혹시 데이터가 100만건이라면 모든 데이터가 메모리에 올라갔을 것입니다.
이렇게 되면 자칫 잘못했을 때 OOME (Out Of Memory Error)가 발생할 수 있습니다.
~ToMany 연관관계가 두개이상 경우
이런 경우에도 join fetch는 문제가 됩니다. 바로 ~Tomany 연관관계가 두개 이상인 경우에 join fetch를 사용하면 MultipleBagFetchException이 발생합니다.
여기서 Bag란 Hibernate에서 중복 요소를 허용하는 비 순차 컬렉션을 의미합니다. 그냥 단순하게 컬렉션을 의미한다고 생각하시면 됩니다.
이 Exception은 2개 이상의 @OneToMany 컬렉션 (Bag) 에 대한 Eager fetch 시 그 결과 만들어지는 카테시안 곱에서 어느 행이 유효한 중복을 포함하고 어능 행이 그렇지 않은지 판단할 수 없어 Bag 컬렉션으로 변환될 수 없기 때문에 예외가 발생하는 것입니다.
이에 대한 해결 방안으로는 자료구조를 List를 사용하지 않고 Set을 사용하는 방법과 default_batch_fetch_size를 조정하는 것입니다.
먼저 Set을 사용하는 경우를 생각해보죠
자료구조 Set 사용
단순히 HashSet을 사용한다는 것은 아닙니다. 순서가 있어야 하기 때문에 LinkedHashSet을 사용하는 것입니다. 하지만 이렇게 되면 페이징 쿼리가 나가지 않고 풀스캔 쿼리 발생 후 메모리에서페이징을 처리합니다. 이렇게 되면 해결되는 것 처럼 보이지만 데이터가 일정량 이상 많으면 전체 데이터를 조회해오는 것은 너무나 부담되는 일이라서 해당 방법을 쓰지 않습니다.
default_batch_fetch_size 조정
두번째로 application파일에서 default_batch_fetch_size를 조정하는 것입니다. 이렇게 되는 경우 쿼리가 in 쿼리로 날아가게 되며 가져오는 데이터가 많으면 많을 수록 효과를 보는 방법입니다. 때문에 이 방법이 가장 많이 쓰이는 방법입니다. 웬만하면 이 방법을 추천드리고 싶네요.
in 절이나 사용 방법에 대해서는 다루지 않습니다.
@EntityGraph
@EntityGraph는 Spring Data JPA 에서 제공하는 어노테이션입니다. attributePath를 지정해서 데이터를 eager로 가져오는 방법입니다.
장점은 하드코딩 하지 않아도 된다는 점이 있습니다.
하지만 단점으로는 관계가 복잡해지는 경우 헬게이트가 열릴 가능성이 있다는 문제가 있죠
하지만 N + 1 문제를 해결하는데에는 문제 없습니다. 간단한 관계인 경우 @EntityGraph를 사용하는 것도 좋은 방법일 수 있습니다.
다만 주의 사항이 있습니다.
join fetch는 inner join이고 @EntityGraph는 outer join이 발생해서 카테시안 곱이 일어나기 때문에 의도치않은 값이 생성될 수 있습니다.
따라서 이를 해결하기 위해서 자료구조 중 Set을 사용하거나 distinct로 중복을 제거하는 방법이 있습니다.
여기까지 join fetch와 @EntityGraph에 대해서 알아봤습니다. 자세한 내용이 들어가진 않았지만 전체적인 흐름을 파악하는 데에는 도움이 되셨으면 좋겠습니다. 긴 글 읽어주셔서 감사합니다.
Reference
https://jojoldu.tistory.com/457
https://programmer93.tistory.com/83
https://jojoldu.tistory.com/165
https://happyer16.tistory.com/entry/N1-%EB%AC%B8%EC%A0%9C-%ED%95%B4%EA%B2%B0%ED%95%98%EA%B8%B0
https://velog.io/@jinyoungchoi95/JPA-%EB%AA%A8%EB%93%A0-N1-%EB%B0%9C%EC%83%9D-%EC%BC%80%EC%9D%B4%EC%8A%A4%EA%B3%BC-%ED%95%B4%EA%B2%B0%EC%B1%85
@Transactional (Propagation과 Isolation의 관점에서)
우리는 보통 @Transactional을 많이 사용합니다. 트랜잭션을 wrapping 해주는 역할로서 많이 사용하죠.
이번 포스팅에선 @Transactional이 무엇인지, @Transactional에서 주로 사용하는 옵션인 Propagation, Isolation에 대해서 알아보도록 하겠습니다.
@Transactional
우선 @Transactional에 대해서 알아봐야겠죠?
@Transactional은 스프링이 만든 AOP중 하나입니다. @Transactional이 붙어있는 메서드에 한해서 트랜잭션의 원자성을 보장해주고 트랜잭션 시작, 커밋, 롤백을 수행해줍니다.
@Transactional의 등장으로 트랜잭션 코드와 비즈니스 로직을 분리하여 개발자들은 좀 더 순수한 비즈니스 로직을 구현할 수 있게 되었는데요.
@Transactional을 사용하는 방법
우리는 이 어노테이션을 인터페이스, 클래스, 메서드에 붙일 수 있습니다. 하지만 공식문서에서는 인터페이스에 붙이는 것을 추천하지는 않습니다. 이 인터페이스가 Spring Data JPA에 의해 만들어진 인터페이스가 아니라면 붙이는 것을 추천하고 있지 않죠.
이 어노테이션을 클래스 레벨에 붙이게 되면 해당 클래스의 public 메서드에 전부 붙게됩니다. private, protected는 어떻게 될까요? 그냥 에러 없이 무시됩니다.
@Service
@Transactional
public class TransferServiceImpl implements TransferService {
@Override
public void transfer(String user1, String user2, double val) {
// ...
}
}
이런식으로 클래스 레벨에 붙여도 되고?
@Transactional
public void transfer(String user1, String user2, double val) {
// ...
}
메서드 레벨에 붙여도 됩니다.
Propagation
Propagation(이하 전파단계)는 우리의 비즈니스 로직의 경계를 정의합니다. 스프링은 전파 단계의 정도에 따라 트랜잭션을 시작할수도, 중지할수도 있습니다.
스프링은 TransactionManager에 getTransaction을 통해 트랜잭션을 얻거나 만듭니다. 이렇게 만들어진 트랜잭션은 TransactionManager의 모든 종류의 전파단계를 지원합니다.
이제부터 JPA의 전파단계에 대해서 하나씩 알아보도록 하겠습니다.
REQUIRED
REQUIRED는 디폴트 전파단계입니다. 스프링은 현재 실행중인 트랜잭션이 있는지 체크하고 만약 존재하지 않는다면 새로운 것을 만듭니다. 비즈니스 로직은 현재 실행중인 트랜잭션에 붙어서 실행됩니다.
SUPPORTS
스프링은 먼저 현재 실행중인 트랜잭션이 존재하는지 체크합니다. 만약 트랜잭션이 존재하면 존재하는 트랜잭션이 사용될 것입니다. 만약 트랜잭션이 존재하지 않았다면 트랜잭션이 없는 상태로 실행됩니다.
NOT_SUPPORTED
만약 현재 트랜잭션이 있으면 스프링은 그 트랜잭션을 중지하고 비즈니스 로직이 트랜잭션 없이 실행됩니다.
REQUIRES_NEW
REQUIRES_NEW는 현재의 트랜잭션이 존재하면 중지합니다. 그리고 새로운 것을 만듭니다. NOT_SUPPORTED와 비슷한데, 이때 트랜잭션을 중지하기 위해서는 JTATransactionManager가 필요합니다.
NESTED
스프링은 트랜잭션이 존재하는지 체크하고 세이브 포인트를 만듭니다. 세이브 포인트를 만든다는 것의 의미는 만약 우리의 비즈니스 로직의 실행이 예외를 만나게 되면 트랜잭션은 이 세이브 포인트로 롤백합니다.
만약 실행중인 트랜잭션이 없다면 REQUIRED 처럼 동작합니다.
DataSourceTransactionManager는 이 NESTED 전파단계를 별도의 설치 없이 실행할 수 있도록 지원해줍니다. 또한 JTATransactionManager의 몇몇 구현체들도 이 NESTED단계를 지원합니다.
JpaTransactionManager는 오직 JDBC 커넥션을 위해 NESTED를 지원합니다. 그러나 만약 우리가 nestedTransactionAllowed의 속성을 true로 준다면 JDBC 드라이버가 저장지점을 원하는 경우, JPA 트랜잭션의 JDBC 접근 코드에 대해서도 작동합니다.
MANDATORY
만약 실행중인 트랜잭션이 있다면 그 트랜잭션이 사용될 것입니다. 만약 현재 실행중인 트랜잭션이 없다면 스프링은 예외를 던집니다.
여기까지 전파단계에 대해서 알아봤습니다. 이제 다음은 트랜잭션 격리수준과 JPA에서는 어떻게 트랜잭션 격리수준을 지원하는지 알아보죠
Transaction Isolation
격리수준은 흔히 ACID의 속성을 따릅니다. 격리수준은 동시에 실행되는 트랜잭션에 대해 어떻게 변하는지 시각적으로 보여줍니다.
데이터베이스 격리수준은 아래의 링크에 자세한 내용이 나와있으므로 중요한 부분만 짚고 넘어가도록 하겠습니다.
https://coding-review.tistory.com/196
각각의 격리수준에서 생기는 문제에 대해서만 빠르게 짚고 넘어가죠
• Dirty Read : Read UnCommitted 격리수준에서 생기는 부정합 문제로 커밋을 하지 않아도 상대방 트랜잭션의 값을 볼 수 있는 경우였죠. 심한 경우 롤백을 하더라도 롤백하기 전 데이터로 값을 변경할 수 있었던 가장 낮은 수준의 격리수준입니다.
• Non-Repeatable Read : Read Committed 격리수준에서 생기는 부정합 문제로 같은 쿼리에서 같은 결괏값이 나와야 한다는 Repeatable Read 정합성 문제에 어긋나는 부정합 문제였습니다.
• Phantom Read : Repeatable Read 격리수준에서 생기는 부정합 문제로 Non-Repeatable Read와 비슷하지만 Phantom Read는 같은 쿼리를 두번 날리는게 아닌 재실행했을 때 레코드가 보였다 안보였다 하는 문제였습니다.
스프링에서는 이 격리수준을 관리할 수 있는 속성들을 제공합니다. 하지만 디폴트값은 각각의 데이터베이스가 기본적으로 세팅해 둔 격리수준을 따릅니다.
또한 JPA에서는 지원하는 격리수준이지만 몇몇의 격리수준은 데이터베이스에서 지원하지 않는 격리수준도 있기 때문에 데이터베이스를 바꾸게 된다면 꼭 조심해야합니다.
READ_UNCOMMITTED
@Transactional(isolation = Isolation.READ_UNCOMMITTED)
public void log(String message) {
// ...
}
위의 방법처럼 사용하면 되지만 READ_UNCOMMITTED는 그냥 사용하지 않는것이 좋습니다. 기본적으로 생기는 부정합 문제인 Dirty Read도 그렇지만 Non-Repeatable Read나 Phantom Read도 발생할 수 있기 때문에 그냥 사용하지 않는 것이 좋습니다.
뭐 그런 자질구레한 이유 말고도 PostgreSQL이나 Oracle 같은 경우에는 READ_UNCOMMITTED 격리수준은 아예 지원을 안합니다. 그래서 READ_UNCOMMITTED로 설정하면 자동으로 디폴트 값인 READ_COMMITTED로 바뀌게 됩니다.
READ_COMMITTED
@Transactional(isolation = Isolation.READ_COMMITTED)
public void log(String message){
// ...
}
READ_COMMITTED는 앞서 발생했던 Dirty Read 부정합 문제를 해결하는 두번째 격리수준입니다. 하지만 READ_COMMITTED는 같은 쿼리에서 같은 결괏값이 나와야 한다는 Repeatable Read 정합성에 어긋납니다.
READ_COMMITTED는 Oracle과 PostgreSQL, SQL Server에서 디폴트 격리수준으로 사용하고 있습니다.
REPEATABLE_READ
@Transactional(isolation = Isolation.REPEATABLE_READ)
public void log(String message){
// ...
}
세번째 격리수준인 REPEATABLE_READ입니다. REPEATABLE_READ는 앞서 생긴 부정합 문제인 Dirty Read와 Non-Repeatable Read가 생기지 않습니다. 따라서 Uncommitted에 의한 동시다발적인 트랜잭션의 변화에대해 완전히 면역을 가지고 있습니다.
같은 쿼리에서 같은 결괏값을 보여주긴 하지만 재실행을 했을 때는 레코드가 보였다 안보였다 하는 Phantom Read가 발생합니다.
REPEATABLE_READ는 Mysql에서 디폴트 격리수준으로 사용하고 있습니다. 또한 Oracle에서는 이 격리수준을 지원하지 않습니다.
SERIALIZABLE
@Transactional(isolation = Isolation.SERIALIZABLE)
public void log(String message){
// ...
}
마지막 격리수준인 SERIALIZABLE입니다. 가장 강력한 격리수준 중 하나로 동시에 일어날 수 있는 모든 부정합 문제가 발생하지 않습니다.
하지만 변경 작업은 그렇다쳐도 읽기 작업까지 lock을 획득해야 하기 때문에 성능상 굉장히 불리함을 가지고 있습니다. SERIALIZABLE 격리수준 이외의 모든 격리수준은 성능이 다 비슷비슷한데 해당 격리수준만 처참한 성능을 가지고 있죠 때문에 대부분의 데이터베이스가 READ_UNCOMMITTED와 마찬가지로 사용하고 있지 않습니다.
여기까지 JPA의 전파단계가 무엇인지, 전파단계에는 어떤 것이 있는지, 격리수준은 어떤것을 지원하는지에 대해서 알아봤습니다. 그런데 이 글을 다 읽고 궁금증이 하나 들 수 있습니다.
Q. 그럼 Oracle, PostgreSQL, SQL Server는 Non-Repeatable Read 문제를 안고 가는건가요? Mysql은 Phantom Read 부정합 문제를 안고 가는건가요?
A. 그렇지 않습니다. 다 해결방법이 존재합니다.
보통의 경우 Non-Repeatable Read같은 부정합 문제는 MVCC를 통해 해결을 하고, Phantom Read 부정합 문제는 gap-locking이라는 방법을 통해 해결합니다.
이 두가지에 대해서는 추후에 데이터베이스 카테고리에서 자세히 다룰 예정이니 그때 다시 언급하도록 하겠습니다.
전파단계는 참 어렵네요 이해하는데 참 오래 걸렸던 것 같습니다. 전파단계를 실무에서는 어느레벨까지 사용할지 감이 잘 안잡히네요 REQUIRED나 REQUIRES_NEW정도는 많이 사용할 것 같은데... 다른 것들은 잘 사용할지 모르겠습니다.
아무래도 전파단계를 사용하는 목적이 서로 다른 두 트랜잭션을 병합하거나 이어붙이기 위해서 사용하는 느낌이 강하게 듭니다. 때문에 우리가 보통 토이프로젝트 레벨에서는 싱글트랜잭션을 사용하게 되니 디폴트 값만 사용하면 될 것 같습니다.
하지만 실무에서는 여러대의 데이터베이스를 묶어서 하나의 트랜잭션으로 처리하고 싶은 상황이 생길 수도 있으니 이럴 때 글로벌 트랜잭션과 함께 묶어서 전파단계를 설정하면 그럴듯하게 사용할 수 있을 것 같습니다.
여기까지 긴 글 읽어주셔서 감사합니다. 오늘도 즐거운 하루 되세요~
출처
https://www.baeldung.com/spring-transactional-propagation-isolation
https://www.marcobehler.com/guides/spring-transaction-management-transactional-in-depth
JPA가 트랜잭션을 관리하는 방법
JPA는 자바 진영에서 사용하는 대표적인 ORM 중 하나입니다. JPA로 인해 자바 개발자들이 데이터베이스 중심에서 객체 중심으로 설계 방식을 전환할 수 있었다고 개인적으로 생각하고 있는데요.
저는 여태껏 JPA를 사용하는데에만 집중을 했습니다. 그래서 JPA가 가진 특징들에 대해서는 등한시 한 느낌이 있습니다.
하지만 제 공부 방식은 항상 써보고 익숙해지면 개념을 공부하는 느낌이었어서 지금이라도 주요 개념들에 대해서 공부해보고자 오랜만에 JPA 카테고리에 글을 썼습니다.
이번 포스팅에선 JPA가 트랜잭션을 관리하는 방법과 JPA에서 제공하는 다양한 기능들에 대해서 소개해드리고자합니다.
JPA가 트랜잭션을 관리하는 방법
JPA는 트랜잭션을 프록시를 이용해서 관리합니다. 여기까지는 보통 알고 있는 내용일겁니다. JPA의 @Transactional이 스프링에서 만든 AOP 중 하나라는 것을 떠올리신다면 금방 알아차릴 내용입니다.
@Transactional이 붙은 모든 메서드와 클래스들을 프록시로 만들어서 AOP 방식을 이용해 트랜잭션 작업을 처리합니다. 이 프록시들은 스프링 프레임워크가 메서드 시작 전후로 트랜잭션 로직을 처리하는데 사용합니다.
그렇기 때문에 트랜잭션을 사용하기 위해서는 스프링 프레임워크의 도움을 받아야 합니다. 즉, 스프링 컨테이너인 Application Context를 이용해야 한다는 의미인데요.
이는 @Async와 같은 방식인데 @Async 어노테이션도 스프링 프레임워크에 도움을 받아 비동기 네트워킹을 원하는 메서드를 프록시로 잡아채서 별도의 스레드를 할당해줍니다.
이와 같이 @Transactional도 트랜잭션을 사용하고 싶은 메서드를 프록시가 가로채서 트랜잭션의 시작과 끝을 관리해줍니다.
스프링 컨테이너의 도움을 받아야 한다는 말은 @Async에서와 마찬가지로 직접 호출을 하거나 new 연산자로 동적할당 하면 아무리 @Transactional 어노테이션이 붙어있더라도 트랜잭션 처리가 되지 않는다는 의미를 뜻합니다.
@Transactional
public void create(Member member) {
memberRepository.save(member);
}
public void selfInvocationCall() {
Member member = new Member("홍길동");
create(member); // Wrong!!!
}
@RequiredArgsConstructor
@Transactional
public class MemberService {
private final MemberRepository memberRepository;
public void create(Member member) {
memberRepository.save(member);
}
}
@RequiredArgsConstructor
public class AnotherService {
private final MemberRepository memberRepository;
public void wrongImplement() {
MemberService memberService = new MemberService(memberRepository);
Member member = new Member("홍길동");
memberService.create(member);
}
}
또한, 프록시 객체 또한 자바에서 제공하는 클래승니기 때문에 private이나 protected로 되어있는 메서드는 프록시 객체가 @Transactional 어노테이션이 붙은 메서드를 확인할 수 없습니다.
때문에 public 접근 제어자만 @Transcational의 생명주기에 포함됩니다.
JPA에서 설정할 수 있는 것들
1. 전파단계
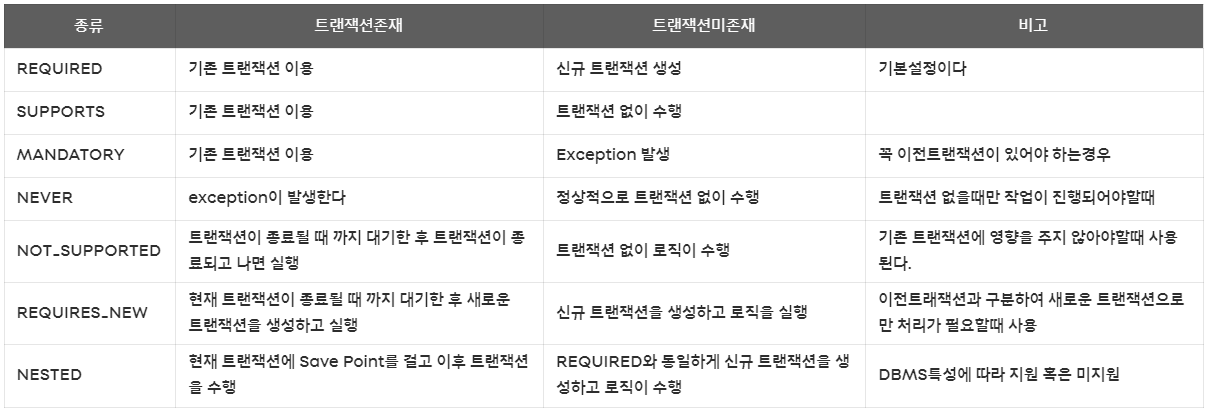
트랜잭션의 전파단계는 단어 그대로 트랜잭션을 "전파" 하는 정도입니다. 보통 기준은 기존 트랜잭션이 존재하는지 여부를 가지고 동작합니다.
위의 표는 전파단계를 잘 설명하고 있는 그림입니다.
트랜잭션의 전파단계를 잘만 조절하면 여러개의 상호작용하는 트랜잭션들을 사용하는 복잡한 시스템에서 일어날 수 있는 데이터 부정합 문제를 해결할 수 있습니다.
@Service
public class TransactionService {
@Authwired
BankService bankService;
@Transactional(propagation = Propagation.REQUIRED)
public void transferMoney(Long fromAccountId, Long toAccountId, BigDecimal amount) {
bankService.withdraw(fromAccountId, amount);
bankService.deposit(toAccountId, amount);
}
}
@Service
public class BankService {
@Autowired
private AccountRepository accountRepository;
@Transactional(propagation = Propagation.REQUIRES_NEW)
public void withdraw(Long accountId, BigDecimal amount) {
Account account = accountRepository.findById(accountId)
.orElseThrow(() -> new RuntimeException("Account not found"));
BigDecimal newBalance = account.getBalance().subtract(amount);
if (newBalance.compareTo(BigDecimal.ZERO) < 0) {
throw new RuntimeException("Insufficient balance");
}
account.setBalance(newBalance);
accountRepository.save(account);
}
@Transactional(propagation = Propagation.REQUIRES_NEW)
public void deposit(Long accountId, BigDecimal amount) {
Account account = accountRepository.findById(accountId)
.orElseThrow(() -> new RuntimeException("Account not found"));
BigDecimal newBalance = account.getBalance().add(amount);
account.setBalance(newBalance);
accountRepository.save(account);
}
}
위의 예제는 OO은행에서 사용하는 비즈니스 로직입니다. TransactionService 클래스에선 BankService 클래스에 있는 withdraw() 메서드와 deposit() 메서드를 호출하고 있습니다.
TransactionService에 있는 메서드는 전파 단계가 디폴트 값인 REQUIRED로 설정되어 부모 트랜잭션이 있으면 합병되고 부모 트랜잭션이 없으면 새로운 트랜잭션을 만들어 로직을 수행하게 됩니다.
BankService에 있는 두 개의 메서드는 전파 단계가 REQUIRES_NEW로 설정되어 부모 트랜잭션이 끝날 때까지 기다리고 있다가 새로운 트랜잭션을 만들어 로직을 수행합니다.
그렇기 때문에 부모 트랜잭션에서 실행되는 transferMoney() 메서드와 withdraw() 메서드와 deposit() 메서드가 모두 다른 트랜잭션에서 수행된다는 사실을 알 수 있습니다.
이렇게 처리하면 서로 격리된 상태에서 로직이 수행되어 데이터의 일관성을 유지할 수 있게 해줍니다.
2. 격리수준
데이터베이스에서 격리수준을 트랜잭션에서 그대로 적용할 수 있습니다. 이 얘기는 예를 들어 데이터베이스의 격리수준은 READ COMMITTED인데 @Transactional을 이용해 격리수준을 Serializable로 격상시킬 수 있다는 얘기입니다.
그에 따라 각각의 격리수준에서 해당하는 부정합 문제나 특징들을 그대로 따릅니다.
3. read-only 플래그
read-only 플래그를 true로 설정하면 트랜잭션을 read-only로 사용할 수 있을... 것처럼 생각이 듭니다. 하지만 이는 오해하기 쉬운 설정인데, 사실상 read-only 플래그를 설정하더라도 INSERT 연산이나 UPDATE 연산이 일어나지 않는다고 장담할 수 없습니다.
read-only 플래그를 이해하는데 중요한 점은 오직 트랜잭션 내부에서만 관련있다는 것입니다. 만약 트랜잭션 밖에서 read-only 플래그가 적용된다면 간단하게 무시됩니다.
가벼운 예시로 트랜잭션의 전파 단계를 SUPPORTS로 설정하면 부모 트랜잭션이 존재하면 부모 트랜잭션을 이용하면서 read-only가 작동하지만 부모 트랜잭션이 없는 상황에선 트랜잭션의 연산이 안걸리고 해당 로직이 실행되고 read-only 플래그가 정상적으로 작동하지 않는다.
4. rollback
우리는 보통 @Transactional을 선언하여 트랜잭션을 관리합니다. 이를 선언적 트랜잭션 관리라고 하는데요. 선언적 트랜잭션 처리에서 롤백은 rollbackFor 혹은 rollbackForClassName 속성을 이용해서 롤백을 진행할 수 있습니다.
예를 들어서 rollbackFor = SQLException.class 라고 적으면 SQLException이 발생하면 해당 트랜잭션에서의 연산을 롤백하겠다는 의미입니다.
@Transactional(rollbackFor = SQLException.class)
public void create(Member member) {
memberRepository.save(member);
throw new SQLException("rollbach test");
}
마치며
여기까지 JPA에서 트랜잭션을 관리하는 방법에 대해서 알아봤습니다. JPA가 AOP라는 사실은 알고 있었지만 프록시를 이용하기 때문에 스프링 컨테이너의 도움을 받아야 한다는 사실은 오늘 처음 알았네요.
이론 공부도 나름 프로젝트 진행하는 것 못지않게 재밌는 점이 많은 것 같습니다. 앞으로 JPA에 대해서 다뤄야할 내용들이 꽤 있는데요. 한번 차근차근 진행해보도록 하겠습니다.
긴 글 읽어주셔서 감사합니다. 오늘도 즐거운 하루 되세요~
출처
https://www.baeldung.com/transaction-configuration-with-jpa-and-spring
JPA의 동시성 컨트롤 (낙관적 락, 비관적 락)
이번 포스팅에선 JPA가 어떻게 동시성 문제를 컨트롤하는지에 대해서 포스팅해보겠습니다.
개인적으로 동시성 문제는 애플리케이션에서 일어날 수 있는 가장 최악의 버그라고 생각합니다. 그 이유로는
• RuntimeException이 발생하지 않는다.
• 컴파일러도 모른다.
• 심각한 장애를 야기한다. (재고가 1개 있는데 3명이 1개씩 주문하면 재고가 0이 되면서 결제 로그가 세개 찍힘)
때문에 이러한 동시성 문제에 대해 개발자가 반응하고 테스트 케이스를 통해 동시성 문제를 잡아내야한다고 생각합니다. 물론 쉽지는 않지만요.
JPA에선 이러한 동시성 문제를 해결하기 위해 두 가지 Locking 매커니즘을 제공합니다. 이제 본격적으로 시작해보죠!
Locking 매커니즘
JPA는 Locking 매커니즘으로 두 가지를 제공하는데 바로 낙관적 락 (Optimistic Lock) 과 비관적 락 (Pessimistic Lock) 입니다. 두 매커니즘 모두 특장점이 있는데요. 각각에 대해서 알아보고 언제 어떤 것을 사용해야 하는지 알아보죠.
낙관적 락 (Optimistic Lock)
이름에서도 알 수 있듯이 동시성 문제에 대해서 굉장히 낙관적인 편입니다. 그렇다고 실제로 동시성 문제가 발생해도 낙관적으로 아무것도 안해서 동시성 문제가 발생하는건 아니구요.
쉽게 설명하면 충돌이 일어날 때만 Lock을 건다는 의미입니다.
우선 동시성 문제가 발생하는 상황을 예시로 설명해보겠습니다.
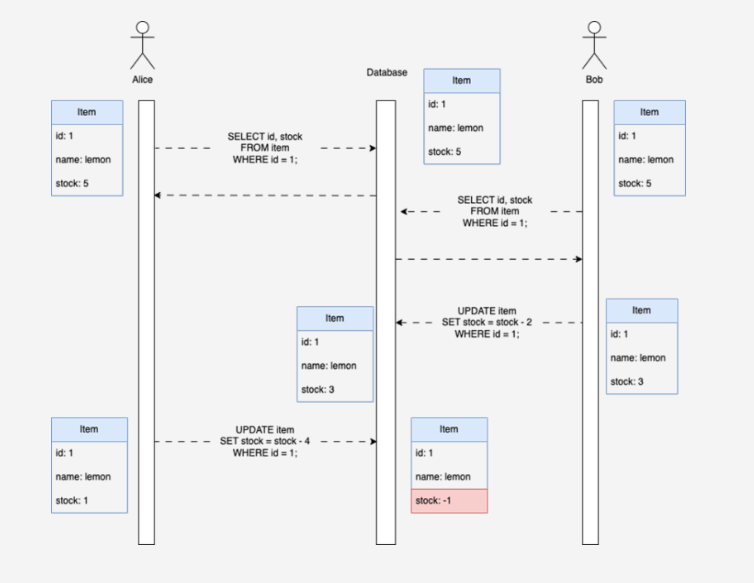
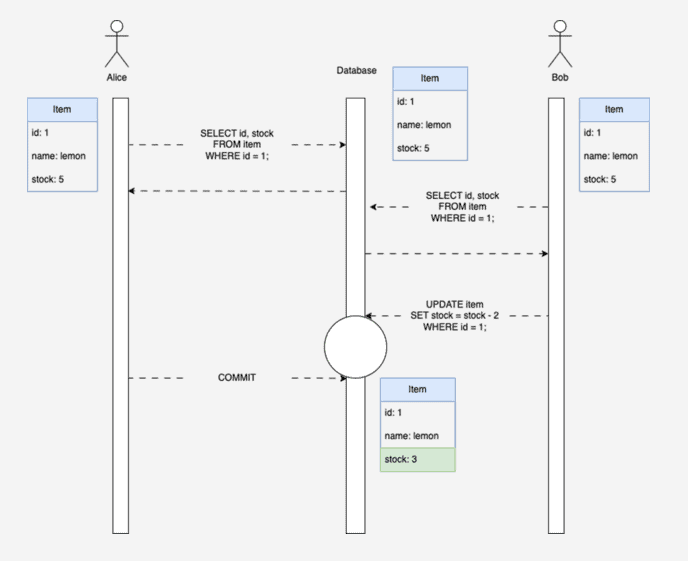
엘리스와 밥은 서로 레몬을 주문하는 상황입니다.
• 서로 레몬을 검색한다.
• 재고가 5개 남았다는 결과를 받는다.
• 밥은 레몬을 두 개 주문하고 엘리스는 레몬을 네 개 주문한다.
• 재고가 -1이 된다.
사실 위와같은 예제는 현실에서 일어나지 않습니다. 그 이유는 몇 가지가 있는데
• 멀티 스레드 환경이다.
각각 재고가 5개인 상태를 조회
• 밥은 레몬을 2개 주문, 엘리스는 레몬을 4개 주문
• 위의 그림대로 밥이 먼저 레몬을 주문해서 레몬의 재고가 3으로 변경
• 하지만 엘리스의 트랜잭션에서 레몬은 아직 5개
• 그러므로 엘리스가 업데이트를 하는 순간 레몬의 재고가 1로 변경
• 멀티 스레드 환경이 아니다.
싱글 스레드로 움직인다면 위와 같은 상황이 발생할 수 있습니다.
• 하지만 보통 재고가 0으로 내려가면 Exception을 발생시킬 수 있습니다.
• 때문에 위와 같은 예제는 발생하지 않습니다.
1번의 상황인 멀티스레드 환경에서는 JPA는 각각의 스레드에 서로 다른 트랜잭션을 부여하기 때문에 각 트랜잭션들은 데이터베이스의 격리수준에 의해 서로 다른 값을 바라보고 있습니다.
커밋을 넣자마자 바로 다른 트랜잭션에서의 재고에 영향을 미치지 않습니다.
일어나지 않는 것과 별개로 일어난다고 가정하고 이야기를 풀어보겠습니다. (위의 예제가 가장 적절했습니다.)
낙관적 락은 버저닝 (Versioning) 을 사용해서 동시성 문제를 해결합니다.
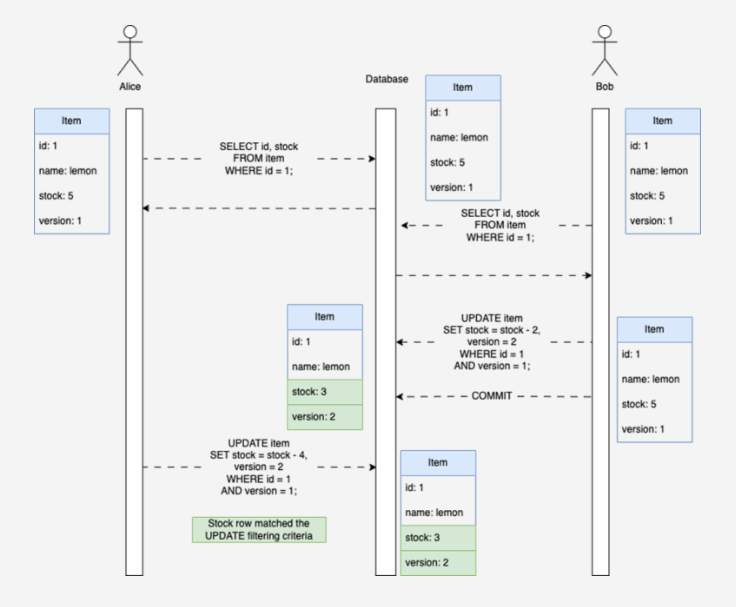
• 밥과 엘리스가 레몬을 조회한다. 재고 = 5, 버전 = 1
• 밥이 레몬 두개를 주문한다. 재고 = 3, 버전 = 2
• 엘리스가 버전 1의 레몬을 업데이트하려고 한다.
• Exception 발생!
이렇게 버전이 맞지 않으면 예외가 발생하게 되어있습니다.
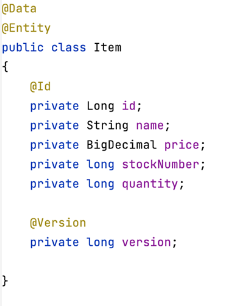
버저닝은 @Version 어노테이션을 이용합니다. 참고로 패키지는 javax.persistence에 있습니다. (스프링 부트 3.x 이상은 jakarta.persistence)
비관적 락 (Pessimistic Lock)
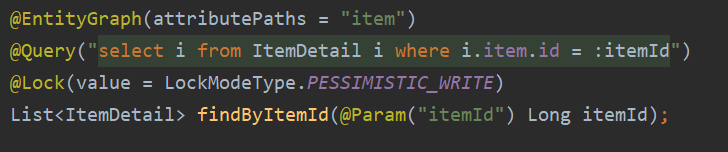
비관적 락은 동시성 문제가 무조건 발생하는 것을 가정하고 락을 걸어버립니다. 보통 읽기 연산에 락을 걸어서 데이터의 일관성을 보장합니다.
조금이라도 일찍 접근한 사람에게 커밋 권한이 주어지고 조금이라도 늦게 도착한 사람은 뒤에서 기다려야합니다.
보통 Spring Data JPA를 사용한다면 @Lock 어노테이션으로 비관적 락을 걸 수 있습니다.
3. 그래서 어떤 락을 써야하지?
• 낙관적 락 : 커밋 시 충돌이 일어나면 OptimisticLockException이 발생하여 해당 예외를 처리함으로써 동시성 문제를 해결할 수 있다.
성능이 비관적 락에 비해 좋음
• 충돌이 빈번하지 않은 경우에 사용하면 좋음
• 비관적 락 : 무조건 읽기 작업에 락을 걸어 동시성 문제를 해결할 수 있다.
성능이 좋진 않음
• 충돌이 빈번한 경우에 사용하면 좋음
• 위의 예시에서처럼 반드시 동시성 문제가 발생하지 않아야 하는 상황에서 사용하면 좋음
마치며
이번 포스팅에선 JPA의 동시성 문제 컨트롤에 대해서 알아봤습니다. 이 개념에 대해서는 제가 알고 있었던 개념이었고 실제로 낙관적 락과 비관적 락을 고민했었던터라 크게 어려움 없이 공부할 수 있었습니다.
여러분도 만약 프로젝트를 진행하다 동시성 문제가 발생할 것 같으면 JPA의 두 가지 Locking 매커니즘을 사용하는 것이 어떨까요?
긴 글 읽어주셔서 감사합니다. 오늘도 즐거운 하루 되세요~
출처
https://www.baeldung.com/jpa-optimistic-locking
https://serengetitech.com/tech/pessimistic-and-optimistic-locking-in-jpa-and-hibernate/
https://swathisprasad.medium.com/concurrency-and-locking-with-jpa-everything-you-need-to-know-6b1111bca3b2
JPA 2차 캐시 (feat. 1차 캐시)
이번 포스팅에서는 JPA의 2차 캐시에 대해서 알아보도록 하겠습니다.
JPA에서 우리가 익숙한 것은 1차 캐시입니다. 보통 영속성 컨텍스트로 많이 알려진 1차 캐시는 JPA가 동작하면서 필요한 데이터들을 모아두는 공간입니다.
보통 1차 캐시는 트랜잭션별로 저장하기 때문에 휘발성이 강한 캐시 저장소입니다.
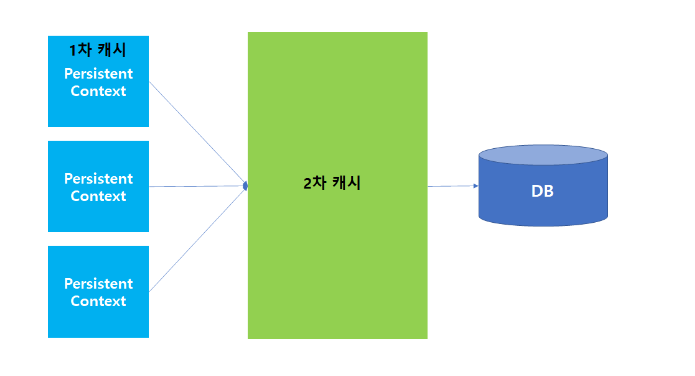
반면 2차 캐시는 1차 캐시와 다르게 글로벌하게 적용되는 캐시입니다. 애플리케이션마다 적용되는 캐시로서 애플리케이션이 종료될 때까지 유지되는 캐시입니다.
그럼 이제 본격적으로 2차 캐시에 대해서 알아볼까요?
2차 캐시
2차 캐시란 무엇인가?
2차 캐시는 앞서 설명했듯이 애플리케이션 단위의 캐시로 애플리케이션이 종료될 때까지 유지됩니다. 이 말은 멀티 스레드 환경에서도 글로벌하게 사용되는 캐시라고 이해할 수 있습니다.
즉, 우리가 만약 아래와 같은 쿼리를 날린다고 가정해봅시다.
public interface MemberRepository extend JpaRepository<Member, Long> {
Optional<Member> findById(Long id);
}
@Service
@RequiredAgrsConstructor
public class MemberService {
private final MemberRepository memberRepository;
@Transactional
public Member findMemberById(Long id) {
return memberRepository.findById(id).orElse(null);
}
}
이 메서드는 호출될 때마다 데이터베이스에 데이터 조회 요청을 보냅니다. 당연합니다. 트랜잭션별로 적용되는 캐시이니 트랜잭션이 끝나는 상황에서 1차캐시는 휘발됩니다.
앞서 설명했듯이 이 상황에서 2차 캐시를 사용하면 휘발되지 않고 사용할 수 있습니다.
2차 캐시는 어떻게 작동하는가?
2차캐시는 다음과 같은 동작 방식을 따릅니다.
• 1차 캐시를 뒤진다
• 없으면 2차캐시를 뒤진다
• 없으면 데이터베이스에서 조회하고 1차 캐시와 2차 캐시에 업데이트한다.
또한, 하이버네이트는 2차캐시의 대상으로
• 엔티티 캐싱 : 엔티티 단위로 캐싱합니다. 식별자(ID)로 엔티티를 조회하거나 컬렉션이 아닌 연관 관계에 있는 엔티티를 조회할 때 사용합니다.
• 컬렉션 캐싱 : 엔티티와 연관된 컬렉션을 캐싱합니다. 컬렉션이 엔티티를 담고 있으면 식별자 값만 캐싱합니다.
• 쿼리 캐싱 : 쿼리와 파라미터 정보를 키로 사용해서 캐싱합니다. 결과가 엔티티면 식별자 값만 캐싱합니다.
2차 캐시는 어떻게 사용하는가?
먼저 의존관계를 추가해야합니다.
implementation 'org.hibernate:hibernate-ehcache'
JPA의 2차 캐시는 다양한 구현체가 있지만 보통 스프링에 내장되어있는 EHcache를 사용합니다.
그리고 application.yml 파일을 아래와 같이 수정합니다.
spring:
jpa:
properties:
hibernate:
generate_statistics: true
format_sql: true
cache:
use_second_level_cache: true
region:
factory_class: org.hibernate.cache.ehcache.EhCacheRegionFactory
javax:
persistence:
sharedCache:
mode: ENABLE_SELECTIVE
logging:
level:
net:
sf:
ehcache: debug
JPA의 2차 캐시를 사용하기 위해서는 두 가지 어노테이션에 대해서 알아야합니다.
• @Cacheable : 엔티티 캐시를 적용할 때 사용하는 어노테이션입니다.
• @Cache : 하이버네이트 전용 어노테이션입니다. 캐시와 관련된 더 세밀한 설정을 할 때 사용합니다. 또한, 컬렉션 캐시를 적용할 때에도 사용합니다.
@Entity
@Cacheable
@org.hibernate.annotations.Cache(usage = CacheConcurrencyStrategy.READ_WRITE)
public class Post {
@Id
private Long id;
@OneToMany(mappedBy = "post", cascade = CascadeType.ALL)
@org.hibernate.annotations.Cache(usage = CacheConcurrencyStrategy.READ_WRITE)
private List<Comment> comments = new ArrayList<>();
// getters and setters
}
@Entity
@Cacheable
@org.hibernate.annotations.Cache(usage = CacheConcurrencyStrategy.READ_WRITE)
public class Comment {
@Id
private Long id;
@ManyToOne
private Post post;
// getters and setters
}
그리고 이제 xml 파일을 만들어줍니다.
<ehcache xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
xsi:noNamespaceSchemaLocation="http://www.ehcache.org/ehcache.xsd">
<defaultCache maxElementsInMemory="100"
eternal="false"
timeToIdleSeconds="120"
timeToLiveSeconds="120"
overflowToDisk="true"/>
<cache name="items"
maxElementsInMemory="1000"
eternal="false"
timeToIdleSeconds="300"
timeToLiveSeconds="600"
overflowToDisk="true"/>
</ehcache>
이 xml 파일은 src/main/resources 안에 저장하시면 됩니다.
그리고 Configuration 클래스를 작성해주면 됩니다.
@Configuration
@EnableCaching
public class CacheConfig {
@Bean
public CacheManager cacheManager() {
return new EhCacheCacheManager(ehCacheCacheManager().getObject());
}
@Bean
public EhCacheManagerFactoryBean ehCacheCacheManager() {
EhCacheManagerFactoryBean cmfb = new EhCacheManagerFactoryBean();
cmfb.setConfigLocation(new ClassPathResource("ehcache.xml"));
cmfb.setShared(true);
return cmfb;
}
}
만약 Spring Data JPA를 사용하고 있다면 다음과 같이 명시하면 됩니다.
public interface ItemRepository extends JpaRepository<Item, Long> {
@Cacheable("items")
List<Item> findByItemName(String itemName);
}
의문점
JPA의 2차 캐시가 엔티티를 캐싱해 오는 것이라면 만약 JPQL의 join fetch를 사용했을 때의 결과는 어떻게 될까요?
결괏값이 모두 캐싱될까요? 아니면 엔티티만 캐싱될까요?
정답은 엔티티만 캐싱됩니다. JPA의 2차 캐시는 @Cacheable이 붙어있는 엔티티를 캐싱해오고 결괏값은 캐싱해오지 않습니다.
하지만 결괏값을 모두 캐싱하는 것이 가능은 합니다. 바로 위에서 잠깐 언급했던 컬렉션 캐싱을 이용하면 됩니다. @Cache 어노테이션을 이용해 작성하는 것들은 컬렉션 캐싱이 되고 join fetch로 가져오는 결괏값을 캐싱할 수 있습니다.
하지만 컬렉션 캐싱은 일반적으로 추천하는 사용 방식은 아닙니다.
2차 캐시 사용 시 주의점
JPA의 2차 캐시는 캐싱 데이터를 동기화 해야 한다는 문제점이 있습니다. 이를 stale data 문제라고 합니다.
예를 들어
• 다수의 데이터베이스 트랜잭션을 사용하는 경우
• 다수의 애플리케이션 인스턴스가 있는 경우 (분산 시스템)
• 컬렉션 캐싱을 하는 경우
1. 다수의 데이터베이스 트랜잭션을 사용하는 경우
만약 우리의 애플리케이션이 데이터를 변경할 수 있는 다수의 트랜잭션을 가지고 있는 경우에 stale data문제가 발생합니다. 이 상황에선 멀티 스레드 환경일 수 있습니다.
예를 들어서 트랜잭션 1이 데이터를 읽어와서 캐싱을 했다고 가정합시다. 그리고 얼마 뒤에 트랜잭션 2가 데이터를 변경해서 데이터베이스에 넣었습니다.
하지만 트랜잭션 1은 아직 변경 전 데이터를 캐싱하고 있고 이 경우 데이터의 정합성이 맞지 않아 큰 문제가 발생할 수 있습니다.
2. 다수의 애플리케이션 인스턴스가 있는 경우
만약 우리가 분산 시스템처럼 여러개의 애플리케이션 인스턴스를 띄워서 사용하고 애플리케이션 각각이 2차 캐시를 사용한다면 캐시 데이터의 싱크를 맞추는 것이 하나의 챌린지가 될 수 있습니다.
이 경우는 위의 1번 처럼 캐싱 데이터의 싱크를 맞춰줘야 하는 문제가 발생합니다.
3. 컬렉션을 캐싱하는 경우
우리가 예를 들어 @OneToMany 혹은 @ManyToMany 어노테이션을 이용해 컬렉션을 연관관계로 지정했다면 stale data 위험이 증가합니다.
이는 위에서 엔티티 하나의 데이터를 변경하는 것 뿐만이 아닌 여러개의 데이터를 한방에 캐싱해놓게 되기 때문에 여러개의 데이터가 정합성이 맞지 않을 수 있기 때문입니다.
해결책
먼저 첫 번째 해결책으로는 TTL을 설정하는 방법입니다. 짧은 시간으로 TTL을 설정하면 캐싱 데이터가 제때제때 업데이트가 되어 stale data 문제를 피할 수 있습니다.
만약 애플리케이션이 분산 시스템에 멀티 스레드를 적용하고 있다면 캐시 데이터들을 모든 노드에 대해 싱크를 맞춰줘야 한다는 문제가 있다는 것을 기술했습니다. 이때 stale data 문제를 해결하기 위해 Redis나 Memcached와 같은 외장 캐싱을 이용하는 것이 방법이 될 수 있습니다.
또한, 캐싱을 해야하는 데이터를 잘 선정하여 캐싱을 최소한으로 설정하는 방법이 있을 수 있습니다.
곧죽어도 EHcache와 같은 2차 캐시를 이용해야겠다면 사용할 수 있는 설정정보가 있습니다. 바로 2차 캐시에서 제공하는 동시성 컨트롤입니다. 위의 예제에서 @Cache 어노테이션에 붙어있던 설정 정보인데 자세히 설명해보겠습니다.
• Read-only : Read-only 전략은 데이터가 절대 변경될 일이 없는 엔티티에 사용할 수 있습니다. 만약 Read-only 전략이 붙어있는 캐싱 엔티티에 변경을 시도하면 예외가 발생합니다.
• Read-write : 이 설정은 가장 많이 사용되는 설정입니다. Read-write 전략은 데이터의 변경이 많은 경우에 사용될 수 있습니다. 이 말은 아까 말했던 2차 캐시의 문제점인 stale data를 해결할 수 있다는 얘기입니다. 객체에 처음 접근한 트랜잭션에게 락을 주고 다음 트랜잭션이 캐시 데이터에 접근할 수 없게 하는 전략입니다. 이렇게 락을 활용함으로써 데이터의 정합성을 보장합니다.
• Nonstrict-read-write : 이 설정은 Read-write와 비슷하지만 Locking 매커니즘만 쏙 빠진 전략입니다. 때문에 데이터 정합성을 보장할 수 없지만 데이터 정합성을 느슨하게 처리함으로써 성능을 끌어올린 설정이라고 할 수 있습니다. 이 설정을 하는 경우는 데이터의 정합성이 그리 중요하지 않아서 결국 데이터의 정합성이 맞는 Eventual Consistency 전략을 취할 때 사용할 수 있습니다. 보통 NoSQL에서 주로 사용하는 전략이죠.
• Transactional : 이 상황은 JTA에서 잘 어울립니다. 캐싱 엔티티 안에서 어떤 변화도 같은 트랜잭션 안에서 커밋될 수도 있고 롤백 될 수도 있는 설정입니다. 이는 주로 글로벌 트랜잭션인 JTA의 XA 아키텍처에서 사용하면 용이합니다.
마치며
JPA를 깊이있게 공부하면서 알게된 내용중에 가장 흥미로운 내용이었습니다. 이전 두개의 포스팅인 JPA의 트랜잭션 관리법과 동시성 컨트롤은 사실 아는 내용이었어서 그리 큰 임팩트가 있지는 않았습니다.
하지만 제가 이론적으로만 알고 있던 EHcache가 사실은 JPA의 2차 캐시였다는 사실과 이론적으로 알고있던 캐싱 동기화 작업이 필요하다는 사실을 조금 더 깊이있게 공부하는 시간이 되었던 것 같습니다.
EHcache가 실무에서 많이 쓰인다고 하는데 이제 한번 공부 해봤으니 실무에서 조금 더 친숙하게 사용할 수 있을 것 같습니다.
긴 글 읽어주셔서 감사합니다. 오늘도 즐거운 하루 되세요~
출처
https://www.baeldung.com/hibernate-second-level-cache
https://vladmihalcea.com/jpa-hibernate-second-level-cache/
https://www.devtalkers.com/2020/04/hibernate-second-level-cache-spring.html
https://cla9.tistory.com/100
https://velog.io/@dnjscksdn98/JPA-Hibernate-First-Level-Cache-Second-Level-Cache
JPA 복합 기본 키 (Composite Primary Key)
이번 포스팅에선 JPA의 복합 기본 키에 대해서 알아보겠습니다.
사실 이 내용을 공부하면서 이게 대체 왜 필요하지..? 싶은 내용이었습니다. 도저히 실제 애플리케이션에서 사용할 것 같지 않은 개념이라 조금 당황했지만 이것도 엄연히 JPA의 스펙 중 하나이기 때문에 놓치고 싶지 않았습니다.
한번 어떤 내용인지 알아보죠!
JPA 복합 기본 키
우선 복합 기본 키라는게 어떤 것인지부터 알아야겠습니다.
복합 기본 키 혹은 복합 키로 잘 알려진 영어로 Composite Primary Key는 컬럼들이 한 행이 보장되는 유니크함을 결합될 때 테이블 안에서 각각의 행들이 유니크하게 식별되는 두개 이상의 키입니다.
이건 왜 사용할까요? 우리가 JPA를 사용할 때를 생각해볼 필요가 있습니다.
만약 이름이 홍길동인 사람을 찾아야 한다고 가정해봅시다. 그래서 JPA로 쿼리 메서드를 만듭니다.
public interface MemberRepository extends JpaRepository<Member, Long> {
Member findByName(String name);
}
이러면 한 두명이 아니니까 리턴값을 Member로 받을 수 없을겁니다.
그래서 이렇게 바꿨습니다.
public interface MemberRepository extends JpaRepository<Member, Long> {
List<Member> findByName(String name);
}
근데 이렇게 해놓으면 어떤 사람이 내가 찾는 사람일까요? 홍길동이 여러명이니까 누가 누구지?
이 때 등장하는게 복합 키 입니다. 예컨대 이름이 홍길동이고 네이버에 근무하는 사람을 찾고 싶다고 쿼리를 날리는겁니다.
그럼 아마 몇명 안나올겁니다. 그럼 문제가 해결됐습니다. 그리고 이게 두개가 아니고 여러개면 더 특정할 수 있을겁니다.
이런식으로 찾게 되면 굳이 기본키가 아니더라도 내가 원하는 데이터를 특정해서 찾을 수 있게 됩니다.
자 이제 어떻게 사용하는지에 대해서 알아보죠.
방법에는 두 가지가 있습니다. @IdClass 어노테이션과 @EmbeddedId 어노테이션을 사용하는 방법이죠.
JPA 복합 기본 키 어떻게 사용하나?
@IdClass
먼저 기본 키가 될 집합이 되는 클래스를 만듭니다.
import lombok.NoArgsConstructor;
import java.io.Serializable;
import lombok.AllArgsConstructor;
import lombok.Data;
@Data
@NoArgsConstructor
@AllArgsConstructor
public class StudentID implements Serializable {
private String studentId;
private String name;
}
그리고 엔티티 클래스를 만들어줍니다.
import java.io.Serializable;
import javax.persistence.Column;
import javax.persistence.Entity;
import javax.persistence.Id;
import javax.persistence.IdClass;
import javax.persistence.Table;
import lombok.AllArgsConstructor;
import lombok.Data;
import lombok.NoArgsConstructor;
@Data
@NoArgsConstructor
@AllArgsConstructor
@Entity
@Table(name = "student")
@IdClass(StudentID.class)
public class Student implements Serializable {
@Id
@Column(name = "student_id")
private String studentId;
@Id
private String name;
@Column(name = "school_id")
private int schoolId;
private int score;
}
여기서 주의하셔야 할 점은 복합 키가 되어야 할 클래스와 엔티티 클래스 모두 복합 키를 사용할 것이라면 Serializable을 implements 해줘야합니다.
Serializable은 직렬화를 나타내는 클래스입니다. 직렬화를 위해서라면 반드시 선언해줘야하는 클래스이죠. 같은 느낌으로 Redis 객체와 엔티티 객체를 매핑할 때도 직렬화 역직렬화가 필요합니다.
그리고 Repository 클래스를 만들어줍니다.
import org.springframework.data.jpa.repository.JpaRepository;
import com.spring.jpa.dto.Student;
import com.spring.jpa.dto.StudentID;
public interface StudentRepository extends JpaRepository<Student, StudentID> { // 제네릭 타입: <엔티티 클래스, 엔티티 클래스의 기본키>
}
이제 이대로 사용하시면 끝입니다.
@EmbeddedId
@EmbeddedId 역시 사용법은 비슷합니다.
import lombok.NoArgsConstructor;
import java.io.Serializable;
import javax.persistence.Column;
import javax.persistence.Embeddable;
import lombok.AllArgsConstructor;
import lombok.Data;
@Data
@NoArgsConstructor
@AllArgsConstructor
@Embeddable
public class StudentID implements Serializable {
@Column(name = "student_id")
private String studentId;
private String name;
}
import java.io.Serializable;
import javax.persistence.Column;
import javax.persistence.EmbeddedId;
import javax.persistence.Entity;
import javax.persistence.Table;
import lombok.AllArgsConstructor;
import lombok.Data;
import lombok.NoArgsConstructor;
@Data
@NoArgsConstructor
@AllArgsConstructor
@Entity
@Table(name = "student")
public class Student implements Serializable {
@EmbeddedId
private StudentID stduentID;
@Column(name = "school_id")
private int schoolId;
private int score;
}
복합 키를 모아놓은 클래스와 엔티티 클래스를 만듭니다. 그리고 Repository클래스를 만들면 끝입니다
import org.springframework.data.jpa.repository.JpaRepository;
import com.spring.jpa.dto.Student;
import com.spring.jpa.dto.StudentID;
public interface StudentRepository extends JpaRepository<Student, StudentID> { // 제네릭 타입: <엔티티 클래스, 엔티티 클래스의 기본키>
}
둘 중 어느 것을 사용해야 하지?
사실 둘의 성능 차이나 그런건 없습니다. 그냥 둘 중 편한거 사용하시면 됩니다.
저는 만약 둘 중 사용한다면 좀 더 객체지향스럽게 보이는 @EmbeddedId를 사용하지 않을까 싶습니다.
복합 기본 키의 장점
복합 기본 키를 사용하면 그냥 사용하는 것보다 조금 더 직관적으로 클래스를 표현할 수 있습니다.
또한, 정규화를 간단하게 이뤄낼 수 있다는 장점도 있죠. 혹은 @ManyToMany 상황에서 사용할 수도 있습니다.
근데... 굳이 사용해야 하나? (feat. ChatGPT)
이런 의문이 드실 수도 있습니다. 저도 이런 의문이 들었습니다.
이거 얻다 쓰지?
그냥 컬럼 명으로 여러개 조건을 달면 되는 것이고, JPA는 엔티티 클래스에서 객체로 매핑하는 방법들을 제공하는데 왜 굳이 저렇게까지 힘들게 해야하나 싶었습니다.
실제로도 복합 기본 키를 사용하는 것은 일반적인 상황은 아닙니다. 특별한 상황에서만 쓰는 것이죠.
그리고 많은 개발자들이 간단한 기본 키를 더 선호합니다. 그 이유도 여러가지가 있는데요.
• 간단함 : 간단하게 기본키 하나만 두는 것이 애플리케이션을 관리하고 이해하는데 더 쉽습니다.
• 성능 : 기본키 하나만 두는 것이 애플리케이션의 성능에도 좋습니다. 데이터베이스에선 다양한 연산이 있는데 인덱스나, 검색, 조인 등을 실행할 때 훨씬 빠른 속도를 보여줍니다.
• 프레임워크와 호환성 : JPA를 포함한 많은 프레임워크에서 기본 키를 하나만 두는 것을 전제로 하고 있습니다. 그래서 JPA에서도 @OneToOne, @ManyToOne, @OneToMany와 같은 어노테이션으로 엔티티들 사이의 관계를 매핑하는데 더 쉽게 만들어주는 어노테이션을 제공합니다.
그럼 복합 기본 키가 JPA의 스펙에 들어있는 이유는 뭘까요? 그것도 몇 가지 이유가 있습니다.
• 오래된 데이터베이스 아키텍처 : 만약 우리가 복합 기본 키를 사용하는 데이터베이스와 자바 애플리케이션을 매핑해야 할 때 사용해야합니다.
• @ManyToMany 매핑 : 다대다 관계에서 테이블을 조인하기 위해서 JPA는 다대다 조인을 위한 테이블이 하나 더 만듭니다. 이 때 종종 복합 기본 키를 사용해서 테이블을 만듭니다.
GPT가 추천해주기를
"설령 복합 기본 키를 사용해야 하더라도 복합 기본 키를 사용하는 것은 우리의 애플리케이션의 추가적인 복잡도를 야기할 수 있습니다. 그러니 특별한 이유에 의한 적절한 해결책을 위해 조심해서 고민해봐야 합니다."
마치며
여기까지 JPA의 복합 기본 키에 대해서 알아봤습니다. 복합 기본 키를 정리하자면 새로운 프로젝트에는 웬만하면 싱글 기본 키를 사용하고 오래된 데이터베이스 아키텍처와 JPA를 매핑해야 하는 상황에서 복합 기본 키를 사용하면 될 것 같습니다.
아무래도 JPA는 데이터베이스와 객체를 연결해줘야 하는 역할이 있기 때문에 데이터베이스에서 제공하는 복합 기본 키를 똑같이 지원할 수 밖에 없을 듯 싶습니다.
긴 글 읽어주셔서 감사합니다. 오늘도 즐거운 하루 되세요~
출처 (Thanks Chat GPT)
https://www.baeldung.com/jpa-composite-primary-keys
https://www.simplilearn.com/tutorials/sql-tutorial/composite-key-in-sql
https://www.geeksforgeeks.org/composite-key-in-sql/
JPA 엔티티 생명주기
이번 포스팅에선 JPA에서 엔티티의 생명주기에 대해서 알아보도록 하겠습니다.
스프링의 빈 생명주기를 공부해 보신 분들이라면 JPA의 엔티티 생명주기라는 말을 들으실 때 대충 감이 잡히실겁니다. 엔티티의 생명주기란 엔티티를 사용할 수 있는 다양한 상태라는 것을 말이죠.
스프링 빈 생명주기에 객체 생성, 의존 설정, 초기화, 사용, 소멸의 생명 주기를 가지고 있다면 JPA의 엔티티는 Trasient (비영속), Managed (영속), Detached (준영속), Removed (삭제) 상태가 있습니다.
한번 자세히 알아보죠.
JPA 엔티티 생명주기
New / Transient (비영속)
• 엔티티 객체가 생성된 상태를 말합니다. 이 상태를 New 혹은 Transient 상태라고 합니다. 이 상태는 객체가 아직 EntityManager에 연관된 상태가 아니고 데이터베이스와 연결도 되지 않은 상태입니다.
• Transient 상태는 곧 GC에 의해 삭제될 객체이고 더 이상 참조가 남아있지 않은 상태로 바뀔 것입니다.
Managed (영속)
• 엔티티 객체는 Managed 혹은 Persist 상태가 되고 EntityManager의 persist() 메서드를 통해 데이터베이스와 연결됩니다. 그리고 이 의미는 현재 활동중인 트랜잭션에 포함된다는 의미입니다.
• 영속 상태인 인스턴스는 항상 영속성 컨텍스트와 연결되어 있고 @Transactional의 대상이기도 합니다.
• 만약 영속 상태의 객체의 값이 변한다면 트랜잭션이 커밋할 때 데이터베이스와 자동으로 동기화 작업을 진행해줍니다. 이 작업이 바로 잘 알려지기로는 Dirty Checking 우리말로 변경 감지라고 합니다.
• EntityManager에 의해 데이터베이스로부터 조회된 엔티티 객체 또한 영속 상태입니다.
Detached (준영속)
• Detached (준영속) 상태는 EntityManager로부터 연결이 끊어진 엔티티 객체를 나타냅니다.
• 객체의 식별자는 데이터베이스 테이블 안에서 존재해야하고 객체는 영속성 컨텍스트와 연관되어있지 않습니다.
• 인스턴스는 하이버네이트 세션에서 close() 메서드를 수행할 때 영속성 컨텍스트와의 연관성을 잃어버립니다.
• 이 상태는 더 이상 데이터베이스와 동기화를 보장하지 않습니다. 준영속 상태의 객체는 더 이상 영속성 컨텍스트의 관리아래 있지 않고 GC에 의해 삭제될 운명입니다.
Removed (삭제)
• 영속 상태인 엔티티 객체는 EntityManager의 remove() 메서드에 의해 트랜잭션에서 떨어져나오고 머리에 "삭제" 딱지를 붙이고 있습니다. 그럼 이 엔티티 객체는 Managed 상태에서 Removed 상태로 변경됩니다. 이 상태는 물리적으로 데이터베이스로부터 떨어져나온 상태입니다.
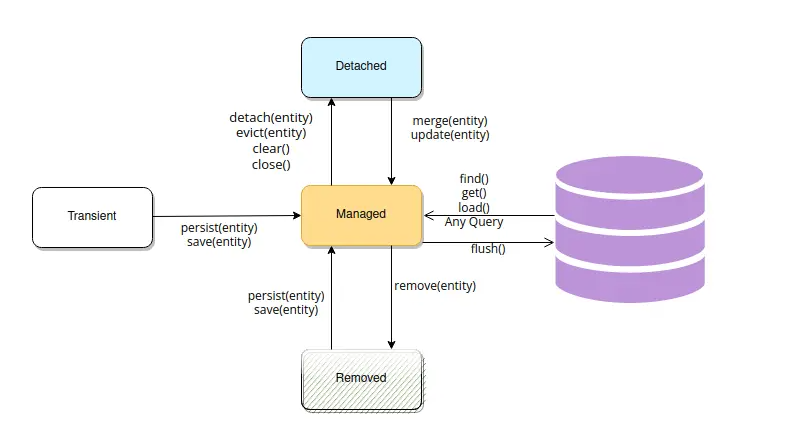
계속 영속성 컨텍스트에 대해서 언급하는데 영속성 컨텍스트에 대해 빠르게 짚고 넘어가겠습니다.
영속성 컨텍스트
영속성 컨텍스트는 EntityManager의 모든 영속화된 객체들을 모아둔 컬렉션입니다. 만약 우리가 엔티티를 조회하려고 하면 영속성 컨텍스트에 엔티티가 존재하는지 살펴보고 존재하면 엔티티 객체는 데이터베이스에 접근해서 엔티티 객체를 가져오는 것이 아니라 영속성 컨텍스트로부터 엔티티 객체를 리턴받아 관리합니다.
모든 EntityManager는 영속성 컨텍스트를 가지고 있고 영속성 컨텍스트는 주어진 EntityManager의 로컬 캐시로서 사용됩니다.
마치며
이번 포스팅은 JPA의 엔티티 생명주기에 대해서 알아봤습니다. 사실 오래전에 이 개념에 대해서 포스팅을 하긴 했는데요. 그땐 뭔소리인지도 모르고 그냥 들었어서 다시 업데이트할겸 새롭게 올렸습니다.
이번 개념을 공부하면서 느낀점은 보통 Spring Data JPA를 사용할텐데 저렇게 영속 준영속 왔다갔다 하면서 쓸 일이 있을까 싶은 느낌은 있습니다.
그냥 영속 상태에서 작업하는게 생각할 것도 없고 간단한데말이죠. 이 부분에 대해서는 추후에 GPT한테 물어보도록 하겠습니다.
이렇게 긴 글 읽어주셔서 감사합니다. 오늘도 즐거운 하루 되세요~
출처
https://www.mastertheboss.com/java-ee/jpa/understanding-jpa-entity-life-cycle/
https://javabydeveloper.com/jpa-entity-lifecycle-jpa-developer-should-know/
트랜잭션 전파 (feat. 논리 트랜잭션, 물리 트랜잭션)
이번 포스팅에선 트랜잭션 전파에 대해서 알아보도록 하겠습니다.
사실 트랜잭션 전파에 대해서는 어느정도 알고 있는 부분이 있었는데 제가 아는 수준은 "트랜잭션 전파를 이용하면 데이터 정합성을 유지할 수 있고 그 단계에는 일곱가지 (REQUIRED 외 6개) 가 있다."
그리고 각각의 전파 단계에 대해서 학습을 했는데요. 그러다 오랜만에 인프런에 들어갔는데 사놓고 안들은 강의가 있었습니다. 김영한님의 DB 접근기술 2탄이었습니다. 이걸 왜 안봤지? 싶어서 봤는데 정말 흥미로운 내용이 있었습니다.
왜 트랜잭션을 전파할 수 밖에 없었는지, 전파 도중 롤백이 일어나면 어떻게 처리하게 되는지에 대한 내용을 상세하게 알려주셨습니다. (역시 영한님!)
이번 포스팅에선 그 내용에 대해서 제 언어로 정리하기 위해 적는 포스팅입니다. 더 자세한 내용은 영한님의 스프링 데이터 접근기술 2탄을 참고해주세요!
트랜잭션 전파
스프링에서는 트랜잭션을 이용해 유연한 데이터베이스 연산 처리를 할 수 있었습니다.
JPA는 이러한 트랜잭션과 함께 쓰기지연으로 상당히 유연한 처리를 할 수 있습니다. 하지만 트랜잭션이 가진 한계도 분명히 존재했습니다.
복잡하게 꼬여있는 애플리케이션 코드들을 사용하기 위해 너도나도 @Transactional 어노테이션을 이용해 트랜잭션을 걸었습니다.
@Transactional
public void 어쩌고저쩌고로직() {
// 대충 뭐 조회하는 로직
// 대충 조회 했던 거 가공하는 로직
// 대충 가공하고 저장하는 로직
}
@Transactional
public void 어쩌고저쩌고로직() {
// 대충 뭐 조회하는 로직
// 대충 조회 했던 거 가공하는 로직
// 대충 가공하고 저장하는 로직
}
그러다보니 트랜잭션이 꼬이는 문제가 발생했고 한번 꼬이기 시작하니까 걷잡을 수 없는 문제가 발생했습니다.
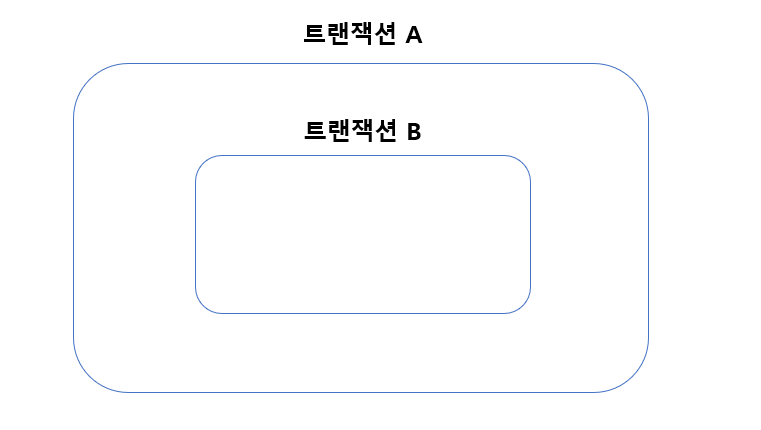
이렇게 트랜잭션 A 안에서 트랜잭션 B를 시작하게 되면 만약 트랜잭션 B에서 예외가 터져 롤백을 하는 경우 상당히 복잡해지게 됩니다.
A도 롤백 해야하나? B만 롤백하나? 그럼 A에서 롤백하면 B는? 이게 두개니까 망정이지 세개 네개 이렇게 쌓이다보면 정말 끝도없이 복잡해질 수 있었습니다.
이 문제는 스프링이 반드시 해결해야 하는 문제였습니다. 때문에 스프링에선 논리 트랜잭션, 물리 트랜잭션이라는 개념으로 해결할 수 있었습니다.
논리 트랜잭션, 물리 트랜잭션
논리, 물리 트랜잭션의 개념은 간단합니다. 여러개의 트랜잭션이 겹쳤다면 그걸 아우르는 하나의 트랜잭션으로 묶는다는 개념이었습니다.
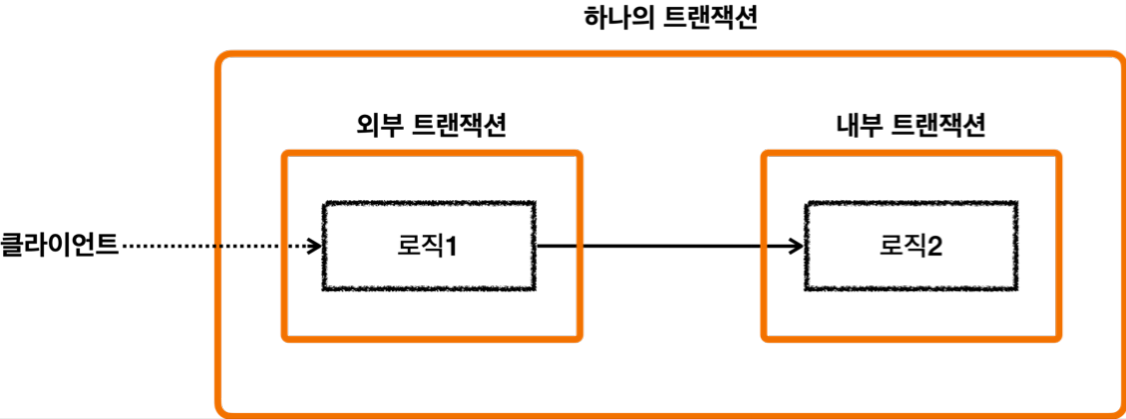
맨 처음 외부 트랜잭션에서 호출한 트랜잭션과 그 다음 호출한 내부 트랜잭션을 묶는 하나의 트랜잭션으로 이 문제를 해결했고 하나로 묶는 트랜잭션을 물리 트랜잭션, 안쪽에 있는 트랜잭션들을 논리 트랜잭션으로 명명했습니다.
논리 트랜잭션은 실제 데이터베이스에 영향을 주는 트랜잭션이 아닌 말 그대로 논리적인 단위입니다. 안에서 트랜잭션이 작동하긴 하지만 결과적으로 데이터베이스에 영향을 주는 트랜잭션은 물리 트랜잭션이라는 말입니다.
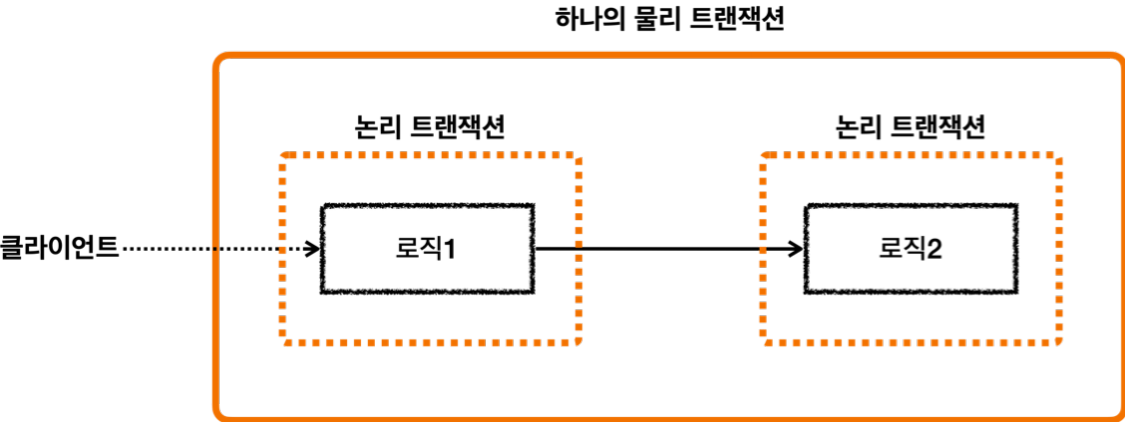
이렇게 논리, 물리 트랜잭션을 도입하면서 생긴 큰 변화는 다음과 같습니다.
• 트랜잭션 커밋과 롤백을 일관성있게 할 수 있음
• 모든 논리 트랜잭션이 커밋이 되어야 물리 트랜잭션이 커밋이 됨
• 하나의 논리 트랜잭션이라도 롤백을 하면 물리 트랜잭션이 롤백 됨
그런데 트랜잭션은 한번 커밋하거나 롤백하면 종료되는데 어떻게 트랜잭션 여러개가 커밋되거나 롤백될 수 있는거죠?
트랜잭션의 커밋 / 롤백 과정
이제 트랜잭션이 롤백되는 상황이 어떻게 진행되는지 알아볼겁니다.
사실 모든 논리 트랜잭션이 커밋되면 물리 트랜잭션이 커밋된다는 개념은 정말 간단합니다. 하지만 롤백은 단순하지 않습니다.
한번 알아보죠.
Case 1. 모든 트랜잭션이 커밋하는 경우
트랜잭션이 시작되는 지점인 외부 트랜잭션은 커넥션 풀에서 새로운 커넥션을 맺고 트랜잭션을 시작합니다. 이렇게 만들어진 외부 트랜잭션은 한가지 설정을 합니다.
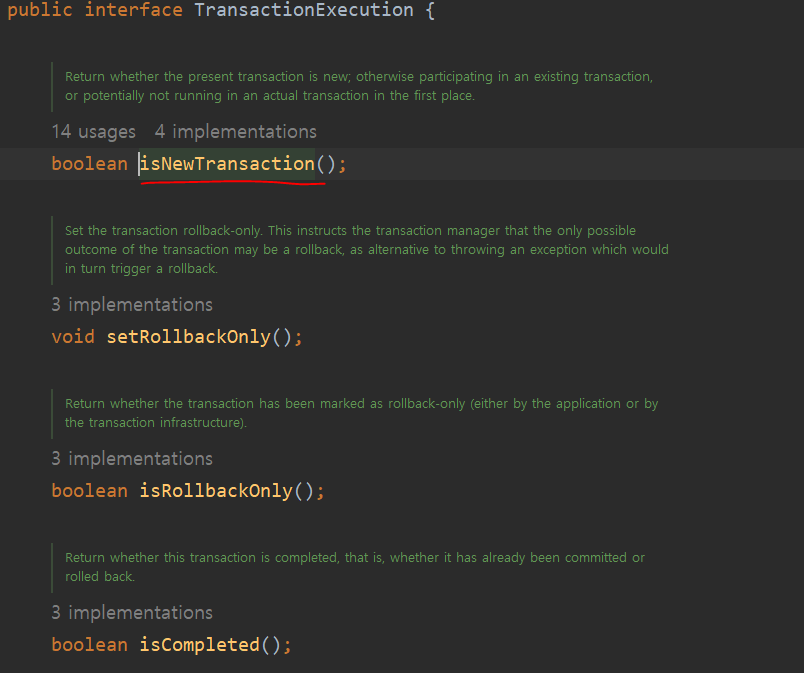
isNewTransaction() 설정을 true로 설정하는 것이죠.
논리 트랜잭션들 중 트랜잭션에 편입된 내부 트랜잭션은 해당 설정이 false로 되어있습니다. 이 설정이 true로 되어있으면 언제 물리 트랜잭션이 커밋해야 하는지 알 수 있습니다.
어떻게 알 수 있을까요?
구조적으로 봤을 때 외부 트랜잭션이 트랜잭션을 시작하고 내부 트랜잭션이 커밋을 먼저 하고 다음 외부 트랜잭션이 커밋하게 되어있습니다.
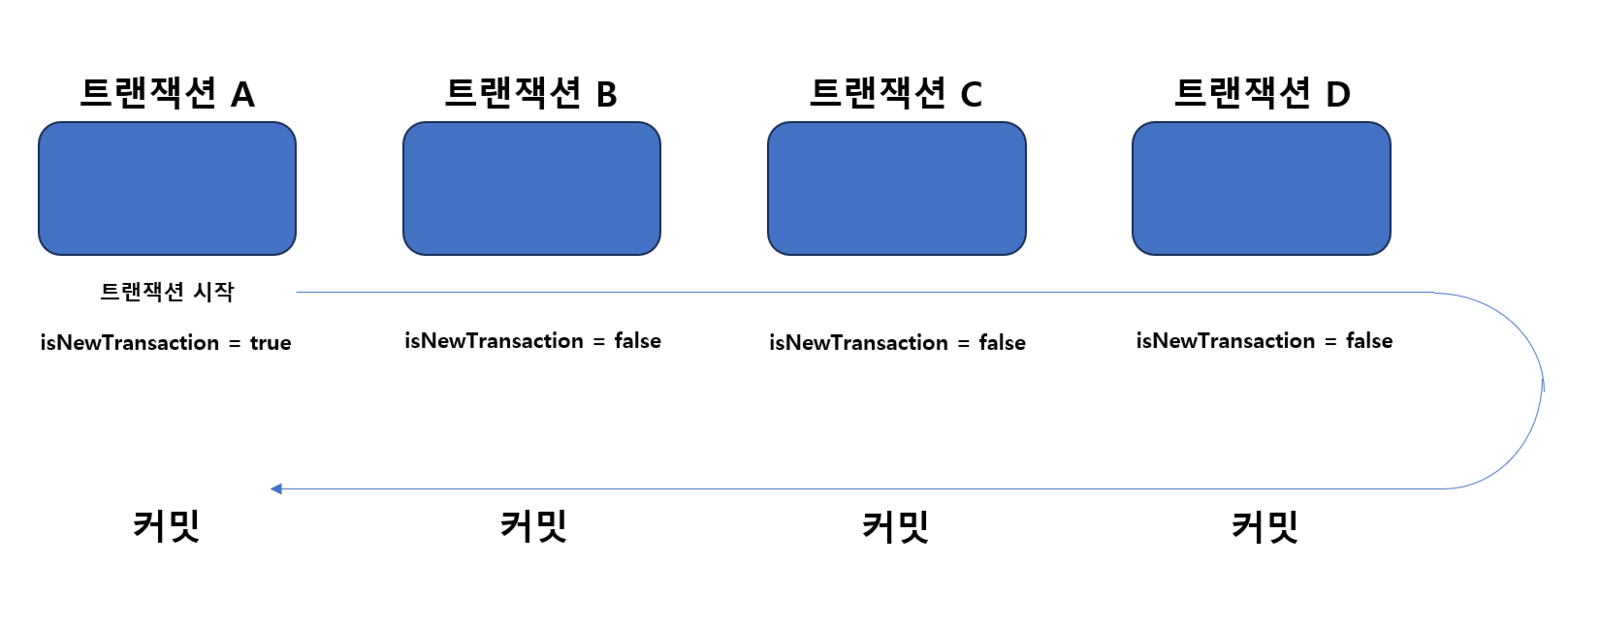
맨 처음 커밋을 진행하는 트랜잭션 D는 isNewTransaction 속성이 false이기 때문에 커밋을 하지 않고 그냥 지나갑니다. 이건 C, B도 마찬가지이구요.
실제로 isNewTransaction 속성이 true이 트랜잭션 A가 커밋할 때 데이터베이스에 반영이 됩니다.
Case 2. 외부 트랜잭션에서 롤백하는 경우
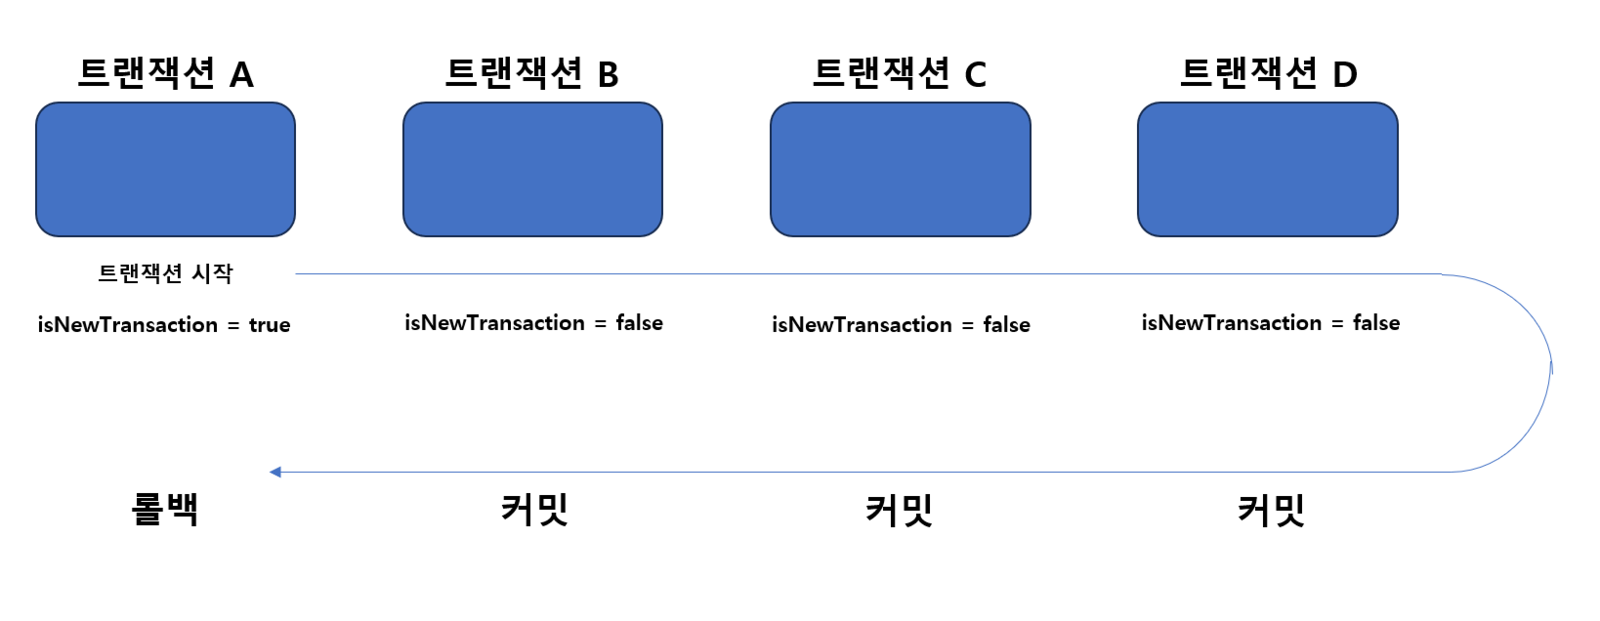
이 경우도 어렵지 않습니다. 앞서 설명했듯이 물리 트랜잭션의 실행을 담당하는 것은 isNewTransaction 속성이 true인 트랜잭션을 따릅니다.
만약 외부 트랜잭션인 A 트랜잭션에서 롤백이 일어나면 isNewTransaction 속성이 true이기 때문에 물리 트랜잭션이 이 속성을 보고 트랜잭션을 커밋할지 롤백할지를 정합니다.
지금은 트랜잭션 A에서 예외가 터져서 롤백을 진행해야 하니 물리 트랜잭션은 쉽게 롤백해버립니다.
Case 3. 내부 트랜잭션에서 롤백하는 경우
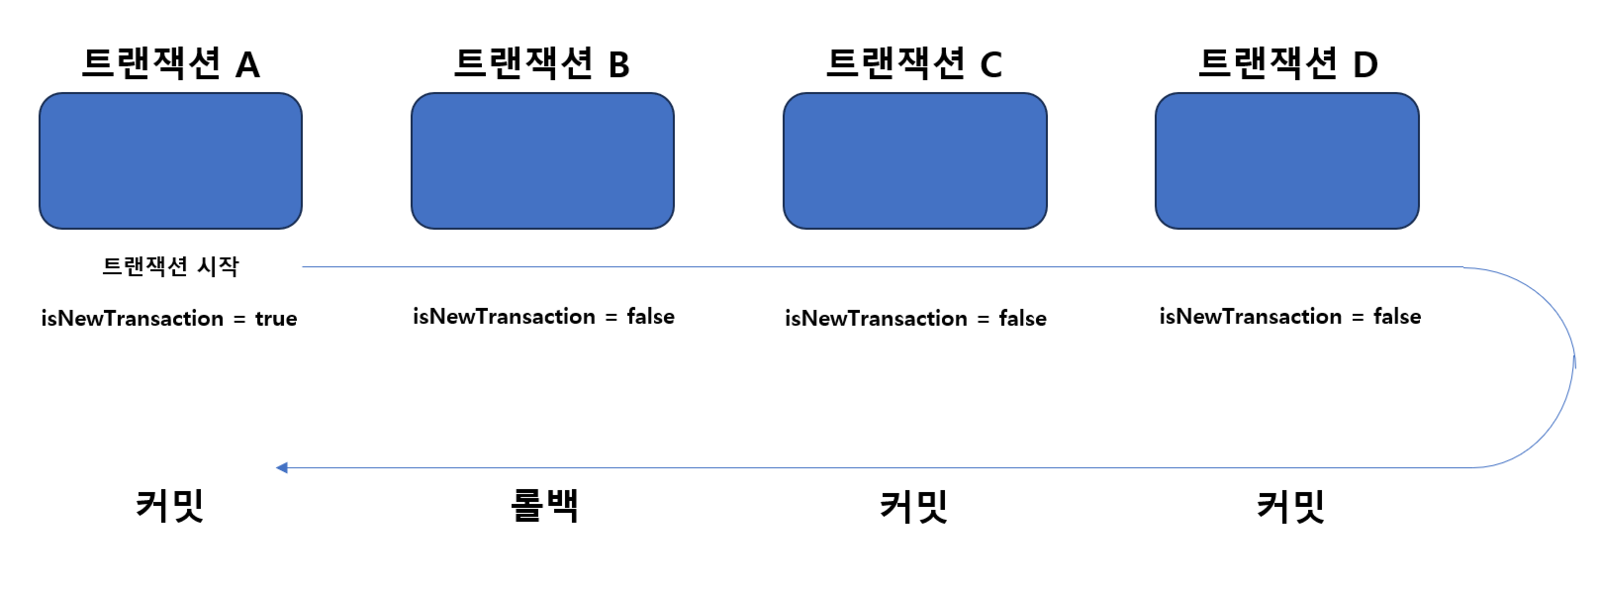
이 경우는 어떡하죠?
앞서 설명했듯이 isNewTransaction이 false인 내부 트랜잭션은 물리 트랜잭션의 연산에 어떤 역할도 하지 않습니다. 그냥 넘어가게되죠.
그런 내부 트랜잭션에서 예외가 터져서 롤백을 진행해야 한다면 물리 트랜잭션은 롤백해야 합니다. 왜냐하면 하나라도 롤백을 해야하면 모든 트랜잭션이 롤백해야 하기 때문이죠. 이는 트랜잭션의 원자성의 개념하고 일맥상통합니다.
이럴 때를 대비해서 스프링은 rollback-only라는 속성을 가지고 있습니다.
내부 트랜잭션에서 롤백을 진행해야 할 때 내부 트랜잭션은 물리 트랜잭션에 영향을 주지 않기 때문에 그냥 넘어가되 rollback-only 속성을 true로 바꾸고 지나갑니다.
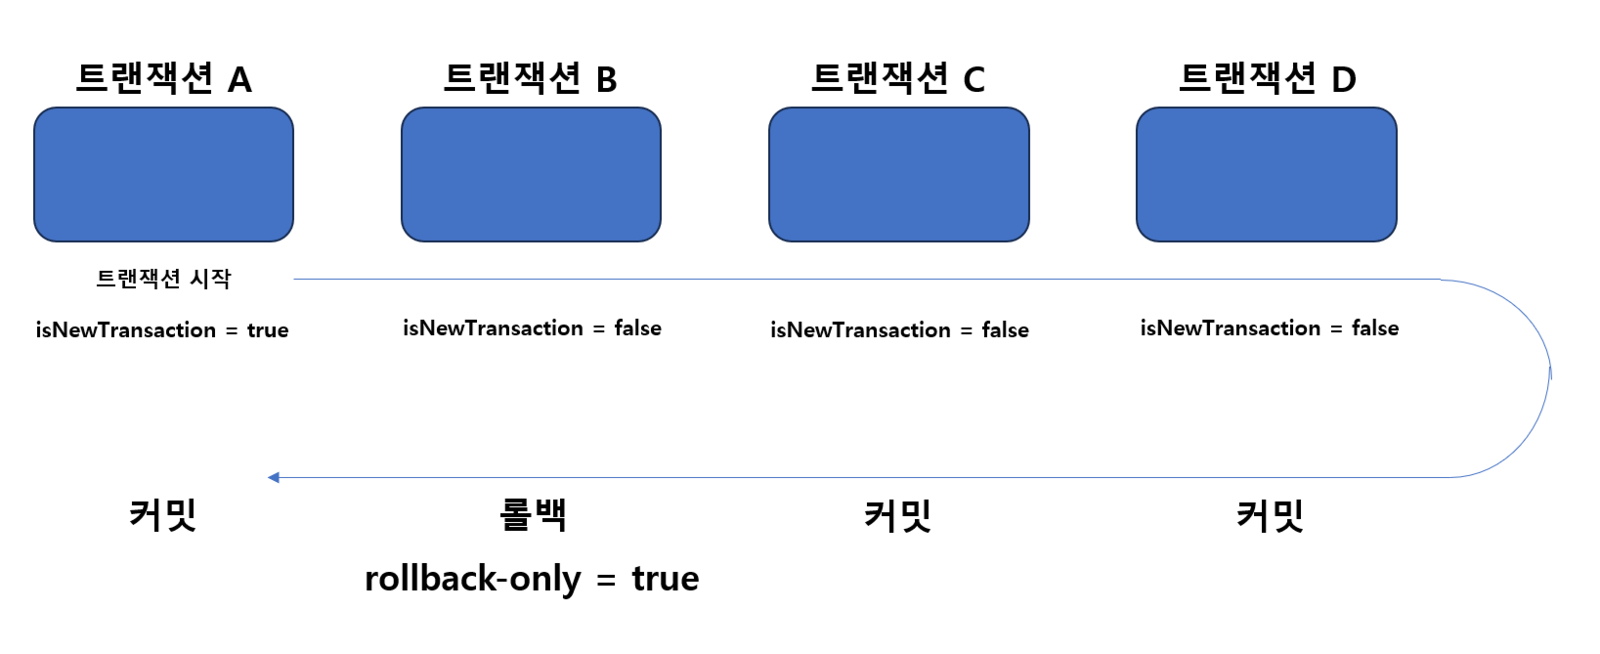
이렇게 되면 로직은 다음과 같습니다.
• 외부 트랜잭션에 의해 트랜잭션 시작
• 트랜잭션 D, C 커밋 isNewTransaction이 false이므로 지나감
• 트랜잭션 B 롤백 isNewTransaction이 false이므로 지나감, 지나가면서 rollback-only를 true로 설정
• 트랜잭션 A 커밋 isNewTransaction이 true이므로 물리트랜잭션에 적용 이 때 rollback-only가 true네! => 물리 트랜잭션 롤백
이런 느낌입니다.
이렇게 진행하면서 스프링은 트랜잭션을 하나로 묶은 상태에서 커밋과 롤백을 자유자재로 넘나들 수 있게 된 것입니다.
Case 4. 그런데 저는 예외 터진 부분만 롤백하고 나머지는 커밋하고 싶은데요?
JPA @Transactional의 전파 단계인 REQUIRES_NEW로 설정하면 됩니다.
위의 예제에서는 트랜잭션 A, B, C, D가 모두 하나의 물리 트랜잭션으로 연결되어 있습니다. 이걸 여러개로 나누기만 하면 됩니다.
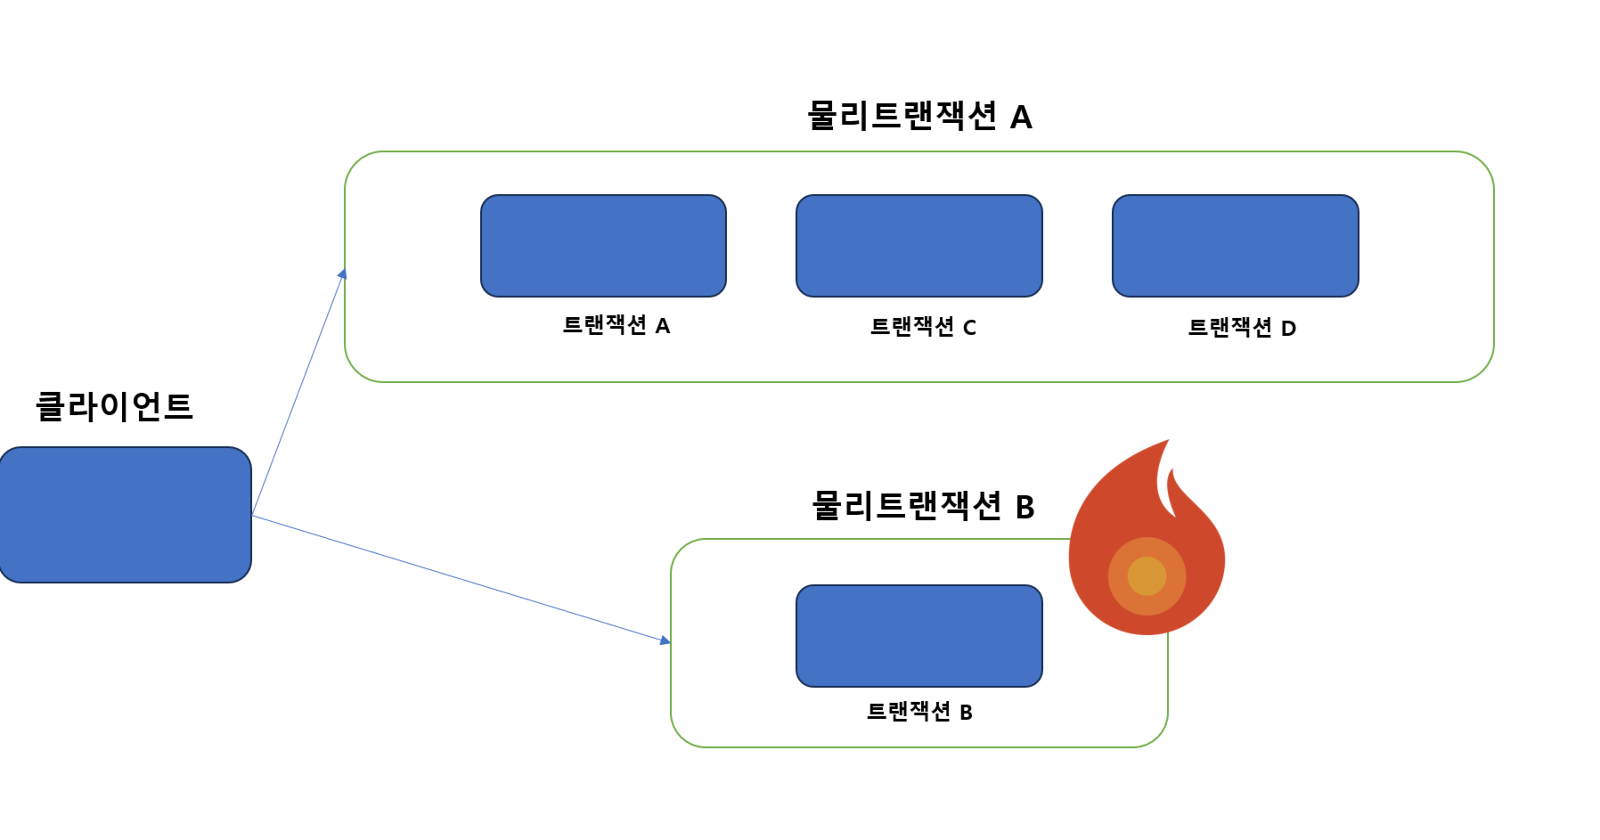
이렇게 되면 물리 트랜잭션 B만 롤백이 되고 나머지는 커밋이 될겁니다.
트랜잭션 B에만 REQUIRES_NEW 속성을 넣게 되면 트랜잭션 B를 생성할 때는 기존 트랜잭션을 잠시 밀어두고 새로운 트랜잭션을 생성하고 그 트랜잭션이 끝나면 기존 트랜잭션을 실행합니다.
물론 이렇게 하면 장점도 있지만 단점도 있습니다. 바로 데이터베이스 커넥션이 두개가 생긴다는 것입니다.
때문에 사용자 요청이 얼마 되지도 않는데 커넥션이 부족해서 데이터베이스가 허덕이고 있을 수도 있다는 얘기이죠. 그러니 조심해서 사용해야 합니다.
마치며
이렇게 트랜잭션 전파에 대해서 알아봤습니다. 이야... 정말 깊이있는 내용이었습니다. 감탄을 자아낼 수 밖에 없었는데요.
제가 기존에 알고있던 트랜잭션의 상식들이 하나둘씩 채워지는 느낌이라 정말 좋은 기분이었습니다. 여러분도 영한님의 데이터베이스 접근 기술 2탄을 한번 들어보시면 어떨까요?
출처
스프링 DB 2편 - 데이터 접근 기술 활용 (지식공유자 : 김영한)
Querydsl 기본문법
*QueryDSL
*QueryDSL 시작하기
• build.gradle plugins에 id "com.ewerk.gradle.plugins.querydsl"version "1.0.10" 추가
• build.gradle dependencies 에 implementation 'com.querydsl:querydsl-jpa' 추가
• build.gradle에 맨아래에
def querydslDir = "$buildDir/generated/querydsl"
querydsl {
jpa = true
querydslSourcesDir = querydslDir
}
sourceSets {
main.java.srcDir querydslDir
}
configurations {
querydsl.extendsFrom compileClasspath
}
compileQuerydsl {
options.annotationProcessorPath = configurations.querydsl
}
추가
• 엔티티가 하나 추가될 때 마다 오른쪽 위에 gradle > other > compileQuerydsl 실행 = build > generated 에 Q타입이 만들어짐
• JPAQueryFactory queryFactory = new JPAQueryFactory(em); 추가 -> 전역변수로 빼도 된다. (동시성 문제 걱정없음)
*JPQL vs QueryDSL
-member1을 찾아라
JPQL : em.createQuery("select m from Member m where m.username = :username, Member.class).setParameter("username", "member1"). getSingleResult();
QueryDSL : queryFactory.select(QMember.member).from(QMember.member).where(QMember.member.username.eq("member1")).fetchOne();
QMember는 static import 할 수 있음 = queryFactory.select(member).from(member).where(member.username.eq("member1")).fetchOne();
*Where 절에 여러개 파라미터가 오면 어떻게 해야할까?
queryFactory.selectFrom(member).where(member.username.eq("member1").and(member.age.eq(10)).fetchOne();
queryFactory.selectFrom(member).where(member.username.eq("member1"), member.age.eq(10)).fetchOne();
둘 다 가능
*최종연산 (fetch)
• List fetch = queryFactory.selectFrom(member).fetch();
• Member fetchOne = queryFactory.selectFrom(member).fetchOne();
• Member fetchFirst = queryFactory.selectFrom(member).fetchFirst();
*정렬 (sorting)
queryFactory.selectFrom(member).where(member.age.eq(100)).orderBy(member.age.desc(), member.username.asc()).fetch();
*페이징 (paging)
queryFactory.selectFrom(member).orderBy(member.username.desc()).offset(1).limit(2).fetch(); -> size() = 2
*기본조인
조인의 기본 문법은 첫 번째 파라미터에 조인 대상을 지정하고, 두 번째 파라미터에 엘리어스로 사용할 Q타입을 지정하면 된다.
queryFactory.selectFrom(member).join(member.team, QTeam.team).where(team.name.eq("teamA")).fetch();
위의 기본 조인은 연관관계매핑이 된 엔티티끼리의 조인이고 연관관계 매핑이 안된 엔티티끼리의 조인을 할 수 있는데 이를 세타조인이라 한다.
queryFactory.select(member).from(member, team)
*on절
• 조인 대상 필터링
queryFactory.select(member, team).from(member).leftjoin(member.team, team).on(team.name.eq("teamA")).fetch();
cf) 조인 대상을 필터링 할 때 내부조인을 사용하게 되면 on절을 사용하는 것이나 where절을 사용하는 것이나 차이가 없다. 따라서 on절을 활용한 조인 대상 필터링을 사용할 때 내부조인이라면 익숙한 where절을 사용하고 정말 외부조인이 필요한 경우에만 on절을 사용하는 것이 가독성을 높이는데에 도움이 된다.
• 연관관계 없는 엔티티 외부 조인 (문법이 살짝 다르다)
queryFactory.select(member, team).from(member).leftjoin(team).on(member.username.eq(team.name)).fetch();
*페치조인
기본 조인과 문법은 비슷하지만 join 뒤에 fetchJoin()을 붙여준다.
queryFactory.selectFrom(member).join(member.team, team).fetchJoin().where(member.username.eq("member1")).fetchOne();
*서브쿼리
com.querydsl.jpa.JPAExpressions 사용 -> static import 할 수 있음
queryFactory.selectFrom(member).where(member.age.eq(JPAExpressioins.select(memberSub.age.max()).from(memberSub))).fetch();
JPA에서는 from절 서브쿼리는 지원하지 않는다. from절 서브쿼리를 사용해야 한다면 다음을 시도해보면 좋을 것이다.
• 서브쿼리를 join으로 변경한다. (가능한 상황도 있고, 불가능한 상황도 있다.)
• 애플리케이션에서 쿼리를 2번 분리해서 실행한다.
• nativeSQL을 사용한다.
*case문
queryFactory.select(member.age.when(10).then("열살").when(20).then("스무살").otherwise("기타")).from(member).fetch();
SQL은 단순히 데이터를 퍼 올리는데에만 사용하는 것이 좋고 데이터를 가공하는 것은 애플리케이션 레벨에서 하면 좋다. case문이 꼭 필요한 상황이 살다보면 있을테지만 굳이 case문을 사용하는 상황은 피해야 할 것이다.
*concat문
queryFactory.select(member.username.concat("_").concat(member.age.stringValue())).from.where(member.username.eq("member1")).fetch();
문자가 아닌 다른 타입들은 stringValue로 문자로 변환할 수 있다. 이 방법은 enum타입을 처리할 때도 자주 사용한다.
Querydsl 중급문법
*프로젝션과 결과 반환
프로젝션 : select 대상 지정
-프로젝션 대상이 하나일 때 (단일 타입)
List<String> result = queryFactory.select(member.username).from(member).fetch();
1. 프로젝션 대상이 하나면 타입을 명확하게 지정할 수 있음
2. 프로젝션 대상이 둘 이상이면 튜플이나 DTO로 조회
-프로젝션 대상이 둘 이상일 때 (튜플 사용)
List<Tuple> result = queryFactory.select(member.username, member.age).from(member).fetch();
-사용방법
for (Tuple tuple : result) {
String username = tuple.get(member.username);
Integer age = tuple.get(member.age);
}
튜플을 사용할 때는 repository레벨에서만 사용하고 service, controller레벨에선 사용하지 않는 것이 좋다.
-프로젝션 대상이 둘 이상일 때 (DTO 조회)
1. 프로퍼티접근 (Setter 이용)
queryFactory
.select(Projection.bean(MemberDto.class, member.username, member.age))
.from(member)
.fetch();
2. 필드접근
queryFactory
.select(Projection.fields(MemberDto.class, member.username, member.age))
.from(member)
.fetch();
3. 생성자사용
queryFactory
.select(Projection.constructor(MemberDto.class, member.username, member.age))
.from(member)
.fetch();
cf)QueryProjection 사용
DTO의 생성자 부분에 @QueryProjection을 달아주고 compileQuerydsl을 실행 하면 Q타입의 DTO가 생긴다. 이후에
queryFactory.select(new QMemberDto(member.username, member.age)).from(member).fetch();
이렇게 사용하면 된다.
QueryProjection의 장단점
장점 : 생성자를 생성할 때 DTO에서의 데이터들을 가지고 생성하는 것이기 때문에 실수로 더 많이 혹은 더 적게 인자값을 넘겨주면 컴파일단계에서 오류가 발생한다. 그러므로 굉장히 안전한 방법이다.
단점 : DTO가 QueryDSL에 의존성을 가지고 종속적으로 바뀐다. 또한 DTO를 Q타입으로 또 하나 생성해야 한다는 단점이 있다.
*동적 쿼리
1. BooleanBuilder 사용
@Test
public void dynamicQuery_BooleanBuilder() {
String usernameParam = "member1";
Integer ageParam = null;
List<Member> result = searchMember1(usernameParam, ageParam);
Assertions.assertThat(result.size()).isEqualTo(1);
}
private List<Member> searchMember1(String usernameCond, Integer ageCond) {
BooleanBuilder builder = new BooleanBuilder();
//new BooleanBuilder(member.username.eq("member1")) 이렇게 기본값을 지정할 수도 있다.
if (usernameCond != null) {
builder.and(member.username.eq(usernameCond));
}
if (ageCond != null) {
builder.and(member.age.eq(ageCond));
}
return queryFactory
.selectFrom(member)
.where(builder)
.fetch();
}
2. where 다중파라미터 사용
@Test
public void dynamicQuery_WhereParam() {
String usernameParam = "member1";
Integer ageParam = 10;
List<Member> result = searchMember2(usernameParam, ageParam);
Assertions.assertThat(result.size()).isEqualTo(1);
}
private List<Member> searchMember2(String usernameCond, Integer ageCond) {
return queryFactory
.selectFrom(member)
.where(usernameEq(usernameCond), ageEq(ageCond))
.fetch();
}
private BooleanExpression usernameEq(String usernameCond) { //나중에 조립하기 위해서는 BooleanExpression타입으로 리턴타입을 받아야 한다.
return usernameCond != null ? member.username.eq(usernameCond) : null;
}
private BooleanExpression ageEq(Integer ageCond) {
return ageCond != null ? member.age.eq(ageCond) : null;
}
where 다중 파라미터사용의 특징
1. where 조건에 null값은 무시된다.
2. 메서드를 다른 쿼리에서도 재활용 할 수 있다.
3. 쿼리 자체의 가독성이 높아진다.
*벌크성 쿼리
벌크성 쿼리란? JPA의 더티체킹(변경감지)을 사용한 데이터 수정은 각각 일어나기 때문에 쿼리가 하나씩 나가는 단점이 있다. 벌크성 쿼리는 일반 SQL문 처럼 한번에 여러개의 데이터를 수정할 수 있게 해주는 기능이다. 다만 벌크성 쿼리는 JPA의 영속성컨텍스트와 전혀 관계없이 동작하기 때문에 데이터가 일치하지 않는 경우가 생길 수 있다. 이 때문에 벌크성 쿼리를 실행한 후에는 영속성컨텍스트를 완전히 초기화 시켜주는 것이 관례이다.
queryFactory
.update(member)
.set(member.username, "memberA")
.where(member.username.eq("member1"))
.execute();
Querydsl 실무활용
*스프링 데이터 JPA에서의 QueryDSL 사용
사용자 정의 리포지토리를 사용하면 된다. (Spring Data JPA 참고)
*QueryDSL 페이징 연동 + 스프링 데이터 JPA
1. 사용자 정의 리포지토리를 사용해서 구현체를 만든다.
2. 인자값으로 Pageable을 넘긴다.
3. queryFactory에서 offset메서드, limit메서드를 사용한다. // offset(pageable.getOffset()), limit(pageable.getPageSize())
4. fetchResults()메서드로 최종연산을 마무리 짓는다. // 이유 : 페이징 처리를 하려면 전체 데이터 개수를 알고 있어야 하므로
5. total사이즈를 뽑는다. fetchResults()의 결괏값으로 QueryResults타입이 나온다. 이 결과에 getResults()메서드를 하면 List타입의 결괏값이 나온다. 이 List타입의 결괏값에 getTotal()메서드를 사용하면 long타입의 결괏값이 나온다.
6. Page타입의 구현체인 PageImpl을 리턴한다. //return new PageImpl<>(content, pageable, total);
QueryDSL 기본문법
이 포스팅은 인프런 김영한 님의 실전! Querydsl 편을 보고 각색한 포스팅입니다. 자세한 내용은 강의를 확인해주세요
QueryDSL 시작하기
먼저 QueryDSL을 시작하기 위해선 gradle에서 설정을 해줘야한다.
//querydsl 추가
buildscript {
ext {
queryDslVersion = "5.0.0"
}
}
plugins {
id 'org.springframework.boot' version '2.6.3'
id 'io.spring.dependency-management' version '1.0.11.RELEASE'
id 'java'
id 'war'
//querydsl 추가
id "com.ewerk.gradle.plugins.querydsl" version "1.0.10"
}
group = 'review'
version = '0.0.1-SNAPSHOT'
sourceCompatibility = '11'
configurations {
compileOnly {
extendsFrom annotationProcessor
}
}
repositories {
mavenCentral()
}
dependencies {
implementation 'org.springframework.boot:spring-boot-starter-data-jpa'
implementation 'org.springframework.boot:spring-boot-starter-thymeleaf'
implementation 'org.springframework.boot:spring-boot-starter-validation'
implementation 'org.springframework.boot:spring-boot-starter-web'
compileOnly 'org.projectlombok:lombok'
runtimeOnly 'mysql:mysql-connector-java'
annotationProcessor 'org.projectlombok:lombok'
providedRuntime 'org.springframework.boot:spring-boot-starter-tomcat'
testImplementation 'org.springframework.boot:spring-boot-starter-test'
//querydsl 추가
implementation "com.querydsl:querydsl-jpa:${queryDslVersion}"
implementation "com.querydsl:querydsl-apt:${queryDslVersion}"
}
tasks.named('test') {
useJUnitPlatform()
}
//querydsl 추가
def querydslDir = "$buildDir/generated/querydsl"
querydsl {
jpa = true
querydslSourcesDir = querydslDir
}
sourceSets {
main.java.srcDir querydslDir
}
configurations {
querydsl.extendsFrom compileClasspath
}
compileQuerydsl {
options.annotationProcessorPath = configurations.querydsl
}
//querydsl 추가 끝
이렇게 설정해주면 엔티티를 만들었을 때 build폴더 안에 generated에 Q타입이 생성된다. 이 Q타입은 QueryDSL을 사용하기 위해서 필요하다.
두번째로 QueryDSL은 QueryFactory라는 곳에서 시작된다. JPAQueryFactory는 EntityManager를 주입받아 사용할 수 있고 JPQL 빌더 역할을 한다. 때문에 자바 컴파일 단계에서 도움을 받을 수 있다.
주입받는 방법은 다음과 같다.
private final JPAQueryFactory queryFactory;
public MemberRepositoryImpl(EntityManager em) {
this.queryFactory = new JPAQueryFactory(em);
}
여기서 잠깐!
JPAQueryFactory가 필드에 있어도 괜찮을까? 동시성 문제가 발생하지 않을까?
스프링 프레임워크는 여러 쓰레드에서 동시에 같은 EntityManager에 접근해도, 트랜잭션 마다 별도의 영속성 컨텍스트를 제공하기 때문에, 동시성 문제는 걱정하지 않아도 된다.
QueryDSL vs JPQL
둘의 차이점을 알아보기 전에 코드를 먼저 확인해보자
@Test
public void startJPQL() {
//member1을 찾아라
String qlString = "select m from Member m where m.username = :username";
Member findMember = em.createQuery(qlString, Member.class)
.setParameter("username", "member1")
.getSingleResult();
assertThat(findMember.getUsername()).isEqualTo("member1");
}
@Test
public void startQuerydsl() {
Member findMember = queryFactory
.select(member)
.from(member)
.where(member.username.eq("member1"))
.fetchOne();
assertThat(findMember.getUsername()).isEqualTo("member1");
}
QueryDSL은 JPQL의 단점을 보완하기 위해 나온 프레임워크이다. 먼저 JPQL의 단점을 확인해보고 QueryDSL이 어떻게 문제를 해결했는지 알아보자
1. 문자로 작성되는 SQL문
JPQL에서 SQL문은 문자로 작성된다. 때문에 오타가 조금만 생겨도 문제가 발생할 수 있다. 오타가 생기더라도 애플리케이션이 실행이 되고 실행 후에 오류가 발생한다 (런타임 오류). QueryDSL은 이러한 문제를 해결하여 자바 컴파일 단계에서 도움을 받아 컴파일 시점에 오류를 잡을 수 있게 되었다. 때문에 안정적으로 SQL문을 자바로 작성하여 프로그램의 안정성을 높여준다.
2. SQL injection 공격
이 단점은 1번과 연결되는 단점이다. JPQL은 SQL문을 문자로 작성하기 때문에 해커에 의한 공격이 상대적으로 쉽다. 해커들이 사용하는 대표적인 공격중 한가지인 SQL injection 공격에 취약하다.
3. 동적쿼리
JPQL에서 동적쿼리는 구현하기 힘든 문제중 하나였다. JPQL에서도 동적쿼리를 위해 제공하는 몇가지 기능들이 있지만 사용하기 너무 난이도가 높고 복잡하고 가시성도 떨어져 거의 사용하지 않고 있다. QueryDSL에선 BooleanExpression를 이용해 동적쿼리를 풀어내었는데 이것은 가히 혁명이라 불려도 될 것이다. 이 부분에 대해서는 다음 포스팅인 QueryDSL 중급 문법에서 자세히 다룰 예정이다.
이제 본격적으로 QueryDSL의 기본 문법을 알아보자
QueryDSL 기본 문법
1. 검색 조건 쿼리
where 절에서 사용하는 다양한 문법을 제공한다.
@Test
public void search() {
Member findMember = queryFactory
.selectFrom(member)
.where(member.username.eq("member1").and(member.age.eq(10)))
.fetchOne();
assertThat(findMember.getUsername()).isEqualTo("member1");
}
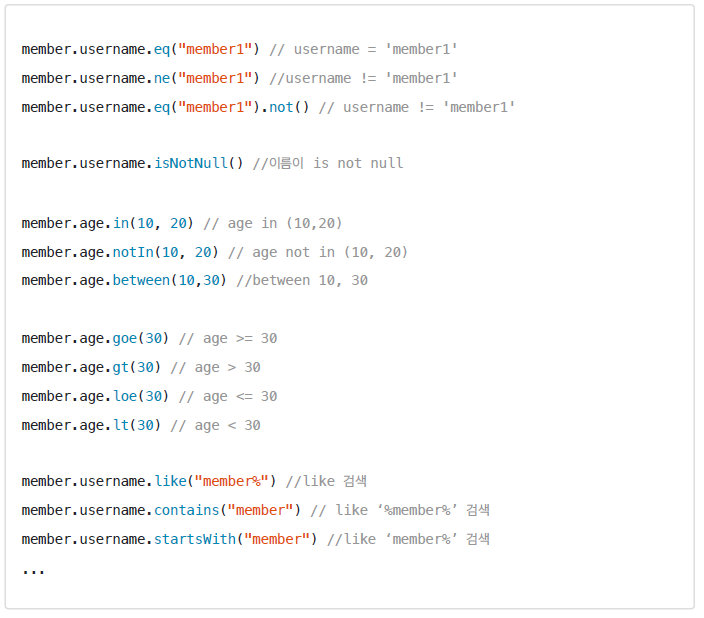
2. 결과 조회
@Test
public void resultFetch() {
List<Member> fetch = queryFactory
.selectFrom(member)
.fetch();
Member fetchOne = queryFactory
.selectFrom(QMember.member)
.fetchOne();
Member fetchFirst = queryFactory
.selectFrom(QMember.member)
.fetchFirst();
QueryResults<Member> results = queryFactory
.selectFrom(member)
.fetchResults();
results.getTotal();
List<Member> content = results.getResults();
long total = queryFactory
.selectFrom(member)
.fetchCount();
}
-fetch() : 리스트 조회, 데이터가 없으면 빈 리스트 반환
-fetchOne() : 단 건 조회 결과가 없으면 null, 결과가 둘 이상이면 NonUniqueResultException 발생
-fetchFirst() : limit(1).fetchOne() 과 동일
-fetchResults() : 페이징 정보 포함, total count 쿼리 추가 실행
-fetchCount() : count쿼리로 변경해서 count수 조회
참고) QueryDSL 5.0 버전 이상 부터 fetchResults와 fetchCount가 deprecated 되었다. count 쿼리가 모든 dialect에서 또는 다중 그룹 쿼리에서 완벽하게 지원되지 않기 때문에 deprecated 되었다라고 공식 문서에 적혀있다.
그럼 count 쿼리는 어떻게 날리지?
fetch()로 뽑아내고 size()를 이용해 같은 결과를 얻어 낼 수 있다.
fetchResults는 count 쿼리를 날릴때 조인이나 검색조건문이 같이 포함되어 날아가기 때문에 성능이 중요한 애플리케이션에선 원래 사용하기 좀 그랬다. 때문에, 이 문제를 해결하기 위해 fetch()와 count쿼리를 두번 날리는 것이 더 나을 때도 있다.
3. 정렬
/**
* 회원 정렬 순서
* 1. 회원 나이 내림차순 (desc)
* 2. 회원 이름 올림차순 (asc)
* 단 2에서 회원 이름이 없으면 마지막에 출력 (nulls last)
*/
@Test
public void sort() {
memberRepository.save(new Member(null, 100));
memberRepository.save(new Member("member5", 100));
memberRepository.save(new Member("member6", 100));
List<Member> result = queryFactory
.selectFrom(member)
.where(member.age.eq(100))
.orderBy(member.age.desc(), member.username.asc().nullsLast())
.fetch();
Member member5 = result.get(0);
Member member6 = result.get(1);
Member memberNull = result.get(2);
assertThat(member5.getUsername()).isEqualTo("member5");
assertThat(member6.getUsername()).isEqualTo("member6");
assertThat(memberNull.getUsername()).isNull();
}
4. 페이징
@Test
public void paging() {
List<Member> result = queryFactory
.selectFrom(member)
.orderBy(member.username.desc())
.offset(1)
.limit(2)
.fetch();
assertThat(result.size()).isEqualTo(2);
}
-offset : 시작 인덱스
-limit : 몇개 가져올건지
후에 paging 쿼리는 pageable을 이용해 사용하는데 다음 포스팅에서 다룰 예정이다.
5. 집합 함수
@Test
public void aggregation() {
List<Tuple> result = queryFactory
.select(
member.count(),
member.age.sum(),
member.age.avg(),
member.age.max(),
member.age.min()
)
.from(member)
.fetch();
}
JPQL에서 제공하는 집합 함수를 모두 제공한다.
groupBy
@Test
public void group() {
List<Tuple> result = queryFactory
.select(team.name, member.age.avg())
.from(member)
.join(member.team, team)
.groupBy(team.name)
.fetch();
Tuple teamA = result.get(0);
Tuple teamB = result.get(1);
assertThat(teamA.get(team.name)).isEqualTo("teamA");
assertThat(teamA.get(member.age.avg())).isEqualTo(15);
assertThat(teamB.get(team.name)).isEqualTo("teamB");
assertThat(teamB.get(member.age.avg())).isEqualTo(35);
}
6. 조인
join(조인 대상, 별칭으로 사용할 Q타입)
inner join where절
/**
* 팀 A에 소속된 모든 회원을 찾아라
*/
@Test
public void join() {
List<Member> result = queryFactory
.selectFrom(member)
.join(member.team, team)
.where(team.name.eq("teamA"))
.fetch();
assertThat(result).extracting("username").containsExactly("member1", "member2");
}
outer join on 절
@Test
public void join_on_filtering() {
List<Tuple> result = queryFactory
.select(member, team)
.from(member)
.leftJoin(member.team, team).on(team.name.eq("teamA"))
.fetch();
for (Tuple tuple : result) {
System.out.println("tuple = " + tuple);
}
}
fetch join
@Test
public void fetchJoinNo() {
em.flush();
em.clear();
Member findMember = queryFactory
.selectFrom(member)
.join(member.team, team).fetchJoin()
.where(member.username.eq("member1"))
.fetchOne();
}
7. 서브쿼리
/**
* 나이가 가장 많은 회원 조회
*/
@Test
public void subQuery() {
QMember memberSub = new QMember("memberSub");
List<Member> result = queryFactory
.selectFrom(member)
.where(member.age.eq(
JPAExpressions.select(memberSub.age.max())
.from(memberSub)
))
.fetch();
assertThat(result).extracting("age").containsExactly(40);
}
JPAExpressions는 static import 가능
JPQL은 from절 서브쿼리가 불가능하다. 때문에 QueryDSL에서도 from절 서브쿼리는 불가능하다.
from 절의 서브쿼리 해결 방안
1. 버스쿼리를 join으로 변경한다. (가능한 상황도 있고, 불가능한 상황도 있다.)
2. 애플리케이션에서 쿼리를 2번 분리해서 실행한다.
3. native 쿼리를 만든다.
8. case 문
@Test
public void basicCase() {
queryFactory
.select(
member.age
.when(10).then("열살")
.when(20).then("스무살")
.otherwise("기타")
)
.from(member)
.fetch();
}
sql문에서 case문은 되도록이면 사용하지 않아야 할 것이다. 위의 예제의 경우 10살 20살인 데이터를 가져와서 애플리케이션 레벨에서 바꾸는 것이 효과적이다.
9. concat 문
@Test
public void concat() {
List<String> result = queryFactory
.select(member.username.concat("_").concat(member.age.stringValue()))
.from(member)
.where(member.username.eq("member1"))
.fetch();
for (String s : result) {
System.out.println("s = " + s);
}
}
참고) member.age.stringValue() 이부분이 중요한데, 문자가 아닌 다른 타입들은 stringValue()로 문자로 변환할 수 있다. 나중에 이 방법으로 ENUM타입을 처리할 때 자주 사용한다.
QueryDSL 중급문법
이 포스팅은 인프런 김영한 님의 실전! Querydsl 편을 보고 각색한 포스팅입니다. 자세한 내용은 강의를 확인해주세요
프로젝션과 결과 반환 - 기본
프로젝션이란 뭘까?
그냥 간단하게 select 대상으로 지정된 것을 말한다.
크게 봤을 때 프로젝션이 한개일 때와 여러개일 때로 나눠볼 수 있다.
프로젝션 대상이 하나일 때
@Test
public void simpleProjection() {
List<String> result = queryFactory
.select(member.username)
.from(member)
.fetch();
for (String s : result) {
System.out.println("s = " + s);
}
}
select문에 member.username하나만 있는 상황이다. 이럴 땐 제네릭이 String처럼 타입을 특정할 수 있게 된다.
프로젝션 대상이 둘 이상일 때
@Test
public void tupleProjection() {
List<Tuple> result = queryFactory
.select(member.username, member.age)
.from(member)
.fetch();
for (Tuple tuple : result) {
String username = tuple.get(member.username);
Integer age = tuple.get(member.age);
System.out.println("username = " + username);
System.out.println("age = " + age);
}
}
select문에 두개가 들어가있는 상황이다. 이때는 Tuple이라는 제네릭 타입으로 바뀐다. QueryDSL에서 이렇게 프로젝션 대상이 둘 이상일때 타입을 특정지을 수 없는 상황에서 제공하는 제네릭이다.
Tuple을 사용하는 방법은 get메서드를 사용해서 내가 가지고 오고 싶은 데이터를 직접 가져와야 한다.
주의) Tuple은 Repository레벨에서만 사용하고 Service, Controller레벨에선 사용하지 말아야 한다. 또한, 뒤에 설명할 DTO로 조회하는 방법을 이용하는 것이 더 나은 방법이다.
프로젝션과 결과 반환 - DTO로 조회
대부분 조회를 할 때 내가 필요한 데이터만 쏙쏙 뽑아서 가져오고 싶을 것이다. 그렇게 가져오는 것이 무겁지도 않고 깔끔하기 때문이다. 필자도 DTO로 조회하는 것을 선호한다.
먼저 QueryDSL에서의 DTO로 조회를 알아보기 전에 JPQL에선 DTO로 조회할 때 어떻게 사용하는지 먼저 알아보고 넘어가자
@Test
public void findDtoByJPQL() {
List<MemberDto> result = em.createQuery("select new review.hello.dto.MemberDto(m.username, m.age) from Member m ", MemberDto.class)
.getResultList();
for (MemberDto memberDto : result) {
System.out.println("memberDto = " + memberDto);
}
}
JPQL에선 DTO로 조회하기 위해서 new 연산자를 사용해야 했다. 그리고 뒤에 패키지명을 쭉 적어준 뒤 생성자로 만드는 것 처럼 값을 넣어주면 완성이다.
여기에 몇가지 단점이 있다.
1. 너무 지저분하다.
패키지가 조금만 많아져도 하나하나 적는게 일이 될 것이다.
2. 생성자 방식만 지원한다.
생성자가 반드시 존재해야하며 뒤에 설명하겠지만 프로퍼티로 주입받거나 필드로 직접 주입받는 등의 유연한 대처가 불가능해진다.
3. 패키지가 바뀌면 코드를 전부 수정해야한다.
이건 꽤 큰 문제가 될 수 있다. 패키지가 바뀐다고 해서 코드를 전부 수정해야 하는 상황은 OCP를 위반할 뿐더러 유지보수에도 최악이다.
QueryDSL에선 이 문제를 어떻게 해결했을까?
QueryDSL에선 프로퍼티로 접근하는 방법과 필드로 접근하는 방법, 생성자로 접근하는 방법 이렇게 세가지를 지원한다. 하나씩 살펴보자
프로퍼티 접근
@Test
public void findDtoBySetter() {
List<MemberDto> result = queryFactory
.select(Projections.bean(MemberDto.class,
member.username,
member.age)
)
.from(member)
.fetch();
for (MemberDto memberDto : result) {
System.out.println("memberDto = " + memberDto);
}
}
select절에 Projections라는 키워드로 (com.querydsl.core.types를 사용해야 한다. hibernate건 사용하면 안됨) bean을 사용하면 된다. 맨 처음엔 타입을 적어주고 뒤에 알맞는 Q타입을 적어주면 된다.
주의) Setter가 반드시 있어야 하며 자바 프로퍼티 규약에 따라 setXxx의 소문자 버전인 xxx와 내가 조회하고싶은 Q타입의 이름이 같아야 매칭이 된다. 또한, 기본 생성자가 있어야 한다. 기본 생성자가 없으면 set으로 접근할 수 없기 때문이다.
필드 접근
@Test
public void findDtoByField() {
List<MemberDto> result = queryFactory
.select(Projections.fields(MemberDto.class,
member.username,
member.age)
)
.from(member)
.fetch();
for (MemberDto memberDto : result) {
System.out.println("memberDto = " + memberDto);
}
}
똑같이 Projections를 사용하고 fields를 사용하면 된다. 프로퍼티 접근과 마찬가지로 맨 처음엔 타입을 적어주고 뒤에 알맞는 Q타입을 적어주면 된다.
주의) 프로퍼티 접근과 마찬가지로 내가 조회하고싶은 필드와 DTO의 필드가 일치해야 한다.
생성자 접근
@Test
public void findUserDtoByField() {
List<MemberDto> result = queryFactory
.select(Projections.constructor(MemberDto.class,
member.username.as("name"),
member.age)
)
.from(member)
.fetch();
for (MemberDto MemberDto : result) {
System.out.println("MemberDto = " + MemberDto);
}
}
마지막 생성자 접근이다. 생성자 접근을 사용하려면 Projections에 constructor를 사용하면 된다.
프로젝션과 결과 반환 - @QueryProjection
@Data
public class MemberDto {
private String username;
private int age;
@QueryProjection
public MemberDto(String username, int age) {
this.username = username;
this.age = age;
}
}
생성자에 @QueryProjection을 달아준 뒤에 gradle에 compile.java를 누르게 되면 Q타입으로 DTO가 만들어진다.
@Test
public void findDtoByQueryProjection() {
List<MemberDto> result = queryFactory
.select(new QMemberDto(member.username, member.age))
.from(member)
.fetch();
for (MemberDto memberDto : result) {
System.out.println("memberDto = " + memberDto);
}
}
이제 사용해주면 되는데 select 절에 생성자를 만들듯이 new로 Q타입 DTO를 넣어주면 된다.
이 방법은 컴파일러롤 타입을 체크할 수 있으므로 가장 안전한 방법이다. 위의 세개의 방법은 실수로 필드를 하나 추가하거나 하면 런타임 오류가 발생하게 된다. 하지만 @QueryProjection은 컴파일 단계에서 이를 막아준다. 때문에, 가장 안전한 방법이다.
하지만 DTO에 QueryDSL 어노테이션을 유지해야하는 점이 단점이다. DTO는 Repository, Service, Controller까지 다양하게 움직이는데 움직일 때 마다 QueryDSL 어노테이션을 달고 움직여야 한다는 것이다.
아키텍처의 부분에서 DTO는 깔끔하게 가져가고 싶다면 QueryProjection은 사용하지 말아야 할 것이다. 하지만 애플리케이션이 QueryDSL에 상당한 부분 종속적이고 의존적이라면 안전을 위해 사용하는 것도 나쁘지 않을 것이다.
때문에 상황에 따라 알맞은 판단을 해야 할 것이다.
동적쿼리
QueryDSL로 동적쿼리를 만드는 것에는 두가지 방법이 있다.
1. BooleanBuilder사용
2. Where 다중 파라미터 사용 (BooleanExpression 사용)
하나씩 알아보자
BooleanBuilder
@Test
public void dynamicQuery_BooleanBuilder() {
String usernameParam = "member1";
Integer ageParam = 10;
List<Member> result = searchMember1(usernameParam, ageParam);
assertThat(result.size()).isEqualTo(1);
}
private List<Member> searchMember1(String usernameCond, Integer ageCond) {
BooleanBuilder builder = new BooleanBuilder();
if (usernameCond != null) {
builder.and(member.username.eq(usernameCond));
}
if (ageCond != null) {
builder.and(member.age.eq(ageCond));
}
return queryFactory
.select(member)
.from(member)
.where(builder)
.fetch();
}
먼저 메서드를 뽑는다. 그리고 BooleanBuilder를 선언하고 빌더를 작성하면 된다.
BooleanExpression
@Test
public void dynamicQuery_WhereParam() {
String usernameParam = "member1";
Integer ageParam = 10;
List<Member> result = searchMember2(usernameParam, ageParam);
assertThat(result.size()).isEqualTo(1);
}
private List<Member> searchMember2(String usernameCond, Integer ageCond) {
return queryFactory
.selectFrom(member)
.where(usernameEq(usernameCond), ageEq(ageCond))
.fetch();
}
private BooleanExpression usernameEq(String usernameCond) {
return usernameCond != null ? member.username.eq(usernameCond) : null;
}
private BooleanExpression ageEq(Integer ageCond) {
return ageCond != null ? member.age.eq(ageCond) : null;
}
마찬가지로 메서드를 뽑아내고 BooleanExpression으로 메서드를 한번 더 뽑는다. 그리고 해당 메서드를 where절에 넣어준다. 이렇게 하는 이유는 QueryDSL의 where절에는 null이 들어오게 되면 무시해버리기 때문이다.
BooleanBuilder vs BooleanExpression 무엇을 사용해야할까?
개인적으로 BooleanExpression이 깔끔하고 좋은 것 같다. 하지만 무엇을 선택하든 상관없다. BooleanExpression은 가독성이 좋아지고 코드를 재사용할 수 있다는 장점이 있다.
벌크성 쿼리
보통 update문에 사용되고 한번에 많은 데이터의 값을 변경해야 할 때 사용한다. JPA의 더티체킹을 사용할 수도 있지만 더티체킹은 영속성컨텍스트에 있는 데이터와 디비의 값을 일일이 하나하나 비교하기 때문에 쿼리가 많이 나가는 단점이 있다.
벌크성 쿼리를 사용하면 한방쿼리로 업데이트를 할 수 있다.
@Test
public void bulkUpdate() {
long count = queryFactory
.update(member)
.set(member.username, "비회원")
.where(member.age.lt(28))
.execute();
}
사용방법은 평범한 update문 뒤에 execute를 달아주면 된다.
주의) 벌크성 쿼리는 영속성 컨텍스트와 관련없는 쿼리이다. 즉, 디비에는 적용되지만 영속성 컨텍스트에는 업데이트가 안된다는 소리다.
예를 들어서 위의 예제처럼 28살보다 나이가 어린 사람의 이름을 비회원으로 바꿔버리는 작업을 한다고 가정해보자
저 벌크성 쿼리를 날리는 순간 디비에는 비회원이라고 이름이 바뀐다. 하지만 영속성 컨텍스트에는 그대로 회원1이라고 남아있다는 얘기이다.
영속성 컨텍스트는 디비에서 값을 가져올 때 참조값을 확인하여 이미 영속성 컨텍스트에 값을 가지고 있다면 디비에서 가져온 값을 무시해버리는 특징이 있다.
때문에, 디비에 무작정 벌크성 쿼리로 저장한다고 해서 영속성컨텍스트에 있는 값들이 바뀐다는 것은 아니다. 벌크성 쿼리를 날리고 다시 영속성컨텍스트에서 값을 가져와 작업한다면 큰 버그로 이어질 것이다.
그럼어떻게 해야하나?
EntityManager를 주입받아 em.flush(); em.clear(); 이 두개를 실행해주면 된다. 벌크성 쿼리를 날린 후 영속성컨텍스트를 깔끔하게 비운뒤 다시 디비에서 값을 가져오게 해서 영속성컨텍스트를 갱신하는 것이다.
스프링 부트 5.0 Querydsl 설정 변경
스프링 부트가 5.0이 됨에 따라 그런지 모르겠지만 javax.persistence에 있던 EntityManager가 작동하지 않는 상황이 발생했습니다.
이제 EntityManager는 jakarta.persistence로 바뀌게 되었는데 이에따라 querydsl의 설정을 바꿔줘야할 필요가 생겼습니다.
구글링을 해본 결과는 다음과 같습니다.
buildscript {
ext {
queryDslVersion = "5.0.0"
}
}
plugins {
id 'java'
id 'org.springframework.boot' version '3.1.0'
id 'io.spring.dependency-management' version '1.1.0'
// querydsl plugin 제거
// id "com.ewerk.gradle.plugins.querydsl" version "1.0.10"
}
group = 'com.test'
version = '0.0.1-SNAPSHOT'
sourceCompatibility = '17'
configurations {
compileOnly {
extendsFrom annotationProcessor
}
}
repositories {
mavenCentral()
}
dependencies {
implementation 'org.springframework.boot:spring-boot-starter-batch'
implementation 'org.springframework.boot:spring-boot-starter-data-jpa'
implementation 'org.springframework.boot:spring-boot-starter-thymeleaf'
implementation 'org.springframework.boot:spring-boot-starter-web'
compileOnly 'org.projectlombok:lombok'
runtimeOnly 'com.mysql:mysql-connector-j'
annotationProcessor 'org.projectlombok:lombok'
testImplementation 'org.springframework.boot:spring-boot-starter-test'
testImplementation 'org.springframework.batch:spring-batch-test'
implementation 'org.springframework.data:spring-data-elasticsearch:4.0.0.RELEASE'
implementation 'org.elasticsearch.client:elasticsearch-rest-high-level-client:7.17.10'
//querydsl 추가
implementation "com.querydsl:querydsl-jpa:5.0.0:jakarta"
annotationProcessor "com.querydsl:querydsl-apt:5.0.0:jakarta"
annotationProcessor "jakarta.annotation:jakarta.annotation-api"
annotationProcessor "jakarta.persistence:jakarta.persistence-api"
}
tasks.named('test') {
useJUnitPlatform()
}
//querydsl 추가
def querydslDir = "$buildDir/generated/querydsl"
clean {
delete file(querydslDir)
}
//querydsl {
// jpa = true
// querydslSourcesDir = querydslDir
//sourceSets {
// main.java.srcDir querydslDir
//}
//
//configurations {
// querydsl.extendsFrom compileClasspath
//}
//
//compileQuerydsl {
// options.annotationProcessorPath = configurations.querydsl
//}
부트 5.0부터 querydsl의 plugin이 잘 작동하지 않는 상황이 발생했다고 하네요. 때문에 이렇게 바뀌게 된 듯합니다.