Spring
개발개발 ·
커스텀 태그 만들기
1. 커스텀 태그의 장점
①재사용 : 한 번 작성한 커스텀 태그는 어떤 JSP 컨테이너에서도 사용 가능하다.
②쉽고 단순한 JSP 코드 작성 : 자바 코드에 익숙하지 않은 개발자들도 커스텀 태그를 사용하면 쉽게 JSP 페이지를 작성할 수 있게 된다. 예를 들어 JSTL 과 EL을 사용하는 것이 스크립트 코드만 사용하기보다 쉽다.
③코드 가독성 향상 : 커스텀 태그는 뚜렷한 의도를 갖고, 커스텀 태그를 사용하면 스크립트코드를 줄일 수 있기 때문에 JSP코드의 가독성을 높일 수 있다.
2. 커스텀태그 사용하기
①WEB-INF파일 아래 원하는 이름으로 파일을 짓는다.
②파일아래 .tag확장자로 jsp파일을 만든다
③맨위에 <%@ tag body-content="empty" pageEncoding="UTF-8" %>를 적는다.
④커스텀 태그를 사용할 페이지에
<%@ taglib prefix="자기가 사용할 태그이름" tagdir="/WEB-INF/태그가 들어있는 파일" %>을 선언해준다.
⑤사용할 페이지에서 <자기가 사용할 태그이름: .tag파일이름>을 쓰면 끝
예를들어 WEB-INF아래 원하는 이름의 파일이 tags이고 자기가 사용할 태그이름이 tf이고 .tag확장자파일이름이 now라면 다음과 같이 적으면 된다.
<%@ taglib prefix="tf" tagdir="/WEB-INF/tags"%>
<tf:now>
3-1. 태그파일의 속성 설정 방법
①description : 속성에 대한 설명을 입력한다. (선택)
②name : 속성의 이름을 입력한다. 태그 파일 내에서 스크립트 변수나 EL 변수의 이름으로 사용된다. (필수)
③required : 속성의 필수 여부를 지정한다. 필수일 경우 true 아닌 경우 false를 값으로 지정한다. 기본값을 false이다 (선택)
④rtexprvalue : 속성값으로 표현식을 사용할 수 있는지 여부를 지정한다. 기본값은 true이다. (선택)
⑤type : 속성값의 타입을 명시한다. java.lang.Integer와 같은 래퍼타입을 사용한다. 기본값은 java.lang.String이다. (선택)
(자바의 제네릭과 같은 역할)
⑥fragment : <jsp:attribute> 액션태그로 속성값을 전달할 때 이값을 true로 지정한다. fragment 속성값을 true로 지정하면 rtexprvalue속성은 true가 되고 type속성의 값은 javax.servlet.jsp.tagext.JspFragment가 된다. (선택)
3-2. 속성값을 전달하는 기본 방식
<%-- header.tag --%>
<%@ attribute name="변수이름" required="true" %>
attribute 디렉티브를 이용해서 지정한 속성은 다음과 같이 태그 파일의 스크립트 요소나 EL에서 변수처럼 사용할 수 있다. <c:set var="변수이름" value="값"/> 과 비슷한 역할 하지만 위의 방식은 변수를 설정하기만 한것이고 직접 값을 넣어줘야한다. ex) <tf:header title=<%= article.getTitle() %> />
3-3 <jsp:attribute> 태그를 이용한 속성값 전달
arrtibute디렉티브의 fragment 속성값이 true일 경우 JSP는 속성에 값을 전달할때 <jsp:attribute> 액션 태그를 사용해야 한다.
<%-- header.tag --%>
<%@ attribute name="title" fragment="true">
<%-- JSP --%>
<%@ taglib prefix="tf" tagdir="/WEB-INF/tags" %>
<tf:header>
<jsp:attribute name="title">${ article.title }</jsp:attribute>
</tf:header>
<jsp:attribute>의 몸체에서는 일반 템플릿 텍스트, EL, 그리고 <jsp:include> 액션 태그등을 사용할 수 있으며, 스크립트 코드는 사용할 수 없다.
3-4 동적 속성 전달
상황에 따라서는 attribute의 속성값을 나중에 정하고 싶을 때가 있을 것이다.
<%@ tag dynimic-attributes="변수이름" %>
<select name="${ name }">
<c:forEach var="option" items="${ 변수이름 }>
<option value="${ option.key }">${ option.value }</option>
</c:forEach>
</select>
이렇게 설정해주면 동적으로 attribute 속성값을 받아 올 수 있다.
3-5 몸체 내용 처리
이 내용은 <c:if>태그와 똑같은 기능을 하는 내용이므로 <c:if>태그를 사용하는것은 선택이다.
<tf:someTagFile attrl="속성값">
몸체내용
</tf:someTagFile>
Spring 테스트클래스
*Test클래스 작성
테스트 클래스를 만들고 난 후에 테스트 할 함수 위에 @Test 어노테이션을 붙인다. 클래스 옆에있는 화살표를 누르고 Run을 누르면 테스트가 시작된다.
테스트를 진행할 때 given(어느것이 주어지는지) when(이 부분이 실행될 때) then(이러한 결과가 나온다) 이 세개를 주석처리 하고 그 아래 쓰는것이 가독성을 높인다.
객체가 같은지 확인시켜주는 Assertions클래스가 두개 있는데 java.assertj.core.api를 고르면 된다. Assertions.assertThat(기준되는객체).isEqualTo(테스트할객체) 이렇게 넣으면 됨
테스트 하나가 끝날 때 마다 실행하는 @AfterEach 어노테이션이 있는데 이 어노테이션을 붙이면 테스트가 하나 끝날때마다 실행시켜준다.
AfterEach에 객체를 초기화해주는 메소드를 넣으면 된다.
DI와 스프링빈
Controller : 컨트롤러를 통해서 외부 요청을 받고
Service : 서비스에서 비즈니스 로직을 만들고
Repository : 리포지토리에서 데이터를 저장하고
=정형화된 패턴
Autowired : 내가 현재 작업하는 클래스에서 다른 클래스의 객체를 사용하고 싶을 때는 현재 작업하는 클래스에서 new 하고 객체를 다른 클래스의 객체를 만드는 것이 아니라
private final 다른클래스 객체명; 이렇게 선언해 준 뒤에
@Autowired
public 현재작업중인클래스(다른클래스 객체명){
this.객체명 = 객체명
}
이렇게 구현하면 된다. => 해당 방법은 Dependency Injection 즉 DI중 생성자 주입이라고 부른다.
*DI란?
의존성 주입이라고 표현하고 DI에는 세가지 주입이 있다.
1. 필드주입
2. setter 주입
3. 생성자 주입
1. 필드 주입은 필드에 선언된 private한 변수에 @Autowired를 붙여주는 주입으로 한번 주입한 의존성이 바뀌지 않는데 이러한 코딩 방식은 지양해야 한다. 마치 필드에서
선언과 동시에 초기화 하는 상황과 같은 상황
2. setter 주입은 private한 변수를 setter를 이용하여 만들어주고 @Autowired를 붙여주는 주입으로 단점은 모든 개발자가 해당 메서드에 접근할 수 있기 때문에 지양해야 한다.
최대한 적은 개수의 메서드에 접근할 수 있어야 한다.
3. 생성자 주입은 private한 변수를 setter 주입과 비슷하게 주입을 하는데 생성자를 통해서 주입이 된다. 이렇게 생성자를 통해 주입이 되면 spring이 한번 호출할 때 한번만
호출되는 장점이 있기 때문에 생성자 주입을 사용하는 것이 좋다.
*스프링 빈을 등록하는 두가지 방법
1. 컴포넌트 스캔과 자동 의존관계 설정
2. 자바 코드로 직접 스프링 빈 등록하기
1. 컴포넌트 스캔 : @Controller, @Autowired, @Service, @Repository 이렇게 어노테이션을 지정한것이 바로 컴포넌트 스캔 방식
= 각 어노테이션에 들어가보면 @Component(어노테이션이 있으면 스프링 빈으로 자동 등록된다)라고 붙어있다.
2. 자바코드로 직접 스프링 빈 등록하기 : 빈(Bean) 클래스를 따로 만들어서 @Configuraion어노테이션을 클래스 위에 붙인다. 그리고 메소드를 만드는데 각 메소드에 @Bean을
붙여서 만든다. 각 메소드는 return 값으로 해당 객체를 넘겨주도록 설정한다.
실무에서는 주로 정형화된 컨트롤러, 서비스, 리포지토리 같은 코드는 컴포넌트 스캔을 사용한다. 그리고 정형화되지 않았거나 사항에 따라 구현 클래스를 변경해야 한다면
설정을 통해 스프링빈으로 등록한다.
스프링빈 조회
*모든 빈 출력하기
AnnotationConfigApplicationContext ac = new AnnotationConfigApplicationContext(AppConfig.class);
@Test
@DisplayName("모든 빈 출력하기")
void findAllBean() {
String[] beanDefinitionNames = ac.getBeanDefinitionNames();
for(String beanDefinitionName : beanDefinitionNames){
Object bean = ac.getBean(beanDefinitionName);
System.out.println("name = " + beanDefinitionName + " object = " + bean);
}
}
*애플리케이션 빈만 출력하기
AnnotationConfigApplicationContext ac = new AnnotationConfigApplicationContext(AppConfig.class);
@Test
@DisplayName("애플리케이션 빈 출력하기")
void findApplicationBean() {
String[] beanDefinitionNames = ac.getBeanDefinitionNames();
for(String beanDefinitionName : beanDefinitionNames){
BeanDefinition beanDefinition = ac.getBeanDefinition(beanDefinitionName);
if(beanDefinition.getRole() == BeanDefinition.ROLE_APPLICATION){
Object bean = ac.getBean(beanDefinitionName);
System.out.println("name = " + beanDefinitionName + " object = " + bean);
}
}
}
*빈 이름으로 조회
AnnotationConfigApplicationContext ac = new AnnotationConfigApplicationContext(AppConfig.class);
@Test
@DisplayName("빈 이름으로 조회")
void findBeanByName() {
MemberService memberService = ac.getBean("memberService", MemberService.class);
assertThat(memberService).isInstanceOf(MemberServiceImpl.class);
}
*이름 없이 타입으로만 조회
AnnotationConfigApplicationContext ac = new AnnotationConfigApplicationContext(AppConfig.class);
@Test
@DisplayName("이름 없이 타입으로만 조회")
void findBeanByType() {
MemberService memberService = ac.getBean(MemberService.class);
assertThat(memberService).isInstanceOf(MemberServiceImpl.class);
}
*빈 이름으로 조회안되는 예외상황
AnnotationConfigApplicationContext ac = new AnnotationConfigApplicationContext(AppConfig.class);
@Test
@DisplayName("빈 이름으로 조회X")
void findBeanByNameX() {
MemberService xxxx = ac.getBean("xxxx", MemberService.class);
assertThrows(NoSuchBeanDefinitionException.class, () -> ac.getBean("xxxx", MemberService.class));
}
스프링 @Autowired, @Component, @Qualifier, @Primary
*@Autowired
스프링 빈의 의존관계를 자동으로 주입해주는 어노테이션이다. @Component 어노테이션으로 컴포넌트 스캔으로 등록된 클래스에서만 사용이 가능 하다. 컴포넌트 스캔으로
등록되지 않은 클래스에서 Autowired만 선언하면 아무런 의미가 없다. 기존의 @Bean을 이용하여 스프링빈에 등록하고 의존관계를 주입하는 것보다 훨씬 편한 방법으로
의존관계를 주입할 수 있다. 객체지향언어가 가져야할 원리다섯가지 SOLID의 D에 해당하는 DIP에 부합하는 어노테이션이다.
*@Component
컴포넌트 스캔을 실행할 때 스캔 대상이다. 스프링은 @ComponentScan 어노테이션을 보면 @Component 가 붙어있는 클래스들을 쭉 돌아서 찾아내고 스프링빈으로 등록한다.
스프링 빈에 등록된 빈들은 싱글톤 패턴을 적용하여 하나만 생성한 후 호출이 될때마다 생성된 빈을 가져다 쓰는 식으로 돌아간다.
*@Autowired로 지정된 의존관계 주입(DI)에서 같은 프로퍼티인 빈이 여러개 존재할 때
조회 대상 빈이 2개 이상일 때 해결방법은 다음과 같다.
1. @Autowired 필드 명 매칭
2. @Qualifier -> @Qualifier끼리 매칭 -> 빈 이름 매칭
3. @Primary 사용
1. @Autowired 필드 명 매칭
@Autowired는 타입 매칭을 시도하고, 이때 여러 빈이 있으면 필드 이름, 파라미터 이름으로 빈 이름을 추가 매칭한다.
필드명이 정상 주입되는 것을 찾아서 자동으로 매칭시켜준다.
2. @Qualifier 사용
@Qualifier는 추가 구분자를 붙여주는 방법이다. 주입 시 추가적인 방법을 제공하는 것이지 빈 이름을 변경하는 것은 아니다.
어노테이션을 추가로 붙이는데 @Qualifier("mainDiscountPolicy")를 적고 생성자에서
@Autowired
public OrderServiceImpl(MemberRepository memberRepository,@Qualifier("mainDiscountPolicy") DiscountPolicy discountPolicy) {
this.memberRepository = memberRepository;
this.discountPolicy = discountPolicy;
}
이렇게 추가해주면 된다.
3. @Primary 사용
@Primary는 우선순위를 정하는 방법이다. @Autowired시에 여러 빈이 매칭되면 @Primary가 우선권을 가진다.
*조회한 빈이 모두 필요할 때, LIst, Map
의도적으로 해당 타입의 스프링 빈이 다 필요한 경우도 있다.
예를 들어서 할인 서비스를 제공하는데, 클라이언트가 할인 종류를 선택할 수 있다고 가정해보자, 스프링을 사용하면 소위 말하는 전략패턴을 매우 간단하게 구현할 수 있다.
package hello.core.autowired;
import hello.core.AutoAppConfig;
import hello.core.discount.DiscountPolicy;
import hello.core.member.Grade;
import hello.core.member.Member;
import org.assertj.core.api.Assertions;
import org.junit.jupiter.api.Test;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.context.ApplicationContext;
import org.springframework.context.annotation.AnnotationConfigApplicationContext;
import java.util.List;
import java.util.Map;
import static org.assertj.core.api.Assertions.*;
public class AllBeanTest {
@Test
void findAllBean() {
ApplicationContext ac = new AnnotationConfigApplicationContext(AutoAppConfig.class, DiscountService.class);
DiscountService discountService = ac.getBean(DiscountService.class);
Member member = new Member(1L, "userA", Grade.VIP);
int discountPrice = discountService.discount(member, 10000, "fixDiscountPolicy");
assertThat(discountService).isInstanceOf(DiscountService.class);
assertThat(discountPrice).isEqualTo(1000);
int rateDiscountPrice = discountService.discount(member, 20000, "rateDiscountPolicy");
assertThat(rateDiscountPrice).isEqualTo(2000);
}
static class DiscountService {
private final Map<String, DiscountPolicy> policyMap;
private final List<DiscountPolicy> policies;
@Autowired
public DiscountService(Map<String, DiscountPolicy> policyMap, List<DiscountPolicy> policies) {
this.policyMap = policyMap;
this.policies = policies;
System.out.println("policyMap = " + policyMap);
System.out.println("policies = " + policies);
}
public int discount(Member member, int price, String discountCode) {
DiscountPolicy discountPolicy = policyMap.get(discountCode);
return discountPolicy.discount(member, price);
}
}
}
스프링 빈 생명주기 콜백
*빈 생명주기 콜백
1. 인터페이스 사용
2. 설정 정보에 초기화 메서드, 종료 메서드 지정
3. @PostConstruct, @PreDestroy 어노테이션 지원
1. 인터페이스 사용
implements InitializingBean, DisposableBean을 선언해준다.
그 후에 afterPropertiesSet(), distroy()메서드를 작성하면 된다. afterPropertiesSet() 은 생성자 호출하고 초기화가 다 끝나면 그때 호출이 된다. distroy()는 스프링이 내려갈때 맨 마지막에 호출해준다.
초기화, 소멸 인터페이스 단점
1. 이 인터페이스는 스프링 전용 인터페이스이다. 해당 코드가 스프링 전용 인터페이스에 의존한다.
2. 초기화, 소멸 메서드의 이름을 변경할 수 없다.
3. 내가 코드를 고칠 수 없는 외부 라이브러리에 적용할 수 없다.
인터페이스를 사용하는 초기화, 종료 방법은 스프링 초창기에 나온 방법들이고, 지금은 더 나은 방법들이 있어서 거의 사용하지 않는다.
2. 빈 등록 초기화, 소멸 메서드
빈을 등록할 때 @Bean(initMethod = "초기화메서드이름", destroyMethod = "소멸메서드이름") 이렇게 설정해주면 된다.
빈 등록 초기화, 소멸 메서드 장점
1. 메서드 이름을 자유롭게 줄 수 있다.
2. 스프링 빈이 스프링 코드에 의존하지 않는다.
3. 코드가 아니라 설정 정보를 사용하기 때문에 코드를 고칠 수 없는 외부 라이브러리에도 초기화, 종료 메서드를 적용할 수 있다.
종료메서드 특징
@Bean의 destroyMethod 속성에는 아주 특별한 기능이 있다.
1. 라이브러리는 대부분 close, shutdown이라는 이름의 종료 메서드를 사용한다.
2. @Bean의 destroyMethod는 기본값이 (inferred)으로 등록되어 있다. inferred = 추론
3. 이 추론 기능은 close, shutdown 이라는 이름의 메서드를 자동으로 호출해준다. 이름 그대로 종료 메서드를 추론해서 호출해준다.
4. 따라서 직접 스프링 빈으로 등록하면 종료 메서드는 따로 적어주지 않아도 잘 동작한다.
5. 추론 기능을 사용하기 싫으면 destroyMethod="" 처럼 빈 공백을 지정하면 된다.
3. 어노테이션 @PostConstruct, @PreDestroy 사용
초기화 메서드에 @PostConstruct, 종료 메서드에 @PreDestroy 어노테이션을 붙여주기만 하면 된다. (간단하다)
@PostConstruct, @PreDestroy 어노테이션 특징
1. 최신 스프링에서 가장 권장하는 방법이다.
2. 어노테이션 하나만 붙이면 되므로 매우 편리하다.
3. 패키지를 잘 보면 javax.annotation.PostConstruct이다. 이는 스프링에 종속적인 기술이 아니라 JSR-250이라는 자바 표준이고 따라서 스프링이 아닌 다른 컨테이너에서도 동작한다.
4. 컴포넌트 스캔과 잘 어울린다.
5. 유일한 단점은 외부 라이브러리에는 적용하지 못한다는 것이다. 외부 라이브러리를 초기화, 종료 해야하면 @Bean의 기능을 사용해야한다.
스프링 빈 스코프
*빈 스코프
일반적으로 스프링 빈은 스프링 컨테이너의 시작과 함께 생성되어서 스프링 컨테이너가 종료될 때 까지 유지된다. 이것은 스프링 빈이 기본적으로 싱글톤 스코프로 생성되기 때문이다. 스코프는 번역 그대로 빈이 존재할 수 있는 범위를 뜻한다.
스프링은 다음과 같은 다양한 스코프를 지원한다.
1. 싱글톤 : 기본 스코프, 스프링 컨테이너의 시작과 종료까지 유지되는 가장 넓은 범위의 스코프이다.
2. 프로토타입 : 스프링 컨테이너는 프로토타입 빈의 생성과 의존관계 주입까지만 관여하고 더는 관리하지 않는 매우 짧은 범위의 스코프이다.
3. 웹 관련 스코프
3-1. request : 웹 요청이 들어오고 나갈때 까지 유지되는 스코프이다.
3-2. session : 웹 세션이 생성되고 종료될 때 까지 유지되는 스코프이다.
3-3. application : 웹의 서블릿 컨텍스트와 같은 범위로 유지되는 스코프이다.
2. 프로토타입
싱글톤 스코프의 빈을 조회하면 스프링 컨테이너는 항상 같은 인스턴스의 스프링 빈을 반환한다. 반면에 프로토타입 스코프를 스프링 컨테이너에 조회하면 스프링 컨테이너는 항상 새로운 인스턴스를 생성해서 반환한다.
핵심은 스프링 컨테이너는 프로토타입 빈을 생성하고, 의존관계 주입, 초기화까지만 처리한다는 것이다. 클라이언트에 빈을 반환하고, 이후 스프링 컨테이너는 생성된 프로토타입 빈을 관리하지 않는다. 프로토타입 빈을 관리할 책임은 프로토타입 빈을 받은 클라이언트에 있다. 그래서 @PreDestroy같은 종료 메서드가 호출되지 않는다.
프로토타입을 사용할 때 싱글톤과 같이 사용하면 문제가 생긴다.
싱글톤 패턴의 기본 빈에서 프로토타입 빈을 주입받을 때 싱글톤 타입의 빈이 호출될 때마다 이미 주입받은 프로토타입의 빈을 호출하기 때문에 만약 두명의 클라이언트가 각각 싱글톤 패턴의 빈을 호출한다면 원래 의도는 두개의 프로토타입이 생성되어야 하지만 스프링은 이미 주입받은 프로토타입을 클라이언트에게 제공하기 때문에 같은 프로토타입의 빈이 클라이언트에게 제공된다. 이를 해결하기 위해 스프링의 기능중 ObjectProvider를 사용하거나 JSR-330 Provider를 사용하면 된다.
2-1. ObjectProvider를 이용하는 방법
static class ClientBean {
private final ObjectProvider<PrototypeBean> prototypeBeanProvider;
public ClientBean(ObjectProvider<PrototypeBean> prototypeBeanProvider) {
this.prototypeBeanProvider = prototypeBeanProvider;
}
public int logic() {
PrototypeBean prototypeBean = prototypeBeanProvider.getObject();
prototypeBean.addCount();
return prototypeBean.getCount();
}
}
지정한 빈을 컨테이너에서 대신 찾아주는 DL(Dependency Lookup)서비스를 제공하는 것이 바로 ObjectProvider이다. ObjectProvider는 getObject()를 호출하면 내부에서는 스프링 컨테이너를 통해 해당 빈을 찾아서 반환한다. 때문에 logic을 호출할 때마다 객체를 new 해서 만든것과 같은 효과를 볼 수 있다.
2-2. JSR-330 Provider를 이용하는 방법 build.gradle에 implementation 'javax.inject:javax.inject:1'을 추가해주면 이용 가능하다.
static class ClientBean {
private final Provider<PrototypeBean> prototypeBeanProvider; //Provider는 javax.inject에 있는 Provider를 사용해야 한다. security에 있는 Provider는아니다.
public ClientBean(Provider<PrototypeBean> prototypeBeanProvider) {
this.prototypeBeanProvider = prototypeBeanProvider;
}
public int logic() {
PrototypeBean prototypeBean = prototypeBeanProvider.get();
prototypeBean.addCount();
return prototypeBean.getCount();
}
}
둘 중 무엇을 써야하나 고민이 될텐데 ObjectProvider는 스프링에서 제공하는 기능이고 JSR-330 Provider는 자바 표준기능이다. 둘다 장단점이 있는데 ObjectProvider는 스프링이 제공하는 기능이기 때문에 사용하기 편리하고 제공하는 편리기능이 많이 있다.
JSR-330 Provider는 자바 표준이기 때문에 스프링컨테이너가 아닌 다른 곳에서도 사용이 가능하고 DL의 기능인 get()메서드만 제공하기 때문에 편리기능이 많이 없다 그리고 라이브러리를 추가해야한다는 약간의(?) 귀찮음이 있다.
둘 중 그냥 끌리는것을 선택해서 사용하면 될 것이다.
3. 웹 스코프
웹 스코프의 특징으로는 웹 환경에서만 동작한다는 것과, 웹 스코프는 프로토타입과 다르게 스프링이 해당 스코프의 종료시점까지 관리한다는 것이다.
웹 스코프의 종류
3-1. request : HTTP 요청 하나가 들어오고 나갈 때 까지 유지되는 스코프, 각각의 HTTP 요청마다 별도의 빈 인스턴스가 생성되고 관리된다.
3-2. session : HTTP Session과 동일한 생명주기를 가지는 스코프
3-3. application : 서블릿 컨텍스트와 동일한 생명주기를 가지는 스코프
3-4. websocket : 웹 소켓과 동일한 생명주기를 가지는 스코프
session, application, websocket은 request스코프와 비슷한 원리로 동작하기 때문에 request스코프만 본문에서 다루도록 한다. 나머지 세개와 request와의 차이점은 적용되는 범위이다.
request 스코프
동시에 여러 HTTP요청이 오면 정확히 어떤 요청이 남긴 로그인지 구분하기가 어렵다. 이럴때 사용하기 좋은것이 바로 request 스코프이다.
의존관계에 있는 클래스를 request 스코프로 지정하고 실행해보면 오류가 나는데 그 이유는 의존관계에 있는 request 스코프는 request 즉 요청이 왔을 때 부터 요청이 끝나는 시간까지 생명주기를 가지고 있는데 스프링을 동작하려고 하는 그 순간에는 요청이 안온 상태이니 스프링 입장에서는 요청이 안왔는데 요청온 것을 의존관계로 주입하려고 하니
야, request 없는데? 라는 오류를 내보내는 것이다. 그렇다면 request 스코프를 사용할 수 없는 것인가? 바로 이럴 땐 두가지 해결방법이 있다.
바로 ObjectProvider와 proxy를 사용하는 것이다.
3-1-1. ObjectProvider 사용
의존 관계를 주입하려는 클래스의 스코프가 request라면 ObjectProvider<MyLogger> objectProvider; 를 선언한 후에 생성자를 만들어주거나 롬복을 이용해서 RequiredArgsConstructor를 어노테이션으로 설정해주면 된다. 그 후에 MyLogger myLogger = myLoggerProvider.getObject(); 로 MyLogger에 접근할 수 있다. ObjectProvider를 사용하면 getObject()가 나타난 시점에 스프링 컨테이너를 통해 해당 빈을 찾아서 반환하기 때문에 선언되면 그때 만들어서 주입해준다.
3-1-2. proxy 사용
스코프를 request로 지정한 클래스에서 @Scope(value = "request", proxyMode = ScopedProxyMode.TARGET_CLASS)를 선언해 주고 private final MyLogger myLogger; 이런식으로 바로 사용해주면 된다. 저 프록시모드가 앞선 Provider의 역할을 대신 하고 있다고 보면 된다. MyLogger가 사용되는 시점 (ex) myLogger.setRequestURL(requestURL); )에 진짜 MyLogger를 찾아서 주입하고 그 전까지는 스프링이 만든 가짜를 집어넣어 놓는다. 이렇게 프록시를 사용하면 마치 싱글톤을 사용하듯이 사용할 수 있는데, 이때 프록시는 싱글톤과 다르게 동작하기 때문에 주의점이 필요하다
3-1-2-1. 프록시 사용시 주의점
1. 마치 싱글톤을 사용하는 것 같지만 다르게 동작하기 때문에 결국 주의해서 사용해야 한다.
2. 이런 특별한 scope는 꼭 필요한 곳에만 최소화해서 사용해야한다. 무분별하게 사용하면 유지보수하기 어려워진다.
스프링 MVC 구조
*스프링 MVC 구조
스프링 MVC의 구조는 다음과 같다
1. HTTP요청이 들어오면 Front Controller인 Dispatcher Servlet이 모든 URL매핑에 반응한다.
2. 그 후에 핸들러(=컨트롤러) 매핑 정보를 기반으로 핸들러를 조회한다.
3. 핸들러마다 다른 기능을 지원하기 위해서 핸들러 어댑터 목록에서 핸들러를 처리할 수 있는 핸들러 어댑터를 조회한다.
4. 핸들러 어댑터를 들고 핸들러를 호출한다.
5. 핸들러를 호출하고 Model And View로 반환해준다.
6. viewResolver를 호출해서 View를 반환받는다.
7. render를 호출해서 랜더링한다.
*@Controller
-스프링이 자동으로 스프링 빈으로 등록한다. (내부에 @Component 어노테이션이 있어서 컴포넌트 스캔의 대상이 됨)
-스프링 MVC에서 어노테이션 기반 컨트롤러로 인식한다. = RequestMappingHandlerMapping에서 핸들러로 매핑이 된다는 소리
*RequestMapping
-요청 정보를 매핑한다. 해당 URL이 호출되면 이 메서드가 호출된다. 어노테이션을 기반으로 동작하기 때문에, 메서드의 이름은 임의로 지으면 된다.
스프링 로깅
*로깅
운영 시스템에서는 System.out.println() 같은 시스템 콘솔을 사용해서 필요한 정보를 출력하지 않고, 별도의 로깅 라이브러리를 사용해서 로그를 출력한다.
참고로 로그 관련 라이브러리도 많고, 깊게 들어가면 끝이 없기 때문에, 여기서는 최소한의 사용 방법만 알아본다.
*로깅 라이브러리
스프링 부트 라이브러리를 사용하면 스프링 부트 로깅 라이브러리가 함께 포함된다. 스프링 부트 로깅 라이브러리는 기본적으로 다음 로깅 라이브러리를 사용한다.
-SLF4J : http://www.slf4j.org
-Logback : http://logback.qos.ch
로그 라이브러리는 Logback, Log4J, Log4J2 등등 수 많은 라이브러리가 잇는데, 그것을 통합해서 인터페이스로 제공하는 것이 바로 SLF4J 라이브러리다. 쉽게 얘기해서 SLF4J는 인터페이스이고 그 구현체로 Logback 같은 로그 라이브러리를 선택하면 된다. 실무에서는 스프링 부트가 기본으로 제공하는 Logback을 대부분 사용한다.
*로그 선언
private final Logger log = LoggerFactory.getLogger(getClass()); //Logger, LoggerFactory둘 다 org.slf4j에 있는 것을 사용해야 한다.
*로그 찍기
-log.trace("trace log={}", 로그내용);
-log.debug("debug log={}", 로그내용);
-개발 단계에서 찍는 로그
-log.info("info log={}", 로그내용);
-log.warn("warn log={}", 로그내용);
-log.error("error log={}", 로그내용);
-운영 단계에서 찍는 로그
application.properties에 들어가서
logging.level.패키지경로=trace or debug or info or warn or error
trace = 모든 로그 다찍겠다
debug = 트레이스는 안찍고 debug 부터 info, warn, error 찍겠다 //개발서버에서 사용
info = 디버그까지도 안찍고 info 부터 warn, error 찍겠다. //운영서버에서 사용
*level
trace > debug > info > warn > error
cf) @RestController
-@Controller는 반환값이 String이면 뷰 이름으로 인식된다. 그래서 뷰를 찾고 뷰가 랜더링 된다.
-@RestController는 반환 값으로 뷰를 찾는 것이 아니라, HTTP메시지 바디에 바로 입력한다. 따라서 실행 결과로 메시지를 받을 수 있따. @ResponseBody와 관련이 있는데 뒤에서 더 자세히 설명하겠다. => RestAPI를 사용할때 주요한 어노테이션
*@Slf4j
매번 선언하는것이 여간 귀찮은것이 아닐것이다. 그런 귀찮은 사람을 위해 준비한 어노테이션인 @Slf4j이다. 롬복이 제공하는 어노테이션이고 선언문을 자동으로 넣어주는 어노테이션이다.
스프링 요청매핑
*요청 매핑
*@RestController
-@Controller는 반환 값이 String 이면 뷰 이름으로 인식된다. 그래서 뷰를 찾고 뷰가 랜더링 된다.
-@RestController는 반환 값으로 뷰를 찾는 것이 아니라 HTTP메시지 바디에 바로 입력한다. @ResponseBody와 관련이 있는데 뒤에서 더 자세히 설명한다.
*@RequestMapping("/hello-basic")
-/hello-basic URL 호출이 오면 이 메서드가 실행되도록 매핑한다.
-대부분 속성을 배열로 제공하므로 다중 설정이 가능하다. {"/hello-basic", "/hello-go"}
RequestMapping은 뒤에 method를 한정지을 수 있는데 다음과 같이 적으면 된다.
@RequestMapping(value = "/hello-basic", method = RequsetMethod.GET) 이렇게 적으면 GET방식만 허용되고 나머지는 차단된다.
*경로 변수
@GetMapping("/mapping/{userId}") 이런식으로 URL 자체에 템플릿처럼 값이 들어오는 것
public String mappingPath(@PathVariable("userId") String data) {
log.info("mappingPath userId = {}", data); //이런 식으로 꺼내서 쓸 수도 있음
return "ok";
}
@GetMapping("/mapping/{userId}")
public String mappingPath(@PathVariable String userId) { //이런식으로 URL에 들어있는 경로변수명을 선언해주면 퉁칠 수 있다.
최근 HTTP API는 다음과 같이 리소스 경로에 식별자를 넣는 스타일을 선호한다.
PathVariable은 다중 사용이 가능하다.
@GetMapping("/mapping/users/{userId}/orders/{orderId}") 이런식으로 다중으로 사용 가능
*특정 헤더 조건 매핑
@GetMapping(value = "/mapping-header", headers = "mode=debug") 이런식으로 특정 헤더를 조건으로 하는 매핑을 추가할 수 있다.
특정 헤더를 추가해줘야만 접근이 가능하다.
*미디어 타입 조건 매핑 - HTTP 요청 Content-Type, consume
@PostMapping(value = "/mapping-consume", consumes = "application/json") 이렇게 매핑하게 되면 application/json인 타입만 접근이 가능하다
@PostMapping(value = "/mapping-consume", consumes = MediaType.APPLICATION_JSON_VALUE) 이렇게 적는게 더 좋다. (가독성)
*미디어 타입 조건 매핑 - HTTP 요청 Accept, produce
@PostMapping(value = "/mapping-produce", produces = "text/html")
@PostMapping(value = "/mapping-produce", produces = MediaType.TEXT_HTML_VALUE) 이렇게 적는게 더 좋다. (가독성)
이렇게 매핑하게 되면 내가 생산하는 타입이 text/html이기 때문에 Accept가 text/html인 파일만 접근이 가능하다. HTTP 요청의 Accept 헤더를 기반으로 미디어 타입으로 매핑한다. 만약 맞지 않으면 HTTP 406 상태코드(Not Acceptable)을 반환한다.
스프링 요청파라미터
*HTTP 요청 파라미터 - @RequestParam
스프링이 제공하는 @RequestParam을 사용하면 요청 파라미터를 매우 편리하게 사용할 수 있다.
@RequestMapping("/request-param-v2")
public String requestParamV2 (@RequestParam("username") String memberName, @RequestParam("age") int memberAge) {
...
}
이런식으로 RequestParam을 이용하면 request.getParameter("username")과 같은 효과를 볼 수 있다.
@RequestMapping("/request-param-v3)
public String requestParamV3 (@RequestParam String username, @RequestParam int age) 파라미터 이름과 변수 이름이 같다면 이런식으로 간략하게 표현 할 수 있다.
*HTTP 요청 파라미터 - @ModelAttribute
@ResponseBody
@RequestMapping("/model-attribute-v1")
public String modelAttributeV1(@RequestParam String username, @RequestParam int age) {
HelloData helloData = new HelloData();
helloData.setAge(age);
helloData.setUsername(username);
log.info("username={}", helloData.getUsername());
log.info("age={}", helloData.getAge());
return "ok";
}
이렇게 귀찮게 길게 써야했던 코드들이
@ResponseBody
@RequestMapping("/model-attribute-v2")
public String modelAttributeV2(@ModelAttribute HelloData helloData) {
log.info("username={}", helloData.getUsername());
log.info("age={}", helloData.getAge());
return "ok";
}
이렇게 간결하게 줄어든다
스프링 MVC는 @ModelAttribute 가 있으면 다음을 실행한다
1. HelloData 객체를 생성한다.
2. 요청 파라미터의 이름으로 HelloData객체의 프로퍼티를 찾는다. 그리고 해당 프로퍼티의 setter를 호출해서 파라미터의 값을 입력한다.
3. 예) 파라미터 이름이 username이면 setUsername() 메서드를 찾아서 호출하면서 값을 입력한다.
프로퍼티란?
객체에 getUsername(), setUsername() 메서드가 있으면, 이 객체는 username이라는 프로퍼티를 가지고 있다. username프로퍼티의 값을 변경하면 setUsername()이 호출되고 조회하면 getUsername()이 호출된다.
스프링 HTTP 요청 메시지 - 단순 텍스트
*HTTP 요청 메시지 - 단순 텍스트
HTTP message body에 데이터를 직접 담아서 요청
-HTTP API에서 주로 사용, JSON, XML, TEXT
-데이터 형식은 주로 JSON 사용
-POST, PUT, PATCH 사용가능
요청 파라미터와 다르게, HTTP 메시지 바디를 통해 데이터가 직접 넘어오는 경우는 @RequestParam, @ModelAttribute를 사용할 수 없다.
이럴때는 InputStream으로 메시지 바디에 있는 내용을 읽어올 수 있다.
@PostMapping("/request-body-string-v1")
public void requestBodyString(HttpServletRequest request, HttpServletResponse response) throws ServletException, IOException {
ServletInputStream inputStream = request.getInputStream();
String messageBody = StreamUtils.copyToString(inputStream, StandardCharsets.UTF_8);
log.info("messageBody={}", messageBody);
response.getWriter().write("ok");
}
매개변수를 InputStream, Writer등으로 읽어올 수도 있다.
@PostMapping("/request-body-string-v2")
public void requestBodyStringV2(InputStream inputStream, Writer responseWriter) throws ServletException, IOException {
String messageBody = StreamUtils.copyToString(inputStream, StandardCharsets.UTF_8);
log.info("messageBody={}", messageBody);
responseWriter.write("ok");
}
스프링에서 제공하는 messageConverter를 이용하면 InputStream이런거 사용 안하고 편리하게 사용할 수 있다.
@PostMapping("/request-body-string-v3")
public HttpEntity<String> requestBodyStringV3(HttpEntity<String> httpEntity) throws ServletException, IOException {
String messageBody = httpEntity.getBody();
log.info("messageBody={}", messageBody);
return new HttpEntity<>("ok");
}
스프링은 HttPEntity는 HTTP header, body 정보를 편리하게 조회할 수 있다.
-메시지 바디 정보를 직접 조회
-요청 파라미터를 조회하는 기능과 관계 없음
HttpEntity는 응답에도 사용 가능
-메시지 바디 정보 직접 변환
-헤더 정보 포함 가능
-view 조회 X
@RequestBody 어노테이션을 이용한 더욱 더 간단한 방법이 있다. //이방법이 실무에서 가장 많이 쓰인다.
@ResponseBody
@PostMapping("/request-body-string-v4")
public String requestBodyStringV4(@RequestBody String messageBody) throws ServletException, IOException {
log.info("messageBody={}", messageBody);
return "ok";
}
@RequestBody를 사용하면 HTTP메시지 바디 정보를 편리하게 조회할 수 있다. 참고로 헤더 정보가 필요하다면 HttpEntity를 사용하거나 @RequestHeader를 사용하면 된다.
*요청 파라미터 vs HTTP 메시지 바디
-요청 파라미터를 조회하는 기능 : @RequestParam, @ModelAttribute
-HTTP 메시지 바디를 직접 조회하는 기능 : @RequestBody
스프링 HTTP요청 메시지 - JSON
*HTTP 요청메시지 - JSON
-InputStream으로 읽어오는 방식
@PostMapping("/request-body-json-v1")
public void requestBodyJsonV1(HttpServletRequest request, HttpServletResponse response) throws ServletException, IOException {
ServletInputStream inputStream = request.getInputStream();
String messageBody = StreamUtils.copyToString(inputStream, StandardCharsets.UTF_8);
log.info("messageBody={}", messageBody);
HelloData helloData = objectMapper.readValue(messageBody, HelloData.class);
log.info("username={}, age={}", helloData.getUsername(), helloData.getAge());
response.getWriter().write("ok");
}
-@RequestBody로 읽어오는 방식
@ResponseBody
@PostMapping("/request-body-json-v2")
public String requestBodyJsonV2(@RequestBody String messageBody) throws ServletException, IOException {
log.info("messageBody={}", messageBody);
HelloData helloData = objectMapper.readValue(messageBody, HelloData.class);
log.info("username={}, age={}", helloData.getUsername(), helloData.getAge());
return "ok";
}
-@RequestBody로 읽어오는데 객체를 파라미터로 받으면 더 간단하게 바꿀 수 있다.
@ResponseBody
@PostMapping("/request-body-json-v3")
public String requestBodyJsonV3(@RequestBody HelloData helloData) throws ServletException, IOException {
log.info("username={}, age={}", helloData.getUsername(), helloData.getAge());
return "ok";
}
*@RequestBody 객체 파라미터
-@RequestBody HelloData helloData 이런식으로 객체를 파라미터로 받을 수 있다.
-@RequestBody에 직접 만든 객체를 지정할 수 있다.
HttpEntity, @RequestBody를 사용하면 HTTP 메시지 컨버터가 HTTP 메시지 바디의 내용을 우리가 원하는 문자나 객체 등으로 변환해준다. HTTP메시지 컨버터는 문자 뿐만 아니라 JSON객체로 변환해주는데, 우리가 방금 V2에서 했던 작업을 대신 처리해준다.
물론 HttpEntity로 꺼내올 수도 있다. 헤더에 관한 정보가 필요하면 HttpEntity가 필요하다.
@ResponseBody
@PostMapping("/request-body-json-v4")
public String requestBodyJsonV4(HttpEntity<HelloData> httpEntity) throws ServletException, IOException {
HelloData helloData = httpEntity.getBody();
log.info("username={}, age={}", helloData.getUsername(), helloData.getAge());
return "ok";
}
리턴 타입을 HelloData로 하면 요청도 JSON으로 오고 응답도 JSON으로 간다
@ResponseBody
@PostMapping("/request-body-json-v5")
public HelloData requestBodyJsonV5(@RequestBody HelloData helloData) throws ServletException, IOException {
log.info("username={}, age={}", helloData.getUsername(), helloData.getAge());
return helloData;
}
응답의 경우에도 @ResponseBody를 사용하면 해당 객체를 HTTP메시지 바디에 직접 넣어줄 수 있다. 물론 이 경우에도 HttpEntity를 사용해도 된다.
@RequestBody 요청
-JSON 요청 -> HTTP 메시지 컨버터 -> 객체
@ResponseBody 응답
-객체 -> HTTP 메시지 컨버터 -> JSON 응답
스프링 HTTP응답 - 정적 리소스, 뷰 템플릿
*HTTP 응답 - 정적 리소스, 뷰 템플릿
스프링에서 응답 데이터를 만드는 방법은 크게 3가지이다.
1. 정적 리소스 : ex) 웹 브라우저에 정적인 HTML, css, js를 제공할 때는, 정적리소스를 사용한다.
2. 뷰 템플릿 사용 : ex) 웹 브라우저에 동적인 HTML을 제공할 때는 뷰 템플릿을 사용한다.
3. HTTP 메시지 사용 : HTTP API를 제공하는 경우에는 HTML이 아니라 데이터를 전달해야 하므로, HTTP메시지 바디에 JSON같은 형식으로 데이터를 실어 보낸다.
1. 정적 리소스
스프링 부트는 클래스패스의 다음 디렉토리에 있는 정적 리소스를 제공한다.
/static, /public, /resources, /META-INF/resources
src/main/resources는 리소스를 보관하는 곳이고, 또 클래스패스의 시작 경로이다. 따라서 다음 디렉토리에 리소스를 넣어두면 스프링 부트가 정적 리소스로 서비스를 제공한다. 정적 리소스는 해당 파일을 변경 없이 그대로 서비스하는 것이다.
2. 뷰 템플릿 사용
뷰 템플릿을 거쳐서 HTML이 생성되고, 뷰가 응답을 만들어서 전달한다. 일반적으로 HTML을 동적으로 생성하는 용도로 사용하지만, 다른 것들도 가능하다. 뷰 템플릿이 만들 수 있는 것이라면 뭐든지 가능하다.
-ModelAndView를 이용해서 뷰 템플릿을 호출할 수 있다.
@RequestMapping("/response-view-v1")
public ModelAndView responseViewV1() {
ModelAndView mav = new ModelAndView("response/hello")
.addObject("data", "hello!");
return mav;
}
-반환을 String으로 해놓고 Model을 매개변수로 받아서 addAttribute를 사용하면 쉽고 간편하게 뷰 템플릿을 호출할 수 있다.
@RequestMapping("/response-view-v2")
public String responseViewV2(Model model) {
model.addAttribute("data", "hello!");
return "response/hello";
}
-반환을 void로 해놓고 사용할 수도 있다.
@RequestMapping("/response/hello")
public void responseViewV3(Model model) {
model.addAttribute("data", "hello!");
}
@Controller를 사용하고, HttpServletResponse, OutputStream(Writer)같은 HTTP 메시지 바디를 처리하는 파라미터가 없으면 요청 URL을 참고해서 논리 뷰 이름으로 사용이 가능하다. 반환방식을 void로 하는것은 명시성이 너무 떨어지고 이렇게 딱 맞는 경우도 많이 없어서, 권장하지 않는다.
스프링 HTTP응답 - HTTP API, 메시지 바디에 직접 입력
*HTTP 응답 - HTTP API, 메시지 바디에 직접 입력
-response.getWriter를 이용한 출력
@GetMapping("/response-body-string-v1")
public void responseBodyV1(HttpServletResponse response) throws IOException {
response.getWriter().write("ok");
}
-ResponseEntity를 이용한 출력 (상태코드 같이 출력 가능)
@GetMapping("/response-body-string-v2")
public ResponseEntity<String> responseBodyV2(HttpServletResponse response) {
return new ResponseEntity<>("ok", HttpStatus.OK);
}
-@ResponseBody를 붙여서 그냥 메시지 바디에 메시지를 콱 박아서 전송하는 방식
@ResponseBody
@GetMapping("/response-body-string-v3")
public String responseBodyV3(HttpServletResponse response) {
return "ok";
}
ㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡ일반 텍스트ㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡㅡ
-ResponseEntity를 이용한 json 전송방식
@GetMapping("/response-body-json-v1")
public ResponseEntity<HelloData> responseBodyJsonV1() {
HelloData helloData = new HelloData();
helloData.setUsername("userA");
helloData.setAge(20);
return new ResponseEntity<>(helloData, HttpStatus.OK);
}
-반환타입을 HelloData로 전송하는 방식
@ResponseStatus(HttpStatus.OK)
@ResponseBody
@GetMapping("/response-body-json-v2")
public HelloData responseBodyJsonV2() {
HelloData helloData = new HelloData();
helloData.setUsername("userA");
helloData.setAge(20);
return helloData;
}
@ResponseBody를 계속 쓰기 귀찮으면 클래스레벨로 올려서 적으면 된다. 클래스 레벨로 올려 적으면 @Controller와 만나게 되는데 이 둘을 합친 것이 바로 @RestController이다. API를 만들 때는 @RestController를 붙이자
스프링 MVC 기본기능 핵심정리
*로깅
롬복의 @Slf4j어노테이션 사용 or private final Logger log = LoggerFactory.getLogger(getClass());
올바른 로그 사용법
log.info("username={}", username);
*요청 매핑 @RequestMapping(value = "/hello-basic" method = "RequestMethod.GET")
이거 두개를 합친것이 바로 @GetMapping
*@ResponseBody 이거 쓰면 return 값을 문자열로 반환했을 때 HTTP메시지 바디에 꽂혀서 전송됨
*@PathVariable 경로 변수
/username/{username} 이런식으로 URL을 템플릿화 시켜서 보냄 가져오는 방법
public String getPathVariable(@PathVariable("username") String data) 이렇게 하면 data에 저 {username} 에 해당하는 값 넣을 수 있음
매개변수명과 경로변수명이 같으면 생략해서 사용 가능
public String getPathVariable(@PathVariable String username) 이런식으로 생략가능
*특정 헤더 조건 매핑
@GetMapping("/mapping-header", headers = "mode=debug") key = mode, value = debug인 헤더가 없으면 오류 띄운다
*미디어 타입 조건 매핑
@GetMapping("/mapping=consume", consume = "application/json") 미디어타입이 안맞으면 오류 띄운다
*HTTP 요청의 Accept헤더를 기반으로 미디어 타입을 매핑
@PostMapping("/mapping-produce", produce = "text/html") 미디어타입이 text/html이 아니면 오류 띄운다
*쿼리 파라미터는 GET, POST, HTTP message body이 세개만 동작 (클라이언트 -> 서버로 요청 데이터 전달할 때)
GET, POST는 request.getParameter로 꺼내올 수 있음 @RequestParam 쓰면 더 간결하게 꺼내올 수 있음
public String requestParam(@RequestParam("username") String memberName) 이렇게 선언하고 memberName으로 사용하면 됨 String memberName = request.getParameter("username")과 같은 의미
매개변수의 변수명과 파라미터의 이름이 같으면 생략할 수 있음 public String requestParam(@RequestParam String username) 이런식으로 가능
매개변수타입이 String, int, Integer등 단순한 타입이면 @RequestParam 생략가능, 하지만 안하는게 더 명시성 좋음
*파라미터를 Map으로 조회하기
public String requestParamMap(@RequestParam Map<String, Object> paramMap) 이렇게 하고 paramMap.get("username") 이런식으로 꺼내서 쓸 수 있음 파라미터 이름을 key로 같는 Map 생성
*요청 파라미터에 객체를 집어 넣는 방법 @ModelAttribute
public String modelAttribute(@ModelAttribute HelloData helloData) 이렇게 @ModelAttribute 어노테이션을 사용하면 객체를 요청 파라미터에 집어넣을 수 있음 이렇게 넣으면 파라미터에 들어온 username이 @ModelAttribute를 만나면 helloData.setUsername("userA"); 이걸 처리해 줌 따라서 메서드에서는 helloData.getUsername()으로 값을 꺼내서 사용 할 수 있음 @ModelAttribute는 생략 가능, 하지만 생략하지 않는게 명시성에 더 좋음
*HTTP 요청 메시지 - HTTP message body에 데이터를 직접 담아서 요청
1. response를 사용하는 방법 //잘 사용 안함
2. InputStream을 사용하는 방법 //잘 사용 안함
3. HttpEntity or ResponseEntity를 사용하는 방법 //꽤 사용 함 헤더정보 읽을 때
4. @RequestBody를 사용하는 방법 //자주 사용 함
3. HttpEntity or ResponseEntity 사용하는 방법
public String requestBodyString(HttpEntity<String> httpEntity) 이렇게 하고 String messageBody = httpEntity.getBody(); 이렇게 선언하면 HTTP 메시지 바디에 있는 단순 텍스트가 messageBody에 저장됨
4. @RequestBody 사용하는 방법
public String requestBodyString(@RequestBody String messageBody) 이렇게 선언하면 바로 messageBody에 HTTP 메시지 바디에 있는 단순 텍스트가 저장됨 바로 꺼내 쓰면 됨
*HTTP 요청 메시지 - JSON
1. InputStream 사용해서 읽기 //잘 안쓴다
2. objectMapper 사용해서 읽기 //잘 안쓴다
3. @RequestBody 사용해서 읽기 //자주 쓴다
4. HttpEntity 사용해서 읽기 //종종 쓴다
5. @RequestBody 사용해서 읽고 json으로 응답하기 //자주 쓴다
3. @RequestBody 사용해서 읽기
public String requestBodyJson(@RequestBody HelloData helloData) 이렇게 하면 json으로 온 {"username":"userA", "age":"20"} 이런 형태의 데이터가
helloData.setUsername("userA"), helloData.setAge(20) 이런식으로 들어감 HelloData에 JSON의 키값이 되는 프로퍼티에 해당하는 getter, setter가 있어야 함
4. HttpEntity 사용해서 읽기
public String requestBodyJson(HttpEntity<HelloData> httpEntity) 이런식으로 선언한 후에 HelloData helloData = httpEntity.getBody(); 이런식으로 객체를 생성해서
helloData.getUsername(), helloData.getAge() 이런식으로 뽑아 쓰면 됨
5. @RequestBody 사용해서 읽고 json으로 응답하기
위의 3번과 똑같은 방식으로 사용하면 되지만 반환타입을 String에서 HelloData로 바꿔준 후에 helloData.setUsername("userB"), helloData.setAge(30); 이렇게 지정한 후에
return helloData이렇게 바꿔주면 json으로 응답이 가능하다. 상대방은 {"username":"userB", "age":"30"}인 json데이터를 받게 된다.
타임리프
*타임리프 간단한 문법
*타임리프 선언<html xmlns:ht="http://www.thymeleaf.org"> (http://www.thymeleaf.org">)
*속성 변경 th:href="@{/css/bootstrap.min.css}"
-href="value1"를 th:href="value2"의 값으로 변경한다.
-타임리프 뷰 템플릿을 거치게 되면 원래 값을 th:xxx값으로 변경한다. 만약 값이 없다면 새로 생성한다.
-html을 그대로 볼 때는 href 속성이 사용되고, 뷰 템플릿을 거치면 th:href의 값이 href로 대체되면서 동적으로 변경할 수 있다.
-대부분 html속성을 th:xxx로 변경할 수 있다.
*타임리프 핵심
-핵심은 th:xxx가 붙은 부분은 서버사이드에서 렌더링되고, 기존 것을 대체한다. th:xxx이 없으면 기존 html의 xxx속성이 그대로 유지된다.
-html을 파일로 직접 열었을 때 th:xxx가 있어도 웹 브라우저는 th: 속성을 알지 못하므로 무시한다.
-따라서 html을 파일 보기 유지하면서 템플릿 기능도 할 수 있다.
*URL 링크 표현식
-th:href="@{/css/bootstrap.min.css}"
-@{...} 타임리프는 URL 링크를 사용하는 경우 @{...}를 사용한다. 이것을 URL 링크 표현식이라고 한다.
*URL 링크 표현식2
-th:href="@{/basic/items/{itemId}(itemId=${item.id})}"
-상품 ID를 선택하는 링크를 확인해보자
-URL 링크 표현식을 사용하면 경로를 템플릿처럼 편리하게 사용할 수 있다.
-경로 변수 {itemId} 뿐만 아니라 쿼리 파라미터도 생성한다.
-ex)th:href="@{/basic/items/{itemId}(itemId={item.id}, query='test')}" => 생성 링크 http://localhost:8080/basic/items/1?query=test
*상품 등록 폼으로 이동할 때 속성 변경
-th:onclick="|location.href='@{/basic/items/add}'|"
-여기에는 다음에 설명하는 리터럴 대체 문법이 사용되었다.
*리터럴 대체 |...|
-타임리프에서 문자와 표현식 등은 불리되어 있기 때문에 더해서 사용해야 한다.
ex) <span th:text=" 'Welcome to our application, ' + ${user.name} + '!' ">
-다음과 같이 리터럴 대체 문법을 사용하면, 더하기 없이 편리하게 사용할 수 있다.
ex) <span th:test="|Welcome to our application ${user.name}!|">
*반복 출력
<tr th:each="item : ${items}">
-반복은 th:each를 사용한다. 이렇게 하면 모델에 포함된 items 컬렉션 데이터가 item 변수 하나씩 포함되고 반복문 안에서 item 변수를 사용할 수 있다.
-컬렉션의 수 만큼 <tr>...</tr> 이 하위 태그를 포함해서 생성된다.
*변수 표현식
-<td th:text="${item.price}">10000</td>
-모델에 포함된 값이나 타임리프 변수로 선언한 값을 조회할 수 있다.
-프로퍼티 접근법을 사용한다. item.getPrice()
*내용 변경
<td th:text="${item.price}">10000</td>
-내용의 값을 th:text의 값으로 변경한다.
-여기서는 10000을 item.price의 값으로 변경한다.
스프링 RedirectAttribute
*RedirecAttribute
파라미터에 RedirectAttribute 를 추가해주면 기능을 사용할 수 있는데
public String item(RedirectAttributes, redirectAttributes) 이렇게 추가해주면 사용 가능하다
redirectAttributes.addAttribute(attributeName, attributeValue) 이렇게 사용 가능하다.
redirectAttributes.addAttribute("itemId", itemId); 이렇게 쓰면 뷰 템플릿을 호출할 때 return "/basic/item/${itemId}" 이렇게 경로변수로 사용할 수 있다. 경로변수로 사용되지 못한 addAttribute는 쿼리 파라미터로 넘어가게 된다.
redirectAttributes.addAttribute("status", true); => /basic/item/3?status=true 이런식으로 됨
스프링 dirty checking과 merge
*변경감지(Dirty Checking)와 병합(merge)
준영속 엔티티란?
영속성 컨텍스트가 더는 관리하지 않는 엔티티를 말한다. em.persist로 넣을 때 혹은 em.find 등으로 디비에서 값을 가져올 때 영속성 컨텍스트에 데이터들이 들어간다. 임의로 만든 엔티티가 식별자를 가지고 있으면 준영속 엔티티로 간주한다.
준영속 엔티티를 수정하는 2가지 방법
1. 변경감지(Dirty Checking)
2. 병합(merge)
1. 변경감지
영속성 컨텍스트에서 엔티티를 다시 조회한 후에 데이터를 수정하는 방법이다. 트랜잭션 안에서 엔티티르 다시 조회, 변경할 값 선택 -> 트랜잭션 커밋 시점에 변경 감지가 작동해 데이터베이스에 update 쿼리가 날아간다.
2. 병합
병합의 동작 방식
1. merge()를 실행한다.
2. 파라미터로 넘어온 준영속 엔티티의 식별자 값으로 1차 캐시에서 엔티티를 조회한다. (만약 1차캐시에 엔티티가 없으면 데이터베이스에서 엔티티를 조회하고 1차캐시에 저장한다.)
3. 조회한 영속 엔티티에 새로운 값을 엔티티에 채워넣는다.
4. 영속 상태인 엔티티를 반환한다.
병합의 동작 방식은 3번 조회한 영속 엔티티에 새로운 값을 엔티티에 채워 넣을 때 모든 값을 다 바꿔서 채워 넣는다. 예를 들어서 나는 이름필드만 바꾸고 싶어서 이름만 setName으로 바꿔버리면 나머지 필드들은 전부 null로 업데이트 쿼리가 날아간다. 때문에 병합을 사용할 때에는 모든 필드를 다 변경해 줘야 한다.
*병합의 실무 설계
병합은 실무에서 사용하지 않는 것이 좋다. 왜냐하면 보통 어떤 필드를 변경할 때 필드가 10개라면 네다섯개정도 변경하는 것이 일반적인데 값을 변경할 때마다 모든 필드의 값을 전부 다 세팅해 줘야 하는 것은 유지보수측면에서 그리고 실용적인 측면에서 옳지못한 방식이 될 수 있다. 예를 들어서 실무에는 모든 테이블에 누가 수정했는지 언제 수정했는지 등의 필수적으로 들어가는 필드가 있기 마련이다. 이렇게 필수적으로 들어가있는 필드 마저도 값을 세팅해주지 않으면 null로 값이 업데이트 되기 때문에 내가 변경하고자 하는 필드만 따로 메서드로 빼서 변경하는 것이 올바른 선택이다.
타임리프기본1
본 포스트는 김영한님의 인프런강의 스프링 MVC 2편 - 백엔드 웹 개발 활용 기술을 보고 정리한 포스트입니다. 자세한 내용은 강의를 참고해주세요
*기본 객체들
타임리프는 기복 객체들을 제공한다.
1. ${#request}
2. ${#response}
3. ${#sesison}
4. ${#servletContext}
5. ${#locale}
그런데 #request는 HttpServletRequest객체가 그대로 제공되기 때문에 데이터를 조회하려면 request.getParameter("data")처럼 불편하게 접근해야 한다.
이런 점을 해결하기 위해 편의 객체도 제공한다.
HTTP요청 파라미터 접근
${param.paramData}
HTTP세션 접근
${session.sessionData}
스프링 빈 접근
${@BeanName.hello('spring!')}
*URL링크
타임리프에서 URL을 생성할 때에는 @{...}문법을 사용하면 된다.
@GetMapping("/link")
public String link(Model model) {
model.addAttribute("param1", "data1");
model.addAttribute("param2", "data2");
return "basic/link";
}
단순한 URL
@{/hello} = /hello
쿼리 파라미터
@{/hello(param1 = ${param1}, param2 = ${param2}) = /hello?param1=data1¶m2=data2
경로변수
@{/hello/{param1}/{param2}(param1 = ${param1}, param2 = ${param2})} = /hello/data1/data2
경로변수 + 쿼리 파라미터
@{/hello/{param1}(param1 = ${param1}, param2 = ${param2})} = /hello/data1?param2=data2
*리터럴
타임리프는 다음과 같은 리터럴이 있다.
1. 문자 : 'hello'
2. 숫자 : 10
3. 불린 : true, false
4. null : null
타임리프에서 문자 리터럴은 항상 작은따옴표로 감싸야 한다.
<span th:text=" 'hello' ">
그런데 문자를 항상 작은따옴표로 감싸는 것은 너무 귀찮은 일이다. 공백 없이 쭉 이어진다면 하나의 의미있는 토큰으로 인지해서 다음과 같이 작은 따옴표롤 생략할 수 있다.
룰 : A-Z, a-z, 0-9, [], .(점), -(하이폰), _(언더바)
<span th:text="hello_world">
cf) 리터럴 대체
<span th:text="|hello ${data}|">
마지막의 리터럴 대체 문법을 사용하면 마치 템플릿을 사용하는 것 처럼 편리하다.
*연산
타임리프 연산은 자바와 크게 다르지 않다. HTML안에서 사용하기 때문에 HTML 엔티티를 사용하는 부분만 주의하면 된다.
비교연산 : HTML엔티티를 사용해야 하는 부분을 주의
조건식 : 자바의 조건식과 유사하다.
Elvis 연산자 : 조건식의 편의버전
No-Operation : _(언더바)인 경우 마치 타임리프가 실행되지 않는 것처럼 동작한다. 이것을 잘 이용하면 HTML의 내용 그대로 활용할 수 있다.
<!DOCTYPE html>
<html xmlns:th="http://www.thymeleaf.org">
<head>
<meta charset="UTF-8">
<title>Title</title>
</head>
<body>
<ul>
<li>산술 연산
<ul>
<li>10 + 2 = <span th:text="10 + 2"></span></li>
<li>10 % 2 == 0 = <span th:text="10 % 2 == 0"></span></li>
</ul>
</li>
<li>비교 연산
<ul>
<li>1 > 10 = <span th:text="1 > 10"></span></li>
<li>1 gt 10 = <span th:text="1 gt 10"></span></li>
<li>1 >= 10 = <span th:text="1 >= 10"></span></li>
<li>1 ge 10 = <span th:text="1 ge 10"></span></li>
<li>1 == 10 = <span th:text="1 == 10"></span></li>
<li>1 != 10 = <span th:text="1 != 10"></span></li>
</ul>
</li>
<li>조건식
<ul>
<li>(10 % 2 == 0)? '짝수':'홀수' = <span th:text="(10 % 2 == 0)?'짝수':'홀수'"></span></li>
</ul>
</li>
<li>Elvis 연산자
<ul>
<li>${data}?: '데이터가 없습니다.' = <span th:text="${data}?: '데이터가없습니다.'"></span></li>
<li>${nullData}?: '데이터가 없습니다.' = <span th:text="${nullData}?:'데이터가 없습니다.'"></span></li>
</ul>
</li>
<li>No-Operation
<ul>
<li>${data}?: _ = <span th:text="${data}?: _">데이터가 없습니다.</
span></li>
<li>${nullData}?: _ = <span th:text="${nullData}?: _">데이터가없습니다.</span></li>
</ul>
</li>
</ul>
</body>
</html>
*속성 값 설정
타임리프는 주로 HTML태그에 th:* 속성을 지정하는 방식으로 동작한다. th:*로 속성을 적용하면 기존 속성을 대체한다. 기존 속성이 없으면 새로 만든다.
cf) checked 처리
HTML에서는 <input type="checkbox" name="active" checked="false" /> 이 경우에도 checked속성이 있기 때문에 checked처리가 되어버린다. (true, false와는 상관X)
HTML에서는 checked 속성은 checked속성의 값과 상관없이 checked라는 속성만 있어도 체크가 된다. 이런 부분이 true, false값을 주로 사용하는 개발자 입장에서는 불편하다.
타임리프의 th:checked는 값이 false인 경우 checked속성 자체를 제거한다.
th:checked="${result}" 이런식으로 사용 가능
타임리프기본2
본 포스트는 김영한님의 인프런강의 스프링 MVC 2편 - 백엔드 웹 개발 활용 기술을 보고 정리한 포스트입니다. 자세한 내용은 강의를 참고해주세요
*반복
타임리프에서 반복은 th:each를 사용한다. 추가로 반복에서 사용할 수 있는 여러 상태 값을 지원한다.
<tr th:each="user : ${users}">
반복 시 오른쪽 컬렉션 ${users}의 값을 하나씩 꺼내서 왼쪽 변수에 담아서 태그를 반복 실행한다.
th:each는 List 뿐만 아니라 배열, Iterable, Enumeration을 구현한 모든 객체를 반복에 사용할 수 있다. Map도 사용할 수 있는데 이 경우에 변수에 담기는 값은 Map.Entry이다.
반복 상태 유지 기능
-index : 0부터 시작하는 값
-count : 1부터 시작하는 값
-size : 전체 사이즈
-even, odd : 홀수, 짝수 여부
-first, last : 처음, 마지막 여부
-current : 현재 객체
*조건부 평가
타임리프의 조건식 : if, unless
타임리프는 해당 조건이 맞지 않으면 태그 자체를 랜더링하지 않는다. 만약 다음 조건이 false인 경우 <span>태그 자체가 랜더링되지 않고 사라진다
<span th:text="미성년자" th:if="${user.age lt 20}"></span>
*템플릿 조각
웹 페이지를 개발할 때는 공통 영역이 많이 있다. 예를 들어서 상단 영역이나 하단 영역, 좌측 카테고리 등등 여러 페이지에서 함께 사용하는 영역들이 있다. 이런 부분을 코드를 복사해서 사용한다면 변경시 여러 페이지를 다 수정해야 하므로 상당히 비효율적이다. 타임리프는 이런 문제를 해결하기 위해 템플릿 조각과 레이아웃 기능을 지원한다.
/template/fragment/footer.html
<!DOCTYPE html>
<html xmlns:th="http://www.thymeleaf.org"> (http://www.thymeleaf.org">)
<body>
<footer th:fragment="copy">
푸터 자리 입니다.
</footer>
<footer th:fragment="copyParam (param1, param2)">
<p>파라미터 자리 입니다.</p>
<p th:text="${param1}"></p>
<p th:text="${param2}"></p>
</footer>
</body>
</html>
/template/fragment/fragmentMain.html
<!DOCTYPE html>
<html xmlns:th="http://www.thymeleaf.org">
<head>
<meta charset="UTF-8">
<title>Title</title>
</head>
<body>
<h1>부분 포함</h1>
<h2>부분 포함 insert</h2>
<div th:insert="~{template/fragment/footer :: copy}"></div>
<h2>부분 포함 replace</h2>
<div th:replace="~{template/fragment/footer :: copy}"></div>
<h2>부분 포함 단순 표현식</h2>
<div th:replace="template/fragment/footer :: copy"></div>
<h1>파라미터 사용</h1>
<div th:replace="~{template/fragment/footer :: copyParam ('데이터1', '데이터2')}"></div>
</body>
</html>
insert = div내부에 추가한다.
replace = div태그를 대체한다.
다음과 같이 파라미터를 전달해서 동적으로 조각을 랜더링할 수도 있다.
<div th:replace="~{template/fragment/footer :: copyParam ('데이터1', '데이터2')}"></div>
타임리프심화1
본 포스트는 김영한님의 인프런강의 스프링 MVC 2편 - 백엔드 웹 개발 활용 기술을 보고 정리한 포스트입니다. 자세한 내용은 강의를 참고해주세요
*입력 폼 처리
지금부터 타임리프가 제공하는 입력 폼 기능을 적용해서 기존 프로젝트의 폼 코드를 타임리프가 지우너하는 기능을 사용해서 효율적으로 개선해보자
-th:object : 커맨드 객체를 지정한다.
-*{...} : 선택 변수 식이라고 한다. th:object에서 선택한 객체에 접근한다.
-th:field : html태그의 id, name, value 속성을 자동으로 처리해준다.
랜더링 전
<input type="text" th:field="*{itemName}"/>
랜더링 후
<input type="text" id="itemName" name="itemName" value=${item.itemName}/>
th:object를 적용하려면 먼저 해당 오브젝트 정보를 넘겨줘야한다.
@GetMapping("/add")
public String addForm(Model model) {
model.addAttribute("item", new Item());
return "form/addForm";
}
<form action="item.html" th:action th:object="${item}" method="post">
<div>
<label for="itemName">상품명</label>
<input type="text" id="itemName" th:field="*{itemName}" class="form-control" placeholder="이름을 입력하세요">
</div>
<div>
<label for="price">가격</label>
<input type="text" id="price" th:field="*{price}" class="form-control" placeholder="가격을 입력하세요">
</div>
<div>
<label for="quantity">수량</label>
<input type="text" id="quantity" th:field="*{quantity}" class="form-control" placeholder="수량을 입력하세요">
</div>
</form>
*{itemName} = ${item.itemName}
*{}(선택변수식)은 form태그 안에서 th:object가 선언되어있을 때에 한에서 사용할 수 있다.
*th:object를 활용한 체크박스(단일)
랜더링 전
<div>
<div class="form-check">
<input type="checkbox" id="open" name="open" th:field="*{open}" class="form-check-input">
<label for="open" class="form-check-label">판매 오픈</label>
</div>
</div>
랜더링 후
<div>
<div class="form-check">
<input type="checkbox" id="open" class="form-check-input" name="open" value="true">
<input type="hidden" name="_open" value="on"/>
<label for="open" class="form-check-label">판매 오픈</label>
</div>
</div>
th:field을 사용하면 id, name, value, hidden태그까지 싹 다 만들어준다. 근데 hidden태그는 왜 만들어진거지?
html에서 checkbox는 선택이 안되면 클라이언트에서 서버로 값 자체를 보내지 않는다. 체크가 됐을 때는 불린이라면 true로 반환을 해주는데 체크가 안되면 서버로 값 자체를 보내지 않기 때문에 null이 찍힌다. 이는 수정을 할때 굉장히 불편해지는데 값이 null이면 false로 바꾸고 어쩌고 하는 로직이 들어가야 하기 때문이다. 그냥 체크가 안되면 false로 해주면 안되나? 그래서 생긴것이 바로 hidden태그이다.
스프링 mvc에서는 약간의 트릭을 사용하는데 히든 필드를 하나 만들어서 _open처럼 기존 체크박스 이름 앞에 언더스코어를 붙여서 전송하면 체크를 해제했다고 인식할 수 있다. 어떻게 이를 인식하냐
1. _open=on&open=on 이렇게 둘다 전송되면 체크됐다고 판단 값을 true로 변환
2. _open=on 이렇게 하나만 전송되면 체크해제됐다고 판단 값을 false로 변환
또 타임리프에서 th:field을 사용하면 체크박스와 라디오버튼 같은 경우 th:field에 담긴 값과 th:value의 값을 비교해 자동으로 체크를 해준다.
*th:object를 활용한 체크박스(멀티)
cf) @ModelAttribute의 특별한 사용법
model에 addAttribute가 중복사용될때 사용하는 방법이다. 여러 메소드에서 model.addAttribute가 반복된다면 이 방법을 사용하면 좋다.
@ModelAttribute("regions")
public Map<String, String> regions() {
Map<String, String> regions = new LinkedHashMap<>();
regions.put("SEOUL", "서울");
regions.put("BUSAN", "부산");
regions.put("JEJU", "제주");
return regions;
}
이렇게 사용하면 컨트롤러가 실행될 때 마다 model에 객체가 담긴다. 즉 model.addAttribute("regions", regions); 이게 컨트롤러가 실행될 때마다 실행되는 것이다.
체크박스(멀티)
<div>
<div>등록 지역</div>
<div th:each="region : ${regions}" class="form-check form-check-inline">
<input type="checkbox" th:field="*{regions}" th:value="${region.key}" class="form-check-input">
<label th:for="${#ids.prev('regions')}" th:text="${region.value}" class="form-check-label">서울</label>
</div>
</div>
이렇게 사용하면 한가지 걸리는 점이 있다. th:field를 사용하여 *{regions}를 선언하는건 좋은데 th:each로 반복하게되면 name이나 value는 그렇다쳐도 id가 중복될 것 같다. 이런 경우에 어떻게할까? 타임리프에선 이런 문제를 해결하기 위해 정한 regions에 숫자를 하나씩 붙여가며 반복한다. 결론적으로 id는 regions1, regions2, regions3이렇게 되기 때문에 걱정할 필요 없다.
#ids.prev는 뭐지?
페이지를 동적으로 만들다보면 th:field처럼 랜더링 하기 전에 결정되지 않은 값이 생기기 마련이다. 위의 예제에선 id, name, value등등이 결정되지 않았다. checkbox나 radio버튼은 라벨과 묶어서 사용하는 것이 일반적인데 라벨에 있는 for속성을 checkbox의 id와 연결해줘야 하는데 id가 결정되지 않은 상태이다. 이럴 때 사용하라고 있는것이 바로 #ids.prev이다. 위의 regions에 숫자를 붙여 생기는 id를 받을 수 있게 만들어주는 코드이다.
*th:object를 활용한 라디오버튼
public enum ItemType {
BOOK("도서"), FOOD("음식"), ETC("기타");
private final String description;
ItemType(String description) {
this.description = description;
}
public String getDescription() {
return description;
}
}
@ModelAttribute("itemTypes")
public ItemType[] itemTypes() {
return ItemType.values();
}
ItemType.values()를 사용하면 해당 ENUM의 모든 정보를 배열로 반환한다.
<div>
<div>상품 종류</div>
<div th:each="type : ${itemTypes}" class="form-check form-check-inline">
<input type="radio" th:field="*{itemType}" th:value="${type.name()}" class="form-check-input">
<label th:for="${#ids.prev('itemType')}" th:text="${type.description}" class="form-check-label">
BOOK
</label>
</div>
</div>
위의 체크박스 예제와 똑같다. 다른 점은 ENUM타입을 사용했다는 점이다.
*th:object를 활용한 셀렉트 박스(콤보박스)
셀렉트 박스는 여러 선택지 중에 하나를 선택할 때 사용할 수 있다.
@ModelAttribute("deliveryCodes")
public List<DeliveryCode> deliveryCodes() {
List<DeliveryCode> deliveryCodes = new ArrayList<>();
deliveryCodes.add(new DeliveryCode("FAST", "빠른배송"));
deliveryCodes.add(new DeliveryCode("NORMAL", "일반배송"));
deliveryCodes.add(new DeliveryCode("SLOW", "느린배송"));
return deliveryCodes;
}
<div>
<div>배송 방식</div>
<select th:field="*{deliveryCode}" class="form-select">
<option value="">==배송 방식 선택==</option>
<option th:each="deliveryCode : ${deliveryCodes}" th:value="${deliveryCode.code}"
th:text="${deliveryCode.displayName}">FAST</option>
</select>
</div>
위의 예제와 다 비슷비슷하다.
스프링 메시지 / 국제화
본 포스트는 김영한님의 인프런강의 스프링 MVC 2편 - 백엔드 웹 개발 활용 기술을 보고 정리한 포스트입니다. 자세한 내용은 강의를 참고해주세요
*메시지 / 국제화
기획자가 화면에 보이는 문구가 마음에 들지 않는다고 상품명이라는 단어를 모두 상품이름으로 고쳐달라고 하면 어떻게 해야할까? 여러 화면에 보이는 상품명, 가격, 수량 등 laebl에 있는 단어를 변경하려면 다음 화면들을 다 찾아가면서 모두 변경해야한다. 이는 페이지가 많으면 많을수록 더 난감해진다. 이렇게 난감해지는 이유는 해당 html파일에 메시지가 하드코딩 되어있기 때문이다.
하드코딩이란?
데이터를 코드 내부에 직접 입력하는 것, 기술적으로는 데이터가 실행 바이너리에 합쳐져 있는 상태를 말한다. 반대말은 소프트코딩 또는 로딩이라고 한다.
하드코딩의 예시
<label for="price">가격</label>
스프링은 기본적인 메시지 관리 기능을 제공한다. 메시지 관리 기능을 사용하려면 스프링이 제공하는 MessageSource를 스프링 빈으로 등록하면 되는데 스프링부트를 사용할 경우
자동으로 스프링 빈으로 등록해주고 관리까지 해준다.
application.properties에 spring.messages.basename=messages,config.i18n.messages 이렇게 등록하면 된다. 베이스네임의 디폴트값이 messages이기 때문에 messages하나만 쓴다면 적지않아도 된다.
스프링에서 메시지 사용하기
1. application.properties에 설정등록
2. messages.properties에 메시지 등록 (메시지 등록은 key, value로 이루어져있다.)
item = 상품
item.id = 상품 ID
item.itemName = 상품명
item.price = 가격
item.quantity = 수량
3. MessageSource의 의존성 주입을 해준다.
4. ms.getMessage("item", null, null); = "상품" (첫번째 파라미터는 키에 해당하는 문자이고, 두번째 파라미터는 Argument이고, 세번째는 Locale이다.)
타임리프에서 메시지 사용하기
2번까지는 스프링에서 메시지 사용하기와 같다.
3. 타임리프에서 제공하는 메시지 표현식 #{...}을 사용하면 된다.
랜더링 전
<label for="price" th:text="#{item.price}"></label>
랜더링 후
<label for="price">가격</label>
스프링 Validation
본 포스트는 김영한님의 인프런강의 스프링 MVC 2편 - 백엔드 웹 개발 활용 기술을 보고 정리한 포스트입니다. 자세한 내용은 강의를 참고해주세요
*검증
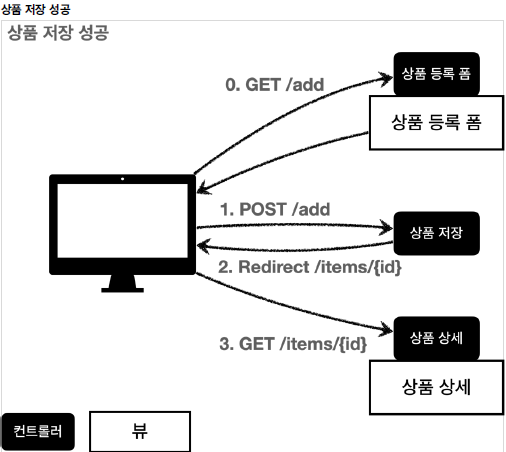
사용자가 상품 등록 폼에서 정상 범위의 데이터를 입력하면, 서버에서는 검증 로직이 통과하고, 상품을 저장하고, 상품 상세 화면으로 redirect한다.
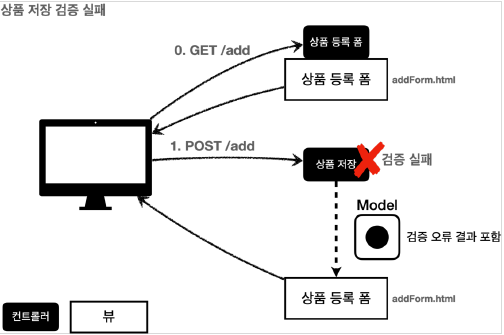
고객이 상품 등록 폼에서 상품명을 입력하지 않거나, 가격, 수량 등이 너무 작거나 커서 검증 범위를 넘어서면, 서버 검증 로직이 실패해야 한다. 이렇게 검증에 실패한 경우 고객에게 다시 상품 등록 폼을 보여주고 어떤 겂을 잘못 입력했는지 친절하게 알려줘야한다.
스프링이 제공하는 검증 오류 처리 방법으로 BindingResult가 있다. 검증오류를 담아두는 곳이라고 생각하면 편하다.
앞으로 이 BindingResult를 점진적으로 발전시켜 더 나은 코드로 바꿀 것이다.
-version1
@PostMapping("/add")
public String addItemV1(@ModelAttribute Item item, BindingResult bindingResult, RedirectAttributes redirectAttributes, Model model) {
//bindingResult는 위치가 중요한데 검증할 객체바로 뒤에 선언해야 한다. ↑Item바로 뒤에 선언한 것을 볼 수 있다.
//검증 로직
if (!StringUtils.hasText(item.getItemName())) {
bindingResult.addError(new FieldError("item", "itemName", "상품 이름은 필수입니다.")); //FieldError = 말그대로 필드에러이다.
}
if (item.getPrice() == null || item.getPrice() < 1000 || item.getPrice() > 1000000) {
bindingResult.addError(new FieldError("item", "price", "가격은 1,000 ~ 1,000,000 까지 허용합니다"));
}
if (item.getQuantity() == null || item.getQuantity() >= 9999) {
bindingResult.addError(new FieldError("item", "quantity", "수량은 최대 9999까지 허용합니다."));
}
//특정 필드가 아닌 복합 룰 검증
if (item.getPrice() != null && item.getQuantity() != null) {
int resultPrice = item.getPrice() * item.getQuantity();
if (resultPrice < 10000) {
bindingResult.addError(new ObjectError("item", "가격 * 수량의 합은 10,000원 이상이어야 합니다. 현재 값 = " + resultPrice)); //ObjectError = 글로벌에러
}
}
//검증에 실패하면 다시 입력 폼으로
if (bindingResult.hasErrors()) {
return "validation/v2/addForm";
}
//성공 로직
Item savedItem = itemRepository.save(item);
redirectAttributes.addAttribute("itemId", savedItem.getId());
redirectAttributes.addAttribute("status", true);
return "redirect:/validation/v2/items/{itemId}";
}
addError함수의 첫번째 인자로 objectName, 두번째로 field, 세번재로 defaultMessage를 입력받는다.
objectName은 검증하는 오브젝트이다(@ModelAttribute이름을 적으면 된다). 위에서 설명했듯이 bindingResult는 검증해야하는 객체 바로 뒤에 선언되기 때문에 자신이 어떤 것을 검증해야 하는지 이미 알고있다. 때문에 objectName을 직접 하드코딩 할 수도 있지만 bindingResult.getObjectName()이렇게 넣을 수도 있다.
field는 오류가 발생한 필드 이름을 적으면 된다. 타임리프로 th:field를 선언할 때 적는 필드 이름과 동일하게 적으면 타임리프에서 관리를 해준다.
defaultMessage는 오류 기본 메시지를 적으면 된다. 그럼 타임리프에서 th:field와 같은 이름을 가진 오류가 발생한다면 오류 기본 메시지를 가져와서 적어준다.
<div th:if="${#fields.hasGlobalErrors()}">
<p class="field-error" th:each="err : ${#fields.globalErrors()}" th:text="${err}">글로벌 오류 메시지지</p>
</div>
<div>
<label for="itemName" th:text="#{label.item.itemName}">상품명</label>
<input type="text" id="itemName" th:field="*{itemName}" class="form-control"
th:errorclass="field-error" placeholder="이름을 입력하세요">
<div class="field-error" th:errors="*{itemName}">
상품명 오류
</div>
</div>
#field : #field로 BindingResult가 제공하는 검증 오류에 접근할 수 있다.
th:errors : 해당 필드에 오류가 있는 경우에 태그를 출력한다. th:if의 편의 버전이다.
th:errorclass : th:field에 지정한 필드에 오류가 있으면 class정보를 추가한다.
BindingResult는 검증에 실패한 오류를 담아두는 기능 뿐만 아니라 @ModelAttribute에 바인딩되는 값이 일치하지 않을 때도 (Integer에 String이 담긴다던가) 컨트롤러를 호출해준다.
ex) @ModelAttribute에 바인딩 시 타입 오류가 발생하면?
-BindingResult가 없으면 = 400오류가 발생하면서 컨트롤러가 호출되지 않고 오류 페이지로 이동한다.
-BindingResult가 있으면 = 오류정보를 BindingResult에 담아서 컨트롤러를 정상 호출한다.
V1에서의 문제점은 사용자 입력 오류 메시지가 화면에 남도록 해야한다. 예를 들어 검증 로직이 가격을 1000원 미만으로 설정시 오류가 발생한다고 하면 가격을 100원으로 설정하면 100이라는 숫자가 그대로 사용자에게 보여져야 한다는 것이다.
이를 해결하기 위해 FieldError와 ObjecError에 대해서 더 알아본다.
@PostMapping("/add")
public String addItemV2(@ModelAttribute Item item, BindingResult bindingResult, RedirectAttributes redirectAttributes, Model model) {
//검증 로직
if (!StringUtils.hasText(item.getItemName())) {
bindingResult.addError(new FieldError("item", "itemName", item.getItemName(), false, null, null, "상품 이름은 필수입니다."));
}
if (item.getPrice() == null || item.getPrice() < 1000 || item.getPrice() > 1000000) {
bindingResult.addError(new FieldError("item", "price", item.getPrice(), false, null, null, "가격은 1,000 ~ 1,000,000 까지 허용합니다"));
}
if (item.getQuantity() == null || item.getQuantity() >= 9999) {
bindingResult.addError(new FieldError("item", "quantity", item.getQuantity(), false, null, null, "수량은 최대 9999까지 허용합니다."));
}
//특정 필드가 아닌 복합 룰 검증
if (item.getPrice() != null && item.getQuantity() != null) {
int resultPrice = item.getPrice() * item.getQuantity();
if (resultPrice < 10000) {
bindingResult.addError(new ObjectError("item", null, null, "가격 * 수량의 합은 10,000원 이상이어야 합니다. 현재 값 = " + resultPrice));
}
}
//검증에 실패하면 다시 입력 폼으로
if (bindingResult.hasErrors()) {
return "validation/v2/addForm";
}
//성공 로직
Item savedItem = itemRepository.save(item);
redirectAttributes.addAttribute("itemId", savedItem.getId());
redirectAttributes.addAttribute("status", true);
return "redirect:/validation/v2/items/{itemId}";
}
V1과 V2가 다른 점은 FieldError, ObjectError를 생성할 때 인자값을 더 많이 입력받는다는 점이다. 첫번째부터 알아보자
1. objectName : 오류가 발생한 객체 이름이다. 이는 @ModelAttribute의 객체 이름을 적어도 되고 bindingResult.getObjectName()을 입력해도 된다.
2. field : 오류 필드이다. 타임리프를 사용할 때 th:field와 같은 이름으로 설정하면 된다.
3. rejectedValue : 사용자가 입력한 값. 사용자가 100을 입력했다면 100이라는 숫자가 남게 된다. 이 자리에는 item.getPrice()를 넣으면 된다.
4. bindingFailure : 타입 오류같은 바인딩 실패인지, 검증 실패인지에 대한 구분 값이다. boolean타입이며 검증실패면 false 바인딩 실패면 true를 입력한다.
5. codes : 메시지 코드. 뒤에서 등장할 메시지를 입력하는 곳이다.
6. arguments : 메시지에서 사용하는 인자값
7. defaultMessage : 기본 오류 메시지
사용자가 입력한 값이 사용자 인터페이스에 남아있게 하고 싶으면 rejectedValue에 값을 넣어주면 된다.
앞서 FieldError, ObjectError에서 제공하는 파라미터중 codes와 arguments는 메시지를 잘 활용하기 위해서 제공하는 파라미터이다. 오류 발생시 오류 코드로 메시지를 찾기 위해서 사용된다.
error 메시지 파일을 생성하고 스프링부트에 메시지 설정을 추가해주면 메시지를 오류코드로 찾아서 뿌려줄 수 있다.
1. errors.properties를 먼저 생성한다.
2. application.properties에 spring.messages.basename=messages,errors를 추가한다.
3. errors.properties에
required.item.itemName=상품 이름은 필수입니다.
range.item.price=가격은 {0} ~ {1} 까지 허용합니다.
max.item.quantity=수량은 최대 {0} 까지 허용합니다.
totalPriceMin=가격 * 수량의 합은 {0}원 이상이어야 합니다. 현재 값 = {1}
를 추가한다.
이제 이 errors.properties를 V3로 사용해보자
@PostMapping("/add")
public String addItemV3(@ModelAttribute Item item, BindingResult bindingResult, RedirectAttributes redirectAttributes, Model model) {
//검증 오류 결과를 보관
//검증 로직
if (!StringUtils.hasText(item.getItemName())) {
bindingResult.addError(new FieldError("item", "itemName", item.getItemName(), false, new String[]{"required.item.itemName"}, null, "상품 이름은 필수입니다."));
}
if (item.getPrice() == null || item.getPrice() < 1000 || item.getPrice() > 1000000) {
bindingResult.addError(new FieldError("item", "price", item.getPrice(), false, new String[]{"range.item.price"}, new Object[]{1000, 1000000}, "가격은 1,000 ~ 1,000,000 까지 허용합니다"));
}
if (item.getQuantity() == null || item.getQuantity() >= 9999) {
bindingResult.addError(new FieldError("item", "quantity", item.getQuantity(), false, new String[]{"max.item.quantity"}, new Object[]{9999}, "수량은 최대 9999까지 허용합니다."));
}
//특정 필드가 아닌 복합 룰 검증
if (item.getPrice() != null && item.getQuantity() != null) {
int resultPrice = item.getPrice() * item.getQuantity();
if (resultPrice < 10000) {
bindingResult.addError(new ObjectError("item", new String[]{"totalPriceMin"}, new Object[]{10000, resultPrice}, "가격 * 수량의 합은 10,000원 이상이어야 합니다. 현재 값 = " + resultPrice));
}
}
//검증에 실패하면 다시 입력 폼으로
if (bindingResult.hasErrors()) {
return "validation/v2/addForm";
}
//성공 로직
Item savedItem = itemRepository.save(item);
redirectAttributes.addAttribute("itemId", savedItem.getId());
redirectAttributes.addAttribute("status", true);
return "redirect:/validation/v2/items/{itemId}";
}
rejectedValue는 String배열로, arguments는 Object배열로 입력값을 넘겨주면 된다. 이렇게 FieldError와 ObjectError를 심도있게 사용해봤는데 아무래도 사용하기엔 무리가 있다. 너무 번거롭고 복잡하다. BindingResult가 제공하는 rejectValue()를 사용하면 FieldError, ObjectError를 직접 생성하지 않고, 깔끔하게 검증 오류를 다룰 수 있다.
@PostMapping("/add")
public String addItemV4(@ModelAttribute Item item, BindingResult bindingResult, RedirectAttributes redirectAttributes, Model model) {
//검증 로직
if (!StringUtils.hasText(item.getItemName())) {
bindingResult.rejectValue("itemName", "required");
}
if (item.getPrice() == null || item.getPrice() < 1000 || item.getPrice() > 1000000) {
bindingResult.rejectValue("price", "range", new Object[]{1000, 1000000}, null);
}
if (item.getQuantity() == null || item.getQuantity() >= 9999) {
bindingResult.rejectValue("quantity", "max", new Object[]{9999}, null);
}
//특정 필드가 아닌 복합 룰 검증
if (item.getPrice() != null && item.getQuantity() != null) {
int resultPrice = item.getPrice() * item.getQuantity();
if (resultPrice < 10000) {
bindingResult.reject("totalPriceMin", new Object[]{10000, resultPrice}, null);
}
}
//검증에 실패하면 다시 입력 폼으로
if (bindingResult.hasErrors()) {
return "validation/v2/addForm";
}
//성공 로직
Item savedItem = itemRepository.save(item);
redirectAttributes.addAttribute("itemId", savedItem.getId());
redirectAttributes.addAttribute("status", true);
return "redirect:/validation/v2/items/{itemId}";
}
rejectValue()의 인자값으로 무엇을 넘기는지 알아보자
1. field : 오류 필드명
2. errorCode : 오류코드 (이 오류 코드는 메시지에 등록된 코드가 아니다. 뒤에서 설명할 messageResolver를 위한 오류코드이다.)
3. errorArgs : 오류 메시지에서 {0}를 치환하기 위한 값
4. defaultMessage : 오류 메시지를 찾을 수 없을 때 사용하는 기본 메시지
FieldError를 직접 다룰 때는 오류 코드를 required.item.itemName과 같이 모두 입력했다. 그런데 rejectValue를 사용하고부터는 오류코드를 required로 간단하게 입력했다. 그래도 오류 메시지를 잘 찾아서 출력한다. 무언가 규칙이 있는것처럼 보인다. 이 부분을 이해하려면 MessageCodesResolver를 이해해야한다.
*MessageCodesResolver
오류 코드를 만들 때는 다음과 같이 자세히 만들수도 있고 단순하게 만들수도 있다.
required.item.itemName=상품 이름은 필수입니다.
required=필수 값 입니다.
단순하게 만들면 범용성이 좋아서 여러곳에서 사용할 수 있지만, 메시지를 세밀하게 작성하기 어렵다. 반대로 너무 자세하게 만들면 범용성이 떨어진다. 가장 좋은 방법은 범용성으로 사용하다가, 세밀하게 작성해야 하는 경우에는 세밀한 내용이 적용되도록 메시지에 단계를 두는 방법이다.
MessageCodesResolver의 구현체인 DefaultMessageCodesResolver를 이용하여 errorCode, objectName, field를 넘기면 다음과 같은 규칙으로 에러코드들이 생성된다.
1. code + "." + object name + "." + field
2. code + "." + field
3. code + "." + field type
4. code
그래서 errorCode = required, objectName = item, field = itemName이렇게 세개를 넘기면
1. required.item.itemName
2. required.itemName
3. required.java.lang.String
4. required
이렇게 네개가 만들어지는 것이다.
rejectValue는 내부에서 MessageCodesResolver를 사용한다. 여기에서 메시지 코드들을 생성하는 것이었다. 그래서 rejectValue의 인자값으로 field 와 errorCode를 넣으면 저절로 오류코드를 생성해줬던 것이다. objectName은 BindingResult가 이미 알고있는 값이므로 MessageCodesResolver에 의하여 생성되는 것이었다.
딱 보면 MessageCodesResolver는 꽤나 복잡하게 돌아가는 것처럼 보인다. 이렇게 복잡하게 왜 사용하는 것일까? 모든 오류 코드에 대해서 메시지를 각각 다 정의하면 개발자 입장에서 관리하기가 너무 힘들다. 크게 중요하지 않은 메시지는 범용성있는 required와 같은 메시지로 끝내고 정말 중요한 메시지는 꼭 필요할 때 구체적으로 적어서 사용하는 방식이 더 효율적이다.
이제 메시지를 활용하여 오류코드를 다룰 수 있게 되었다. 하지만 바인딩시 타입 정보가 맞지 않을때 생기는 스프링이 자동적으로 생성해주는 오류메시지는 별로 이쁘지않다. 이 오류 내용을 사용자에게 그대로 보여줄 수는 없을것이다. 이 메시지도 이쁘게 다듬을 수 있을까?
바인딩시 타입 정보가 맞지 않을 때 스프링에서는 MessageCodesResolver를 이용하여 네가지 메시지 코드를 자동적으로 생성해준다.
1. typeMismatch.item.price
2. typeMismatch.price
3. typeMismatch.java.lang.Integer
4. typeMismatch
그렇다. 스프링은 타입 오류가 발생하면 typeMismatch라는 오류 코드를 사용해서 메시지를 뿌리고 있었던 것이었다. 그럼 errors.properties에 메시지를 추가해주면 내가 원하는 메시지를 사용자에게 보여줄 수 있을 것이다.
*Validator
지금까지의 검증은 컨트롤러 안에서 이루어졌다. 하지만 이는 객체지향적이지 않다. 하나의 메서드에서는 하나의 역할만 하게 하기 위해서 우리는 Validator라는 것을 사용할 것이다.
ItemValidator.java
@Component
public class ItemValidator implements Validator {
@Override
public boolean supports(Class<?> clazz) {
return Item.class.isAssignableFrom(clazz);
}
@Override
public void validate(Object target, Errors errors) {
Item item = (Item) target;
//검증 오류 결과를 보관
//검증 로직
if (!StringUtils.hasText(item.getItemName())) {
errors.rejectValue("itemName", "required");
}
if (item.getPrice() == null || item.getPrice() < 1000 || item.getPrice() > 1000000) {
errors.rejectValue("price", "range", new Object[]{1000, 1000000}, null);
}
if (item.getQuantity() == null || item.getQuantity() >= 9999) {
errors.rejectValue("quantity", "max", new Object[]{9999}, null);
}
//특정 필드가 아닌 복합 룰 검증
if (item.getPrice() != null && item.getQuantity() != null) {
int resultPrice = item.getPrice() * item.getQuantity();
if (resultPrice < 10000) {
errors.reject("totalPriceMin", new Object[]{10000, resultPrice}, null);
}
}
}
}
눈여겨 볼 만한 것은 바로 Validator라는 인터페이스를 implements했다는 것이다. 구현체로 supports, validate 두개를 오버라이드 하는 모습을 볼 수 있는데 supports는 Class를 인자값으로 받아와 ItemValidator가 실행될 때 validate를 실행할지 말지를 결정하는 구현체이다. 그리고 ItemValidator를 스프링빈에 컴포넌트스캔 대상으로 만들어 스프링이 관리하도록 만들어주었다.
그렇게하여 만들어진 V5를 보자
@PostMapping("/add")
public String addItemV5(@ModelAttribute Item item, BindingResult bindingResult, RedirectAttributes redirectAttributes, Model model) {
//검증 오류 결과를 보관
itemValidator.validate(item, bindingResult);
//검증에 실패하면 다시 입력 폼으로
if (bindingResult.hasErrors()) {
return "validation/v2/addForm";
}
//성공 로직
Item savedItem = itemRepository.save(item);
redirectAttributes.addAttribute("itemId", savedItem.getId());
redirectAttributes.addAttribute("status", true);
return "redirect:/validation/v2/items/{itemId}";
}
target으로 item을 Errors으로 BindingResult를 넘긴 것을 볼 수 있다. 모든 타입의 부모인 Object이기 때문에 item을 넘길 수 있고 Errors도 BindingResult의 부모이기 때문에 넘길 수 있었다.
스프링이 Validator 인터페이스를 별도로 제공하는 이유는 체계적으로 검증 기능을 도입하기 위해서이다. 그런데 V5에서는 검증기를 직접 불러서 사용했고, 이렇게 사용해도 된다. 그런데 Validator 인터페이스를 사용해서 검증기를 만들면 스프링의 추가적인 도움을 받을 수 있다.
바로 WebDataBinder를 통해서 사용하는 방법이다. WebDataBinder는 스프링의 파라미터 바인딩의 역할을 해주고 검증 기능도 내부에 포함한다. 컨트롤러에 다음 코드를 추가하자
@InitBinder
public void init(WebDataBinder dataBinder) {
dataBinder.addValidators(itemValidator);
}
이렇게 하면 @Validated 어노테이션을 사용하여 스프링의 도움을 받을 수 있다.
@PostMapping("/add")
public String addItemV6(@Validated @ModelAttribute Item item, BindingResult bindingResult, RedirectAttributes redirectAttributes, Model model) {
//검증에 실패하면 다시 입력 폼으로
if (bindingResult.hasErrors()) {
return "validation/v2/addForm";
}
//성공 로직
Item savedItem = itemRepository.save(item);
redirectAttributes.addAttribute("itemId", savedItem.getId());
redirectAttributes.addAttribute("status", true);
return "redirect:/validation/v2/items/{itemId}";
}
스프링 Bean Validation
본 포스트는 김영한님의 인프런강의 스프링 MVC 2편 - 백엔드 웹 개발 활용 기술을 보고 정리한 포스트입니다. 자세한 내용은 강의를 참고해주세요
*Bean Validation
검증 기능을 전 시간 처럼 매번 코드로 작성하는 것은 상당히 번거롭다. 특히 특정 필드에 대한 검증 로직은 대부분 빈 값이 아닌지, 특정 크기를 넘는지 아닌지와 같이 매우 일반적인 로직이다.
Bean Validation 시작하기
1. 의존관계 추가 build.gradle에 implementation 'org.springframework.boot:spring-boot-starter-validation' 를 추가한다.
2. @NotNull, @NotBlank, @NotEmpty등 어노테이션을 필드에 추가해준다.
Bean Validation 기능을 어떻게 사용하는지 코드로 알아보자
@Data
public class Item {
private Long id;
@NotBlank
private String itemName;
@NotNull
@Range(min = 1000, max = 1000000)
private Integer price;
@NotNull
@Max(9999)
private Integer quantity;
public Item() {
}
public Item(String itemName, Integer price, Integer quantity) {
this.itemName = itemName;
this.price = price;
this.quantity = quantity;
}
}
@PostMapping("/add")
public String addItem(@Validated @ModelAttribute Item item, BindingResult bindingResult, RedirectAttributes redirectAttributes, Model model) {
//검증에 실패하면 다시 입력 폼으로
if (bindingResult.hasErrors()) {
return "validation/v3/addForm";
}
//성공 로직
Item savedItem = itemRepository.save(item);
redirectAttributes.addAttribute("itemId", savedItem.getId());
redirectAttributes.addAttribute("status", true);
return "redirect:/validation/v3/items/{itemId}";
}
실행해보면 어노테이션 기반의 Bean Validation이 정상 동작하는 것을 확인할 수 있다.
스프링 MVC는 어떻게 Bean Validation을 사용할까?
스프링 부트가 spring-boot-starter-validation라이브러리를 넣으면 자동으로 Bean Validator를 인지하고 스프링에 통합한다.
스프링 부트는 자동으로 글로벌 Validator로 등록한다.
LocalValidatorFactoryBean을 글로벌 Validator로 등록한다. 이 Validator는 @NotNull같은 어노테이션을 보고 검증을 수행한다. 이렇게 글로벌 Validator가 적용되어 있기 때문에, @Valid, @Validated만 적용하면 된다. 검증 오류가 발생하면, FieldError, ObjectError를 생성해서 BindingResult에 담아준다.
검증 순서
1. @ModelAttribute 각각의 필드에 타입 변환 시도
1-1. 성공하면 2번으로
1-2. 실패하면 typeMismatch로 FieldError추가
2. Validator적용
바인딩에 성공한 필드만 Bean Validation을 적용한다. BeanValidator는 바인딩에 실패한 필드는 BeanValidation을 적용하지 않는다. 생각해보면 타입 변환에 성공해서 바인딩에 성공한 필드여야 BeanValidation 적용이 의미가 있다. (일단 모델 객체에 바인딩 받는 값이 정상으로 들어와야 검증도 의미 있다.)
Ex)
1. itemName에 문자 "A" 입력 => 타입 변환 성공 => itemName필드에 BeanValidation적용
2. price에 문자 "A" 입력 => "A"를 숫자 타입 변환 시도 실패 => typeMismatch FieldError 추가 => price필드에는 BeanValidation적용X
*Bean Validation 에러코드
Bean Validation이 기본으로 제공하는 오류 메시지를 좀 더 자세히 변경하고 싶으면 어떻게 하면 될까?
Bean Validation을 적용하고 bindingResult에 등록된 검증 오류 코드를 보면 오류 코드가 어노테이션 이름으로 등록된다. 마치 typeMismatch와 유사하다. NotBlank라는 오류 코드 기반으로 MessageCodesResolver를 통해 다양한 메시지 코드가 순서대로 생성된다.
@NotBlank
NotBlank.item.itemName
NotBlank.itemName
NotBlank.java.lang.String
NotBlank
@Range
Range.item.price
Range.price
Range.java.lang.Integer
Range
*Bean Validation 오브젝트 오류 (글로벌 오류)
Bean Validation에서 특정 필드가 아닌 해당 오브젝트 관련 오류는 어떻게 처리할 수 있을까? @ScriptAssert()를 사용하면 된다. 하지만 실제 사용해보면 제약이 많고 복잡하다. 그리고 실무에서는 검증 기능이 해당 객체의 범위를 넘어서는 경우들도 종종 등장하는데 그런 경우 대응이 어렵다.
따라서 오브젝트 오류의 경우 @ScriptAssert를 억지로 사용하는 것 보다는 다음과 같이 오브젝트 오류 관련 부분만 직접 자바코드로 작성하는 것을 권장한다.
@PostMapping("/add")
public String addItem(@Validated @ModelAttribute("item") ItemSaveForm form, BindingResult bindingResult, RedirectAttributes redirectAttributes, Model model) {
//특정 필드가 아닌 복합 룰 검증
if (form.getPrice() != null && form.getQuantity() != null) {
int resultPrice = form.getPrice() * form.getQuantity();
if (resultPrice < 10000) {
bindingResult.reject("totalPriceMin", new Object[]{10000, resultPrice}, null);
}
}
//검증에 실패하면 다시 입력 폼으로
if (bindingResult.hasErrors()) {
return "validation/v4/addForm";
}
//성공 로직
Item item = new Item();
item.setItemName(form.getItemName());
item.setPrice(form.getPrice());
item.setQuantity(form.getQuantity());
Item savedItem = itemRepository.save(item);
redirectAttributes.addAttribute("itemId", savedItem.getId());
redirectAttributes.addAttribute("status", true);
return "redirect:/validation/v4/items/{itemId}";
}
*Bean Validation의 한계
데이터를 등록할 때와 수정할 때는 요구사항이 다를 수 있다.
등록시 요구사항
1. 타입 검증
1-1. 가격, 수량에 문자가 들어가면 검증 오류 처리
2. 필드 검증
2-1. 상품명 : 필수, 공백X
2-2. 가격 : 1000원 이상 100만원 이하
2-3. 수량 : 최대 9999
3. 특정 필드의 범위를 넘어서는 검증
3-1. 가격 * 수량의 합은 10000원 이상
수정시 추가 요구사항
1. 등록시에는 quantity 수량을 최대 9999까지 등록할 수 있지만 수정시에는 수량을 무제한으로 변경할 수 있게 해줘라
2. 등록시에는 id에 값이 없어도 되지만, 수정시에는 id 값이 필수이다.
참고)
현재 구조에서는 수정시 item 의 id 값은 항상 들어있도록 로직이 구성되어 있다. 그래서 검증하지 않아도 된다고 생각할 수 있다. 그런데 HTTP 요청은 언제든지 악의적으로 변경해서 요청할 수 있으므로 서버에서 항상 검증해야 한다. 예를 들어서 HTTP 요청을 변경해서 item 의 id 값을 삭제하고 요청할 수도 있다. 따라서 최종 검증은 서버에서 진행하는 것이 안전한다.
이렇게 등록과 수정시에 요구사항이 서로 다른데 같은 객체를 사용하면 충돌이 일어난다. 수정시 id가 필수라고 해서 @NotNull을 넣어버리면 등록때 @NotNull때문에 등록자체가 안될 수 있다.
이럴 때 사용할 수 있는 방법으로 두가지 정도가 있다.
1. Bean Validation groups 기능을 사용한다.
2. Item을 직접 사용하지 않고 ItemSaveForm, ItemUpdateForm같은 폼 전송을 위한 별도의 모델 객체를 만들어서 사용한다.
groups 기능을 사용해서 등록과 수정시에 각각 다르게 검증할 수 있다. 그런데 groups기능을 사용하면 Item은 물론이고 전반적으로 복잡도가 올라간다. 사실 groups 기능은 실제 잘 사용되지 않는데 그 이유는 실무에서는 주로 다음에 등장하는 등록용 폼 객체와 수정용 폼 객체를 분리해서 사용하기 때문이다. 그렇게 하는 이유는 groups를 사용하면 등록시 폼에서 전달하는 데이터가 Item도메인 객체와 딱 맞지 않기 때문이다.
@Data
public class ItemSaveForm {
@NotBlank
private String itemName;
@NotNull
@Range(min = 1000, max = 1000000)
private Integer price;
@NotNull
@Max(9999)
private Integer quantity;
}
@Data
public class ItemUpdateForm {
@NotNull
private Long id;
@NotBlank
private String itemName;
@NotNull
@Range(min = 1000, max = 1000000)
private Integer price;
@NotNull
private Integer quantity;
}
@PostMapping("/add")
public String addItem(@Validated @ModelAttribute("item") ItemSaveForm form, BindingResult bindingResult, RedirectAttributes redirectAttributes, Model model) {
//특정 필드가 아닌 복합 룰 검증 ↑이렇게 등록시에 요구사항을 담은 폼을 모델로 받는다.
if (form.getPrice() != null && form.getQuantity() != null) {
int resultPrice = form.getPrice() * form.getQuantity();
if (resultPrice < 10000) {
bindingResult.reject("totalPriceMin", new Object[]{10000, resultPrice}, null);
}
}
//검증에 실패하면 다시 입력 폼으로
if (bindingResult.hasErrors()) {
return "validation/v4/addForm";
}
//성공 로직
Item item = new Item();
item.setItemName(form.getItemName());
item.setPrice(form.getPrice());
item.setQuantity(form.getQuantity());
Item savedItem = itemRepository.save(item);
redirectAttributes.addAttribute("itemId", savedItem.getId());
redirectAttributes.addAttribute("status", true);
return "redirect:/validation/v4/items/{itemId}";
}
스프링 필터, 인터셉터
본 포스트는 김영한님의 인프런강의 스프링 MVC 2편 - 백엔드 웹 개발 활용 기술을 보고 정리한 포스트입니다. 자세한 내용은 강의를 참고해주세요
*필터
로그인을 구현하는 경우 로그인을 하지 않으면 접근할 수 없는 페이지가 있을 것이다. 예를 들어 상품수정이나 상품등록같은 경우가 그런 경우일 것이다. 로그인을 하지 않은 사람을 거르는 로직을 컨트롤러에서 일일이 구현하려면 엄청난 하드코딩이 아닐 수 없다. 이를 해결하기 위해 서블릿에서는 필터, 스프링에서는 인터셉터를 제공한다.
필터는 애플리케이션 여러 로직에서 공통으로 관심이 있는 것을 공통 관심사라고 하는데 이런 공통 관심사를 처리하기 위해 존재한다.
*서블릿 필터 소개
필터의 흐름
HTTP 요청 -> WAS -> 필터 -> 서블릿 -> 컨트롤러
필터를 적용하면 필터가 호출 된 다음에 서블릿이 호출된다. 그래서 모든 고객의 요청 로그를 남기는 요구사항이 있다면 필터를 사용하면 된다.
필터 제한
HTTP 요청 -> WAS -> 필터 -> 서블릿 -> 컨트롤러 //로그인 사용자
HTTP 요청 -> WAS -> 필터 (서블릿 호출 X) //비 로그인 사용자
필터 체인
HTTP 요청 -> WAS -> 필터1 -> 필터2 -> 필터3 -> 서블릿 -> 컨트롤러
필터는 체인으로 구성되는데 중간에 필터를 자유롭게 추가할 수 있다. 예를 들어서 로그를 남기는 필터를 먼저 적용하고 그 다음에 로그인 여부를 체크하는 필터를 만들 수 있다.
로그 필터
LogFilter.java
@Slf4j
public class LogFilter implements Filter {
@Override
public void init(FilterConfig filterConfig) throws ServletException {
log.info("log filter init");
}
@Override
public void doFilter(ServletRequest request, ServletResponse response, FilterChain chain) throws IOException, ServletException {
log.info("log filter doFilter");
HttpServletRequest httpRequest = (HttpServletRequest) request;
String requestURI = httpRequest.getRequestURI();
String uuid = UUID.randomUUID().toString();
try {
log.info("Request [{}] [{}]", uuid, requestURI);
chain.doFilter(request, response);
} catch (Exception e) {
throw e;
} finally {
log.info("Response [{}] [{}]", uuid, requestURI);
}
}
@Override
public void destroy() {
log.info("log filter destroy");
}
-public class LogFilter implements Filter
필터를 사용하려면 필터 인터페이스를 구현해야 한다.
-doFilter(ServletRequest request, ServletResponse response, FilterChain chain)
HTTP 요청이 오면 doFilter가 호출된다.
ServletRequest는 HTTP 요청이 아닌 경우까지 고려해서 만든 인터페이스이다. HTTP를 사용하려면 HttpServletRequest로 다운케스팅 해야한다.
-String uuid = UUID.randomUUID().toString();
HTTP요청을 구분하기 위해 요청당 임의의 uuid를 생성해둔다.
-chain.doFilter(request, response)
이 부분이 가장 중요한데, 다음 필터가 있으면 필터를 호출하고 필터가 없으면 서블릿을 호출한다. 만약 이 로직을 호출하지 않으면 다음 단계로 진행되지않는다.
LoginCheckFilter.java
@Slf4j
public class LoginCheckFilter implements Filter {
private static final String[] whitelist = {"/", "/members/add", "/login", "/logout", "/css/*"};
@Override
public void doFilter(ServletRequest request, ServletResponse response, FilterChain chain) throws IOException, ServletException {
HttpServletRequest httpRequest = (HttpServletRequest) request;
String requestURI = httpRequest.getRequestURI();
HttpServletResponse httpResponse = (HttpServletResponse) response;
try {
log.info("인증 체크 필터 시작 {}", requestURI);
if (isLoginCheckPath(requestURI)) {
log.info("인증 체크 로직 실행 {}", requestURI);
HttpSession session = httpRequest.getSession(false);
if (session == null || session.getAttribute(SessionConst.LOGIN_MEMBER) == null) {
log.info("미인증 사용자 요청 {}", requestURI);
//로그인으로 redirect
httpResponse.sendRedirect("/login?redirectURL=" + requestURI);
return;
}
}
chain.doFilter(request, response);
} catch (Exception e) {
throw e;
} finally {
log.info("인증 체크 필터 종료 {}", requestURI);
}
}
/**
* 화이트 리스트의 경우 인증 체크 X
*/
private boolean isLoginCheckPath(String requestURI) {
return !PatternMatchUtils.simpleMatch(whitelist, requestURI);
}
}
-whitelist
인증 필터를 적용해도 홈, 회원가입, 로그인 화면, css같은 리소스에는 접근할 수 있어야 한다. 이렇게 화이트 리스트 경로는 인증과 무관하게 항상 허용한다. 화이트 리스트를 제외한 나머지 모든 경로에는 인증 체크 로직을 적용한다.
-isLoginCheckPath(requestURI)
화이트 리스트를 제외한 모든 경우에 인증 체크 로직을 적용한다.
-httpResponse.sendRedirect("/login?redirectURL=" + requestURI);
미인증 사용자는 로그인 화면으로 리다이렉트한다. 그런데 로그인 이후에 다시 홈으로 이동해버리면 원하는 경로를 다시 찾아가야하는 불편함이 있다. 예를 들어서 상품 관리 화면을 보려고 들어갔다가 로그인 화면으로 이동하면, 로그인 이후에 다시 상품 관리 화면으로 들어가는 것이 좋다. 이런 부분이 개발자 입장에서는 좀 귀찮을 수 있어도 사용자 입장에서 보면 편리한 기능이다. 이러한 기능을 위해 현재 요청한 경로인 requestURI를 /login에 쿼리 파라미터로 함께 전달한다. 물론 /login컨트롤러에서 로그인 성공시 해당 경로로 이동하는 기능은 추가로 개발해야 한다.
-return;
여기가 중요하다. 필터를 더는 진행하지 않게 하기 위한 로직. 이후 필터는 물론 서블릿, 컨트롤러가 더는 호출되지 않는다. 앞서 redirect를 사용했기 때문에 redirect가 응답으로 적용되고 요청이 끝난다.
WebConfig.java
@Bean
public FilterRegistrationBean logFilter() {
FilterRegistrationBean<Filter> filterRegistrationBean = new FilterRegistrationBean<>();
filterRegistrationBean.setFilter(new LogFilter());
filterRegistrationBean.setOrder(1);
filterRegistrationBean.addUrlPatterns("/*");
return filterRegistrationBean;
}
-setFilter(new LogFilter());
등록할 필터를 지정한다.
-setOrder(1);
필터는 체인으로 동작한다. 따라서 순서가 필요하다. 낮을 수록 먼저 동작한다.
-addUrlPatterns("/*");
필터를 적용할 URL패턴을 지정한다. 한번에 여러 패턴을 지정할 수 있다.
*인터셉터
스프링 인터셉터도 서블릿 필터와 같이 웹과 관련된 공통 관심 사항을 효과적으로 해결할 수 있는 기술이다. 서블릿 필터가 서블릿이 제공하는 기술이라면, 스프링 인터셉터는 스프링 MVC가 제공하는 기술이다. 둘 다 웹과 관련된 공통 관심 사항을 처리하지만, 적용되는 순서와 범위, 그리고 사용방법이 다르다.
스프링 인터셉터의 흐름
HTTP 요청 -> WAS -> 필터 -> 서블릿 -> 스프링 인터셉터 -> 컨트롤러
-스프링 인터셉터는디스패처 서블릿과 컨트롤러 사이에서 컨트롤러 호출 직전에 호출된다.
-스프링 인터셉터는 스프링 MVC가 제공하는 기능이기 때문에 결국 디스패처 서블릿 이후에 등장하게 된다. 스프링 MVC의 시작점이 디스패처 서블릿이라고 생각하면 이해하기 쉬울 것이다.
-스프링 인터셉터에도 URL패턴을 적용할 수 있는데, 서블릿 URL 패턴과는 다르고, 매우 정밀하게 설정할 수 있다.
인터셉터도 필터와 마찬가지로 제한을 둘 수 있고, 체인으로 이루어져 있어서 순서를 정할 수 있다.
public interface HandlerInterceptor {
default boolean preHandle(HttpServletRequest request, HttpServletResponse response, Object handler) throws Exception {}
default void postHandle(HttpServletRequest request, HttpServletResponse response, Object handler, @Nullable ModelAndView modelAndView) throws Exception {}
default void afterCompletion(HttpServletRequest request, HttpServletResponse response, Object handler, @Nullable Exception ex) throws Exception {}
}
서블릿 필터의 경우 단순하게 doFilter() 하나만 제공된다. 인터셉터는 컨트롤러 호출 전(preHandle), 호출 후(postHandle), 요청 완료 이후(afterCompletion)와 같이 단계적으로 잘 세분화 되어 있다.
서블릿 필터의 경우 단순히 request, response만 제공했지만 인터셉터는 어떤 컨트롤러가 호출되는지 호출 정보도 받을 수 있다. 그리고 어떤 modelAndView가 반환되는지 응답 정보도 받을 수 있다.
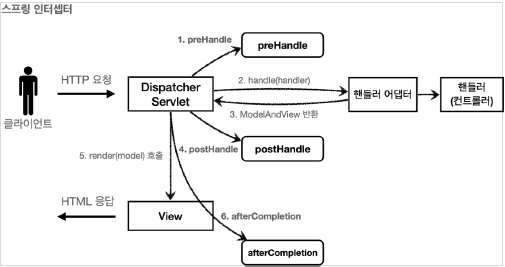
정상작동 시
preHandle : 컨트롤러 호출 전에 호출된다. preHandle의 응답값이 true이면 다음으로 진행하고, false이면 더는 진행하지 않는다. false인 경우 나머지 인터셉터는 물론이고, 핸들러 어댑터도 호출되지 않는다. 그림에서 1번에서 끝나버린다.
postHandle : 컨트롤러 호출 후에 호출된다.
afterCompletion : 뷰가 랜더링 된 이후에 호출된다.
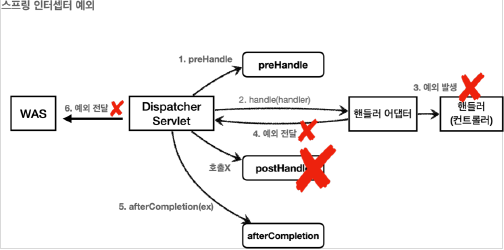
예외 발생 시
preHandle : 컨트롤러 호출 전에 호출된다.
postHandle : 컨트롤러에서 예외가 발생하면 postHandle은 호출되지 않는다.
afterCompletion : afterCompletion은 항상 호출된다. 이 경우 예외를 파라미터로 받아서 어떤 예외가 발생했는지 로그로 출력할 수 있다.
LoginIntercpetor.java
@Slf4j
public class LogInterceptor implements HandlerInterceptor {
public static final String LOG_ID = "logId";
@Override
public boolean preHandle(HttpServletRequest request, HttpServletResponse response, Object handler) throws Exception {
String requestURI = request.getRequestURI();
String uuid = UUID.randomUUID().toString();
request.setAttribute(LOG_ID, uuid);
//@RequestMapping : HandlerMethod
//정적 리소스 : ResourceHttpRequestHandler
if (handler instanceof HandlerMethod) {
HandlerMethod hm = (HandlerMethod) handler;//호출할 컨트롤러 메서드의 모든 정보가 포함되어있다.
}
log.info("Request [{}] [{}] [{}]", uuid, requestURI, handler);
return true;
}
@Override
public void postHandle(HttpServletRequest request, HttpServletResponse response, Object handler, ModelAndView modelAndView) throws Exception {
log.info("PostHandle [{}]", modelAndView);
}
@Override
public void afterCompletion(HttpServletRequest request, HttpServletResponse response, Object handler, Exception ex) throws Exception {
String requestURI = request.getRequestURI();
String logId = (String) request.getAttribute(LOG_ID);
log.info("Response [{}] [{}] [{}]", logId, requestURI, handler);
if (ex != null) {
log.error("afterCompletion error!!", ex);
}
}
}
-String uuid = UUID.randomUUID().toString()
요청 로그를 구분하기 위한 uuid를 생성하낟.
-request.setAttribute(LOG_ID, uuid);
서블릿 필터의 경우 지역변수로 해결이 가능하지만, 스프링 인터셉터는 호출 시점이 완전히 분리되어있다. 따라서 preHandle에 지정한 값을 postHandle, afterCompletion에서 함께 사용하려면 어딘가에 담아두어야 한다. LogInterceptor도 싱글톤처럼 사용되기 때문에 멤버변수를 사용하면 위험하다. 따라서 request에 담아두었다.
-return true
true면 정상호출이다. 다음 인터셉터나 컨트롤러가 호출된다.
LoginCheckInterceptor.java
@Slf4j
public class LoginCheckInterceptor implements HandlerInterceptor {
@Override
public boolean preHandle(HttpServletRequest request, HttpServletResponse response, Object handler) throws Exception {
String requestURI = request.getRequestURI();
log.info("인증 체크 인터셉터 실행 {}", requestURI);
HttpSession session = request.getSession();
if (session == null || session.getAttribute(SessionConst.LOGIN_MEMBER) == null) {
log.info("미인증 사용자 요청");
//로그인으로 redirect
response.sendRedirect("/login?redirectURL=" + requestURI);
return false;
}
return true;
}
}
WebConfig.java
public class WebConfig implements WebMvcConfigurer {
@Override
public void addInterceptors(InterceptorRegistry registry) {
registry.addInterceptor(new LogInterceptor())
.order(1)
.addPathPatterns("/**")
.excludePathPatterns("/css/**", "/*.ico", "/error");
registry.addInterceptor(new LoginCheckInterceptor())
.order(2)
.addPathPatterns("/**")
.excludePathPatterns("/", "/members/add", "/login", "logout", "/css/**", "/*.ico", "/error");
}
}
-registry.addInterceptor(new LogInterceptor())
인터셉터를 등록한다.
-order(1)
인터셉터의 호출 순서를 지정한다. 낮을 수록 먼저 호출된다.
-addPathPatterns("/**")
인터셉터를 적용할 URL패턴을 지정한다.
-excludePathPatterns("/css/**", "/*.ico", "/error", "/members/add", "/login", "/logout")
인터셉터에서 제외할 패턴을 지정한다.
그래서 결국 필터, 인터셉터 무엇을 사용하면 될까?
스프링 환경이라면 인터셉터 스프링이 없는 jsp, servlet으로만 개발한다면 필터를 사용하자
스프링 예외처리, 오류페이지
본 포스트는 김영한님의 인프런강의 스프링 MVC 2편 - 백엔드 웹 개발 활용 기술을 보고 정리한 포스트입니다. 자세한 내용은 강의를 참고해주세요.
*예외처리, 오류페이지
고객이 웹페이지를 이용함에 있어서 예외가 발생하거나 오류가 발생할 때를 대비해 오류페이지를 커스텀하여 만들면 좋은데 스프링부트가 제공하는 기본 오류페이지는 디자인적으로나 가독성면에서 좋지못하다. 그렇기 때문에 개발자는 고객을 위한 오류페이지를 따로 만들어야 한다.
웹 애플리케이션은 사용자 요청별로 별도의 쓰레드가 할당되고, 서블릿 컨테이너 안에서 실행된다. 애플리케이션에서 예외가 발생했는데, 어디선가 try-catch로 예외를 잡아서 처리하면 아무런 문제가 없다. 그런데 만약 애플리케이션에서 예외를 잡지 못하고, 서블릿 밖으로 까지 예외가 전달되면 어떻게 동작할까?
WAS -> 필터 -> 서블릿 -> 인터셉터 -> 컨트롤러(예외발생) -> 인터셉터 -> 서블릿 -> 필터 -> WAS(여기까지 전파)
결국 톰캣 같은 WAS까지 예외가 전달된다. WAS는 예외가 올라오면 어떻게 처리해야 할까?
@GetMapping("/error-ex")
public void errorEx() {
throw new RuntimeException("예외 발생!");
}
위의 예제를 실행해보면 tomcat이 기본으로 제공하는 오류화면을 볼 수 있다.
오류가 발생했을 때 HttpServletResponse가 제공하는 sendError라는 메서드를 사용해도 된다. 이것을 호출한다고 당장 예외가 발생하는 것은 아니지만, 서블릿 컨테이너에게 오류가 발생했다는 점을 전달할 수 있다.
@GetMapping("/error-404")
public void error404(HttpServletResponse response) throws IOException {
response.sendError(404, "404오류!");
}
@GetMapping("/error-500")
public void error500(HttpServletResponse response) throws IOException {
response.sendError(500, "500오류!");
}
response.sendError를 호출하면 response 내부에는 오류가 발생했다는 상태를 저장해둔다. 그리고 서블릿 컨테이너는 고객에게 응답 전에 response에 sendError가 호출되었는지를 확인한다. 그리고 호출되었다면 설정한 오류 코드에 맞추어 기본 오류 페이지를 보여준다.
*서블릿 예외처리-오류화면 제공
서블릿 컨테이너가 제공하는 기본 예외 처리 화면은 고객 친화적이지 않다. 서블릿이 제공하는 오류 화면 기능을 사용해보자.
서블릿은 예외가 발생해서 서블릿 밖으로 전달되거나 또는 response.sendError가 호출되었을 때 각각의 상황에 맞춘 오류 처리 기능을 제공한다.
@Component
public class WebServerCustomizer implements WebServerFactoryCustomizer<ConfigurableWebServerFactory> {
@Override
public void customize(ConfigurableWebServerFactory factory) {
ErrorPage errorPage404 = new ErrorPage(HttpStatus.NOT_FOUND, "/error-page/404");
ErrorPage errorPage500 = new ErrorPage(HttpStatus.INTERNAL_SERVER_ERROR, "/error-page/500");
ErrorPage errorPageEx = new ErrorPage(RuntimeException.class, "/error-page/500");
factory.addErrorPages(errorPage404, errorPage500, errorPageEx);
}
}
오류가 발생햇을 때 처리할 수 있는 컨트롤러가 필요하다. 예를 들어서 RuntimeException 예외가 발생하면 errorPageEx에서 지정한 /error-page/500이 호출된다.
@Slf4j
@Controller
public class ErrorPageController {
@RequestMapping("/error-page/404")
public String errorPage404(HttpServletRequest request, HttpServletResponse response) {
log.info("errorPage 404");
return "error-page/404";
}
@RequestMapping("/error-page/500")
public String errorPage500(HttpServletRequest request, HttpServletResponse response) {
log.info("errorPage 500");
return "error-page/500";
}
}
*서블릿 예외처리 - 오류페이지 작동 원리
서블릿은 Exception이 발생해서 서블릿 밖으로 전달되거나 또는 response가 호출되었을 때 설정된 오류 페이지를 찾는다.
서블릿 밖으로 전달된 예외 혹은 오류가 WAS에서 해당 예외를 처리하는 오류 페이지 정보를 확인한다.
예를 들어서 RuntimeException예외가 WAS까지 전달되면 WAS는 오류 페이지 정보를 확인한다. 확인해보니 RuntimeException의 오류페이지로 /error-page/500이 지정되어 있다. WAS는 오류 페이지를 출력하기 위해 /error-page/500을 다시 요청한다.
그럼 오류 페이지 요청 흐름은 다음과 같다
WAS -> 필터 -> 서블릿 -> 인터셉터 -> 컨트롤러(예외 발생) -> 인터셉터 -> 서블릿 -> 필터 -> WAS (/error-page/500 다시요청) -> 필터 -> 서블릿 -> 인터셉터 -> 컨트롤러 -> View
오류가 발생하면 오류 페이지를 출력하기 위해 WAS내부에서 다시 한번 호출이 발생한다. 이때 필터, 서블릿, 인터셉터도 모두 다시 호출된다. 그런데 로그인 인증 체크 같은 경우를 생각해보면, 이미 한번 필터나 인터셉터에서 로그인 체크를 완료했다. 따라서 서버 내부에서 오류 페이지를 호출한다고 해서 해당 필터나 인터셉터가 한번 더 호출되는 것은 매우 비효율적이다.
결국 클라이언트로부터 발생한 정상요청인지, 아니면 오류페이지를 출력하기 위한 내부 요청인지 구분할 수 있어야 한다. 서블릿은 이런 문제를 해결하기 위해 DispatcherType이라는 추가 정보를 제공한다.
고객이 처음 요청하면 dispatcherType=REQUEST이다. 이렇듯 서블릿 스펙은 실제 고객이 요청한 것인지 서버가 내부에서 오류 페이지를 요청하는 것인지 DsipatcherType으로 구분할 수 있는 방법을 제공한다.
필터를 등록할 때 setDispatcherType메소드를 적어주면 디폴트값이 DispatcherType.REQUEST이기 때문에 DispatcherType.ERROR로 요청하는 것은 걸러지게 된다.
인터셉터는 excludePathPatterns에 오류페이지를 호출하는 url을 추가해주기만 하면 된다.
그렇게 되면 오류페이지의 요청 흐름은 이렇게 바뀐다.
원래 : WAS -> 필터 -> 서블릿 -> 인터셉터 -> 컨트롤러(예외 발생) -> 인터셉터 -> 서블릿 -> 필터 -> WAS (/error-page/500 다시요청) -> 필터 -> 서블릿 -> 인터셉터 -> 컨트롤러 -> View
개선 : WAS -> 필터 -> 서블릿 -> 인터셉터 -> 컨트롤러(예외 발생) -> 인터셉터 -> 서블릿 -> 필터 -> WAS(오류 페이지 확인) -> 필터(X) -> 서블릿 -> 인터셉터(X) -> View
이렇듯 필터와 인터셉터를 거치지 않고 곧바로 View를 호출한다.
위의 방법은 스프링부트를 전혀 사용하지 않고 쓰는 방법이다. 그렇다면 스프링 부트는 어떻게 이 문제를 해결할까?
*예외처리 오류페이지 - 스프링부트
지금까지 예외 처리 페이지를 만들기 위해서 다음과 같은 복잡한 과정을 거쳤다.
1. WebServerCustomizer (오류 등록)
2. 예외 종류에 따라서 ErrorPage를 추가
3. 예외 처리용 컨트롤러를 만듦
스프링 부트는 이런 과정을 모두 기본으로 제공한다.
ErrorPage를 자동 등록하고, /error라는 경로로 기본 오류 페이지를 설정한다. 또한 컨트롤러 또한 자동으로 등록되어 개발자가 아주 편하게 개발할 수 있도록 자동화를 완료했다.
그럼 이제 스프링 부트를 이용하여 오류페이지를 커스텀 해보자
1. resources에 templates혹은 static폴더에 error라는 디렉토리를 만든다.
2. 스프링 부트에서 제공하는 규칙에 따라 html파일을 만든다. (404.html, 5xx.html)
예를 들어 페이지가 존재하지 않다면 404.html을 호출한다. 404.html이 없다면 4xx.html이 호출된다. 4xx.html마저도 없으면 error.html이 호출된다. error.html도 없으면 스프링 부트가 제공하는 기본 오류 페이지인 whitelabel을 보여준다.
스프링 API 예외처리
본 포스트는 김영한님의 인프런강의 스프링 MVC 2편 - 백엔드 웹 개발 활용 기술을 보고 정리한 포스트입니다. 자세한 내용은 강의를 참고해주세요.
*API 예외처리
HTML 페이지의 경우 4xx, 5xx처럼 오류 페이지만 있으면 대부분의 문제를 해결할 수 있었다. 그런데 API의 경우에는 생각할 내용이 더 많다. 오류 페이지는 단순히 고객에게 오류 화면을 보여주고 끝이지만, API는 각 오류 상황에 맞는 오류 응답 스펙을 정하고 json으로 데이터를 내려줘야 한다.
지금부터 API의 경우 어떻게 에외 처리를 하면 좋은지 알아보자. APi도 오류페이지에서 설명했던 것처럼 처음으로 돌아가서 서블릿 오류 페이지로 방식을 사용해보자
@Component
public class WebServerCustomizer implements WebServerFactoryCustomizer<ConfigurableWebServerFactory> {
@Override
public void customize(ConfigurableWebServerFactory factory) {
ErrorPage errorPage404 = new ErrorPage(HttpStatus.NOT_FOUND, "/error-page/404");
ErrorPage errorPage500 = new ErrorPage(HttpStatus.INTERNAL_SERVER_ERROR, "/error-page/500");
ErrorPage errorPageEx = new ErrorPage(RuntimeException.class, "/error-page/500");
factory.addErrorPages(errorPage404, errorPage500, errorPageEx);
}
}
@Slf4j
@RestController
public class ApiExceptionV2Controller {
@GetMapping("/api2/members/{id}")
public ApiExceptionController.MemberDto getMember(@PathVariable("id") String id) {
if (id.equals("ex")) {
throw new RuntimeException("잘못된 사용자");
}
if (id.equals("bad")) {
throw new IllegalArgumentException("잘못된 입력 값");
}
if (id.equals("user-ex")) {
throw new UserException("사용자 오류");
}
return new ApiExceptionController.MemberDto(id, "hello " + id);
}
@Data
@AllArgsConstructor
static class MemberDto {
private String memberId;
private String name;
}
}
API를 요청했는데, 정상의 경우 API로 json형식으로 데이터가 정상 반환된다. 그런데 오류가 발생하면 우리가 미리 만들어둔 오류 페이지 HTML이 반환된다. 이는 기대하는 바가 아니다. 클라이언트는 정상 요청이든, 오류 요청이던 json이 반환되기를 기대한다.
문제를 해결하려면 오류 페이지 컨트롤러도 json응답을 할 수 있도록 수정해야 한다.
@RequestMapping(value = "/error-page/500", produces = MediaType.APPLICATION_JSON_VALUE)
public ResponseEntity<Map<String, Object>> errorPage500Api(HttpServletRequest request, HttpServletResponse response) {
log.info("API errorPage 500");
Map<String, Object> result = new HashMap<>();
Exception ex = (Exception) request.getAttribute(ERROR_EXCEPTION);
result.put("status", request.getAttribute(ERROR_STATUS_CODE));
result.put("message", ex.getMessage());
Integer statusCode = (Integer) request.getAttribute(RequestDispatcher.ERROR_STATUS_CODE);
return new ResponseEntity<>(result, HttpStatus.valueOf(statusCode));
}
produces = MediaType.APPLICATION_JSON_VALUE의 뜻은 클라이언트가 요청하는 HTTP header의 Accept의 값이 application/json일 때 해당 메서드가 호출된다는 것이다. 결국 클라이언트가 받고 싶은 미디어타입이 json이면 이 컨트롤러의 메서드가 호출된다.
응답 데이터를 위해서 Map을 만들고 status, message 키에 값을 할당했다. Jackson 라이브러리는 Map을 json구조로 변환할 수 있다.
ResponseEntity를 사용해서 응답하기 때문에 메시지 컨버터가 동작하면서 클라이언트에 json이 반환된다.
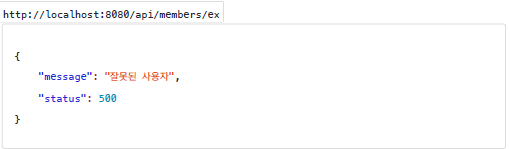
*API 예외 처리 - 스프링 부트 기본 오류 처리
API 예외 처리도 스프링 부트가 제공하는 기본 오류 방식을 사용할 수 있다. 스프링 부트가 제공하는 BasicErrorController를 사용하면 된다. WebServerCustomizer에서 컴포넌트 스캔에 등록했던 것을 주석처리하고 에러를 강제로 띄우면 자동으로 예외처리가 된다.
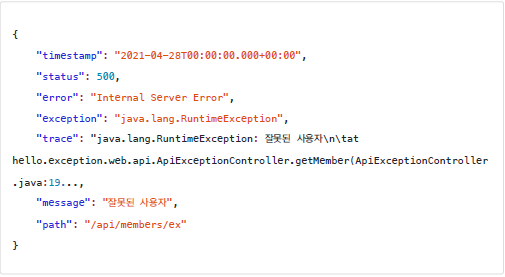
BasicErrorController 를 확장하면 JSON 메시지도 변경할 수 있다. 그런데 API 오류는 조금 뒤에 설명할 @ExceptionHandler 가 제공하는 기능을 사용하는 것이 더 나은 방법이므로 지금은 BasicErrorController 를 확장해서 JSON 오류 메시지를 변경할 수 있다 정도로만 이해해두자.
스프링 부트가 제공하는 BasicErrorController는 HTML 페이지를 제공하는 경우에는 매우 편리하다. 그런데 API 오류 처리는 다른 차원의 이야기이다. API마다 각각의 컨트롤러나 예외마다 서로 다른 응답 결과를 출력해야 할 수도 있다. 예를 들어서 회원과 관련된 API에서 예외가 발생할 때 응답과, 상품과 관련된 API에서 발생하는 예외에 따라 그 결과가 달라질 수 있다. 결과적으로 매우 세밀하고 복잡하다. 따라서 이 방법은 HTML 화면을 처리할 때 사용하고 API의 오류처리는 뒤에서 설명할 @ExceptionHandler를 사용하자
그렇다면 복잡한 API오류는 어떻게 처리해야하는지 지금부터 하나씩 알아보자
*API 예외 처리 - HandlerExceptionResolver의 시작
예외가 발생해서 서블릿을 넘어 WAS까지 예외가 전달되면 HTTP 상태코드가 500으로 처리된다. 발생하는 예외에 따라서 400, 404등 다른 상태코드로 처리하고 싶을 때가 있을 것이다.
예를 들어 IllegalArgumentException을 처리하지 못해서 컨트롤러 밖으로 넘어가는 일이 발생하면 HTTP 상태코드를 400으로 처리하고 싶다. 어떻게 해야할까?
스프링 MVC는 컨트롤러 박으로 예외가 던져진 경우 예외를 해결하고, 동작을 새로 정의할 수 있는 방법을 제공한다. 컨트롤러 밖으로 던져진 예외를 해결하고 동작 방식을 변경하고 싶으면 HandlerExceptionResolver를 사용하면 된다. 줄여서 ExceptionResolver라고 한다.
ExceptionResolver 적용 전
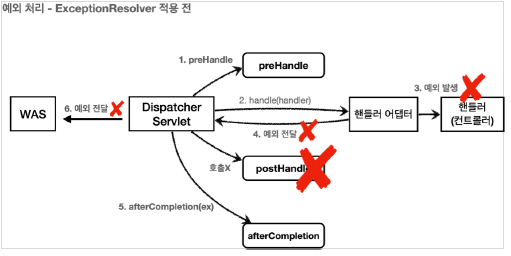
ExceptionResolver 적용 후
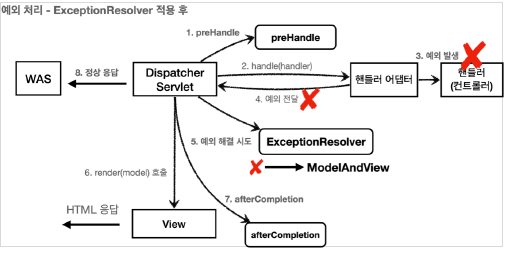
@Slf4j
public class MyHandlerExceptionResolver implements HandlerExceptionResolver {
@Override
public ModelAndView resolveException(HttpServletRequest request, HttpServletResponse response, Object handler, Exception ex) {
try {
if (ex instanceof IllegalArgumentException) {
log.info("IllegalArgumentException resolver to 400");
response.sendError(HttpServletResponse.SC_BAD_REQUEST, ex.getMessage());
return new ModelAndView();
}
} catch (IOException e) {
log.error("resolver ex", e);
e.printStackTrace();
}
return null;
}
}
ExceptionResolver가 ModelAndView를 반환하는 이유는 마치 try-catch를 하듯이, Exception을 처리해서 정상 흐름 처럼 변경하는 것이 목적이다.
여기서는 IllegalArgumentException이 발생하면 response.sendError(400)을 호출해서 HTTP 상태 코드를 400으로 지정하고 빈 ModelAndView를 반환한다.
ModelAndView의 반환 값에 따른 동작 방식은 다음과 같다.
1. 빈 ModelAndView : new ModelAndView() 처럼 빈 ModelAndView를 반환하면 뷰를 랜더링하지 않고 정상 흐름으로 서블릿이 리턴된다.
2. ModelAndView 지정 : ModelAndView에 View, Model등의 정보를 지정해서 반환하면 뷰를 랜더링한다.
3. null : null을 반환하면 다음 ExceptionResolver를 찾아서 실행한다. 만약 처리할 수 있는 ExceptionResolver가 없으면 예외처리가 안되고, 기존에 발생한 예외를 서블릿 밖으로 던진다.
WebConfig에 등록
@Configuration
public class WebConfig implements WebMvcConfigurer {
@Override
public void extendHandlerExceptionResolvers(List<HandlerExceptionResolver> resolvers) {
resolvers.add(new MyHandlerExceptionResolver());
}
}
*API 예외 처리 - handlerExceptionResolver 활용
-예외를 여기서 마무리하기
예외가 발생하면 WAS까지 예외가 던져지고, WAS에서 오류 페이지 정보를 찾아서 다시 /error를 호출하는 과정은 생각해보면 너무 복잡하다. ExceptionResolver를 활용하면 예외가 발생했을 때 이런 복잡한 과정 없이 여기에서 문제를 깔끔하게 해결할 수 있다.
먼저 사용자 정의 예외를 하나 추가하자
public class UserException extends RuntimeException{
public UserException() {
super();
}
public UserException(String message) {
super(message);
}
public UserException(String message, Throwable cause) {
super(message, cause);
}
public UserException(Throwable cause) {
super(cause);
}
protected UserException(String message, Throwable cause, boolean enableSuppression, boolean writableStackTrace) {
super(message, cause, enableSuppression, writableStackTrace);
}
}
이제 이 예외를 처리하는 UserHandlerExceptionResolver를 만들어보자
@Slf4j
public class UserHandlerExceptionResolver implements HandlerExceptionResolver {
private final ObjectMapper objectMapper = new ObjectMapper();
@Override
public ModelAndView resolveException(HttpServletRequest request, HttpServletResponse response, Object handler, Exception ex) {
try {
if (ex instanceof UserException) {
log.info("UserException resolver to 400");
String acceptHeader = request.getHeader("accept");
response.setStatus(HttpServletResponse.SC_BAD_REQUEST);
if ("application/json".equals(acceptHeader)) {
Map<String, Object> errorResult = new HashMap<>();
errorResult.put("ex", ex.getClass());
errorResult.put("message", ex.getMessage());
String result = objectMapper.writeValueAsString(errorResult);
response.setContentType("application/json");
response.setCharacterEncoding("utf-8");
response.getWriter().write(result);
return new ModelAndView();
} else {
//text/html
return new ModelAndView("error/500");
}
}
} catch (IOException e) {
log.error("resolver ex", e);
}
return null;
}
}
HTTP 요청 헤더의 Accept값이 application/json이면 json으로 오류를 내려주고, 그 외 경우에는 error/500에 있는 HTML 오류 페이지를 보여준다.
포스트맨으로 http://localhost:8080/api/members/user-ex를 실행해보면 다음과 같은 오류를 볼 수 있다.
ExceptionResolver를 사용하면 컨트롤러에서 예외가 발생해도 ExceptionResolver에서 예외를 처리해버린다. 따라서 예외가 발생해도 서블릿 컨테이너까지 예외가 전달되지 않고, 스프링 MVC에서 예외 처리는 끝이 난다. 결과적으로 WAS 입장에서는 정상 처리가 된 것이다. 이렇게 예외를 이곳에서 모두 처리할 수 있다는 것이 핵심이다.
하지만 직접 Resolver를 구현하려니 상당히 복잡하다. 지금부터 스프링이 제공하는 ExceptionResolver들을 알아보자
*API 예외 처리 - 스프링이 제공하는 ExceptionResolver
스프링 부트가 기본으로 제공하는 ExceptionResolver는 다음과 같다.
1. ExceptionHandlerExceptionResolver
2. ResponseStatusExceptionResolver
3. DefaultHandlerExceptionREsolver
우선순위는 1번부터 차례대로이다.
-ExceptionHandlerExceptionResolver
@ExceptionHandler를 처리한다. API 예외 처리는 대부분 이 기능으로 해결한다. 조금 뒤에 자세히 설명한다.
-ResponseStatusExceptionResolver
HTTP 상태 코드를 지정해준다.
ex) @ResponseStatus(value = HttpStatus.NOT_FOUND)
-DefaultHandlerExceptionREsolver
스프링 내부 기본 예외를 처리한다.
*API 예외 처리 - @ExceptionHandler
HTML 화면 오류 vs API 오류
우베 브라우저에 HTML 화면을 제공할 때는 오류가 발생하면 BasicErrorController를 사용하는게 편하다. 이때는 단순히 5xx, 4xx 관련된 오류 화면을 보여준면 된다. BasicErrorController는 이런 매커니즘을 모두 구현해 두었다.
그런데 API는 각 시스템마다 응답의 모양도 다르고, 스펙도 모두 다르다. 예외 상황에 단순히 오류 화면을 보여주는 것이 아니라 예외에 따라서 각각 다른 데이터를 출력해야 할 수도 있다. 그리고 같은 예외라고 해도 어떤 컨트롤러에서 발생했는가에 따라서 다른 예외 응답을 내려주어야 한다. 한마디로 매우 세밀한 제어가 필요하다.
앞서 이야기했지만, 예를 들어서 상품 API와 주문 API는 오류가 발생했을 때 응답의 모양이 완전히 다를 수 있다.
결국 지금까지 살펴본 BasicErrorController를 사용하거나 HandlerExceptionResolver를 직접 구현하는 방식으로 API 예외를 다루기는 쉽지 않다.
API예외 처리의 어려운 점
1. HandlerExceptionResolver를 떠올려 보면 ModelAndView를 반환해야 했다. 이것은 API응답에는 필요하지 않다.
2. API 응답을 위해서 HttpServletResponse에 직접 응답 데이터를 넣어주었다. 이것은 매우 불편하다. 스프링 컨트롤러에 비유하면 마치 과거 서블릿을 사용하던시절로 돌아간 것 같다.
3. 특정 컨트롤러에서만 발생하는 예외를 별도로 처리하기 어렵다. 예를 들어서 회원을 처리하는 컨트롤러에서 발생하는 RuntimException 예외와 상품을 관리하는 컨트롤러에서 발생하는 동일한 RuntimException예외를 서로 다른 방식으로 처리하고 싶다면 어떻게 해야할까?
@ExceptionHandler
스프링은 API 예외 처리 문제를 해결하기 위해 @ExceptionHandler라는 어노테이션을 사용하는 매우 편리하는 예외 처리 기능을 제공하는데 이것이 바로 ExceptionHandlerExceptionResolver 이다. 스프링은 ExceptionHandlerExceptionResolver를 기본으로 제공하고, 기본으로 제공하는 ExceptionResolver 중에 우선순위도 가장 높다. 실무에서 API 예외 처리는 대부분 이 기능을 사용한다.
먼저 예외가 발생했을 때 API 응답으로 사용하는 객체를 정의해야한다.
@Data
@AllArgsConstructor
public class ErrorResult {
private String code;
private String message;
}
@ExceptionHandler 예외 처리 방법
@ExceptionHandler 어노테이션을 선언하고, 해당 컨트롤러에서 처리하고 싶은 예외를 지정해주면 된다. 해당 컨트롤러에서 예외가 발생하면 이 메서드가 호출된다. 참고로 지정한 예외 또는 그 예외의 자식 클래스는 모두 잡을 수 있다.
@ResponseStatus(HttpStatus.BAD_REQUEST)
@ExceptionHandler(IllegalArgumentException.class)
public ErrorResult illegalExHandler(IllegalArgumentException e) {
log.error("[exceptionHandler] ex", e);
return new ErrorResult("BAD", e.getMessage());
}
@ExceptionHandler를 사용해서 예외를 깔끔하게 처리할 수 있게 되었지만, 정상 코드와 예외 처리 코드가 하나의 컨트롤러 안에 섞여있다. @ControllerAdvice 또는 @RestControllerAdvice를 사용하면 둘을 분리할 수 있다.
@Slf4j
@RestControllerAdvice
public class ExControllerAdvice {
@ResponseStatus(HttpStatus.BAD_REQUEST)
@ExceptionHandler(IllegalArgumentException.class)
public ErrorResult illegalExHandler(IllegalArgumentException e) {
log.error("[exceptionHandler] ex", e);
return new ErrorResult("BAD", e.getMessage());
}
}
@ControllerAdvice
-@ControllerAdvice는 대상으로 지정한 여러 컨트롤러에 @ExceptionHandler, @InitBinder 기능을 부여해주는 역할을 한다.
-@ControllerAdvice에 대상을 지정하지 않으면 모든 컨트롤러에 적용된다. (글로벌 적용)
-@RestControllerAdvice는 @ControllerAdvice와 같고 @ResponseBody가 추가되어있다.
대상 컨트롤러 지정 방법
@ControllerAdvice(annotations = RestController.class)
public class ExampleAdvice1 {}
@ControllerAdvice(basePackages = {"org.example.controllers"})
public class ExampleAdvice2 {}
@ControllerAdvice(assignableTypes = {ControllerInterface.class, AbstractController.class})
public class ExampleAdvice3 {}
스프링 타입컨버터
본 포스트는 김영한님의 인프런강의 스프링 MVC 2편 - 백엔드 웹 개발 활용 기술을 보고 정리한 포스트입니다. 자세한 내용은 강의를 참고해주세요.
*스프링 타입 컨버터
문자를 숫자로 변환하거나, 반대로 숫자를 문자로 변환해야 하는 것 처럼 애플리케이션을 개발하다 보면 타입을 변환해야 하는 경우가 상당히 많다.
스프링을 사용하지 않는다면 보통의 경우 WrapperClass의 valueOf (String.valueOf, Integer.valueOf 등등) 메소드를 사용하거나 WrapperClass의 pasrseSomething (parseInt, parseDouble 등등) 메소드를 사용하는 것이 대부분일 것이다. 하지만 이렇게 일일이 타입을 변환해주는 것은 매우 번거로운 일이다. 혹은 단순히 타입 변환이 아니라 객체 -> 객체 변환을 사용하고 싶을 때가 있을 것이다. 이 때 사용하는 것이 바로 스프링의 타입 컨버터이다.
앞으로 소개하는 타입 컨버터는 밑바닥부터 천천히 풀어내는 내용이 담겨있다. 따라서 점진적으로 발전하는 코드를 볼 수 있을 것이다.
스프링은 확장 가능한 컨버터 인터페이스를 제공한다. 개발자는 스프링에 추가적인 타입 변환이 필요하면 이 컨버터 인터페이스를 구현해서 등록하면 된다. 이 컨버터 인터페이스는 모든 타입에 적용할 수 있다. 필요하면 X -> Y타입으로 변환하는 컨버터 인터페이스를 만들고 또 Y -> X 타입으로 변환하는 컨버터 인터페이스를 만들어서 등록하면 된다. 예를 들어서 문자로 "true"가 왔을 때 Boolean타입으로 받고 싶으면 String -> Boolean타입으로 변환되도록 컨버터 인터페이스를 만들어서 등록하면 된다.
*타입 컨버터 - Converter
타입 컨버터를 어떻게 사용하는지 코드로 알아보자
타입 컨버터를 사용하려면 org.springframework.core.convert.converter.Converter 인터페이스를 구현하면 된다.
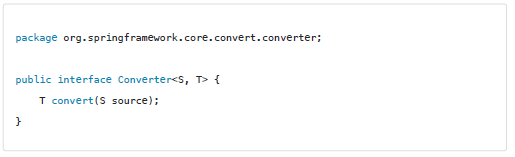
먼저 가장 단순한 형태인 문자를 숫자로 바꾸는 타입 컨버터를 만들어보자
@Slf4j
public class StringToIntegerConverter implements Converter<String, Integer> {
@Override
public Integer convert(String source) {
log.info("convert source={}", source);
return Integer.valueOf(source);
}
}
Converter의 제네릭에 들어가는 <S, T> 는 S타입의 소스가 T타입으로 변환되는 것을 의미한다. 위의 예제에서는 String 타입이 Integer타입으로 변환되는 것을 의미한다.
String -> Integer로 변환하기 때문에 소스가 String이 된다. 이 문자를 Integer.valueOf(source)를 사용해서 숫자로 변경한 다음에 변경된 숫자르 반환하면 된다.
위의 예제를 토대로 반대의 경우도 만들 수 있을 것이다.
@Slf4j
public class IntegerToStringConverter implements Converter<Integer, String> {
@Override
public String convert(Integer source) {
log.info("convert source={}", source);
return String.valueOf(source);
}
}
이런 단순한 타입 변환 말고 객체를 또다른 객체로 변환하는 사용자 정의 타입 컨버터에 대해서 알아보자
127.0.0.1:8080과 같은 IP와 Port를 입력하면 IP, Port 둘로 나눠지게 되는 컨버터를 만들어보자
@Getter
@EqualsAndHashCode
public class IpPort {
private String ip;
private int port;
public IpPort(String ip, int port) {
this.ip = ip;
this.port = port;
}
}
cf) @EqualsAndHashCode는 모든 필드를 사용해서 equals()와 hashcode()를 생성한다. 따라서 모든 필드의 값이 같다면 a.equals(b)의 결과가 참이 된다.
@Slf4j
public class StringToIpPortConverter implements Converter<String, IpPort> {
@Override
public IpPort convert(String source) {
log.info("convert source={}", source);
//"127.0.0.1:8080" -> IP = "127.0.0.1", Port = 8080
String[] split = source.split(":");
String ip = split[0];
int port = Integer.parseInt(split[1]);
return new IpPort(ip, port);
}
}
위의 예제는 String 타입으로 "127.0.0.1:8080"이 들어오게 되면 IpPort객체로 바뀌게 되는 컨버터이다.
위의 예제를 토대로 반대의 경우도 만들 수 있을 것이다.
@Slf4j
public class IpPortToStringConverter implements Converter<IpPort, String> {
@Override
public String convert(IpPort source) {
log.info("convert source={}", source);
return source.getIp() + ":" + source.getPort();
}
}
위의 예제를 테스트해볼 테스트 코드를 작성해보자
@Test
void StringToIpPort() {
IpPortToStringConverter converter = new IpPortToStringConverter();
IpPort source = new IpPort("127.0.0.1", 8080);
String result = converter.convert(source);
assertThat(result).isEqualTo("127.0.0.1:8080");
}
@Test
void IpPortToString() {
StringToIpPortConverter converter = new StringToIpPortConverter();
String source = "127.0.0.1:8080";
IpPort result = converter.convert(source);
assertThat(result).isEqualTo(new IpPort("127.0.0.1", 8080));
}
잘 동작하는 것을 볼 수 있다. 그런데 이렇게 타입 컨버터를 하나하나 직접 사용하면, 개발자가 직접 컨버팅 하는 것과 크게 차이가 없다. 타입 컨버터를 등록하고 관리하면서 편리하게 변환 기능을 제공하는 역할을 하는 무언가가 필요하다.
*컨버전 서비스 - ConversionService
이렇게 타입 컨버터를 하나하나 직접 찾아서 타입 변환에 사용하는 것이 매우 불편하다. 그래서 스프링은 개별 컨버터를 모두 모아두고 그것들을 묶어서 편리하게 사용할 수 있는 기능을 제공하는데, 이것이 바로 컨버전 서비스이다.
@Test
void ConversionService() {
//등록
DefaultConversionService conversionService = new DefaultConversionService();
conversionService.addConverter(new StringToIntegerConverter());
conversionService.addConverter(new IntegerToStringConverter());
conversionService.addConverter(new StringToIpPortConverter());
conversionService.addConverter(new IpPortToStringConverter());
//사용
assertThat(conversionService.convert("10", Integer.class)).isEqualTo(10);
assertThat(conversionService.convert(10, String.class)).isEqualTo("10");
assertThat(conversionService.convert("127.0.0.1:8080", IpPort.class)).isEqualTo(new IpPort("127.0.0.1", 8080));
assertThat(conversionService.convert(new IpPort("127.0.0.1", 8080), String.class)).isEqualTo("127.0.0.1:8080");
}
DefaultConversionService는 conversionService 인터페이스를 구현햇는데, 추가로 컨버터를 등록하는 기능도 제공한다.
컨버터를 등록할 때는 StringToIntegerConverter같은 타입 컨버터를 명확하게 알아야한다. 반면에 컨버터를 사용하는 입장에서는 타입 컨버터를 전혀 몰라도 된다. 타입 컨버터들은 모두 컨버전 서비스 내부에 숨어서 제공된다. 따라서 타입을 변환하는 원하는 사용자는 컨버전 서비스 인터페이스에만 의존하면 된다. 물론 컨버전 서비스를 등록하는 부분과 사용하는 부분을 분리하고 의존관계 주입을 사용해야 한다.
*스프링에 Converter 적용하기
웹 애플리케이션에 Converter를 적용해보자
@Configuration
public class WebConfig implements WebMvcConfigurer {
@Override
public void addFormatters(FormatterRegistry registry) {
registry.addConverter(new StringToIntegerConverter());
registry.addConverter(new IntegerToStringConverter());
registry.addConverter(new StringToIpPortConverter());
registry.addConverter(new IpPortToStringConverter());
}
}
스프링은 내부에서 ConversionService를 제공한다. 우리는 WebMvcConfigurer가 제공하는 addFormatters() 를 사용해서 추가하고 싶은 컨버터를 등록하면 된다. 이렇게 하면 스프링은 내부에서 사용하는 ConversionService에 컨버터를 추가해준다.
이제 잘 작동하는지 테스트 해보자
@GetMapping("/hello-v2")
public String helloV2(@RequestParam Integer data) {
System.out.println("data = " + data);
return "ok";
}
?data=10 의 쿼리 파라미터는 문자이고 이것을 Integer data로 변환하는 과정이 필요하다. 실행해보면 직접 등록한 StringToIntegerConverter가 작동하는 로그를 확인할 수 있다.
그런데 생각해보면 StringToIntegerConverter를 등록하기 전에도 이 코드는 잘 수행되었다. 그것은 스프링이 내부에서 수 많은 기본 컨버터들을 제공하기 때문이다. 컨버터를 추가하면 추가한 컨버터가 기본 컨버터보다 높은 우선순위를 가진다.
이번에는 직접 정의한 타입인 IpPort를 사용해보자
@GetMapping("/ip-port")
public String ipPort(@RequestParam IpPort ipPort) {
System.out.println("ipPort IP = " + ipPort.getIp());
System.out.println("ipPort Port = " + ipPort.getPort());
return "ok";
}
실행
http://localhost:8080/ip-port?ipPort=127.0.0.1:8080
실행로그
*뷰 템플릿에 컨버터 적용하기
이번에는 뷰 템플릿에 컨버터를 적용하는 방법을 알아보자. 타임리프는 랜더링 시에 컨버터를 적용해서 랜더링하는 방법을 편리하게 지원한다. 이전까지는 문자를 객체로 변환했다면, 이번에는 그 반대로 객체를 문자로 변환하는 작업을 확인할 수 있다.
@GetMapping("/converter-view")
public String converterView(Model model) {
model.addAttribute("number", 10000);
model.addAttribute("ipPort", new IpPort("127.0.0.1", 8080));
return "converter-view";
}
<!DOCTYPE html>
<html xmlns:th="http://www.thymeleaf.org">
<head>
<meta charset="UTF-8">
<title>Title</title>
</head>
<body>
<ul>
<li>${number}: <span th:text="${number}" ></span></li>
<li>${{number}}: <span th:text="${{number}}" ></span></li>
<li>${ipPort}: <span th:text="${ipPort}" ></span></li>
<li>${{ipPort}}: <span th:text="${{ipPort}}" ></span></li>
</ul>
</body>
</html>
타임리프는 ${{...}}를 사용하면 자동으로 컨버전 서비스를 사용해서 변환된 결과를 출력해준다. 물론 스프링과 통합 되어서 스프링이 제공하는 컨버전 서비스를 사용하므로 우리가 등록한 컨버터들을 사용할 수 있다.
변수 표현식 : ${...}
컨버전 서비스 적용 : ${{...}}
${{number}} : 뷰 템플릿은 데이터를 문자로 출력한다. 따라서 컨버터를 적용하게 되면 Integer타입인 10000을 String타입으로 변환하는 컨버터인 IntegerToStringConverter를 실행하게 된다. 이 부분은 컨버터를 실행하지 않아도 타임리프가 숫자를 문자로 자동으로 변환하기 때문에 컨버터를 적용할때와 하지 않을 때가 같다.
${{ipPort}} : 뷰 템플릿은 데이터를 문자로 출력한다. 따라서 컨버터를 적용하게 되면 IpPort타입을 String타입으로 변환해야 하므로 IpPortToStringConverter가 적용된다. 그 결과 127.0.0.1:8080가 출력된다.
*포맷터 - Formatter
Converter는 입력과 출력 타입에 제한이 없는 범용 타입 변환 기능을 제공한다. 이번에는 일반적인 웹 애플리케이션 환경을 생각해보자. 불린 타입을 숫자로 바꾸는 것 같은 범용 기능 보다는 개발자 입장에서는 문자를 다른 타입으로 변환하거나, 다른 타입을 문자로 변환하는 상황이 더 일반적이다. 앞서 살펴본 예제들은 떠올려 보면 문자를 다른 객체로 변환하거나 객체를 문자로 변환하는 일이 대부분이다.
-웹 애플리케이션에서 객체를 문자로, 문자를 객체로 변환하는 예
1. 화면에 숫자를 출력해야 하는데, Integer -> String 출력 시점에 숫자 1000 -> 문자 "1,000" 이렇게 1000단위에 쉼포를 넣어서 출력하거나 또는 "1,000"이라는 문자를 1000이라는 숫자로 변경해야 한다.
2. 날짜 객체를 문자인 "2021-01-01 10:50:11" 와 같이 출력하거나 또는 그 반대의 상황
이렇게 객체를 특정한 포맷에 맞추어 문자를 출력하거나 또는 그 반대의 역할을 하는 것에 특화된 기능이 바로 포맷터이다. 포맷터는 컨버터의 특별한 버전으로 이해하면 된다.
Converter vs Formatter
Converter : 범용 (객체 -> 객체)
Formatter : 문자에 특화 (문자 -> 객체, 객체 -> 문자)
포맷터 만들기
포맷터는 객체를 문자로 변경하고, 문자를 객체로 변경하는두 가지 기능을 모두 수행한다.
Formatter 인터페이스
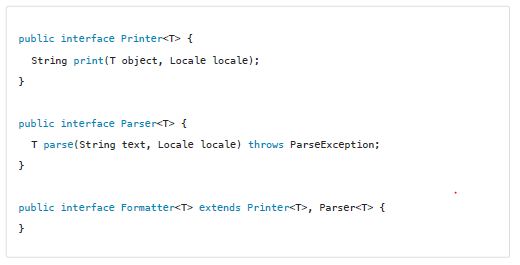
숫자 1000을 문자 "1,000"으로 그러니까 1000단위로 쉼표가 들어가는 포맷을 적용해보자. 그리고 그 반대도 처리해주는 포맷터를 만들어보자
@Slf4j
public class MyNumberFormatter implements Formatter<Number> {
@Override
public Number parse(String text, Locale locale) throws ParseException {
log.info("text={}, locale={}", text, locale);
//"1,000" -> 1000
NumberFormat format = NumberFormat.getInstance(locale);
return format.parse(text);
}
@Override
public String print(Number object, Locale locale) {
log.info("object={}, locale={}", object, locale);
return NumberFormat.getInstance(locale).format(object);
}
}
"1,000" 처럼 숫자 중간의 쉼표를 적용하려면 자바가 기본으로 제공하는 NumberFormat 객체를 사용하면 된다. 이 객체는 Locale 정보를 활용해서 나라별로 다른 숫자 포맷을 만들어준다.
parse() 를 사용해서 문자를 숫자로 변환한다. 참고로 Number 타입은 Integer , Long 과 같은 숫자 타입의 부모 클래스이다.
*포맷터를 지원하는 컨버전 서비스
컨버전 서비스에는 컨버터만 등록할 수 있고, 포맷터를 등록할 수는 없다. 그런데 생각해보면 포맷터는 객체 -> 문자, 문자 -> 객체로 변환하는 특별한 컨버터일 뿐이다.
포맷터를 지우너하는 컨버전 서비스를 사용하면 컨버전 서비스에 포맷터를 추가할 수 있다. 내부에서 어댑터 패턴을 사용해서 Formatter가 Converter처럼 동작하도록 지원한다.
웹 애플리케이션에 포맷터 적용하기
@Configuration
public class WebConfig implements WebMvcConfigurer {
@Override
public void addFormatters(FormatterRegistry registry) {
// registry.addConverter(new StringToIntegerConverter());
// registry.addConverter(new IntegerToStringConverter());
registry.addConverter(new StringToIpPortConverter());
registry.addConverter(new IpPortToStringConverter());
//추가
registry.addFormatter(new MyNumberFormatter());
}
}
주의!
StringToIntegerConverter, IntegerToStringConverter를 꼭 주석처리 하자. MyNumberFormatter도 숫자 -> 문자, 문자 -> 숫자로 변경하기 때문에 둘의 기능이 겹친다. 우선순위는 컨버터가 우선하므로 포맷터가 적용되지 않고 컨버터가 적용된다.
실행해보면 잘 실행되는 것을 볼 수 있다.
이제 다음으로 스프링이 제공하는 기본 포맷터를 알아보자
*스프링이 제공하는 기본 포맷터
스프링은 자바에서 기본으로 제공하는 타입들에 대해 수 많은 포맷터를 기본으로 제공한다. IDE에서 Formatter인터페이스의 구현 클래스를 찾아보면 수 많은 날짜나 시간 관련 포맷터가 제공되는 것을 확인할 수 있다.
그런데 포맷터는 기본 형식이 지정되어 있기 때문에, 객체의 각 필드마다 다른 형식으로 포맷을 지정하기는 어렵다.
@NumberFormat : 숫자 관련 형식 지정 포맷터 사용
@DtateTimeFormat : 날짜 관련 형식 지정 포맷터 사용
예제를 통해 확인해보자
@Controller
public class FormatterController {
@GetMapping("/formatter/edit")
public String formatterForm(Model model) {
Form form = new Form();
form.setNumber(10000);
form.setLocalDateTime(LocalDateTime.now());
model.addAttribute("form", form);
return "formatter-form";
}
@PostMapping("/formatter/edit")
public String formatterEdit(@ModelAttribute Form form) {
return "formatter-view";
}
@Data
static class Form {
@NumberFormat(pattern = "###,###")
private Integer number;
@DateTimeFormat(pattern = "yyyy-MM-dd HH:mm:ss")
private LocalDateTime localDateTime;
}
}
실행해보면 지정한 포맷으로 출력된 것을 확인할 수 있다.
타임리프 classappend
타임리프를 사용하면서 동적으로 클래스를 추가해주고싶은 경우가 있을 것이다. 예를 들어 값이 1이면 클래스를 추가하고 2면 클래스를 추가하고 이런식으로 말이다.
그럴 때 타임리프에선 classappend라는 기능을 제공한다.
<a th:classappend="${notice} == 1 ? 'notice'">공지사항</a>
위의 예제는 notice의 값이 1이면 notice라는 클래스를 추가하는 문법이다.
나의 경우 공지사항을 상단에 노출시키고 노출시킨 공지사항만 색을 칠해주고 싶었다.
이와 같은 문법으로 th:errorclass 라는 문법도 존재한다. errorclass 는 BindingResult 값으로 에러가 넘어오면 클래스를 추가해주는 문법이다. 자세한 내용은 아래의 게시글을 참고하자
https://coding-review.tistory.com/72
객체지향 설계 5원칙 SOLID
*객체지향 설계 SOLID
1. SRP (Single Responsibility Principle) : 단일 책임 원칙
-한 클래스는 하나의 책임만 가져야 한다.
-하지만 하나의 책임이라는 것은 모호하다.
--클 수도 있고, 작을 수도 있다.
--문맥과 상황에 따라 다르다.
-중요한 기준은 변경이다. 변경이 있을 때 파급 효과가 적으면 단일 책임 원칙을 잘 따른 것
2. OCP (Open / Closed Principle) : 개방-폐쇄 원칙
-소프트웨어 요소는 확장에는 열려 있으나, 변경에는 닫혀 있어야 한다.
-이런 거짓말 같은 말이? 확장을 하려면 당연히 기존 코드를 변경해야 하는것이 아닌가?
-다형성을 활용해보면 된다.
-인터페이스를 구현한 새로운 클래스를 하나 만들어서 새로운 기능을 구현한다.
3. LSP (Liskov Substitution Principle) : 리스코프 치환 원칙
-프로그램의 객체는 프로그램의 정확성을 깨뜨리지 않으면서 하위 타입의 인스턴스로 바꿀 수 있어야 한다.
-다형성에서 하위 클래스는 인터페이스 규약을 다 지켜야 한다는 것, 다형성을 지원하기 위한 원칙, 인터페이스를 구현한 구현체는 믿고 사용하려면 이 원칙이 필요하다.
-단순히 컴파일에 성공하는 것을 넘어서는 이야기
-ex) 자동차 인터페이스의 엑셀은 앞으로 가라는 기능, 뒤로 가게 구현하면 LSP 위반, 느리더라도 앞으로 가야함
4. ISP (Interface Segregation Principle) : 인터페이스 분리 원칙
-특정 클라이언트를 위한 인터페이스 여러 개가 범용 인터페이스 하나보다 낫다.
-자동차 인터페이스 -> 운전 인터페이스, 정비 인터페이스로 분리
-사용자 클라이언트 -> 운전자 클라이언트, 정비사 클라이언트로 분리
-분리하면 정비 인터페이스 자체가 변해도 운전자 클라이언트에 영향을 주지 않음
-인터페이스가 명확해지고 대체 가능성이 높아진다.
5. DIP (Dependency Inversion Principle) : 의존관계 역전 원칙
-프로그래머는 "추상화에 의존해야지, 구체화에 의존하면 안된다." 의존성 주입은 이 원칙을 따르는 방법 중 하나이다.
-쉽게 이야기해서 구현 클래스에 의존하지 말고, 인터페이스에 의존하라는 뜻
-앞에서 이야기한 역할에 의존하게 해야 한다는 것과 같다. 객체 세상도 클라이언트가 인터페이스에 의존해야 유연하게 구현체를 변경할 수 있다. 구현체에 의존하게 되면 변경이 아주 어려워진다.
순수한 자바로 DI 구현하기
이 포스팅은 인프런 김영한님의 스프링 핵심 원리 기본편을 보고 각색한 포스팅입니다. 자세한 내용은 강의를 확인해주세요
코드에 들어가기 전 이 코드의 배경이 되는 스토리가 있는데
사장님이 할인 정책을 구상하는데 VIP에게 정액할인제를 할지 정률할인제를 할지 고민하는 상황이다. 사장님이 할인 정책에 대해서는 중요한 사항이므로 런칭하기 바로 직전까지 생각하다 적용할 예정이다. 기획자는 일단 둘 다 만들어 놓고 우선 정액할인제를 적용한 상태로 개발에 착수하라는 지령이 떨어졌다.
우리의 개발자는 언제 할인 정책이 바뀔지 모르는 상황에서 개발에 착수해야 하며 런칭 바로 직전에 할인정책이 바뀔수도 있는 상황이다.
Member.java
public class Member {
private Long id;
private String name;
private Grade grade;
public Member(Long id, String name, Grade grade) {
this.id = id;
this.name = name;
this.grade = grade;
}
public Long getId() {
return id;
}
public void setId(Long id) {
this.id = id;
}
public String getName() {
return name;
}
public void setName(String name) {
this.name = name;
}
public Grade getGrade() {
return grade;
}
public void setGrade(Grade grade) {
this.grade = grade;
}
}
Member 클래스를 만들고 우선 할인 정책을 두개 만들어 놔야 한다.
public interface DiscountPolicy {
/**
* @return 할인 대상 금액
*/
int discount(Member member, int price);
}
public class FixDiscountPolicy implements DiscountPolicy{
private int discountFixAmount = 1000; //1000원 할인
@Override
public int discount(Member member, int price) {
if (member.getGrade() == Grade.VIP) {
return discountFixAmount;
}
else {
return 0;
}
}
}
public class RateDiscountPolicy implements DiscountPolicy{
private int discountPercent = 10;
@Override
public int discount(Member member, int price) {
if (member.getGrade() == Grade.VIP) {
return price * discountPercent / 100;
}
else {
return 0;
}
}
}
정액할인정책 (FixDiscountPolicy) 정률할인정책 (RateDiscountPolicy) 이렇게 두개를 만들었다. 언제 바뀔지 모르기 때문에 다형성을 이용한 개발을 완료했다. Member를 인자값으로 받아와서 Grade에 따라 할인을 할지 안할지를 결정하는 코드이다.
이제 주문 관련 코드를 만들어보자
public class Order {
private Long memberId;
private String itemName;
private int itemPrice;
private int discountPrice;
public Order(Long memberId, String itemName, int itemPrice, int discountPrice) {
this.memberId = memberId;
this.itemName = itemName;
this.itemPrice = itemPrice;
this.discountPrice = discountPrice;
}
public int calculatePrice() {
return itemPrice - discountPrice;
}
public Long getMemberId() {
return memberId;
}
public void setMemberId(Long memberId) {
this.memberId = memberId;
}
public String getItemName() {
return itemName;
}
public void setItemName(String itemName) {
this.itemName = itemName;
}
public int getItemPrice() {
return itemPrice;
}
public void setItemPrice(int itemPrice) {
this.itemPrice = itemPrice;
}
public int getDiscountPrice() {
return discountPrice;
}
public void setDiscountPrice(int discountPrice) {
this.discountPrice = discountPrice;
}
}
public interface OrderService {
Order createOrder(Long memberId, String itemName, int itemPrice);
}
public class OrderServiceImpl implements OrderService{
private final MemberRepository memberRepository = new MemoryMemberRepository();
private final DiscountPolicy discountPolicy = new FixDiscountPolicy();
@Override
public Order createOrder(Long memberId, String itemName, int itemPrice) {
Member member = memberRepository.findById(memberId);
int discountPrice = discountPolicy.discount(member, itemPrice);
return new Order(memberId, itemName, itemPrice, discountPrice);
}
}
이제 모든 준비가 완료되었다. 우리는 다형성을 이용해 개발했기 때문에 언제든지 정책이 바뀌면 그에 걸맞는 코드로 갈아끼울 수 있게 되었다.
자 이제 런칭일이 다가오고 있다. 우리는 기획자의 말대로 정액할인정책에 초점을 둔 상태로 개발에 착수했다. 이때 사장님이 정액할인정책말고 더 고객친화적인 정률할인정책을 펼치겠다고 선언하셨다.
하지만 우린 이미 다형성을 이용해 개발을 완료했다.
private final DiscountPolicy discountPolicy = new FixDiscountPolicy()
이 부분을
private final DiscountPolicy discountPolicy = new RateDiscountPolicy();
이렇게 바꿔주기만 하면 된다.
하지만 여기서 문제가 발생했다. 바로 객체지향의 5가지 원칙 SOLID중 SRP (단일 책임 원칙), OCP (개발 폐쇄 원칙), DIP (의존관계 역전 원칙) 을 지킬 수 없게 된것이다.
https://coding-review.tistory.com/81
하나씩 살펴보자
1. SRP 위반
SRP에 대해 간단하게 정리하면 하나의 클래스는 하나의 책임만 가져야 한다는 원칙이다. 위의 코드에서 SRP가 위배된 부분은 바로 OrderServiceImpl 구현체는 Order 관련된 책임만을 가지고 있어야 하는데 할인정책까지 직접 선택해야하는 책임이 새로 부여된 것이다.
2. OCP 위반
OCP에 대해 간단하게 정리하면 소프트웨어 요소는 확장에는 열려 있으나, 변경에는 닫혀 있어야 한다는 원칙이다. 이는 즉 무슨말이냐하면 지금 정액할인정책에서 정률할인정책으로 서비스를 확장해야하는 상황에서 서비스는 확장하되 코드의 변경은 없어야 한다는 의미이다. 우리는 DiscountPolicy를 Fix -> Rate로 변경했다. 이는 OCP의 위반이라고 볼 수 있다.
3. DIP 위반
DIP에 대해 간단하게 정리하면 프로그래머는 추상화에 의존해야지 구체화에 의존하면 안된다는 원칙이다. 즉 역할 (인터페이스) 과 구현 (구현체) 중 역할만 알고있어야 한다는 의미이다. 얼핏 보면 역할에 의존하는 것 같이 보이지만 구현도 알고있다.
private final DiscountPolicy(역할) discountPolicy = new RateDiscountPolicy()(구현);
이 세개를 위반하지 않게 하려면 코드를 어떻게 리팩토링 해야할까? 바로 이렇게 바꾸면 된다.
private DiscountPolicy discountPolicy;
엥? 이렇게 바꾸면 된다고? 인터페이스만 선언하고 구현체는 선언하지 않지 않았는가 이러면 분명 NullPointerException이 터질게 분명하다.
물론 저렇게 바꾸기만 하면 당연히 NullPointerException이 터진다. 추가적으로 코드를 작성해주어야 한다.
우리는 앞서 책임에 대해서 이야기한 적이 있다. 바로 SRP를 얘기할 때이다. 위의 코드가 오류가 나지 않게 하려면 새로운 책임을 부여해주면 된다. 바로 애플리케이션의 전체 동작 방식을 구성(config)하기 위해, 구현 객체를 생성하고, 연결하는 책임을 가지는 별도의 설정 클래스를 만들면 된다.
AppConfig.java
public class AppConfig {
public MemberService memberService() {
return new MemberServiceImpl(new MemoryMemberRepository());
}
public OrderService orderService() {
return new OrderServiceImpl(new MemoryMemberRepository(), new FixDiscountPolicy(););
}
}
이렇게 동작 방식을 구성하기 위한 클래스를 새로 만들어주었다. 그럼 기존의 코드는 어떻게 변경되어야 할까?
public class OrderServiceImpl implements OrderService{
private final MemberRepository memberRepository;
private final DiscountPolicy discountPolicy;
public OrderServiceImpl(MemberRepository memberRepository, DiscountPolicy discountPolicy) {
this.memberRepository = memberRepository;
this.discountPolicy = discountPolicy;
}
@Override
public Order createOrder(Long memberId, String itemName, int itemPrice) {
Member member = memberRepository.findById(memberId);
int discountPrice = discountPolicy.discount(member, itemPrice);
return new Order(memberId, itemName, itemPrice, discountPrice);
}
}
생성자를 통해 이 OrderServiceImpl 클래스가 생성될 때 AppConfig에서는 해당하는 내용을 주입해준다. 이를 생성자 주입이라고 표현한다.
이렇게 하면 SRP, OCP, DIP를 위반하지 않고 코드를 작성할 수 있다.
SRP : OrderServiceImpl은 Order 관련된 책임만을 가지고 있고, AppConfig는 애플리케이션 동작을 총괄하는 책임을 가지고있다.
OCP : 서비스가 확장했음에도 코드의 변경이 일어나지 않았다.
DIP : 코드에서 나와있듯이 추상화에만 의존할 뿐 구체화에 의존하고 있지 않다.
한가지 아쉬운 점이 있다면 AppConfig에서의 코드 중복이다. 살짝 리팩토링을 해준다면 다음과 같이 깔끔하게 바뀔 것이다.
public class AppConfig {
public MemberService memberService() {
return new MemberServiceImpl(memberRepository());
}
public OrderService orderService() {
return new OrderServiceImpl(memberRepository(), discountPolicy());
}
private MemoryMemberRepository memberRepository() {
return new MemoryMemberRepository();
}
public DiscountPolicy discountPolicy() {
// return new FixDiscountPolicy();
return new RateDiscountPolicy();
}
}
만약 할인정책이 정액할인정책에서 정률할인정책으로 바뀐다면 어떻게 하면 될까? 앞으로는 AppConfig에서 DiscountPolicy 부분을 바꿔주기만 하면 된다.
이렇게 객체지향을 잘 준수하면서 사용하기 용이한 서비스가 완성되었다.
*포스팅 후기
이번에 종강을 맞이해서 무엇을 공부할까 고민하다가 이전에 들었던 스프링 강의와 JPA강의를 전부 2회독 하기로 결심했는데 이 강의를 처음 들었던 약 4개월 전에 나와 비교했을 때 지금의 내가 많이 성장했다는 느낌을 받았다. 이 강의를 처음 들었을 때는 인터페이스도 처음 써보고 Repository, Service, Controller 구조도 처음 봤다. 하지만 지금은 이런 구조가 익숙하고 처음 들을때와 다르게 이해도 잘 되는것 같았다. 이 포스팅을 시작으로 모든 강의를 듣고 포스팅을 남길 생각이다. 나와 함께 성장해나갈 블로그를 잘 지켜봐주셨으면 좋겠다.
스프링을 사용해서 DI 구현하기
이 포스팅은 인프런 김영한 님의 스프링 핵심 원리 기본 편을 보고 각색한 포스팅입니다. 자세한 내용은 강의를 확인해주세요
순수한 자바를 이용해서 DI를 구현해봤다.
https://coding-review.tistory.com/82
이번에는 스프링을 이용해서 DI를 구현해보자
이전의 AppConfig를 다음과 같이 변경하면 된다.
@Configuration
public class AppConfig {
@Bean
public MemberService memberService() {
return new MemberServiceImpl(memberRepository());
}
@Bean
public OrderService orderService() {
return new OrderServiceImpl(memberRepository(), discountPolicy());
}
@Bean
public MemoryMemberRepository memberRepository() {
return new MemoryMemberRepository();
}
@Bean
public DiscountPolicy discountPolicy() {
// return new FixDiscountPolicy();
return new RateDiscountPolicy();
}
}
AppConfig에 설정을 구성한다는 뜻의 @Configuration 을 붙여준다.
각 메서드에 @Bean 을 붙여준다. 이렇게 하면 스프링 컨테이너에 스프링 빈으로 등록한다.
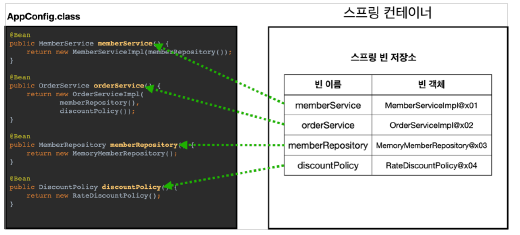
스프링 컨테이너에는 빈이름과 빈객체가 key, value로 저장되고 스프링은 스프링 빈 저장소에 있는 빈객체를 사용자가 호출하면 언제든지 사용할 수 있게 준비해놓는다.
이제 이 빈들을 사용해보자
public class MemberApp {
public static void main(String[] args) {
// AppConfig appConfig = new AppConfig();
// MemberService memberService = appConfig.memberService();
// OrderService orderService = appConfig.orderService();
// MemberService memberService = new MemberServiceImpl();
// OrderService orderService = new OrderServiceImpl();
ApplicationContext applicationContext = new AnnotationConfigApplicationContext(AppConfig.class);
MemberService memberService = applicationContext.getBean("memberService", MemberService.class);
OrderService orderService = applicationContext.getBean("orderService", OrderService.class);
Long memberId = 1L;
Member member = new Member(memberId, "memberA", Grade.VIP);
memberService.join(member);
Order order = orderService.createOrder(memberId, "itemA", 10000);
System.out.println("order = " + order);
}
}
AnnotationConfigApplicationContext는 ApplicationContext인터페이스의 구현 체중 하나이고 말 그대로 어노테이션을 기반으로 Config 즉 설정 정보를 가져오겠다는 말이다. 파라미터로 class정보를 넘겨서 해당 클래스에 @Bean을 찾아 스프링 빈으로 등록하겠다는 의미이기도 하다.
이후 getBean메서드를 이용하여 첫번째 파라미터로 빈 이름 두 번째 파라미터로 클래스 정보를 넘겨서 빈을 꺼내서 사용하면 된다.
관례상 빈 이름은 AppConfig에서 메서드 이름을 따른다.
코드가 전보다 더 복잡해진것 같은데 ApplicationContext 즉 스프링 컨테이너에 스프링 빈을 등록했을 때 장점이 있을까?
애플리케이션을 개발할 때는 빈은 관리하고 조회하는 기능은 물론이고, 수 많은 부가기능이 필요하다.
부가기능으로는 메시지소스를 활용한 국제화 기능이 있다. 예를 들어서 한국에서 들어오면 한국어로, 영어권에서 들어오면 영어로 출력해주는 기능이다.
또 환경변수를 관리해주는 기능이 있는데 로컬환경, 개발환경, 운영환경을 구분해서 관리해주는 기능이다.
애플리케이션 이벤트를 발행하고 구독하는 모델을 편리하게 지원도 해준다.
편리한 리소스를 조회해 파일, 클래스패스, 외부 등에서 리소스를 편리하게 조회할 수도 있다.
이외에도 많은 기능이 있다.
포스팅 후기 : 이전시간 자바로 DI 구현하기 다음 스프링으로 DI 구현하기를 진행해보았다. 다음시간엔 싱글톤패턴과 @Configuration의 비밀에 대해 포스팅 할 예정이다.
싱글톤과 @Configuration
이 포스팅은 인프런 김영한 님의 스프링 핵심 원리 기본 편을 보고 각색한 포스팅입니다. 자세한 내용은 강의를 확인해주세요
싱글톤 패턴이란 무엇일까?
싱글톤 패턴이란 클래스의 인스턴스가 딱 한개만 생성되는 것을 보장하는 디자인 패턴이다. 인스턴스가 딱 한개만 생성되지 않는다면 고객이 요청할 때마다 인스턴스를 새로 만들어야한다. 인스턴스를 계속 새로 만들면 메모리 낭비가 심하기 때문에 인스턴스는 하나만 만드는것이 좋다.
public class SingletonService {
//1. static 영역에 객체를 딱 1개만 생성해둔다.
private static final SingletonService instance = new SingletonService();
//2. public으로 열어서 객체 인스터스가 필요하면 이 static 메서드를 통해서만 조회하도록
허용한다.
public static SingletonService getInstance() {
return instance;
}
//3. 생성자를 private으로 선언해서 외부에서 new 키워드를 사용한 객체 생성을 못하게 막는다.
private SingletonService() {
}
public void logic() {
System.out.println("싱글톤 객체 로직 호출");
}
}
테스트코드로 정말 인스턴스가 딱 한개만 생성되는지 확인해보자
@Test
@DisplayName("싱글톤 패턴을 적용한 객체 사용")
public void singletonServiceTest() {
//private으로 생성자를 막아두었다. 컴파일 오류가 발생한다.
//new SingletonService();
//1. 조회: 호출할 때 마다 같은 객체를 반환
SingletonService singletonService1 = SingletonService.getInstance();
//2. 조회: 호출할 때 마다 같은 객체를 반환
SingletonService singletonService2 = SingletonService.getInstance();
//참조값이 같은 것을 확인
System.out.println("singletonService1 = " + singletonService1);
System.out.println("singletonService2 = " + singletonService2);
// singletonService1 == singletonService2
assertThat(singletonService1).isSameAs(singletonService2);
singletonService1.logic();
}
테스트를 돌려보면 정말 인스턴스가 하나만 생성되는 것을 확인할 수 있다.
하지만 이렇게 좋아보이는 싱글톤 패턴에도 문제점이 엄청 많다.
1. 싱글톤 패턴을 구현하는 코드 자체가 많이 들어간다.
2. 의존관계상 클라이언트가 구체 클래스에 의존한다. ( SingletoinService.getInstance() )
3. 클라이언트가 구체 클래스에 의존해서 OCP 원칙을 위반할 가능성이 높다.
4. 테스트하기가 어렵다.
5. 내부 속성을 변경하거나 초기화하기 어렵다.
6. private 생성자로 자식 클래스를 만들기 어렵다.
7. 결론적으로 유연성이 떨어진다.
8. 때문에 안티패턴으로 불리기도 한다.
스프링 컨테이너는 싱글톤 패턴의 문제점을 해결하면서, 객체 인스턴스를 싱글톤으로 관리한다. 어떻게 가능한지 살펴보자
우선 그전에 AppConfig를 다시 살펴보자
@Configuration
public class AppConfig {
@Bean
public MemberService memberService() {
return new MemberServiceImpl(memberRepository());
}
@Bean
public OrderService orderService() {
return new OrderServiceImpl(memberRepository(), discountPolicy());
}
@Bean
public MemoryMemberRepository memberRepository() {
return new MemoryMemberRepository();
}
@Bean
public DiscountPolicy discountPolicy() {
// return new FixDiscountPolicy();
return new RateDiscountPolicy();
}
}
여기서 MemberRepository를 잘 보면 빈으로 등록할 때 MemoryMemberRepository가 호출되고 MemberServiceImpl이 호출될 때 한번 더 호출되고 OrderServiceImpl 까지 호출된다면 세번 호출된다. 세번 호출되니까 싱글톤이 깨지는거 아닌가? 테스트로 확인해보자
public class SingletonTest {
ApplicationContext ac = new AnnotationConfigApplicationContext(AppConfig.class);
@Test
@DisplayName("세번 호출되는지 확인하는 테스트")
void singletonTest() {
MemberServiceImpl memberService = ac.getBean("memberService", MemberServiceImpl.class);
OrderServiceImpl orderService = ac.getBean("orderService", OrderServiceImpl.class);
MemoryMemberRepository memberRepository = ac.getBean("memberRepository", MemoryMemberRepository.class);
System.out.println("memberService = " + memberService.getMemberRepository());
System.out.println("orderService = " + orderService.getMemberRepository());
System.out.println("memberRepository = " + memberRepository);
}
}
다 같은 인스턴스가 참조되는 것을 확인할 수 있다. 이게 어떻게 된일일까?
비밀은 바로 @Configuration에 있다.
AnnotationConfigApplicationContext구현체에서 클래스정보를 넘기면 해당 클래스도 스프링빈으로 등록되는데 이 AppConfig의 값이 뭐가 나오나 찍어보자
@Test
void configurationDeep() {
ApplicationContext ac = new AnnotationConfigApplicationContext(AppConfig.class);
//AppConfig도 스프링 빈으로 등록된다.
AppConfig bean = ac.getBean(AppConfig.class);
System.out.println("bean = " + bean.getClass());
//출력: bean = class hello.core.AppConfig$$EnhancerBySpringCGLIB$$bd479d70
}
원래 내가 원했던 값은 class hello.core.AppConfig까지인데 뒤에 이상한게 많이 붙어있다. 우린 여기서 CGLIB에 주목하자 바로 비밀이 여기에 있기 때문이다.
이것은 바로 내가 만든 클래스가 아니라 스프링이 CGLIB라는 바이트코드 조작 라이브러리를 사용해서 AppConfig 클래스를 상속받은 임의의 클래스를 만들고 그 다른 클래스를 스프링 빈으로 등록한 것이다.
CGLIB의 코드는 훨씬 복잡하겠지만 예상되는 코드는 다음과 같다.
@Bean
public MemberRepository memberRepository() {
if (memoryMemberRepository가 이미 스프링 컨테이너에 등록되어 있으면) {
return 스프링 컨테이너에서 찾아서 반환
}
else {
기존 로직을 호출해서 MemoryMemberRepository를 생성하고 스프링 컨테이너에 등록
return 반환
}
}
CGLIB를 통해 우리는 안전하게 싱글톤을 사용할 수 있다. 앞서 말한 싱글톤패턴의 문제점을 다 해결하면서 싱글톤을 보장해주는 것이다. 그렇다면 @Configuration을 빼면 어떻게 될까? 곧바로 싱글톤이 깨지는 것을 볼 수 있다. 때문에 설정정보를 가진 곳에는 @Configuration을 붙여주자
다음 포스팅은 컴포넌트스캔과 자동의존관계주입에 대해서 포스팅할 예정이다.
컴포넌트 스캔과 자동 의존 관계 주입
이 포스팅은 인프런 김영한 님의 스프링 핵심 원리 기본 편을 보고 각색한 포스팅입니다. 자세한 내용은 강의를 확인해주세요
https://coding-review.tistory.com/84
앞서 우리는 @Configuration의 비밀과 싱글톤 컨테이너인 스프링 컨테이너에 대해서 자세히 알아봤다. 근데 여기서 한가지 문제가 있다. AppConfig가 지금은 작으니까 상관없는데 애플리케이션이 점점 커지면 스프링 빈으로 등록해야 하는것이 수십개 수백개가 될텐데 일일히 저걸 관리해주는 AppConfig를 만들고있자니 유지보수하기 여간 까다로운게 아니다.
그래서 스프링에선 컴포넌트 스캔이라는 기능을 제공한다.
코드로 바로 확인해보자
@Configuration
@ComponentScan
public class AutoAppConfig {
}
이렇게 AutoAppConfig를 만들어놓고 스프링 빈으로 등록할 것들에 @Component 어노테이션을 붙여주기만 하면 자동으로 스프링 빈으로 등록이 된다.
하지만 여기서 문제가 있다. 기존 AppConfig는 의존관계 주입을 명시적으로 표기함으로써 자바코드만 봐도 누가 어떤 의존관계를 가지고 있는지 한눈에 파악하기 쉬웠다. 하지만 @Component 어노테이션을 붙여주는 클래스에서 누가 어떤 의존관계를 가지고 있는지 확인할 방법이 없다. 어떻게 해결해야할까?
자동 의존관계 주입이라고도 불리는 @Autowired 어노테이션을 사용하면 된다.
@Component
public class MemberServiceImpl implements MemberService{
private MemberRepository memberRepository;
@Autowired
public MemberServiceImpl(MemberRepository memberRepository) {
this.memberRepository = memberRepository;
}
@Override
public void join(Member member) {
memberRepository.save(member);
}
@Override
public Member findMember(Long memberId) {
return memberRepository.findById(memberId);
}
public MemberRepository getMemberRepository() {
return memberRepository;
}
}
@Autowired의 기본 조회 전략은 타입이 같은 빈을 찾아서 주입한다는 것이다. 우리가 앞서 했던 ac.getBean(MemberRepository.class)와 동일하다고 이해하면 된다. @Autowired에 대해서는 다음 포스팅에서 더 자세히 다루도록 하겠다.
이렇게 AutoAppConfig를 통해 컴포넌트 스캔에 대해서 간단히 알아봤는데 우리는 실제로 개발할 때 AutoAppConfig와 같은 클래스를 만들지 않아도 된다. 왜냐하면 기본적으로 스프링부트를 사용하면 만들어지는 메인메소드에 붙어있는 어노테이션인 @SpringBootApplication을 들어가보면 컴포넌트스캔이 붙어있는 것을 확인할 수 있다.
또한 컴포넌트 스캔의 용도 뿐만 아니라 다음 어노테이션이 있으면 스프링은 부가 기능을 수행한다.
-@Controller : 스프링 MVC 컨트롤러로 인식
-@Repository : 스프링 데이터 접근 계층으로 인식하고 데이터 계층의 예외를 스프링 예외로 반환해준다.
-@Configuration : 앞서 보았듯이 스프링 설정 정보로 인식하고, 스프링 빈이 싱글톤을 유지하도록 추가처리를 한다.
-@Service : 사실 @Service는 특별한 처리를 하지 않는다. 대신 개발자들이 핵심 비즈니스 로직이 여기에 있겠구나 하고 비즈니스 계층을 인식하는데 도움이 된다.
이번 포스팅에서는 컴포넌트스캔과 자동의존관계 주입에 대해서 간단하게 살펴봤다. 다음포스팅에서는 @Autowired에 대해서 깊이있게 파헤쳐볼 것이다.
@Autowired
이 포스팅은 인프런 김영한 님의 스프링 핵심 원리 기본 편을 보고 각색한 포스팅입니다. 자세한 내용은 강의를 확인해주세요
의존관계 주입에는 다양한 방법이 있다.-생성자 주입-수정자 주입 (setter 주입)-필드 주입
이제부터 하나씩 살펴보며 어떤 방법을 지향해야 하는지 알아보자
1. 생성자 주입
말 그대로 생성자를 통해서 의존 관계를 주입 받는 방법이다. 여태까지 우리가 진행했던 방법이 바로 생성자 주입이다.
*특징
-생성자 호출시점에 딱 한번만 호출되는 것이 보장된다.
-불변, 필수 의존관계에 사용
불변, 필수 의존관계에 사용한다는 것은 어떤 의미를 가지고 있을까?
불변이라는 의미는 생성자는 클래스가 생성되는 순간에 바로 결정되기 때문에 수정자가 없는한 값을 변경할 수 없는 의미이다. 또한 필수라는 의미는 마치 공연이 시작되기 전에 모든 배우를 섭외하고 시작하는 것과 같은 효과를 줄 수 있다.
@Component
public class OrderServiceImpl implements OrderService{
private final MemberRepository memberRepository;
private final DiscountPolicy discountPolicy;
@Autowired
public OrderServiceImpl(MemberRepository memberRepository, DiscountPolicy discountPolicy) {
this.memberRepository = memberRepository;
this.discountPolicy = discountPolicy;
}
@Override
public Order createOrder(Long memberId, String itemName, int itemPrice) {
Member member = memberRepository.findById(memberId);
int discountPrice = discountPolicy.discount(member, itemPrice);
return new Order(memberId, itemName, itemPrice, discountPrice);
}
public MemberRepository getMemberRepository() {
return memberRepository;
}
}
2. 수정자 주입
setter라 불리는 필드의 값을 변경하는 수정자 메서드를 통해서 의존관계를 주입하는 방법이다.
*특징
-선택, 변경 가능성이 있는 의존관계에 사용
-자바빈 프로퍼티 규약의 수정자 메서드를 사용하는 방법이다.
@Component
public class OrderServiceImpl implements OrderService{
private MemberRepository memberRepository;
private DiscountPolicy discountPolicy;
@Autowired
public void setDiscountPolicy(DiscountPolicy discountPolicy) {
this.discountPolicy = discountPolicy;
}
@Autowired
public void setMemberRepository(MemberRepository memberRepository) {
this.memberRepository = memberRepository;
}
@Override
public Order createOrder(Long memberId, String itemName, int itemPrice) {
Member member = memberRepository.findById(memberId);
int discountPrice = discountPolicy.discount(member, itemPrice);
return new Order(memberId, itemName, itemPrice, discountPrice);
}
public MemberRepository getMemberRepository() {
return memberRepository;
}
}
3. 필드 주입
이름 그대로 필드에 바로 주입하는 방법이다.
*특징
-코드가 간결해서 많은 개발자들을 유혹하지만 외부에서 변경이 불가능해서 테스트하기 힘들다는 치명적인 단점이 있다.
-DI프레임워크가 없으면 아무것도 할 수 없다.
-사용하면 안되는 패턴이다!
@Component
public class OrderServiceImpl implements OrderService{
@Autowired
private MemberRepository memberRepository;
@Autowired
private DiscountPolicy discountPolicy;
@Override
public Order createOrder(Long memberId, String itemName, int itemPrice) {
Member member = memberRepository.findById(memberId);
int discountPrice = discountPolicy.discount(member, itemPrice);
return new Order(memberId, itemName, itemPrice, discountPrice);
}
public MemberRepository getMemberRepository() {
return memberRepository;
}
}
생성자 주입을 선택해라!
과거에는 수정자 주입과 필드 주입을 ㅁ낳이 사용했찌만, 최근에는 스프링을 포함한 DI 프레임워크 대부분이 생성자 주입을 권장한다. 이유는 다음과 같다.
불변
-대부분의 의존관계 주입은 한번 일어나면 애플리케이션 종료시점까지 의존관계를 변경할 일이 없다. 오히려 대부분의 의존관계는 애플리케이션 종료 전까지 변하면 안된다.
-수정자 주입을 사용하면 setXxx메서드를 public으로 열어두어야 한다.
-누군가 실수로 변경할 수도 있고, 변경하면 안되는 메서드를 열어두는 것은 좋은 설계 방법이 아니다.
-생성자 주입은 객체를 생성할 때 딱 한번만 호출되므로 이후에 호출되는 일이 없다. 따라서 불변하게 설계할 수 있다.
누락
프레임워크 없이 순수한 자바 코드로 단위테스트를 하는 경우에 다음과 같이 수정자 의존관계인 경우
@Component
public class OrderServiceImpl implements OrderService{
private MemberRepository memberRepository;
private DiscountPolicy discountPolicy;
@Autowired
public void setMemberRepository(MemberRepository memberRepository) {
this.memberRepository = memberRepository;
}
@Autowired
public void setDiscountPolicy(DiscountPolicy discountPolicy) {
this.discountPolicy = discountPolicy;
}
....
}
@Autowired가 프레임워크 안에서 동작할 때는 의존관계가 없으면 오류가 발생하지만, 지금은 프레임워크 없이 순수한 자바 코드로만 단위 테스트를 수행하고 있다.
이렇게 테스트를 수행하면 실행은 된다.
@Test
void createOrder() {
OrderServiceImpl orderService = new OrderServiceImpl();
orderService.createOrder(1L, "itemA", 10000);
}
그런데 막상 실행 결과는 NullPointerException이 발생하는데 memberRepository, discountPolicy 모두 의존관계 주입이 누락되었기 때문이다.
final 키워드
생성자 주입을 사용하면 필드에 final 키워드를 사용할 수 있다. 그래서 생성자에서 혹시라도 값이 설정되지 않는 오류를 컴파일 시점에서 막아준다. 다음 코드를 보자
@Component
public class OrderServiceImpl implements OrderService{
private final MemberRepository memberRepository;
private final DiscountPolicy discountPolicy;
@Autowired
public OrderServiceImpl(MemberRepository memberRepository, DiscountPolicy discountPolicy) {
this.memberRepository = memberRepository;
}
....
}
잘 보면 필수 필드인 discountPolicy 에 값을 설정해야 하는데, 이 부분이 누락되었다. 자바는 컴파일시점에 다음 오류를 발생시킨다.
java: variable discountPolicy might not have been initialized
기억하자! 컴파일 오류는 세상에서 가장 빠르고, 좋은 오류다!
막상 개발을 해보면, 대부분이 다 불변이고 그래서 다음과 같이 생성자에 final 키워드를 사용하게 되는데 생성자도 만들어야하고 주입받은 값을 대입하는 코드도 만들어야하고... 여간 귀찮은게 아니다.
이때 등장하는 라이브러리가 바로 롬복이다.
@RequiredArgsConstructor를 달아주기만 하면 코드가 깔끔하게 바뀐다.
@Component
@RequiredArgsConstructor
public class OrderServiceImpl implements OrderService{
private final MemberRepository memberRepository;
private final DiscountPolicy discountPolicy;
....
}
롬복을 사용하는 방법은 다음과 같다.
1. start.spring.io 에서 dependency 추가에 lombok을 입력 후 추가
2. build.gradle에 추가
dependencies {
compileOnly 'org.projectlombok:lombok'
annotationProcessor 'org.projectlombok:lombok'
}
MVC 프레임워크 만들기
이 포스팅은 인프런 김영한 님의 스프링 핵심 원리 기본 편을 보고 각색한 포스팅입니다. 자세한 내용은 강의를 확인해주세요
우리는 앞으로 점진적인 버전업을 통해 스프링 MVC를 구현해 볼 것이다.
-프론트 컨트롤러 도입 (v1)
-View 분리 (v2)
-Model 추가 (v3)
-단순하고 실용적인 컨트롤러 (v4)
-유용한 컨트롤러 (v5)
순으로 구현해 나갈 것이다.
스프링 MVC에서 가장 중요한 부분이 바로 프론트 컨트롤러 패턴이다. 스프링에선 프론트 컨트롤러를 디스패쳐 서블릿으로 구현했다.
프론트 컨트롤러란 서블릿 하나를 모든 컨트롤러 앞에 두고 클라이언트 요청을 이 앞에 있는 서블릿이 먼저 받게 하여 프론트 컨트롤러가 요청에 맞는 컨트롤러를 찾아서 호출해주는 역할을 한다.
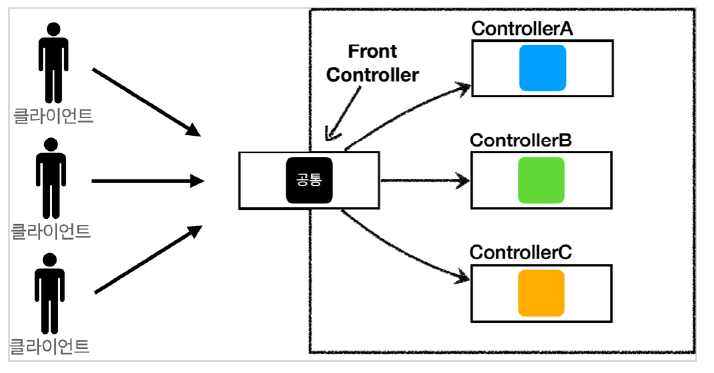
기본이 되는 엔티티와 Repository를 먼저 만들고 V1부터 차례대로 만들어보겠다.
Member.java
@Getter @Setter
public class Member {
private Long id;
private String username;
private int age;
public Member() {
}
public Member(String username, int age) {
this.username = username;
this.age = age;
}
}
MemberRepository.java
/**
* 동시성 문제가 고려되어 있지 않음, 실무에서는 ConcurrentHashMap, AtomicLong 사용 고려
*/
public class MemberRepository {
private static Map<Long, Member> store = new HashMap<>();
private static long sequence = 0L;
private static final MemberRepository instance = new MemberRepository();
public static MemberRepository getInstance() {
return instance;
}
private MemberRepository() {
}
public Member save(Member member) {
member.setId(++sequence);
store.put(member.getId(), member);
return member;
}
public Member findById(Long id) {
return store.get(id);
}
public List<Member> findAll() {
return new ArrayList<>(store.values());
}
public void clearStore() {
store.clear();
}
}
일단 지금은 JPA나 다른 데이터베이스 접근 방식을 사용하지 않고 메모리에 올려서 사용하는 방식을 채택했다. 최대한 예제를 단순하게 하기 위함이니 이 부분을 잘 숙지하고 다음 부분으로 넘어가면 될 것이다. 또한, 뷰 템플릿으로 jsp를 사용하였다.
V1
V1의 기본 구조는 다음과 같다.
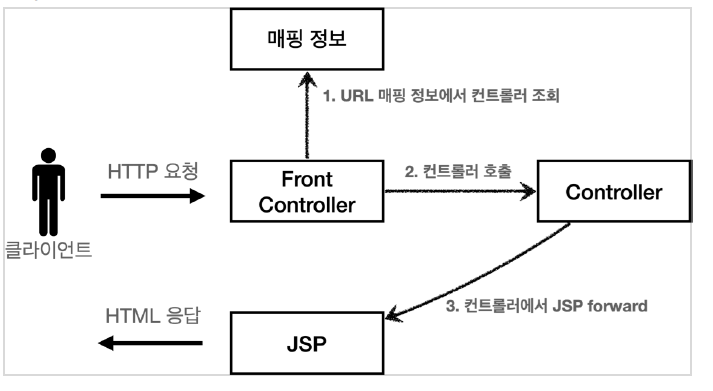
ControllerV1.java
public interface ControllerV1 {
void process(HttpServletRequest request, HttpServletResponse response) throws ServletException, IOException;
}
우리는 다형성을 활용하기 위해서 컨트롤러를 인터페이스로 만들었다. 인자값으로 HttpServletRequest, HttpServletResponse를 받아서 구현체를 하나씩 만들 것이다.
MemberFormControllerV1.java
public class MemberFormControllerV1 implements ControllerV1 {
@Override
public void process(HttpServletRequest request, HttpServletResponse response) throws ServletException, IOException {
String viewPath = "/WEB-INF/views/new-form.jsp";
RequestDispatcher dispatcher = request.getRequestDispatcher(viewPath);
dispatcher.forward(request, response);
}
}
MemberFormController는 단순히 뷰로 이동하기만 하는 컨트롤러이다.
MemberListControllerV1.java
public class MemberListControllerV1 implements ControllerV1 {
private MemberRepository memberRepository = MemberRepository.getInstance();
@Override
public void process(HttpServletRequest request, HttpServletResponse response) throws ServletException, IOException {
List<Member> members = memberRepository.findAll();
request.setAttribute("members", members);
String viewPath = "/WEB-INF/views/members.jsp";
RequestDispatcher dispatcher = request.getRequestDispatcher(viewPath);
dispatcher.forward(request, response);
}
}
MemberRepository에서 findAll로 모든 멤버를 찾아와 모델에 담아주는 역할을 하는 컨트롤러이다.
MemberSaveControllerV1.java
public class MemberSaveControllerV1 implements ControllerV1 {
private MemberRepository memberRepository = MemberRepository.getInstance();
@Override
public void process(HttpServletRequest request, HttpServletResponse response) throws ServletException, IOException {
String username = request.getParameter("username");
int age = Integer.parseInt(request.getParameter("age"));
Member member = new Member(username, age);
memberRepository.save(member);
//Model에 데이터를 보관한다.
request.setAttribute("member", member);
String viewPath = "/WEB-INF/views/save-result.jsp";
RequestDispatcher dispatcher = request.getRequestDispatcher(viewPath);
dispatcher.forward(request, response);
}
}
파라미터로 username, age를 받아와 멤버에 저장하고 모델에 멤버를 담아 뷰로 이동하는 컨트롤러이다.
FrontControllerServletV1.java
@WebServlet(name = "frontControllerServletV1", urlPatterns = "/front-controller/v1/*")
public class FrontControllerServletV1 extends HttpServlet {
private Map<String, ControllerV1> controllerMap = new HashMap<>();
public FrontControllerServletV1() {
controllerMap.put("/front-controller/v1/members/new-form", new MemberFormControllerV1());
controllerMap.put("/front-controller/v1/members/save", new MemberSaveControllerV1());
controllerMap.put("/front-controller/v1/members", new MemberListControllerV1());
}
@Override
protected void service(HttpServletRequest request, HttpServletResponse response) throws ServletException, IOException {
String requestURI = request.getRequestURI();
ControllerV1 controller = controllerMap.get(requestURI);
if (controller == null) {
response.setStatus(HttpServletResponse.SC_NOT_FOUND);
return;
}
controller.process(request, response);
}
}
urlPatterns를 /front-controller/v1으로 들어오는 모든 url이 이 FrontControllerServletV1을 통과하게 만들었다. 그 후에 url매핑 정보를 Map에 저장하였다. service 부분에서는 request.getRequestURI 메서드를 사용하여 어떤 url로 들어오는지를 캐치해 매핑 정보에 저장되어있는 컨트롤러를 그때그때 바꿔서 호출해준다.
V1에는 모든 컨트롤러에서 뷰로 이동하는 부분에 중복이 있고, 깔끔하지 않다.
String viewPath = "/WEB-INF/views/new-form.jsp";
RequestDispatcher dispatcher = request.getRequestDispatcher(viewPath);
dispatcher.forward(request, response);
이 부분이 항상 모든 컨트롤러에 들어간다.
V2에서는 깔끔하게 분리하기 위해 별도로 뷰를 처리하는 객체를 만들어보자
V2
V2의 구조는 다음과 같다.
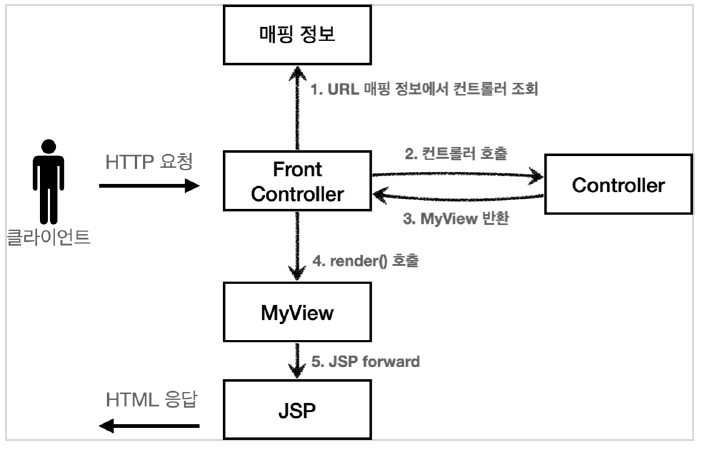
MyView.java
public class MyView {
private String viewPath;
public MyView(String viewPath) {
this.viewPath = viewPath;
}
public void render(HttpServletRequest request, HttpServletResponse response) throws ServletException, IOException {
RequestDispatcher dispatcher = request.getRequestDispatcher(viewPath);
dispatcher.forward(request, response);
}
}
MyView를 생성자를 통해 한번만 만들어지게 하고 render를 호출하면 getRequestDispatcher메서드를 이용해 forward하는 로직이 추가되었다.
ControllerV2.java
public interface ControllerV2 {
MyView process(HttpServletRequest request, HttpServletResponse response) throws ServletException, IOException;
}
컨트롤러에선 기존에 컨트롤러의 리턴타입이 void였던 것을 MyView를 반환하게 하여 process 로직을 타고 컨트롤러에서 할 일이 끝나면 MyView 값을 통해 render를 호출하도록 설계하였다.
MemberFormControllerV2.java
public class MemberFormControllerV2 implements ControllerV2 {
@Override
public MyView process(HttpServletRequest request, HttpServletResponse response) throws ServletException, IOException {
return new MyView("/WEB-INF/views/new-form.jsp");
}
}
MemberSaveControllerV2.java
public class MemberSaveControllerV2 implements ControllerV2 {
private MemberRepository memberRepository = MemberRepository.getInstance();
@Override
public MyView process(HttpServletRequest request, HttpServletResponse response) throws ServletException, IOException {
String username = request.getParameter("username");
int age = Integer.parseInt(request.getParameter("age"));
Member member = new Member(username, age);
memberRepository.save(member);
//Model에 데이터를 보관한다.
request.setAttribute("member", member);
return new MyView("/WEB-INF/views/save-result.jsp");
}
}
MemberListControllerV2.java
public class MemberListControllerV2 implements ControllerV2 {
private MemberRepository memberRepository = MemberRepository.getInstance();
@Override
public MyView process(HttpServletRequest request, HttpServletResponse response) throws ServletException, IOException {
List<Member> members = memberRepository.findAll();
request.setAttribute("members", members);
return new MyView("/WEB-INF/views/members.jsp");
}
}
FrontControllerServletV2.java
@WebServlet(name = "frontControllerServletV2", urlPatterns = "/front-controller/v2/*")
public class FrontControllerServletV2 extends HttpServlet {
private Map<String, ControllerV2> controllerMap = new HashMap<>();
public FrontControllerServletV2() {
controllerMap.put("/front-controller/v2/members/new-form", new MemberFormControllerV2());
controllerMap.put("/front-controller/v2/members/save", new MemberSaveControllerV2());
controllerMap.put("/front-controller/v2/members", new MemberListControllerV2());
}
@Override
protected void service(HttpServletRequest request, HttpServletResponse response) throws ServletException, IOException {
String requestURI = request.getRequestURI();
ControllerV2 controller = controllerMap.get(requestURI);
if (controller == null) {
response.setStatus(HttpServletResponse.SC_NOT_FOUND);
return;
}
MyView view = controller.process(request, response);
view.render(request, response);
}
}
프론트 컨트롤러에서는 매핑정보를 통해 해당 컨트롤러를 호출하고 process를 실행해 해당 컨트롤러의 비즈니스 로직을 실행한 후에 render를 호출해 forward하게 설계하였다. 전 버전에서는 forward가 모든 컨트롤러에서 일어났다면 이번에 개선된 V2에서는 프론트 컨트롤러에서만 forward가 호출되어 컨트롤러의 부담이 한층 덜었다. V2에선 V1과 비교했을 때 컨트롤러가 많이 깔끔해진 것을 볼 수 있다.
하지만 V2에도 문제가 몇가지 있다. 바로 서블릿 종속성과 뷰 이름 중복이다.
MemberSaveController와 MemberListController는 모델에 담을 request객체를 제외하면 response는 사용하지도 않는다. 심지어 MemberFormController는 request, response 둘다 사용하지 않는다. 게다가 request객체도 자바의 Map을 이용하면 필요없어진다.
또한, MyView를 생성할 때 /WEB-INF/views/논리이름.jsp 가 중복되는 것을 볼 수 있다. 다음 버전에선 이 두개를 해결해보겠다.
V3
V3에선 모델에 담길 객체를 request가 아닌 자바의 Map을 이용하여 서블릿의 종속을 피할 것이다. 또한 viewResolver의 도입으로 논리이름을 넘기면 MyView를 반환하여 뷰 이름의 중복을 피할 것이다.
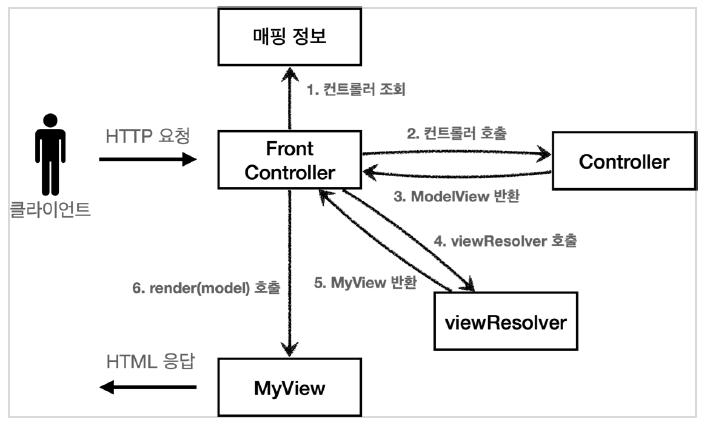
ModelView.java
public class ModelView {
private String viewName;
private Map<String, Object> model = new HashMap<>();
public ModelView(String viewName) {
this.viewName = viewName;
}
public String getViewName() {
return viewName;
}
public void setViewName(String viewName) {
this.viewName = viewName;
}
public Map<String, Object> getModel() {
return model;
}
public void setModel(Map<String, Object> model) {
this.model = model;
}
}
생성자로 viewName (논리이름) 을 생성해준다.
ControllerV3.java
public interface ControllerV3 {
ModelView process(Map<String, String> paramMap);
}
컨트롤러는 ModelView를 반환하고 인자값으로 model에 들어갈 값을 넣는다.
MemberFormControllerV3.java
public class MemberFormControllerV3 implements ControllerV3 {
@Override
public ModelView process(Map<String, String> paramMap) {
return new ModelView("new-form");
}
}
MemberSaveControllerV3.java
public class MemberSaveControllerV3 implements ControllerV3 {
private MemberRepository memberRepository = MemberRepository.getInstance();
@Override
public ModelView process(Map<String, String> paramMap) {
String username = paramMap.get("username");
int age = Integer.parseInt(paramMap.get("age"));
Member member = new Member(username, age);
memberRepository.save(member);
ModelView mv = new ModelView("save-result");
mv.getModel().put("member", member);
return mv;
}
}
process는 모델 (paramMap)을 인자값으로 받아와 Map에 저장되어있는 값을 꺼내 값을 저장하고 비즈니스 로직을 실행한다. 그 후 ModelView에 논리이름을 넣고 반환한다.
MemberListControllerV3.java
public class MemberListControllerV3 implements ControllerV3 {
private final MemberRepository memberRepository = MemberRepository.getInstance();
@Override
public ModelView process(Map<String, String> paramMap) {
List<Member> members = memberRepository.findAll();
ModelView mv = new ModelView("members");
mv.getModel().put("members", members);
return mv;
}
}
FrontControllerservletV3.java
@WebServlet(name = "frontControllerServletV3", urlPatterns = "/front-controller/v3/*")
public class FrontControllerServletV3 extends HttpServlet {
private Map<String, ControllerV3> controllerMap = new HashMap<>();
public FrontControllerServletV3() {
controllerMap.put("/front-controller/v3/members/new-form", new MemberFormControllerV3());
controllerMap.put("/front-controller/v3/members/save", new MemberSaveControllerV3());
controllerMap.put("/front-controller/v3/members", new MemberListControllerV3());
}
@Override
protected void service(HttpServletRequest request, HttpServletResponse response) throws ServletException, IOException {
String requestURI = request.getRequestURI(); // 1번
ControllerV3 controller = controllerMap.get(requestURI); // 2번
if (controller == null) {
response.setStatus(HttpServletResponse.SC_NOT_FOUND);
return;
}
Map<String, String> paramMap = createParamMap(request); // 3번
ModelView mv = controller.process(paramMap); // 4번
String viewName = mv.getViewName();
MyView view = viewResolver(viewName); // 5번
view.render(mv.getModel(), request, response); // 6번
}
private MyView viewResolver(String viewName) {
return new MyView("/WEB-INF/views/" + viewName + ".jsp");
}
private Map<String, String> createParamMap(HttpServletRequest request) {
Map<String, String> paramMap = new HashMap<>();
request.getParameterNames().asIterator()
.forEachRemaining(paramName -> paramMap.put(paramName, request.getParameter(paramName)));
return paramMap;
}
}
이제 점점 복잡해지는데 번호를 붙여가면서 하나씩 살펴보자
1번 : 사용자의 url매핑 정보를 받아서
2번 : 매핑 정보에 맞는 컨트롤러를 찾아온다.
3번 : 파라미터로 넘어온 값의 이름 (username, age) 을 getParameterNames메서드를 통해 다 꺼내와 asIterator 메서드로 iterator화 시킨후 forEachRemaining 메서드와 람다를 활용하여 paramMap에 저장한다.
4번 : 저장한 paramMap을 process에 넘겨 컨트롤러는 안에있는 값을 꺼내 사용할지 말지를 비즈니스 로직에 따라 결정한다. (MemberSaveControllerV3에서는 paramMap을 사용하지만 나머지 컨트롤러에선 사용하지 않는다.)
5번 : 컨트롤러에서 MyView에 논리이름을 가져와서 viewResolver를 통해 온전한 뷰 이름으로 만든후에
6번 : render로 forward를 실행한다.
V3컨트롤러는 서블릿 종속성을 제거하고 뷰 경로의 중복을 제거하는 등 잘 설계된 컨트롤러이다. 그런데 실제 컨트롤러 인터페이스를 구현하는 개발자 입장에서 보면 항상 ModelView 객체를 생성하고 반환해야 하는 부분이 조금 번거롭다.
좋은 프레임워크는 아키텍처도 중요하지만, 그와 더불어 실제 개발하는 개발자가 단순하고 편리하게 사용할 수 있어야 한다. 소위 실용성이 있어야 한다.
V4
V4는 V3와 구조는 똑같지만 ModelView를 반환하지 않고 String을 반환하여 말그대로 진짜 논리 이름만 반환하는 로직으로 설계될 예정이다.
ControllerV4.java
public interface ControllerV4 {
/**
* @param paramMap
* @param model
* @return viewName
*/
String process(Map<String, String> paramMap, Map<String, Object> model);
}
이번 컨트롤러에선 모델을 직접 넘기는 방식이다. 저번 컨트롤러에선 ModelView에 있는 model을 getModel()을 사용하여 put 했었다. 하지만 이번엔 모델을 직접 넘겨 개발자가 사용하기에 더 용이하게 설계했다. 또한 반환 타입이 String으로 바뀌어서 진짜 논리이름만 반환하면 되도록 설계하였다.
MemberFormControllerV4.java
public class MemberFormControllerV4 implements ControllerV4 {
@Override
public String process(Map<String, String> paramMap, Map<String, Object> model) {
return "new-form";
}
}
MemberSaveControllerV4.java
public class MemberSaveControllerV4 implements ControllerV4 {
private MemberRepository memberRepository = MemberRepository.getInstance();
@Override
public String process(Map<String, String> paramMap, Map<String, Object> model) {
String username = paramMap.get("username");
int age = Integer.parseInt(paramMap.get("age"));
Member member = new Member(username, age);
memberRepository.save(member);
model.put("member", member);
return "save-result";
}
}
MemberListControllerV4.java
public class MemberListControllerV4 implements ControllerV4 {
private final MemberRepository memberRepository = MemberRepository.getInstance();
@Override
public String process(Map<String, String> paramMap, Map<String, Object> model) {
List<Member> members = memberRepository.findAll();
model.put("members", members);
return "members";
}
}
FrontControllerServletV4.java
@WebServlet(name = "frontControllerServletV4", urlPatterns = "/front-controller/v4/*")
public class FrontControllerServletV4 extends HttpServlet {
private Map<String, ControllerV4> controllerMap = new HashMap<>();
public FrontControllerServletV4() {
controllerMap.put("/front-controller/v4/members/new-form", new MemberFormControllerV4());
controllerMap.put("/front-controller/v4/members/save", new MemberSaveControllerV4());
controllerMap.put("/front-controller/v4/members", new MemberListControllerV4());
}
@Override
protected void service(HttpServletRequest request, HttpServletResponse response) throws ServletException, IOException {
String requestURI = request.getRequestURI();
ControllerV4 controller = controllerMap.get(requestURI);
if (controller == null) {
response.setStatus(HttpServletResponse.SC_NOT_FOUND);
return;
}
Map<String, String> paramMap = createParamMap(request);
Map<String, Object> model = new HashMap<>(); //추가
String viewName = controller.process(paramMap, model);
MyView view = viewResolver(viewName);
view.render(model, request, response);
}
private MyView viewResolver(String viewName) {
return new MyView("/WEB-INF/views/" + viewName + ".jsp");
}
private Map<String, String> createParamMap(HttpServletRequest request) {
Map<String, String> paramMap = new HashMap<>();
request.getParameterNames().asIterator()
.forEachRemaining(paramName -> paramMap.put(paramName, request.getParameter(paramName)));
return paramMap;
}
}
바뀐 부분중 가장 눈에 띄는 것은 render에 model을 넘긴다는 것이다. jsp는 request.setAttribute로 모델을 전달하는데 개발자가 model에 집어넣은 값을 request.setAttribute로 바꿔주는 역할을 할 것이다. 그리하여 새롭게 추가된 코드는 다음과 같다.
MyView.java
public class MyView {
private String viewPath;
public MyView(String viewPath) {
this.viewPath = viewPath;
}
public void render(HttpServletRequest request, HttpServletResponse response) throws ServletException, IOException {
RequestDispatcher dispatcher = request.getRequestDispatcher(viewPath);
dispatcher.forward(request, response);
}
public void render(Map<String, Object> model, HttpServletRequest request, HttpServletResponse response) throws ServletException, IOException {
modelToRequestAttribute(model, request);
RequestDispatcher dispatcher = request.getRequestDispatcher(viewPath);
dispatcher.forward(request, response);
}
private void modelToRequestAttribute(Map<String, Object> model, HttpServletRequest request) {
model.forEach((key, value) -> request.setAttribute(key, value));
}
}
자바의 Map에 forEach메서드와 람다를 사용하여 request.setAttribute로 바꿔준 것을 확인할 수 있다.
여기까지 했다면 거의 다 온것이다. 마지막 V5에서는 유연한 컨트롤러를 만들건데, 어떤 개발자는 V3 방식을 쓰고싶을 수도 있고, 어떤 개발자는 V4방식을 사용하고 싶을수도 있을 것이다. 하지만 우리가 만든 코드는 V4면 V4, V3면 V3이렇게 고정되게 사용할 수 밖에 없다. 왜냐하면 바로 이부분 때문이다.
private Map<String, ControllerV4> controllerMap = new HashMap<>();
public FrontControllerServletV4() {
controllerMap.put("/front-controller/v4/members/new-form", new MemberFormControllerV4());
controllerMap.put("/front-controller/v4/members/save", new MemberSaveControllerV4());
controllerMap.put("/front-controller/v4/members", new MemberListControllerV4());
}
Map에 보면 ControllerV4라고 적혀있는 것을 확인할 수 있다. 이렇게 되면 우린 V4만 사용할 수 밖에 없는것이다. 이제 이것을 Object로 바꿔 어떤 컨트롤러든 수용할 수 있게 설계할 것이다.
V5
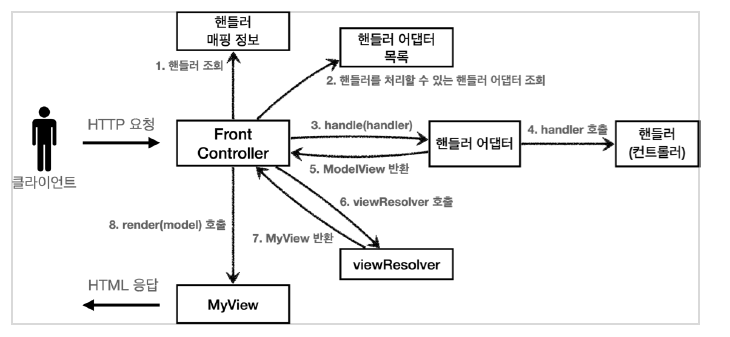
V5에서는 핸들러 어댑터라는 것이 새로 생기는데 이것이 바로 핸들러를 처리할 수 있는 핸들러 어댑터를 조회하고 그에 맞는 핸들러 (컨트롤러) 를 호출하게 만드는 것이다.
MyHandlerAdapter.java
public interface MyHandlerAdapter {
boolean supports(Object handler);
ModelView handle(HttpServletRequest request, HttpServletResponse response, Object handler) throws ServletException, IOException;
}
support는 이 핸들러가 우리가 원하는 핸들러와 일치하는지를 확인하는 메서드이다. handle은 실제 컨트롤러를 호출하고 그 결과로 ModelView를 반환하는 것이다.
ControllerV3HandlerAdapter.java
public class ControllerV3HandlerAdapter implements MyHandlerAdapter {
@Override
public boolean supports(Object handler) {
return (handler instanceof ControllerV3);
}
@Override
public ModelView handle(HttpServletRequest request, HttpServletResponse response, Object handler) throws ServletException, IOException {
//MemberFormControllerV3
ControllerV3 controller = (ControllerV3) handler;
Map<String, String> paramMap = createParamMap(request);
ModelView mv = controller.process(paramMap);
return mv;
}
private Map<String, String> createParamMap(HttpServletRequest request) {
Map<String, String> paramMap = new HashMap<>();
request.getParameterNames().asIterator()
.forEachRemaining(paramName -> paramMap.put(paramName, request.getParameter(paramName)));
return paramMap;
}
}
supports에선 ControllerV3이 맞는지를 확인한다. 그리고 handle에서 ControllerV3으로 다운캐스팅하고 createParamMap이 handle안으로 들어온 것을 확인할 수 있다. 그리고 ModelView를 반환하고 끝이난다.
ControllerV4HandlerAdapter.java
public class ControllerV4HandlerAdapter implements MyHandlerAdapter {
@Override
public boolean supports(Object handler) {
return (handler instanceof ControllerV4);
}
@Override
public ModelView handle(HttpServletRequest request, HttpServletResponse response, Object handler) throws ServletException, IOException {
ControllerV4 controller = (ControllerV4) handler;
Map<String, String> paramMap = createParamMap(request);
HashMap<String, Object> model = new HashMap<>();
String viewName = controller.process(paramMap, model);
ModelView mv = new ModelView(viewName);
mv.setModel(model);
return mv;
}
private Map<String, String> createParamMap(HttpServletRequest request) {
Map<String, String> paramMap = new HashMap<>();
request.getParameterNames().asIterator()
.forEachRemaining(paramName -> paramMap.put(paramName, request.getParameter(paramName)));
return paramMap;
}
}
V4는 process가 String을 반환하게 되어있다. 그래서 ModelView 객체를 따로 만들어서 setter를 이용해 값을 설정해준 다음 return하는 모습을 보여준다.
FrontControllerServletV5
@WebServlet(name = "frontControllerServletV5", urlPatterns = "/front-controller/v5/*")
public class FrontControllerServletV5 extends HttpServlet {
private final Map<String, Object> handlerMappingMap = new HashMap<>();
private final List<MyHandlerAdapter> handlerAdapters = new ArrayList<>();
public FrontControllerServletV5() {
initHandlerMappingMap(); // 1번
initHandlerAdapters(); // 2번
}
private void initHandlerMappingMap() {
handlerMappingMap.put("/front-controller/v5/v3/members/new-form", new MemberFormControllerV3());
handlerMappingMap.put("/front-controller/v5/v3/members/save", new MemberSaveControllerV3());
handlerMappingMap.put("/front-controller/v5/v3/members", new MemberListControllerV3());
//V4 추가
handlerMappingMap.put("/front-controller/v5/v4/members/new-form", new MemberFormControllerV4());
handlerMappingMap.put("/front-controller/v5/v4/members/save", new MemberSaveControllerV4());
handlerMappingMap.put("/front-controller/v5/v4/members", new MemberListControllerV4());
}
private void initHandlerAdapters() {
handlerAdapters.add(new ControllerV3HandlerAdapter());
handlerAdapters.add(new ControllerV4HandlerAdapter());
}
@Override
protected void service(HttpServletRequest request, HttpServletResponse response) throws ServletException, IOException {
Object handler = getHandler(request); // 3번
if (handler == null) {
response.setStatus(HttpServletResponse.SC_NOT_FOUND);
return;
}
MyHandlerAdapter adapter = getHandlerAdapter(handler); // 4번
ModelView mv = adapter.handle(request, response, handler); // 5번
String viewName = mv.getViewName(); // 6번
MyView view = viewResolver(viewName); // 7번
view.render(mv.getModel(), request, response); //8번
}
private Object getHandler(HttpServletRequest request) {
String requestURI = request.getRequestURI();
return handlerMappingMap.get(requestURI);
}
private MyHandlerAdapter getHandlerAdapter(Object handler) {
//MemberFormControllerV4
for (MyHandlerAdapter adapter : handlerAdapters) {
if (adapter.supports(handler)) {
return adapter;
}
}
throw new IllegalArgumentException("handler adapter를 찾을 수 없습니다. handler=" + handler);
}
private MyView viewResolver(String viewName) {
return new MyView("/WEB-INF/views/" + viewName + ".jsp");
}
}
이번엔 진짜 복잡해졌다. 이번에도 번호를 매겨 하나하나 확인해보자
1번, 2번 : 생성자를 사용하여 FrontController가 만들어질 때 설정 정보를 입력해놓는다. handlerAdapters는 for 문을 돌려가면서 supports를 확인할 때 사용할 리스트이고 handlerMappingMap은 url마다 컨트롤러를 등록해놓는 곳이라고 이해하면 된다.
3번 : requestURI 메서드를 이용하여 매핑정보를 가지고 알맞는 핸들러 (컨트롤러) 를 가져온다.
4번 : 가져온 핸들러를 가지고 알맞는 어댑터를 가져온다. for문을 돌려서 supports를 확인해 true가 나오면 해당 어댑터를 리턴한다.
5번 : handle을 호출하여 알맞은 핸들러와 그에 맞는 로직을 실행한다.
6번 : ModelView에서 논리이름을 꺼낸다.
7번 : viewResolver로 논리이름을 완전한 뷰 이름으로 만들어준다.
8번 : V4에서 render에 모델을 같이 넘기는 것과 같은 로직이다.
이렇게 우리는 점진적으로 단계를 거쳐 아키텍처도 안정적이고 사용자 (개발자) 가 편리하게 사용할 수 있는 프레임워크를 만들었다. 다음 포스팅에서는 우리가 만든 프레임워크와 실제 스프링 프레임워크를 비교하면서 스프링 MVC 프레임워크에 대해 더 자세히 알아볼 것이다.
스프링 MVC 구조 파악하기
이 포스팅은 인프런 김영한 님의 스프링 핵심 원리 기본 편을 보고 각색한 포스팅입니다. 자세한 내용은 강의를 확인해주세요
우리는 앞서 직접 MVC 프레임워크를 만들었다. 안정적인 아키텍처와 사용자의 편의를 위한 기능도 추가했었다.
https://coding-review.tistory.com/87
이번엔 우리가 직접 만든 MVC 프레임워크와 스프링 MVC 프레임워크를 비교해보고 스프링 MVC에 대해 좀 더 자세히 알아보는 시간을 가지려 한다.
먼저 직접 만든 MVC 프레임워크의 구조이다.
다음은 스프링 MVC의 구조이다.
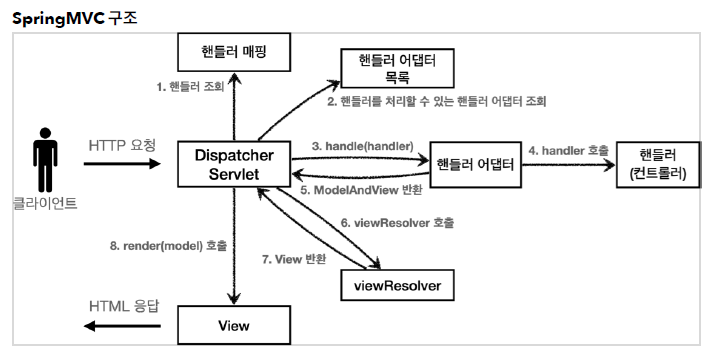
비교해보면 둘이 완벽하게 일치하는 것을 알 수 있다. 그렇다. 우리가 직접 만든 MVC 프레임워크는 사실 스프링을 기반으로 한 MVC 구조와 완전히 똑같다. 다른것이라고 한다면 스프링이 사용하고 있는 이름과 우리가 직접 만든 프레임워크의 이름이 다르다는 점과 스프링은 viewResolver나 View를 인터페이스로 만들어 확장성에 더 용이하게 만들었다는 것이다.
동작 순서
1. 핸들러 조회 : 핸들러 매핑을 통해 요청 URL에 매핑된 핸들러 (컨트롤러) 를 조회한다.
2. 핸들러 어댑터 조회 : 핸들러를 실행할 수 있는 핸들러 어댑터를 조회한다.
3. 핸들러 어댑터 실행 : 핸들러 어댑터를 실행한다.
4. 핸들러 실행 : 핸들러 어댑터가 실제 핸들러를 실행한다.
5. ModelAndView 반환 : 핸들러 어댑터는 핸들러가 반환하는 정보를 ModelAndView로 변환해서 반환한다.
6. viewResolver 호출 : 뷰 리졸버를 찾고 실행한다. JSP의 경우 InternalResourceViewResolver가 자동등록되고 사용된다.
7. View 반환 : 뷰 리졸버는 뷰의 논리 이름을 물리 이름으로 바꾸고, 렌더링 역할을 담당하는 뷰 객체를 반환한다. JSP의 경우 InternalREsourceView (JstlView)를 반환하는데 내부에 forward() 로직이 있다.
8. 뷰 렌더링 : 뷰를 통해서 뷰를 렌더링 한다.
스프링 MVC의 큰 강점은 DispatcherServlet 코드의 변경 없이, 원하는 기능을 변경하거나 확장할 수 있다는 점이다. 지금까지 설명한 대부분을 확장 가능할 수 있게 인터페이스로 제공한다.
과거버전 스프링 컨트롤러는 다음과 같았다.
public interface Controller {
ModelAndView handleRequest(HttpServletRequest request, HttpServletResponseresponse) throws Exception;
}
스프링도 처음에는 이런 딱딱한 형식의 컨트롤러를 제공했다. 우리가 만든 V3와 비슷한 모양이다. 인터페이스 Controller는 어노테이션 @Controller와 완전히 다른 객체이다.
과거버전 스프링 컨트롤러를 간단하게 구현해보자
@Component("/springmvc/old-controller")
public class OldController implements Controller {
@Override
public ModelAndView handleRequest(HttpServletRequest request,HttpServletResponse response) throws Exception {
System.out.println("OldController.handleRequest");
return null;
}
}
어? @Component는 컴포넌트 스캔의 대상으로서 스프링빈으로 등록하는 것인데 스프링 빈 이름이 url이네? 이게 동작하려면 어떤게 필요할까?
핸들러 매핑부분
-핸들러 매핑에서 이 컨트롤러를 찾을 수 있어야 한다.
-예) 스프링 빈의 이름으로 핸들러를 찾을 수 있는 핸들러 매핑이 필요하다.
핸들러 어댑터 부분
-핸들러 매핑을 통해서 찾은 핸들러를 실행할 수 있는 핸들러 어댑터가 필요하다.
-예)Controller 인터페이스를 실행할 수 있는 핸들러 어댑터를 찾고 실행해야 한다.
스프링은 이미 필요한 핸들러 매핑과 핸들러 어댑터를 대부분 구현해두었다.
이제 스프링의 핸들러 매핑과 핸들러 어댑터에 대해 더 자세히 알아보도록 하자 실제로는 더 많지만 중요한 부분 위주로 설명하기 위해 일부 생략
HandlerMapping
1. RequestMappingHandlerMapping : 어노테이션 기반의 컨트롤러인 @RequestMapping에서 사용
2. BeanNameUrlHandlerMapping : 스프링 빈의 이름으로 핸들러를 찾는다.
HandlerAdapter
1. RequestMappingHandlerAdapter : 어노테이션 기반의 컨트롤러인 @Requestmapping에서 사용
2. HttpRequestHandlerAdapter : HttpRequestHandler 처리
3. SimpleControllerHandlerAdapter : Controller 인터페이스 처리
각각의 번호는 호출 순서를 의미한다.
1. 핸들러 매핑으로 핸들러 조회
1. HandlerMapping을 순서대로 실행해서, 핸들러를 찾는다.
2. 이 경우 빈 이름으로 핸들러를 찾아야 하기 때문에 이름 그대로 빈 이름으로 핸들러를 찾아주는 BeanNameHandlermapping이 실행에 성공하고 핸들러인 OldController를 반환한다.
2. 핸들러 어댑터 조회
1. HandlerAdapter의 supports()를 순서대로 호출한다.
2. SimpleControllerHandlerAdapter가 Controller 인터페이스를 지원하므로 대상이 된다.
3. 핸들러 어댑터 실행
1. 디스패처 서블릿이 조회한 SimpleControllerHandlerAdapter를 실행하면서 핸들러 정보도 함께 넘겨준다.
2. SimpleControllerHandlerAdapter는 핸들러인 OldController를 내부에서 실행하고, 그 결과를 반환한다.
이제 뷰 리졸버에 대해서 자세히 알아보자
@Component("/springmvc/old-controller")
public class OldController implements Controller {
@Override
public ModelAndView handleRequest(HttpServletRequest request,HttpServletResponse response) throws Exception {
System.out.println("OldController.handleRequest");
return new ModelAndView("new-form");
}
}
View를 사용할 수 있도록 다음 코드를 추가했다.
return nuew ModelAndView("new-form");
실행해보면 404 오류페이지가 뜬다.
스프링 부트는 InternalResourceViewREsolver라는 뷰 리졸버를 자동으로 등록하는데, 이때 application.properties에 등록한 spring.mvc.view.prefix, spring.mvc.view.suffix설정 정보를 사용해서 등록한다.
뷰 리졸버 동작 방식은 다음과 같다.
1. 핸들러 어댑터 호출
핸들러 어댑터를 통해 new-form이라는 논리 뷰 이름을 획득한다.
2. ViewResolver 호출
new-form이라는 뷰 이름으로 viewResolver를 순서대로 호출하고 BeanNameViewResolver는 new-form이라는 이름의 스프링 빈으로 등록된 뷰를 찾아야 하는데 없다. 그럼 InternalResourceViewResolver가 호출된다.
3. InternalResourceViewResolver
이 뷰 리졸버는 InternalResourceView를 반환한다.
4. 뷰 - InternalResourceView
InternalResourceView는 JSP처럼 포워드를 호출해서 처리할 수 있는 경우에 사용한다.
5. view.render()
view.render()가 호출되고 InternalResourceView는 forward()를 사용해서 JSP를 실행한다.
이제 본격적으로 스프링 MVC를 시작해보자, 스프링이 제공하는 컨트롤러는 어노테이션 기반으로 동작해서, 매우 유연하고 실용적이다. 과거에는 자바 언어에 어노테이션이 없기도 했고, 스프링도 처음부터 이런 유연한 컨트롤러를 제공한 것은 아니다.
@RequestMapping
스프링은 어노테이션을 활용한 매우 유연하고, 실용적인 컨트롤러를 만들었는데 이것이 바로 @RequestMapping어노테이션을 사용하는 컨트롤러이다. 다들 한번쯤 사용해봤을 것이다.
@Controller
1. 스프링이 자동으로 스프링빈으로 등록한다 (내부에 @Component 어노테이션이 있어서 컴포넌트 스캔의 대상이 됨)
2. 스프링 MVC에서 어노테이션 기반 컨트롤러로 인식한다.
@GetMapping
@RequestMapping의 확장버전 Get방식의 url을 처리하는 컨트롤러에 붙여준다.
@PostMapping
@RequestMapping의 확장버전 Post방식의 url을 처리하는 컨트롤러에 붙여준다.
바로 현업에서는 어떻게 사용하는지 보자
@Controller
@RequestMapping("/springmvc/v3/members")
public class SpringMemberControllerV3 {
private MemberRepository memberRepository = MemberRepository.getInstance();
@GetMapping("/new-form")
public String newForm() {
return "new-form";
}
@PostMapping("/save")
public String save(@RequestParam("username") String username,@RequestParam("age") int age,Model model) {
Member member = new Member(username, age);
memberRepository.save(member);
model.addAttribute("member", member);
return "save-result";
}
@GetMapping
public String members(Model model) {
List<Member> members = memberRepository.findAll();
model.addAttribute("members", members);
return "members";
}
}
@RequestParam은 request.getParameter와 역할이 같다. 스프링에선 타입까지 지정해서 받아올 수 있다. 때문에 Integer.parseInt같은 문법을 사용하지 않고 깔끔하게 처리할 수 있다. 넘어오는 파라미터가 한두개면 @RequestParam을 사용하지만 넘어오는 파라미터가 여러개라면 따로 DTO를 만들어서 받아올 수 있다. 또한 인자값으로 Model을 받을 수 있는데 이는 우리가 Model을 직접 넘긴 것과 같은 효과를 본다.
동시성문제와 스레드 로컬
이 포스팅은 인프런 김영한 님의 스프링 핵심 원리 고급 편을 보고 각색한 포스팅입니다. 자세한 내용은 강의를 확인해주세요
이번 시간에는 스프링을 사용할 때 주의할 점과 해결방법인 스레드 로컬에 대해 알아보겠다.
스프링을 사용할 때 우리는 컴포넌트스캔을 이용하고 스프링 빈을 자동 등록하든 수동 등록하든 자연스럽게 사용하고 있다. 스프링의 장점중 하나는 이 스프링 빈이 싱글톤 패턴으로 만들어지기 때문에 메모리를 효율적으로 사용할 수 있다는 점이다. 하지만 이러한 싱글톤 패턴은 조심해서 사용해야 한다.
바로 동시성 문제 때문이다.
동시성 문제에 대한 가벼운 예시를 들어 설명할 예정이다.
FieldService.java
@Slf4j
public class FieldService {
private String nameStore;
public String logic(String name) {
log.info("저장 name = {} -> nameStore = {}", name, nameStore);
nameStore = name;
sleep(1000);
log.info("조회 nameStore = {}", nameStore);
return nameStore;
}
private void sleep(int millis) {
try {
Thread.sleep(1000);
} catch (InterruptedException e) {
e.printStackTrace();
}
}
}
nameStore라는 멤버변수(필드변수)에 값을 저장하고 조회하는 로직을 만들었다. sleep으로 조회하는데 시간이 어느정도 걸린다고 가정했다.
@Slf4j
public class FieldServiceTest {
private FieldService fieldService = new FieldService();
@Test
void field() {
log.info("main start");
Runnable userA = () -> {
fieldService.logic("userA");
};
Runnable userB = () -> {
fieldService.logic("userB");
};
Thread threadA = new Thread(userA);
threadA.setName("thread-A");
Thread threadB = new Thread(userB);
threadB.setName("thread-B");
threadA.start();
sleep(2000);
threadB.start();
sleep(3000);
log.info("main exit");
}
private void sleep(int millis) {
try {
Thread.sleep(millis);
} catch (InterruptedException e) {
e.printStackTrace();
}
}
}
스레드를 사용해 로직을 두번 실행하는 코드를 작성했다.
userA는 스레드A를 이용해 자신의 이름을 nameStore에 저장하였고 userB도 스레드B를 이용해 자신의 이름을 nameStore에 저장하는 로직이다.
1. 저장과 조회에 1초가 걸리고
2. userA가 실행하고 2초 뒤 userB가 실행한다
3. 3초뒤 메인스레드가 종료된다.
이를 그림으로 나타내면 다음과 같다.
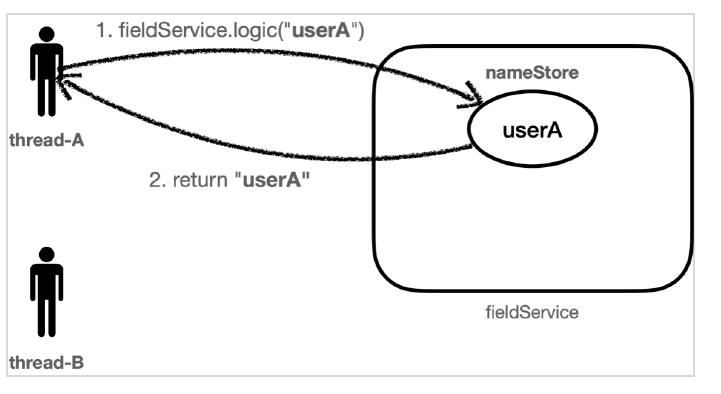
스레드A가 userA를 nameStore에 저장하고 nameStore를 조회해 userA를 반환받는다.
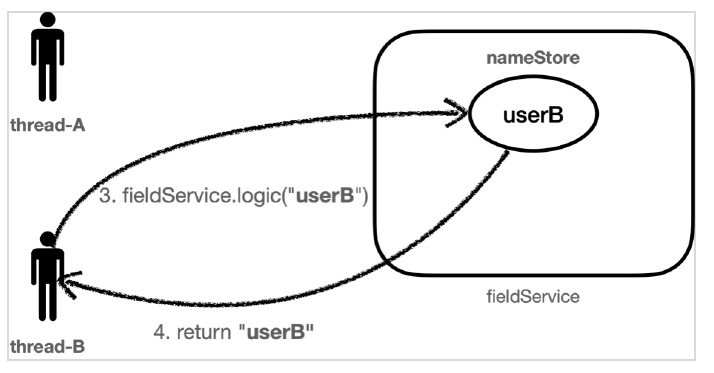
이후에 스레드B가 userB를 nameStore에 저장하고 nameStore를 조회해 userB를 반환받는다.
실행 결과
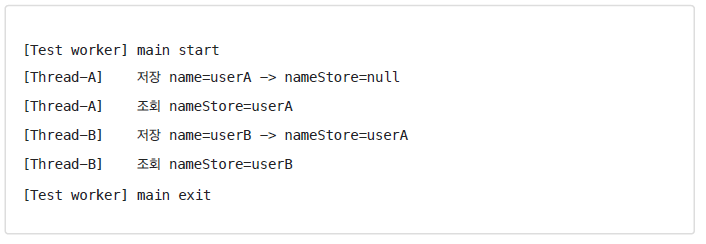
아직까지 동시성 문제가 발생하지 않는다.
이제 동시성 문제가 발생하게 코드를 바꿀 것이다. 스레드A의 시작과 스레드B사이에 있는 sleep을 100으로 설정해주면 된다.
그렇게 되면 순서는 이렇게 된다.
1. 저장과 조회에 1초가 걸린다.
2. userA가 실행하고 0.1초 뒤에 userB가 실행한다.
3. 3초뒤 메인스레드가 종료된다.
저장과 조회에 1초가 걸리는데 userA가 실행한지 0.1초만에 userB가 실행해버렸다. 이제 결과가 어떻게 되나 지켜보자
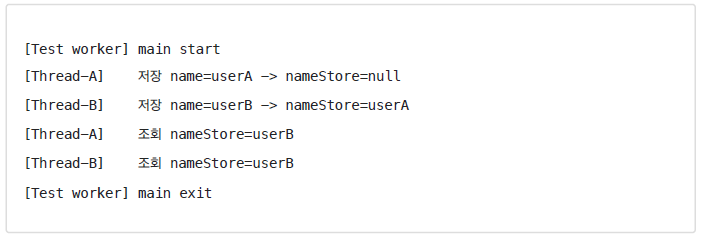
우리가 원했던 결과와 다르게 나왔다. 스레드A가 가진 nameStore엔 userA가 찍혀야하고 스레드B가 가진 nameStore엔 userB가 찍혀야 하는데 둘다 userB가 나와버렸다.
이제 이 상황을 그림으로 더 알기쉽게 설명해보겠다.
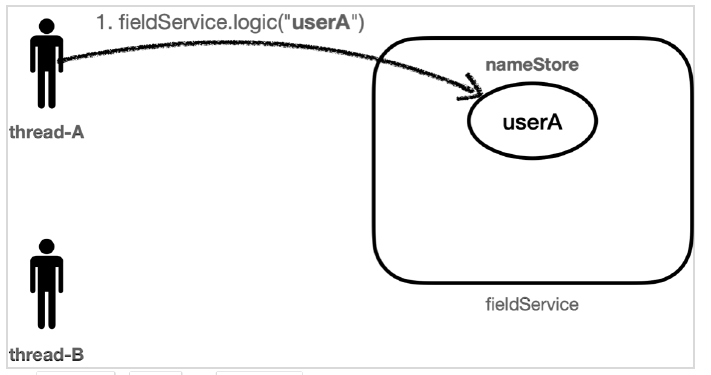
1. 먼저 스레드A가 userA로 nameStore에 저장한다.
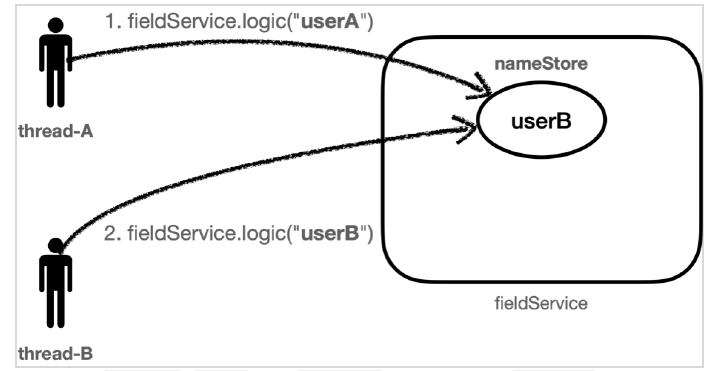
2. 0.1초 뒤에 스레드B가 userB를 nameStore에 저장한다. 기존에 nameStore에 보관되어 있던 userA값은 제거되고 userB 값이 저장된다.
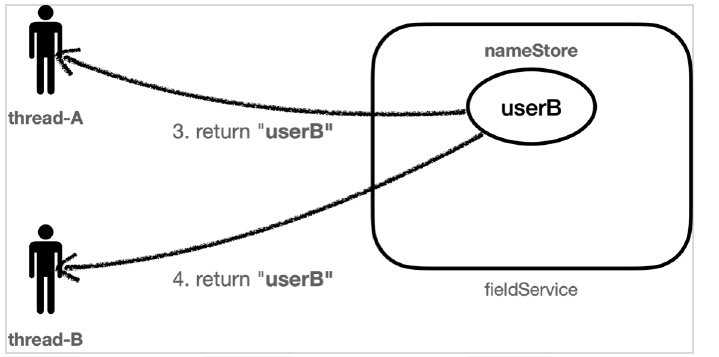
3. 스레드A의 호출이 끝나면서 nameStore의 결과를 반환받는데 이때 nameStore는 앞의 2번에서 userB의 값으로 대체되었다. 따라서 기대했던 userA가 아니라 userB의 값이 반환된다.
결과적으로 스레드A입장에서 저장한 데이터와 조회한 데이터가 다른 문제가 발생한다. 이처럼 여러 스레드가 동시에 같은 인스턴스의 필드 값을 변경하면서 발생하는 문제를 동시성 문제라 한다. 이런 동시성 문제는 여러 스레드가 같은 인스턴스의 필드에 접근해야 하기 때문에 트래픽이 적은 상황에서는 확률상 잘 나타나지 않고 트래픽이 점점 많아질 수록 자주 발생한다.
cf) 이런 동시성 문제는 지역 변수에서는 발생하지 않는다. 지역 변수는 스레드마다 각각 다른 메모리 영역이 할당된다. 동시성 문제가 발생하는 곳은 같은 인스턴스의 필드 또는 static같은 공용 필드에 접근할 때 발생한다. 또한 동시성 문제는 값을 읽기만 하면 발생하지 않는다. 어디선가 값을 변경하기 때문에 발생한다.
이런 동시성 문제를 해결할 수 있는 것이 바로 스레드로컬이다.
스레드로컬은 해당 스레드만 접근할 수 있는 특별한 저장소를 말한다. 쉽게 이야기해 물건 보관 창구를 떠올리면 되는데, 여러 사람이 같은 물건 보관 창구를 사용하더라도 창구 직원은 사용자를 인식해서 사용자별로 확실하게 물건을 구분해준다.
앞서 예제처럼 여러 스레드가 같은 인스턴스의 필드에 접근하면 처음 스레드가 보관한 데이터가 사라질 수 있다.
하지만 스레드 로컬은 각 스레드별로 별도의 내부 저장소를 제공한다. 따라서 같은 인스턴스의 스레드로컬 필드에 접근해도 문제없다.
이제 예제 코드를 다음과 같이 바꾸면 스레드로컬을 사용하여 동시성 문제를 해결할 수 있다.
@Slf4j
public class ThreadLocalService {
private ThreadLocal<String> nameStore = new ThreadLocal<>();
public String logic(String name) {
log.info("저장 name = {} -> nameStore = {}", name, nameStore.get());
nameStore.set(name);
sleep(1000);
log.info("조회 nameStore = {}", nameStore.get());
return nameStore.get();
}
private void sleep(int millis) {
try {
Thread.sleep(1000);
} catch (InterruptedException e) {
e.printStackTrace();
}
}
}
nameStore를 단순한 필드 변수가 아닌 스레드로컬로 선언한다. 스레드 로컬을 지정해줄 때는 set메서드를 사용하고 꺼낼 땐 get메서드를 사용한다.
@Slf4j
public class ThreadLocalServiceTest {
private ThreadLocalService service = new ThreadLocalService();
@Test
void field() {
log.info("main start");
Runnable userA = () -> {
service.logic("userA");
};
Runnable userB = () -> {
service.logic("userB");
};
Thread threadA = new Thread(userA);
threadA.setName("thread-A");
Thread threadB = new Thread(userB);
threadB.setName("thread-B");
threadA.start();
sleep(100);
threadB.start();
sleep(3000);
log.info("main exit");
}
private void sleep(int millis) {
try {
Thread.sleep(millis);
} catch (InterruptedException e) {
e.printStackTrace();
}
}
}
실행결과 우리가 원한대로 스레드A는 userA를 스레드B는 userB를 반환받았다.
이제 동시성 문제 해결!
이 아니라 하나 더 남았다. 바로 동시성 문제를 해결하려 할때 스레드로컬을 사용하는데 스레드로컬에는 주의해야 하는 점이 있다. 바로 리소스를 삭제해줘야 한다는 것이다.
예를 들어서 설명해보겠다.
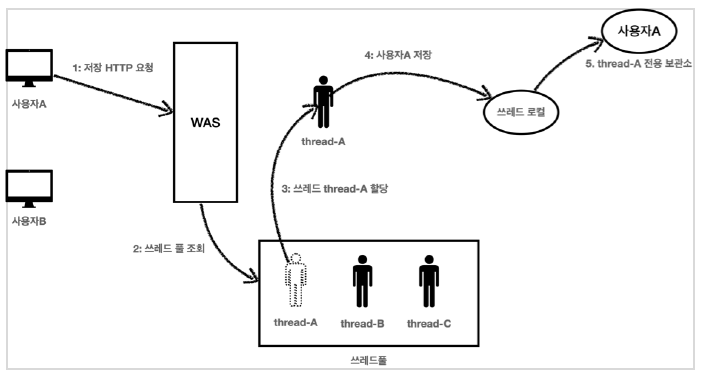
1. 사용자A가 저장 HTTP를 요청했다.
2. WAS는 스레드풀에서 스레드를 하나 조회한다.
3. 스레드A가 할당된다.
4. 스레드A는 사용자A의 데이터를 스레드 로컬에 저장한다.
5. 스레드 로컬의 스레드A 전용 보관소에 사용자A 데이터를 보관한다.
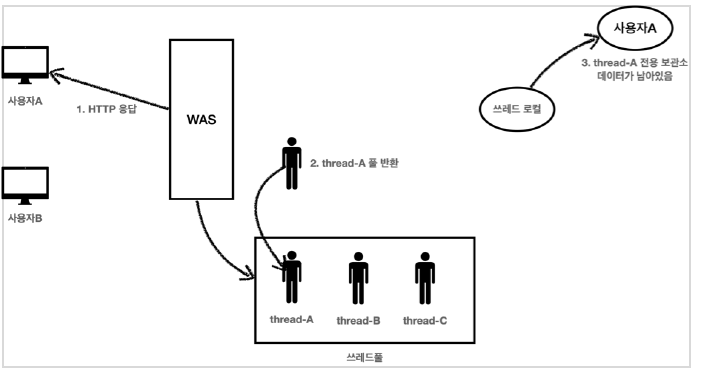
1. 사용자A의 HTTP응답이 끝난다.
2. WAS는 사용이 끝난 스레드A를 스레드 풀에 반환한다. 스레드를 생성하는 비용은 비싸기 때문에 스레드를 제거하지 않고 보통 스레드 풀을 통해서 스레드를 재사용한다.
3. 스레드A는 스레드풀에 아직 살아있다. 따라서 스레드로컬의 스레드A 전용보관소에 사용자A데이터도 함께 살아있게 된다.
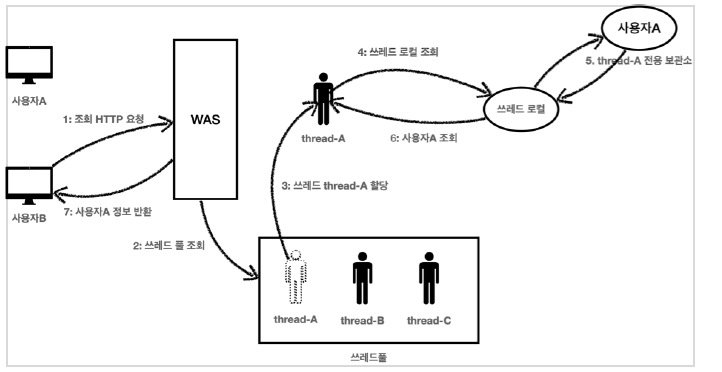
1. 사용자B가 조회를 위한 새로운 HTTP요청을 한다.
2. WAS는 스레드 풀에서 스레드 하나를 조회한다.
3. 우연찮게 스레드A가 선택되었다. (물론 다른 스레드가 할당될 수도 있다.)
4. 이번에는 조회하는 요청이니 스레드A는 스레드로컬에서 데이터를 조회한다.
5. 스레드로컬은 스레드A 전용 보관소에 있는 사용자A 값을 반환한다.
6. 결과적으로 사용자A값이 반환된다.
7. 사용자B는 사용자A의 정보를 조회하게 된다.
이처럼 사용자B는 사용자A의 데이터를 확인하게 되는 심각한 문제가 발생하게 된다. 이런 문제를 예방하려면 사용자A의 요청이 끝날 때 스레드로컬의 값을 ThreadLocal.remove()를 통해서 꼭 제거해야 한다.
스레드로컬을 사용할 때는 이 부분을 꼭꼭 기억하자
디자인패턴 (템플릿 메서드 패턴, 전략 패턴)
이 포스팅은 인프런 김영한 님의 스프링 핵심 원리 고급 편을 보고 각색한 포스팅입니다. 자세한 내용은 강의를 확인해주세요
오늘 알아볼 패턴들을 보기 전에 간단한 예시를 먼저 소개하겠다.
비즈니스 로직을 실행하는데 있어서 어딘가에서 병목현상이 자꾸 벌어진다는 것을 확인했다. 어디서 병목현상이 발생하는지 알아보기 위해서 비즈니스 로직 앞뒤에 시간을 체크해 걸린 시간을 뽑아오라는 임무를 부여받았다.
@Test
void templateMethodV0() {
logic1();
logic2();
}
private void logic1() {
long startTime = System.currentTimeMillis();
//비즈니스 로직
log.info("비즈니스 로직 1 실행");
//비즈니스 로직 종료
long endTime = System.currentTimeMillis();
long resultTime = endTime - startTime;
log.info("resultTime={}", resultTime);
}
private void logic2() {
long startTime = System.currentTimeMillis();
//비즈니스 로직
log.info("비즈니스 로직 2 실행");
//비즈니스 로직 종료
long endTime = System.currentTimeMillis();
long resultTime = endTime - startTime;
log.info("resultTime={}", resultTime);
}
간단한 예제이다. 비즈니스 로직1 실행에 걸린 시간과 비즈니스 로직2 실행에 걸린 시간을 각각 계산해서 화면에 뿌려주는 역할을 한다.
위의 예제에서 보아하니 일정한 패턴이 보인다. 비즈니스 로직을 실행하는 부분을 제외하면 모든것이 다 똑같다.
GOF 디자인패턴에 템플릿 메서드 패턴이라는 디자인패턴이 있다. 이에 대해 살펴보자
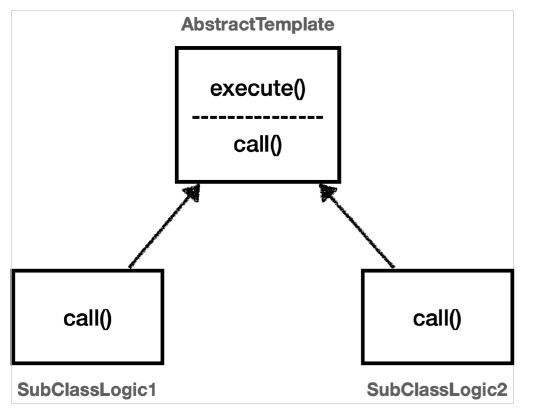
그림만 보면 이해가 잘 안될것이다. AbstractTemplate에 execute와 call을 나눠서 변하지 않는 부분은 execute에 변하는 부분은 call에 넣어두는 것이다. 그럼 수백 수천개의 반복된 코드를 한곳에서 관리할 수 있게 된다.
AbstractTemplate.java
@Slf4j
public abstract class AbstractTemplate {
public void execute() {
long startTime = System.currentTimeMillis();
//비즈니스 로직
call();
//비즈니스 로직 종료
long endTime = System.currentTimeMillis();
long resultTime = endTime - startTime;
log.info("resultTime={}", resultTime);
}
protected abstract void call();
}
먼저 AbstractTemplate을 추상클래스로 만든다. 그리고 execute에 변하지 않는 부분(시간을 체크하는 로직)을 call에 변하는 부분(비즈니스 로직)을 넣는다. execute를 실행하면서 그때그때 call을 호출해줄 것이다. 그때그때 변하는 로직은 상속을 통해 풀어낼 것이다.
SubClassLogic1.java
@Slf4j
public class SubClassLogic1 extends AbstractTemplate{
@Override
protected void call() {
log.info("비즈니스 로직 1 실행");
}
}
SubClassLogic2.java
@Slf4j
public class SubClassLogic2 extends AbstractTemplate{
@Override
protected void call() {
log.info("비즈니스 로직 2 실행");
}
}
/**
* 템플릿 메서드 패턴 적용
*/
@Test
void templateMethodV1() {
AbstractTemplate template1 = new SubClassLogic1();
template1.execute();
AbstractTemplate template2 = new SubClassLogic1();
template2.execute();
}
template1은 SubClassLogic1에서 구현한 call이 호출될 것이고 template2는 SubClassLogic2에서 구현한 call이 호출될 것이다.
이렇게 하고 실행해보면 다음과 같이 잘 나오는것을 확인할 수 있다.
아니 근데 저렇게 상속으로 클래스를 계속 만드는걸 수백 수천개 로직에 다 만들어야 되는거냐
그래서 익명 내부 클래스를 사용하면 더 깔끔하게 구현할 수 있다.
@Test
void templateMethodV2() {
AbstractTemplate template1 = new AbstractTemplate() {
@Override
protected void call() {
log.info("비즈니스 로직 1 실행");
}
};
log.info("클래스 이름1={}", template1.getClass());
template1.execute();
AbstractTemplate template2 = new AbstractTemplate() {
@Override
protected void call() {
log.info("비즈니스 로직 2 실행");
}
};
log.info("클래스 이름1={}", template2.getClass());
template2.execute();
}
GOF 다지안 패턴에서는 템플릿 메서드 패턴을 다음과 같이 정의했다.
템플릿 메서드 디자인 패턴의 목적은 다음과 같습니다. "작업에서 알고리즘의 골격을 정의하고 일부 단계를 하위 클래스로 연기합니다. 템플릿 메서드를 사용하면 하위 클래스가 알고리즘의 구조를 변경하지 않고도 알고리즘의 특정 단계를 재정의 할수 있습니다."
풀어서 설명하면 다음과 같다.
부모 클래스에 알고리즘의 골격인 템플릿을 정의하고, 일부 변경되는 로직은 자식 클래스에 정의하는 것이다. 이렇게 하면 자식 클래스가 알고리즘의 전체 구조를 변경하지 않고, 특정 부분만 재정의 할 수 있다. 결국 상속과 오버라이딩을 통한 다형성으로 문제를 해결하는 것이다.
하지만
템플릿 메서드 패턴은 상속을 사용한다. 따라서 상속에서 오는 단점들을 그대로 안고간다. 특히 자식 클래스가 부모 클래스와 컴파일 시점에 강하게 결합되는 문제가 있다. 이것은 의존관계에 대한 문제이다. 자식 클래스 입장에서는 부모 클래스의 기능을 전혀 사용하지 않는다.
SubClassLogic1, 2를 살펴보면 부모 클래스를 상속받고 있지만 부모 클래스의 그 어떠한 것도 이용하지 않는다.
상속을 받는다는 것은 특정 부모 클래스를 의존하고 있다는 것이다. 따라서 부모 클래스의 기능을 사용하든 사용하지 않든간에 부모 클래스를 강하게 의존하게 된다. 여기서 강하게 의존한다는 뜻은 자식 클래스의 코드에 부모 클래스의 코드가 명확하게 적혀 있다는 뜻이다.
자식 클래스 입장에서는 부모 클래스의 기능을 전혀 사용하지 않는데 부모 클래스를 알아야한다. 이것은 좋은 설계가 아니다. 그리고 이런 잘못된 의존관계 때문에 부모 클래스를 수정하면, 자식 클래스에도 영향을 줄 수 있다.
템플릿 메서드 패턴과 비슷한 역할을 하면서 상속의 단점을 제거할 수 있는 디자인 패턴이 바로 "전략 패턴"이다.
이번에는 동일한 문제를 전략 패턴을 사용해서 해결해보겠다.
템플릿 메서드 패턴은 부모 클래스에 변하지 않는 템플릿을 두고, 변하는 부분을 자식 클래스에 두어서 상속을 문제를 해결했다.
전략 패턴은 변하지 않는 부분을 Context라는 곳에 두고, 변하는 부분을 Strategy라는 인터페이스를 만들고 해당 인터페이스를 구현하도록 해서 문제를 해결한다. 상속이 아니라 위임으로 문제를 해결하는 것이다.
전략 패턴에서 Context는 변하지않는 템플릿 역할을 하고 Strategy는 변하는 알고리즘 역할을 한다.
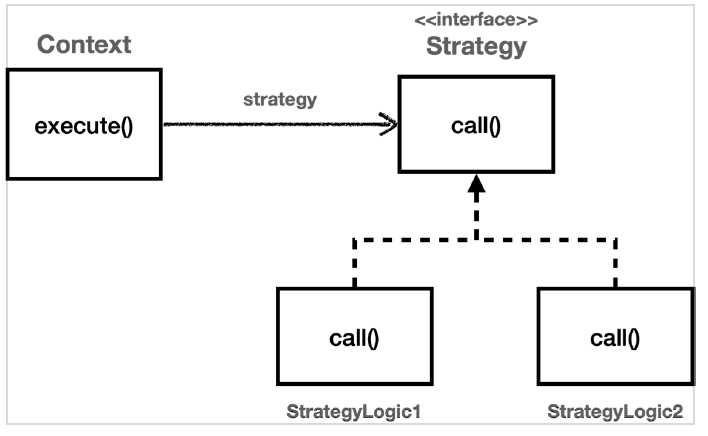
Strategy.java
public interface Strategy {
void call();
}
StrategyLogic1.java
@Slf4j
public class StrategyLogic1 implements Strategy{
@Override
public void call() {
log.info("비즈니스 로직 1 실행");
}
}
StrategyLogic2.java
@Slf4j
public class StrategyLogic1 implements Strategy{
@Override
public void call() {
log.info("비즈니스 로직 2 실행");
}
}
이번에는 전략을 필드에 보관하는 방식과 파라미터로 넘기는 두가지 방식을 살펴볼 것이다.
ContextV1
/**
* 필드에 전략을 보관하는 방식
*/
@Slf4j
public class ContextV1 {
private Strategy strategy;
public ContextV1(Strategy strategy) {
this.strategy = strategy;
}
public void execute() {
long startTime = System.currentTimeMillis();
//비즈니스 로직
strategy.call();
//비즈니스 로직 종료
long endTime = System.currentTimeMillis();
long resultTime = endTime - startTime;
log.info("resultTime={}", resultTime);
}
}
@Test
void strategyV1() {
StrategyLogic1 strategyLogic1 = new StrategyLogic1();
ContextV1 contextV1 = new ContextV1(strategyLogic1);
contextV1.execute();
StrategyLogic2 strategyLogic2 = new StrategyLogic2();
ContextV1 contextV2 = new ContextV1(strategyLogic2);
contextV2.execute();
}
이 방식 어쩐지 익숙하지 않은가? 인터페이스의 다형성을 이용해 원하는 로직을 주입받아 사용하는 것
그렇다 바로 스프링에서 의존관계를 주입할 때 사용하는 방식이다.
https://coding-review.tistory.com/83
템플릿 메서드 패턴때와 마찬가지로 익명 내부 클래스를 사용해서 풀어낼 수도 있다.
@Test
void strategyV2() {
Strategy strategyLogic1 = new Strategy() {
@Override
public void call() {
log.info("비즈니스 로직 1 실행");
}
};
ContextV1 contextV1 = new ContextV1(strategyLogic1);
contextV1.execute();
Strategy strategyLogic2 = new Strategy() {
@Override
public void call() {
log.info("비즈니스 로직 2 실행");
}
};
ContextV1 contextV2 = new ContextV1(strategyLogic2);
contextV2.execute();
}
익명 내부 클래스를 선언한 뒤 주입하는게 아니라 선언하자마자 바로 주입받는 방법도 있다.
@Test
void strategyV3() {
ContextV1 contextV1 = new ContextV1(new Strategy() {
@Override
public void call() {
log.info("비즈니스 로직 1 실행");
}
});
contextV1.execute();
ContextV1 contextV2 = new ContextV1(new Strategy() {
@Override
public void call() {
log.info("비즈니스 로직 2 실행");
}
});
contextV2.execute();
}
익명 내부 클래스를 자바8부터 제공하는 람다로 변경할 수 있다. 람다로 변경하려면 인터페이스에 메서드가 한개만 있으면 되는데, 여기에서 제공하는 Strategy 인터페이스는 메서드가 한개만 있으므로 람다로 사용할 수 있다.
@Test
void strategyV4() {
ContextV1 contextV1 = new ContextV1(() -> log.info("비즈니스 로직 1 실행"));
contextV1.execute();
ContextV1 contextV2 = new ContextV1(() -> log.info("비즈니스 로직 2 실행"));
contextV2.execute();
}
전략 패턴을 그림으로 설명하면 다음과 같다.
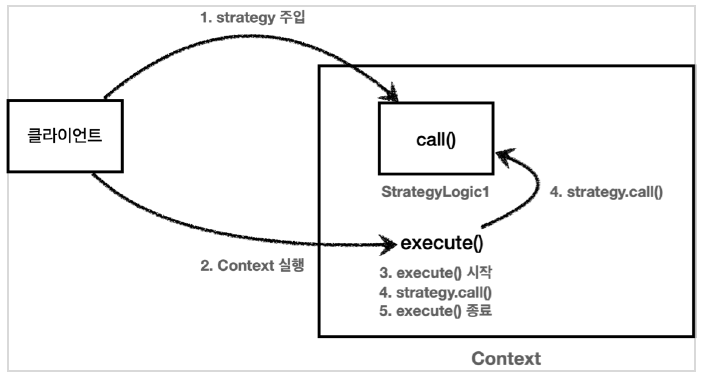
1. Context에 원하는 Strategy 구현체를 주입한다.
2. 클라이언트는 Context를 실행한다.
3. Context는 Context로직을 실행한다.
4. Context로직 중간에 strategy.call()을 호출해서 주입받은 strategy로직을 실행한다.
5. Context는 나머지 로직을 실행한다.
이번에는 주입받아 사용하는게 아니라 파라미터로 strategy를 넘겨받아 사용하는 방법에 대해 알아보자
ContextV2.java
/**
* 전략을 파라미터로 전달받는 방식
*/
@Slf4j
public class ContextV2 {
public void execute(Strategy strategy) {
long startTime = System.currentTimeMillis();
//비즈니스 로직
strategy.call();
//비즈니스 로직 종료
long endTime = System.currentTimeMillis();
long resultTime = endTime - startTime;
log.info("resultTime={}", resultTime);
}
}
ContextV2는 전략을 필드로 가지지 않는다. 대신에 전략을 execute가 호출될 때 마다 항상 파라미터로 전달 받는다.
/**
* 전략패턴 사용
*/
@Test
void strategyV1() {
ContextV2 context = new ContextV2();
context.execute(new StrategyLogic1());
context.execute(new StrategyLogic2());
}
여기서도 물론 익명 내부 클래스를 사용할 수 있다. 물론 람다도 사용할 수 있다.
/**
* 전략패턴 익명 내부 클래스
*/
@Test
void strategyV2() {
ContextV2 context = new ContextV2();
context.execute(new Strategy() {
@Override
public void call() {
log.info("비즈니스 로직 1 실행");
}
});
context.execute(new Strategy() {
@Override
public void call() {
log.info("비즈니스 로직 2 실행");
}
});
}
@Test
void strategyV3() {
ContextV2 context = new ContextV2();
context.execute(() -> log.info("비즈니스 로직 1 실행"));
context.execute(() -> log.info("비즈니스 로직 2 실행"));
}
지금까지 우리는 변하는 코드와 변하지 않는 코드를 분리하고 더 적은 코드로 적용하기위해 고군분투했다.
그런데 지금까지 설명한 방식의 한계는 아무리 최적화를 해도 결국 원본 코드를 수정해야 한다는 점이다. 클래스가 수백개면 수백개를 더 힘들게 수정하는가 덜 힘들게 수정하는가의 차이가 있을 뿐 본질적으로 코드를 다 수정해야 하는 것은 마찬가지이다.
수많은 개발자들이 이 문제에 대해서 집요하게 고민해왔고, 여러가지 방향으로 해결책을 만들어왔다. 지금부터 원본 코드를 손대지 않고 코드를 적용할 수 있는 방법을 알아보자. 그러기 위해선 프록시의 개념을 이해해야한다.
다음 포스팅은 프록시와 프록시패턴, 데코레이터 패턴에 대해서 풀어보는 시간을 갖도록 하겠다.
디자인패턴 (프록시 패턴, 데코레이터 패턴)
이 포스팅은 인프런 김영한 님의 스프링 핵심 원리 고급 편을 보고 각색한 포스팅입니다. 자세한 내용은 강의를 확인해주세요
저번 포스팅에서 우리는 템플릿 메서드 패턴, 전략 패턴에 대해서 알아보았다. https://coding-review.tistory.com/93
앞서 배운 디자인 패턴들은 우리가 원했던 요구사항에 맞긴 하지만 코드를 직접 다 고쳐야 한다는 엄청난 부담감이 있다. 수백개면 수백개 수천개면 수천개의 코드를 일일히 다 고쳐야 한다는 것이다.
기존 코드는 변경하지 않고 시간을 잴 수 있는 방법은 없을까?
방법이 있다. 바로 프록시를 사용하면 된다.
프럼 프록시에 대해서 알아보자
클라이언트와 서버 개념에서 일반적으로 클아이너트가 서버를 직접 호출하고 처리 결과를 직접 받는데 이것을 직접 호출이라 한다.
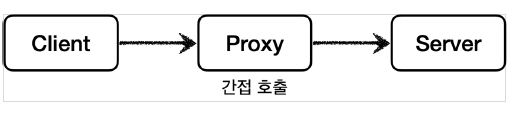
그런데 클라이언트가 요청한 결과를 서버에 직접 요청하는 것이 아니라 어떤 대리자를 통해서 대신 간접적으로 서버에 요청할 수 있다. 예를 들어서 내가 직접 마트에서 장을 볼 수도 있지만, 누군가에게 대신 장을 봐달라고 부탁할 수도 있는것처럼 말이다.
이해를 돕기위해 실생활속 예시를 몇개 들어 설명하겠다.
상황1) 엄마에게 라면을 사달라고 부탁했는데 엄마는 그 라면은 이미 집에 있다고 말했다. 그러면 기대한 것 보다 더 빨리 라면을 먹을 수 있을 것이다. (접근 제어, 캐싱)
상황2) 아버지께 자동차 주유를 부탁했는데 아버지가 주유 뿐만 아니라 세차까지 하고 왔다. 클라이언트가 기대한 것 외에 세차라는 부가 기능까지 얻게 되었다. (부가 기능 추가)
상황3) 대리자가 또다른 대리자를 부를 수도 있다. 예를 들어서 내가 동생에게 라면을 사달라고 했는데 동생이 엄마한테 다시 라면을 사달라고 요청할 수도 있다. 중요한 점은 클라이언트는 대리자를 통해서 요청했기 때문에 그 이후 과정은 모른다는 점이다. 동생을 통해서 라면이 나에게 도착하기만 하면 된다. (프록시 체인)
여기까지 듣고 보면 아무 객체나 프록시가 될 수 있는 것 같다.
객체에서 프록시가 되려면 클라이언트는 서버에게 요청을 한 것인지 프록시에게 요청을 한 것인지 조차 몰라야 한다.
쉽게 이야기해서 서버와 프록시는 같은 인터페이스를 사용해야 한다. 그리고 클라이언트가 사용하는 서버 객체를 프록시 객체로 변경해도 클라이언트 코드를 변경하지 않고 동작할 수 있어야 한다.
이는 우리가 DI를 공부할 떄 중요하게 봤던 포인트 중 하나이다.
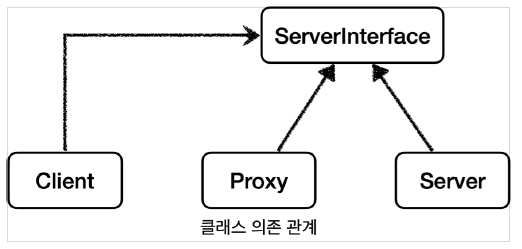
이제 프록시의 주요 기능에 대해 알아보자
프록시를 통해서 할 수 있는 일은 크게 두가지로 구분할 수 있다.
1. 접근제어
-권한에 따른 접근 차단
-캐싱
-지연 로딩
2. 부가 기능 추가
-원래 서버가 제공하는 기능에 더해서 부가 기능을 수행한다.
-예) 요청 값이나, 응답 값을 중간에 변형한다.
-예) 실행 시간을 측정해서 추가 로그를 남긴다.
GOF 디자인 패턴에서는 이 둘을 의도에 따라서 프록시 패턴과 데코레이터 패턴으로 구분한다.
프록시 패턴부터 순서대로 구현해보자
Subject.java
public interface Subject {
String operation();
}
이 예제의 근간이 되는 서버 인터페이스이다.
RealSubject.java
@Slf4j
public class RealSubject implements Subject{
@Override
public String operation() {
log.info("실제 객체 호출");
sleep(1000);
return "data";
}
private void sleep(int millis) {
try {
Thread.sleep(millis);
} catch (InterruptedException e) {
e.printStackTrace();
}
}
}
서버 인터페이스를 구현하는 구현체중 실제 객체이다. 실제 객체를 호출하는데 부하가 많이 걸리는 작업이라 가정하고 1초의 지연시간을 두었다.
ProxyPatternClient.java
public class ProxyPatternClient {
private Subject subject;
public ProxyPatternClient(Subject subject) {
this.subject = subject;
}
public void execute() {
subject.operation();
}
}
클라이언트 객체이다. 클라이언트는 알맞는 서버 인터페이스를 주입받아 execute를 실행할 수 있게 준비했다.
CacheProxy.java
@Slf4j
public class CacheProxy implements Subject{
private Subject target;
private String cacheValue;
public CacheProxy(Subject target) {
this.target = target;
}
@Override
public String operation() {
log.info("프록시 호출");
if (cacheValue == null) {
cacheValue = target.operation();
}
return cacheValue;
}
}
클라이언트가 프록시를 호출하면 프록시가 최종적으로 실제 객체를 호출해야 한다. 따라서 내부에 실제 객체의 참조를 가지고 있어야 한다. 이렇게 프록시가 호출하는 대상을 target이라 한다.
그 아래 구현한 코드를 보면 cacheValue에 값이 없으면 실제 객체를 호출해서 값을 구한다. 그리고 구한 값을 cacheValue에 저장하고 반환한다. 만약 cacheValue에 값이 있으면 실제 객체를 전혀 호출하지 않고 캐시값을 그대로 반환한다. 따라서 처음 조회 이후에는 캐시에서 매우 빠르게 데이터를 조회할 수 있다.
public class ProxyPatternTest {
@Test
void noProxyTest() {
RealSubject realSubject = new RealSubject();
ProxyPatternClient client = new ProxyPatternClient(realSubject);
client.execute();
client.execute();
client.execute();
}
@Test
void cacheProxyTest() {
RealSubject realSubject = new RealSubject();
CacheProxy cacheProxy = new CacheProxy(realSubject);
ProxyPatternClient client = new ProxyPatternClient(cacheProxy);
client.execute();
client.execute();
client.execute();
}
}
첫번째 테스트는 서버 인터페이스를 구현한 실제 객체를 클라이언트에 주입받아 세번 실행하는 모습이다. 세번 실행하면 각각1초씩 3초가 걸리게 된다.
두번째 테스트는 서버 인터페이스를 구현한 실제 객체를 프록시에 주입받고 클라이언트는 프록시 객체를 주입받아서 실행하는 모습이다. 이렇게 되면 클라이언트는 자신이 실제 객체를 주입받았는지 프록시를 주입받았는지조차 알 수 없이 실행한다.
두번째 테스트를 실행해보면 다음과 같은 결과를 얻을 수 있다.
순서상으로 보면 이렇게 된다.
1. 클라이언트는 프록시 객체를 주입받았다.
2. 프록시 객체는 실제 객체를 주입 받았다.
3. 클라이언트가 프록시 객체를 이용해 execute를 실행한다.
4. 그럼 프록시 객체가 소환되고 프록시 객체가 호출된다.
5. 프록시 객체는 cacheValue에 값이 없기 때문에 실제 객체를 호출해서 값을 채워 넣는다.
6. 두번째 호출부터는 프록시 객체에 값이 있기 때문에 있는 값을 그대로 반환한다.
이제 데코레이터 패턴으로 넘어가보자
Component.java
public interface Component {
String operation();
}
RealComponent.java
@Slf4j
public class RealComponent implements Component {
@Override
public String operation() {
log.info("RealComponent 실행");
return "data";
}
}
프록시 패턴과 마찬가지로 서버 인터페이스를 구현한 실제 객체이다. 단순히 로그를 남기고 data를 반환한다.
DecoratorPatternClient.java
@Slf4j
public class DecoratorPatternClient {
private Component component;
public DecoratorPatternClient(Component component) {
this.component = component;
}
public void execute() {
String result = component.operation();
log.info("result={}", result);
}
}
컴포넌트를 주입받아 operation을 실행하는 코드이다.
MessageDecorator.java
@Slf4j
public class MessageDecorator implements Component {
private Component component;
public MessageDecorator(Component component) {
this.component = component;
}
@Override
public String operation() {
log.info("MessageDecorator 실행");
String result = component.operation();
String decoResult = "*****" + result + "*****";
log.info("MessageDecorator 꾸미기 적용 전={}, 적용 후={}", result, decoResult);
return decoResult;
}
}
operation을 실행하고 나온 결괏값에 별을 찍어 메시지를 꾸며주는 역할을 한다.
TimeDecorator.java
@Slf4j
public class TimeDecorator implements Component{
private Component component;
public TimeDecorator(Component component) {
this.component = component;
}
@Override
public String operation() {
log.info("TimeDecorator 실행");
long startTime = System.currentTimeMillis();
String result = component.operation();
long endTime = System.currentTimeMillis();
log.info("걸린 시간 = {}ms", endTime - startTime);
return result;
}
}
컴포넌트를 주입받아 opration을 실행하는데 시작과 끝에 시간을 측정하여 걸린시간을 측정하는 로직이 들어가있다.
DecoratorPatternTest.java
@Slf4j
public class DecoratorPatternTest {
@Test
void noDecorator() {
RealComponent realComponent = new RealComponent();
DecoratorPatternClient client = new DecoratorPatternClient(realComponent);
client.execute();
}
@Test
void decorator1() {
Component realComponent = new RealComponent();
MessageDecorator messageDecorator = new MessageDecorator(realComponent);
DecoratorPatternClient client = new DecoratorPatternClient(messageDecorator);
client.execute();
}
@Test
void decorator2() {
Component realComponent = new RealComponent();
MessageDecorator messageDecorator = new MessageDecorator(realComponent);
TimeDecorator timeDecorator = new TimeDecorator(messageDecorator);
DecoratorPatternClient client = new DecoratorPatternClient(timeDecorator);
client.execute();
}
}
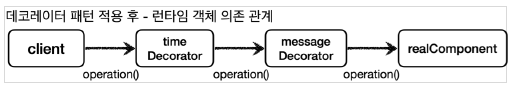
런타임 객체간 프록시 체인으로 연결되어 실행되는 것을 확인할 수 있다.
지금까지 프록시를 사용해서 기존 코드를 변경하지 않고 여러가지 기능을 추가해봤다. 그런데 문제는 프록시 클래스를 너무 많이 만들어야 한다는 점이다. 대상 클래스가 100개라면 프록시 클래스도 100개를 만들어야한다. 이것도 만만치않게 힘들다. 프록시 클래스를 하나만 만들어서 모든 곳에 적용하는 방법은 없을까?
다음 포스팅에선 이 문제를 해결하기 위해 동적 프록시라는 기술에 대해 알아보겠다.
동적 프록시
이 포스팅은 인프런 김영한 님의 스프링 핵심 원리 고급 편을 보고 각색한 포스팅입니다. 자세한 내용은 강의를 확인해주세요
지금까지 프록시를 적용하기 위해 적용 대상의 숫자 만큼 많은 프록시 클래스를 만들었다. 적용 대상이 100개면 프록시 클래스도 100개를 만들었다.
그런데 앞서 살펴본 것과 같이 프록시 클래스의 기본 코드와 흐름은 거의 같고, 프록시를 어떤 대상에 적용하는가 정도만 차이가 있었다. 쉽게 얘기해서 프록시의 로직은 같은데, 적용 대상만 차이가 있는 것이다.
이 문제를 해결하는 것이 바로 동적 프록시 기술이다. 동적 프록시 기술을 사용하면 개발자가 직접 프록시 클래스를 만들지 않아도 된다. 이름 그대로 프록시 객체를 동적으로 런타임에 개발자 대신 만들어준다. 그리고 동적 프록시에 원하는 실행 로직을 지정할 수 있다.
동적 프록시엔 JDK 동적 프록시와 CGLIB를 사용한 프록시 두개가 있다. 지금부터 차근차근 하나씩 알아보자
JDK 동적 프록시
JDK 동적 프록시는 인터페이스가 있어야 적용할 수 있다. 또한, 구현하기 위해서는 InvocationHandler의 인터페이스를 구현해야한다.
TimeInvocationHandler.java
@Slf4j
public class TimeInvocationHandler implements InvocationHandler {
private final Object target;
public TimeInvocationHandler(Object target) {
this.target = target;
}
@Override
public Object invoke(Object proxy, Method method, Object[] args) throws Throwable {
log.info("TimeProxy 실행");
long startTime = System.currentTimeMillis();
Object result = method.invoke(target, args);
long endTime = System.currentTimeMillis();
long resultTime = endTime - startTime;
log.info("TimeProxy 종료 resultTime = {}", resultTime);
return result;
}
}
TimeInvocationHandler는 InvocationHandler 인터페이스를 구현한다. 이렇게해서 JDK 동적 프록시에 적용할 공통 로직을 개발할 수 있다.
Object target : 동적 프록시가 호출할 대상
method.invoke(target, args) : 리플렉션을 사용해서 target 인스턴스의 메서드를 실행한다. args는 메서드 호출시 넘겨줄 인수이다.
그런데 잠깐 리플렉션이 뭐지?
쉽게 말해서 리플렉션이란 동적으로 메서드를 호출할 수 있게 만들어주는 기술이다. 예를 들어서 다음과 같은 코드가 있다고 가정해보자
@Test
void reflection0() {
Hello target = new Hello();
//공통 로직1 시작
log.info("start");
String result1 = target.callA(); //호출하는 메서드가 다름
log.info("result={}", result1);
//공통 로직1 종료
//공통 로직1 시작
log.info("start");
String result2 = target.callB(); //호출하는 메서드가 다름
log.info("result={}", result2);
//공통 로직1 종료
}
공통 로직 사이에 callA와 callB가 있다. 이 공통 로직을 메서드로 뽑고싶은 생각이 들것이다. 하지만 호출하는 메서드가 서로 다르기 때문에 메서드로 뽑는것이 쉽지않다. 이때 등장하는 것이 바로 자바언어차원에서 제공하는 리플렉션이라는 기술이다.
@Test
void reflection1() throws Exception {
//클래스 정보
Class classHello = Class.forName("hello.proxy.jdkdynamic.ReflectionTest$Hello");
Hello target = new Hello();
//callA 메서드 정보
Method methodCallA = classHello.getMethod("callA");
dynamicCall(methodCallA, target);
//callB 메서드 정보
Method methodCallB = classHello.getMethod("callB");
dynamicCall(methodCallB, target);
}
private void dynamicCall(Method method, Object target) throws Exception {
log.info("start");
Object result = method.invoke(target);
log.info("result={}", result);
}
@Slf4j
static class Hello {
public String callA() {
log.info("callA");
return "A";
}
public String callB() {
log.info("callB");
return "B";
}
}
이렇게하면 공통 로직을 메서드로 뽑아낼 수 있다.
이게 바로 리플렉션이다.
이제 이어서 JDK 동적 프록시에 대해 자세히 알아보자
우선 앞서 설명했듯이 JDK 동적 프록시는 인터페이가 있어야 한다. 인터페이스와 그 구현체를 먼저 만들어보자
AInterface.java
public interface AInterface {
String call();
}
AImpl.java
@Slf4j
public class AImpl implements AInterface{
@Override
public String call() {
log.info("A호출");
return "A";
}
}
이제 테스트코드로 JDK 동적 프록시가 잘 실행되는지 확인해보겠다.
@Test
void dynamicA() {
AInterface target = new AImpl();
TimeInvocationHandler handler = new TimeInvocationHandler(target);
AInterface proxy = (AInterface) Proxy.newProxyInstance(AInterface.class.getClassLoader(), new Class[]{AInterface.class}, handler);
proxy.call();
log.info("targetClass={}", target.getClass());
log.info("targetClass={}", proxy.getClass());
}
Proxy.newProxyInstance는 클래스 로더 정보, 인터페이스, 그리고 핸들러 로직을 넣어주면 된다. 그러면 해당 인터페이스를 기반으로 동적 프록시를 생성하고 그 결과를 반환한다.
그냥 이런 코드가 있구나 하고 넘어가면 된다.
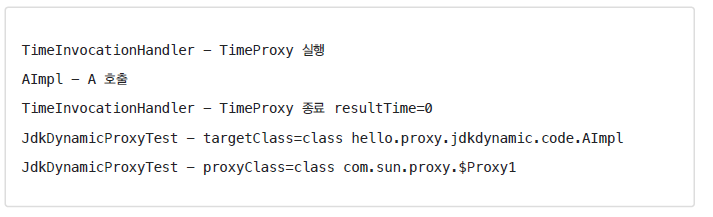
잘 보면 프록시가 잘 실행된것을 볼 수 있다.
프록시의 클래스 정보를 보면 proxyClass=class com.sun.proxy.$Proxy1 이부분이 동적으로 생성된 프록시 클래스 정보이다. 이것은 우리가 만든 클래스가 아니라 JDK 동적 프록시가 이름 그대로 동적으로 만들어준 프록시이다. 이 프록시는 TimeInvocationHandler 로직을 실행한다.
실행순서는 다음과 같다.
1. 클라이언트는 JDK 동적 프록시의 call()을 실행한다.
2. JDK 동적 프록시는 InvocationHandler.invoke()를 호출한다. TimeInvocationHandler가 구현체로 있으므로 TimeInvocationHandler가 호출된다.
3. TimeInvocationHandler가 내부 로직을 수행하고, method,invoke(target, args)를 호출해서 target인 실제 객체를 호출한다.
4. AImpl 인스턴스의 call()이 실행된다.
5. AImpl 인스턴스의 call()이 실행이 끝나면 TimeInvocationHandler로 응답이 돌아온다. 시간 로그를 출력하고 결과를 반환한다.
이를 그림으로 표현하면 다음과 같다.
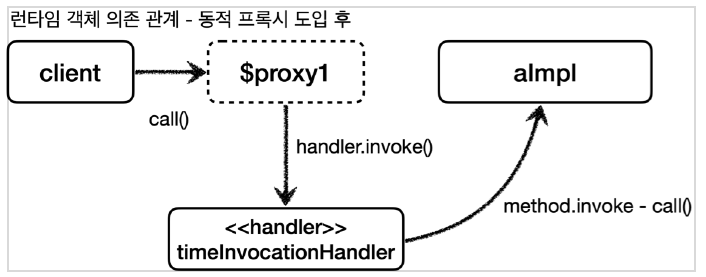
JDK 동적 프록시의 한계
JDK 동적 프록시는 인터페이스가 필수이다. 그렇다면 인터페이스 없이 클래스만 있는 경우에는 어떻게 동적 프록시를 적용할 수 있을까?
이것은 일반적인 방법으론 어렵고 CGLIB라는 바이트코드를 조작하는 특별할 라이브러리를 사용해야한다.
CGLIB
CGLIB는 바이트코드를 조작해서 동적으로 클래스를 생성하는 기술을 제공하는 라이브러리이다. CGLIB를 사용하면 인터페이스가 없어도 구체 클래스만 가지고 동적 프록시를 만들어낼 수 있다. CGLIB는 원래 외부 라이브러리인데, 스프링 프레임워크가 스프링 내부 소스 코드에 포함했다. 따라서 스프링을 사용한다면 별도의 외부 라이브러리를 추가하지 않아도 사용할 수 있다.
참고로 우리가 CGLIB를 직접 사용하는 경우는 거의 없다. 이후에 설명할 스프링의 ProxyFactory라는 것이 이 기술을 편리하게 사용할 수 있게 도와주기 때문에, 너무 깊이있게 파기보다는 CGLIB가 무엇인지 대략 개념만 잡으면 된다.
JDK 동적 프록시에서 실행 로직을 위해 InvocationHandler를 제공했듯이, CGLIB는 MethodInterceptor를 제공한다.
TimeMethodInterceptor.java
@Slf4j
public class TimeMethodInterceptor implements MethodInterceptor {
private final Object target;
public TimeMethodInterceptor(Object target) {
this.target = target;
}
@Override
public Object intercept(Object obj, Method method, Object[] args, MethodProxy methodProxy) throws Throwable {
log.info("TimeProxy 실행");
long startTime = System.currentTimeMillis();
Object result = methodProxy.invoke(target, args);
long endTime = System.currentTimeMillis();
long resultTime = endTime - startTime;
log.info("TimeProxy 종료 resultTime = {}", resultTime);
return result;
}
}
TimeMethodInterceptor는 MethodInterceptor 인터페이스를 구현해서 CGLIB 프록시의 실행 로직을 정의한다.
JDK 동적 프록시를 설명할 때 예제와 거의 같은 코드이다.
이제 테스트코드로 잘 작동하나 확인해보자
@Test
void cglib() {
ConcreteService target = new ConcreteService();
Enhancer enhancer = new Enhancer();
enhancer.setSuperclass(ConcreteService.class);
enhancer.setCallback(new TimeMethodInterceptor(target));
ConcreteService proxy = (ConcreteService) enhancer.create();
log.info("targetClass={}", target.getClass());
log.info("proxyClass={}", proxy.getClass());
proxy.call();
}
다시 말하지만 우리는 CGLIB를 사용할 일이 더이상 없다. 테스트 코드에서 사용한 코드는 그냥 이런 코드가 있구나 하고 생각하고 넘어가면 된다.
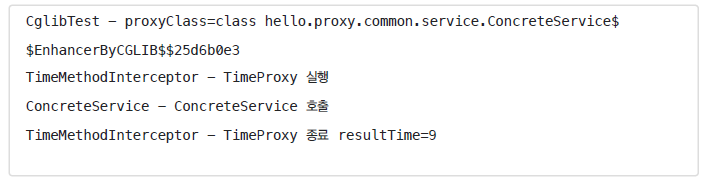
CGLIB가 동적으로 생성하는 클래스 이름은 다음과 같은 규칙으로 생성된다.
대상클래스$$EnhancerByCGLIB$$임의코드
참고로 다음은 JDK 동적 프록시가 생성한 클래스 이름이다.
proxyClass=class com.sun.proxy.$Proxy1
정리
남은 문제는 인터페이스가 있는 경우에는 JDK 동적 프록시를 적용하고, 그렇지 않은 경우엔 CGLIB를 적용해야 하는지에 대한 것이다. 두 기술을 함께 사용할 때 부가 기능을 제공하기 위해서 JDK 동적 프록시가 제공하는 InvocationHandler와 CGLIB가 제공하는 MethodInterceptor를 각각 중복으로 만들어서 관리해야 하는지도 문제이다.
특정 조건에 맞을 때 프록시 로직을 적용하는 기능도 공통으로 제공되었으면 한다.
이 문제들을 해결해주기 위해 다음 포스팅에선 ProxyFactory에 대해서 살펴보겠다.
프록시 팩토리
이 포스팅은 인프런 김영한 님의 스프링 핵심 원리 고급 편을 보고 각색한 포스팅입니다. 자세한 내용은 강의를 확인해주세요
앞서 마지막에 설명했던 동적 프록시를 사용할 때 문제점을 다시 확인해보자
문제점
1. 인터페이스가 있는 경우에는 JDK 동적 프록시를 적용하고, 그렇지 않은 경우에는 CGLIB를 적용하려면 어떻게 해야할까?2. 두 기술을 함께 사용할 때 부가기능을 제공하기 위해 JDK 동적 프록시가 제공하는 InvocationHandler와 CGLIB가 제공하는 MethodInterceptor를 각각 중복으로 만들어서 관리해야할까?
Q: 인터페이스가 있는 경우에는 JDK 동적 프록시를 적용하고, 그렇지 않은 경우에는 CGLIB를 적용하려면 어떻게 해야할까?
스프링은 유사한 구체적인 기술들이 있을 때 그것들을 통합해서 일관성 있게 접근할 수 있고, 더욱 편리하게 사용할 수 있는 추상화된 기술을 제공한다.
스프링은 동적 프록시를 통합해서 편리하게 만들어주는 프록시 팩토리라는 기능을 제공한다.
이전에는 사오항에 따라서 JDK 동적 프록시를 사용하거나 CGLIB를 사용해야 했다면, 이제는 이 프록시 팩토리 하나로 편리하게 동적 프록시를 생성할 수 있다.
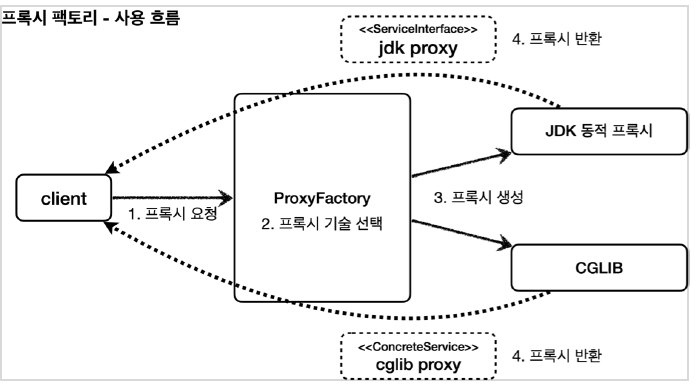
Q: 두 기술을 함께 사용할 때 부가 기능을 적용하기 위해 JDK 동적 프록시가 제공하는 InvocationHandler와 CGLIB가 제공하는 MethodInterceptor를 각각 중복으로 다로 만들어야 할까?
스프링은 이 문제를 해결하기 위해 부가 기능을 적용할 때 Advice라는 새로운 개념을 도입했다. 개발자는 InvocationHandler나 MethodInterceptor를 신경쓰지 않고, Advice만 만들면 된다. 결과적으로 InvocationHandler나 MethodInterceptor는 Advice를 호출하게 된다.
프록시 팩토리를 사용하면 Advice를 호출하는 전용 InvocationHandler, MethodInterceptor를 내부에서 사용한다.
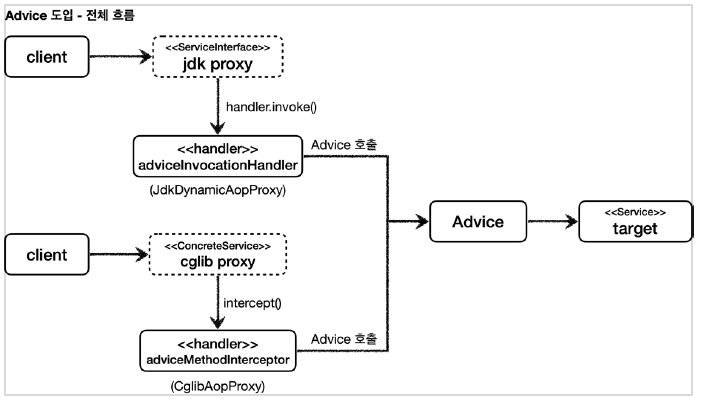
그럼 이제 Advice에 대해 알아보자
Advice는 프록시에 적용하는 부가 기능 로직이다. 이것은 JDK 동적 프록시가 제공하는 InvocationHandler와 CGLIB가 제공하는 MethodInterceptor의 개념과 유사하다. 둘을 개념적으로 추상화 한 것이다. 프록시 팩토리를 사용하면 둘 대신에; Advice를 사용하면 된다.
Advice를 만드는 방법은 여러가지가 있지만, 기본적인 방법은 다음 인터페이스를 구현하면 된다.
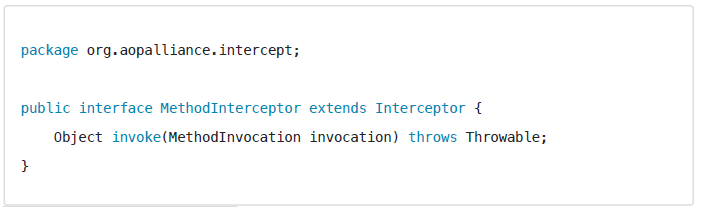
-MethodInvocation invocation : 내부에는 다음 메서드를 호출하는 방법, 현재 프록시 객체 인스턴스, args, 메서드 정보등이 포함되어 있다. 기존에 파라미터로 제공되는 부분들이 이 안으로 모두 들어갔다고 생각하면 된다.
-CGLIB의 MethodInterceptor와 이름이 같으므로 패키지 이름에 주의하자. 참고로 여기서 사용하는 org.aopalliance.intercept 패키지는 스프링 AOP 모듈 안에 들어있다.
이제 Advice를 만들어보자
@Slf4j
public class TimeAdvice implements MethodInterceptor {
@Override
public Object invoke(MethodInvocation invocation) throws Throwable {
log.info("TimeProxy 실행");
long startTime = System.currentTimeMillis();
// Object result = method.invoke(target, args);
Object result = invocation.proceed();
long endTime = System.currentTimeMillis();
long resultTime = endTime - startTime;
log.info("TimeProxy 종료 resultTime = {}", resultTime);
return result;
}
}
Object result = invocation.proceed()
invocation.proceed()를 호출하면 target 클래스를 호출하고 그 결과를 받는다. 그런데 기존에 보았던 코드들과 다르게 target 클래스의 정보가 보이지 않는다. target클래스의 정보는 MethodInvocation invocation안에 모두 포함되어 있다.
그 이유는 바로 다음에 확인할 수 있는데, 프록시 팩토리로 프록시를 생성하는 단계에서 이미 target정보를 파라미터로 전달받기 때문이다.
그럼 정말 인터페이스가 있으면 JDK 동적프록시를 없으면 CGLIB를 사용하는지 예제를 통해 알아보자
ServiceInterface.java
public interface ServiceInterface {
void save();
void find();
}
ServiceImpl.java
@Slf4j
public class ServiceImpl implements ServiceInterface {
@Override
public void save() {
log.info("save 호출");
}
@Override
public void find() {
log.info("find 호출");
}
}
@Test
@DisplayName("인터페이스가 있으면 JDK 동적 프록시 사용")
void interfaceProxy() {
ServiceInterface target = new ServiceImpl();
ProxyFactory proxyFactory = new ProxyFactory(target);
proxyFactory.addAdvice(new TimeAdvice());
ServiceInterface proxy = (ServiceInterface) proxyFactory.getProxy();
log.info("targetClass={}", target.getClass());
log.info("proxyClass={}", proxy.getClass());
proxy.save();
assertThat(AopUtils.isAopProxy(proxy)).isTrue();
assertThat(AopUtils.isJdkDynamicProxy(proxy)).isTrue();
assertThat(AopUtils.isCglibProxy(proxy)).isFalse();
}
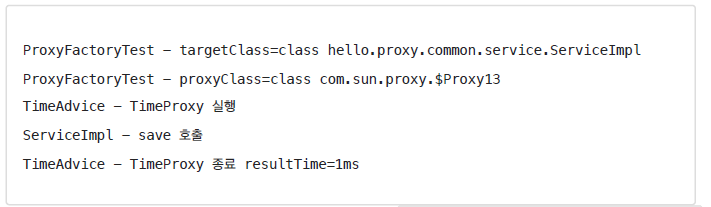
실행해보면 프록시가 정상적용된것을 확인할 수 있다. proxyClass=class com.sun.proxy.$Proxy13 코드를 통해 JDK 동적 프록시가 적용된 것도 확인할 수 있다.
인터페이스가 있을 땐 JDK 동적 프록시를 사용했다. 그럼 인터페이스가 없는 구체클래스에는 CGLIB이 동작하는지 알아보자
ConcreteService.java
@Slf4j
public class ConcreteService {
public void call() {
log.info("ConcreteService 호출");
}
}
@Test
@DisplayName("구체 클래스만 있으면 CGLIB 사용")
void concreteProxy() {
ConcreteService target = new ConcreteService();
ProxyFactory proxyFactory = new ProxyFactory(target);
proxyFactory.addAdvice(new TimeAdvice());
ConcreteService proxy = (ConcreteService) proxyFactory.getProxy();
log.info("targetClass={}", target.getClass());
log.info("proxyClass={}", proxy.getClass());
proxy.call();
assertThat(AopUtils.isAopProxy(proxy)).isTrue();
assertThat(AopUtils.isJdkDynamicProxy(proxy)).isFalse();
assertThat(AopUtils.isCglibProxy(proxy)).isTrue();
}
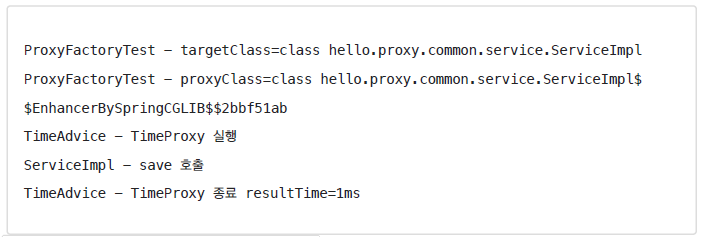
ServiceImpl$$EnhancerBySpringCGLIB...를 보면 CGLIB 기반의 프록시가 생성된 것을 확인할 수 있다.
마지막으로 인터페이스가 있지만 CGLIB를 사용해서 인터페이스가 아닌 클래스 기반으로 동적 프록시를 만들수도 있다. 프록시 팩토리는 proxyTargetClass라는 옵션을 제공하는데 이 옵션에 true 값을 넣으면 인터페이스가 있어도 강제로 CGLIB를 사용한다.
proxyFactory.setProxyTargetClass(true); 이렇게 사용하면 된다.
포인트컷, 어드바이스, 어드바이저
이 포스팅은 인프런 김영한 님의 스프링 핵심 원리 고급 편을 보고 각색한 포스팅입니다. 자세한 내용은 강의를 확인해주세요
포인트컷 : 어디에 부가 기능을 적용할지, 어디에 부가 기능을 적용하지 않을지 판단하는 필터링 로직이다. 주로 클래스와 메서드 이름으로 필터링한다. 이름 그대로 어떤 포인트에 기능을 적용할지 하지 않을지 잘라서 구분하는 것이다.
어드바이스 : 이전 포스팅에서 본 것 처럼 프록시가 호출하는 부가 기능이다. 단순하게 프록시 로직이라 생각하면 된다.
어드바이저 : 단순하게 하나의 포인트컷과 하나의 어드바이스를 가지고 있는 것이다. 쉽게 이야기해서 포인트컷1 + 어드바이스1이다.
정리하면 부가 기능 로직을 적용해야 하는데, 포인트컷으로 어디에 적용할지를 선택하고, 어드바이스로 어떤 로직을 적용할지 선택하는 것이다. 그리고 어디에 어떤 로직을 모두 알고 있는 것이 어드바이저이다.
이렇게 구분한 것은 역할과 책임을 명확하게 분리한 것이다.
포인트컷은 대상 여부를 확인하는 필터 역할만 담당하고 어드바이스는 깔끔하게 부가 기능 로직만 담당한다.
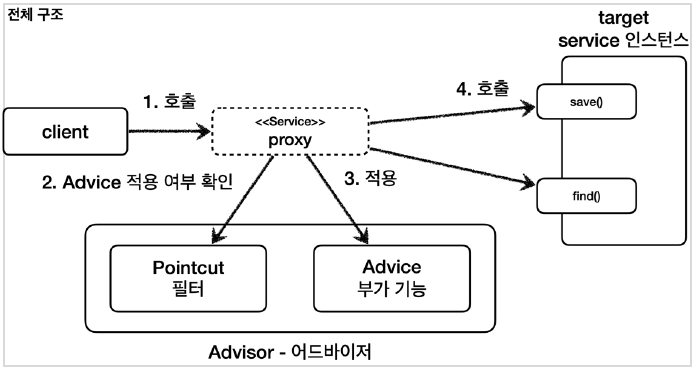
@Test
void advisorTest1() {
ServiceInterface target = new ServiceImpl();
ProxyFactory proxyFactory = new ProxyFactory(target);
DefaultPointcutAdvisor advisor = new DefaultPointcutAdvisor(Pointcut.TRUE, new TimeAdvice());
proxyFactory.addAdvisor(advisor);
ServiceInterface proxy = (ServiceInterface) proxyFactory.getProxy();
proxy.save();
proxy.find();
}
코드설명
-new DefaultPoincutAdvisor : Advisor 인터페이스의 가장 일반적인 구현체이다. 생성자를 통해 하나의 포인트컷과 하나의 어드바이스를 넣어주면 된다. 어드바이저는 하나의 포인트컷과 하나의 어드바이스로 구성된다.
-Pointcut.TRUE : 항상 true를 반환하는 포인트컷이다. 이후에 직접 포인트컷을 구현해볼 것이다.
-new TimeAdvice() : 앞선 포스팅에서 개발한 TimeAdvice 어드바이스를 제공한다.
-proxyFactory.addAdvisor(advisor) : 프록시 팩토리에 적용할 어드바이저를 지정한다. 어드바이저는 내부에 포인트컷과 어드바이스를 모두 가지고 있다. 따라서 어디에 어떤 부가 기능을 적용해야 할지 어드바이스 하나로 알 수 있다. 프록시 팩토리를 사용할 때 어드바이저는 필수이다.
이제 스프링에서 제공하는 포인트컷을 사용해보자
@Test
@DisplayName("스프링이 제공하는 포인트 컷")
void advisorTest3() {
ServiceInterface target = new ServiceImpl();
ProxyFactory proxyFactory = new ProxyFactory(target);
NameMatchMethodPointcut pointcut = new NameMatchMethodPointcut();
pointcut.setMappedName("save");
DefaultPointcutAdvisor advisor = new DefaultPointcutAdvisor(pointcut, new TimeAdvice());
proxyFactory.addAdvisor(advisor);
ServiceInterface proxy = (ServiceInterface) proxyFactory.getProxy();
proxy.save();
proxy.find();
}
NameMatchMethodPointcut을 선언하고 setMappedName으로 메서드 이름을 지정하면 포인트컷이 완성된다.
스프링은 무수히 많은 포인트컷을 제공하는데 대표적인 몇가지만 알아보자
-NameMatchMethodPoincut : 메서드 이름을 기반으로 매칭한다. 내부에서는 PatternMatchUtils를 사용한다.
-JdkRegexpMethodPointcut : JDK 정규 표현식을 기반으로 포인트컷을 매칭한다.
-TruePointcut : 항상 참을 반환한다.
-AnnotationMatchingPointcut : 어노테이션 기반으로 맻이한다.
-AspectJExpressionPointcut : aspectJ 표현식으로 매칭한다.
이 중 가장 중요한것은 AspectJExpressionPointcut이다. 실무에서는 사용하기도 편리하고 기능도 가장 많기 때문이다. aspectJ 표현식과 사용방법은 중요해서 이후 AOP를 포스팅할때 다시 자세히 설명하겠다.
여러 어드바이저를 함께 적용
어드바이저는 하나의 포인트컷과 하나의 어드바이스를 가지고 있다. 만약 여러 어드바이저를 하나의 target에 적용하려면 어떻게 해야 할까? 쉽게 이야기해ㅑ서 하나의 target에 여러 어드바이스를 적용하려면 어떻게 해야할까?
@Test
@DisplayName("하나의 프록시, 여러 어드바이저")
void multiAdvisorTest2() {
//client -> proxy -> advisor2 -> advisor1 -> target
DefaultPointcutAdvisor advisor1 = new DefaultPointcutAdvisor(Pointcut.TRUE, new Advice1());
DefaultPointcutAdvisor advisor2 = new DefaultPointcutAdvisor(Pointcut.TRUE, new Advice2());
//프록시 1 생성
ServiceInterface target = new ServiceImpl();
ProxyFactory proxyFactory1 = new ProxyFactory(target);
proxyFactory1.addAdvisor(advisor2);
proxyFactory1.addAdvisor(advisor1);
ServiceInterface proxy1 = (ServiceInterface) proxyFactory1.getProxy();
proxy1.save();
}
프록시팩토리에서 제공하는 addAdvisor를 사용하면 된다.
이 코드를 그림으로 설명하면 다음과 같다.
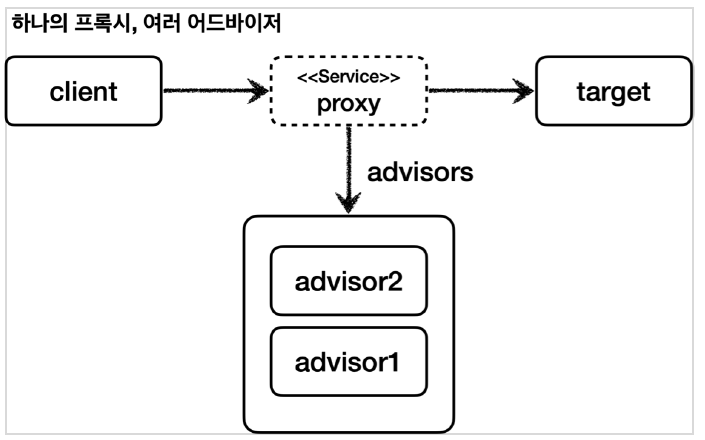
빈 후처리기
이 포스팅은 인프런 김영한 님의 스프링 핵심 원리 고급 편을 보고 각색한 포스팅입니다. 자세한 내용은 강의를 확인해주세요
빈 후처리기란 무엇일까?
스프링이 빈 저장소에 등록할 목적으로 생성한 객체를 빈 저장소에 등록하기 직전에 조작하는 기능이다.
그림으로 간단하게 알아보자
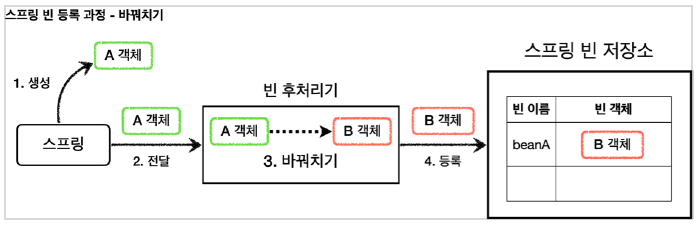
1. A객체를 생성하고
2. A객체를 빈 후처리기에 전달한다.
3. A객체를 B객체로 바꿔치기하고
4. 스프링 빈 저장소에 B객체를 저장한다.
이해를 돕기위해 예제코드로 살펴보자
public class BasicTest {
@Test
void basicConfig() {
ApplicationContext applicationContext = new AnnotationConfigApplicationContext(BasicConfig.class);
//A는 빈으로 등록된다.
A a = applicationContext.getBean("beanA", A.class);
a.helloA();
//B는 빈으로 등록되지 않는다.
Assertions.assertThrows(NoSuchBeanDefinitionException.class, () -> applicationContext.getBean(B.class));
}
@Slf4j
@Configuration
static class BasicConfig {
@Bean(name = "beanA")
public A a() {
return new A();
}
}
@Slf4j
static class A {
public void helloA() {
log.info("hello A");
}
}
@Slf4j
static class B {
public void helloB() {
log.info("hello B");
}
}
}
A객체와 B객체를 하나씩 만들고 A객체를 빈으로 등록했다. 그럼 A는 빈으로 등록되고 B는 등록되지 않는다. 당연한 결과이다.
이제 A객체가 저장되는것 대신 B객체를 저장해보자
A객체 대신 B객체를 저장하려면 빈 후처리기를 사용해야 하는데 빈 후처리기를 사용하는 방법은 다음과 같다.
1. BeanPostProcessor 인터페이스를 구현하고 스프링 빈으로 등록한다.
2. postProcessBeforeInitialization 혹은 postProcessAfterInitialization을 구현한다.
-postProcessBeforeInitialization : 객체 생성 이후에 @PostConstruct같은 초기화가 발생하기 전에 호출되는 포스트 프로세스이다.
-postProcessAfterInitialization : 객체 생성 이후에 @PostConstruct같은 초기화가 발생한 다음에 호출되는 포스트 프로세스이다.
public class BeanPostProcessorTest {
@Test
void basicConfig() {
ApplicationContext applicationContext = new AnnotationConfigApplicationContext(BeanPostProcessorConfig.class);
//beanA 이름으로 B 객체가 빈으로 등록된다.
B b = applicationContext.getBean("beanA", B.class);
b.helloB();
//A는 빈으로 등록되지 않는다.
Assertions.assertThrows(NoSuchBeanDefinitionException.class, () -> applicationContext.getBean(A.class));
}
@Slf4j
@Configuration
static class BeanPostProcessorConfig {
@Bean(name = "beanA")
public A a() {
return new A();
}
@Bean
public AToBPostProcessor helloPostProcessor() {
return new AToBPostProcessor();
}
}
@Slf4j
static class A {
public void helloA() {
log.info("hello A");
}
}
@Slf4j
static class B {
public void helloB() {
log.info("hello B");
}
}
@Slf4j
static class AToBPostProcessor implements BeanPostProcessor {
@Override
public Object postProcessAfterInitialization(Object bean, String beanName) throws BeansException {
log.info("beanName = {} bean = {}", beanName, bean);
if (bean instanceof A) {
return new B();
}
return bean;
}
}
}
BeanPostProcessor를 구현한 부분을 잘 보면 인자값으로 bean과 beanName이 들어오고 bean이 A의 인스턴스이면 B객체를 리턴하여 스프링 빈에 등록하는 모습을 볼 수 있다. A인스턴스가 아니라면 그냥 bean을 리턴한다.
이제 실제로 적용해보자
PackageLogTracePostProcessor.java
@Slf4j
public class PackageLogTracePostProcessor implements BeanPostProcessor {
private final String baskPackage;
private final Advisor advisor;
public PackageLogTracePostProcessor(String baskPackage, Advisor advisor) {
this.baskPackage = baskPackage;
this.advisor = advisor;
}
@Override
public Object postProcessAfterInitialization(Object bean, String beanName) throws BeansException {
log.info("param beanName = {} bean = {}", beanName, bean.getClass());
//프록시 적용 대상 여부 체크
//프록시 적용 대상이 아니면 원본을 그대로 진행
String packageName = bean.getClass().getPackageName();
if (!packageName.startsWith(baskPackage)) {
return bean;
}
//프록시 대상이면 프록시를 만들어서 반환
ProxyFactory proxyFactory = new ProxyFactory(bean);
proxyFactory.addAdvisor(advisor);
Object proxy = proxyFactory.getProxy();
log.info("create proxy : target={} proxy={}", bean.getClass(), proxy.getClass());
return proxy;
}
}
이 객체는 원본 객체를 프록시 객체로 변환하는 역할을 한다. 이때 프록시 팩토리를 사용하는데 프록시 팩토리는 어드바이저가 필요하기 때문에 이 부분은 외부에서 주입받도록 했다.
모든 스프링 빈들에 프록시를 적용할 필요는 없다. 여기서는 특정 패키지와 그 하위에 위치한 스프링 빈들만 프록시를 적용한다. 여기서는 hello.proxy.app과 관련된 부분에만 적용하면 된다. 다른 패키지의 객체들은 원본 객체를 그대로 반환한다.
프록시 적용 대상의 반환 값을 보면 원본 객체 대신에 프록시 객체를 반환한다. 따라서 스프링 컨테이너에 원본 객체 대신에 프록시 객체가 스프링 빈으로 등록된다. 원본 객체는 스프링 빈으로 등록되지 않는다.
@Slf4j
@Configuration
@Import({AppV1Config.class, AppV2Config.class})
public class BeanPostProcessorConfig {
@Bean
public PackageLogTracePostProcessor logTracePostProcessor(LogTrace logTrace) {
return new PackageLogTracePostProcessor("hello.proxy.app", getAdvisor(logTrace));
}
private Advisor getAdvisor(LogTrace logTrace) {
//pointcut
NameMatchMethodPointcut pointcut = new NameMatchMethodPointcut();
pointcut.setMappedNames("request*", "order*", "save*");
//advice
LogTraceAdvice advice = new LogTraceAdvice(logTrace);
return new DefaultPointcutAdvisor(pointcut, advice);
}
}
이제 프록시를 생성하는 코드가 설정 파일에는 필요 없다. 순수한 빈 등록만 고민하면 된다. 프록시를 생성하고 프록시를 스프링 빈으로 등록하는 것은 빈 후처리기가 모두 처리해준다.
@Aspect
이 포스팅은 인프런 김영한 님의 스프링 핵심 원리 고급 편을 보고 각색한 포스팅입니다. 자세한 내용은 강의를 확인해주세요
스프링은 @Aspect 어노테이션으로 매우 편리하게 포인트컷과 어드바이스로 구성되어 있는 어드바이저 생성 기능을 지원한다.
바로 사용방법을 알아보자
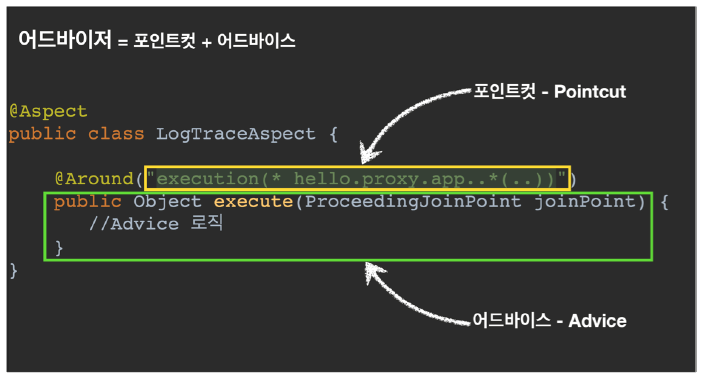
1. 사용할 클래스에 @Aspect를 붙여준다.
2. 적용할 Advice에 @Around를 붙여준다 Around는 포인트컷이 된다.
3. 반환 타입은 Object 인자값으로 ProceedingJoinPoint를 넣어서 Advice로직을 만든다.
이어서 @Aspect를 어드바이저로 변환해서 저장하는 과정을 알아보자
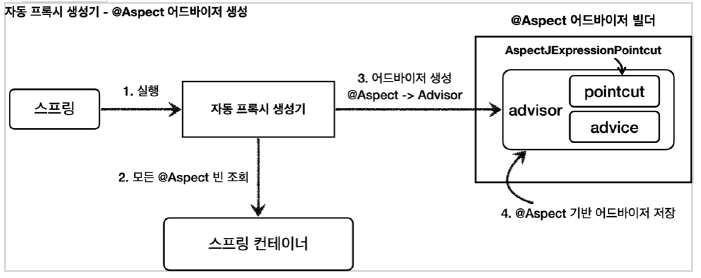
1. 실행 : 스프링 애플리케이션 로딩 시점에 자동 프록시 생성기를 호출한다.
2. 모든 @Aspect 빈 조회 : 자동 프록시 생성기는 스프링 컨테이너에서 @Aspect 언노테이션이 붙은 스프링빈을 모두 조회한다.
3. 어드바이저 생성 : @Aspect 어드바이저 빌더를 통해 @Aspect 어노테이션 정보를 기반으로 어드바이저를 생성한다.
4. @Aspect 기반 어드바이저 저장 : 생성한 어드바이저를 @Aspect 어드바이저 빌더 내부에 저장한다.
어드바이저를 기반으로 프록시를 생성하는 과정을 알아보자
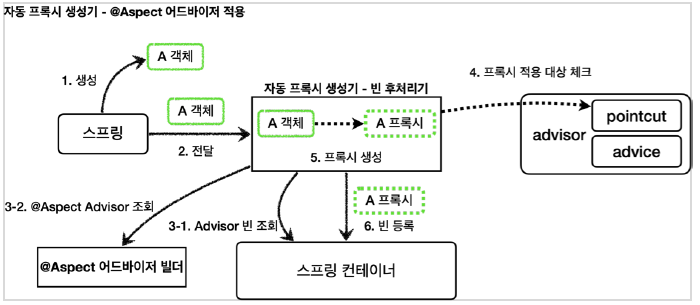
1. 생성 : 스프링 빈 대상이 되는 객체를 생성한다. (@Bean, 컴포넌트 스캔 모두 포함)
2. 전달 : 생성된 객체를 빈 저장소에 등록하기 직전에 빈 후처리기에 전달한다.
3-1. Advisor 빈 조회 : 스프링 컨테이너에서 Advisor 빈을 모두 조회한다.
3-2. @Aspect Advisor 조회 : @Aspect 어드바이저 빌더 내부에 저장된 Advisor를 모두 조회한다.
4. 프록시 적용 대상 체크 : 앞서 3-1, 3-2에서 조회한 Advisor에 포함되어 있는 포인트컷을 사용해서 해당 객체가 프록시를 적용할 대상인지 아닌지 판단한다. 이때 객체의 클래스 정보는 물론이고 해당 객체의 모든 메서드를 포인트컷에 하나하나 모두 맻이해본다. 그래서 조건이 하나라도 만족하면 프록시 적용 대상이 된다.
5. 프록시 생성 : 프록시 적용 대상이면 프록시를 생성하고 프록시를 반환한다. 그래서 프록시를 스프링 빈으로 등록한다. 만약 프록시 적용 대상이 아니라면 원본 객체를 반환해서 원본 객체를 스프링 빈으로 등록하낟.
6. 빈 등록 : 반환된 객체는 스프링 빈으로 등록된다.
스프링 AOP - 포인트컷
이 포스팅은 인프런 김영한 님의 스프링 핵심 원리 고급 편을 보고 각색한 포스팅입니다. 자세한 내용은 강의를 확인해주세요
지금부터 포인트컷 표현식을 포함한 포인트컷에 대해서 알아보자
스프링AOP에서 제공하는 포인트컷은 꽤 많다.
1. execution
2. within
3. args
4. this
5. target
6. @target
7. @within
8. @annotation
9. @args
10. bean
우리는 이중에서 자주 사용되는 1. execution, 8. @annotation에 대해서 알아볼 것이다.
execution
먼저 execution의 문법을 살펴보자
execution은 메서드 실행 조인 포인트를 매칭하기 때문에 메서드의 정보를 적어준다.
execution(접근제어자? 반환타입 선언타입?메서드이름(파라미터) 예외?)
-?는 생략할 수 있다.
-*같은 패턴을 지정할 수 있다.
이제 하나씩 뜯어보자
접근제어자 : public private protected와 같은 접근지정자를 말한다.
반환타입 : 해당 메서드의 반환 타입이 무엇인지 적는 것이다. (String, Integer, Object)
선언타입 : 해당 메서드의 패키지를 적는다.
메서드이름 : 해당 메서드의 이름을 적는다.
파라미터 : 메서드에 달려있는 파라미터의 정보를 적는다.
예외 : 해당 메서드의 예외를 적는다.
Ex) "execution(public String hello.aop.member.MemberServiceImpl.hello(String))"
public : 접근제어자
String : 반환타입
hello.aop.member.MemberServiceImpl : 선언타입 (패키지이름)
hello : 메서드이름
String : 파라미터
예외 생략
변형
* (별) 을 이용한 패턴을 넣을 수도 있다.
Ex) "execution(public String hello.aop.member.MemberServiceImpl.*(String))"
뜻 : 접근제어자가 public이고 반환타입이 String이며 패키지명이 hello.aop.member.MemberServiceImpl인 그아래 하위 모든 메서드중 파라미터 타입이 String인 것에 대해 어드바이스를 적용하겠다.
cf) 아직 포인트컷, 어드바이스, 어드바이저에 대해 아리송하다면 해당 포스팅을 복습하고 오자
https://coding-review.tistory.com/97
*을 이용한 패턴에 이런 것도 가능하다.
Ex) "execution(public String hello.aop.member.MemberServiceImpl.*llo(String)
이렇게 되면 *llo인 hello가 적용대상이 된다.
또한 파라미터 속성에 .. (점점) 을 사용할 수도 있다.
파라미터 속성에 ..이 들어간다는 것은 파라미터가 아예 없는 메서드부터 여러개인 메서드까지 모두 어드바이스의 대상이 된다는 것이다.
Ex) "execution(* *(..))"
뜻 : 반환타입이 어떤것이든 상관없으며 메서드이름이 어떤것이든 상관없고 파라미터로 어떤 값이 넘어와도 상관없다.
즉 모든 메서드에 어드바이스를 적용하겠다. 라는 뜻
특징
execution에서는 부모 타입을 선언해도 자식 타입이 매칭된다. 다형성에서 부모타입 = 자식타입이 할당 가능하다는 점을 떠올려보면 된다.
즉, "execution(public String hello.aop.member.MemberService.hello(..))" 이렇게 사용해도 된다는 것이다. MemberService는 MemberServiceImpl에 부모이기 때문에 매칭이 가능하다.
하지만 부모에 선언되어있는 메서드만 매칭이 된다.
이것이 무슨 말이냐하면 MemberService에 hello가 선언되어있고 MemberServiceImpl에 hello를 구현했다고 하면 hello만 가능하고 다른 MemberServiceImpl에만 있는 메서드는 매칭이 안된다는 것이다.
execution는 파라미터 매칭 규칙이 있다.
(String) : 정확하게 String 타입 파라미터만 매칭
() : 파라미터가 없는 메서드에 매칭
(*) : 정확히 하나의 파라미터에 매칭, 단 모든 타입을 허용한다.
(*, *) : 정확히 두개의 파라미터에 매칭, 단 모든 타입을 허용한다.
(..) : 숫자와 무관하게 모든 파라미터, 모든 타입을 허용한다. 참고로 파라미터가 없어도 된다.
(String, ..) : String 타입으로 시작해야 하고 숫자와 무관하게 모든 파라미터 모든 타입을 허용한다. ( Ex) (String, Integer) / (String, Object) / (String, Integer, Object) 등등..)
@annotation
@annotation은 메서드가 주어진 어노테이션을 가지고 잇는 조인 포인트를 매칭하는 것이다.
쉽게 얘기해서 매칭하고싶은 어노테이션이 있는 것만 어드바이스를 적용하고 싶을 때 사용한다.
Ex) @Trace라는 어노테이션을 만들고 @Trace 어노테이션이 붙어있는 메서드나 클래스에 한해서 로그를 찍을 것이다.
문법
"@annotation(선언타입.어노테이션이름)"
선언타입 = 패키지명
Ex) "@annotation(hello.aop.member.annotation.MethodAop)"
참고) 파라미터 바인딩
파라미터 바인딩을 통해 해당 어노테이션의 값을 사용할 수 있다.
@Before("@annotation(annotation)")
public void atAnnotation(JoinPoint joinPoint, MethodAop annotation) {
log.info("[@annotation]{}, annotationValue={}", joinPoint.getSignature(), annotation.value());
}
파라미터로 바인딩 했을 경우 선언타입 어노테이션이름을 적지 않아도 된다. 여기서 주의해야 할 점은 @annotation에 들어갈 값 (annotation) 과 파라미터 이름을 동일하게 맞춰줘야 한다.
따라서 위의 예제는 아래의 예제와 같은 뜻이 된다.
@Before("@annotation(hello.aop.member.annotation.MethodAop)")
public void atAnnotation(JoinPoint joinPoint) {
log.info("[@annotation]{}, annotationValue={}", joinPoint.getSignature(), annotation.value());
}
파라미터 바인딩을 통해 어노테이션을 적으면 코드가 깔끔해짐과 동시에 어노테이션의 값을 사용할 수 있다는 장점이 있다.
여기까지 자주 사용하는 포인트컷인 execution과 @annotation에 대해서 알아보았다. 다음 포스팅에선 앞서 배웠던 것으로 실전에서 사용할만한 예제를 만들어보겠다.
스프링 AOP - 실전 예제
이 포스팅은 인프런 김영한 님의 스프링 핵심 원리 고급 편을 보고 각색한 포스팅입니다. 자세한 내용은 강의를 확인해주세요
지금까지 학습한 내용을 활용해서 유용한 스프링 AOP를 만들어보자
1. @Trace 어노테이션으로 로그 출력하기
2. @Retry 어노테이션으로 예외 발생시 재시도 하기
cf) 어? 예외 발생시 재시도 하는 로직이 왜 필요하지? 예를 들어서 API통신을 하는데 조회를 해야한다고 가정해보자 특정 시간대 혹은 특정 횟수에 한번꼴로 예외가 터지는 경우라고 생각했을 때 조회라면 예외를 무시하고 다시 재시도 하면 되는 경우가 많다. 때문에 예외 로그가 찍히는 상황을 방지하고자 조회로직에 한해서 예외 발생시 재시도 하는 로직을 만드는 것이다.
먼저 어노테이션을 만들어야한다.
Trace.java
@Target(ElementType.METHOD)
@Retention(RetentionPolicy.RUNTIME)
public @interface Trace {
}
Retry.java
@Target(ElementType.METHOD)
@Retention(RetentionPolicy.RUNTIME)
public @interface Retry {
int value() default 3;
}
이제 어드바이저를 만들어보자 이전에 배운 @Aspect, @Around, @Before를 이용하여 만들 것이다. 해당 내용이 기억나지 않는다면 아래의 포스팅을 참고하자
https://coding-review.tistory.com/99
TraceAspect.java
@Slf4j
@Aspect
public class TraceAspect {
@Before("@annotation(hello.review.exam.annotation.Trace)")
public void doTrace(JoinPoint joinPoint) {
Object[] args = joinPoint.getArgs();
log.info("[trace] {} args={}", joinPoint.getSignature(), args);
}
}
클래스레벨에 @Aspect를 적어 이 클래스가 AOP의 대상임을 명시한다. @Before를 사용해 이 어드바이스가 메서드 호출 전에 로그를 찍도록 한다. 또한 @annotation을 사용해 포인트컷을 설정해준다. 그리고 로그로 메서드정보(시그니처)와 인자값을 찍는다.
@annotation에 대해 아직 잘 모르겠다면 아래의 포스팅을 참고하자
https://coding-review.tistory.com/100
이제 예외가 터졌을 때 재시작하는 RetryAspect를 만들어보자
RetryAspect.java
@Slf4j
@Aspect
public class RetryAspect {
@Around("@annotation(retry)")
public Object doRetry(ProceedingJoinPoint joinPoint, Retry retry) throws Throwable {
log.info("[retry] {} retry={}", joinPoint.getSignature(), retry);
int maxRetry = retry.value();
Exception exceptionHolder = null;
for (int retryCount = 1; retryCount <= maxRetry ; retryCount++) {
try {
log.info("[retry] try count={}/{}", retryCount, maxRetry);
return joinPoint.proceed();
} catch (Exception e) {
exceptionHolder = e;
}
}
throw exceptionHolder;
}
}
@Aspect로 해당 클래스가 AOP의 대상이 되게 설정한 후에 @Around를 사용했다.
@Around와 @Before나 @After등의 차이는 @Around는 joinPoint.proceed()를 자유자재로 사용할 수 있다는 점이 가장 큰 차이점이다. 단순히 메서드 호출 전/후에 호출하는 것이 아니라 로직이 정해져있고 proceed를 자유롭게 설정해야 한다면 @Around를 사용하자
또한 @annotation을 파라미터 바인딩을 통해 어노테이션의 값을 사용할 수 있게 했다.
또한 exceptionHolder를 만들어서 예외가 발생되더라도 예외가 for문이 다 돌기 전까지 터지지않고 붙잡아 놓을 수 있게 해놓았다.
Retry의 디폴트 값으로 설정된 3의 값을 꺼내 for문에 반복 횟수로 넣어주었다. 이렇게 하지 않으면 계속 요청이 들어가 셀프 디도스를 만들 수 있다.
이제 위의 어노테이션과 AOP를 활용해 비즈니스 로직을 만들어보자
ExamRepository.java
@Repository
public class ExamRepository {
private static int seq = 0;
/**
* 다섯번에 한번 실패하는 요청
*/
@Trace
@Retry(value = 4)
public String save(String itemId) {
seq++;
if (seq % 5 == 0) {
throw new IllegalStateException("예외 발생");
}
return "ok";
}
}
sequence를 설정해 놓고 다섯번에 한번씩 예외가 터진다고 가정한 코드이다. 메서드에 우리가 만든 @Trace, @Retry를 달아 놓았다. 또한 Retry의 디폴트 값을 4로 변경해주었다.
ExamService.java
@Service
@RequiredArgsConstructor
public class ExamService {
private final ExamRepository examRepository;
@Trace
public void request(String itemId) {
examRepository.save(itemId);
}
}
Service는 단순히 Repository를 호출하는 역할만을 한다. 여기에는 @Trace를 달아주었다.
이제 테스트코드로 예외가 발생했을 때 재시도가 되는지, 로그가 제대로 남는지 확인해보자
@SpringBootTest
@Slf4j
@Import({TraceAspect.class, RetryAspect.class})
public class ExamTest {
@Autowired
ExamService examService;
@Test
void test() {
for (int i = 0; i < 5; i++) {
log.info("client request i={}", i);
examService.request("data" + i);
}
}
}
실행해보면 다음과 같이 나온다.
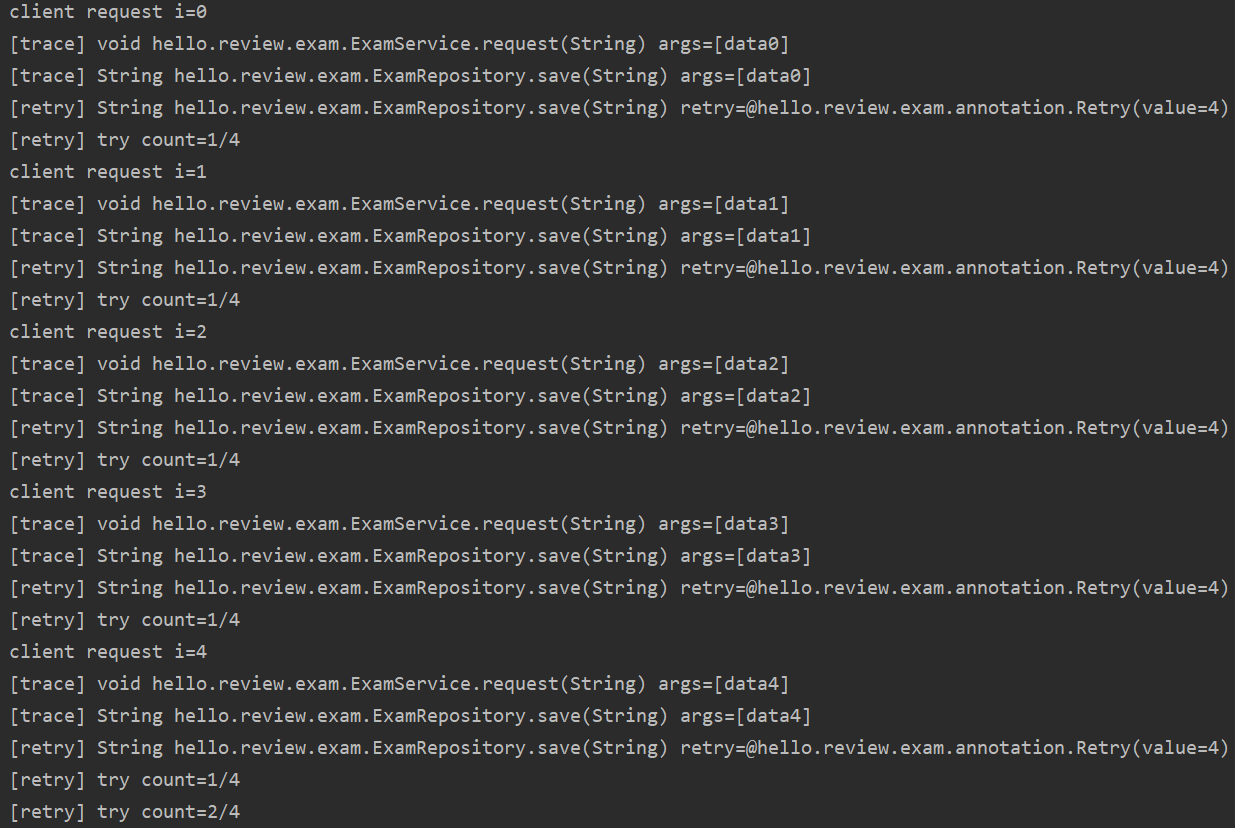
trace로그가 잘 찍히고 retry도 잘 작동되는 것을 확인할 수 있다. 다섯번에 한번씩 예외가 터지기 때문에 첫번째, 두번째, 세번째, 네번째에는 retry횟수가 한번이지만 마지막 다섯번째에 retry를 한번 더 했기 때문에 try count가 2로 늘어난 것을 확인할 수 있다.
@Target, @Retention
ElementType.ㅇ어노테이션을 만들 때 사용하는 어노테이션들이다. 어노테이션을 이용한 포인트컷을 구현할 때 등장했으며 궁금하기때문에 포스팅으로 남긴다.
구글링해보니 그렇게 어려운 내용은 아니었다.
@Target
@Target은 자신이 만든 어노테이션이 사용되게 될 자바 요소를 지정할 수 있다.
Target의 속성으로는
ElementType.ANNOTATION_TYPE
ElementType.CONSTRUCTOR
ElementType.FIELD
ElementType.LOCAL_VARIABLE
ElementType..METHOD
ElementType.PACKAGE
ElementType.PARAMETER
ElementType.TYPE
이렇게 여덟가지이다. 내가 주로 사용하게될 타겟은 메서드로 보인다. 메서드 레벨에 붙일 어노테이션은 ElementType.METHOD를 붙이면 되고 클래스 레벨에 붙일 어노테이션은 ElementType.TYPE을 붙이면 된다.
@Retention
Retention은 얼마나 오랫동안 어노테이션 정보가 유지되는지 설정할 수 있다.
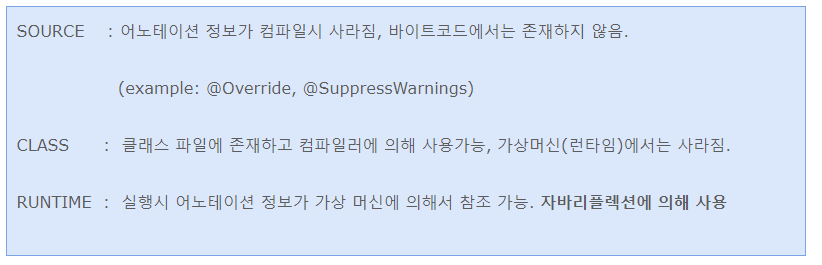
내가 자주 사용할 속성은 RUNTIME이다. 대부분의 어노테이션이 RUNTIME을 달고 있다.
커넥션 풀 (Connection pool)
*커넥션 풀
커넥션을 하는데 많은 소스가 들어간다.
1. 애플리케이션 로직이 디비 드라이버에 커넥션을 조회한다.
2. TCP/IP 커넥션 연결
3. ID, PW 부가정보 전달
4. DB내부 인증 + DB 세션 생성
5. 커넥션 생성 완료
6. 애플리케이션 로직에 커넥션 반환
근데 데이터베이스에 접근할 때마다 커넥션 객체를 만들면 메모리 누수, 시간 낭비 심함
그래서 대안이 커넥션 객체를 여러개 만들어 둔다.
-애플리케이션 로직이 디비에 커넥션 객체를 요청할 때 디비 드라이버가 커넥션을 만드는것이 아니라 이미 만들어진 커넥션 풀에서 꺼내 쓰게 된다.
근데 커넥션 객체를 여러개 만들기 위해서 커넥션 풀이란걸 만들게 되는데 각각의 커넥션 풀을 구현해놓은 것들 마다 사용법이 조금씩 다른 현상이 생겼다. 그래서 커넥션 풀을 바꿀 때마다 애플리케이션 로직이 변경되는 현상 발생
그래서 이들을 모두 추상화 한것이 바로 데이터소스(DataSource)라는 인터페이스이다.
데이터소스는 커넥션을 획득하는 방법을 추상화 하는 인터페이스이다.
트랜잭션과 @Transactional
*트랜잭션
트랜잭션은 더 이상 쪼갤 수 없는 작업의 최소 단위를 의미한다. 즉 여러 작업을 진행하다가 문제가 생겼을 경우 롤백하기 위해 트랜잭션을 다누이로서 사용할 수 있다. 트랜잭션에는 commit, rollback 두 가지 경우가 존재한다. 모두 성공하여 commit되거나 하나라도 실패하면 rollback되는 것이다.
Spring에서 제공하는 Transaction 기능
1. 트랜잭션 동기화
2. 트랜잭션 추상화
3. 트랜잭션 분리
1. 트랜잭션 동기화
개발자들이 JDBC의 모든 커넥션을 하나의 트랜잭션으로 관리하기 위한 작업을 직접 수행한다면 매우 번거로울 것이다. Spring에서는 이러한 문제를 해결하고자 트랜잭션 동기화 기술을 지원한다. 즉, 트랜잭션을 시작하기 위한 자원을 특별한 저장소에 보관해두고 꺼내쓸 수 있도록 한다.
하지만 이 기술은 JDBC에 종속적이기 때문에 이를 해결하기 위해 트랜잭션 추상화가 등장했다.
2. 트랜잭션 추상화
애플리케이션에서 사용할 수 있는 기술마다 종속적인 코드를 이용하지 않고도 일관되게 트랜잭션을 처리할 수 있도록 트랜잭션 추상화를 지원한다.
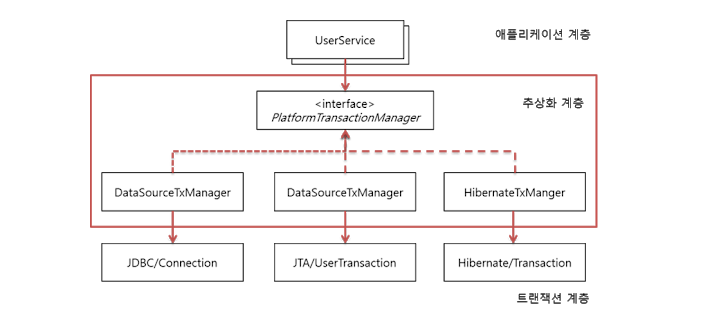
Spring이 제공하는 트랜잭션 경계 설정을 위한 추상 인터페이스는 PlatformTransactionManager이다. 이를 통해 사용하는 기술과 무관하게 트랜잭션을 공유 / 커밋 / 롤백할 수 있게 되었다.
하지만 비즈니스 코드와 트랜잭션 코드가 결합되는 것은 피하지 못했다.
public void updateMember(Member member) {
TransactionStatus status = this.transactionManager.getTransaction(new DefaultTransactionDefinition());
try {
if (validateMember(member)) {
memberRepository.save(member);
}
this.transactionManager.commit(status);
} catch (Exception e) {
this.transactionManager.rollback(status);
throw e;
}
}
위 코드처럼 비즈니스 코드와 트랜잭션 코드가 결합되어 메서드 내에서 2가지 책임을 갖고 있게 되었다. 따라서 Spring에서는 트랜잭션 부분을 핵심 비즈니스 로직과 분리하였다.
3. 트랜잭션 분리
트랜잭션과 핵심 비즈니스 로직을 분리하기 위해 선언적 트랜잭션 @Transactional을 지원하게 되었다. @Transactional은 스프링 AOP에 의해 만들어진 어노테이션이고 스프링이 프록시패턴을 이용해 만든 어노테이션이다.
프록시 패턴이란?
https://coding-review.tistory.com/94
그래서 만들어진 코드가 바로 아래의 코드이다.
@Transactional
public void updateMember(Member member) {
if (validateMember(member)) {
memberRepository.save(member);
}
}
이렇게 트랜잭션과 비즈니스 코드를 분리하는 작업까지 끝났다.
Spring에서 예외를 관리하는 방법 (@ControllerAdvice, @ExceptionHandler)
https://coding-review.tistory.com/148
CheckedException, UncheckedException에 대해 공부하다가 김영한님의 강의 "데이터베이스 접근기술 1편"을 다시 보면서 "체크 예외를 쓰기 보다는 런타임 예외를 쓰고 런타임 예외에 대한 로그를 남기고 개발자가 해당 오류를 빠르게 인지하는 것이 필요하다. 서블릿 필터, 스프링의 인터셉터, 스프링의 ControllerAdvice를 사용하면 이런 부분을 깔끔하게 공통으로 해결할 수 있다." 라는 문장을 발견했다.
서블릿의 필터, 스프링의 인터셉터 모두 사용해봤지만 스프링의 ControllerAdvice는 한번도 써본 적이 없다. 이 기회에 한번 써보고 포스팅을 해보려고 한다.
예외 처리 과정
프로그래밍에서 예외 처리는 아주 중요하면서도 아주 어렵다. 과하다할만큼 상세하고 다양하게 예외를 잡아 처리해준다면, 클라이언트도 그렇고 서버도 그렇고 더 안정적인 프로그램이 될 수 있게 도와준다.
예외를 처리하는 경우와 방법은 다양하다.
• 메서드 내에서 예외 상황을 예측해서 처리하는 try-catch문을 이용하는 방법
• 요구사항에 의한 예외 처리 (ex. validation > 특정 값이 0~255 범위가 아니라면 유효하지 않은 값으로 판단하고 예외처리)
• 스프링 시큐리티에서 인터셉터로 잡아서 UnauthorizedException 같은 예외 처리
기타 여러 예외 처리들을 적용하다 보면 코드가 엄청나게 복잡해진다. if문으로 잡던 try-catch문으로 잡던 상위 메서드로 예외처리를 위임하던 코드는 복잡해진다.
그렇게 되면 유지보수 하기가 아주 어려워진다. 비즈니스 로직에 집중하기 어렵고, 비즈니스 로직과 관련된 코드보다 예외를 처리하기 위한 코드가 더 많아지는 경우도 생긴다.
이러한 문제를 조금이라도 개선하기 위해 @ControllerAdvice, @ExceptionHandler를 사용한다고 보면 이해하기가 쉬워진다.
@ExceptionHandler
@ExceptionHandler 같은 경우는 @Controller, @RestController가 적용된 Bean 내에서 발생하는 예외를 잡아서 하나의 메서드에서 처리해주는 기능을 한다.
@RestController
public class MyRestController {
...
...
@ExceptionHandler(NullPointerException.class)
public Object nullex(Exception e) {
System.err.println(e.getClass());
return "myService";
}
}
위와 같이 적용하기만 하면 된다. @ExceptionHandler라는 어노테이션을 쓰고 인자로 캐치하고 싶은 예외 클래스를 등록해주면 끝난다.
cf) @ExceptionHandler({ Exception1.class, Exception2.class }) 이런식으로 두 개 이상 등록도 가능하다.
위의 예제에서 처럼 하면 MyRestController에 해당하는 Bean 내에서 NullPointerException이 발생한다면 @ExceptionHandler가 적용된 메서드가 호출될 것이다.
주의사항 / 알아둘 것
• Controller, RestController에만 적용 가능하다. (@Service같은 빈에서는 안됨)
• 리턴 타입은 자유롭게 해도 된다. (Controller 내부에 있는 메서드들은 여러 타입의 response를 할 것이다. 해당 타입과 전혀 다른 리턴 타입이어도 상관없다.)
• @ExceptionHandler를 등록한 Controller엣만 적용된다. 다른 Controller에서 NullPointerException이 발생하더라도 예외를 처리할 수 없다.
• 메서드의 파라미터로 Exception을 받아왔는데 이것 또한 자유롭게 받아와도 된다.
@ControllerAdvice
@ExceptionHandler가 하나의 클래스에 대한 것이라면, @ControllerAdvice는 모든 @Controller 즉, 전역에서 발생할 수 있는 예외를 처리해주는 어노테이션이다.
@ControllerAdvice
public class MyAdvice {
@ExceptionHandler(CustomException.class)
public String custom() {
return "hello custom";
}
}
위와 같이 새로운 클래스 파일을 만들어서 어노테이션을 붙이기만 하면 된다. 그 다음에 ExceptionHandler로 처리하고 싶은 예외를 잡아 처리하면 된다. 별도의 속성값 없이 사용하면 모든 패키지 전역에 있는 컨트롤러를 담당하게 된다.
@RestControllerAdvice와 @ControllerAdvice가 존재하는데 @RestControllerAdvice 어노테이션을 들여다보면 아래와 같이 되어있다.
@Target(ElementType.TYPE)
@Retention(RetentionPolicy.RUNTIME)
@Documented
@ControllerAdvice
@ResponseBody
public @interface RestControllerAdvice {
//...
}
@ControllerAdvice와 동일한 역할 즉, 예외를 잡아 핸들링 할 수 있도록 하는 기능을 수행하면서 @ResponseBody를 통해 객체를 리턴할 수도 있다는 얘기이다.
ViewResolver를 통해서 예외 처리 페이지로 리다이렉트 시키려면 @ControllerAdvice만 써도 되고, API서버여서 에러 응답으로 객체를 리턴해야 한다면 @ResponseBody 어노테이션이 추가된 @RestControllerAdvice를 적용하면 되는 것이다.
@RestController에서 예외가 발생하던 @Controller에서 예외가 발생하던 @ControllerAdvice + @ExceptionHandler 조합으로 다 캐치할 수 있고, @ResponseBody의 필요 여부에 따라 적용하면 된다는 것이다.
@RestControllerAdvice
@Slf4j
public class MemberControllerAdvice {
@ExceptionHandler(NotFoundMember.class)
public ResponseEntity notMemberFoundExceptionHandler(NotFoundMember exception) {
Map body = Map.of("status", HttpStatus.BAD_REQUEST.value(),
"error", HttpStatus.BAD_REQUEST.getReasonPhrase(),
"message", "회원을 찾을 수 없습니다.");
log.info("Exception Handler 작동중");
return ResponseEntity.status(HttpStatus.BAD_REQUEST).body(body);
}
}
@ControllerAdvice
@Slf4j
public class MemberControllerAdvice {
@ExceptionHandler(NotFoundMember.class)
public String notMemberFoundExceptionHandler(NotFoundMember exception, Model model) {
model.addAttribute("errorMessage", exception.getMessage());
log.info("Exception Handler 작동중");
return "error";
}
}
위의 두개의 예제는 각각 @ControllerAdvice, @RestControllerAdvice를 사용해 만든 예제이다. 위의 예제의 상황은 회원가입 후 로그인을 할 때 회원 객체를 찾을 수 없는 경우에 발생한 예외를 잡아서 처리한 과정이다.
@RestControllerAdvice는 API이기 때문에 ResponseEntity에 Map을 담아서 리턴한 것이고 @ControllerAdvice는 ViewResolver를 이용해 에러 페이지로 리다이렉트 한 것이다.
실무에선 어떻게?
일반적인 실무에서 어떻게 사용하는지는 사실 명확하지 않다. 무슨 얘기냐면 에러메시지로 나가는 포맷이 일정해야 한다는 이야기이다. 만약 로그인 모듈에서 발생한 예외에 응답하는 메세지는 에러코드랑 설명을 리턴해준다고 하고, 배송 모듈에서 발생한 예외는 에러코드랑 배송 번호를 리턴해준다고 하자.
그러면 @ControllerAdvice를 이용해서 통합으로 처리하려고 했지만 리턴 타입이 다르니까 통합해서 처리할 수 없다. 에러 인터페이스, 포맷이 다 같고 클라이언트 측에서도 이해하기 좋은 에러가 날라오는 것이다.
그래서 @ExceptionHandler와 함께 @ResponseStatus(value = HttpStauts.UNAUTHORIZED) 이런것도 같이 집어 넣어서 HTTP 상태코드를 리턴하기도 한다.
다시 한번 정리하지만 에러 메시지가 잘 정의되어 있어야 한다는게 전제 조건이다.
→ 에러 관리하기
public enum LoginErrorCode {
OperationNotAuthorized(6000,"Operation not authorized"),
DuplicateIdFound(6001,"Duplicate Id"),
//...
UnrecognizedRole(6010,"Unrecognized Role");
private int code;
private String description;
private LoginErrorCode(int code, String description) {
this.code = code;
this.description = description;
}
public int getCode() {
return code;
}
public String getDescription() {
return description;
}
}
보통 에러를 위와 같이 한 곳에 정리를 할 것이다. 저렇게 미리 정의해 놓고 실제 사용할 때는 이런식으로 불러와서 에러 객체를 만들어서 리턴할 것이다.
LoginErrorCode.OperationNotAuthorized.getCode();
그러면 1차적으로 에러 객체 관리는 위와 같은 방법으로 끝난다.
그 다음에 위에서 말한 @ControllerAdvice, @ExceptionHandler를 이용해서 에러를 처리하면 된다.
@Async 어노테이션
꽤 전에 동기 비동기 프로그래밍에 대해서 이론적으로 학습하고 최근에 실습할 기회가 생겼습니다.
SMTP를 이용해 2차인증을 요구하는 서비스를 개발하는데 SMTP가 동기 네트워킹이라 사용자가 이메일이 날아가는 3~4초정도를 손놓고 가만히 기다려야 하는 상황이 발생했습니다.
이를 비동기 통신으로 바꾸면 좋겠다는 생각이 들어서 찾아보니 @Async를 적용하면 동기 통신을 비동기 통신으로 바꿔준다는 소리를 들었습니다.
@Async
@Async는 스프링 AOP에 의해 동작하는 프록시 패턴 중 하나입니다. 해당 포스팅에선 프록시 패턴이 어떤 것인지는 다루지 않겠습니다.
@Async가 설정된 메서드에 접근하면 프록시가 중간에서 샥 하고 가로채서 메인 스레드가 아닌 서브 스레드에 할당합니다.
그렇기 때문에 @Async가 작동하기 위해서 몇가지 조건이 필요합니다.
우선 결론부터 말하자면 @Async가 붙은 메서드가 public 타입이어야 한다는 것과 self-invocation (직접 호출) 을 피해야 합니다.
이 두가지 조건에 특징이 있습니다. 바로 프록시 패턴이 작동하기 위한 조건이기 때문입니다.
1. 프록시도 결국은 클래스다.
프록시 객체도 결국은 스프링이 만든 클래스입니다. 이 프록시 객체가 Async가 붙은 메서드를 찾으려면 메서드가 private 하면 안되겠죠.
때문에 @Async의 메서드는 반드시 public이어야 합니다.
2. 직접 호출은 스프링의 도움을 받지 못한다.
여기서 말하는 직접 호출은 같은 클래스에서 직접적으로 호출하는 방법을 의미합니다.
public void semdMail(string to, String subject) {
send(to, subject);
}
@Async
public void send(String to, String subject) {
// 이메일 보내는 로직
}
이러한 방법과 비슷한 방법이 있습니다. 바로 동적으로 객체를 생성해서 호출하는 방식입니다.
public void sendMail(String to, String subject) {
EmailSender mailSender = new EmailSender();
mailSender.send(to, subject);
}
@Service
@RequiredArgsConstructor
public class EmailService {
private final JavaMailSender javaMailSender;
public void send(String to, String subject) {
// 메일 보내는 로직
}
}
프록시 객체를 타지 않는다는 말은 IoC의 도움을 받지 않는다는 의미이고 이는 @Async가 작동하지 않게되는 원인이 된다는 말입니다.
때문에 우리는 반드시 @Async를 이용하기 위해선 이런식으로 코드를 짜야합니다.
@RestController
@RequiredArgsConstructor
public class MailController {
private final EmailService emailService;
@GetMapping("/send")
public String send(@RequestBody EmailDto dto) {
emailService.send(dto.getTo(), dto.getSubject());
return "success";
}
}
@Service
public class EmailService {
@Async
public void send(String to, String subject) {
// 메일 보내는 로직
}
}
@Data
public class EmailDto {
private String to;
private String subject;
}
3. 메인 스레드를 사용하지 않는다? 서브 스레드를 만들어줘야한다!
앞서 @Async가 붙은 메서드를 프록시가 가로채서 서브 스레드에 할당해준다고 했는데 그렇다는 의미는 우리가 서브스레드를 직접 만들어야 한다는 의미입니다.
package com.hello.capston.config;
import lombok.extern.slf4j.Slf4j;
import org.springframework.aop.interceptor.AsyncUncaughtExceptionHandler;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
import org.springframework.scheduling.annotation.AsyncConfigurer;
import org.springframework.scheduling.annotation.EnableAsync;
import org.springframework.scheduling.concurrent.ThreadPoolTaskExecutor;
import java.util.concurrent.Executor;
@Configuration
@EnableAsync
@Slf4j
public class AsyncConfiguration implements AsyncConfigurer {
@Override
@Bean(name = "mailExecutor")
public Executor getAsyncExecutor() {
ThreadPoolTaskExecutor executor = new ThreadPoolTaskExecutor();
executor.setCorePoolSize(2);
executor.setMaxPoolSize(5);
executor.setQueueCapacity(10);
executor.setThreadNamePrefix("MailExecutor-");
executor.initialize();
return executor;
}
@Override
public AsyncUncaughtExceptionHandler getAsyncUncaughtExceptionHandler() {
return (ex, method, params) -> {
log.error("Exception handler for async method : ", method.toGenericString(), " threw unexpected exception itself", ex);
};
}
}
그런다음 @Async 어노테이션의 속성에 우리가 만든 Bean 이름을 집어넣으면 됩니다. (ex. @Async("mailExecutor"))
마치며
이렇게 @Async에 대해서 간단하게 알아보고 주의해야할 점에 대해서 알아봤습니다. 생각보다 쉽지만 막 사용하면 원하는 결과를 얻을 수 없다는 것을 깨달았습니다.
동기, 비동기 프로그래밍 방식을 아는 것은 굉장히 중요해보입니다. 동기처리를 하냐 비동기처리를 하냐의 차이 때문에 고객경험이 부정적이냐 긍정적이냐를 가를 수 있으니까요.
해당 포스팅에선 어떻게 SMTP를 비동기로 처리하냐에 대한 자세한 내용은 기술하지 않았습니다. 전반적인 @Async의 내용 그리고 주의해야할 점만을 기술했습니다.
기회가 된다면 SMTP를 비동기로 처리하는 것에 대해서 포스팅하도록 하겠습니다. 긴 글 읽어주셔서 감사합니다. 오늘도 즐거운 하루 되세요~
스프링에서 동시성 문제 해결하기
프로젝트를 고도화하는 과정에서 동시성 문제에 대해 고민하게 되었습니다.
동시성 문제... 참 쉽지 않더군요... 우선 정말 추상적이고 해결 방법도 정말 많습니다.
이번 포스팅에선 동시성 문제에 대해 짧게 서술하고 해결방안 그리고 문제점까지 확인해보도록 하겠습니다.
동시성 문제
어떤 것을 동시성 문제라고 할까요?
사실 동시성 문제는 제 포스팅에 자세히 나와있습니다. 동시성 문제에 대한 내용도 많이 기술했습니다. 아래의 링크에서 확인해주세요!
https://coding-review.tistory.com/362
https://coding-review.tistory.com/359
https://coding-review.tistory.com/354
https://coding-review.tistory.com/92
https://coding-review.tistory.com/351
이렇게 나열하고 보니까 정말 많이 썼네요...
아무튼 정말 많이 입이 닳도록 얘기한 주제이기 때문에 간단하게 짚고 넘어가겠습니다.
동시성 문제는 여러 스레드가 하나의 자원을 사용하면서 값이 꼬여버리거나 개발자가 원하는대로 동작하지 않는 현상을 말합니다.
근데 이 동시성 문제 한번쯤 고민해보신 분들은 아실겁니다. 어떤 상황에서 동시성 문제가 발생하는지 전혀 감이 안잡힙니다.
몇가지 패턴이 있는데
• 멤버변수 (전역변수) 를 선언한 경우
• Thread-safe 하지 않은 클래스를 사용한 경우
• ++, -- 와 같은 증감연산자를 사용한 경우
• 동시에 여러개의 스레드가 하나의 메서드에 접근하는 경우
대충 이정도가 있습니다. 하지만 이런 경우가 동시성 문제의 전부는 아닙니다.
저의 경우가 그러했는데요. 만약 이런 경우를 생각해봅시다. 이 예시는 제가 처한 상황이랑 100퍼센트 일치합니다.
• 온라인 쇼핑몰에서 상품 A는 재고가 1개입니다.
• 유저 A가 상품 A를 1개 결제합니다. 동시에 유저 B가 상품 A를 1개 결제합니다.
• 에이 그럴줄 알고 재고가 0이 되면 결제가 안되게 예외처리를 했죠
• 하지만 멀티 스레드라면요? 각각의 스레드가 메서드를 타면서 값이 지역적으로 바뀌게됩니다. 이는 데이터베이스 격리수준과 연관있습니다.
• 스레드 1에서의 상품 A의 재고는 유저 A에 의해 0이 되었습니다. 스레드 2에서 상품 A의 재고는 유저 B에 의해 0이 되었습니다.
• 동시에 두개가 결제됐네요? 하지만 재고는 한개인데...
• 이게 바로 중복 저장입니다.
이런 상황 충분히 가능하지 않을까요? 글로만 보면 이해가 안되니까 그림으로 이해해봅시다.
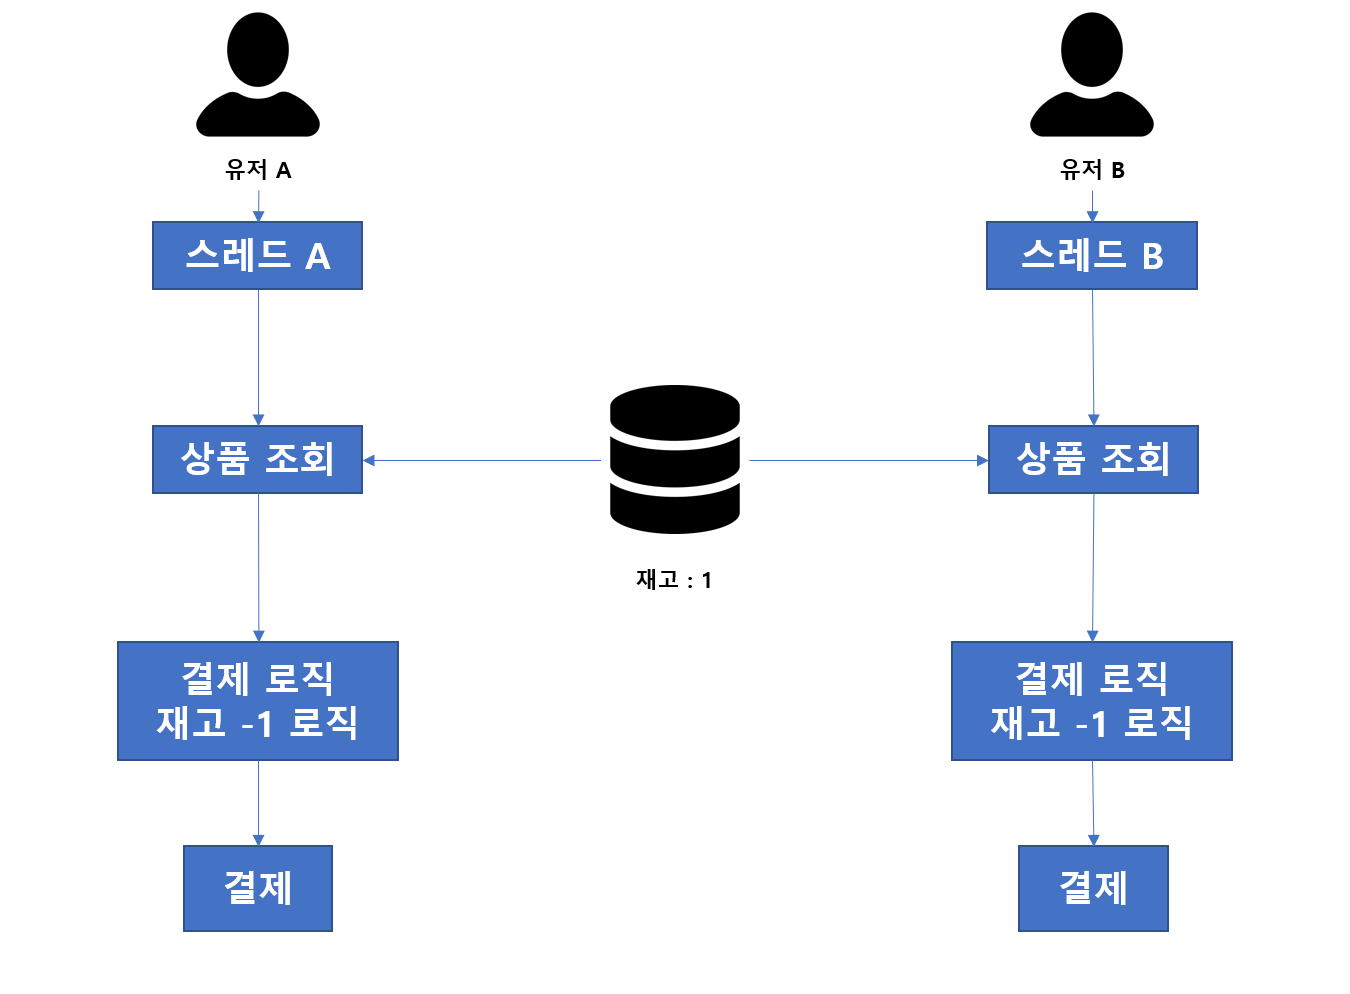
이런 상황도 동시성 문제에 들어가는 상황입니다.
이제 해결방안을 찾아봐야겠죠?
동시성 문제 해결 방안
동시성 문제를 해결하기 위한 방법은 여러가지가 있습니다. 제가 말한 상황 이외에도 다양한 상황에서 동시성 문제가 발생하고 해결할 수 있습니다.
제가 포스팅에서 소개한 내용을 간단하게 다시 소개해드리고 위의 예제에서 어떻게 해결하는지에 대해서 알아보죠!
• 불변 객체를 사용한다.
• final 변수를 사용한다.
• java.util.concurrent 클래스를 사용한다.
• Thread Local을 사용한다.
• 전역 변수의 사용을 지양한다.
• synchronized 키워드를 사용한다.
제가 알고있는 동시성 문제는 값이 꼬여버리는 상황입니다. 대부분 증감연산자를 사용해서 생기는 문제들이 그러하죠. 대표적으로 조회수 증가 같은 것도 동시성 문제의 대상입니다.
동시에 두 사람이 같은 게시글을 클릭한다면? 같은 문제죠. 이제 아주 직관적이면서 이해하기 쉬운 예시입니다.
때문에 제 예시에서 생기는 동시성 문제를 아주 단순하게 생각했습니다. 그래서 상품 재고에 대한 테스트코드를 작성했습니다. 재고가 1이고 3번의 동시 결제가 일어났다. 그럼 재고가 -2가 되겠구나!
재고에 대한 테스트 코드를 계속 작성해봤지만 결과는 대참패였습니다.
테스트 코드에서 재고가 항상 0이었습니다. 물론 이 결과에 대한 이해 전에 수많은 삽질이 있었습니다... (JPA 전파 단계라던가...)
그러다가 동시성 문제를 10시간정도 고민했을 때 문득 생각이 들었습니다. 재고가 0이면 결제가 안되어야하잖아..? 근데 결제가 세번 일어나네? 데이터베이스에 저장이 세번되잖아 그럼 내가 생각하던 동시성 문제가 아니잖아!!!
맞습니다. 각각의 스레드가 제가 만든 메서드를 동시에 통과하는게 아니고 한 스레드당 하나만 통과해야 했습니다.
위의 예제 정확히는 제 상황의 해결 방안은 크게 세가지입니다. (이 세가지를 떠올리는 것만 해도 엄청난 삽질이...)
• synchronized 키워드 사용
• 격리수준을 Serializable로 격상
• 낙관적 락, 비관적 락 사용
어떻게 제가 구현했나 한번 보시죠!
synchronized 키워드
우선 저는 synchronized 키워드를 되도록 사용하고 싶지 않았습니다. 왜냐하면 기존 프로젝트에서 이미 synchronized로 동시성 문제를 해결했거든요. (사실 해결한건 아닙니다. 해결한 척 한거죠)
synchronized 키워드를 사용하는건 제 프로젝트와 맞지 않았습니다. 왜냐하면 매번 결제가 일어날 때마다 이 결제 메서드를 통과할건데 모든 결제에 대해서 synchronized 를 건다고?
제 프로젝트는 이용가자 100만명 있다고 가정하기 때문에 이런 경우는 절대 용납할 수 없었습니다. synchronized 키워드 때문에 발생하는 성능 이슈는 도저히 참고 넘어갈 수 없었죠.
synchronized 키워드 정말 쉽습니다. 구글링 잠깐 하면 바로 나오니까요 한번 도전해보세요!
isolation level 을 Serializable로 격상
MySQL이 격리 수준을 Repeatable Read를 채택하고 있다는 것은 다들 아실겁니다. 때문에 Oracle이나 PostgreSQL에서 발생하는 Non-Repeatable Read 부정합 문제가 발생하지 않죠. (물론 이 둘은 다른 방법으로 부정합 문제를 해결했습니다.)
구현은 정말 간단합니다. 기존 Service 계층에서 사용하던 @Transactional의 격리수준을 올려버리면 됩니다.
@Transactional(isolation = Isolation.SERIALIZABLE)
public Map<String, String> saveUsingTemporaryOrder(List<TemporaryOrder> tOrder, Order order) {
// 결제 로직
}
하지만 이 방법에는 두가지 문제가 발생합니다.
격리 수준을 Serializable로 격상하면 쓰기작업은 물론이고 읽기 작업까지 락이 걸려버립니다.
이는 synchronized 키워드를 작성한 것과 마찬가지의 효과가 생깁니다.
아니 성능 때문에 synchronized 키워드 안쓰는건데 격리수준을 격상하면 뭐가 달라지나?
달라지지 않습니다. 오히려 더 안좋아집니다. 왜냐하면 격리수준을 격상시키면 synchronized 키워드였다면 생기지도 않았을 데드락 (교착상태)에 걸리게 됩니다.
Caused by: com.mysql.cj.jdbc.exceptions.MySQLTransactionRollbackException: Deadlock found when trying to get lock; try restarting transaction
at com.mysql.cj.jdbc.exceptions.SQLError.createSQLException(SQLError.java:123)
at com.mysql.cj.jdbc.exceptions.SQLExceptionsMapping.translateException(SQLExceptionsMapping.java:122)
at com.mysql.cj.jdbc.ClientPreparedStatement.executeInternal(ClientPreparedStatement.java:953)
at com.mysql.cj.jdbc.ClientPreparedStatement.executeUpdateInternal(ClientPreparedStatement.java:1098)
at com.mysql.cj.jdbc.ClientPreparedStatement.executeUpdateInternal(ClientPreparedStatement.java:1046)
at com.mysql.cj.jdbc.ClientPreparedStatement.executeLargeUpdate(ClientPreparedStatement.java:1371)
at com.mysql.cj.jdbc.ClientPreparedStatement.executeUpdate(ClientPreparedStatement.java:1031)
at com.zaxxer.hikari.pool.ProxyPreparedStatement.executeUpdate(ProxyPreparedStatement.java:61)
at com.zaxxer.hikari.pool.HikariProxyPreparedStatement.executeUpdate(HikariProxyPreparedStatement.java)
at org.hibernate.engine.jdbc.internal.ResultSetReturnImpl.executeUpdate(ResultSetReturnImpl.java:197)
... 35 more
물론 이걸 국지적으로 해결하는 방법이 있습니다. 바로 데드락이 발생할 것 같은 객체를 정렬하는 방법입니다.
엥? 데드락이랑 정렬이랑 뭔상관?
저도 처음엔 그렇게 생각했는데요.
데드락은 스레드 A가 자원 B의 락을 가지고 있고 자원 A를 요청하고, 스레드 B가 자원 A의 락을 가지고 있고 자원 B를 요청하는 상황에서 발생합니다.
즉 자원의 락을 순서를 가지지 않고 막 가지게 되면 데드락이 발생합니다.
자원의 순서를 sort() 메서드로 정렬해서 자원에게 걸릴 락의 우선순위를 부여하는 방법입니다.
그럼 데드락이 '국지적으로' 안걸립니다.
국지적으로 안걸린다는 의미는 걸릴수도? 안걸릴수도? 있다는 의미이죠.
이는 좋은 해결책은 아닙니다. 그래서 제가 선택한 마지막 방법 바로 낙관적 락과 비관적 락입니다.
Optimistic Lock, Pessimistic Lock
낙관적 락과 비관적 락은 데이터 행에 락을 거는겁니다. 이 둘은 비슷한듯 다른데요.
낙관적 락은 말 그대로 락을 거는 것에 대해 낙관적입니다. 비관적 락은 락을 거는 것에 비관적입니다. 때문에 낙관적 락은 락을 느슨하게 겁니다. 비관적 락은 일단 동시성 문제가 발생한다고 가정하고 락을 걸기 때문에 굉장히 빡빡합니다.
낙관적 락과 비관적 락은 각각 장단점이 있습니다.
• 낙관적 락 (Optimistic Lock) : 충돌이 빈번하게 일어나지 않을 때 성능상 유리한 락입니다. 보통 @Version을 통해 Versioning 즉 버전 관리를 하는 것이죠. 낙관적 락은 충돌이 일어났을 경우 개발자가 다시 요청하는 로직을 구현해야합니다. 이는 try / catch 문에서 OptimisticLockingFailureException을 구현하면서 이뤄냅니다.
• 비관적 락 (Pessimistic Lock) : 비관적 락은 충돌이 빈번하게 일어날 때 조금 더 효과적입니다. 아무래도 락을 걸고 시작하니까요. 비관적 락은 락을 통해 업데이트를 제어하기 때문에 데이터의 정합성이 어느정도 보장됩니다. 하지만 그에 따르는 성능 감소는 감수해야합니다.
저는 결제 로직이라면 충분히 충돌이 빈번할 것이라고 생각했습니다. (아무래도 100만명이 이용한다고 가정하니까요)
그래서 비관적 락을 이용해서 동시성 문제를 해결했습니다.
public interface ItemDetailRepository extends JpaRepository<ItemDetail, Long> {
@EntityGraph(attributePaths = "item")
@Query("select i from ItemDetail i where i.item.id = :itemId")
@Lock(value = LockModeType.PESSIMISTIC_WRITE)
List<ItemDetail> findByItemId(@Param("itemId") Long itemId);
}
하지만 주의하셔야 할 것이 있는데요. 바로 낙관적, 비관적 락은 행에 락을 거는 것이기 때문에 쓰기 작업에는 락을 걸 수 없습니다.
이렇게 락을 걸면? 테스트가 성공합니다.
서비스 계층은 아무런 코드 변경도 없었구요, 그냥 저기에 락하나 걸어주면 끝입니다. 정말 쉽습니다.
근데 저는 쓰기 작업에 락을 걸어야한다고 아까 해결 방법에서 말했습니다. 그런데 읽기 작업에 락을 거는 것이 어떻게 위와 같은 동시성 문제를 해결할 수 있을까요?
바로 읽기 작업에 락을 거는 것이 그 이후에 있을 쓰기 작업까지 영향을 주기 때문입니다.
그림으로 설명하면 다음과 같은데요.
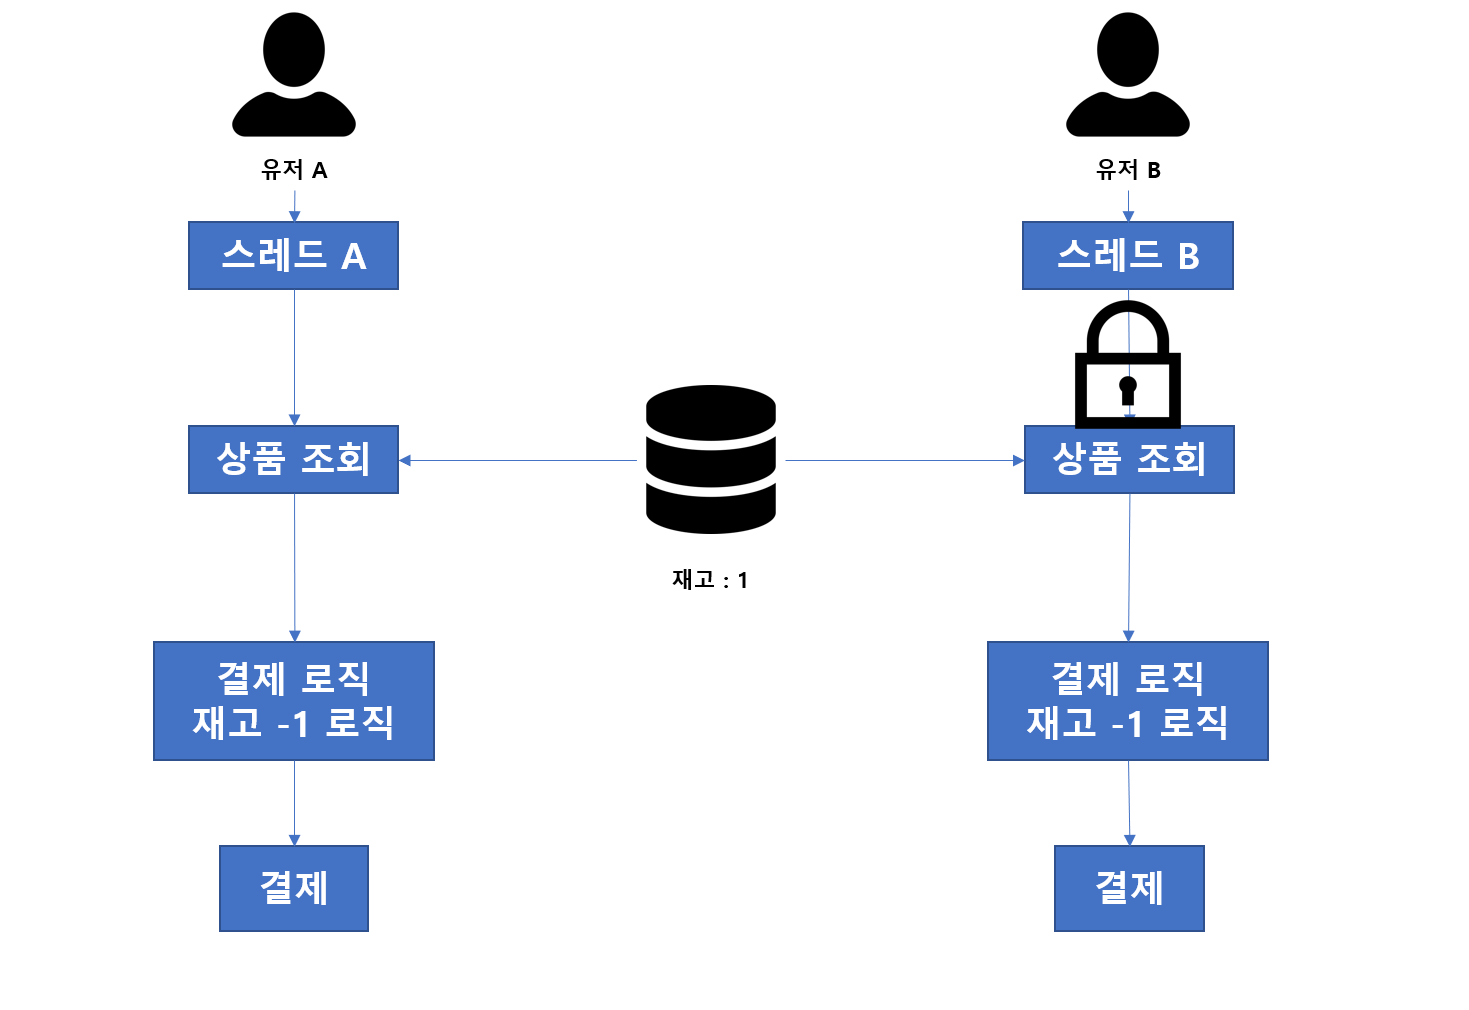
그림과 같이 조회로 가는 락이 걸려있기 때문에 스레드 B가 처리해야할 결제 로직을 더이상 들어갈 수 없는 것입니다.
saveAndFlush + synchronized 키워드?
블로그 포스팅을 보다보니 saveAndFlush를 이용해서 커밋을 시켜버린 다음에 synchronized 키워드로 락을 걸어버리는 방법에 대해서 알게되었습니다.
물론 커밋을 시키면 좋겠는데 한가지 걸린다면 커밋을 해버리면 그 다음부터 영속성 컨택스트의 1차 캐시를 사용하지 못하는 것은 아닐까 하는 생각이 듭니다.
하지만 원래 synchronized 키워드는 사용하지 않을 목적이었기 때문에 상관은 없지만요.
마치며
여기까지 동시성 문제를 스프링에서 어떻게 해결하는지에 대해서 알아봤습니다.
동시성 문제, 트랜잭션 처리 정말 어렵네요... 아직 하나의 서비스 로직만 동시성 문제를 해결했습니다. 이후에 천천히 다른 로직까지 넓혀갈 생각입니다.
프로젝트를 고도화 한다는 것은 정말 놀랍네요. 평소라면 생각하지도 않았을 내용에 대해서 공부하고 삽질도 미친듯이 해보고 좋은 경험이었습니다.
거기다 동시성 문제는 현업에서도 정말 조심해야할 문제이기 때문에 더욱 값진 경험이 된 것 같아서 시간은 오래 걸렸지만 굉장히 뿌듯합니다.
그럼 이만 긴 글 줄여보도록 하겠습니다. 긴 글 읽어주셔서 감사합니다. 오늘도 즐거운 하루 되세요~
출처
https://crazy-horse.tistory.com/entry/%EC%9E%AC%EA%B3%A0-%EC%8B%9C%EC%8A%A4%ED%85%9C%EC%9C%BC%EB%A1%9C-%EC%95%8C%EC%95%84%EB%B3%B4%EB%8A%94-%EB%8F%99%EC%8B%9C%EC%84%B1-%EB%AC%B8%EC%A0%9C-%ED%95%B4%EA%B2%B0-%EB%B0%A9%EB%B2%95
https://parkjeongwoong.github.io/articles/Failure/5
+
GPT 야 정말 고맙다 ㅜㅜ
스프링 부트 3.0 마이그레이션 가이드
이번 포스팅은 스프링 부트가 얼마전 3.0이 됨에 따라 바뀌게 된 점 중 저에게 해당하는 점만 정리해보겠습니다.
자세한 내용은 이곳!
https://github.com/spring-projects/spring-boot/wiki/Spring-Boot-3.0-Migration-Guide
스프링 부트 3.0
1. JavaEE에서 JakartaEE로 변경
javax 패키지에 있던 것들이 전부 jakarta로 변경되었습니다.
때문에 만약 JPA를 사용하신다면 필수로 마이그레이션해야 하는 사항입니다.
javax.persistence.EntityManager 이런 것들이 전부 jakarta.persistence.EntityManager 이렇게 변경되었습니다.
2. Java 17로 업그레이드 해야한다.
자바 17버전으로 업그레이드 하면서 많은 개발자들이 우려를 했습니다. 물론 찬성한 개발자들도 적지 않았는데요.
• 역호환 문제 (우려) : Java 17은 오랜 기간 LTS를 릴리즈 했고, 그것이 많은 새로운 특징들과 개선들을 가져왔습니다. 뿐만 아니라 획기적인 변화도 포함되어 있었죠. 하지만 이것은 오래된 자바 버전과 호환되지 않는다는 것을 의미할 수 있습니다. 때문에 스프링 부트가 3.0이 되면서 많은 문제가 발생할 것을 우려했습니다.
• 새로운 기능을 채택 (찬성) : Java 17은 새로운 특징과 개선사항을 발표했고 개발자들이 자신들의 스프링 부트 프로젝트에 새로운 기능을 써보고 싶어하는 사람도 있었습니다.
• 성능 (찬성) : Java 버전들은 전형적으로 성능 개선을 가져왔습니다. 예를 들어서 Java 17같은 경우 Z Garbage Collector와 자바 메모리 모델의 개선사항이 포함되어 있었습니다. 이 두가지 개선은 스프링 부트 프로젝트의 성능에 상당한 부스팅이 될 것입니다.
• 오래된 버전에 대한 지원 (우려) : 스프링 부트 3.0이 Java 17버전을 디폴트로 사용하면서 더이상 자바의 오래된 버전을 지원하지 않을 수 있고 오래된 버전을 사용하는 개발자들은 업그레이드할 필요가 있습니다. 이러한 변화는 급작스러운 변화를 준비하지 못한 프로젝트들의 문제로 발전할 수 있습니다.
• 보안 (우려) : Java 17은 많은 보안 개선사항이 포함되어 있습니다. 이것은 스프링 부트 프로젝트에 큰 이점이 될 수 있습니다. 하지만 몇몇 개발자들은 새로운 버전을 도입함으로써 생기는 보안 문제를 걱정하고 있다.
• 특정 기능을 더이상 사용하지 않음 (우려) : Java 17은 미래의 릴리즈를 위해 몇몇 특정한 특징들을 deprecate 시켰습니다. 이것은 이러한 특징에 의존하는 스프링 부트 프로젝트에 영향을 미칠 수 있습니다.
3. 보안상의 이유로 URL 매칭이 변함
기존에는 @GetMapping("/some/greeting") 과 @GetMapping("/some/greeting/") 이 같았다
이제 이 둘은 같지 않습니다. 만약 해당 URL로 요청을 보낸다면 404 에러가 발생할겁니다.
이를 해결하기 위해서는
• 두개의 API를 만든다
• 디폴트 Configuration을 오버라이딩해서 기존과 같이 사용한다
• 커스텀 필터를 이용해 리다이렉트 시킨다
• WebFilter를 이용한다
• 프록시 (NGINX, Apache) 를 이용해 리다이렉트 시킨다
4. Data Access 가 변경됨
기존 application 파일에서 데이터베이스에 대한 설정은 spring.data.~ or spring.~ 이었습니다.
이번에 바뀐 데이터베이스 접근 방식은 저에게 해당하는건 두가지인데요.
Cassandra
spring.data.cassandra => spring.cassandra
Redis
spring.redis => spring.data.redis
5. 하이버네이트 6.1이 디폴트로
스프링 부트 3.0에서는 하이버네이트 6.1을 디폴트로 사용합니다.
6.1 마이그레이션 가이드를 참고하라고 나와있는데 읽어보니 딱히 별다른 내용은 없더라구요. 그냥 버전 업만 시켜주면 알아서 마이그레이션 될 듯 합니다.
6. 스프링 시큐리티 변경
스프링 시큐리티가 6.0으로 격상되었습니다. 그에따라 변하는게 있다고 마이그레이션 가이드를 참고하라고 했지만
읽어본 결과 딱히 변하는건 없었습니다. 그냥 쓰던대로 쓰면 될 것 같습니다.
7. 스프링 배치 변경
스프링 배치가 5.0 버전이 릴리즈 됐습니다. 이건 꽤 의미있는 변화가 있었는데요.
이전 main 메소드가 있는 클래스에 @EnableBatchProcessing은 스프링 부트의 auto-configuration을 위해 사용되었습니다만, 이제는 더이상 사용되지 않습니다. 만약 @EnableBatchProcessing을 붙이게 되면 자동적으로 설정파일을 주입해주던 기능을 사용할 수 없습니다.
때문에 배치 클래스에 DefaultBatchConfiguration을 상속함으로써 auto-configuration을 사용할 수 있습니다.
마치며
스프링 배치에 대해 알아보던 내요이었는데 꽤 의미있는 변화들이 있었던 것 같습니다.
이것 외에도 변하는 것이 상당히 많았는데 저와 상관없는 것들이라 깔끔하게 무시했습니다.
스프링 부트 3.0이 됨으로써 버전 업을 하려고 하시는 분들에게 참고가 되었스면 좋겠습니다. 그럼 여기까지 스프링 부트 3.0 마이그레이션 가이드였습니다. 긴 글 읽어주셔서 감사합니다. 오늘도 즐거운 하루 되세요~
출처
https://github.com/spring-projects/spring-boot/wiki/Spring-Boot-3.0-Migration-Guide
Mockito 프레임워크를 이용해 스프링 단위테스트 진행하기
이번 프로젝트에서 단위테스트를 해야할 일이 생겨서 알아보던 중에 Mockito에 대해서 알게 되었습니다.
스프링을 공부한지 만으로 2년이 되어가지만 아직까지 Mockito를 이용해 테스트 케이스를 만드는 법을 모른다는 사실에 반성하게 되었습니다.
많은 개발자 선배님들이 TDD를 외치셨는데 저는 그걸 지키지 못한 것 같아서 조금 아쉽지만... 지금이라도 TDD를 실천하고자 이렇게 포스팅 적어봅니다.
이번엔 Mockito를 어떤 방식으로 사용해야 하는지 그리고 주요 문법은 무엇이 있는지에 대해서 알아보도록 하겠습니다.
Mockito
Mock 이라는 단어는 가짜, 허구의 라는 뜻입니다.
즉 Mock 객체를 만들어 (가짜 객체를 만들어) DB의 접근 없이도 자신의 코드의 논리적인 부분을 체크하는 방법이 바로 Mockito 프레임워크의 핵심이라고 할 수 있습니다.
즉, findById() 이런 메서드로 반환되는 객체를 가짜로 주입해서 코드의 논리적인 부분을 체크하는 방법이죠.
때문에 Mock객체는 모두 자신이 한땀한땀 설정해줘야합니다.
한번 어떤식으로 사용하는지 보시죠.
@ExtendWith(MockitoExtension.class)
public class BucketServiceTest {
@Mock
BucketRepository bucketRepository;
@Mock
TemporaryOrderRepository temporaryOrderRepository;
@Mock
ItemDetailRepository itemDetailRepository;
@Mock
CacheRepository cacheRepository;
@Mock
ItemRepository itemRepository;
@Mock
TemporaryOrderService temporaryOrderService;
@InjectMocks
BucketService bucketService;
@Test
@DisplayName("장바구니에서 수량을 줄이거나 늘리면 개수가 변해야한다.")
public void test1() throws Exception {
//given
ChangeCountDto dto = new ChangeCountDto();
dto.setBucketId("1");
dto.setCount("2");
Member member = Data.createMember();
Item item = Data.createItem(member);
Bucket bucket = Data.createBucket(member, null, item);
TemporaryOrder tOrder = Data.createTOrder(bucket);
ItemDetail itemDetail = Data.createItemDetail(item);
when(bucketRepository.findById(Long.parseLong(dto.getBucketId()))).thenReturn(Optional.of(bucket));
when(temporaryOrderRepository.findTemporaryOrderByBucketId(bucket.getId())).thenReturn(tOrder);
when(itemDetailRepository.findByItemId(bucket.getItem().getId())).thenReturn(Collections.singletonList(itemDetail));
//when
Map<String, String> map = bucketService.isBucketStockZero(dto);
//then
Assertions.assertNotNull(map);
Assertions.assertEquals(map.get("message"), "재고가 남아있지 않습니다. 남은 수량 : 1");
Assertions.assertEquals(map.get("count"), "2");
}
}
@Service
@RequiredArgsConstructor
@Transactional
public class BucketService {
private final BucketRepository bucketRepository;
private final TemporaryOrderRepository temporaryOrderRepository;
private final ItemDetailRepository itemDetailRepository;
private final CacheRepository cacheRepository;
private final ItemRepository itemRepository;
private final TemporaryOrderService temporaryOrderService;
public Map<String, String> isBucketStockZero(ChangeCountDto dto) {
Map<String, String> map = new HashMap<>();
int nowStock = 0;
Bucket findBucket = bucketRepository.findById(Long.parseLong(dto.getBucketId())).orElseThrow(
() -> new RuntimeException("Not Found Bucket")
);
TemporaryOrder tOrder = temporaryOrderRepository.findTemporaryOrderByBucketId(findBucket.getId());
List<ItemDetail> findItemDetails = itemDetailRepository.findByItemId(findBucket.getItem().getId());
for (ItemDetail itemDetail : findItemDetails) {
nowStock = itemDetail.getStock() - Integer.parseInt(dto.getCount());
if (nowStock <= -1) {
map.put("message", "재고가 남아있지 않습니다. 남은 수량 : " + itemDetail.getStock());
}
}
TemporaryOrder temporaryOrder = tOrder.changeCount(Integer.parseInt(dto.getCount()));
map.put("count", String.valueOf(temporaryOrder.getCount()));
return map;
}
}
위는 테스트코드고 아래는 제가 테스트할 Service 계층의 코드입니다.
먼저 하나씩 살펴보죠. test 코드부터 보죠.
@ExtendWith(MockitoExtension.class)
public class BucketServiceTest {
}
Mockito 프레임워크를 사용하기 위해서는 먼저 테스트 클래스레벨에 @ExtendWith 어노테이션을 달아줘야합니다. 이게 시작이라고 볼 수 있죠.
@Mock
BucketRepository bucketRepository;
@Mock
TemporaryOrderRepository temporaryOrderRepository;
@Mock
ItemDetailRepository itemDetailRepository;
@Mock
CacheRepository cacheRepository;
@Mock
ItemRepository itemRepository;
@Mock
TemporaryOrderService temporaryOrderService;
@InjectMocks
BucketService bucketService;
이것들은 제가 테스트케이스에서 주입한 객체들입니다. 보통 우리는 @Autowired를 이용해 주입하는 것이 익숙합니다만, Mockito에선 가짜 객체를 주입해줘야 합니다.
@Mock에 해당하는 것들은 내가 테스트할 클래스의 의존관계와 같습니다.
즉, @Mock 객체 = Service 클래스에서 DI 받은 것
이렇게 생각하시면 됩니다.
그리고 이렇게 가짜 객체를 만들면 @InjectMocks 어노테이션을 이용해 내가 테스트하고 싶은 클래스에 적으면 이 어노테이션이 적힌 클래스에 Mock 객체가 주입됩니다.
그리고 주요 문법 확인하시죠!
주요 문법
when(bucketRepository.findById(Long.parseLong(dto.getBucketId()))).thenReturn(Optional.of(bucket));
Bucket findBucket = bucketRepository.findById(Long.parseLong(dto.getBucketId())).orElseThrow(
() -> new RuntimeException("Not Found Bucket")
);
제가 코드를 따로 가져와 봤는데요. 제가 잘 설명할 수 있을지 모르겠습니다. 한번 도전해보겠습니다.
우리가 일반적으로 스프링 컨테이너를 띄우면 일어나는 일을 상상해봅시다.
스프링 컨테이너가 빈으로 등록된 Repository를 싱글톤으로 생성하고 Service로직에 가서 DI로 주입을 해줬습니다. 그럼 bucketRepository.findById() 메서드가 데이터베이스를 타고 객체를 가져오겠죠.
하지만 말씀드렸다시피 Mock 객체는 가짜 객체입니다. BucketRepository를 가짜로 주입했으니 스프링 입장에서 findById()에 대한 객체도 뭘 가져와야할지 모르는 상황입니다.
그래서 when(), thenReturn() 메서드를 이용해 값을 세팅해주는 것입니다.
때문에 위의 코드를 풀어 해석하면 다음과 같습니다.
bucketRepository.findById() 를 실행했을 때는 => Optional객체의 bucket이 나온단다.
그럼 스프링은 가짜로 주입했어도 대충 아 findById에는 bucket이 들어가는구나 하고 어물쩡 넘어갑니다.
그렇게 해서 DB와 연결되는 부분들을 모두 Mock 객체로 세팅해주면?
내가 원하는 bucketService.isBucketStockZero() 를 호출했을 때 값이 잘 바인딩 됩니다.
잘 설명이 됐나 모르겠네요...
이제 자주 쓰이는 문법에 대해서 알아보죠!
*findBy~() 를 호출했을 때 단일 객체가 있어야 하는 경우
when(cacheRepository.findmemberAtCache(loginId)).thenReturn(member);
*Repository 의 save() 메서드 Mock 객체로 만드는 법
when(commentRepository.save(any(Comment.class))).thenAnswer(invocation -> invocation.getArgument(0));
이렇게 하면 save() 메서드를 타고 나온 첫번째 객체를 Mock 객체로 바인딩 해준다.
*findBy~() 를 호출했을 때 빈 List가 반환되는 경우
when(memberWhoGetCouponRepository.findCouponByMemberId(member.getId())).thenReturn(Collections.emptyList());
*findBy~() 를 호출했을 때 값이 있는 List가 반환되는 경우
when(memberWhoGetCouponRepository.findCouponByMemberId(member.getId())).thenReturn(Collections.singletonList(memberWhoGetCoupon));
저도 아직 잘 모르는 초보라... 제가 자주 썼던 문법만 간단하게 추려봤습니다.
마치며
여기까지 Mockito를 이용한 단위 테스트에 대해서 알아봤습니다.
기존 통합 테스트만 돌려볼 줄 알았던 제가 조금 부끄러워질 정도로 테스트 성능이 매우 잘나와서 부끄러우면서도 아주 만족스럽습니다. 앞으로 많이 애용하게 될 것 같네요.
긴 글 읽어주셔서 감사합니다. 오늘도 즐거운 하루 되세요~
프록시패턴, 데코레이터 패턴
이번 포스팅에는 프록시 패턴과 데코레이터 패턴에 대해서 알아보겠습니다. 뜬금없이 왜 프록시 패턴과 데코레이터 패턴을 공부했냐면 제가 AOP를 공부했기 때문입니다.
스프링 AOP에서 사용하는 GOF 디자인 패턴 중 데코레이터 패턴이 사용되었기 때문에 공부차 한번 구현해봤습니다.
한번 시작해보죠!
프록시
이 두 패턴을 알아보기 전에 프록시에 대해서 알아봐야 합니다.
보통 프록시는 '대리자' 라고 번역이 되고 내가 수행해야 할 일을 대신 수행해주는 존재 라고 생각하시면 됩니다.
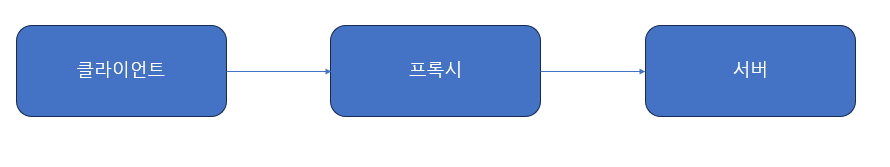
이렇게 대신 내 일을 대신 수행해주면 무슨 이점이 있을까요?
프록시를 이용하면 얻을 수 있는 것은 두 가지 입니다.
• 접근 제어 (캐싱)
• 부가 기능 (로깅, 트랜잭션)
접근 제어
예를 들어 클라이언트가 서버에 A라는 데이터를 조회했다고 가정해봅시다. 그럼 서버는 클라이언트에게 A를 전달하겠죠. 다시 조회하면? 다시 전달합니다.
이 때 프록시가 있으면 어떻게 될까요?
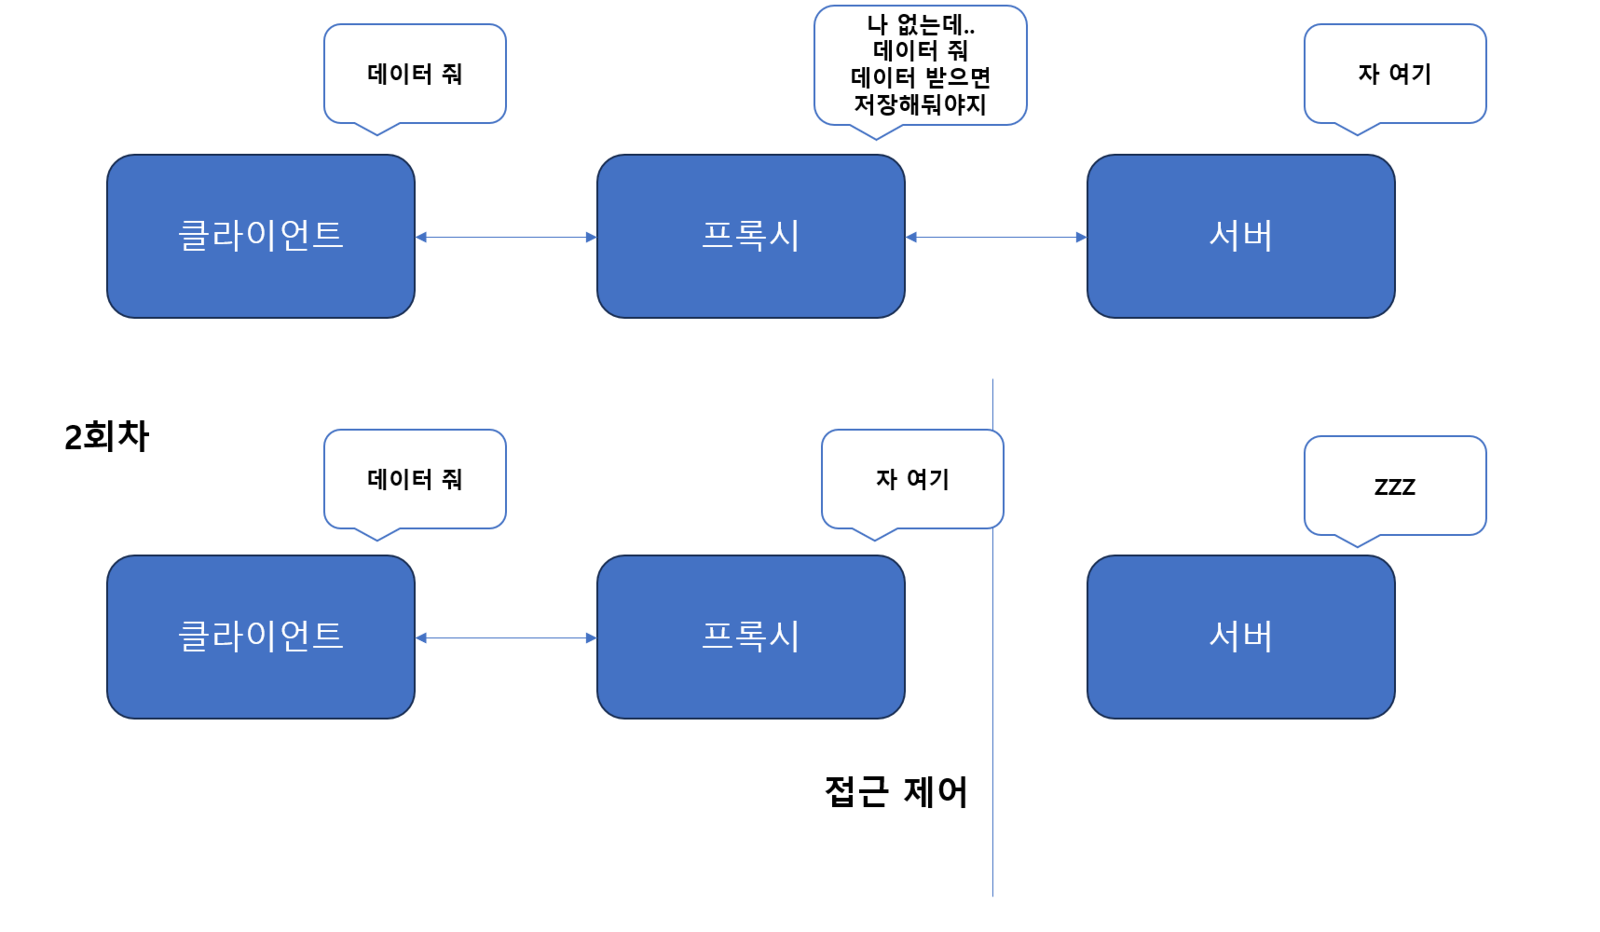
이렇게 프록시가 접근을 제어할 수 있게 됩니다. 이렇게 되면 클라이언트는 두 번째엔 처음보단 빠르게 데이터를 받을 수 있겠죠?
이제 코드로 구현해보겠습니다. 그 전에 의존관계를 확인해볼 필요가 있습니다.
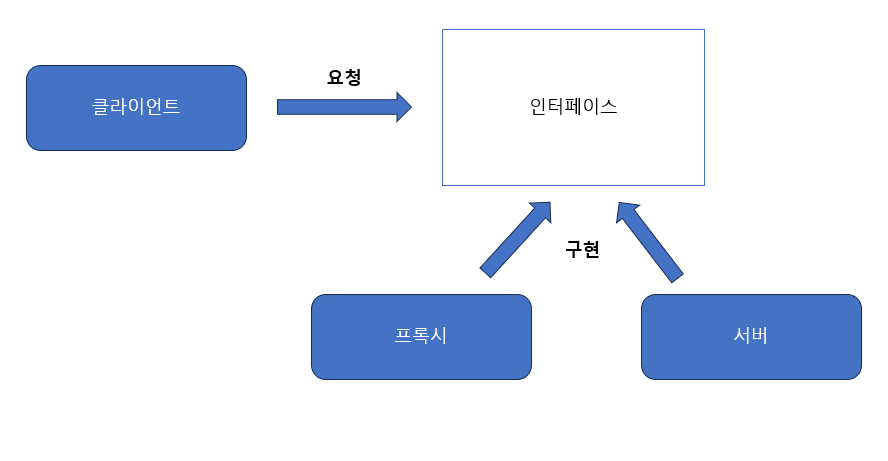
프록시와 서버는 같은 인터페이스를 구현한 객체입니다. 이렇게 되면 클라이언트는 인터페이스에만 의존하기 때문에 내가 프록시를 호출했는지 서버를 호출했는지 알 수 없습니다.
이것이 바로 느슨한 결합도를 유지한다는 것이죠.
이제 프록시와 서버를 보면 프록시는 서버를 호출해야 합니다. 그래야 접근을 제어할 수 있기 때문이죠.
위에 있는 이 그림을 다시 보시면 클라이언트는 프록시를 프록시는 서버를 호출하면서 클라인어트와 서버 사이에 대리자로서 접근을 제어하는 것입니다.
이 그림에서 보면 클라이언트는 프록시를 (정확히는 인터페이스를) 프록시는 서버를 호출하는 것입니다.
이제 본격적으로 코드로 확인해보시죠.
@Slf4j
public class Service {
private final Proxy proxy;
public Service(Proxy proxy) {
this.proxy = proxy;
}
public void method() {
log.info("Service 호출");
proxy.call();
}
}
public interface Proxy {
String call();
}
@Slf4j
public class ProxyObject implements Proxy {
private final RealObject target;
private String cacheValue;
public ProxyObject(RealObject target) {
this.target = target;
}
@Override
public String call() {
log.info("프록시 객체 호출");
if (cacheValue == null) {
cacheValue = target.call();
}
return cacheValue;
}
}
@Slf4j
public class RealObject implement Proxy {
@Override
public String call() {
log.info("실제 객체 호출");
sleep(1000);
return "data";
}
}
실제 객체인 RealObject의 call()은 실행시간이 1초정도 걸리는 로직이라고 가정합니다.
위의 코드는 서버와 프록시를 구현한 코드입니다. 이제 클라이언트를 구현해보죠.
@Test
void test() {
RealObject realObject = new RealObject();
ProxyObject proxyObject = new ProxyObject(realObject);
Service service = new Service(proxyObject);
service.method();
service.method();
service.method();
}
자 이제 실행해보면?
원래였으면 3초가 걸렸어야할 로직이 1초만에 끝나는 것을 알 수 있습니다.
맨 처음에만 캐싱된 데이터가 없으니 실제 객체를 호출하지만 그 이후부턴 프록시가 호출되어 곧바로 리턴되는 것을 볼 수 있습니다.
부가 기능
부가 기능은 앞서 봤던 접근 제어와 거의 흡사합니다. 개념은 접근 제어와 일치하기 때문에 생략하고 바로 코드로 넘어가겠습니다.
@Slf4j
public class Service {
private final Proxy proxy;
public Service(Proxy proxy) {
this.proxy = proxy;
}
public void method() {
log.info("Service 호출");
proxy.call();
}
}
public interface Proxy {
String call();
}
@Slf4j
public class ProxyObject implements Proxy {
private final RealObject target;
public ProxyObject(RealObject target) {
this.target = target;
}
@Override
public String call() {
log.info("프록시 객체 호출");
String data = target.call();
String decorator = "*****" + data + "*****"
return decorator;
}
}
@Slf4j
public class RealObject implement Proxy {
@Override
public String call() {
log.info("실제 객체 호출");
return "data";
}
}
달라진건 캐시 데이터가 없다는 것과 실제 객체에 1초 소요가 없다는 것 그리고 그 외에는 전부 똑같습니다.
이제 클라이언트 코드를 작성해보겠습니다.
@Test
void test() {
RealObject realObject = new RealObject();
ProxyObject proxyObject = new ProxyObject(realObject);
Service service = new Service(proxyObject);
service.method();
}
결괏값이 이쁘게 꾸며져 나오는 것을 확인할 수 있습니다.
프록시 패턴과 데코레이터 패턴
앞서 우리는 접근제어, 부가기능 추가라는 관점에서 프록시를 이용해봤습니다. 접근 제어는 프록시 패턴, 부가 기능 추가는 데코레이터 패턴이라고 불립니다.
그런데 조금 이상하죠? 둘이 구현하는 방법이나 사용 방법이 너무 똑같은데 이 둘을 구분해야 할까요?
GOF패턴에선 패턴들을 의도에 맞게 구별합니다. 접근 제어의 의도를 가지고 있다면 프록시 패턴, 부가 기능을 추가하는 의도를 가지고 있다면 데코레이터 패턴이라고 부르는 것이죠.
※주의
프록시 패턴이라는 이름 때문에 헷갈릴 수도 있지만 프록시 패턴만 프록시를 사용하는 것이 아닙니다! 프록시 패턴, 데코레이터 패턴 모두 프록시를 이용하는 패턴이고 이름만 프록시 패턴, 데코레이터 패턴이라고 명명한 것 뿐이죠.
마치며
이번 포스팅에선 AOP를 포스팅하기 전 내용으로 프록시 패턴과 데코레이터 패턴에 대해서 알아봤습니다. AOP에선 프록시 패턴보단 데코레이터 패턴에 더 가깝긴 하지만 둘 다 프록시를 이용한 패턴이니만큼 실제로 구현해봤습니다.
GOF 디자인 패턴을 시간이 되면 본격적으로 공부해야겠다고 생각이 드는 시간이었습니다. 나중에라도 한번 제대로 배워봐야겠네요.
Spring Actuator
이번 프로젝트에서 프로메테우스와 그라파나로 모니터링 환경을 구축했는데 어떤 포스팅에서 Spring Actuator를 사용해서 의미있는 모니터링을 하고싶다는 글을 봤습니다.
엑추에이터..? 이게 뭐지? 궁금해서 공부해보고 포스팅하려고 합니다! 그리고 실제로 시각화 툴과 조합해서 이용해보도록 하겠습니다.
Spring Actuator?
Spring Actuator는 우리의 애플리케이션을 모니터링하고, 메트릭스를 수집하고, 트래픽을 관찰하고, 우리의 데이터베이스의 상태를 모니터링할 수 있는 스프링의 프로젝트 중 하나입니다.
이 라이브러리를 사용하면 실제로 아무것도 구현하지 않아도 프로덕션 레벨의 도구를 사용할 수 있다는 엄청난 장점이 있습니다.
Actuator는 주로 구동중인 애플리케이션에 대한 설정 정보들을 노출하는데 사용됩니다. 헬스체크, 메트릭스, 정보, 덤프, 환경 기타 등등 다양한 것들을 노출하죠.
Actuator는 HTTP 엔드포인트나 JMX 빈으로 애플리케이션과 상호작용할 수 있습니다.
cf) node-exporter와 차이점
아마 프로메테우스와 그라파나를 사용하신 분들이라면 익숙하실 node-exporter와 비슷한 부분이 있어보입니다.
하지만 이 둘은 엄연히 다릅니다. node-exporter는 프로메테우스를 위한 머신 메트릭스의 exporter입니다. 프로메테우스의 exporter인 node-exporter는 하드웨어 레벨이나 OS레벨의 모니터링을 도와줍니다. 예를 들어 CPU 사용량이나 메모리 사용량, 디스크 I/O, 네트워크 등등 다양한 하드웨어적 정보를 보여주죠.
프로메테우스와 그라파나, node-exporter를 이용한 모니터링 환경 구축은 아래의 링크를 참고해주세요!
https://coding-review.tistory.com/436
Spring Actuator 시작하기
Spring Actuator는 정말 간단합니다. 우리가 추가적으로 코드를 작성할 필요가 없다고 앞에서 말씀드렸죠? 그냥 설정만 해주시면 자연스럽게 사용할 수 있습니다.
한번 시작해보죠!
1. 의존성 추가
implementation 'org.springframework.boot:spring-boot-starter-actuator'
runtimeOnly 'io.micrometer:micrometer-registry-prometheus'
저는 gradle을 사용했습니다. 위와같이 적으시면 1단계는 끝입니다.
2. application.yml 설정 추가
management:
endpoints:
web:
exposure:
include: beans
자 이제 끝입니다!
이제 서버를 띄우고 /actuator/beans 를 입력해보면?
네 json으로 제공되는 정보들은 눈으로 읽을 수가 없습니다. 처음 보면 이딴게... 모니터링..? 이라는 말이 절로 나옵니다.
네! 그래서 시각화 툴과 같이 사용해야합니다.
Spring Actuator 시각화
우리는 프로메테우스와 그라파나를 이용할겁니다.
먼저 application.yml에 추가해줄 것이 있습니다.
management:
endpoints:
web:
exposure:
include: prometheus
include 부분에 prometheus를 입력해줍니다.
그리고 prometheus.yml에서 우리 프로젝트를 job_name으로 추가해줘야합니다.
global:
scrape_interval: 15s
scrape_timeout: 15s
evaluation_interval: 2m
external_labels:
monitor: 'codelab-monitor'
query_log_file: query_log_file.log
rule_files:
- "rule.yml"
scrape_configs:
- job_name: 'prometheus'
scrape_interval: 10s
scrape_timeout: 10s
metrics_path: '/metrics'
honor_labels: false
honor_timestamps: false
scheme: 'http'
params:
user-id: ['[email protected]']
static_configs:
- targets: ['{IP 입력}:9090']
labels:
service: 'monitor-1'
- job_name: 'node'
static_configs:
- targets: ['{IP 입력}:9100']
- job_name: 'spring-actuator'
static_configs:
- targets: ['{IP 입력}:8080']
metrics_path: '/actuator/prometheus'
만약 localhost 라면 IP부분에 localhost를 적어주면 됩니다. 실제로 배포된 서버라면 퍼블릭 IP를 적어주면 됩니다.
자 이제 프로메테우스를 시작해봅시다.
자 이렇게 띄웠으면 그라파나로 넘어갑니다.
Data sources를 선택하는 부분은 넘어가도록 하겠습니다. 아래의 링크를 확인해주세요!
https://coding-review.tistory.com/436
바로 대쉬보드로 넘어가죠.
import 주소에 위와같이 입력해주고 Load를 클릭합니다.
그리고 우리가 설정한 Data sources를 프로메테우스로 설정해준다음 import를 누르면!
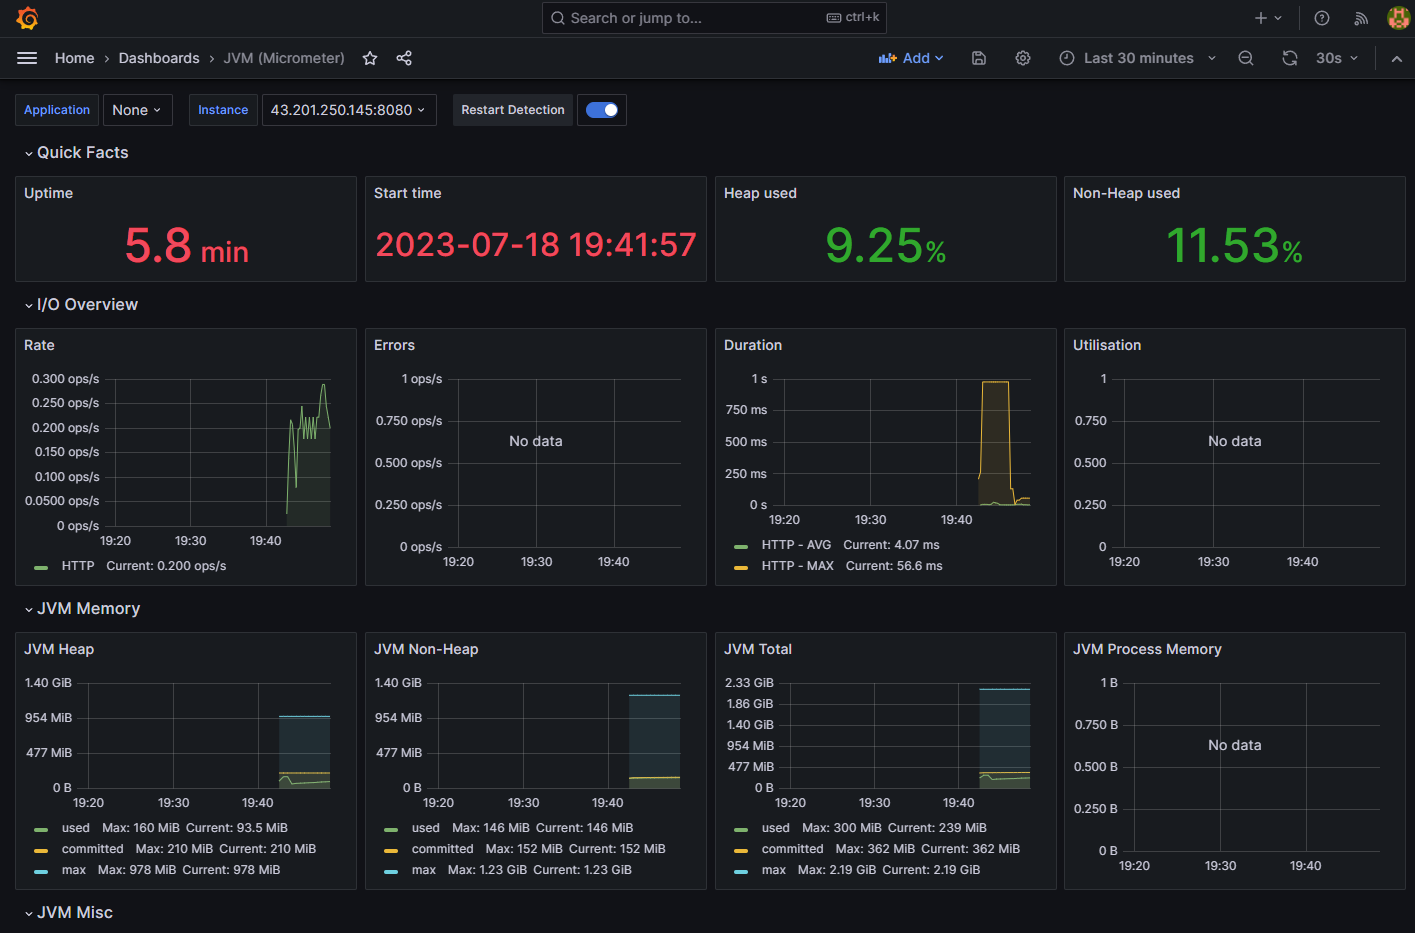
이렇게 이쁜 대쉬보드가 생깁니다.
Spring Actuator에서 제공하는 지표
끝내기 전에 Actuator에서 제공하는 지표에 대해서 간단하게 정리하고 마무리짓도록 하겠습니다.
• I/O
HTTP 요청
• HTTP 에러 (4xx, 5xx)
• 지연시간
• JVM 메모리
JVM heap 영역
• JVM non-heap 영역
• JVM Misc (여기서 Misc는 그냥 잡동사니 정도로 해석하시면 되고 JVM에 관련한 잡동사니를 넣었다고 보시면 됩니다. )
CPU 사용률
• JVM 부하
• 스레드 (실제 운영되는 스레드, 데몬 스레드)
• 스레드 상태 (블로킹, 생성, 실행중)
• GC 부하
• 로그 트레이스
• JVM 메모리 풀 (heap 영역입니다. 저는 Java 11이라 G1 GC로 인식하는 듯 합니다. 아마 Java 17이라면 Z GC일지는 모르겠습니다.)
GC 에덴 영역
• GC 올드 영역
• GC 서바이버 영역
• JVM 메모리 풀 (non-heap 영역입니다.)
Metaspace
• GC
• 클래스 로더
정말 다양한 것들을 알려줍니다.
마치며
이번엔 스프링에서 제공하는 Actuator에 대해서 알아봤습니다. 정말 다양한 지표들을 제공해준다는 것에 깜짝 놀랐습니다. 아마 하드웨어를 체크하는 node-exporter와 함께 요긴하게 사용할 듯 합니다.
여러분도 Spring Actuator를 모니터링 도구로 사용해보시는건 어떨까요?
긴 글 읽어주셔서 감사합니다. 오늘도 즐거운 하루 되세요~
출처
https://hudi.blog/spring-boot-actuator-prometheus-grafana-set-up/
개발 하다 보면 많이 접하는 스프링 빈 직접 등록하기 : 활용편
우리는 스프링을 사용하면서 너무 편하게 개발하고 있습니다. 스프링이 정해둔 규칙대로 프로그래밍하면 되기 때문에 정말 쉽게 개발할 수 있죠.
하지만 이게 쉽긴하지만 마냥 쉽진 않습니다. "스프링이 정해둔 규칙" 이라는게 정말 넓고 깊은 지식을 요구하거든요.
일례로 스프링 시큐리티같은 것만 하더라도 "스프링이 정해진 규칙" 이지만 시큐리티를 처음 보는 사람들은 이게 만만치않게 힘들겁니다.
이번에 포스팅할 스프링 빈을 직접 등록하는 것도 마찬가지일 것이라고 생각합니다. 마냥 컴포넌트 스캔을 이용해서 빈을 등록했고 구글링한 예제 코드에서도 @Bean을 이용해서 빈으로 등록하라고는 했지만 어떻게 동작하는 것이고 어떻게 사용하는 것인지 처음엔 알기 쉽지 않거든요.
어떻게 빈을 직접 등록하는 것인지 어떤 상황에서 빈을 직접 등록하는 것인지 그 안에 스프링 개발자들이 숨겨둔 규칙은 무엇인지 한번 본격적으로 알아보도록 하겠습니다.
스프링 빈?
스프링 빈이란 무엇일지 짚고 넘어가도록 하겠습니다. 스프링 빈이란 스프링 컨테이너가 관리하는 자바 객체입니다.
그럼 스프링 컨테이너도 뭔지 설명을 해야겠죠. 스프링 컨테이너도 결국 클래스입니다. 정확히는 인터페이스라고 해야겠지만 아무튼 자바로 만들어진 클래스라는 것이죠.
컨테이너 컨테이너 그래서 뭐가 있나 싶지만 실제로는 그냥 자바로 만들어진 클래스에 불과합니다. 스프링 컨테이너니 IoC 컨테이너니 말만 번지르르하지 사실 그냥 클래스! 라는 것만 명심하시면 더 쉽게 접근할 수 있습니다.
ApplicationContext 라고도 불리는 스프링 컨테이너의 주 역할은 스프링 빈 즉 자바 객체를 관리하는 것입니다.
아니... 그냥 new 로 객체 생성해서 우리가 만들면 되지 뭔 컨테이너인지 뭐시기한테 왜 관리를 맡기냐...라고 생각이 드실 수 있습니다.
외부에서 주입받는 것이 얼마나 큰 장점을 가지는지 제가 설명해보도록 하겠습니다.
IoC (Inversion of Control)
흔히들 제어의 역전이라고 하죠. 이를 설명하기 위해 상황을 가정해보겠습니다.
상황)
기획자가 콜라보레이션을 기획하고 있습니다. A기업과 B기업의 콜라보를 고민하고 있는데 A기업과 B기업에 마진율이 달라서 고객에게 제공하는 할인이 서로 다릅니다.
A기업과 콜라보를 한다면 고객에게 10퍼센트를 할인해줄 수 있고 B기업과 콜라보를 한다면 고객에게 20퍼센트를 할인해줄 수 있습니다.
기획자는 A기업은 비싼만큼 퀄리티가 좋고 B기업은 퀄리티가 조금 떨어지는만큼 싸다는 특징때문에 고민중입니다.
정리)
개발자는 그럼 기획자가 결정하기 전까지 개발을 못하겠네요? 아니요. 둘 다 개발하고 결정되면 그때 바꿔끼워야죠. 수치만 바꿔주는거니까요.
public interface Discount {
void payment();
}
이런 인터페이스를 하나 만들어두고?
public class ACompanyPayment implements Discount {
@Override
public void payment() {
// 10퍼센트 할인
// 할인 정책 엄청 많은 코드와 로직
}
}
public class BCompanyPayment implements Discount {
@Override
public void payment() {
// 20퍼센트 할인
// 할인 정책 엄청 많은 코드와 로직
}
}
그리고 실질적으로 할인이 이루어지는 코드에선 이렇게 사용합니다.
@Service
public class PaymentService {
private Discount discount = new ACompanyPayment();
public void collaborationPayment() {
discount.payment();
}
}
일단 A기업 콜라보로 만들어두고 기획자의 결정을 기다립니다...
기획자가 B기업으로 결정했다고 개발자들에게 전했습니다. 만약 이 상황에서 B를 갑자기 만들어야하면 주7일 근무를 해야할지도 모릅니다.
하지만! 우리는 A와 B를 모두 만들어뒀기 때문에 바로 바꿔끼워주기만 하면됩니다.
바로 이렇게요.
@Service
public class PaymentService {
private Discount discount = new BCompanyPayment();
public void collaborationPayment() {
discount.payment();
}
}
자 이렇게 하면 비즈니스 로직인 collaborationPayment의 코드 변경 없이 콜라보를 마무리지을 수 있었습니다...만
진짜 코드의 변경이 없었나요?
@Service
public class PaymentService {
private Discount discount = new BCompanyPayment(); // 이 부분이 A에서 B로 변경됨
public void collaborationPayment() {
discount.payment();
}
}
일단 OCP에 위배됐고, SRP도 위배됐습니다. (SOLID에 대해서 알고 계시면 이해하기 쉽습니다!)
코드의 변경이 있었으니 OCP에 위배되었고 결제를 위해 만들어진 PaymentService가 할인 정책을 결정하는 역할까지 맡고있으니 SRP에도 위배된 것입니다.
이럴 때 "빈"을 직접 등록하면 정말 편해집니다.
public class CollaborationConfig {
@Bean
public Discount discount() {
return new ACompanyPayment();
}
}
@Service
public class PaymentService {
@Autowired
private Discount discount;
public void collaborationPayment() {
discount.payment();
}
}
어떤가요? 자 이제 B기업으로 콜라보를 바꿔보겠습니다.
public class CollaborationConfig {
@Bean
public Discount discount() {
return new BCompanyPayment();
}
}
@Service
public class PaymentService {
@Autowired
private Discount discount;
public void collaborationPayment() {
discount.payment();
}
}
자 PaymentService에서 코드의 변경이 하나도 없었네요. OCP에 위배되지 않았죠? 그리고 SRP도 위배되지 않았네요. CollaborationConfig는 콜라보를 결정하는 책임을 가지고 있고 PaymentService에는 결제하는 책임만을 가지고 있죠.
스프링 컨테이너의 도움을 받아서 우리는 객체지향에 한걸음 가까워졌습니다.
이 내용은 인프런의 김영한 강사님의 강의에도 나와있는 내용입니다. 자세한 내용은 강의를 확인해주세요!
하지만 제가 하고 싶은 말은 이게 아닙니다.
그래서 뭐요?
결국 스프링 컨테이너를 이용하면 SRP, OCP 그리고 심지어 DIP까지 객체지향의 핵심 원칙 세가지를 모두 지킬 수 있다는 것입니다.
하지만 위와 같은 예제는 조금 현실성이 떨어지는 예시입니다. 이런 상황이 있긴 있지만 흔하지 않은 상황이라는 것이죠.
실제로 어떤 상황이 직접 빈을 등록하는 경우인지 예시를 두개 소개해드리려고 합니다.
상황1) 스프링 컨테이너가 뜰 때 객체에 대한 설정을 해줘야할 때
제가 지금 회사에서 개발하고 있는 것이 미디어 서버를 이용한 영상채팅을 구현하고 있는데 이 OpenVidu라는 객체를 @PostContruct 를 이용해서 초기화시켜줍니다.
이게 뭔가 뜻이 있어서 그런건 아니고 오픈소스 예제코드가 이렇게 생겼더라구요...
그런데 이 오픈소스를 커스터마이징 하는 과정에서 문제가 발생했습니다.
public class Controller {
private OpenVidu openvidu;
@PostConstruct
public void init() {
openvidu = new Openvidu();
// 각종 설정들
}
@GetMapping("/api/sessions")
public void createSession() {
Session session = openvidu.createSession();
// 각종 로직들
}
}
실제 코드를 대충 각색해봤습니다.
어떤 문제였냐하면 이 OpenVidu 객체를 다른 클래스에서도 사용해야 했던 것입니다.
그런데 이 OpenVidu 객체는 Controller 라는 클래스 혼자서만 독식하고있습니다. 또한, 이 OpenVidu라는 객체는 스프링 컨테이너에 의해 관리되는 객체도 아닙니다. 그래서 전역적으로 사용하지 못했던 것이죠.
저는 이 OpenVidu라는 오픈소스를 커스터마이징 하는 과정에서 OpenVidu 객체를 전역적으로 사용해야하기 때문에 이를 스프링 컨테이너의 도움을 받기로 결정했습니다.
public class OpenViduConfig {
@Bean
public OpenVidu openVidu() {
OpenVidu openvidu = new OpenVidu();
openvidu.set~
// 각종 설정들
}
}
이렇게 OpenVidu 라는 객체를 스프링 컨테이너에 직접 등록함으로써 테스트를 작성하기도 편해졌고 전역적으로 모든 곳에서 OpenVidu 객체를 사용할 수 있었습니다.
상황2) 서버간 통신을 위해 서버를 등록해줘야 하는 상황
서버간 통신을 위해서 어떤 서버에 데이터를 보내야하는지 명시적으로 선언해줘야합니다.
@PostMapping("/")
@ResponseBody
public String paymentPost(HttpServletRequest request) {
// TODO 회원 인증으로 넘어가야함.
HttpSession session = request.getSession(false);
Object value = session.getAttribute("authentication");
WebClient webClient = WebClient.create("http://localhost:8090");
ResponseEntity<String> responseEntity = webClient.get()
.uri("/member/authentication/{username}", value)
.retrieve()
.toEntity(String.class)
.block();
return responseEntity.getBody();
}
WebClient.create() 이 부분이 바로 서버를 선언해주는 곳입니다. 하지만 이런 코드를 한두번 더 써보고 이걸 빈으로 등록해줘야겠다는 생각을 했습니다. 왜냐하면
@PostMapping("/")
@ResponseBody
public String paymentPost(HttpServletRequest request) {
// TODO 회원 인증으로 넘어가야함.
HttpSession session = request.getSession(false);
Object value = session.getAttribute("authentication");
WebClient webClient = WebClient.create("http://localhost:8090");
ResponseEntity<String> responseEntity = webClient.get()
.uri("/member/authentication/{username}", value)
.retrieve()
.toEntity(String.class)
.block();
return responseEntity.getBody();
}
@PostMapping("/payment")
public String payment() {
WebClient webClient = WebClient.create("http://localhost:8090");
ResponseEntity<String> responseEntity = webClient.get()
.uri("/member/payment")
.retrieve()
.toEntity(String.class)
.block();
return responseEntity.getBody();
}
이렇게 두 곳에서 WebClient를 사용하고 있었는데 코드의 중복 뿐만 아니라 OCP를 위배하기도 합니다. 만약 도메인이 바뀐다거나 포트가 바뀌어버리면 직접 이 컨트롤러 클래스로 와서 하드코딩된 "http://localhost:8090" 이 부분을 직접 수정해줘야합니다.
또한, 만약 기존 8090 서버 말고 8070서버가 추가된다면 어떨까요?
WebClient webClient = WebClient.create("http://localhost:8070");
이렇게 계속 추가해줘야합니다.
이럴 때 스프링 컨테이너의 도움을 받아서 전역적으로 관리해주면 정말 편하겠다싶어서 리팩토링을 진행했습니다.
@Configuration
public class ServerConfig {
private static final String AUTHENTICATION_SERVER = "http://localhost:8090";
private static final String COST_SETTLEMENT_SERVER = "http://localhost:8070";
@Bean
public WebClient authenticationServer() {
return WebClient.create(AUTHENTICATION_SERVER);
}
@Bean
public WebClient costSettlementServer() {
return WebClient.create(COST_SETTLEMENT_SERVER);
}
}
이렇게 관리하면 아까 코드가 이렇게 바뀝니다.
@PostMapping("/")
@ResponseBody
public String paymentPost(HttpServletRequest request) {
// TODO 회원 인증으로 넘어가야함.
HttpSession session = request.getSession(false);
Object value = session.getAttribute("authentication");
ResponseEntity<String> responseEntity = authenticationServer.get()
.uri("/member/authentication/{username}", value)
.retrieve()
.toEntity(String.class)
.block();
return responseEntity.getBody();
}
@PostMapping("/payment")
public String payment() {
ResponseEntity<String> responseEntity = authenticationServer.get()
.uri("/member/payment")
.retrieve()
.toEntity(String.class)
.block();
return responseEntity.getBody();
}
이렇게 함으로써 코드의 가독성도 올라가게 되었습니다.
오잉? 코드의 가독성이 어떻게 올라간거지?
기존 코드와 직접 비교하면서 알아보죠.
// 기존 코드
WebClient webClient = WebClient.create("http://localhost:8090");
webClient.get()
// 바뀐 코드
authenticationServer.get();
그냥 코드 몇줄 사라진게 코드 가독성이 올라간 것이 아닙니다. 기존엔 localhost:8090이 뭐하는 서버인지 모릅니다. 이걸 알기위해선 어떻게 해야할까요?
맞습니다. 주석을 적어야하죠. 하지만 주석이 있어야만 이해할 수 있는 코드는 잘못된 코드입니다. 주석은 코드의 이해를 도와줄뿐이고 없으면 이해가 안되는 코드는 잘못 만든겁니다.
우리는 localhost:8090 이라는 서버는 인증을 위한 서버라는 것을 직접 명시해주고 있기 때문에 코드를 처음 보는 사람도 이 서버가 인증 서버라는 것을 알 수 있게 되는겁니다.
또한, 서버가 추가되더라도 우리는 추가된 서버를 명시적으로 알 수 있고 애플리케이션 전역적으로 사용할 수도 있습니다.
잠깐! 스프링 빈에 대한 틈새 상식!
스프링 빈을 등록하는 과정에서 스프링 내부적인 명명규칙이 있습니다. 컴포넌트 스캔 (@Service, @Repository 등등) 을 사용한다면 클래스이름의 앞글자를 소문자로 바꾼 것을 빈 이름으로 등록합니다.
@Service
public class PaymentService {
}
이렇게 되면 빈 이름은 paymentService
즉 우리가 사용할 때는
@Autowired
private PaymentService paymentService;
이렇게 사용하는 것이 일반적인데 이 때 이렇게 사용하는 이유는 paymentService가 빈 이름이기 때문
우리가 빈을 직접 등록할 때
@Bean
public WebClient authenticationServer {
}
이렇게 만들면 빈이름은 authenticationServer가 됩니다.
물론 이렇게 정해줄 수도 있습니다.
@Bean(name = "authenticationServer")
public WebClient authenticationServer() {
return WebClient.create(AUTHENTICATION_SERVER);
}
그래서 결론은!
제가 예시로 들었던 콜라보는 이해를 돕기 위한 것이지 실제 많이 일어나는 상황은 아닙니다. 하지만 스프링 빈을 직접 등록해야하는 경우는 정말 흔하게 일어납니다.
스프링 빈은 스프링 애플리케이션 전체적으로 사용할 수 있는 "슈퍼전역변수" 같은 것이라고 생각하시면 편합니다.
우리는 변수를 배울 때 지역변수 전역변수를 배우곤 합니다. 지역변수는 메서드 안에서만 사용가능한 변수, 전역 변수는 클래스 내부에서만 사용가능한 변수라고말이죠. 하지만 애플리케이션 전반적으로 모두 사용해야하는 변수는 어떤가요? 전역변수로 커버할 수 없습니다.
이렇듯 모든 클래스에서 사용할 수 있는 변수를 "슈퍼전역변수" 라고 한다면 그것은 스프링 빈이 될 것입니다.
조금 어려운 내용이지만 static 키워드를 이용하면 어느정도 흉내낼 수 있습니다. 하지만 static은 GC의 영향 밖에 있기 때문에 객체가 많아지면 메모리를 많이 잡아먹어서 서버의 성능에 큰 영향을 미칠 수 있습니다.
이번 포스팅을 정리하면 다음과 같습니다.
• 뭔가 같은 행동을 반복하고 있을 때 = 중복이 일어날 때
• 내 프로젝트 전반적으로 모든 곳에서 사용해야하는 변수가 있는 경우
마치며
이번엔 긴 글을 적게 되었습니다. 이번 포스팅을 통해 저도 어느때에 직접 빈을 등록하는지에 대해서 정리하는 계기가 되었습니다.
스프링 빈은 스프링을 사용하는 개발자에게 기본 중에 기본이지만 저도 이 기본기를 잘 활용하고 있냐하면 그건 아닌 것 같은 느낌이 듭니다. 저도 언제쯤 훌륭한 개발자들과 어깨를 나란히할지 모르겠습니다 ㅎㅎ..
저도 포스팅을 계속 쓰면서 정진하도록 하겠습니다. 여러분들 모두 화이팅입니다!
JWT 중복로그인 방지
JWT를 이용해서 인증을 한다면 중복 로그인에 대한 문제를 반드시 겪게 되는 것 같습니다.
로그인을 한 사용자가 다시 로그인을 한다면 이 로그인을 막아야할텐데 (구현은 stateful하게 하지만) stateless인 JWT 특성상 인증과 관련된 부분이 서버와 격리되어있어 서버에서 처리를 하지 못하는 상황이 발생합니다.
이미 발급된 access token (이하 AT) 를 어떻게 제어할 수 없다는 문제가 발생하죠.
JWT 중복로그인 방지
이를 해결하기위해 중간 단계를 거칠 수 밖에 없었습니다. 모든 코드를 다 보여드리기엔 양이 많아 개요만 포스팅하려고 합니다.
먼저 일반적인 JWT는 이렇게 인증을 거칩니다.
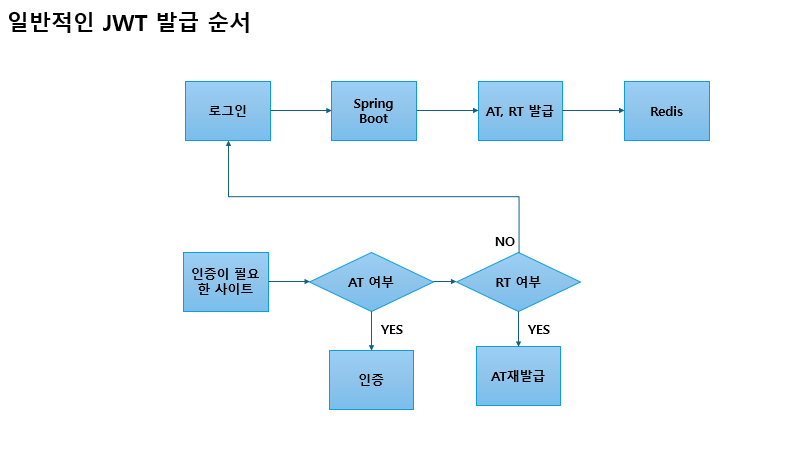
이건 JWT를 아시는 분들에겐 친숙한 흐름도일 것입니다.
하지만 로그인을 한 사용자가 또 로그인을 하는 상황은 어떻게 대처해야할까요?
세션을 사용한다면 기존 세션을 없애버리고 새로운 세션을 생성하면 됩니다. 하지만 이미 발급된 AT는 어떻게 할 방법이 없기 때문에 저는 Redis에서 AT를 한번 더 검증하는 과정을 거쳤습니다.
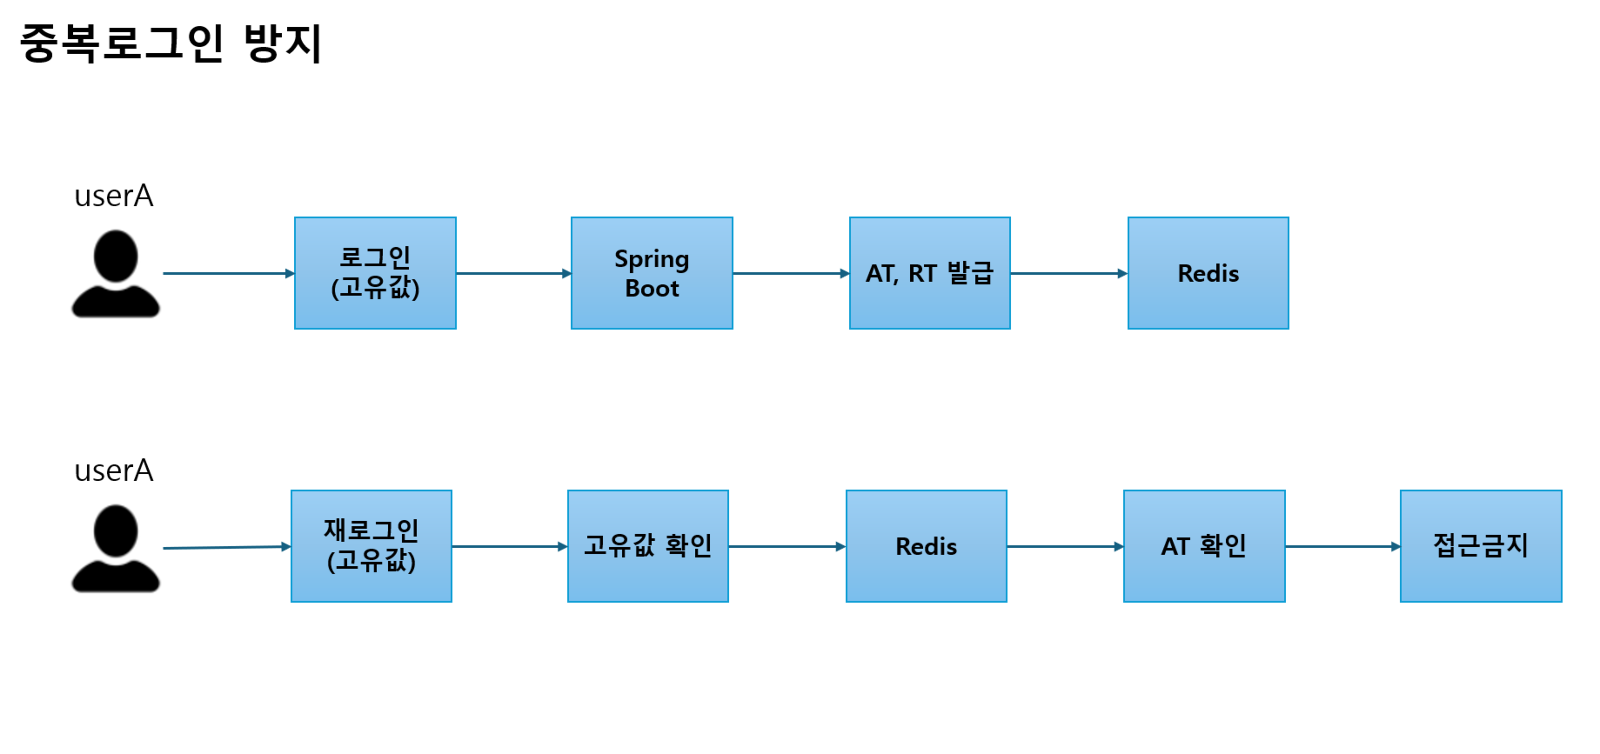
그렇게 하기 위해서 결국 로그인 과정에서 클라이언트 (브라우저) 별 고유값을 서버에 전달할 수 밖에 없었고 서버는 이 고유값을 이용해 Redis에서 토큰을 검증하고 접근을 막을 수 있었습니다.
장점
장점은 뭐니뭐니해도 중복로그인을 방지할 수 있다는 것이죠. ChatGPT는 중복로그인을 막지 않았더군요. 하지만 인프런같은 사이트는 어떨까요? 아이디의 공유를 방지하기 위해서라도 중복로그인을 방지해야합니다.
이런 사이트에선 중복로그인을 방지하는 것이 큰 장점이 될 수 있습니다.
단점
Redis에 토큰을 고유값으로 지속적으로 검증해야한다는 단점이 있습니다. 물론 Redis가 캐시 데이터베이스로 이용되기 때문에 일반적으로 RDB에 접근하는 것보다 리소스가 적게 들어가지만 네트워크 I/O나 CPU자원이 소모되는 것은 사실입니다.
결론
중복로그인을 방지하지 않아도 된다면 그냥 냅두는 것도 좋은 방법이라고 생각합니다. 우리 서비스에 잘 맞는 인증 정책을 가져가면서 어떤 것이 좋을지 고민해보고 적용하는 것이 좋을 것 같네요.
저희 회사에선 중복 로그인을 방지해야 하는 입장이었어서 JWT인데 중복로그인을 방지하기가 꽤나 까다롭더군요.
마치며
JWT 중복 로그인 방지는 이론적으로 크게 어려운 내용은 없지만 코드 내용은 많아 포스팅이 짧아지게 된 것이 조금 아쉽긴 하네요. 짧지만 글 읽어주셔서 감사합니다. 오늘도 즐거운 하루 되세요~
스프링으로 영상 랜더링하기 (Resource Range)
넷플릭스나 유튜브를 보면 이런 경험 있으실겁니다.
이렇게 회색바가 앞으로 천천히 진행하는 것을말이죠.
이렇게 하는 이유는 영상의 크기가 어마어마하다보니 이걸 전부 랜더링하고 사용자에게 내려주면 사용자가 꽤나 오랜시간 기다려야하기 때문에 먼저 영상을 내려주고 조금씩 랜더링하는 방식을 사용합니다.
저도 이걸 구현하게 될 줄은 몰랐습니다. 하지만 많은 레퍼런스가 있어서 따라하기 편했고 의외로 쉽게 구현할 수 있었습니다.
이번 포스팅에선 스프링으로 영상 랜더링하고 리액트로 응용하는 것까지 한번 정리하고 공유해보도록 하겠습니다.
스프링으로 영상 랜더링하기
@RestController
@RequiredArgsConstructor
@Slf4j
public class CouponController {
@Value("${record-path}")
String recordPath;
@GetMapping("/api/video/{streamId}")
public ResponseEntity<ResourceRegion> videoRegion(@RequestHeader HttpHeaders headers, @PathVariable("streamId") String streamId) throws Exception {
String path = recordPath + streamId + ".webm"
Resource resource = new FileSystemResource(path);
long chunkSize = 1024 * 1024 * 10; // 10MB
long contentLength = resource.contentLength();
ResourceRegion region;
try {
HttpRange httpRange = headers.getRange().stream().findFirst().get();
long start = httpRange.getRangeStart(contentLength);
long end = httpRange.getRangeEnd(contentLength);
long rangeLength = Long.min(chunkSize, end -start + 1);
log.info("start === {} , end == {}", start, end);
region = new ResourceRegion(resource, start, rangeLength);
} catch (Exception e) {
long rangeLength = Long.min(chunkSize, contentLength);
region = new ResourceRegion(resource, 0, rangeLength);
}
return ResponseEntity.status(HttpStatus.PARTIAL_CONTENT)
.cacheControl(CacheControl.maxAge(10, TimeUnit.MINUTES))
.contentType(MediaTypeFactory.getMediaType(resource).orElse(MediaType.APPLICATION_OCTET_STREAM))
.header("Accept-Ranges", "bytes")
.eTag(path)
.body(region);
}
}
이게 끝입니다! 여기서 중요한건 chunkSize만큼 추가 랜더링을 진행한다는 점입니다. 즉, 저 회색바를 얼마만큼으로 할지를 chunkSize가 결정한다고 보시면 됩니다.
저희 회사 서비스는 사용자가 선택함에따라 영상이 바뀌어야해서 리액트쪽에서 조금 이 랜더링을 활용했습니다.
function Video(props) {
const {streamId, startTime} = props
useEffect(() => {
video.current.currentTime = startTime;
}, [startTime])
return (
<video autoPlay controls ref={video} key={streamId}>
<source src={'api/video/' + streamId} type="video/webm">
</video>
)
}
일단 이렇게 Video 컴포넌트를 만들어줍니다. 그리고 이걸 사용하는 쪽에선
function StudentView() {
const [nowVideo, setNowVideo] = useState({
streamId: '초기값',
startTime: 0
});
const [videoInfo, setVideoInfo] = useState({});
axios.get('/api/video', headers: {"Content-Type": "application/json"})
.then((response) => {
setVideoInfo(response);
});
const setNowVideo(streamId, startTime) = () => {
setNowVideo({...nowVideo, streamId: streamId, startTime: startTime});
}
return (
<div>
{videoInfo.map((video) => {
<button onClick={() => setNowVideo(video.streamId, video.startTime)}>선택구간</button>
})}
<Video streamId={nowVideo.streamId} startTime={nowVideo.startTime}/>
</div>
)
}
이렇게 선택구간에 시작시간을 서버에서 가져온 뒤 "선택구간"이라는 버튼을 클릭하면 nowVideo값을 바꿔주면서 <video> 태그를 리랜더링하는 방식입니다.
제가 리액트를 사용한지 얼마 안되서 잘 몰랐던게 리액트에선 key라는 파라미터로 리랜더링 여부를 결정하는 것 같더군요. 음... 아닐수도 있습니다.
그래서 처음엔 <video> 태그 안에 있는 src만 상태값을 변경했더니 src는 정상적으로 변경됐지만 비디오가 랜더링이 안되서 처음에 재생했던 영상을 계속 재생했습니다.
대신 key라는 파라미터는 말 그대로 PK같은 역할을 해야하더군요. map으로 여러개 두어도 key가 달라야한다고 사수가 말해줬습니다.
그래서 절대 중복될리 없는 streamId를 key로 주어 streamId가 바뀔때마다 <video>태그가 리랜더링되면서 사용자에게 보여줄 수 있었습니다.
마치며
회사 서비스에 직접적인 기여를 한건 이번이 처음이네요. 사실 이건 버전2고 버전1이 따로 있습니다. 지금 대표님의 컨펌을 기다리고 있죠.
버전1은 버튼을 클릭하면 모달로 나와서 영상을 크게 보여주는 것입니다. 이렇게 개발했는데 상무님이 현재 페이지에서 모달말고 화면공유가 되는 곳을 화면공유 말고 녹화해놓은 영상으로 보여주는게 어떻겠냐고 하셔서 버전2를 만들게 되었습니다.
모달까지 포스팅하면 스프링으로 영상 랜더링이 아니고 리액트로 비디오태그 조절하기가 될 것같아서 빼놓았습니다.
회사에서 리액트를 사용하고 OpenVidu도 리액트로 개발해놔서 요즘 리액트 코드를 많이 보고 많이 접하고 많이 개발하게 되었습니다.
덕분에 손에 조금 익은 것 같은데 아직 최적화라던가 이런 부분이 조금 약한 것 같습니다.
백엔드 개발자가 백엔드만 알면 그건 미덕이 못된다고 생각하는 철학을 가지고 있는 저로서 회사에서 프론트에 대해서 공부하면서 서비스에 기여까지 해보고 오래살고볼 일입니다. 백엔드에만 투자해온 저에게 황금같은 시간이었습니다.
이번 포스팅은 여기까지입니다! 긴 글 읽어주셔서 감사합니다. 오늘도 즐거운 하루 되세요~
Spring AOP 와 Redis의 분산락이 만나면
일단 포스팅은 아래의 링크를 참고하였습니다.
https://helloworld.kurly.com/blog/distributed-redisson-lock/
컬리에서 다양한 동시성 문제를 앓았다고 합니다.
1. 동시에 요청하는 사용자
2. Kafka에서 동시에 보내는 메세지
등등
이런 상황에서 다양한 동시성 문제가 있었고 이를 처음엔 RDBMS의 분산락으로 해결했다고 하더군요. 하지만 락킹 매커니즘을 RDBMS가 담당해야 하기 때문에 데이터베이스에 부하가 심하게 걸린다는 사실을 알아내셨습니다.
때문에 Redis의 분산락을 이용하기로 결정했고 이를 스프링과 잘 조합하여 성공적으로 동시성문제를 해결하셨다고 하시네요.
이를 공부해보고 실습해서 결과까지 정리해봤습니다.
동시성문제와 분산락
동시성 문제는 흔히 알려진 문제로 이는 데이터베이스의 트랜잭션과 관련된 문제입니다. 서로 다른 트랜잭션이 락킹 매커니즘 없이 데이터에 접근하여 데이터의 값이 꼬여버리는 상황이죠.
운영체제에서, 그리고 컴퓨터공학에서 많이 언급되는 race condition입니다.
race condition을 해결하는 방법은 여러가지가 있는데요. 운영체제에선 세마포어와 뮤텍스라는 개념이 나오고 Java에선 언어적으로 synchronized 키워드를 제공해주죠.
그리고 이 synchronized 키워드를 적절히 사용한 JDBC 드라이버가 있습니다. 이 JDBC 드라이버를 이용해서 만든 JDBC Template이나 JPA같은 ORM, MyBatis와 같은 것들에서 다양한 락킹 매커니즘을 제공해줍니다.
RDBMS에선 흔히 비관적락과 낙관적락을 얘기할 수 있을 것 같습니다.
해당 내용은 아래의 링크에 자세히 설명되어있습니다.
https://coding-review.tistory.com/386
동시성 문제가 발생하는 상황 하나를 실습해보고 처음엔 RDBMS의 비관적락을 이용해서 해결해보고 Redis의 분산락을 이용해서 해결해보도록 하겠습니다.
@Transactional
public Item updatePrice() {
Item item = itemRepository.findById(2L).orElse(null);
int price = item.getPrice();
price++;
item.setPrice(price);
itemRepository.save(item);
return item;
}
updatePrice()를 호출하면 하나를 가져와서 price를 하나 올려주고 데이터를 저장하는 로직입니다 .
굉장히 간단합니다.
이제 이걸 멀티스레드 환경에 넣고 돌려보겠습니다.
@Test
public void concurrencyWithUpdateQuery() throws Exception {
ExecutorService executorService = Executors.newFixedThreadPool(100);
CountDownLatch latch = new CountDownLatch(100);
for (int i = 0; i < 100; i++) {
executorService.execute(() -> {
try {
itemService.updatePrice();
}
finally {
latch.countDown();
}
});
}
latch.await();
Item concurrency = itemRepository.findByItemName("concurrency");
assertThat(concurrency.getPrice()).isEqualTo(100);
}
결과는 이렇게 원하는대로 나오지 않았습니다.
예상가능한 상황이었죠. 이제 비관적락을 이용해서 락을 걸어보겠습니다.
이렇게 읽기 쿼리에 Pessimistic Lock을 걸었습니다.
이제 실행해보면?
정상적으로 완료가 된 것을 확인할 수 있습니다.
이렇게 해결은 했지만 컬리의 백엔드 팀에선 이렇게 하는 경우 RDBMS에 부하가 걸려 좋은 상황은 아니라고 하더라구요. 이를 위해 Redis의 Redisson을 사용했다고 전해집니다.
왜 Lettuce가 아니고 Redisson이냐하면 Lettuce는 자체적인 락킹 매커니즘을 가지고 있지 않아서 Redis에 수시로 Lock이 있는지 확인해야하는 작업을 거쳐야하기 때문에 RDBMS의 부하를 그대로 Redis가 가져가게 됩니다.
하지만 Redisson은 Pub/Sub 메세징으로 Lock이 있는지 없는지 확인하기 때문에 Redis에 부하가 걸리지 않아 Redisson을 사용했다고 하더군요.
이제 한번 Redis의 Redisson을 사용해서 해결해보겠습니다.
Redis의 분산락을 이용해 동시성 문제 해결하기
우선 어노테이션을 먼저 만들어야합니다.
@Target(ElementType.METHOD)
@Retention(RetentionPolicy.RUNTIME)
public @interface DistributedLock {
String key();
TimeUnit timeUnit() default TimeUnit.SECONDS;
long waitTime() default 5L;
long leaseTime() default 3L;
}
key는 실제로 key가될 값이고 waitTime은 락을 획득하기위해 커넥션이 기다리는 시간을 말합니다. leaseTime은 이 시간 이후에 락을 획득하고 락을 놓아주는 시간입니다.
그리고 RedisConfig 파일에 다음과 같은 설정을 해줍니다.
package com.example.firstapplication.config;
@Configuration
@EnableRedisHttpSession
@EnableRedisRepositories
@Slf4j
public class RedisConfig {
@Value("${spring.redis.host}")
private String host;
@Value("${spring.redis.port}")
private int port;
@Bean
public RedisConnectionFactory redisConnectionFactory() {
return new LettuceConnectionFactory(host, port);
}
@Bean
public RedissonClient redissonClient() {
RedissonClient redisson = null;
Config config = new Config();
config.useSingleServer().setAddress(String.format("redis://%s:%d", host, port));
redisson = Redisson.create(config);
return redisson;
}
}
그리고 이제 Parser를 하나 만들어줄겁니다. Parser는 전달받은 Lock의 이름을 Spring Expression Language로 파싱해서 읽어오기 위해 필요한 클래스입니다.
public class CustomSpringELParser {
private CustomSpringELParser() {}
public static Object getDynamicValue(String[] parameterNames, Object[] args, String key) {
ExpressionParser parser = new SpelExpressionParser();
StandardEvaluationContext context = new StandardEvaluationContext();
for (int i = 0; i < parameterNames.length; i++) {
context.setVariable(parameterNames[i], args[i]);
}
return parser.parseExpression(key).getValue(context, Object.class);
}
}
그리고 AOP를 위한 Transaction을 하나 만들어주도록 하겠습니다.
@Component
public class AopForTransaction {
@Transactional(propagation = Propagation.REQUIRES_NEW)
public Object proceed(final ProceedingJoinPoint joinPoint) throws Throwable {
return joinPoint.proceed();
}
}
AOP를 이용할건데 AOP의 joinPoint에 트랜잭션을 걸기위해 사용하는 클래스입니다. 따로 빼주는 것 같네요.
그리고 이제 제일 중요한 AOP를 만들어봅시다.
@Aspect
@Component
@RequiredArgsConstructor
@Slf4j
public class DistributedLockAop {
private static final String REDISSON_LOCK_PREFIX = "LOCK:";
private final RedissonClient redissonClient;
private final AopForTransaction aopForTransaction;
@Around("@annotation(com.example.firstapplication.annotation.DistributedLock)")
public Object lock(final ProceedingJoinPoint joinPoint) throws Throwable {
MethodSignature signature = (MethodSignature) joinPoint.getSignature();
Method method = signature.getMethod();
DistributedLock distributedLock = method.getAnnotation(DistributedLock.class);
String key = REDISSON_LOCK_PREFIX + CustomSpringELParser.getDynamicValue(signature.getParameterNames(), joinPoint.getArgs(), distributedLock.key());
RLock rLock = redissonClient.getLock(key);
boolean available = false;
try {
available = rLock.tryLock(distributedLock.waitTime(), distributedLock.leaseTime(), distributedLock.timeUnit());
if (!available) {
return false;
}
return aopForTransaction.proceed(joinPoint);
} catch (InterruptedException e) {
Thread.currentThread().interrupt();
throw new RuntimeException("Thread was interrupted while acquiring lock", e);
} finally {
try {
rLock.unlock();
} catch (IllegalMonitorStateException e) {
log.info("Redisson Lock Already Unlock {} {}", method.getName(), key);
}
}
}
}
순서를 잘보시면 컬리팀의 숨겨진 디테일이 있습니다.
• 락을 획득하고
• 락이 사용가능한지 확인한 뒤
• aopForTransaction.proceed()를 이용해 트랜잭션을 겁니다. 그리고 이 행동이 완료되면 커밋을 하겠죠.
• 그리고 락을 반납합니다.
컬리팀에선 무조건 트랜잭션의 커밋을 락을 반납하기 전에 하도록 하였는데 이 순서가 매우 중요합니다.
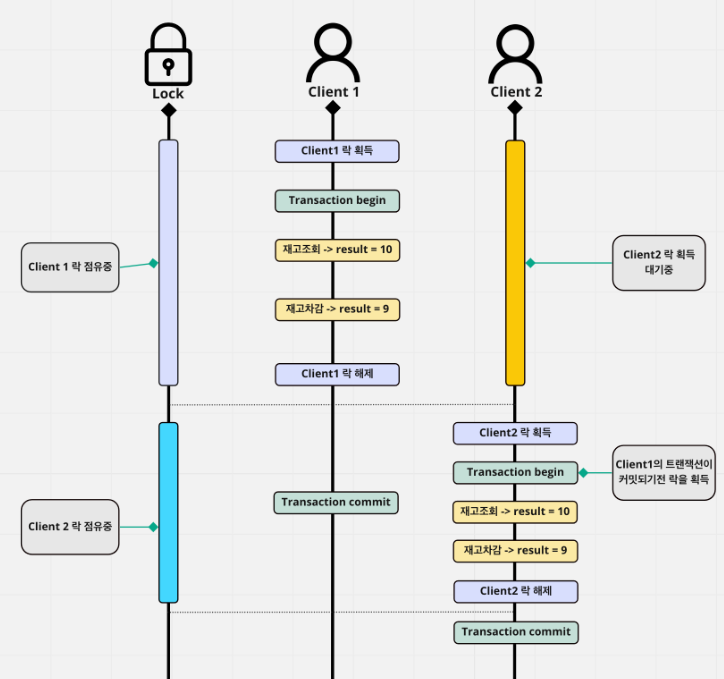
이렇게 락을 해제하고 커밋을 하게 되면 Client2가 락을 획득하고 트랜잭션을 시작했을 때 값이 맞지않아 문제가 생길 수 있습니다. 네, race condition이죠.
그래서 커밋을 락을 해제하기 전에 반드시 해줌으로써 이 값이 꼬이지 않게 해주는 것 같습니다.
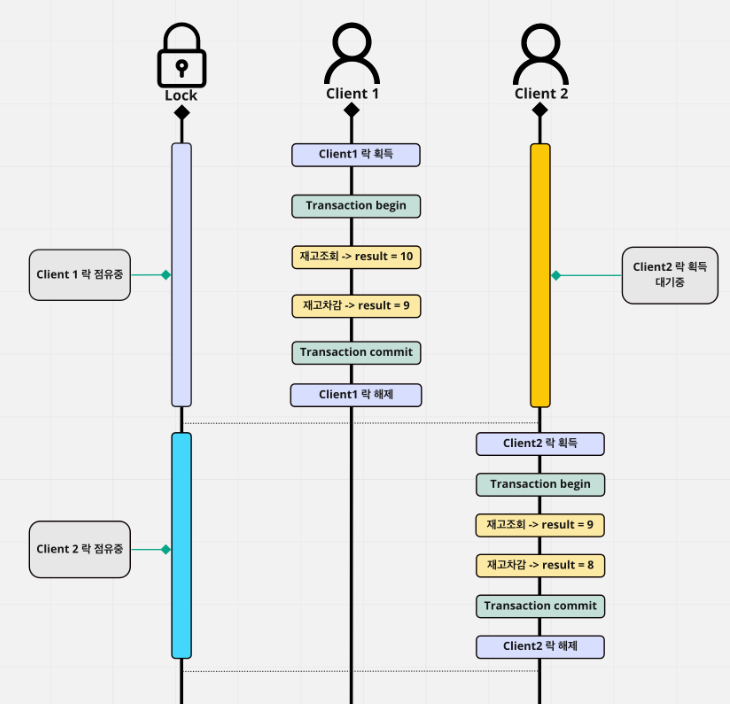
자 이제 코드도 다 생성했고 원리도 이해했으니 실험을 해보겠습니다.
package com.example.firstapplication.service;
import com.example.firstapplication.annotation.DistributedLock;
import com.example.firstapplication.entity.Item;
import com.example.firstapplication.repository.ItemRepository;
import lombok.RequiredArgsConstructor;
import lombok.extern.slf4j.Slf4j;
import org.springframework.cache.annotation.Cacheable;
import org.springframework.stereotype.Service;
import org.springframework.transaction.annotation.Transactional;
@Service
@RequiredArgsConstructor
@Slf4j
public class ItemService {
private final ItemRepository itemRepository;
@Transactional
public Item updatePrice() {
Item item = itemRepository.findById(2L).orElse(null);
int price = item.getPrice();
price++;
item.setPrice(price);
itemRepository.save(item);
return item;
}
@DistributedLock(key = "#key")
public Item distributedLock(String key) {
Item item = itemRepository.findById(2L).orElse(null);
int price = item.getPrice();
price++;
item.setPrice(price);
return item;
}
}
@Test
public void concurrencyControlWithDistributedLock() throws Exception {
ExecutorService executorService = Executors.newFixedThreadPool(100);
CountDownLatch latch = new CountDownLatch(100);
for (int i = 0; i < 100; i++) {
executorService.execute(() -> {
try {
itemService.distributedLock("key");
}
finally {
latch.countDown();
}
});
}
latch.await();
Item item = itemRepository.findById(2L).orElse(null);
assertThat(item.getPrice()).isEqualTo(100);
}
이렇게 실험을 해보면?
똑같이 성공하는 모습을 볼 수 있습니다.
정리
RDBMS의 비관적 락과 Redis의 분산락을 이용해서 동시성 문제를 해결해봤습니다. 다시 정리하자면 다음과 같습니다.
• RDBMS의 비관적 락으로 동시성 문제를 해결하는 것은 RDBMS가 락킹 매커니즘을 처리해야하기 때문에 부하가 심하다.
• 스프링 진영에서 Redis를 구현한 라이브러리인 Lettuce와 Redisson중 Redisson을 사용해야한다.
• 그 이유는 Lettuce는 스핀락이라고 하는 Redis에 지속적으로 Lock이 있는지 요청해야하기 때문이다.
• Redisson은 Pub/Sub 메세징으로 Lock을 검사해서 Redis에 부하가 없다.
• 락을 해제하는 시점은 트랜잭션이 커밋하고 난 뒤에 해야한다.
• try/catch문이 반복적으로 등장하는 공통 관심사를 AOP를 이용해서 깔끔하게 어노테이션으로 해결할 수 있다.
또한, 실제로 부하 차이만 있지 성능 차이는 거의 비슷한 것으로 보여집니다.
마치며
나중에 시간이 된다면 JMeter나 NGrinder를 이용해서 서버 부하에 대한 성능 비교까지 해보도록 하겠습니다. 다음 주제는 그게 될 것 같네요.
Redis... 이자식 생각보다 엄청나게 쓸모가 많네요. Pub/Sub 메세징이 지원된다는 것 자체가 엄청난 메리트가 있을 것 같습니다.
오늘도 긴 글 읽어주셔서 감사합니다. 즐거운 하루 되세요~
출처
https://helloworld.kurly.com/blog/distributed-redisson-lock/
Redis로 대기열 구현하기
이번 포스팅에선 Redis로 대기열을 구현한 것을 공유하려고 컴퓨터 앞에 앉았습니다.
이번에 주요한 기능은 WebSocket과 Redis의 Sorted Set 자료구조입니다. Sorted Set은 정렬 알고리즘의 시간 복잡도가 O(log n)이라 굉장히 빠르고 중복을 허용하지 않는 Set 자료구조에다 정렬이 되어있어 선착순으로 사용자를 지워줄 수 있다는 장점이 있습니다.
Redis의 다양한 자료구조들은 기능을 구현할 때 유용하게 쓰이는 것 같네요.
이번 포스팅은 다음과 같은 흐름을 가집니다.
상황)
온라인 쇼핑몰에서 블랙 프라이데이를 기념하여 50퍼센트 할인 쿠폰을 100명에게 쏩니다. 서버는 이를 감당할 수 있는 대기열을 구현해야합니다.
흐름)
• 사용자가 이벤트 페이지를 조회합니다.
• 조회함과 동시에 웹소켓에 연결합니다.
• 연결할 때 웹소켓 핸들러에서 사용자를 대기열에 추가합니다. 이때 Redis Sorted Set에 추가합니다.
• 10초에 한번씩 Redis range명령어로 상위 10명의 데이터를 가져옵니다. 그와 동시에 데이터베이스에서 수량을 감소시킵니다.
• 상위 10명의 데이터를 Sorted Set에서 지워버립니다.
• 대기하고 있는 사용자에겐 WebSocket을 이용해 현재 얼마나 대기열이 형성되어있는지 알려줍니다.
바로 시작해보죠.
@Data
@AllArgsConstructor
public class Coupon {
private String couponName;
private Item item;
private int code;
}
우선 쿠폰 정보입니다.
그리고 제일 중요한 EventService를 만들어야합니다.
@Service
@RequiredArgsConstructor
@Slf4j
public class EventService {
private final ItemRepository itemRepository;
private final RedisTemplate<String, Object> redisTemplate;
private static final long FIRST_ELEMENT = 0;
private static final long LAST_ELEMENT = 9;
public void addQueue(String sessionId) {
final String people = Thread.currentThread().getName();
final long now = System.currentTimeMillis();
redisTemplate.opsForZSet().add("치킨", sessionId, 10f);
log.info("대기열에 추가 - {} ({})초", people, now);
}
public Long getOrder(String sessionId) {
return redisTemplate.opsForZSet().rank("치킨", sessionId);
}
@Transactional
public void publish(Item item) {
Set<Object> queue = redisTemplate.opsForZSet().range("치킨", FIRST_ELEMENT, LAST_ELEMENT);
for (Object people : queue) {
final Coupon coupon = new Coupon("치킨", item, 10000);
log.info("{}님의 {}기프티콘이 발급되었습니다. ({})", people, "치킨", coupon.getCode());
redisTemplate.opsForZSet().remove("치킨", people);
Item decreaseItem = item.decreaseCount();
itemRepository.save(decreaseItem);
}
}
public boolean isValidEvent(Item item) {
return item.getCount() == 0;
}
}
FIRST_ELEMENT는 0으로 잡아주시고 LAST_ELEMENT는 몇개의 데이터를 처리할 것인지를 결정하는 것입니다. 저는 0부터 9개 즉, 상위 10개의 데이터를 가져올 것입니다.
@Slf4j
@Component
@RequiredArgsConstructor
public class EventScheduler {
private final EventService eventService;
private final Item item;
@Scheduled(fixedDelay = 10000)
private void chickenEventScheduler() {
if (eventService.isValidEvent(item)) {
log.info("===== 선착순 이벤트가 종료되었습니다. =====");
return;
}
eventService.publish(item);
}
}
EventScheduler에선 10초마다 데이터를 처리해줄겁니다.
@Configuration
@EnableWebSocket
@RequiredArgsConstructor
public class WebSocketConfig implements WebSocketConfigurer {
private final QueueWebSocketHandler queueWebSocketHandler;
@Override
public void registerWebSocketHandlers(WebSocketHandlerRegistry registry) {
registry.addHandler(queueWebSocketHandler, "/ws").setAllowedOrigins("*");
}
}
위의 Config는 웹소켓과 관련된 설정입니다.
@Slf4j
@Component
@RequiredArgsConstructor
public class QueueWebSocketHandler extends TextWebSocketHandler {
private final EventService eventService;
private final RedisTemplate<String, Object> redisTemplate;
@Override
public void afterConnectionEstablished(WebSocketSession session) throws Exception {
eventService.addQueue(session.getId());
log.info("Connected : " + session.getId());
}
@Override
protected void handleTextMessage(WebSocketSession session, TextMessage message) throws Exception {
Long rank = eventService.getOrder(session.getId());
log.info("session id : " + session.getId());
long rankMessage = rank == null ? 0 : rank;
session.sendMessage(new TextMessage(String.valueOf(rankMessage)));
}
@Override
public void afterConnectionClosed(WebSocketSession session, CloseStatus status) throws Exception {
log.info("Disconnected : " + session.getId());
}
}
QueueWebSocketHandler에선 웹소켓과 관련된 작업을 처리해줄겁니다.
그리고 프론트단을 가볍게 만들어보면?
import {useEffect, useRef, useState} from 'react'
import './App.css'
function App() {
const ws = useRef(null);
const [queue, setQueue] = useState("0");
useEffect(() => {
ws.current = new WebSocket("ws://localhost:8080/ws");
console.log("test");
const sendMessage = setInterval(() => {
ws.current.send("hello");
}, 2000);
ws.current.onmessage = function(event) {
setQueue(event.data);
}
return () => {
clearInterval(sendMessage);
}
}, [])
return (
<div className="App">
<div className='message'>잠시만 기다려주세요.</div>
{queue && (
<div className='queue-message'>
대기열 : {queue}
</div>
)}
</div>
);
}
export default App;
처음에 웹소켓과 연결하고 2초마다 hello 메세지를 보내서 현재 대기열이 얼마나 남았는지 알려주는 역할을 합니다. 그리고 UseState를 이용해서 값을 지속적으로 변경해주도록 하겠습니다.
그럼 결과물이 이렇게 나옵니다.
마치며
Redis는 참 보면볼수록 오묘한... 그런 녀석인 것 같습니다. 저는 캐시로 사용하고 땡인줄 알았는데 다양한 자료구조로 다양한 기능을 만들 수 있는 것을 보고 새삼 왜 사람들이 Redis를 많이 사용하는지 알겠더군요.
저는 이번 기회에 Redis에 대해 좀 더 깊이있게 공부하게 된 것 같아 정말 뿌듯합니다. 오늘도 긴 글 읽어주셔서 감사합니다. 즐거운 하루 되세요~
@Transactional, 진짜 Checked Exception을 사용하면 안될까?
이번 포스팅에서는 또 @Transactional 어노테이션에 대한 내용입니다. 제 블로그에 트랜잭션과 관련된 글이 일곱개나 되는데 이거까지 합치면 여덟개입니다...
사골을 너무 우려서 뼈가 말랑말랑 해질거같은데 하지만 나름 중요한 내용인 것 같아서 또 우려보겠습니다.
이번에 포스팅하게 된 이유는 트위터에서 어떤 개발자분이 @Transactional을 사용하려면 Checked Execption을 사용하지 말아야된다는 글이었습니다.
그리고 공부하게 되었죠.
Checked? UnChecked?
우선 본 내용으로 들어가기 전에 자바의 Exception의 종류에 대해서 짚고 넘어가도록 하겠습니다.
기존 자바 언어 개발자들은 Checked Exception을 개발하면서 정말 잘 개발했다고 생각하게 됐다고합니다. 그렇게 처음 자바엔 Checked Exception밖에 없었다고 하죠.
하지만 이후 문제점을 깨닫게 됩니다.
처리할 수 없는 예외가 너무 많다.
예외를 모두 컴파일타임 때 체크해서 처리하도록 했더니 처리할 수 없는 예외가 등장하기 시작했습니다. 그리고 우리가 겪는 대부분의 예외는 처리가 불가능한 경우가 대부분입니다.
예를 들면 데이터베이스 커넥션 예외라던가, 네트워크 연결 예외라던가, 파일 입출력 예외 등등이 그러하죠.
이 예외가 터진다고 한들 자바입장에서 뭔가 하기가 힘들어졌습니다. 데이터베이스 커넥션 예외가 터졌다! 그럼... 뭐?
이 상황이 반복되는게 문제였습니다.
처리할 수 없는 예외는 전부 던져버렸다.
Checked Exception에서 처리할 수 없는 예외는 throws로 던져버려야합니다. 타고타고 들어간 로직에서 Checked Exception이 발생하면 위로위로위로 던져버리게 되었습니다.
일단 보기에 굉장히 흉해졌습니다.
public void businessLogic() throws 어쩌구예외, 저쩌구예외, 이런예외, 저런예외 {
// logic
}
이짓이 너무나도 화난 개발자 한명이 다음과 같은 만행을 저지릅니다.
public void businessLogic() throws Exception {
// logic
}
이후 이 개발자가 개발한 로직에서 디버깅하기가 굉장히 힘들어졌습니다.
그로인해 Exception이 OCP를 위배했다.
만약 JDBC를 이용한 상황에서 Checked Exception이 발생해서 이런 예외를 던졌다고 가정해봅시다. 가정입니다!
public void dbInit() throws JDBC예외 {
}
이 상황에서 JPA로 바꾼다면 어떻게 될까요? 예외를 전부 바꿔야합니다!
public void dbInit() throws JPA예외 {
}
이런 상황에서 기술적인 확장은 했지만 코드의 변경을 피할 수 없었습니다. 확장에 열려있고 변경에 닫혀있어야한다는 OCP에 위배됩니다.
Unchecked Exception의 등장
이런 문제를 자바 언어 개발팀과 여러 팀에서 인지하고 Exception을 컴파일 타임에서 체크하지 않는 Unchecked Exception이 많이 개발되었습니다.
Unchecked Exception이 등장하면서 Exception을 어느 상황에서 사용해야하는지 기준이 명확해졌습니다.
기본적으로 위에서의 이유 때문에 Unchecked Exception을 사용하면서 로그 시스템으로 장애 상황을 인지하는쪽으로 굳어지고 Checked Exception은 개발자간 협업할 때 이 예외를 반드시 처리하고 넘어가라는 명시적인 표현으로 사용하게 되었습니다.
때문에 Checked Exception은 결제로직과 같은 예외상황을 반드시 처리해줘야 하는 상황에서 주로 사용하게 되었죠.
@Transactional과 롤백 전략
여기까지 내용은 인프런의 영한님 강의를 들으셨다면 들어보신 내용일겁니다. 그래서 오늘의 본 내용인 @Transactional과 롤백 전략입니다.
스프링에서 만약 @Transactional을 사용한 로직이라면 트랜잭션을 생성해 트랜잭션의 원자성을 보장받을 수 있게 됩니다. 트랜잭션이 실패하면 모든 상황을 롤백해야하는데 스프링에서 그 전략을 Exception 상황을 기반하여 처리합니다.
Exception이 발생하면 롤백을 하는것이죠.
@Transactional은 Exception 중 Unchecked Exception이 발생할 때만 롤백을 진행하게 됩니다. 이에 대한 이유는 자세하게 알 수 없었지만 스프링 공식문서에서 그 이유를 대강 짐작할 수 있었습니다.
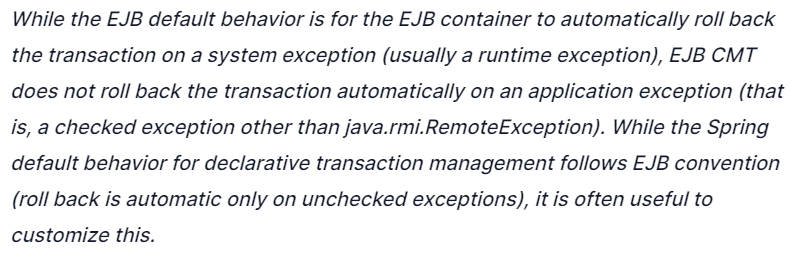
"스프링 컨테이너는 애플리케이션 예외 상황(Checked Exception)이 아닌 시스템 예외상황(Unchecked Exception)에 트랜잭션을 자동적으로 롤백하도록 설계되었다" 라는 이야기입니다.
그리고 첨언으로 "Checked Exception에서 롤백을 하려면 커스텀하게 설정해야한다" 라는 내용이 나와있습니다.
@Transactional(rollbackFor = MyCheckedException.class)
public void logic() {
}
위와같은 방식으로 커스텀하게 처리해줄 수 있습니다.
하지만 여기서 Checked Exception을 try/catch에서 잡아버리면 롤백을 할 수 없습니다. 이때 궁금증이 떠올랐습니다. Checked Exception의 존재의의는 예외 상황을 반드시 처리해야한다고 명시적으로 알리는 용도라는 것을 생각하고 다시 보면 Checked Exception과 try/catch는 뗄래야 뗄 수 없는 상황이라고 생각했습니다.
때문에 Checked Exception과 try/catch문을 둘 다 사용하고 싶은 경우를 알아보니 다음과 같은 방법이 있었습니다.
예외를 던질까 말까~ 던질까 말까~
@Transactional(rollbackFor = MyCheckedException.class)
public void logic() {
try {
// logic
doSomething();
}
catch (MyCheckedException e) {
throw e;
}
}
이렇게 예외를 try 문에서 던지고 catch에서 잡고 다시 예외를 던지는겁니다.
이렇게 하면 @Transactional의 rollbackFor에 잡혀서 롤백을 하게됩니다.
트랜잭션 인터셉터 사용하기
또한, 신기한 방법이 있었는데 아래와 같은 방식으로 예외를 처리할 수 있습니다.
@Transactional
public void myMethod() {
try {
// logic
doSomthing();
} catch (MyCheckedException e) {
TransactionAspectSupport.currentTransactionStatus().setRollbackOnly();
}
}
이렇게 TransactionAspectSupport라는 트랜잭션 인터셉터를 이용해서 예외가 발생하면 롤백을 바로 진행시키는겁니다.
마치며
흔히 스프링 개발자들 사이에서 "@Transactional에 Checked Exception를 사용하는 것이 안티패턴이다!" 라는 것으로 갑론을박을 하게 되는데 저는 개인적으로 그렇게 안티패턴이라고 정의하면서까지 기피해야할 것은 아니라고 생각합니다.
실전에서 @Transactional을 사용하게 되는 경우는 비즈니스 로직에 트랜잭션을 태워서 보내는 용도로 사용하는데 그 와중에서 Checked Exception을 사용해야 하는 경우도 있을거라고 생각합니다.
물론, "이럴거면 그냥 UnChecked Exception 사용하는거랑 뭐가 다르냐" 라고 반박하실 수도 있겠습니다. 하지만 Checked Exception은 언급했다시피 개발자들이 협업할 때 "이 예외는 반드시 처리해라!" 라고 명시적으로 알려주기 위한 용도로 바뀌었기 때문에 항상 100퍼센트 옳은 것은 없다 라는 말이 떠오르게 되더군요.
이렇게 @Transactional과 Checked Exception에 대한 포스팅을 마치도록 하겠습니다. 긴 글 읽어주셔서 감사합니다. 오늘도 즐거운 하루 되세요!
@Transactional, 왜 이게 롤백이돼..?
이번 포스팅에선 되게 신기한 상황을 접하게 되어서 이를 분석해보고 뜯어본 결과를 공유해보고 싶어서 글을 쓰게 되었습니다.
이번 글은 물리 트랜잭션, 논리 트랜잭션, @Transactional을 사용할 때 주의사항, 롤백전략 등의 내용이 모두 선행되기 때문에 해당 내용을 모두 담을 수 없어 알고있다는 전제하에 글을 작성하려고 합니다.
트랜잭션에 관한 자세한 내용은 아래의 링크에 자세히 설명이 되어 있습니다. 아래의 링크를 꼭 보고 오시길 바랍니다.
https://coding-review.tistory.com/425
이게 왜... 롤백?
상황은 이렇습니다.
서로 다른 클래스에 존재하는 메서드 A, B, C가 있고 A -> B -> C의 순서로 호출합니다. B에서 REQUIRES_NEW를 이용해서 새로운 트랜잭션을 시작하였고 C에서 예외가 발생했습니다.
여기서 A에서 만들어진 트랜잭션을 TA라고 하고 B에서 만들어진 트랜잭션을 TB라고 할 때, 우리는 TA는 커밋, TB는 롤백되기를 원합니다.
때문에 B에서 예외를 잡아서 처리하였죠.
이를 코드로 보겠습니다.
@Service
@RequiredArgsConstructor
@Slf4j
public class MemberServiceA {
private final MemberRepository memberRepository;
private final MemberServiceB memberServiceB;
@Transactional
public void update() {
Member member = Member.builder()
.name("MemberServiceA")
.age(20).build();
memberRepository.save(member);
memberServiceB.update();
}
}
@Service
@RequiredArgsConstructor
@Slf4j
public class MemberServiceB {
private final ExceptionInvoke exceptionInvoke;
private final MemberRepository memberRepository;
@Transactional(propagation = Propagation.REQUIRES_NEW)
public void update() {
try {
Member member = Member.builder()
.name("MemberServiceB")
.age(27)
.build();
memberRepository.save(member);
exceptionInvoke.invoke();
} catch (Exception e) {
log.error("잡았다!!!");
}
}
}
@Component
@RequiredArgsConstructor
public class ExceptionInvoke {
private final MemberRepository memberRepository;
@Transactional
public void invoke() {
memberRepository.findByName("우헤헤").orElseThrow(() -> new IllegalStateException("존재하는 사용자가 없습니다."));
}
}
이때 우리가 기대하는 것은 다음과 같습니다.
TA에서 TB가 분리되었고 C에서 예외가 발생한걸 B에서 잡았으니 A는 커밋되겠지?
우리가 TA이 커밋되는 것을 바라는건 지극히 당연해보입니다. 하지만!!
엥? rollbackOnly 때문에 롤백됐다고?
TB에서는 C에서 예외가 발생했고 이 예외 때문에 rollbackOnly가 되는게 당연해 보이지만 TA는 TB와 전혀 다른 트랜잭션으로 동작할텐데 왜 롤백이 되는걸까?
답은 TransactionAspectSupport 에 있었다.
이 문제를 해결하기위해 디버깅을 하면서 스프링 내부 동작 코드들을 보게 되었습니다. 그런데 이게 왠걸?
트랜잭션 진행 중에 예외가 발생하면 들어오는 코드인 completeTransactionAfterThrowing 메서드입니다. 여기서 디버깅을 더 자세히 해보면?
TransactionStatus에는 현재 A의 메서드명이 담겨있고 전파단계가 REQUIRED라고 적혀있습니다. 그리고 예외가 UnexpectedRollbackException 이라고 적혀있네요.
이는 이렇게 해석할 수 있습니다.
"try / catch 문으로 잡을 수 없는 내부적인 Exception이 터졌다."
이 내부적인 Exception이 TA의 rollbackOnly태그에 다시 true로 적는 결과를 초래했고 이것이 TA가 롤백된 이유입니다.
이를 해결하려면?
이를 해결하기 위해서는 A에서 예외를 잡아줘야합니다. 즉, 이런 예외까지 예상하고 잡아줘야한다는 것이죠.
@Service
@RequiredArgsConstructor
@Slf4j
public class MemberServiceA {
private final MemberRepository memberRepository;
private final MemberServiceB memberServiceB;
@Transactional
public void update() {
try {
Member member = Member.builder()
.name("MemberServiceA")
.age(20).build();
memberRepository.save(member);
memberServiceB.update();
}
catch (UnexpectedRollbackException e) {
log.error("잡았죠?");
}
}
}
마치며
이런 상황과 비슷한 상황이 한 가지 더 있습니다. 바로 데이터베이스 내부적인 Exception상황인데요. 예를 들어서 컬럼 길이보다 더 긴 데이터를 삽입하려고 하는 상황에서 발생하는 예외인 DataAccessException이 발생하여도 위와같은 결과를 초래합니다.
정말... 트랜잭션을 다루는 것은 어디로 튈지 모르는 공을 잡아야하는 것 같은 기분이 드네요. 그냥 서버 한대에서 발생하는 트랜잭션도 이렇게 다루기 힘든데 MSA로 가기 시작하면 얼마나 복잡도가 올라갈지 상상도 안됩니다.
괜히 MSA의 유지보수만으로도 시간이 다간다 라고 하는게 아닌 것 같네요.
여기까지 트랜잭션 전파단계와 롤백에 관해서 의아한 상황에 대한 글을 정리해봤습니다. 오늘도 즐거운 하루 되시고 공부 화이팅입니다!
스프링 시큐리티 동작 원리
이번에 JWT 토큰 인증 방식에 대해서 공부하고 있습니다. 제 프로젝트에 인증 부분이 세션 + Redis + Spring Security 이렇게 세가지 부분으로 돌아가는데 여기에 JWT라는 새로운 레이어가 들어가면 보안적으로 어떨지 궁금했습니다.
알아보던 중에 정말 괜찮은 블로그를 발견했습니다.
https://wildeveloperetrain.tistory.com/57
이분 블로그에 있는 코드 퀄리티가 정말 혀를 내두를정도로 좋아서 저도 나중에 보고 따라해볼 생각입니다. 블로그를 먼저 보시고 맨 마지막에 깃헙 코드를 보고 따라 하시면 될 것 같습니다.
위 포스팅의 주된 목적은 포스팅 제목에도 있지만
"스프링 시큐리티와 JWT를 혼합할 수는 없을까?"
그냥 단순히 JWT토큰 발급하고 필터 중간에 끼워넣는 수준이 아닙니다. 위 포스팅 저자는 스프링 시큐리티에대한 깊은 이해를 가지고 있는 것 같았는데요.
스프링 시큐리티에서 전역적으로 관리하는 Authentication 객체를 뽑아내서 JWT 토큰으로 만들고 Redis에 넣어버리는 보안적으로 봤을 때 실로 놀라울 정도로 안전할 것 같은 방법을 사용합니다.
그리고 Access Token 과 Refresh Token을 사용해서 사용자를 계속 로그인할 수 있게 했습니다. (물론 서버가 내려갔다가 올라가면 어떻게 될진 모릅니다.)
위와 같은 방법에 크게 감명받았습니다. 그래서 저도 스프링 시큐리티에대한 깊은 이해가 필요하다고 생각했습니다.
Spring Secutiry 동작 원리
스프링 시큐리티는 8개의 단계로 작동합니다.
• FilterChainProxy에 의해 Request를 인터셉터 : 클라이언트가 스프링 애플리케이션으로 요청을 보내면 요청은 FilterChainProxy라는 일련의 필터에 의해 인터셉터 됩니다. 이 필터들의 체인은 스프링 시큐리티가 제공하는 Security 기능들을 벌크연산하는 역할을 수행합니다.
• Security Filter 작동 : FilterChainProxy는 특정한 security task를 각각 수행하는 몇몇 필터들의 요청을 위임합니다. 이 필터들은 인증, 인가, CSRF 보호, session management와 같은 일들을 수행합니다.
• Authentication (인증) : AuthenticationFilter인 UsernamePasswordAuthenticationFilter (POST요청의 form 데이터를 거르는 필터, OAuth 2.0같은 경우는 OAuth2ClientAuthenticationProcessingFilter가 작동합니다.) 가 Authentication객체를 생성합니다. 이때의 Authentication객체는 아직 인증된 객체는 아닙니다. 그리고 이 객체를 AuthenticationManager객체 (실질적인 객체는 ProviderManager) 에 전달하고 AuthenticationProvider가 인증을 마칩니다.
• SecurityContext Updated : Authentication 객체를 인증하고 SecurityContext에 담고 이 객체는 다시 SecurityContextHolder에 담아집니다.
• Authorization (인가) : 인증이 끝난 후에 인증된 유저에게 특별한 권한을 부여합니다. 그리고 이 후 AccessDecisionVoter를 이용해 인증된 Authentication객체를 적절히 인가된 접근인지 확인합니다.
• Exception Handling : 만약 인증이나 인가에서 실패한다면 예외가 발생하게 되고 이 예외는 다양한 Exception Handler에 의해 관리됩니다.
• Request 이행 : 만약 유저가 성공적으로 인증과 인가를 마쳤다면, 애플리케이션의 컨트롤러 메서드들에 도달할 때까지 필터 체인을 통해 요청이 진행됩니다. 요청이 진행된 후 응답은 필터체인을 거꾸로 타고 올라와서 추가적인 프로세싱을 진행합니다.
• Session 관리 : 스프링 시큐리티는 전반적인 세션 관리 지원을 포함하고 있습니다. 이 지원은 session fixation을 막을 수 있고 동시에 세션을 관리할 수 있으며 세션 만료를 관리합니다.
글로만 보면 정말 복잡합니다... 저도 이 과정을 이해하는데 굉장히 애먹었는데요. 이해하기 힘드시면 선형적으로 알고계시면 됩니다.
• FilterChainProxy 작동
• Security Filter 작동
• Authentication (인증)
• SecurityContext 업데이트
• Authorization (인가)
• Exception Handling
• Request 이행
• Session 관리
인증
이제 스프링 시큐리티의 중요한 부분 중 하나인 인증에 대해서 자세히 알아보도록 하겠습니다.
인증을 도식화하면 다음과 같습니다.
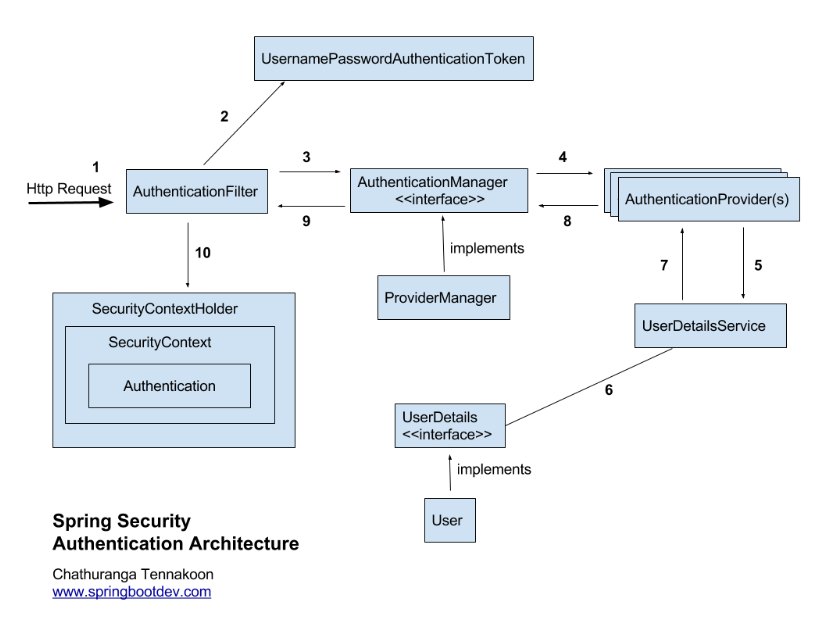
이 도식화는 이어서 설명할 내용과 계속 번갈아서 보시면 이해하기 편합니다.
순서와 함께 한번 알아보죠
1. UsernamePasswordAuthenticationFilter에서 request를 가로챈다.
UsernamePasswordAuthenticationFilter에 들어온 모습입니다. 우리가 가장 먼저 만나는 메서드는 바로 attemptAuthentication입니다.
이 메서드는 request를 중간에 가로채서 form 안에 있는 username 과 password를 가지고 UsernamePasswordAuthenticationToken을 만들고 Authentication객체인 AuthenticationManager를 호출합니다.
2. AuthenticationManager의 디폴트 구현체인 ProviderManager에게 Token을 위임
AuthenticationManager는 디폴트 구현체인 ProviderManager에서 UsernamePasswordAuthenticationToken을 처리할 수 있는 AuthenticationProvider를 Provider중에 찾습니다.
위에서 네모친 부분이 바로 Provider를 순회하면서 알맞은 AuthenticationProvider를 찾는 과정입니다.
3. AuthenticationProvider를 구현한 구현체를 Provider로 설정하고 UserDetialService를 가지고 Principal을 만든다
AuthenticationProvider를 구현한 구현체중 디폴트 값인 AbstractUserDetailsAuthenticationProvider안에 있는 코드입니다.
이 retrieveUser라는 곳이 핵심인데요. retrieveUser를 타고 들어가면 DaoAuthenticationProvider라는 구현체로 들어오게 됩니다.
이 안에서
UserDetailService를 가져오게 됩니다. 한번이라도 시큐리티를 사용해보신 분들은 다들 익숙하실 그 메서드!
바로 loadUserByUsername을 구현하는 클래스가 바로 UserDetailService을 구현한 커스텀 클래스입니다.
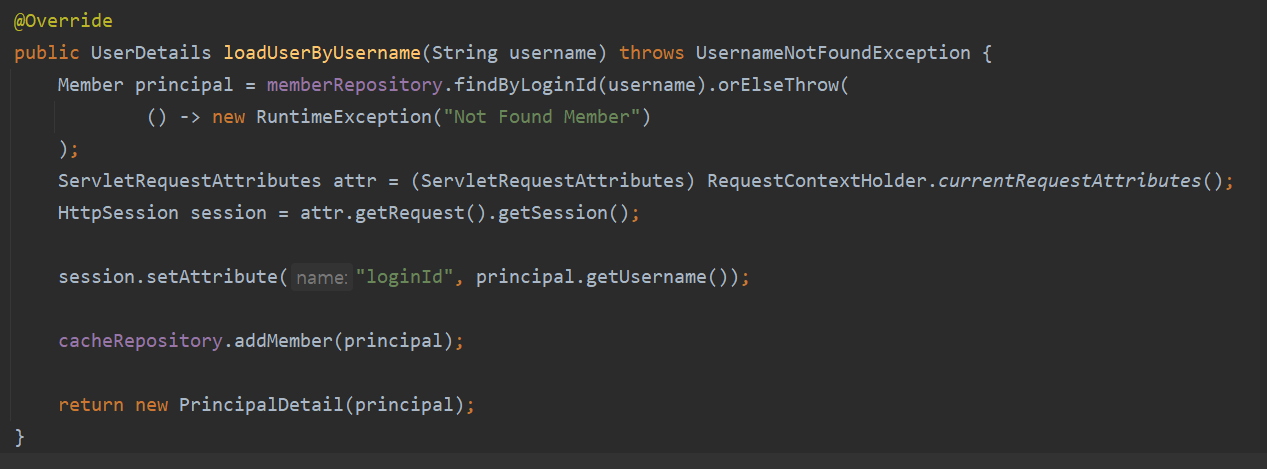
제가 현제 개발중인 프로젝트의 한 부분입니다. 이렇게 loadUserByUsername을 구현해줘야 그 안에 가지고 있는 User객체를 Principal로 만들어서 전달해줄 수 있는 것입니다.
4. 우리가 만든 Principal을 가지고 Authentication 객체를 만든다.
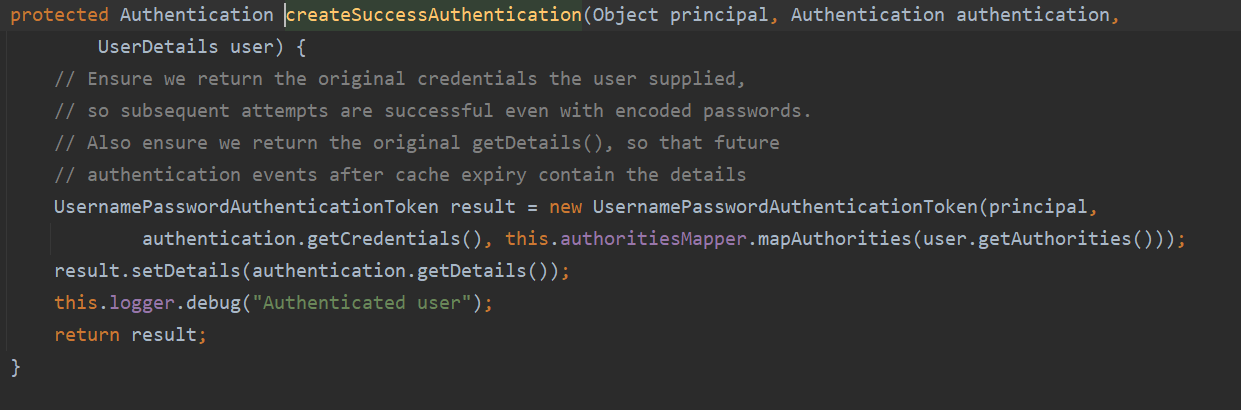
Principal을 만들었다면 이제 createSuccessAuthentication으로 들어오게 됩니다. 이곳에서 Principal과 credential, 인가값을 가지고 새로운 토큰을 만들어서 Authentication객체를 만듭니다.
그러면 SecurityContext에 담기게 됩니다.
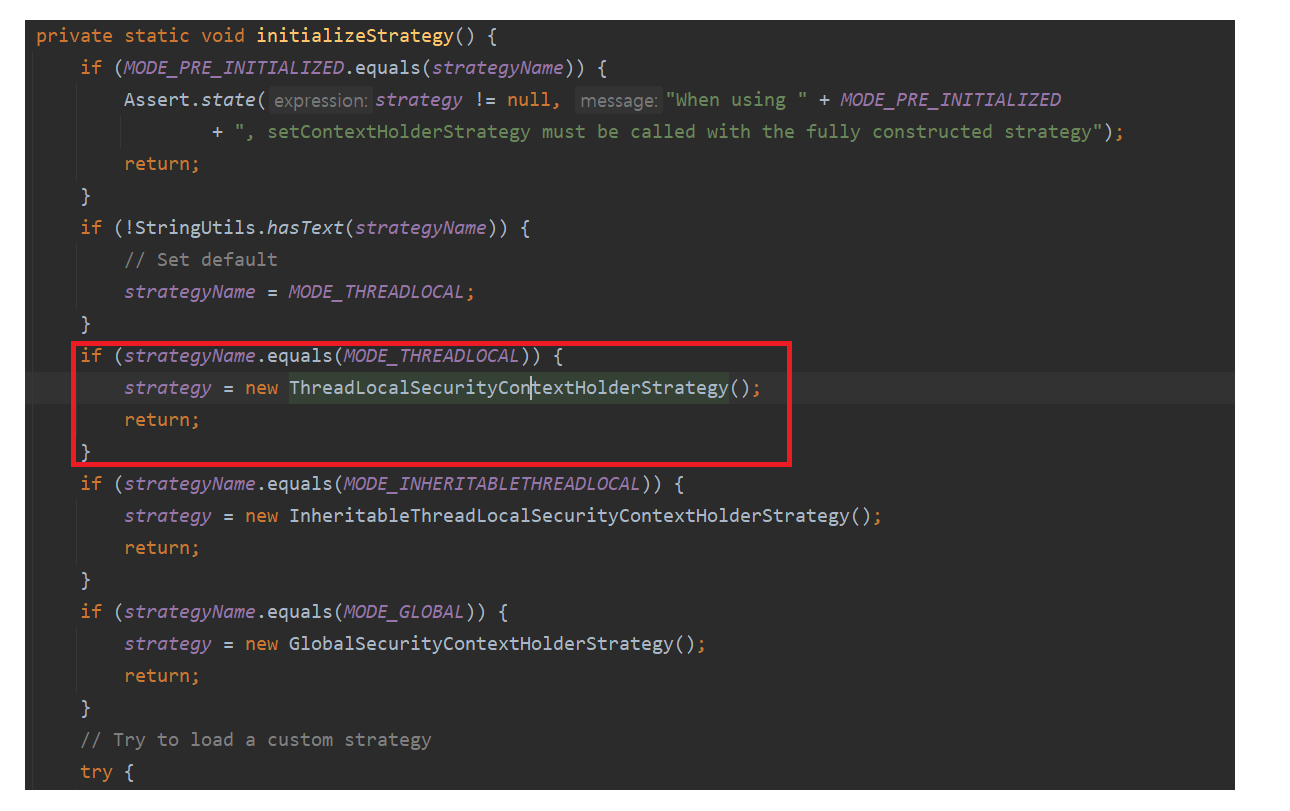
이곳은 SecurityContextHolder 내부입니다. SecurityContextHolder에는 총 세가지 설정이 있는데요.
1. MODE_THREADLOCAL
2. MODE_INHERITABLETHREADLOCAL
3. MODE_GLOBAL
이렇게 세가지입니다. 우리는 기본 설정인 MODE_THREADLOCAL로 타고들어가게 됩니다.
그리고 저 ThreadLocalSecurityContextHolderStrategy() 로 객체가 만들어지면?
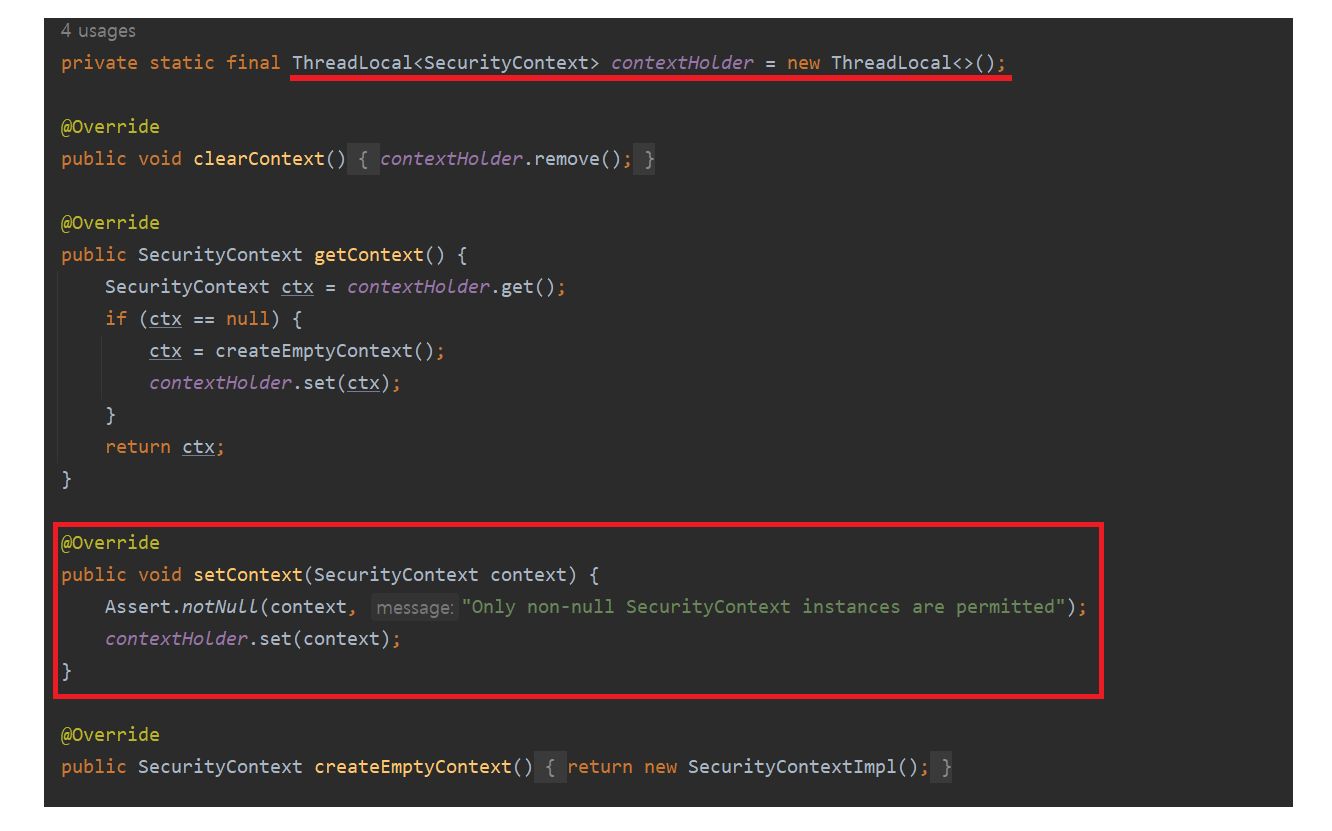
이렇게 ThreadLocal이 기다리고 있습니다. 스레드로컬에 대해서 궁금하신 분들은 아래의 링크를 확인해주세요!
https://coding-review.tistory.com/92
스레드 로컬로 Authentication객체가 관리되기 때문에 전역적으로 어디서든지 사용해도 멀티스레드에의한 동시성 문제가 발생하지 않습니다.
이는 스레드로컬이 가지고있는 특징중 하나인데요. 간단하게 설명하자면 스레드로컬은 내부적으로 Map을 사용합니다.
Map을 사용하기 때문에 Key만 같다면 같은 값을 반환받는 것을 보장하죠.
하지만 스레드로컬 저장소는 한번의 요청이 올 때 동안만 굉장히 유용합니다. 왜냐하면 각각 다른 스레드가 각기다른 요청을 멀티스레드 환경에서 처리하기 때문입니다.
즉, 이말은 서버가 한번 내려가면 혹은 사이트를 벗어나면 세션이 풀리게 된다는 말입니다.
이를 해결하기 위한 방법으로 시큐리티에서 지원하는 RememberMe도 조만간 포스팅해보도록 하겠습니다.
마치며
여기까지 스프링 시큐리티에대한 전반적인 동작과정 그리고 인증에 대한 심층적인 이해까지 다뤄봤습니다. 직접 스프링을 타고타고 들어가는 경험은 몇번을 해도 놀라울 따름입니다.
어떻게 이런걸 구현했지... 싶은 경외심이 듭니다. 스프링 시큐리티를 사용하는 분들이라면 이번 기회에 스프링 시큐리티에 대한 전반적인 이해를 추천드립니다.
긴 글 읽어주셔서 감사합니다. 오늘도 즐거운 하루 되세요~
스프링 시큐리티 + JWT 인증 레이어 추가하기 (1) : 개요
이번 포스팅에선 스프링 시큐리티에 JWT 인증 레이어를 추가하는 방법에 대해서 소개해드릴까 합니다.
제가 이 프로젝트를 개발하면서 했던 고민들, 마냥 만사형통하지 않았던 험난한 과정들, 결국 내가 이 프로젝트를 통해 얻은 것들, 앞으로의 계획등은 아래의 링크에 자세히 기술되어있으니 참고해주시면 좋겠습니다.
https://coding-review.tistory.com/381
아마 두개 내지 세개에 걸쳐 포스팅을 진행할텐데 이번 포스팅에선 개요에 대해서 작성해보도록 하겠습니다.
위의 포스팅에서 적은 고민에 대해서 조금 설명하고 넘어가겠습니다.
사실 이 프로젝트에 많은 고민이 있었습니다.
• 이미 스프링 시큐리티의 인증을 사용하고 있는데 굳이 다른 인증이 필요할까?
• stateful한 session으로 인증을 구현하는게 stateless한 JWT에 비해 구현하기가 더 쉬운데...
• JWT는 세션으로 인증을 안쓰려고 구현하는건데 스프링 시큐리티가 세션으로 인증을 진행한다고? 굳이 이 둘을 합쳐야할까?
• 혹여 구현이 복잡해서 유지보수에 큰 영향을 끼치진 않을까?
이런 크고작은 고민들이 있었습니다.
사실 이런 고민을 한다는 것 자체가 저한텐 좋은 경험이었습니다. 아마 현업에서 개발하시는 분들이 겪는 고민들과 비슷한 느낌일 것이니까요.
현업에선 많은 사람들끼리 회의를 통해 이런 기술을 도입할지 말지를 결정하겠지만 저는 회의할 사람이 없어서 챗 지피티한테 물어봤습니다.
내가 스프링 시큐리티와 JWT를 결합해서 인증을 시도하려고 하는데 이렇게 둘을 합쳤을 때 장점이 있느냐
아주 청산유수더군요. 장점을 막 쏟아내는데 이 한문장 때문에 도입하기로 결정했습니다.
"JWT는 MicroService의 준비단계다"
저는 제 프로젝트를 MicroService까지 구현할 생각입니다. 아직은 성능개선에 조금 초점을 두고 있지만 제 프로젝트의 종착지는 아마 마이크로서비스일 것입니다.
이제 거두절미하고 본격적으로 포스팅 진행해보도록 하겠습니다.
JWT로 인증
기본적으로 JWT로 인증을 구현했다고 하면 이런 구조를 떠올리실 것입니다.
JWT가 구현하기가 뭐가 어려워? 라고 하시는 분들도 있을 것 같네요.
그냥 JWT 빌더로 Access Token, Refresh Token 만들어서 쿠키에 넣어버리고 계속 검증하면 되는거 아냐?
그것도 물론 맞는 말이지요.
하지만 그냥 스프링 시큐리티의 인증을 사용하는 것보다는 까다롭다고 생각합니다. 유지보수도 생각해야하구요.
아마 그렇게 생각하신 분들도 있을텐데, JWT로 간단하게 구현하려면 얼마든지 간단하게 만들 수 있습니다.
그렇지만 그렇게 간단하게 만들면 재미가 없지않겠습니까.
제가 생각한 구조입니다.
• 사용자가 로그인을 요청한다.
• JWTAuthenticationFilter로 요청을 인터셉트한다.
• Authentication 객체를 만들어서 SecurityContext에 집어넣는다.
• Access Token, Session Token을 발급해서 쿠키에 저장한다.
• Session Token의 ID를 Redis에 저장한다.
• 기본적인 HTTP 통신은 Filter에 의해 Access Token의 여부를 확인한다.
• 이때 Access Token이 만료되면
SecurityContext에 들어있는 Authentication 객체의 isAuthenticated() 를 확인해서 true가 나왔다 = 웹 페이지를 벗어나지 않고 Access Token이 만료된 경우, 이런 경우엔 그냥 Access Token을 재발급
• Access Token이 null이고 = 쿠키가 만료되었고, Authentication 객체도 null 이다, 이런 경우엔 웹 페이지를 종료했다가 다시 들어온 사용자라는 얘기죠. 이럴땐 SESSION-TOKEN 쿠키를 확인해서 Redis에 있는 Refresh Token을 꺼내온다.
• Refresh Token을 검증한 뒤 Access Token을 재발급한다.
• 모든 경우에서 SecurityContext에 Authentication 객체를 넣어서 스프링 시큐리티에게 인증을 위임한다.
이정도는 되어야 개발하는 맛이 있지 않겠습니까.
정말 많은 삽질을 경험했구요.
구현하는데 정말 까다로웠습니다. 험난했던 과정은 맨 처음에 올린 포스팅에서 확인해주세요!
그래서 결국 JWT와 스프링 시큐리티를 이용한 인증을 구현했습니다.
다음엔 주요 클래스 설명으로 이어집니다.
https://coding-review.tistory.com/383
스프링 시큐리티 + JWT 인증 레이어 추가하기 (2) : 주요 클래스 (JwtProvider와 JwtFilter)
https://coding-review.tistory.com/382
이 포스팅은 이전 포스팅과 내용이 이어집니다.
먼저 JwtTokenProvider입니다. 이 클래스가 하는 역할은 JWT 토큰을 발급하는 과정과 Authentication 객체를 이용해 Access Token을 재발급하는 역할, Access Token으로 Authentication 객체를 반환받는 과정, 토큰을 검증하는 과정을 담고 있습니다.
package com.hello.capston.jwt;
import com.hello.capston.entity.Member;
import com.hello.capston.jwt.dto.UserResponseDto;
import io.jsonwebtoken.*;
import io.jsonwebtoken.io.Decoders;
import io.jsonwebtoken.security.Keys;
import io.jsonwebtoken.security.SecurityException;
import lombok.extern.slf4j.Slf4j;
import org.springframework.beans.factory.annotation.Value;
import org.springframework.security.authentication.UsernamePasswordAuthenticationToken;
import org.springframework.security.core.Authentication;
import org.springframework.security.core.GrantedAuthority;
import org.springframework.security.core.authority.SimpleGrantedAuthority;
import org.springframework.security.core.userdetails.User;
import org.springframework.security.core.userdetails.UserDetails;
import org.springframework.stereotype.Component;
import java.security.Key;
import java.util.Arrays;
import java.util.Collection;
import java.util.Date;
import java.util.stream.Collectors;
@Slf4j
@Component
public class JwtTokenProvider {
private static final String AUTHORITIES_KEY = "auth";
private static final String BEARER_TYPE = "Bearer";
private static final long ACCESS_TOKEN_EXPIRE_TIME = 30 * 60 * 1000L;
private static final long REFRESH_TOKEN_EXPIRE_TIME = 7 * 24 * 60 * 60 * 1000L;
private final Key key;
public JwtTokenProvider(@Value("${jwt.secret.key}") String secretKey) {
byte[] keyBytes = Decoders.BASE64.decode(secretKey);
this.key = Keys.hmacShaKeyFor(keyBytes);
}
public UserResponseDto generateToken(Authentication authentication) {
// 권한 가져오기
String authorities = authentication.getAuthorities().stream()
.map(GrantedAuthority::getAuthority)
.collect(Collectors.joining(","));
long now = (new Date()).getTime();
// Access Token 생성
Date accessTokenExpiresIn = new Date(now + ACCESS_TOKEN_EXPIRE_TIME);
String accessToken = Jwts.builder()
.setSubject(authentication.getName())
.claim(AUTHORITIES_KEY, authorities)
.setExpiration(accessTokenExpiresIn)
.signWith(key, SignatureAlgorithm.HS256)
.compact();
// Refresh Token 생성
String refreshToken = Jwts.builder()
.setExpiration(new Date(now + REFRESH_TOKEN_EXPIRE_TIME))
.signWith(key, SignatureAlgorithm.HS256)
.compact();
return UserResponseDto.builder()
.grantType(BEARER_TYPE)
.accessToken(accessToken)
.refreshToken(refreshToken)
.refreshTokenExpirationTime(REFRESH_TOKEN_EXPIRE_TIME)
.build();
}
public String remakeAccessToken(Authentication authentication) {
long now = (new Date()).getTime();
Date accessTokenExpiresIn = new Date(now + ACCESS_TOKEN_EXPIRE_TIME);
String authorities = authentication.getAuthorities().stream()
.map(GrantedAuthority::getAuthority)
.collect(Collectors.joining(","));
return Jwts.builder()
.setSubject(authentication.getName())
.claim(AUTHORITIES_KEY, authorities)
.setExpiration(accessTokenExpiresIn)
.signWith(key, SignatureAlgorithm.HS256)
.compact();
}
public Authentication getAuthentication(String accessToken) {
Claims claims = parseClaims(accessToken);
if (claims.get(AUTHORITIES_KEY) == null) {
throw new RuntimeException("권한 정보가 없는 토큰입니다.");
}
Collection<? extends GrantedAuthority> authorities =
Arrays.stream(claims.get(AUTHORITIES_KEY).toString().split(","))
.map(SimpleGrantedAuthority::new)
.collect(Collectors.toList());
UserDetails principal = new User(claims.getSubject(), "", authorities);
return new UsernamePasswordAuthenticationToken(principal, "", authorities);
}
public boolean validateToken(String token) {
try {
Jwts.parserBuilder().setSigningKey(key).build().parseClaimsJws(token);
return true;
} catch (SecurityException | MalformedJwtException e) {
log.info("Invalid JWT Token", e);
} catch (ExpiredJwtException e) {
log.info("Expired JWT Token", e);
} catch (UnsupportedJwtException e) {
log.info("Unsupported JWT Token", e);
} catch (IllegalArgumentException e) {
log.info("JWT claims string is empty", e);
}
return false;
}
private Claims parseClaims(String accessToken) {
try {
return Jwts.parserBuilder().setSigningKey(key).build().parseClaimsJws(accessToken).getBody();
} catch (ExpiredJwtException e) {
return e.getClaims();
}
}
}
제가 이 클래스를 만들고 제 프로젝트에 맞게 커스터마이징 하는 과정에서 했던 고민이 있습니다.
잘 보시면 remakeAccessToken() 메서드에 Authentication 객체를 필요로 한다는 것이었습니다.
처음엔 문제가 되지 않습니다.
하지만 어느때 문제가 생기냐하면 Access Token이 만료되고 Authentication 객체도 null 인 상황 즉, 웹 페이지를 껐다가 수일 뒤에 다시 들어온 사용자가 있을 때입니다.
아직 Refresh Token은 만료가 안됐지만 Access Token은 없고? Authentication 객체도 없다? 그럼 뭘로 Access Token을 재발급하지?
혹자는 이렇게 말할수도 있을겁니다. "아니 누가 Authentication 객체로 Access Token 만들래? 그냥 String으로 username이나 email 같은걸로 Access Token 만들면 되잖아"
물론 맞는 말이지만 일단 첫번째로 Authentication 객체로 Access Token을 만들지않으면 제 프로젝트 정체성이 흐려지고, 새로 들어온 사람의 username이나 email을 어떤 수로 아냐는 것이 문제였습니다.
쿠키도 만료되고 Authentication 객체도 없는데 세션이라고 남아있을리가 없었죠.
그래서 고안한 것이 필터를 좀 더 강화하는 것이었습니다.
package com.hello.capston.jwt;
import com.hello.capston.entity.Member;
import com.hello.capston.entity.User;
import com.hello.capston.jwt.dto.UserResponseDto;
import com.hello.capston.jwt.gitbefore.RedisAndSession;
import com.hello.capston.jwt.gitbefore.RedisTokenRepository;
import com.hello.capston.repository.MemberRepository;
import com.hello.capston.repository.UserRepository;
import lombok.RequiredArgsConstructor;
import lombok.extern.slf4j.Slf4j;
import org.springframework.data.redis.core.RedisTemplate;
import org.springframework.http.ResponseCookie;
import org.springframework.security.authentication.UsernamePasswordAuthenticationToken;
import org.springframework.security.core.Authentication;
import org.springframework.security.core.GrantedAuthority;
import org.springframework.security.core.authority.SimpleGrantedAuthority;
import org.springframework.security.core.context.SecurityContextHolder;
import org.springframework.security.core.userdetails.UserDetails;
import org.springframework.util.ObjectUtils;
import org.springframework.util.StringUtils;
import org.springframework.web.filter.GenericFilterBean;
import javax.servlet.FilterChain;
import javax.servlet.ServletException;
import javax.servlet.ServletRequest;
import javax.servlet.ServletResponse;
import javax.servlet.http.Cookie;
import javax.servlet.http.HttpServletRequest;
import javax.servlet.http.HttpServletResponse;
import javax.servlet.http.HttpSession;
import java.io.IOException;
import java.time.Duration;
import java.util.Arrays;
import java.util.Collection;
import java.util.stream.Collectors;
@Slf4j
@RequiredArgsConstructor
public class JwtAuthenticationFilter extends GenericFilterBean {
private static final String AUTHORIZATION_HEADER = "Authorization";
private static final String BEARER_TYPE = "Bearer";
private final JwtTokenProvider jwtTokenProvider;
private final RedisTemplate redisTemplate;
private final RedisTokenRepository redisTokenRepository;
private final MemberRepository memberRepository;
private final UserRepository userRepository;
@Override
public void doFilter(ServletRequest request, ServletResponse response, FilterChain chain) throws IOException, ServletException {
// 1. Request Header 에서 JWT 토큰 추출
String token = resolveToken((HttpServletRequest) request);
Authentication authentication = SecurityContextHolder.getContext().getAuthentication();
// 2. validateToken 으로 토큰 유효성 검사
if (token != null && isValidJwtFormat(token) && jwtTokenProvider.validateToken(token)) {
// Redis 에 해당 accessToken logout 여부 확인
String isLogout = (String) redisTemplate.opsForValue().get(token);
if (ObjectUtils.isEmpty(isLogout)) {
// 토큰이 유효할 경우 토큰에서 Authentication 객체를 가지고 와서 SecurityContext 에 저장
Authentication getAuthentication = jwtTokenProvider.getAuthentication(token);
SecurityContextHolder.getContext().setAuthentication(getAuthentication);
}
}
else if (authentication != null && authentication.isAuthenticated()) { // 3. access token 이 만료된 상황
// token 은 만료 되었으나 인증이 되어있는 사용자 = 아직 페이지를 안벗어났지만 token 의 유효시간은 끝난 사용자
UserResponseDto tokenInfo = (UserResponseDto) redisTemplate.opsForValue().get("RT:" + authentication.getName());
if (tokenInfo != null) {
setNewAuthentication((HttpServletResponse) response, authentication);
SecurityContextHolder.getContext().setAuthentication(authentication);
}
}
else { // 4. access token 만료되고 Authentication 객체도 null 인 상황
String sessionId = getSessionId((HttpServletRequest) request);
Authentication authenticationFromSessionId = null;
RedisAndSession redisAndSession = null;
if (sessionId != null) {
redisAndSession = redisTokenRepository.findBySessionId(sessionId).orElse(null);
}
if (redisAndSession != null) { // refresh token 이 존재하는 경우 존재하지 않으면 로그인이 풀린다.
Member findMember = memberRepository.findBySessionId(sessionId).orElse(null);
User findUser = userRepository.findBySessionId(sessionId).orElse(null);
if (findMember == null && findUser != null) { // User 객체만 존재할 경우
Collection<? extends GrantedAuthority> authorities =
Arrays.stream(findUser.getRole().toString().split(","))
.map(SimpleGrantedAuthority::new)
.collect(Collectors.toList());
UserDetails principal = new org.springframework.security.core.userdetails.User(findUser.getEmail(), "", authorities);
authenticationFromSessionId = new UsernamePasswordAuthenticationToken(principal, "", authorities);
setNewAuthentication((HttpServletResponse) response, authenticationFromSessionId);
SecurityContextHolder.getContext().setAuthentication(authenticationFromSessionId);
}
else if (findUser == null && findMember != null) { // Member 객체만 존재할 경우
Collection<? extends GrantedAuthority> authorities =
Arrays.stream(findMember.getRole().toString().split(","))
.map(SimpleGrantedAuthority::new)
.collect(Collectors.toList());
UserDetails principal = new org.springframework.security.core.userdetails.User(findMember.getUsername(), "", authorities);
authenticationFromSessionId = new UsernamePasswordAuthenticationToken(principal, "", authorities);
setNewAuthentication((HttpServletResponse) response, authenticationFromSessionId);
SecurityContextHolder.getContext().setAuthentication(authenticationFromSessionId);
}
else if (findMember != null && findUser != null) { // 둘 다 존재하는 경우 우선순위는 Member
Collection<? extends GrantedAuthority> authorities =
Arrays.stream(findMember.getRole().toString().split(","))
.map(SimpleGrantedAuthority::new)
.collect(Collectors.toList());
UserDetails principal = new org.springframework.security.core.userdetails.User(findMember.getUsername(), "", authorities);
authenticationFromSessionId = new UsernamePasswordAuthenticationToken(principal, "", authorities);
setNewAuthentication((HttpServletResponse) response, authenticationFromSessionId);
SecurityContextHolder.getContext().setAuthentication(authenticationFromSessionId);
}
else { // 둘 다 null 인 경우 에는 로그인이 풀린다.
chain.doFilter(request, response);
}
}
}
chain.doFilter(request, response);
}
private void setNewAuthentication(HttpServletResponse response, Authentication authentication) {
String remakeAccessToken = jwtTokenProvider.remakeAccessToken(authentication);
Cookie cookie = new Cookie("AUTH-TOKEN", remakeAccessToken);
ResponseCookie responseCookie =
ResponseCookie.from("AUTH-TOKEN", remakeAccessToken)
.httpOnly(true)
.path("/")
.maxAge(Duration.ofMinutes(30))
.sameSite("Lax")
.build();
response.addCookie(cookie);
response.addHeader("Set-cookie", responseCookie.toString());
}
private String getSessionId(HttpServletRequest request) {
Cookie[] cookies = request.getCookies();
if (cookies != null) {
for (Cookie cookie : cookies) {
String cookieName = cookie.getName();
if (cookieName.equals("SESSION-TOKEN")) {
return cookie.getValue();
}
}
}
return null;
}
private String resolveToken(HttpServletRequest request) {
Cookie[] cookies = request.getCookies();
if (cookies != null) {
for (Cookie cookie : cookies) {
String cookieName = cookie.getName();
if (cookieName.equals("AUTH-TOKEN")) {
return cookie.getValue();
}
}
}
return null;
}
private boolean isValidJwtFormat(String token) {
String[] split = token.split("\\.");
return split.length == 3;
}
}
코드가 너무 길고 if else if else 너무 많습니다.
빠르게 정리해드리면
제 필터는 크게 세가지 상황을 상정합니다.
• Access Token이 만료되지 않은 상황 => Access Token으로 Authentication 객체를 만들어서 SecurityContext에 넣습니다.
• Access Token은 만료되었지만 Authentication 객체는 살아있는 상황 => 그냥 한 페이지에 오래 머물러서 Access Token은 만료되었지만 인증은 풀리지 않은 상태입니다. 이 상황에는 Authentication 객체의 이름을 키로하는 Redis 객체를 가져와서 Refresh Token을 검증하고 Authentication 객체는 냅두고 Access Token만 재발급합니다.
• Access Token도 만료되었고 Authentication 객체도 null인 상황 => 이 상황은 오랜시간 접속하지않다가 접속한 아무것도 없는 사람이지만 Refresh Token은 살아있는 상황입니다. 이때의 행동강령은 다음과 같습니다.
쿠키에 Refresh Token과 같은 생명주기를 가지는 SESSION-TOKEN이 있습니다. 이 쿠키의 값으로 Redis에 객체를 찾습니다.
• Refresh Token 이 존재한다 = Refresh Token이 만료되지 않았다. Member (일반 로그인), User (소셜 로그인) 객체에 있는 sessionId 컬럼에서 우리가 가지고 있는 SESSION-TOKEN의 값으로 RDBMS 인 MySQL에 조회를 해봅니다. 이 때 네가지 상황이 존재합니다.
User만 존재할 경우 => User 객체로 Authenticaion 객체를 만들어서 Access Token을 만들고 쿠키에 다시 담은 뒤 SecurityContext에 우리가 만든 Authenticaion 객체를 집어넣습니다.
• Member만 존재할 경우 => Member 객체로 Authentication 객체를 만들고 이후는 위와 같습니다.
• User, Member 둘다 존재할 경우 => 이때는 Member로 우선순위를 정하고 위와 같습니다.
• 둘 다 존재하지 않을 경우 => 이때는 바로 다음 필터 체인으로 넘깁니다.
• Refresh Token이 존재하지 않으면 다음 필터 체인으로 넘어갑니다.
정말 복잡하지만... 제가 가장 고민이 많았던 쿠키도 만료되고 Authentication 객체도 없는 상황을 커버할 수 있었습니다.
너무 길어져서 다음으로 이어집니다.
https://coding-review.tistory.com/384
스프링 시큐리티 + JWT 인증 레이어 추가하기 (3) : 주요클래스 (JwtService와 Controller)
https://coding-review.tistory.com/383
이전 포스팅과 이어집니다.
다음은 JwtService입니다. 이 곳에서 본격적으로 로그인이 일어날 때 로직을 구현했습니다.
package com.hello.capston.jwt.service;
import com.hello.capston.jwt.JwtTokenProvider;
import com.hello.capston.jwt.dto.Response;
import com.hello.capston.jwt.dto.UserRequestDto;
import com.hello.capston.jwt.dto.UserResponseDto;
import com.hello.capston.repository.MemberRepository;
import lombok.RequiredArgsConstructor;
import lombok.extern.slf4j.Slf4j;
import org.springframework.data.redis.core.RedisTemplate;
import org.springframework.http.HttpStatus;
import org.springframework.http.ResponseEntity;
import org.springframework.security.authentication.AuthenticationManager;
import org.springframework.security.authentication.UsernamePasswordAuthenticationToken;
import org.springframework.security.core.Authentication;
import org.springframework.security.core.context.SecurityContextHolder;
import org.springframework.security.crypto.bcrypt.BCryptPasswordEncoder;
import org.springframework.stereotype.Service;
import org.springframework.util.ObjectUtils;
import java.util.concurrent.TimeUnit;
@Slf4j
@RequiredArgsConstructor
@Service
public class JwtService {
private final MemberRepository memberRepository;
private final Response response;
private final JwtTokenProvider jwtTokenProvider;
private final AuthenticationManager authenticationManager;
private final RedisTemplate redisTemplate;
public UserResponseDto login(UserRequestDto.Login login) {
memberRepository.findByLoginId(login.getUsername()).orElseThrow(
() -> new RuntimeException("Not Found Member")
);
// 1. Login ID/PW 를 기반으로 Authentication 객체 생성
// 이 때 authentication 은 인증 여부를 확인하는 isAuthenticated 값이 false
UsernamePasswordAuthenticationToken authenticationToken = login.toAuthentication();
// 2. 실제 검증이 이루어지는 부분
// authenticate 메서드가 실행될 때 PrincipalDetailService 에서 만든 loadUserByUsername 메서드가 실행
Authentication authentication = authenticationManager.authenticate(authenticationToken);
// 3. 인증 정보를 기반으로 JWT 토큰 생성
UserResponseDto tokenInfo = jwtTokenProvider.generateToken(authentication);
// 4. RefreshToken Redis 저장
redisTemplate.opsForValue().set("RT:" + authentication.getName(), tokenInfo, tokenInfo.getRefreshTokenExpirationTime(), TimeUnit.MILLISECONDS);
// Customize 5. Spring Security Context Holder 에 Authentication 객체 삽입
SecurityContextHolder.getContext().setAuthentication(authentication);
return tokenInfo;
}
}
여기서 눈여겨 보셔야할 점은 스프링 시큐리티의 인증을 위해서라면 반드시 만들어야할 메서드인 loadUserByUsername을 이용해 Authenticaion 객체를 가져오는 부분인데요.
스프링 시큐리티의 전반적인 동작 원리를 알고 계신다면 아시겠지만
• Filter로 ID / PW를 인터셉트
• UsernamePasswordAuthenticaionToken 생성
• Token을 처리할 AuthenticationManager (실질적인 구현체는 ProviderManager) 로 authenticate() 메서드를 통해 Authentication 객체 생성
• AuthenticationProvider가 Authentication 객체를 검증할 Provider를 선택
• SecurityContextHolder에 SecurityContext 안에 Authentication 객체를 저장하여 인증을 완료
이 3번에 해당하는 AuthenticaionManager인데 무작정 AuthenticationManager로 authenticate() 메서드를 부르면 "빈이 만들어지지 않았습니다." 라는 에러메시지를 받습니다.
이는 스프링 컨테이너가 AuthenticationManager를 주입하기에 아직 빈이 만들어지지 않은 것입니다.
때문에 AuthenticationManager를 빈으로 등록해줘야 합니다.
@Bean
@Override
public AuthenticationManager authenticationManagerBean() throws Exception {
return super.authenticationManagerBean();
}
Configuration 클래스에 이렇게 빈으로 등록해주시면 됩니다. 참고로 스프링 5.0에선 다음과 같이 작성하시면 됩니다.
@Bean
public AuthenticationManager authenticationManager() throws Exception {
return authenticationManager();
}
이렇게 JwtService까지 만들었다면 다음은 컨트롤러에서 써먹어야겠죠?
@PostMapping("/custom/login")
public ResponseEntity<?> login_post(@Validated @RequestBody LoginForm form, BindingResult bindingResult, HttpServletResponse response,
HttpServletRequest request) {
UserRequestDto.Login login = new UserRequestDto.Login();
login.setUsername(form.getLoginId());
login.setPassword(form.getLoginPw());
if (bindingResult.hasErrors()) {
return ResponseEntity.status(HttpStatus.BAD_REQUEST).body("아이디와 비밀번호는 빈칸일 수 없습니다.");
}
UserResponseDto tokenInfo = jwtService.login(login);
Cookie authCookie = new Cookie("AUTH-TOKEN", tokenInfo.getAccessToken());
authCookie.setHttpOnly(true);
response.addCookie(authCookie);
ResponseCookie cookie =
ResponseCookie.from("AUTH-TOKEN", tokenInfo.getAccessToken())
.sameSite("Lax")
.httpOnly(true)
.secure(false)
.path("/")
.maxAge(Duration.ofMinutes(30))
.build();
response.addHeader("Set-Cookie", cookie.toString());
// NEW!
String sessionId = request.getSession(true).getId();
Cookie sessionCookie = new Cookie("SESSION-TOKEN", sessionId);
sessionCookie.setHttpOnly(true);
response.addCookie(sessionCookie);
ResponseCookie responseSessionCookie =
ResponseCookie.from("SESSION-TOKEN", sessionId)
.sameSite("Lax")
.httpOnly(true)
.secure(false)
.path("/")
.maxAge(Duration.ofDays(7))
.build();
response.addHeader("Set-Cookie", responseSessionCookie.toString());
RedisAndSession redisAndSession = RedisAndSession.builder().sessionId(sessionId).refreshToken(tokenInfo.getRefreshToken()).build();
redisTokenRepository.save(redisAndSession);
Member member = memberRepository.findByLoginId(form.getLoginId()).map(entity -> entity.update(sessionId)).orElse(null);
memberRepository.save(member);
//NEW!
return "main";
}
ResposneCookie 객체에 대해서 설명을 잠깐 해야겠군요.
Cookie는 탈취당하기 매우 쉽기 때문에 반드시 HttpOnly 플래그를 true로 만들어주셔야 합니다. 하지만 무작정 쿠키만 세팅하고 끝나면 쿠키가 안보이는 상황이 생깁니다.
이는 Same-Site 속성이 Secure이기 때문일 수 있습니다. 또한 쿠키가 만들어진 경로가(path) 루트 주소가 아닌 다른 곳에서 만들어지면 쿠키가 안보입니다.
때문에 ResponseCookie 속성을 이용해 쿠키를 세팅해주고 response.setHeader()를 이용해 헤더를 적어주셔야 쿠키가 잘 작동하는 모습을 볼 수 있습니다.
너무 길어져서 다음에 이어서 진행하도록 하겠습니다.
https://coding-review.tistory.com/385
스프링 시큐리티 + JWT 인증 레이어 추가하기 (4) : 주요 클래스 (SecurityConfig와 OAuth2 Handler)
https://coding-review.tistory.com/384
이전 포스팅과 이어집니다.
package com.hello.capston.oauth;
import com.hello.capston.jwt.JwtAuthenticationFilter;
import com.hello.capston.jwt.JwtTokenProvider;
import com.hello.capston.jwt.OAuth2LoginSuccessHandler;
import com.hello.capston.jwt.gitbefore.RedisTokenRepository;
import com.hello.capston.jwt.service.JwtService;
import com.hello.capston.jwtDeprecated.JwtUtil;
import com.hello.capston.principal.PrincipalDetailService;
import com.hello.capston.repository.MemberRepository;
import com.hello.capston.repository.UserRepository;
import lombok.RequiredArgsConstructor;
import org.springframework.context.annotation.Bean;
import org.springframework.data.redis.core.RedisTemplate;
import org.springframework.security.authentication.AuthenticationManager;
import org.springframework.security.config.annotation.authentication.builders.AuthenticationManagerBuilder;
import org.springframework.security.config.annotation.web.builders.HttpSecurity;
import org.springframework.security.config.annotation.web.configuration.EnableWebSecurity;
import org.springframework.security.config.annotation.web.configuration.WebSecurityConfigurerAdapter;
import org.springframework.security.config.http.SessionCreationPolicy;
import org.springframework.security.crypto.bcrypt.BCryptPasswordEncoder;
import org.springframework.security.web.authentication.UsernamePasswordAuthenticationFilter;
@RequiredArgsConstructor
@EnableWebSecurity
public class SecurityConfig extends WebSecurityConfigurerAdapter {
private final CustomOAuth2UserService customOAuth2UserService;
private final PrincipalDetailService principalDetailService;
private final JwtTokenProvider jwtTokenProvider;
private final RedisTemplate redisTemplate;
private final MemberRepository memberRepository;
private final UserRepository userRepository;
private final RedisTokenRepository redisTokenRepository;
@Bean
public BCryptPasswordEncoder encodePWD() {
return new BCryptPasswordEncoder();
}
@Override
protected void configure(AuthenticationManagerBuilder auth) throws Exception {
auth.userDetailsService(principalDetailService).passwordEncoder(encodePWD());
}
@Override
protected void configure(HttpSecurity http) throws Exception {
http.csrf().disable().headers().frameOptions().disable()
.and()
.sessionManagement().sessionCreationPolicy(SessionCreationPolicy.IF_REQUIRED)
.and()
.authorizeRequests().antMatchers(
"/", "/css/**", "/image/**", "/js/**", "/h2-console/**", "/login", "/item_list/**",
"/item_detail/**", "/social_login", "/join", "/login_id_duplicate", "/sendEmail", "/checkNumber",
"/find_by_detail_category/**", "/item_list_popular/**", "/inquiry/**", "/custom/login", "/custom/logout",
"/oauth2/authorization/google", "/oauth2/authorization/naver", "/oauth2/authorization/kakao", "/erase/authToken/authentication"
).permitAll()
.antMatchers("/item_upload", "/detail_upload/**").hasAnyRole("MANAGER", "ADMIN")
.antMatchers("/admin/**", "/coupon_upload").hasRole("ADMIN")
.anyRequest().authenticated()
.and()
.addFilterBefore(new JwtAuthenticationFilter(jwtTokenProvider, redisTemplate, redisTokenRepository, memberRepository, userRepository), UsernamePasswordAuthenticationFilter.class)
.oauth2Login().loginPage("/login")
.and()
.logout().logoutSuccessUrl("/")
.and()
.oauth2Login().userInfoEndpoint().userService(customOAuth2UserService)
.and()
.successHandler(new OAuth2LoginSuccessHandler(jwtTokenProvider, redisTemplate, redisTokenRepository, userRepository));
//중복 로그인
http.sessionManagement()
.maximumSessions(1) //세션 최대 허용 수
.maxSessionsPreventsLogin(false); // false 이면 중복 로그인하면 이전 로그인이 풀린다.
}
@Bean
@Override
public AuthenticationManager authenticationManagerBean() throws Exception {
return super.authenticationManagerBean();
}
}
좀 복잡하긴 한데... 스프링 시큐리티의 기본적인 메서드는 넘어가도록 하겠습니다.
구조는 이렇습니다.
• 인증이 필요없는 URL 설정
• ROLE_MANAGER와 ROLE_ADMIN만 입장할 수 있는 URL
• ROLE_ADMIN만 입장할 수 있는 URL
• UsernamePasswordAuthenticationFilter앞에 우리가 만든 JwtAuthenticationFilter 끼워넣기
• OAuth는 자체적으로 커스텀하게 만든 CustomOAuth2UserService 장착
• OAuth로그인이 끝나면 SuccessHandler를 실행
4번 같은 경우는 꼭 UsernamePasswordAuthenticationFilter 앞에 우리가 커스텀하게 만든 JwtFilter가 있어야합니다.
왜냐하면 스프링 시큐리티같은 경우는 여러개의 필터 중 하나라도 작동해서 인증에 성공하면 다음 필터는 작동되지 않기 때문입니다.
우리는 로그인과 인증에 JWT를 사용하기 때문에 JWT 필터를 맨 앞에 둬야합니다.
또한 6번같은 경우는 OAuth는 기본적으로 폼 기반의 로그인 (Username과 Password를 넘기는)과는 다른 필터를 사용합니다.
그리고 인증하는 과정도 폼 기반 로그인과 많이 다릅니다. 때문에 일반적인 폼 형태의 로그인은 컨트롤러를 통해 쿠키와 Redis 객체를 생성해주면 됐지만 OAuth는 컨트롤러를 타지 않고 인증을 거칩니다.
때문에 OAuth가 모두 끝났을 때 쿠키와 Redis 객체를 생성해주고 저장해야합니다.
이런 우리에게 아주 꿀맛같은 인터페이스가 있습니다. 이걸 찾아내는데 굉장히 많은 삽질을 했는데...
바로 AuthenticationSuccessHandler입니다. (스프링 짱짱... 내가 원하는 인터페이스 웬만한건 다있어 대박)
package com.hello.capston.jwt;
import com.hello.capston.entity.User;
import com.hello.capston.jwt.dto.UserResponseDto;
import com.hello.capston.jwt.gitbefore.RedisAndSession;
import com.hello.capston.jwt.gitbefore.RedisTokenRepository;
import com.hello.capston.repository.UserRepository;
import lombok.RequiredArgsConstructor;
import lombok.extern.slf4j.Slf4j;
import org.springframework.data.redis.core.RedisTemplate;
import org.springframework.http.ResponseCookie;
import org.springframework.security.core.Authentication;
import org.springframework.security.core.context.SecurityContextHolder;
import org.springframework.security.web.authentication.AuthenticationSuccessHandler;
import javax.servlet.ServletException;
import javax.servlet.http.Cookie;
import javax.servlet.http.HttpServletRequest;
import javax.servlet.http.HttpServletResponse;
import java.io.IOException;
import java.time.Duration;
import java.util.concurrent.TimeUnit;
@Slf4j
@RequiredArgsConstructor
public class OAuth2LoginSuccessHandler implements AuthenticationSuccessHandler {
private final JwtTokenProvider jwtTokenProvider;
private final RedisTemplate redisTemplate;
private final RedisTokenRepository redisTokenRepository;
private final UserRepository userRepository;
@Override
public void onAuthenticationSuccess(HttpServletRequest request, HttpServletResponse response, Authentication authentication) throws IOException, ServletException {
UserResponseDto tokenInfo = jwtTokenProvider.generateToken(authentication);
// NEW!
String sessionId = request.getSession(true).getId();
RedisAndSession redisAndSession = RedisAndSession.builder().sessionId(sessionId).refreshToken(tokenInfo.getRefreshToken()).build();
redisTokenRepository.save(redisAndSession);
Cookie sessionCookie = new Cookie("SESSION-TOKEN", sessionId);
sessionCookie.setHttpOnly(true);
ResponseCookie responseSessionCookie = ResponseCookie
.from("SESSION-TOKEN", sessionId)
.maxAge(Duration.ofDays(7))
.httpOnly(true)
.path("/")
.sameSite("Lax")
.build();
response.setHeader("Set-Cookie", responseSessionCookie.toString());
response.addCookie(sessionCookie);
User principal = (User) authentication.getPrincipal();
User user = userRepository.findByEmail(principal.getEmail()).map(entity -> entity.updateSessionId(sessionId)).orElse(principal);
userRepository.save(user);
// NEW!
redisTemplate.opsForValue()
.set("RT:" + authentication.getName(), tokenInfo, tokenInfo.getRefreshTokenExpirationTime(), TimeUnit.MILLISECONDS);
SecurityContextHolder.getContext().setAuthentication(authentication);
Cookie cookie = new Cookie("AUTH-TOKEN", tokenInfo.getAccessToken());
cookie.setHttpOnly(true);
ResponseCookie responseCookie =
ResponseCookie.from("AUTH-TOKEN", tokenInfo.getAccessToken())
.sameSite("Lax")
.httpOnly(true)
.maxAge(Duration.ofMinutes(30))
.path("/")
.build();
response.addCookie(cookie);
response.setHeader("Set-Cookie", responseCookie.toString());
response.sendRedirect("/");
}
}
뭐가 많이 긴데 그냥 Access Token 쿠키와 Session Id 쿠키, 그리고 Redis 객체를 생성해주는 코드입니다. 그냥 Controller에서 하던 것을 핸들러에서 처리한다 이렇게 생각하시면 됩니다.
마치며
정말 우여곡절이 많았습니다. 우선 제가 참고한 코드를 제 프로젝트에 걸맞게 커스터마이징 하는 과정에서 많은 삽질이 있었습니다.
아마 이 기능을 만드실 때 기본적인 JWT만들고 쿠키로 간단하게 만드실 분은 상관없겠지만 스프링 시큐리티에 대한 전반적인 이해를 하고 만드시는 것을 추천드립니다.
생각보다 스프링 시큐리티와 JWT를 결합하는 것이 만만치않더군요. 폼 기반 로그인은 어떤 필터를 타고 어떤 과정을 거쳐서 인증이 되는지, OAuth는 어떤 필터를 거치고 어떤 과정으로 인증이 되는지 이에 대한 학습이 조금 부족하다면 만드시는데 큰 어려움이 있을 것이라고 예상합니다.
아래 제가 참고한 깃헙 링크와 블로그 포스팅 링크를 달아두도록 하겠습니다.
출처
https://wildeveloperetrain.tistory.com/57
=> 이 블로그를 참고했습니다.
https://wildeveloperetrain.tistory.com/50
=> 이 블로그에서 스프링 시큐리티에 대한 전반적인 이해를 권장합니다.
깃허브
https://github.com/JianChoi-Kor/Login
=> 이분 깃헙을 기반으로 만들었습니다. 제 깃헙 보다는 이분것을 기반으로 만드는 것을 추천드립니다. 제건 너무 클래스도 많고 난잡해서...
https://github.com/garlicpollpoll/capston
=> 혹시 몰라서 제 깃헙 주소도 적어두도록 하겠습니다. 패키지는 capston > jwt 에 모아놨습니다. 포스팅에 있던 컨트롤러는 capston > controller > login > LoginController.java 입니다. 또한 SecurityConfig는 capston > oauth > SecurityConfig 여기에 있습니다.
SSO (부제 : Spring Security CAS)
서로 물리적으로 분리된 서버끼리 사용자의 로그인 상태를 유지하고 싶으면 어떻게 해야할까요?
저는 이 문제 상황에서 제일 먼저 떠오른 것이 상태저장 데이터베이스를 중간에 두는 것이었습니다.
사용자가 A서버에 로그인하면 쿠키에 간단한 값을 저장합니다. 예를 들어서 회원의 인덱스를 저장한다고 해보죠 그 값을 1이라고 가정하겠습니다.
그리고 동시에 Redis와 같은 캐시, 세션 저장소에 1이라는 값을 씁니다.
만약 B서버에 사용자가 접근하면 쿠키 값을 읽고 회원 인덱스가 존재하니 Redis에 해당 값을 조회해봅니다. 그리고 존재하기 때문에 MySQL과 같은 RDBMS에서 회원을 조회하고 그 값을 토대로 Spring Security에서 제공해주는 SecurityContextHolder에 Authentication 객체를 집어넣어서 인증을 완료하면 됩니다.
어? 꽤 간단해보입니다?
근데 서버가 두개가 아니고 여러개면 어떻게 해야될까요? 마이크로 서비스 아키텍처처럼 같은 서비스지만 모든 도메인마다 서버가 나누어져 있으면요?
그럴때마다 세션 데이터베이스에 조회해서 RDB에 조회를 요청하기엔 데이터베이스에 부하가 우려됩니다.
그럼 이를 위해서 데이터베이스 레플리케이션같은 솔루션을 사용해야할까요? 그것도 좀 아닌거같고...
어떡하죠?
SSO (Single Sign On)
SSO는 인증 서버를 이용해 인증을 구현하는 것입니다.
순서는 이렇게 됩니다.
해당 순서는 로그인을 하지 않은 최초의 상황입니다.
• 사용자가 인증이 필요한 A서버의 서비스에 요청한다
• 웹서버가 A서버로 사용자의 트래픽을 유도한다
• A서버에서 인증되지 않은 사용자로 판단하여 Exception을 터트린다.
• 해당 Exception을 핸들링하는 Filter에 의해 인증서버로 Redirect된다.
• 인증 서버에서 로그인을 수행하고 로그인때 입력한 값을 A서버로 티켓형태로 Redirect해준다
• A서버에서 데이터베이스를 뒤지면서 티켓을 검증한다.
• 검증된 티켓을 다시 인증서버에 전송한다. 동시에 A서버에서 인증절차를 통해 인증을 마무리한다.
• 해당 티켓을 인증서버에서 저장하고 있는다.
그리고 인증이 필요한 B서버의 서비스로 사용자의 요청이 들어오면 다음과 같은 순서를 가집니다.
• 사용자가 인증이 필요한 B서버의 서비스에 요청한다.
• 웹서버가 B서버로 사용자의 트래픽을 유도한다.
• B서버에서 인증되지 않은 사용자로 판단하여 Exception을 터트린다.
• 해당 Exception을 핸들링하는 Filter에 의해 인증서버로 Redirect된다.
• 인증 서버에서 사용자와 일치하는 티켓을 찾아본다.
• 티켓이 존재하므로 B서버로 인증완료 티켓과 함께 다시 Redirect한다.
• B서버에서 인증완료 티켓을 기반으로 인증을 마무리한다.
이런 절차를 거치게 됩니다.
그런데 인증서버를 직접 구현하기엔 조금 무리가 있어보이긴 합니다. 좀 복잡해보이지 않나요?
하지만 개발자는 항상 비슷한 문제상황을 겪고 있었고 하는 생각은 다 거기서 거기입니다. Spring에선 이런 SSO를 구현하기 위해 CAS라는 오픈소스를 제공하고 있습니다.
다음 시간엔 CAS를 어떻게 배포할 것인지 실습하면서 알아보도록 하죠.
CAS 인증서버 구축하기 (1) : CAS 서버 가져오기
CAS의 Overview를 보고 오시는 것을 추천드립니다!
https://coding-review.tistory.com/475
포스팅에 들어가기 앞서 Docker와 Docker-Compose에 대한 내용은 포스팅과 어울리지않아 빼도록 하겠습니다. Docker와 관련된 내용은 아래의 링크를 확인해주세요! 또한 AWS에 대한 내용도 생략하도록 하겠습니다.
https://coding-review.tistory.com/category/%EB%B0%B0%ED%8F%AC/docker
https://coding-review.tistory.com/category/%EB%B0%B0%ED%8F%AC/docker
먼저 CAS overlay template의 Git을 풀링해야합니다. 현재 CAS는 7.0버전까지 릴리즈되었지만 저는 조금 더 안정적인 버전인 6.6버전을 선택했습니다.
$ git clone -b 6.6 https://github.com/apereo/cas-overlay-template.git cas-server
깃을 클론하고 나면 이런 모습입니다. 여기서 주요하게 봐야할 부분은 Dockerfile, docker-compose.yml, etc, build.gradle입니다. 사실 src/main/resources에 etc파일을 둬야하는지는 잘 모르겠습니다. 하지만 중요한건 위의 네개가 확실합니다.
1. build.gradle에 의존성 추가하기

build.gradle에 dependencies 부분에 해당 세줄을 추가해줍니다.
간단하게 설명하자면 json기반 설정파일을 읽기위한 json-servier-registry이고 CAS서버에서 데이터베이스에 접근하기위해 JDBC와 JDBC-Driver를 의존하도록 합니다.
2. docker-compose.yml 파일에서 etc 폴더 바인딩하기
volumes에 현재 존재하는 /etc/cas 폴더를 컨테이너 내부의 /etc/cas로 바인딩해주는 작업이 필요합니다. 해당 docker-copose 파일을 실행하게 되면 같은 디렉토리에 있는 Dockerfile을 기반으로 빌드를 해주고 이미지를 생성합니다.
그리고 해당 이미지를 기반으로 컨테이너를 생성해주는 작업을 거치게됩니다.
3. saml 폴더와 services 폴더 생성하기
$ sudo docker-compose -f ./docker-compose.yml up -d
실행하면 다음과 같은 에러가 뜰 것입니다.
해당 에러는 읽어보시면 대충 감이 잡히실겁니다. /etc/cas/saml 폴더가 없다는 것입니다.
우리는 어차피 docker-compose.yml을 이용해 바인딩하기 때문에 프로젝트 내부에 직접 만들어주기만 하면 됩니다.
$ cd /etc/cas
$ mkdir saml
그리고 다시 docker-compose를 실행해줍니다.
그럼 또 이와같은 에러가 발생합니다.
이역시 services 폴더가 없어서 그런것입니다. 만들어주도록 합시다.
$ mkdir services
자 이제 CAS 서버에 HTTPS를 적용시키도록 합시다. CAS는 인증정보가 티켓형태로 이동하기 때문에 TLS/SSL 통신이 필수적입니다.
다음 포스팅에서 자세히 알아보도록 하죠!
CAS 인증서버 구축하기 (2) : CAS 서버에 HTTPS 적용하기
이전 포스팅과 이어집니다.
바로 HTTPS를 위해 thekeystore를 만들어주도록 하죠.
우리는 먼저 /etc/cas 폴더로 이동해야합니다. 이동해주시구요.
이제 thekeystore를 만들어봅시다.
$ keytool -genkey -keyalg RSA -alias thekeystore -keystore thekeystore -storepass changeit -validity 360 -keysize 2048
하지만 이렇게 쓰면 에러가 날겁니다. 우리가 아직 openjdk를 설치하지 않았거든요 ㅎㅎ..
CAS overlay template은 최신 버전인 7.0이 JDK 21을 사용하고 6.6버전까지는 JDK 11을 사용합니다. 때문에 저희는 JDK 11을 설치해주도록 합시다.
$ sudo apt-get install open-jdk-11
자 이제 설치가 완료되었으니 다시 keytool 명령어를 실행해줍니다.
중요!!
이때 생성하는 thekeystore는 도메인을 입력해야합니다! 도메인이 없고 IP 주소만 있다면 IP주소를 적어주셔야합니다.
이름과 성을 입력하시오
[Unknown] : 도메인 or IP주소
조직 단위 이름을 입력하십시오
[Unknown] : 도메인 or IP주소
조직 이름을 입력하십시오
[Unknown] : 도메인 or IP주소
구/군/시 이름을 입력하십시오
[Unknown] : Seoul
시/도 이름을 입력하십시오
[Unknown] : Mapo
이 조직의 두 자리 국가 코드를 입력하십시오
[Unknown] : 82
CN=도메인 or IP주소, OU=도메인 or IP주소, O=도메인 or IP주소, L=Seoul, ST=Mapo, C=82 가 맞습니까?
[No} : Y
thekeystore에 대한 키 비밀번호를 입력하십시오.
changeit
다음 단계는 생성된 저장소를 클라이언트 응용 프로그램에서 사용할 수 있도록 .crt 형식으로 export하는 것입니다.
$ keytool -export -alias thekeystore -file thekeystore.crt -keystore thekeystore
키 저장소 비밀번호 입력 : changeit
이제 thekeystore.crt를 java cacerts 키 저장소로 import 해야합니다.
$ keytool -import -alias thekeystore -storepass changeit -file thekeystore.crt -keystore "/usr/lib/jvm/java-11-openjdk-amd64/lib/security/cacerts"
이런식으로 뜨면 성공입니다.
그리고 우리는 프로젝트로 다시 돌아가서 /src/main/resources/application.yml 에 해당 내용을 추가해줍니다.
server:
context-path: /cas
port: 8443
ssl:
key-store: classpath:/etc/cas/thekeystore // 이게 안되면 file:/etc/cas/thekeystore로 하세요
key-store-password: changeit
key-password: changeit
그리고 도메인 or IP:8443/cas/login 으로 들어가보면?
위에보시면 https가 적용 안된것 같지만 사실 된겁니다.
자 여기까지 CAS 서버에 HTTPS를 적용해보았습니다.
다음엔 사용자 등록하는 과정을 진행해보겠습니다!
CAS 인증서버 구축하기 (3) : 사용자 등록하기
이제 로그인을 하기 위해서 사용자가 있어야겠죠?
가장 간단한 방법은 static한 사용자를 만들면 됩니다. 그냥 하드코딩으로 때려박는거죠. 하지만 이 방법은 생략하도록 하겠습니다.
우리가 본질적으로 원하는 것은 데이터베이스에 존재하는 사용자를 이용해서 로그인을 진행하는 것이니까요.
static한 사용자 인증을 패스하고 바로 데이터베이스 사용자를 등록해보도록 하겠습니다.
일단 CAS 서버를 띄웠으니 데이터베이스를 위한 서버를 하나 더 띄우겠습니다.
그곳에서 docker, docker-compose을 내려받아주고 Docker를 이용해 MySQL을 띄웁니다.
MySQL 사용자를 만들어주고 외부 연결까지 마치고 나면 준비 끝입니다.
너무 두루뭉술하게 넘어가서 왜이렇게 금방금방 넘어가? 하신다면 아래의 링크를 통해 자세히 보실 수 있습니다!
https://coding-review.tistory.com/category/%EB%B0%B0%ED%8F%AC/docker
데이터베이스 쿼리를 사용하기 위해 application.yml에 다음과 같이 작성합니다.
test라는 데이터베이스를 사용했고 컬럼은 id, login_id, login_pw가 있습니다.
user에는 우리가 생성한 MySQL사용자를, password는 사용자를 인증하기위한 비밀번호를, 실제 CAS 서버에서 아이디와 비밀번호를 입력받아야하는 텍스트필드와 데이터베이스의 컬럼과 바인딩하기위해 어떤 컬럼명인지 field-user, field-password를 적어줍니다.
그리고 마지막으로 password-encoder를 NONE으로 하였는데 해당 옵션은 데이터베이스에 평문으로 비밀번호를 저장할 때 사용하는 것입니다. 저는 테스트용으로 만들었기 때문에 암호화를 하지 않았지만 실환경에선 BCrypt로 암호화할 것입니다.
이때는 password-encoder 의 type 부분을 BCRYPT라고 적어주시면 됩니다.
테스트용 사용자를 하나 만들고 다시 CAS 서버에서 로그인을 진행해보도록 하겠습니다.
주의!
그리고 뭐라도 설정이 하나 바뀌었다면 서버를 내렸다가 다시 올려야합니다.
다시 서버를 올려서 로그인을 진행해보면?
이렇게 성공한 것을 볼 수 있습니다.
데이터베이스 연동에 대한 더 자세한 내용은 아래의 링크를 참고해주세요! 해당 링크는 CAS 공식문서입니다.
https://apereo.github.io/cas/6.6.x/authentication/Database-Authentication.html
이제 클라이언트를 만들어보도록 하죠!
CAS 인증서버 구축하기 (4) : CAS 클라이언트 생성
클라이언트를 개발하기 전에 한가지 해야할 일이 있습니다.
바로 CAS 인증 서버에 우리가 사용할 서비스를 등록해줘야한다는 것이죠.
우리가 첫번째 시간에 만들었던 services 폴더 기억하시나요? 그곳은 우리가 생성할 서비스들을 관리하는 폴더입니다.
우리는 첫번째 시간에 의존성도 추가했는데 그때 json 기반 registry를 기억하실겁니다. 그것을 이용해 서비스를 json 파일로 등록할 수 있습니다.
프로젝트/etc/cas/services 로 가서 파일을 하나 만들어줍니다.
$ vim casSecuredApp-19991.json
자 간단하게 설명드리자면 @class는 Regex 즉 정규표현식을 이용해 서비스를 등록하는 레지스트리를 만들겠다는 뜻입니다. 때문에 serviceId에 맨처음 " ^ " 이것을 빼먹어서는 안됩니다. 이것때문에 삽질을 좀 했네요 ㅎㅎ..
제일 중요한 것은 @class와 serviceId 그리고 id입니다.
serviceId에는 우리가 사용할 도메인 혹은 퍼블릭IP 그리고 해당 프로젝트의 포트, /login/cas까지 빠짐없이 적어야합니다.
이때 중요한 점은 이 services 내부에 json 파일을 {프로젝트디렉토리}/src/main/resources로 복사해주어야 한다는 것입니다. 만약 /etc/cas/services에만 json파일을 생성한다면 이 json파일을 서버가 읽을 수 없습니다.
이건 잘...
이건 검증해보지 않아서 잘 모르는 부분이긴 합니다만... /etc/cas/config에 가보면 log4j2.xml이 있습니다. config 폴더에 cas.properties를 만들었습니다.
그리고 해당 내용은 다음과 같습니다.

이 내용이 필요한 것인지 필요하지 않은 것인지는 모르겠습니다만 오래 걸리는 것도 아니니 혹시 모르니까 하나 만들어주시는 것을 추천드립니다.
클라이언트 개발
이렇게 인증 서버를 사용할 서비스를 등록했습니다. 자 이제 본격적으로 클라이언트를 만들어보도록 하겠습니다. 위의 설정은 CAS 인증 서버에서 진행해주시고 우리는 MySQL을 설치한 새로운 서버로 들어와서 진행해주시면 됩니다.
우리는 Spring Boot 프로젝트를 준비해줘야합니다. 의존성은 web, security를 추가해주세요.
1. 의존성 추가
build.gradle에 다음과 같이 추가해줍니다.
implementation 'org.springframework.security:spring-security-cas'
빌드 해주시고 다음과 같이 코딩해주시면 됩니다.
package com.example.firstapplication.controller;
import org.springframework.web.bind.annotation.GetMapping;
import org.springframework.web.bind.annotation.RestController;
@RestController
public class HomeController {
@GetMapping("/")
public String home() {
return "home";
}
}
package com.example.firstapplication.controller;
import org.springframework.security.core.Authentication;
import org.springframework.security.core.context.SecurityContextHolder;
import org.springframework.web.bind.annotation.GetMapping;
import org.springframework.web.bind.annotation.RestController;
@RestController
public class SecuredController {
@GetMapping("/secured")
public Authentication secured() {
Authentication authentication = SecurityContextHolder.getContext().getAuthentication();
return authentication;
}
}
간단한 컨트롤러 두개를 만들었습니다. 하나는 로그인이 필요하지 않은 API, 그리고 나머지 하나는 로그인이 필요한 API입니다.
package com.example.firstapplication.config;
import com.sun.xml.bind.v2.TODO;
import org.jasig.cas.client.validation.Cas30ServiceTicketValidator;
import org.jasig.cas.client.validation.TicketValidator;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
import org.springframework.context.annotation.Primary;
import org.springframework.security.cas.ServiceProperties;
import org.springframework.security.cas.authentication.CasAuthenticationProvider;
import org.springframework.security.cas.web.CasAuthenticationEntryPoint;
import org.springframework.security.core.authority.AuthorityUtils;
import org.springframework.security.core.userdetails.User;
import org.springframework.security.web.AuthenticationEntryPoint;
@Configuration
public class CassClientConfiguration {
@Bean
public ServiceProperties serviceProperties() {
ServiceProperties serviceProperties = new ServiceProperties();
serviceProperties.setService("http://3.38.247.51:9000/login/cas");
serviceProperties.setSendRenew(false);
return serviceProperties;
}
@Bean
@Primary
public AuthenticationEntryPoint authenticationEntryPoint(ServiceProperties sp) {
CasAuthenticationEntryPoint entryPoint = new CasAuthenticationEntryPoint();
entryPoint.setLoginUrl("https://43.203.127.117:8443/cas/login");
entryPoint.setServiceProperties(sp);
return entryPoint;
}
@Bean
public TicketValidator ticketValidator() {
return new Cas30ServiceTicketValidator("https://43.203.127.117:8443/cas");
}
@Bean
public CasAuthenticationProvider casAuthenticationProvider() {
CasAuthenticationProvider provider = new CasAuthenticationProvider();
provider.setServiceProperties(serviceProperties());
provider.setTicketValidator(ticketValidator());
provider.setKey("CAS_PROVIDER_LOCALHOST_9000");
// UserDetailService 가 반드시 등록되어야 CasAuthenticationProvider 가 정상 작동 한다.
provider.setUserDetailsService(s -> new User("ks325", "123", AuthorityUtils.createAuthorityList("ROLE_ADMIN")));
return provider;
}
}
CAS 서버 인증을 위해 사용할 빈들을 만들어줘야합니다.
• ServiceProperties에는 우리가 만든 서비스의 설정정보를 적어야합니다.
• AuthenticationEntryPoint는 설명하자면 길어서 간단하게 설명해드리자면 우리의 CAS 서버를 가리키게 하면 됩니다.
• TicketValidator의 구현체로 Cas30ServiceTicketValidator를 설정해주시면 됩니다.
• 마지막으로 Provider로 CasAuthenticationProvider를 만들어주면 됩니다.
주석에 쓰여있듯이 UserDetailService를 구현해주셔서 주입해주어야합니다. Security에서 구현하듯이 구현해서 주입해주시면 되겠습니다. 저는 간단하게 테스트용이라 간단하게 만들어보았습니다.
그리고 마지막으로 Security 설정을 하면 끝!
package com.example.firstapplication.config;
import lombok.RequiredArgsConstructor;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
import org.springframework.security.authentication.AuthenticationManager;
import org.springframework.security.authentication.AuthenticationProvider;
import org.springframework.security.authentication.ProviderManager;
import org.springframework.security.cas.ServiceProperties;
import org.springframework.security.cas.web.CasAuthenticationFilter;
import org.springframework.security.config.annotation.web.builders.HttpSecurity;
import org.springframework.security.config.annotation.web.configuration.EnableWebSecurity;
import org.springframework.security.config.annotation.web.configuration.WebSecurityConfigurerAdapter;
import org.springframework.security.web.AuthenticationEntryPoint;
import java.util.Arrays;
@Configuration
@EnableWebSecurity
@RequiredArgsConstructor
public class WebSecurityConfiguration extends WebSecurityConfigurerAdapter {
private final AuthenticationEntryPoint authenticationEntryPoint;
private final ServiceProperties serviceProperties;
private final AuthenticationProvider authenticationProvider;
@Override
protected void configure(HttpSecurity http) throws Exception {
http.authorizeRequests().regexMatchers("/secured.*", "/login").authenticated()
.and().authorizeRequests().antMatchers("/favicon.ico", "/static/**").permitAll()
.and().authorizeRequests().antMatchers("/").permitAll()
.and().httpBasic().authenticationEntryPoint(authenticationEntryPoint);
}
@Bean
public CasAuthenticationFilter casAuthenticationFilter() throws Exception {
CasAuthenticationFilter filter = new CasAuthenticationFilter();
filter.setServiceProperties(serviceProperties);
filter.setAuthenticationManager(authenticationManager());
return filter;
}
@Bean
public AuthenticationManager authenticationManager() {
return new ProviderManager(Arrays.asList(authenticationProvider));
}
}
뭔가 이상하긴 하실겁니다. 왜냐면 스프링 부트 3.x 버전이 아니기 때문입니다.
저희 회사가 2.5.3을 사용하고 있기 때문이기도 하고... 프로젝트를 굳이 3.x 버전으로 하는 건 테스트용으로 적합하지 않다고 판단하여 다운그레이드 하여 사용했습니다.
자 이제 해당 프로젝트를 배포하고 루트 주소로 들어가보면?
잘 작동합니다. 그리고 /secured로 들어가보면?
위에 주소를 보시면 특이한 점이 있을겁니다. 바로 서버가 다르다는 것입니다. IP주소도 다르고 포트도 다르네요. 그리고 뒤에 쿼리스트링으로 service=http 불라불라 이렇게 나와있죠.
이 페이지에서 로그인을 마치고 나면 티켓을 발급해주고 해당 페이지로 리다이렉트를 시켜줘야 하기 때문에 저렇게 되어있는 것입니다.
이 페이지가 뜬것만으로도 우리는 해당 서비스가 CAS 서버에 잘 적용되었다는 것을 알 수 있습니다.
여기까지만 하면 거의 성공! 거의 다왔습니다. 이제 로그인을 해보면?
허허... 이게 뭐죠?
에러 로그는 이렇게 되어있었습니다.
위에 더 있는데 핵심은 이겁니다. 구글링해본 결과
네... ec2 인스턴스에 https 설정이 안되어있어서 그렇습니다.
다음 포스팅에선 ec2에 https를 설정하고 이어가도록 하겠습니다.
CAS 인증서버 구축하기 (5) : 모든 EC2 인스턴스를 HTTPS로 전환하기
저번 포스팅에선 SSLHandshakeException이 발생했었습니다. 이 문제를 해결하기 위해서는 EC2 인스턴스의 SSL 설정을 해줘야합니다.
보통 WAS 서버에 HTTPS를 적용하는 방법은 NginX나 Apache같은 웹서버에 SSL 인증서를 등록하여 해결할 수 있습니다.
저는 AWS ACM 인증서를 가지고 있었기 때문에 AWS ALB에 ACM을 연결하여 HTTPS 설정을 할 수 있었지만 이참에 회사에서 사용하는 NginX에 대해 공부하고자 NginX에 SSL 설정을 하는 방법을 강구했습니다.
네... 결론만 말하자면 ACM을 이용해서 SSL을 설정하는 것을 불가능합니다. 우선 NginX에 SSL 설정을 위해서는 다음과 같은 설정이 필수적으로 필요합니다.
server {
listen 443 ssl http2;
server_name example.com;
ssl_certificate /etc/letsencrypt/live/example.com/fullchain.pem;
ssl_certificate_key /etc/letsencrypt/live/example.com/privkey.pem;
location / { #
proxy_pass https//localhost:9001;
proxy_set_header Host $http_host;
proxy_set_header X-Real-IP $remote_addr;
proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
proxy_set_header X-Forwarded-Proto $scheme;
}
}
여기서 ssl_certificate와 ssl_certificate_key이 필요합니다. ssl_certificate는 CA에서 제공해주는 인증서를 등록해야합니다. 여기서는 pem 기반 인코딩 방식의 pem 확장자 혹은 crt 확장자면 됩니다.
이때 ssl_certificate는 full-chaining 된 인증서여야합니다. 여기서 chiaining이란 단순히 CA에서 등록한 인증서를 기반으로 SSL통신을 하는 것이 아니라 추가적인 하나이상의 CA에서 발급한 인증서를 체이닝해서 연결해야한다는 뜻입니다.
또한, ssl_private_key는 CA에서 발급한 인증서와 일치하는 private_key의 위치를 적어주시면 됩니다.
이 두개는 openssl 명령어를 이용해 일치하는지 확인하고 등록하시는 것을 추천드립니다.
openssl x509 -noout -modulus -in /path/to/your/certificate.pem | openssl md5
openssl rsa -noout -modulus -in /path/to/your/private.key | openssl md5
이 명령어를 이용해 둘이 일치하는지 확인하시면 됩니다.
ACM 얘기하다 갑자기 뜬금없이 NginX의 SSL설정 얘기는 왜하느냐...
네... ACM은 private-key 추출이 불가능했습니다. 이를 해결하기위해 AWS PCA라는 사설 인증서 (유료) 를 이용해 private-key를 추출하기 위해 PCA를 신청하고 추출하려 했지만 IAM 정책이 잘 적용되지 않는 문제 (아직도 해결 못했습니다.) 때문에 NginX SSL 설정을 못했습니다.
때문에 제가 잘 알고있는 AWS ALB를 이용해서 ACM을 적용해 HTTPS를 적용했습니다.
AWS ALB를 이용해 SSL설정을 하는 방법은 제가 쓴 글인 아래의 링크를 확인해주시면 감사하겠습니다.
https://coding-review.tistory.com/432
다만 여기서 주의해야 할 점은 타겟그룹을 설정할 때입니다. 타겟그룹을 설정해줄 때 HTTP or HTTPS 프로토콜을 선택하고 포트를 입력하는 곳이 있는데 기본적으로 CAS는 HTTPS 기반의 통신을 기본값으로 설정하고 있기 때문에 HTTPS로 타겟그룹을 설정해야합니다. (이것도 삽질 좀 오래했습니다.)
만약 타겟그룹의 프로토콜을 HTTP로 설정한다면 인증서가 잘 적용되었다는 표시가 뜨지만 정작 400 Bad Request가 뜨는 기이한 상황이 펼쳐집니다.
이렇게 모든 EC2에 HTTPS를 적용하면 로그인이 성공하는 모습을 볼 수 있습니다.
여기까지 EC2 인스턴스에 HTTPS 적용하는 방법에 대해서 알아봤습니다. 여러분은 삽질하지 마시고 순탄대로 적용하셨으면 좋겠습니다. 다음 포스팅은 CAS의 인증정책에 대해서 알아보도록 하겠습니다.
CAS 인증서버 구축하기 (6) : CAS 인증정책
왜 뜬금없이 CAS 서버의 인증정책에 대해서 알아보냐...
제가 지금 문제 상황에 놓여있기 때문입니다. 이를 위해 공식문서를 얼마나 뒤져봤는지 아주 눈알이 빠지기 직전입니다.
우선 제가 이 문제 상황에 빠지게 된 경위에 대해서 설명드리겠습니다.
CAS 공식문서엔 다음과 같이 나와있습니다.
https://apereo.github.io/cas/6.6.x/authentication/Database-Authentication.html
cas:
authn:
jdbc:
query[0]:
driver-class: "org.hsqldb.jdbcDriver"
이 application.yml 설정을 보시면 직관적으로 다음과 같은 생각을 하게 됩니다.
query[0] 이라고? 그럼 query[1]도 있겠는데?
아하 CAS 서버는 데이터베이스 기반 인증처리를 할 때 설정되어있는 query[0], query[1] 혹은 query[2] 까지 모두 데이터베이스에 찔러보고 값이 있으면 인증을 진행하는구나.
그래서 저도 그걸 철썩같이 믿었습니다.
cas:
jdbc:
show-sql: true
authn:
policy:
any:
enabled: true
jdbc:
query[0]:
driver-class: "com.mysql.cj.jdbc.Driver"
url: "jdbc:mysql://{public IP}:3306/test?autoReconnect=true&allowMultiQueries=true&serverTimezone=UTC"
sql: "select id, login_id, login_pw from test.sso where login_id = ?;"
user: "mysql"
password: "root"
field-password: "password"
password-encoder:
type: "NONE"
query[1]:
driver-class: "com.mysql.cj.jdbc.Driver"
url: "jdbc:mysql://{public IP}:3306/test2?autoReconnect=true&allowMultiQueries=true&serverTimezone=UTC"
sql: "select id, username, password from test2.kva_user where username = ?;"
user: "mysql"
password: "root"
field-password: "password"
password-encoder:
type: "NONE"
그래서 이렇게 작성했습니다.
그리고 실험해본 결과... 쿼리를 query[0] 만 날려보고 query[1] 은 전송이 안됩니다. 무슨 수를 쓰더라도.
우선 여러번의 실험끝에 query[1]이 전송되지 않는다는 사실을 발견했습니다.
"선생님 저기 show-sql에 true로 되어있는걸로 보면 확실히 알 수 있지않나요?"
네. 그래서 저렇게 작성했는데 SQL이 안보였습니다. 그래서 여러번 실험을 할 수 밖에 없었구요.
• query[0] 이 성공하고 query[1] 은 실패하는 케이스
• query[0] 이 실패하고 query[1] 은 성공하는 케이스
• query[0] 을 삭제하고 query[1] 을 query[0] 으로 변경해본 케이스
• query[1] 이 실패한 데이터를 query[0] 에 성공하게 데이터를 변경해본 케이스
이 다양한 상황에서 어느 하나도 두번째 쿼리가 날아가는 상황은 찾을 수 없었습니다. query[1] 이 전송되는지 확인하기 위해 쿼리를 날릴때마다 데이터베이스 커넥션과 프로세스를 확인했습니다.
결국 가설을 세웠습니다.
• query[1] 에 해당하는 데이터베이스 연결이 안되어있고 query[0] 만 전송되는 상황
• query[0] 과 query[1] 에 해당하는 데이터베이스 연결은 잘 되었고 query[1] 만 쿼리가 전송되지 않는 상황
저는 DEBUG 레벨 로그를 보고 첫번째 가설을 폐기하였습니다.
그 이유는 다음과 같습니다.
• 로그에 데이터베이스 커넥션과 관련된 Exception이 없었다.
• DEBUG 레벨에서 application.yml에서 설정한 값들이 정상적으로 관리되고 있는 것을 확인하였다.
때문에 제 가설은 2번으로 더 굳어지게 되었습니다.
여기서 CAS의 인증 정책에 대해서 조금 알아볼 필요가 있습니다.
CAS 인증정책
인증 정책은 기본적으로 첫번째로 인증에 실패하면 다음 인증 체인은 끝납니다.
이 말은 무엇이냐. 지금 제가 사용하는 데이터베이스 기반 인증 정책이 실패하면 해당 인증 체인은 종료된다는 것입니다.
즉, query[0]이 실패하면 해당 인증은 끝 query[1]이 추가적으로 실행되지 않습니다.
이것을 보고 처음엔 이해가 되지 않았습니다.
애초에 query[0] 같이 개발자로 하여금 배열이라고 생각이 들게 하여 query[1] 을 직관적으로 생각하게 만들고 query[1] 이 실행조차 되지 않는것이 말이 안되는 것 같았습니다.
또한, 만약 데이터베이스 기반 인증 정책을 사용한다고 하더라도 application.yml 에 등록된 query 들은 전부 실행해보고 인증 실패를 판단해야지 왜 query[0] 하나만 실행해보고 인증 성공 여부를 판단하는지도 이해가 안됐습니다.
그리고 제 직관상 CAS 서버는 각각의 서버들의 인증을 담당해야 하기 때문에 인증을 위해 각각의 서버에 물려있는 데이터베이스를 모두 확인해봐야 한다고 생각했습니다.
때문에, 인증을 직접 수행하는 Handler라는 것을 커스텀하게 작성하여 모든 데이터베이스에 쿼리를 날려보도록 설계하기도 하였습니다. 하지만 구글링 결과 그렇게 의문을 가진 사람도 한명도 없었고 시도해본 사람도 한명도 없었습니다.
모든 정황들은 제 생각이 틀렸다고 말해주고 있었습니다.
결국은 제 직관이 틀렸다는 것을 반증하고 있었는데. 만약 이것이 모두 의도되었다고 가정하고 문제 상황을 생각해보았습니다.
첫번째
만약 CAS 서버에 연결된 서비스들이 수십개라면? 이 상황엔 로그인을 위해서 수십개의 DB에 쿼리를 날려봐야합니다. 그때 발생하는 네트워크 I/O와 데이터베이스 커넥션 생성에 필요한 리소스를 생각하면 애플리케이션 규모가 큰 경우에 문제가 발생할 수 있을 것 같았습니다.
두번째
저의 다양한 실험 끝에 query[1] 은 실행이 되지 않는다는 것을 확인했습니다. 물론 이를 show-sql로 확인하면 확실하게 알 수 있었지만 sql이 보이지 않는 상황에서의 최선이었습니다.
저의 실험끝에 query[1] 이 실행되지 않는 다는 것이 제 생각이 틀렸다는 것을 반증하고 있었습니다.
세번째
데이터베이스 기반 인증을 위해 직접적으로 인증을 수행하는 Handler에 대한 구현체를 모두 살펴봤습니다. 코드를 분석해본 결과 그 어디에서도 여러개의 DataSource를 사용하지 않는 것으로 확인되었습니다.
심지어 반복문이 그 어디에도 사용되지 않았습니다.
결론
결론적으로 제 생각이 틀렸고 제가 모르는 이유가 있음을 암시하고 있었습니다. 제가 직관적으로 생각한대로 CAS가 작동하면 모종의 문제가 생길 수 있는 것 같습니다.
또한, 이 문제 상황을 유심히 듣던 제 동기가 조금 찾아보더니 이렇게 얘기하더군요
"만약 query[0] 만 실행된다면 CAS 서버는 다른 서비스로부터 인증을 위해 떨어져 나왔듯이 데이터베이스도 회원 인증만을 위한 데이터베이스가 따로 있어야 하는 것이 아니냐"
처음엔 그렇게 하는 경우엔 데이터베이스 마이그레이션이 필수적인데 그거에 들어가는 리소스가 많지 않겠냐고 얘기했지만 결국 이 방법이 맞는 방법인가 싶은 생각이 들었습니다.
다음은 CAS를 위해 마이그레이션을 공부하고 다음 포스팅엔 마이그레이션으로 찾아뵙도록 하겠습니다.
스프링 부트 배치 개념
대략 10만명의 회원을 거느리는 웹 서비스를 운영한다고 가정했을 때 우린 매일마다 회원들의 상태변화를 감지하고 운용할 수 있어야 합니다.
가령 오늘까지 우리 서비스에 접속하지 않은지 1년 이상이 지난 회원의 상태는 휴면으로 전환시키고 휴면으로 전환된 회원은 다시 로그인 했을 때 본인인증 절차를 거치도록 하는 것이 서비스 보안에 좋겠죠.
또는 후불로 청구되는 유료 서비스를 이용하고 과금액을 미납한지 한 달째 되는 회원에 대해서도 매일마다 집계하여 그에 맞는 추심을 한다거나 채권 관리대상으로 지정하여 우리서비스의 수익구조를 안정적으로 보호해야 하는 경우도 있습니다.
만약 이런 일들을 사람의 손을 반복적으로 거쳐야 한다면 매우 고단한 일이 될겁니다.
스프링부트 프레임워크에서는 이러한 일괄처리를 쉽게 안정적으로 지원해주는 배치 애플리케이션을 제공합니다. 바로 지금 이야기 할 스프링부트 배치 (Springboot Batch) 입니다.
스프링 부트 배치에 관하여
스프링 부트가 제공하는 스프링부트 배치는 다음과 같은 강점을 가지고 있습니다.
자동화 : 매번 단순 반복 작업을 쉽고 빠르게 자동화시켜줍니다.
대용량 처리 : 그것이 대용량이라 할지라도 가장 최적화된 성능을 보장합니다.
견고성 : 예측하지 못한 상황이나 동작에 대한 예외처리라도 정의할 수 있습니다.
재사용성 : 공통적인 작업을 단위별로 재사용할 수 있습니다.
이렇게 좋은 배치처리 프레임워크가 있으니 당장 사용해야겠죠?
하지만 이런 스프링부트 배치라도 배치처리 특성상 몇 가지 고려해야 될 사항이 있습니다.
> 단순하게!
복잡한구조와 로직을 피해야 합니다.
> 안전하게!
정의한 단위수만큼 데이터를 불러와서 처리합니다.
처리해야 하는 데이터에 대한 예외적인 상황이 일어나지 않도록 데이터의 무결성이 보장되어야 합니다.
> 가볍게!
배처처리시 시스템에 입력(Input)과 출력(Output)의 사용을 최소화해야 합니다. 네트워크 비용을 커질수록 그만큼 성능에도 영향을 끼치기 때문이죠.
최대한 적은 횟수로 데이터를 가져와서 -> 처리하고 -> 저장하는 것이 좋습니다.
> 스케쥴러가 아닙니다!
착오하지 말아야 할 것이 스프링부트배치는 스케줄러가 아닙니다. 별도로 스케줄링 프레임워크에 구현된 스프링 부트 배치를 적용하여 원하는 시간이나 이벤트 상황에 실행되게 하거나 이력관리를 할 수 있어야 합니다.
스프링 부트 배치의 기본 구조
스프링 배치에 공통적으로 정의된 시나리오는 다음과 같습니다.
Read(가져와서) : 원하는 조건의 데이터 레코드를 DB에서 읽어옵니다.
Processing(처리하고) : 읽어온 데이터를 비즈니스로직을 따라 처리합니다.
Write(저장한다.) : 처리된 데이터를 DB에 업데이트(저장)합니다.
이해하기 매우 쉽죠. 그저 '가져와서', '처리하고', '저장합니다'. 이 기본구조를 스프링 부트 배치에서 제공하는 인터페이스 관계도를 나타내면 다음과 같습니다.
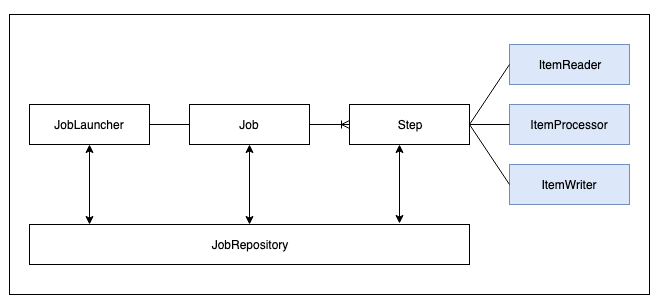
전 단계는 잠시 무시하고 방금 전 언급한 부분만 살펴보겠습니다. 가져와서, 처리하고, 저장한다는 각각 다음의 인터페이스에서 정의합니다.
ItemReader : 배치데이터를 읽어오는 인터페이스입니다. DB뿐 아니라 File, XML 등 다양한 타입에서 읽어올 수 있습니다.
ItemProcessor : 읽어온 데이터를 가공/처리합니다. 즉, 비즈니스 로직을 처리합니다.
ItemWriter : 처리한 데이터를 DB(또는 파일)에 저장합니다.
ItemProcessor vs ItemWriter
지금도 단순하지만 더 단순하게 생각해서
1. 가져와서(ItemReader)
2. 처리한다.(ItemProcessor)
2. 처리하고 저장한다.(ItemWriter)
이렇게 생각해 볼 수도 있겠죠, 굳이 ItemProcessor와 ItemWriter 단계를 별도로 분리하지 않고 그냥 ItemWriter에서 처리하고 바로 저장하는 구조가 더 간결해 보일수도 있겠습니다...만 이렇게 분리하는 데에는 다 이유가 있습니다.
1. 각각의 역할을 단순명료하게 분리하기 위함입니다.
앞서 설명드린 바와 같이 스프링부트 배치는 배치 처리 특성상 그 구조가 단순해야 합니다. 이미 역할이 정해져 있는 인터페이스에 본연의 역할외에 다른 역할까지 정의하여 사용하면 처리가 이루어지는 분기 단위가 모호해질 수 밖에 없습니다.
꼭 스프링부트 배치 프레임워크라서가 아니라 대용량 데이터에 대한 배치 처리는 100건이면 100건 1000건 이면 1000건 과 같이 일정한 처리 단위로 최대한 단순하게 읽고 처리하고 저장되게 하는 것이 좋습니다.
개발자 입장에서도 비즈니스 로직을 살펴볼 때에 어디가 데이터를 읽어오고, 어디에서 데이터를 처리하며, 어디가 데이터를 저장소에 저장하는 역할인지 명확하게 구분 지어 설계하는 것이 견고한 서비스를 만들어가는데에 좋은 밑바탕이 될 수 있겠죠
2. 읽어오는 데이터와 저장하는 데이터의 타입을 분리하기 위함입니다.
ItemReader(데이터를 읽어올 때)에선 DB 뿐만 아니라 File 에서도 읽어올 수 있습니다. 마찬가지로 ItemWriter(데이터를 저장 할 때)에서도 역시 DB뿐 아니라 File에 쓰이게 할 수도 있습니다. 스프링부트 배치 프레임워크에서 제공하는 2개의 인터페이스를 살펴보겠습니다.
인터페이스 : ItemReader
package org.springframework.batch.item;
import org.springframework.lang.Nullable;
public interface ItemReader<T> {
T read() throws Exception, UnexpectedInputException, ParseException, NonTransientResourceException;
}
ItemReader는 배치 데이터를 읽어오는 인터페이스입니다. Read 메서드의 반환 타입을 볼까요? 제네릭 타입입니다. 네 맞습니다. 제네릭이기 때문에 우리가 직접 타입을 지정할 수가 있습니다. 즉 ItemReader를 통해 읽어오는 타입은 우리가 직접 지정할 수 있습니다.
인터페이스 : ItemWriter
package org.springframework.batch.item;
import java.util.List;
public interface ItemWriter<T> {
void write(List<? extends T> items) throws Exception;
}
ItemWriter의 write 메소드의 매개변수를 살펴볼까요? 제네릭 입니다. 아까 ItemReader 인터페이스의 반환타입이던 바로 그 제네릭 말입니다. 매개변수는 우리가 원하는 타입을 리스트 형태로 받습니다.
그렇다면 데이터를 한번에 몇건 씩 처리해야 할까요?
단순하게 ItemReader에서 반환된 모든 데이터를 한꺼번에 받아서 처리하면 될까요? 만약 읽어온 데이터가 1만건, 아니 100만건이 될 수도 있을텐데요. 그렇게 많은 양의 데이터가 한꺼번에 메모리에 올려지면 실제 서비스에 어떤 영향을 주게 될까요?
네 스프링부트 배치는 한 번의 트랜잭션 안에 처리(commit)되는 수를 정의할 수 있습니다. 그 역할을 하는 것이 바로 chunk라는 단위이지요. 이것은 스프링부트 프레임의 가장 핵심적인 키워드라 잠시 후 다시 설명드리도록 하겠습니다.
마지막으로 itemReader와 ItemWrtier중간에 있는 ItemProcessor를 살펴볼까요?
인터페이스 : ItemProcessor
package org.springframework.batch.item;
import org.springframework.lang.Nullable;
public interface ItemProcessor<I, O> {
O process(I item) throws Exception;
}
이 인터페이스의 존재의 이유는 방금전에 소개드렸다시피 각각의 역할을 분리하기 위해 그리고 읽어올 때와 저장할 때의 데이터 타입이 다른 경우, DB에서 레코드를 읽어와 파일 형태로 저장할 때 혹은 그 반대일 때를 대응하기 위함입니다.
이 인터페이스의 제네릭의 매개변수가 2개인데요. 앞에 있는 <I>는 Input을 의미하고 뒤에 있는 <O>는 Output을 의미합니다. 말그대로 인풋과 아웃풋 타입을 정의하여 process 메서드 안에서 무리가 필요한 비즈니스 로직을 구현합니다.
지금까지 설명한 내용을 하나의 그림으로 표현하면 다음과 같습니다.
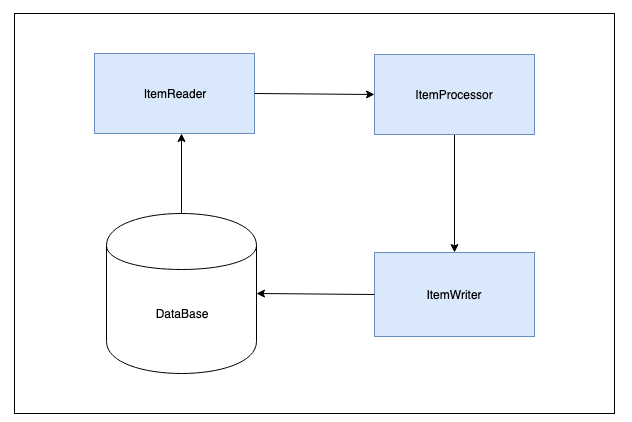
이 배치 프로세스가 돌아가는 가상의 시나리오를 설계한다고 가정해봅시다.
1. 데이터베이스에서 우리 서비스요금이 청구된 지 30일이 지난 고객 리스트를 읽어온다. (ItemReader)
2. 1번에서 가져온 고객리스트들을 대상으로 다음의 비즈니스를 처리한다. (ItemProcessor)
- 각 고객정보의 카드정보를 활용하여 자동결제를 시도한다.
- 자동결제를 시도하여 미납금액 결제을 정상적으로 처리된 고객은 요금 청구 완료상태로 전환한다.
- 자동결제를 시도하여 미납금액 결제를 실패로 처리된 고객은 서비스구독 이용정지상태로 전환한다.
- 자동결제가 성공한 고객에게는 결제가 완료됐다는 안내메시지를 등록된 휴대폰 정보를 통해 SMS로 발송한다.
- 자동결제가 실패한 고객에게는 서비스이용정지 안내 메시지를 등록된 휴대폰 정보를 통해 SMS로 발송한다.
3. 2번에서 처리된 고객리스트들를 저장한다. (ItemWriter)
실제 운영되는 서비스와 비슷한 상황의 가상 시나리오를 각각의 인터페이스의 역할에 맞게 분리하여 설계해보았습니다. 스프링 부트 배치 프레임워크가 없이 구현해야 한다면 이러한 일련의 과정을 거쳐야 하는 프로세스를 설계하는 것은 모두 개발자의 몫이 되겠죠? 비즈니스 로직은 둘째 치더라도 대용량을 다루는 배치처리에 대한 안정성 여부는 또 다른 차원의 문제입니다.
이정도라면 스프링 부트 배치 프레임워크가 제공하는 기본구조가 개발자들을 위해 얼마나 단순하고 명확하게 분리되어 제공하고 있는지를 알 수 있습니다. 스프링 부트 배치 프레임워크가 제공하는 기본 구조를 알았다면 이젠 그 기본구조를 포함하고 있는 객체를 살펴보겠습니다. 바로 저 파란색으로 칠해진 부분이죠
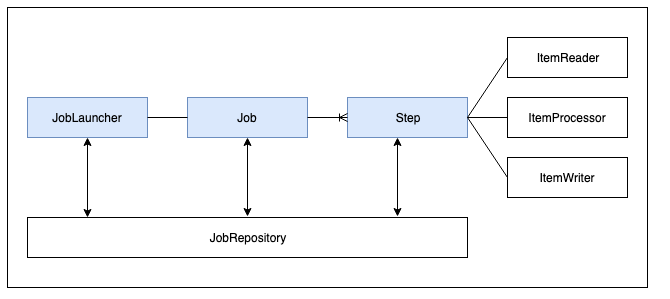
Step
기본구조(읽고, 처리하고, 저장한다.)는 Step이라는 객체에서 정의됩니다. 1개의 Step은 읽고, 처리하고 저장하는 구조를 가지고 있는 실질적인 배치처리를 담당하는 도메인 객체입니다. 그리고 이 Step은 한 개 혹은 여러 개가 이루어 Job을 표현합니다. 그리고 1개의 Step은 위에서 설명한 것과 같이 ItemReader, ItemProcessor, ItemWriter를 정의합니다.
Job
한개 혹은 여러개의 Step을 이루어 하나의 단위로 만들어 표현한 객체입니다. 스프링 부트 배치 처리에 가장 윗 계층에 있는 객체이죠. Job객체는 JobBuilderFactory 클래스에서 Job을 생성할 수 있습니다. 더 정확하게 표현하자면 JobBuilderFactory에서 생성된 JobBuilder를 통해 Job을 생성할 수 있습니다.
1) JobbuilderFactory
JobBuilderFactory 클래스를 살펴보면 다음과 같습니다.
package org.springframework.batch.core.configuration.annotation;
import org.springframework.batch.core.job.builder.JobBuilder;
import org.springframework.batch.core.repository.JobRepository;
public class JobBuilderFactory {
private JobRepository jobRepository;
public JobBuilderFactory(JobRepository jobRepository) { // 1
this.jobRepository = jobRepository;
}
public JobBuilder get(String name) { // 2
JobBuilder builder = new JobBuilder(name).repository(jobRepository);
return builder;
}
}
1. JobBuilderFactory의 생성자를 살펴봅시다. JobBuilder를 생성하는 JobBuilderFactory가 생성되는 시점에 JobRepository를 주입하여 JobBuilder에 사용할 Repository로 설정합니다. 이말인 즉슨, JobBuilder가 생성되기 전에 JobBuilderFactory는 JobRepository를 주입받게 되고 JobBuilder는 해당 JobRepository를 그대로 사용하게 되니 결국에는 모든 JobBuilder는 모두 동일한 JobRepository를 사용하게 되겠죠.
2. get 메소드가 JobBuilder 인스턴스를 생성 후 반환하고 있네요. 그러니까 JobBuilderFactory에서 get메소드를 호출하게 되면 새로운 JobBuilder가 생성된다는 사실을 알 수 있습니다.
2) JobBuilder
JobBuilderFactory를 통해 JobBuilder를 반환받았습니다. 이제 JobBuilder를 통해 Job을 생성할 수 있습니다. JobBuilder의 내부를 살펴보도록 하겠습니다.
package org.springframework.batch.core.job.builder;
import org.springframework.batch.core.Step;
import org.springframework.batch.core.job.flow.Flow;
public class JobBuilder extends JobBuilderHelper<JobBuilder> {
public JobBuilder(String name) {
super(name);
}
public SimpleJobBuilder start(Step step) {
return new SimpleJobBuilder(this).start(step);
}
public JobFlowBuilder start(Flow flow) {
return new FlowJobBuilder(this).start(flow);
}
public JobFlowBuilder flow(Step step) {
return new FlowJobBuilder(this).start(step);
}
}
각각 다르게 정의된 2개의 start메서드 그리고 1개의 flow메서드가 있네요
반환타입이 모두 Builder인 것으로 보아 사용하려는 의도에 따라 각각 다른 빌더 메서드가 분류되어 있는 것처럼 보입니다.
1. JonBuilderFactory에서 JobBuilder를 만들고
2. JobBuilder에서 Job을 생성하기 위한 Step(or Flow) 파라미터를 받아 그 목적에 맞는 JobBulder를 생성합니다.
3. Job은 Step(or Flow) 인스턴스의 컨테이너가 되기 때문에 생성하기 직전에 인스턴스를 전달받습니다.
이 원리를 잘 이해하시면 위 원리대로 기본적인 Job 생성코드를 만들어 보겠습니다.
@Bean
public Job myJob(JobBuilderFactory jobBuilderFactory) {
return jobBuilderFactory.get("myJob")
.start(mystep)
.build();
}
@Bean
public Step mystep(
StepBuilderFactory stepBuilderFactory
) {
return stepBuilderFactory.get("mystep")
.<MemberIn, MemberOut> chunk(100)
.reader(myrReader())
.processor(myProcessor())
.writer(myWriter())
.build();
}
@Bean
public ListItemReader<Member> myrReader() {
List<Member> oldMember = memberRepository.findByStatusNot(MemberStatus.INACTIVE);
return new ListItemReader<>(oldMember);
}
public ItemProcessor<Member, Member> myProcessor() {
return Member::setInactive;
}
public ItemWriter<Member> myWriter() {
return ((List<? extends Member> memberList) ->
memberRepository.saveAll(memberList));
}
이제 하나씩 한번 해석해보겠습니다.
myJob
JobBuilderFactory를 주입받은 인스턴스를 통해 JobBuilderFactory를 메서드체인 형식으로 빌드합니다.
.get("myjob") : job이라는 이름의 Job을 생성하는 JobBulder 인스턴스를 반환받고자 합니다.
.start(myStep) : myStep이라는 메서드에서 Step이라는 인스턴스를 생성하여 반환받습니다.
.build(); : 이 메소드를 통해 비로소 myJob이라는 Job이 빌드가 되면서 Job이 생성됩니다.
myStep
StepBuilderFactory를 주입받은 인스턴스를 통해 JobBuilderFactory를 메서드체인 형식으로 빌드합니다.
.get("myStep") : myStep이라는 이름의 Step을 생성하는 StepBuilder 인스턴스를 반환받고자 합니다.
.<Member, Member> Chuck(100) : MemberIn 타입을 100건 단위로 읽어와서 MemberOut로 반환한다는 의미입니다.
.reader(myReader) : myReader를 통해 DB에서 원하는 조건의 데이터 레코드를 읽어옵니다.
.processor(myProcessor) : myProcessor를 통해 비즈니스로직을 작성하여 데이터를 처리합니다.
.write(myWrite) : 처리된 데이터를 DB에 저장합니다.
JobLauncher
Job을 구현했다면 이제 구현된 Job을 실행시킬 수 있어야겠죠. 이렇게 구현한 Job은 JobLauncher라는 인터페이스에서 실행할 수 있게 해줍니다. JobLauncher는 다음과 같이 오직 실행을 위한 run이라는 이름의 메서드 한개만 가지고 있습니다.
package org.springframework.batch.core.launch;
import org.springframework.batch.core.Job;
import org.springframework.batch.core.JobExecution;
import org.springframework.batch.core.JobParameters;
import org.springframework.batch.core.JobParametersInvalidException;
import org.springframework.batch.core.repository.JobExecutionAlreadyRunningException;
import org.springframework.batch.core.repository.JobInstanceAlreadyCompleteException;
import org.springframework.batch.core.repository.JobRestartException;
public interface JobLauncher {
public JobExecution run(Job job, JobParameters jobParameters) throws JobExecutionAlreadyRunningException,
JobRestartException, JobInstanceAlreadyCompleteException, JobParametersInvalidException;
}
마지막으로 하단에 있는 JobRepository를 살펴봅시다.
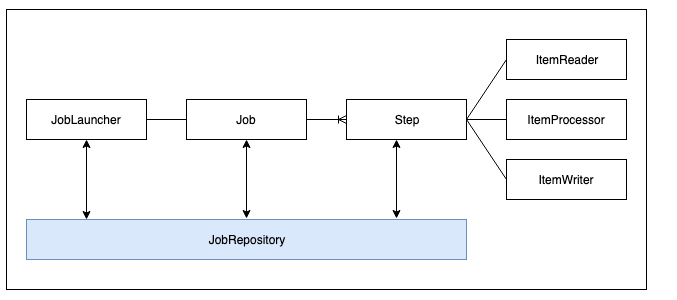
JobRepository
배치처리는 일정한 주기 간격으로 특정 조건을 가진 데이터를 읽어와서 처리하고 저장하는 구조를 가지고 있습니다. 이런 작업이 매번 반복되다 보면 가령 일주일 전부터 동작하는 Job이 그동안 몇 번 실행되고 언제 끝났는지를 알아야 하는 경우가 생기겠죠. 이러한 처리 정보를 메타데이터 형식으로 저장하여 관리하는 곳이 바로 JobRepository입니다. Job이 실행될 때 마다 JobRepository에서는 배치 실행에 관련된 정보를 담는 도메인인 JobExecution을 생성합니다.
JobInstance vs JobExecution
두 단어가 비슷해 보이지만 의미는 완전히 다릅니다. Job이 한번 실행 될 때 JobInstance라는 실행 단위 인스턴스가 만들어집니다. JobExecution은 JobInstance에 대한 실행을 나타냅니다. 뭔가 설명이 막걸리스럽죠?
오늘 실행한 Job이 있다고 합시다. 위에서 설명한대로 JobInstance가 만들어지겠죠. 그런데 오늘 실행이 되어야 할 JobInstance가 예기치 못한 오류로 정상적으로 처리되지 않고 실패로 끝났습니다. 다음날 같은 시점에 Job이 실행될 때 어제 처리가 실패되었던 JobInstance는 그대로 끝나고 새로운 실행 단위인 JobInstance가 만들어질까요?
아닙니다. 한번 실패한 JobInstance는 그 다음날에도 그대로 실행됩니다.
그렇다면 그 JobInstance는 결과적으로 2번의 실행을 하게 되는 셈이죠. 그런데 만약 2번째 실행에도 실패했다? 그렇다면 그 다음날인 3번째 실행을 하게 되죠. 이렇게 1개의 JobInstance는 여러번의 실행을 가질 수 있습니다. 그리고 그 여러번의 실행 단위를 JobExecution이라고 하죠.
자 뭔가 구구절절하게 전달해 드린 것 같아 일단 스프링부트 배치 프레임워크에 대한 기본적인 설명은 이 정도로만 하고 이 내용을 토대로 직접 기본적인 스프링 부트 배치 프레임워크를 활용하여 실제 동작하는 배치 Job을 다음 포스팅에서 만들어 보겠습니다.
Reference
https://jojoldu.tistory.com/
https://ahndy84.tistory.com/18
스프링 배치를 이용해서 휴면 계정을 관리해보자
스프링 배치에 대한 전반적인 내용은 아래의 포스팅을 참고해주세요. 때문에 스프링 배치에서 사용되는 단어에 대한 설명은 생략합니다.
https://coding-review.tistory.com/172
스프링 배치를 이용해서 휴면 계정을 관리해 보겠습니다.
사용한 기술 스택
-Spring Boot 2.7.2
-Spring Data JPA
우선 Entity를 만들어 보겠습니다.
코드에 대해서 하나씩 설명하면서 진행하도록 하겠습니다.
Member.java
package com.capston.chatting.entity;
import com.capston.chatting.enums.MemberRole;
import com.capston.chatting.enums.MemberStatus;
import com.capston.chatting.enums.OTPApplyStatus;
import lombok.Getter;
import lombok.NoArgsConstructor;
import lombok.Setter;
import javax.persistence.*;
import java.time.LocalDateTime;
@Entity
@Getter
@NoArgsConstructor
public class Member extends BaseTime{
@Id @GeneratedValue(strategy = GenerationType.IDENTITY)
@Column(name = "member_id")
private Long id;
private String loginId;
private String loginPw;
private String name;
private int score;
@Enumerated(EnumType.STRING)
private MemberRole role;
@Enumerated(EnumType.STRING)
private MemberStatus status;
@Setter
private LocalDateTime updateDate;
public Member(String loginId, String loginPw, String name, int score, MemberRole role, MemberStatus status, LocalDateTime updateDate) {
this.loginId = loginId;
this.loginPw = loginPw;
this.name = name;
this.score = score;
this.role = role;
this.status = status;
this.updateDate = updateDate;
}
public Member setInactive() {
this.status = MemberStatus.INACTIVE;
return this;
}
}
BaseTime을 상속하고 있는데 이 부분에 대해서는
https://coding-review.tistory.com/173
해당 포스팅에 설명해놓았으니 위의 포스팅을 참고해주세요
Entity에 대한 설명은 굳이 안해도 될 것 같습니다. 맨 아래 setInactive 메서드는 1년이 지나서도 활동하지 않는 회원에 대해 MemberStatus를 ACTIVE에서 INACTIVE로 변경하기 위해서 만든 메서드입니다.
MemberStatus는 enum타입으로 ACTIVE, INACTIVE 두개의 값을 가지고 있습니다.
이제 가장 중요한 배치에 관련된 코드를 보겠습니다.
Job
@Bean
public Job inactiveMemberJob() {
log.info("InactiveMemberJob execution");
return jobBuilderFactory.get("inactiveMemberJob")
.start(inactiveJobStep())
.preventRestart()
.build();
}
우선 가장 먼저 보이는건 로그네요 Job이 실행됐을 때 실행됐다는 것을 보여주기 위한 로그입니다.
JobBuilderFactory.get()
다음은 JobBuilderFactory에서 .get은 Job의 이름을 지정해주고 앞으로 Job을 실행할 때 이 이름으로 쓰겠다~를 지정해주는 문법입니다.
start()
해당 Step을 사용하겠다는 의미입니다. Job은 여러개의 Step을 가질 수 있기 때문에 .next를 이용해서 다음 Step을 설정해줄 수 있습니다.
preventRestart()
이 설정을 넣은 Job은 재시작을 막습니다. 재시작을 막는다는 의미는 항상 새로운 Job을 실행한다는 의미입니다.
build()
Job을 실행하라는 의미입니다. 별다른 의미는 없습니다.
Step
다음은 Step입니다.
@Bean
public Step inactiveJobStep() {
log.info("InactiveMemberStep execution");
return stepBuilderFactory.get("inactiveMemberStep")
.<Member, Member>chunk(10)
.reader(inactiveMemberReader())
.processor(inactiveMemberProcessor())
.writer(inactiveMemberWriter())
.build();
}
로그는 무시하고 바로 넘어가겠습니다.
stepBuilderFactory.get()
StepBuilderFactory에서 StepBuilder를 만들고 Step을 생성하는데 이름을 inactiveMemberStep으로 하겠다. 앞으로 이 Step은 저 이름으로 사용하겠다. 라는 의미입니다.
<Member, Member> chunk(10)
앞선 포스팅을 보셨다면 chunk에 대해서 바로 이해하실겁니다. 하지만 앞선 포스팅을 보지 않으신 분들을 위해 간단하게 설명해드리겠습니다.
chunk는 간단하게 설명해서 트랜잭션 커밋을 이루는 단위입니다.
너무 대충 설명했나요?
트랜잭션은 트랜잭션의 특징(ACID) 중에 A에 해당하는 Atom 즉 원자성을 보장해야 합니다. 예를 들어서 10건의 데이터가 있으면 5건까지는 잘 되다가 6건째부터 갑자기 예외가 터져서 프로그램이 다운됐다. 그럼 5건의 데이터만 완료되고 나머지 5건의 데이터는 완료되지 않은 상황이 벌어집니다. 이건 꽤 큰일이죠
엥 그게 왜? 라고 하신다면 아직 트랜잭션에 대해 감이 없으신것입니다.
예를 들어서 10명의 사원에게 월급을 보내는 로직이라고 가정해봅시다. 자 사원 1부터 순서대로 10까지 300만원의 월급이 들어갑니다. 근데 5명의 월급은 정상적으로 들어갔는데 6번째에서 예외가 터져서 나머지 5명은 월급이 안들어갔습니다. 이때 우리는 어떻게 해야할까요?
1. 월급을 처음부터 다시 준다.
이 방법은 잘못됐습니다. 그렇게 되면 처음 받았던 5명은 월급을 또 받게 되니까요.
2. 못준 사람에게 월급을 준다.
이 방법도 좋은 방법은 아닐겁니다. 프로그램이 용빼는 재주가 있는 것도 아니고 받았는지 안받았는지 어떤 수로 알까요?
3. 월급 줬던 사람것을 다시 돌려받고 처음부터 다시 준다.
이 방법이 가장 현실적인 방법일 것입니다.
따라서 트랜잭션은 위의 세가지 방법 중에서 3번을 채택하고 있습니다.
자 이제 우리는 트랜잭션의 원자성에 대해서 간단하게 알아봤습니다. 그럼 chunk가 트랜잭션의 원자성을 보장하기 위한 단위라는 것도 아시겠죠.
하지만 chunk는 단순히 원자성을 보장해주는 정도의 수준이 아닙니다. chunk의 매력에 대해서 좀 더 설명해보겠습니다. 그리고 이 매력을 알게 되면 왜 스프링 배치가 대용량 데이터를 관리하는데에 특화됐다고 하는지 아실겁니다.
자 위의 예제는 큰 문제가 있습니다. 만약 10건이 아니라 100만건이라면 어떨까요? 100만건이라면 두가지 문제가 있습니다.
1. 100만건을 모두 메모리에 올린다
JVM이 버텨줄지 모르겠네요...
2. 중간에 끊기는 경우
100만건을 다 메모리에 올렸다고 가정해봅시다. 50만건까지는 잘 이행됐습니다. 하지만 50만1번째에서 예외가 터졌습니다. 그럼 50만건의 성공을 전부 롤백하고 다시 처음부터 시작해야합니다. 이는 다시 1번 문제로 돌아갑니다.
때문에 우리는 chunk를 이용해서 100만건이라면 chunk 사이즈를 1만건으로 잡아두고 50만건이 쭉쭉 성공하고 51만번째에서 예외가 터졌다면 chunk 사이즈인 1만건에 대해서만 롤백을 하면 됩니다. 이는 더 효율적이죠
때문에 위의 코드는 Processor에서 사용할 데이터 건수가 10건이라는 것을 의미합니다. 앞에 있는 <Member, Member>인 이유도 아시겠죠? Processor에서 사용할 Input과 Output이기 때문입니다.
reader(), processor(), writer()
이건 간단해보입니다. reader로 inactiveMemberReader()를, processor로 inactiveMemberProcessor를, writer로 inactiveMemberWriter를 사용하겠다는 의미입니다.
Reader
@Bean
public JpaCursorItemReader<Member> jpaCursorItemReader() {
Map<String, Object> map = new HashMap<>();
map.put("updateDate", LocalDateTime.now().minusYears(1));
map.put("status", MemberStatus.ACTIVE);
return new JpaCursorItemReaderBuilder<Member>()
.name("jpaCursorItemReader")
.entityManagerFactory(entityManagerFactory)
.queryString("select m from Member m where m.updateDate <= :updateDate and m.status = :status")
.parameterValues(map)
.build();
}
저는 JPA를 사용하고 있기 때문에 JpaCursorItemReader를 사용했습니다. ItemReader는 다양한 구현체를 갖고있으니 필요한 Reader를 사용하면 좋을 것 같습니다.
name()
해당 reader의 이름은 이것이다! 하고 선언해주는 메서드입니다.
entityManagerFactory()
JPQL을 실행하기 위한 EntityManagerFactory를 주입받아서 사용하면 됩니다.
queryString()
우리가 실행할 쿼리입니다. 해당 쿼리는 JPQL로 넘어가서 실행됩니다.
parameterValues()
JPQL의 각종 조건을 담아두는 메서드입니다. Map에 담아서 넘겨주면 자동으로 값을 꺼내와서 매칭시킵니다.
Processor
@Bean
public ItemProcessor<Member, Member> inactiveMemberProcessor() {
return new ItemProcessor<Member, Member>() {
@Override
public Member process(Member member) throws Exception {
log.info("InactiveMemberProcessor execution");
return member.setInactive();
}
};
}
Input과 Output을 정의하는 제네릭에 Member를 넣습니다. 우리는 Member에서 Member로 이동할거니까요.
이제 Entity에서 setInactive의 리턴타입을 Member로 했는지 이해되실겁니다. Processor에서 거쳐간 Member가 Writer에서도 사용되어야 하기 때문이죠
현재 저는 ItemProcessor를 Override해서 리턴하고 있습니다. 이 방법도 물론 좋은 방법이지만 ItemProcessor 인터페이스를 직접 까보면 메서드가 하나밖에 없는것을 알 수 있습니다.
메서드가 하나밖에 없다는 뜻은? 해당 메서드를 오버라이딩할 때 람다를 사용할 수 있다는 얘기입니다. 따라서 위의 코드는 이렇게 변경될 수 있습니다.
@Bean
public ItemProcessor<Member, Member> inactiveMemberProcessor() {
return member -> {
log.info("InactiveMemberProcessor execution");
return member.setInactive();
};
}
이렇게 하는게 좀 더 깔끔해보이겠죠? 하지만 람다에 익숙하지 않으신 분은 굳이 저렇게까지 쓰지 않아도 됩니다. 솔직히 저도 얼마전까지만 해도 람다의 사용에 대해 거부감을 느끼고 있었거든요. 람다가 가독성을 올려준다고 하는데 람다의 어디가 가독성을 올려준다는 것인지 이해하지 못했거든요. 지금은 아주 잘 사용하고 있지만 저도 처음엔 람다를 사용하지 않았습니다.
아무튼 람다가 편하신 분들은 위의 방법을 추천드립니다.
Writer
@Bean
public ItemWriter<Member> inactiveMemberWriter() {
log.info("InactiveMemberWriter execution");
return ((List<? extends Member> members) -> {
memberRepository.saveAll(members);
});
}
이제 Processor에서 가공한 데이터를 가지고 직접 데이터베이스에 넣어주는 작업인 ItemWriter입니다. Spring Data JPA에서 제공해주는 기본적인 메서드인 saveAll을 사용해서 데이터를 넣어주는 모습입니다.
전체적인 코드는 다음과 같습니다.
package com.capston.chatting.config.batch;
import com.capston.chatting.entity.Member;
import com.capston.chatting.enums.MemberStatus;
import com.capston.chatting.repository.MemberRepository;
import lombok.RequiredArgsConstructor;
import lombok.extern.slf4j.Slf4j;
import org.springframework.batch.core.Job;
import org.springframework.batch.core.Step;
import org.springframework.batch.core.configuration.annotation.JobBuilderFactory;
import org.springframework.batch.core.configuration.annotation.StepBuilderFactory;
import org.springframework.batch.core.configuration.annotation.StepScope;
import org.springframework.batch.item.ItemProcessor;
import org.springframework.batch.item.ItemWriter;
import org.springframework.batch.item.support.ListItemReader;
import org.springframework.beans.factory.annotation.Value;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
import org.springframework.stereotype.Component;
import java.time.LocalDateTime;
import java.util.List;
@Slf4j
@RequiredArgsConstructor
@Configuration
public class InactiveMemberJob {
private final MemberRepository memberRepository;
private final JobBuilderFactory jobBuilderFactory;
private final StepBuilderFactory stepBuilderFactory;
@Bean
public Job inactiveMemberJob() {
log.info("InactiveMemberJob execution");
return jobBuilderFactory.get("inactiveMemberJob")
.start(inactiveJobStep())
.preventRestart()
.build();
}
@Bean
public Step inactiveJobStep() {
log.info("InactiveMemberStep execution");
return stepBuilderFactory.get("inactiveMemberStep")
.<Member, Member>chunk(10)
.reader(inactiveMemberReader())
.processor(inactiveMemberProcessor())
.writer(inactiveMemberWriter())
.build();
}
@Bean
public JpaCursorItemReader<Member> jpaCursorItemReader() {
return new JpaCursorItemReaderBuilder<Member>()
.name("jpaCursorItemReader")
.entityManagerFactory(entityManagerFactory)
.queryString("select m from Member m")
.build();
}
@Bean
public ItemProcessor<Member, Member> inactiveMemberProcessor() {
ItemProcessor<Member, Member> memberItemProcessor = (member) -> {
log.info("InactiveMemberProcessor execution");
return member.setInactive();
};
return memberItemProcessor;
// return member -> {
// log.info("InactiveMemberProcessor 작동");
// return member.setInactive();
// };
}
@Bean
public ItemWriter<Member> inactiveMemberWriter() {
log.info("InactiveMemberWriter execution");
return ((List<? extends Member> members) -> {
memberRepository.saveAll(members);
});
}
}
이제 실행해보면 잘 실행되는 것을 알 수 있습니다.
하지만 한가지 궁금합니다. Reader -> Processor -> Writer로 이어지는 이 하나의 로테이션에서 스프링 배치는 어떻게 데이터를 이동시킬까요? 우리가 평소에 사용하는 방법은 메서드안에 파라미터를 넣어서 데이터를 전달합니다. 근데 배치에서는 아무데도 파라미터가 안보이는데요?
그런 의문을 가진 당신! 정말 예리하시군요. 코드를 그냥 주어진대로 보는 것이 아니라 그런 의문을 품는다는 것 자체가 높게 평가할만 합니다.
해당 질문을 여기서 설명하기엔 지금도 스크롤 압박이 살짝 있으니 관련해서 스택오버플로우에 올려져있는 질문을 링크해드리겠습니다.
https://stackoverflow.com/questions/48092171/how-data-is-passed-from-reader-to-processor-and-to-writer/48694672#48694672
이제 포스팅은 마치겠습니다. 긴 글 읽어주시느라 고생 많으셨습니다. 다음 포스팅엔 스프링 배치 + 스케줄러를 이용해서 특정 시간이 되면 배치를 실행시키는 작업을 진행해보도록 하겠습니다. 감사합니다.
CF)
근데 잠시만요!
Job, Step, Reader, Writer 의 로그는 다 찍혔는데 Processor의 로그는 안찍혔는데요? 라고 하시는 분들!
혹시 저같은 분이 있을까봐 알려드립니다. 해당 질문은 저도 답답해서 직접 올렸던 스택 오버플로우 질문의 링크를 첨부해 드리겠습니다.
https://stackoverflow.com/questions/73434102/spring-batch-return-is-not-working-so-logs-and-another-code-does-not-working
영어가 약하신 분들을 위해 간단하게 설명해드리자면
According to the log message Step already complete or not restartable, so no action to execute, your step does not seem to be executed. So probably that is the reason you are not seeing your log message.
You can set allowStartIfComplete to true on your step and that should work.
로그 메세지에 따르면 Step은 이미 완료되었거나 재시작할 수 없는 상태입니다. 그래서 아무런 실행에 대한 액션이 없는 것이지요. 당신의 Step은 실행자체가 된것 같지 않습니다. 그러니 아마 이러한 이유때문에 로그가 찍히지 않은 것 같은데요. Step의 속성중에 allowStartIfComplete를 true 로 줘보시겠어요?
라는 뜻입니다.
따라서 저 답변대로 Step에 있는 속성중에 allowStartIfComplete를 true로 주면 됩니다.
@Bean
public Step inactiveJobStep() {
log.info("InactiveMemberStep execution");
return stepBuilderFactory.get("inactiveMemberStep")
.<Member, Member>chunk(10)
.reader(inactiveMemberReader())
.processor(inactiveMemberProcessor())
.writer(inactiveMemberWriter())
.allowStartIfComplete(true)
.build();
}
스프링 배치 + 스케줄러를 이용해 나만의 배치만들어보기
저번 포스팅과 이어지는 내용입니다.
https://coding-review.tistory.com/177
때문에 배치와 관련된 코드는 생략하도록 하겠습니다.
스프링 배치 vs 스케줄러
배치에 대해 잘 알고계시지 못하는 분이 배치와 스케줄러를 같다고 생각하십니다. 하지만 둘은 엄연히 다른 존재입니다. 스프링 배치는 대용량 데이터를 단발성으로 처리해야 하는 경우에 사용하는 프레임워크입니다. 스케줄러는 내가 원하는 타이밍에 원하는 메서드를 실행시킬 수 있는 라이브러리입니다.
자 이제 한번 시작해보도록 하겠습니다.
우선 스케줄러에도 다양한 라이브러리가 있습니다. 대표적으로는 Quartz가 있죠. 하지만 스프링에서는 강력한 스케줄러를 제공합니다. 바로 어노테이션을 이용한 스케줄링인데요. 스프링 안에 내장되어있기 때문에 따로 라이브러리를 설정하지 않아도 되는 편리함도 있습니다.
본격적으로 시작하기에 앞서 우리는 크론(cron)표현식 이라는 것을 알아야 합니다.
크론 표현식이 뭐냐? 내가 원하는 시간을 특정한 문자를 통해 나타낼 수 있는 표현식입니다. 그런데 표현식 표현식 하니까 어디서 들어본 것도 같습니다.
맞습니다. 바로 정규 표현식입니다. 즉, 크론 표현식은 정규 표현식처럼 문자열을 이용해 특정 패턴을 표현한 것이라고 생각해주시면 되겠습니다. 크론 표현식은 정규 표현식에 포함되어 있습니다. 따라서 크게 보면 크론 표현식도 정규 표현식이죠. 하지만 크론 표현식이라는 정규 표현식 중에서도 따로 이름을 가진 표현식 입니다.
자 그럼 크론 표현식에 대해서 간단하게 알아보고 넘어가도록 하겠습니다.
크론 표현식
크론 표현식은 7개의 필드와 숫자 그리고 특수문자로 이루어져 있습니다. 7개의 필드는 다음과 같습니다.
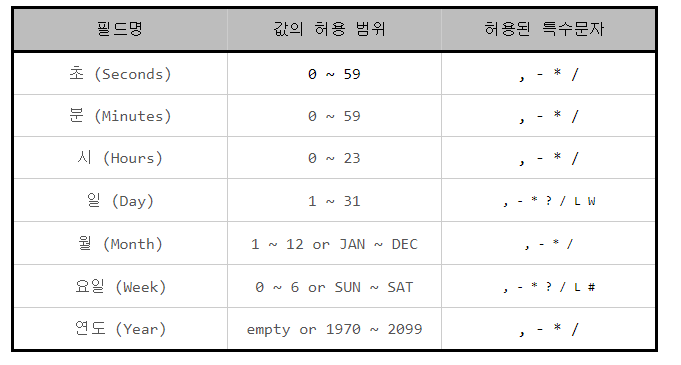
필드에 대해서는 알아봤고 이제 크론 표현식에서 사용가능한 특수문자에 대해서 알아보겠습니다.
• * : 모든 값을 뜻합니다.
• ? : 특정 한 값이 없음을 뜻합니다. (*와 비슷한 느낌입니다.)
• - (하이폰) : 범위를 뜻합니다. 예를 들어서 월요일에서 수요일까지는 MON-WED로 표현합니다.
• , (콤마) : 특별한 값일 때만 동작합니다. 예를 들어서 MON,WED,FRI 로 표현합니다.
• / : (시작시간) / (단위) 예를 들어서 0분부터 매5분마다는 0/5 로 표현합니다.
• L : 일에서 사용하면 마지막 일, 요일에서는 마지막 요일(토요일)을 나타냅니다.
• W : 가장 가까운 평일 예를 들어서 15W는 15일에서 가장 가까운 평일 (월~금) 을 나타냅니다.
• # : 몇째주의 무슨 요일을 표현합니다. 예를 들어서 3#2는 2번째주 수요일입니다.
이제 필드와 특수문자에 대해서 알아봤습니다. 그럼 크론 표현식이 대충 어떻게 생겼는지 알아보겠습니다.
"0 0 0 0 0 0 0" 맨 처음부터 초 / 분 / 시 / 일 / 월 / 요일 / 년 이렇게 일곱개로 구성되어 있습니다.
어떻게 구성해야 할지 되게 막막하실겁니다. 특수문자중에서 가장 많이 쓰이는 것만 알아두시면 됩니다. 저는 여태까지 크론 표현식에서 *, - (하이폰), / 이렇게 세개 말고는 안써봤습니다. 저기서도 하이폰과 별표는 많이 안쓰이고 압도적으로 많이 쓰이는건 / (슬래쉬) 입니다.
cf) * (에스터리크 / 별) 참고로 이 별표는 정식명칭이 에스터리크입니다. 다른 특수문자들도 다 이름이 있습니다만 제일 많이 쓰이는 특수문자이기 때문에 알고계시면 어디가서 아는척 할 수 있습니다. (저도 저거 하나밖에 몰라요 ㅎㅎ..)
* 별표는 '모든' 을 뜻합니다. 즉 초 자리에 *를 찍는다면 '매초마다' 라고 해석할 수 있는것이지요
ex) 매초마다 = "* 0 0 0 0 0 0"
/ (슬래쉬) 는 시작 시간과 단위를 적으면 특정 시간마다라고 표현할 수 있습니다. * (별표) 의 상위 버전인 것이죠. 즉, '10분마다' 라고 표현하고 싶다면 0/10 이라고 적으면 됩니다. 굳이 해석하자면 0분부터 10분마다 이겠죠
자 이제 크론 표현식에 대해서 알았으니 본격적으로 들어가보도록 하겠습니다.
우선 배치를 시작하기 위해서는 JobLauncher라는 것을 알아야합니다. JobLauncher는 JobInstance와 JobExecution을 생성해서 Job을 직접적으로 실행할 수 있는 객체입니다.
JobInstance와 JobExecution에 대해서는 저번 포스팅에서 설명해두었으니 혹시 이 부분을 모르시는 분들은 저번 포스팅을 확인해주세요.
https://coding-review.tistory.com/172?category=1063479
그럼 코드를 보겠습니다.
package com.capston.chatting.service.scheduler;
import com.capston.chatting.config.batch.InactiveMemberJob;
import com.capston.chatting.entity.Member;
import com.capston.chatting.enums.MemberStatus;
import com.capston.chatting.repository.MemberRepository;
import lombok.RequiredArgsConstructor;
import lombok.extern.slf4j.Slf4j;
import org.springframework.batch.core.*;
import org.springframework.batch.core.explore.JobExplorer;
import org.springframework.batch.core.launch.JobLauncher;
import org.springframework.scheduling.annotation.Scheduled;
import org.springframework.stereotype.Service;
import java.time.LocalDateTime;
import java.util.List;
import java.util.stream.Collectors;
@Service
@RequiredArgsConstructor
@Slf4j
public class ScheduleService {
private final InactiveMemberJob config;
private final JobLauncher jobLauncher;
private final MemberRepository memberRepository;
@Scheduled(cron = "0/5 * * * * *")
public void runInactiveMemberScheduler() {
try {
jobLauncher.run(config.inactiveMemberJob(), new JobParameters());
} catch(Exception e) {
log.error(e.getMessage());
}
}
}
이렇게 만들면 끝입니다. 우리가 만들었던 InactiveMemberJob을 주입받고 JobLauncher도 주입받습니다. 그리고 JobLauncher 안에 있는 run 메서드를 실행해주는데 파라미터로 Job, JobParameters를 넘겨주면 됩니다.
그리고 시작해보면 5초마다 해당 메서드가 실행되는 것을 알 수 있습니다.
근데... 뭔가 이상합니다?
2022-08-25 02:12:25.352 INFO 13104 --- [MessageBroker-3] o.s.b.c.l.support.SimpleJobLauncher : Job: [SimpleJob: [name=inactiveMemberJob]] launched with the following parameters: [{}]
2022-08-25 02:12:25.597 INFO 13104 --- [MessageBroker-3] o.s.batch.core.job.SimpleStepHandler : Executing step: [inactiveMemberStep]
2022-08-25 02:12:25.797 INFO 13104 --- [MessageBroker-3] o.s.batch.core.step.AbstractStep : Step: [inactiveMemberStep] executed in 200ms
2022-08-25 02:12:25.960 INFO 13104 --- [MessageBroker-3] o.s.b.c.l.support.SimpleJobLauncher : Job: [SimpleJob: [name=inactiveMemberJob]] completed with the following parameters: the following status: [COMPLETED] in 545ms
우리가 Job에 적었던 InactiveMemberJob execution 이라던가 Step에 적었던 InactiveMemberStep execution로그가 안보입니다. 그리고 Reader에 분명 쿼리가 보여야하는데 쿼리가 안보입니다.
뭐지? Job이 실행이 안된건가?
Job은 내부적으로 돌아가고 있습니다. 때문에 안심하셔도 될 것 같네요. 단지 @Bean으로 등록된 메서드에 적혀있는 로그들은 Bean이 초기화 될 때 한번만 생성되므로 우리가 적은 로그들은 보이지 않을 것입니다.
해당 문제에 대한 스택오버플로우에 제가 올린 질문이 있으니 궁금하신 분들은 한번 보시는것도 좋을 것 같습니다.
https://stackoverflow.com/questions/73450739/spring-batch-when-i-run-using-joblauncher-i-think-the-job-is-not-running/73454379?noredirect=1#comment129731886_73454379
다음 포스팅에서는 JobInstance와 JobParameter에 대해서 포스팅하도록 하겠습니다.
스프링 배치 JobParameter
JobParameter란?
우선 JobParameter에 대해 알아보자면, 스프링 문서에는 이렇게 나와있습니다..
https://docs.spring.io/spring-batch/docs/current/reference/html/domain.html#jobparameters
"Having discussed JobInstance and how it differs from Job, the natural question to ask is: "How is one JobInstance distinguished from another?" The answer is: JobParameters. A JobParameters object holds a set of parameters used to start a batch job. They can be used for identification or even as reference data during the run"
해석하면 이렇습니다.
"Job을 어떻게 구분할까? 이 질문은 즉 이런 의미이다. 어떻게 JobInstance를 다른 JobInstance와 구분할까? 그에 대한 답은 바로 JobParameter이다. JobParameters 객체는 배치 Job을 실행하기 위해 사용되는 파라미터이다. JobParameter는 실행되는 도중에 reference를 식별하기 위해 사용한다."
즉 JobParameter는 JobInstance를 구별하기 위한 파라미터라는 것인데요.
JobInstance를 구별한다는 것은 무슨 의미일까요?

위의 코드는 JobLauncher의 run 메서드중 일부입니다. JobExecution을 선언한 뒤에 jobRepository에서 마지막으로 실행된 JobExecution을 찾아서 lastExecution에 저장하죠. 그리고 null인지 null이 아닌지를 판별해서 각각의 로직을 수행합니다.
null이라는 의미는 해당 Job과 JobParameter를 가진 JobExecution이 없다는 의미겠죠. null인 경우에는 새로운 JobExecution을 만들어서 새로 실행한다는 의미입니다.
근데 지금 JobInstance 얘기하고 있는거 아니었나요? 갑자기 JobExecution이 왜나오나요?
우리는 이를 이해하기 위해선 JobInstance와 JobExecution에 대해 이해해야 합니다.
제 스프링 배치 첫번째 포스팅에서 이에 대해 간단하게 나와있습니다.
두 단어가 비슷해 보이지만 의미는 완전히 다릅니다. Job이 한번 실행 될 때 JobInstance라는 실행 단위 인스턴스가 만들어집니다. JobExecution은 JobInstance에 대한 실행을 나타냅니다. 뭔가 설명이 막걸리스럽죠?
오늘 실행한 Job이 있다고 합시다. 위에서 설명한대로 JobInstance가 만들어지겠죠. 그런데 오늘 실행이 되어야 할 JobInstance가 예기치 못한 오류로 정상적으로 처리되지 않고 실패로 끝났습니다. 다음날 같은 시점에 Job이 실행될 때 어제 처리가 실패되었던 JobInstance는 그대로 끝나고 새로운 실행 단위인 JobInstance가 만들어질까요?
아닙니다. 한번 실패한 JobInstance는 그 다음날에도 그대로 실행됩니다.
그렇다면 그 JobInstance는 결과적으로 2번의 실행을 하게 되는 셈이죠. 그런데 만약 2번째 실행에도 실패했다? 그렇다면 그 다음날인 3번째 실행을 하게 되죠. 이렇게 1개의 JobInstance는 여러번의 실행을 가질 수 있습니다. 그리고 그 여러번의 실행 단위를 JobExecution이라고 하죠.
뭔가 이해하기 조금 까다로울것으로 예상하는데요.
즉 알기쉽게 설명하자면 이런 것입니다. 우리는 JobParameter로 JobInstance를 구별할 수 있다고 했는데요. 그 이야기는 JobParameter가 같으면 같은 JobInstance라는 의미입니다.
여기까진 이해하셨죠?
그렇다면 다른 JobParameter인 경우엔 어떨까요? 확실히 이번엔 JobInstance가 다르겠죠? 하지만 JobExecution은 어떨까요? JobExecution은 같은 JobParamter이던 다른 JobParameter이던 상관없이 새로운 객체가 생성됩니다.
그러니까 즉 JobExecution은 실행될 때마다 새로 생성된다는 것입니다.
이를 달리 말하면 어떤 의미가 될까요? JobInstance가 JobExecution을 포함하고 있다. 라고 해석할 수도 있는 것입니다.
스프링 공식 문서에도 이를 명시하고 있습니다.
Therefore, each JobInstance can have multiple executions ...중략
해석하면 다음과 같습니다. "그러므로 JobInstance는 많은 execution을 가질 수 있다."
이제 JobInstance와 JobExecution에 대해서 이해하셨다면 다시 JobParameter로 넘어오겠습니다.
그럼 JobParameter가 다르던 말던 JobExecution은 새로 생성된다는 거잖아요? 그런데 왜 null인지 null이 아닌지를 체크하는것이죠?
이에 대한 대답은 아주 간단합니다.
JobExecution의 중복을 확인했을 때 중복인 경우 물을 필요도 없이 JobInstance가 같은 JobInstance이기 때문에 execution 만 확인하면 된다는 것이죠
이제 알겠어요! 그래도 난 항상 새로운 JobInsatnce를 생성해서 배치를 돌리고싶어요! 라고 하신다면
방법이 두가지입니다.
1. JobParameter로 시간값을 넣는다.
2. RunIdIncrementer를 사용한다.
1. JobParameter로 시간값을 넣는다.
JobLauncher로 Job을 실행할 때 JobParametersBuilder를 이용해서 JobParameter에 현재 시간을 계속 집어넣어 주는것이지요
@Service
@RequiredArgsConstructor
@Slf4j
public class ScheduleService {
private final JobLauncher jobLauncher;
private final JobExplorer jobExplorer;
private final Job inactiveMemberJob;
// @Scheduled(cron = "0/5 0 0 0 0 0 0")
public void runInactiveMemberScheduler() {
try {
jobLauncher.run(
inactiveMemberJob, new JobParametersBuilder(jobExplorer)
.getNextJobParameters(inactiveMemberJob)
.addString("requestDate", LocalDateTime.now().toString())
.addString("test", "Test")
.toJobParameters()
);
} catch(Exception e) {
log.error(e.getMessage());
throw new WhyHappenedException(e.getMessage(), e.getCause());
}
}
}
JobParameterBuilder에 JobExplorer를 주입받아서 사용하면 됩니다. 이렇게 하고 실행되는 JobParameter를 확인해보면 항상 다른 값이 들어가있는 것을 확인할 수 있습니다.
2. RunIdIncrementer를 사용한다.
우리는 JobBuilderFactory를 이용해서 Job을 만들었습니다. 그리고 그 Job의 속성중에는 incrementer라는 속성이 있습니다. 우리는 이 incrementer에 RunIdIncrementer를 주입해서 사용하면 됩니다.
@Bean
public Job inactiveMemberJob() {
log.info("InactiveMemberJob execution");
return jobBuilderFactory.get("inactiveMemberJob")
.start(inactiveJobStep())
.preventRestart()
.incrementer(new RunIdIncrementer())
.build();
}
저도 그냥 간단하게 RunIdIncrementer를 사용하라고 하고 싶지만 RunIdIncrementer에는 버그가 몇개 있는데요
우선 스프링 부트 2.1.0 이전에는 배치 Job이 실패할 경우 이후에 파라미터를 변경해도 계속 실패한 파라미터가 사용되는 버그가 있었습니다.
하지만 2.1.0 이후에 이 버그는 픽스됐습니다. 하지만 다른 버그가 남아있죠.
바로 이전 Job이 실행시 사용한 파라미터 중 하나가 다음 실행시 누락되면 누락된 파라미터를 재사용한다는 것인데요.
때문에 RunIdIncrementer를 사용하기 보다는 Custom RunIdIncrementer를 사용하는걸 추천합니다.
바로 이렇게 하면 됩니다.
@Slf4j
public class UniqueRunIdIncrementer extends RunIdIncrementer {
private static final String RUN_ID = "run.id";
private static final Long DEFAULT_VALUE = 0L;
private static final Long INCREMENT_VALUE = 1L;
@Override
public JobParameters getNext(JobParameters parameters) {
JobParameters params = (parameters == null) ? new JobParameters() : parameters;
log.info("GetNext");
return new JobParametersBuilder()
.addLong(RUN_ID, params.getLong(RUN_ID, DEFAULT_VALUE) + INCREMENT_VALUE)
.toJobParameters();
}
}
이렇게 커스텀 클래스를 만들어주고
@Bean
public Job inactiveMemberJob() {
log.info("InactiveMemberJob execution");
return jobBuilderFactory.get("inactiveMemberJob")
.start(inactiveJobStep())
.preventRestart()
.incrementer(new UniqueRunIdIncrementer())
.build();
}
이렇게 설정해주면 끝!
이렇게 할 경우 JobParameter로 run.id라는 값이 실행할때마다 하나씩 올려주기 때문에 다른 JobInstance라는것을 보장받을 수 있죠. 이는 JobParameter로 시간값을 넣는 것과 비슷합니다.
이상으로 JobParameter에 대해 알아봤습니다. 도움이 되셨을지 모르겠네요 다음 포스팅에서는 ItemReader에 대해서 자세히 알아보도록 하겠습니다.
Reference
https://docs.spring.io/spring-batch/docs/current/reference/html/domain.html#domainLanguageOfBatch
스프링 배치 CursorItemReader vs PagingItemReader
스프링 배치에서는 각기 다양한 ItemReader를 제공하는데 그 중 CursorItemReader 와 PagingItemReader는 언뜻 보기에 비슷해 보이고 실제로도 하는 일이 비슷합니다.
그래서 이번 포스팅에선 이 둘의 차이점에 대해 탐구해보는 시간을 가져보도록 하겠습니다.
ItemReader
우선 ItemReader에 대해서 짚고 넘어가야 할 것 같습니다.
ItemReader란 뭘까요?
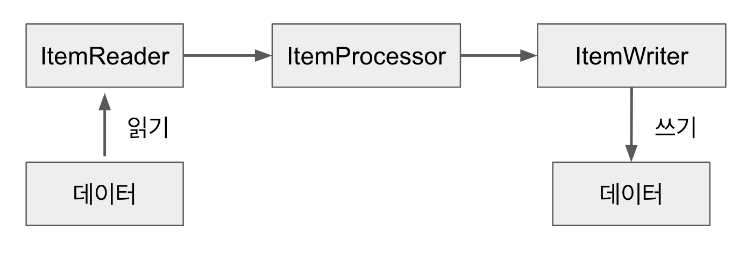
스프링 배치의 ItemReader는 데이터를 읽어들이는 일을 합니다. 그게 꼭 DB의 데이터만을 얘기하진 않습니다. File, XML, JSON 등 다른 데이터 소스를 배치 처리의 입력으로 사용할 수 있습니다.
이외에도 Spring Batch에서 지원하지 않는 Reader가 필요한 경우 직접 해당 Reader를 만들 수 있습니다. Spring Batch는 이를 위해 Custom Reader 구현체를 만들기 쉽게 제공하고 있습니다.
대표적인 구현체로 JdbcPagingItemReader가 있는데요. 해당 ItemReader의 관계도에 대해 먼저 알아보겠습니다. 관계도를 보시면 오늘의 문제에 대한 답이 어느정도 나옵니다!
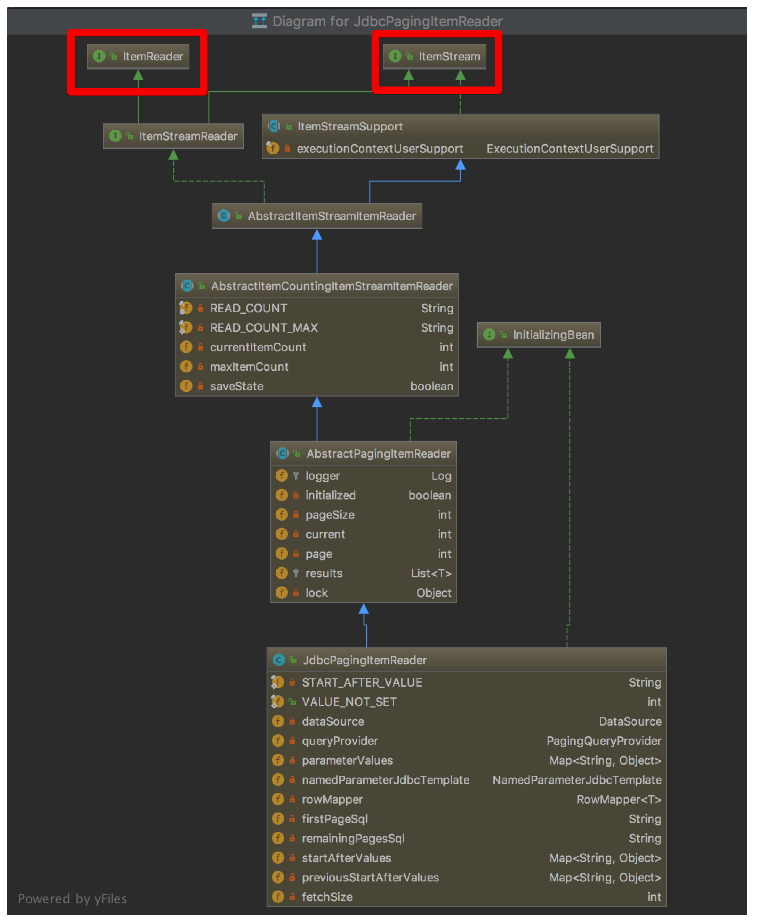
보시면 최 상위 인터페이스에 ItemReader, ItemStream이 있는 것을 확인할 수 있는데요.
각각을 살펴보도록 하겠습니다.
ItemReader를 살펴보면 read()만 가지고 있습니다. read()의 경우 데이터를 읽어오는 메서드입니다.
그럼 ItemStream은 무슨 역할을 할까요?
ItemStream 인터페이스는 주기적으로 상태를 저장하고 오류가 발생하면 해당 상태에서 복원하기 위한 마커 인터페이스입니다. 이렇게 말하면 역시 이해하기 힘들겠죠
즉 ItemStream은 ItemReader의 상태를 저장하고 실패한 곳에서 다시 시작할 수 있게 해주는 역할을 합니다. 쉽게 생각해서 데이터베이스와 애플리케이션 사이에 통로를 하나 연결하고 하나씩 빨아들인다고 생각하면 됩니다.
JSP나 Servlet으로 게시판을 작성할 때 ResultSet을 사용해서 next()로 하나씩 데이터를 가져왔던 것을 생각하시면 됩니다.
ItemReader에 대해서 더 자세히 알고 싶으신 분들은 향로(jojoldu)님 블로그에 가시면 자세한 내용을 만나보실 수 있습니다.
https://jojoldu.tistory.com/336
그럼 이제 본론으로 들어가볼까요?
제가 이 ItemStream과 ItemReader에 대해서 왜 얘기를 꺼냈을까요? 어느정도 눈치가 빠르신 분들은 눈치채셨을겁니다. 바로 CursorItemReader와 PagingItemReader가 각각 ItemStreamReader, ItemReader이기 때문인데요.
공식문서에서는 이를 어떻게 표현하고 있을지 궁금해서 공식문서를 찾아봤습니다.
https://docs.spring.io/spring-batch/docs/current/reference/html/readersAndWriters.html#databaseReaders
해석하면 이정도로 해석할 수 있습니다.
"HibernateCursorItemReader는 하이버네이트의 상단에 위치한 데이터베이스 기록을 읽는 ItemStreamReader이다. 이것은 HQL쿼리로 실행되고 시작될 때 read()메서드가 호출되면서 결과들이 반복자를 통해 현재 행에 해당하는 개체를 순차적으로 반환한다. 스프링 배치는 HibernateCursorItemReader인스턴스를 생성하기 위한 HibernateCursorItemReaderBuilder를 제공한다"
이것도 해석하면 이런 내용입니다.
"HibernatePagingItemReader는 하이버네이트의 상단에 위치한 데이터베이스 기록을 읽는 ItemReader이다. 그리고 한번에 아이템의 숫자를 고정해서 읽어온다. 스프링 배치는 HibernatePagingItemReader인스턴스를 생성하기 위한 HibernatePagingItemReaderBuilder를 제공한다."
둘의 내용을 봤을 때 CursorItemReader와 PagingItemReader에 대해서 다른 내용은 CursorItemReader는 반복자를 통해 현재 행에 해당하는 개체를 "순차적으로" 반환한다. PagingItemReader는 "한번에" 아이템의 숫자를 고정해서 읽어온다.
이제 둘의 차이에 대해 아시겠죠?
둘의 차이점에 대해 더 자세한 궁금증을 가진 외국인 질문자가 스택오버플로우에 남긴 질문을 보시죠.
https://stackoverflow.com/questions/20386642/spring-batch-which-itemreader-implementation-to-use-for-high-volume-low-laten
질문자의 질문은 이렇습니다.
"ItemReader의 구현체 중에서 JdbcCursorItemReader와 JdbcPagingItemReader중에 어떤 것을 추천하나요? 그리고 그 이유는 뭔가요?"
뒤이은 질문은 이렇습니다.
"둘 중 사용했을 때 성능상 더 빠른건 뭔가요?"
첫번째 질문에 대한 답변은 이렇습니다.
It really depends on the database you're using, driver options available as well as processing models you can support. Another consideration is, do you need restartability?
해석하면 대충 이런 내용입니다. "그 둘의 선택은 네가 무슨 데이터베이스를 쓰는지 어떤 드라이버 옵션을 가지고 있는지에 따라 다르다."
두번째 질문에 대한 답은 이렇습니다.
"Again it depends on your processing model chosen."
"이 질문 역시 네가 선택한 수행 모델에 따라 다르다"
왜 수행 모델에 따라 다르다고 했을까요? 이제 본격적으로 둘의 차이점에 대해 알아보도록 하겠습니다.
ItemCursorReader
ItemCursorReader는 기본적으로 JDBC ResultSet 의 기본 매커니즘을 사용합니다.
현재 행에 커서를 유지하며 다음 데이터를 호출하면 다음 행으로 커서를 이동하며 데이터 반환이 이루어지는 Streaming 방식의 I/O 입니다.
ResultSet이 open 될 때마다 next() 메서드가 호출 되어 DB의 데이터가 반환되고 객체와 매핑이 이루어집니다.
DB Connection이 연결되면 배치 처리가 완료될 때까지 데이터를 읽어오기 때문에 DB와 SocketTimeout을 충분히 큰 값으로 설정할 필요가 있습니다.
모든 결과를 메모리에 할당하기 대문에 메모리 사용햘잉 많아지는 단점이 있습니다. 하지만 Connection 연결 유지 시간과 메모리 공간이 충분하다면 대량의 데이터 처리에 적합할 수 있습니다.
ItemPagingReader
ItemPagingReader는 페이징 단위로 데이터를 조회하는 방식으로 Page Size만큼 한번에 메모리로 가지고 온 다음 한 개씩 읽습니다.
한 페이지를 읽을 때마다 Connection을 맺고 끊기 때문에 대량의 데이터를 처리하더라도 SocketTimeout 예외가 거의 일어나지 않습니다.
시작 행 번호를 지정하고 페이지에 반환시키고자 하는 행의 수를 지정한 후 사용합니다. (Offset, Limit 사용)
페이징 단위의 결과만 메모리에 할당하기 때문에 메모리 사용량이 적어지는 장점이 있습니다. 따라서 Connection 연결 유지 시간이 길지 않고 메모리 공간을 효율적으로 사용해야 하는 데이터 처리에 적합할 수 있습니다.
이렇게 ItemCursorReader와 ItemPagingReader에 대해서 알아봤습니다. 둘의 차이에 대해서 확실히 이해 하셨나요? 긴 글 읽어주셔서 감사합니다. 다음 포스팅에서 뵐게요~
Reference
https://jojoldu.tistory.com/336
https://docs.spring.io/spring-batch/docs/current/reference/html/readersAndWriters.html#databaseReaders
https://stackoverflow.com/questions/20386642/spring-batch-which-itemreader-implementation-to-use-for-high-volume-low-laten
스프링 배치와 Querydsl
서론
요즘 배치에 대해서 깊이있게 공부중입니다.
하지만 한가지 아쉬운 점이 있더라구요. 바로 JPA를 사용하면 배치에서 기본으로 제공해주는 JpaCursorItemReader, JpaPagingItemReader가 순수 JPQL을 사용해야 한다는 것이었습니다.
아시다시피 순수 JPQL은 문자열로 쿼리를 만들기 때문에 안전성 부분에서 큰 부담이 됩니다. 흔히 말하는 휴먼 에러를 피할 수 없습니다. 순간 잘못해서 공백을 한칸 더 추가한다거나 혹은 오타가 나기 시작하면 어디서 틀렸는지 찾기도 만만치않게 힘들죠
그래서 아 Querydsl에 관련된 ItemReader가 있으면 정말 좋겠다 라는 생각을 하고 있었습니다. 그래서 혹시 있을까 싶어서 구글링을 해봤는데 우아한형제들 기술블로그에 향로(jojoldu)님이 작성하신 QuerydslPagingItemReader에 대한 포스팅을 발견했습니다.
도입부부터 너무 감명받아서 길이가 좀 되는 포스팅을 두세번씩 읽었습니다. 그리고 실제 프로젝트에 적용하기 위해서 굉장히 여러번 봤습니다.
너무 감명깊어서 블로그에 포스팅을 옮기려는데 솔직히 해당 포스팅의 길이가 상당합니다. 그래서 제 포스팅을 보시는 분들은 압축해서 알려드리기 위해서 해당 포스팅을 정리해보았습니다. 우아한형제들 기술블로그에 포스팅된 게시글은 Reference 부분에서 링크를 적어놓도록 하겠습니다. 그럼 이제 본격적으로 시작해보겠습니다.
QuerydslPagingItemReader
Querydsl은 단순 JPQL에서보다 복잡한 쿼리를 사용할 때 용이합니다. 여러개의 join과 복잡한 order by, group by를 Native Query로 만들기엔 다소 무리가 있기 때문에 Querydsl은 JPA를 사용한다면 복잡한 쿼리에서 많이 사용합니다.
하지만 Querydsl을 사용함에 있어서 한가지 문제가 있는데요, 바로 스프링 배치에서는 QuerydsPagingItemReader를 제공하지 않는다는 것입니다.
스프링 배치에서 JpaPagingItemReader와 Querydsl을 함께 사용하기란 정말 복잡한 문제가 뒤따랐습니다.
물론 Querydsl을 포기하고 JpaPagingItemReader를 이용해도 되지만 그렇게 되면 Querydsl의 타입 안전성, 자동완성, 컴파일 단계 문법 체크, 공백 이슈 대응을 지원받을 수 없습니다. 더군다나 페이징 성능 향상을 위한 Offset이 제거된 페이징 처리는 JpaPagingItemReader에서도 불가능하여 매번 별도의 Reader를 만들 수 밖에 없었습니다.
그래서 QuerydslPagingItemReader를 만들게 되었습니다.
QuerydslPagingItemReader의 컨셉은 아주 단순합니다. JpaPagingItemReader에서 JPQL이 수행되는 부분만 교체하는 것입니다.
JPQL이 수행되는 부분은 어딜까요? 기본적인 chunk 지향구조에서 doReadPage() 메서드에서 수행됩니다.
그래서 해당 부분에 createQuery() 부분을 오버라이딩 하려고 봤더니 private여서 확장할 수 없게 되었습니다. 그래서 JpaPagingItemReader를 전부 복사해서 구현할 수 밖에 없었습니다.
public class QuerydslPagingItemReader<T> extends AbstractPagingItemReader<T> {
protected final Map<String, Object> jpaPropertyMap = new HashMap<>();
protected EntityManagerFactory entityManagerFactory;
protected EntityManager entityManager;
protected Function<JPAQueryFactory, JPAQuery<T>> queryFunction;
protected boolean transacted = true;//default value
protected QuerydslPagingItemReader() {
setName(ClassUtils.getShortName(QuerydslPagingItemReader.class));
}
public QuerydslPagingItemReader(EntityManagerFactory entityManagerFactory,
int pageSize,
Function<JPAQueryFactory, JPAQuery<T>> queryFunction) {
this();
this.entityManagerFactory = entityManagerFactory;
this.queryFunction = queryFunction;
setPageSize(pageSize);
}
public void setTransacted(boolean transacted) {
this.transacted = transacted;
}
@Override
protected void doOpen() throws Exception {
super.doOpen();
entityManager = entityManagerFactory.createEntityManager(jpaPropertyMap);
if (entityManager == null) {
throw new DataAccessResourceFailureException("Unable to obtain an EntityManager");
}
}
@Override
@SuppressWarnings("unchecked")
protected void doReadPage() {
clearIfTransacted();
JPAQuery<T> query = createQuery()
.offset(getPage() * getPageSize())
.limit(getPageSize());
initResults();
fetchQuery(query);
}
protected void clearIfTransacted() {
if (transacted) {
entityManager.clear();
}
}
protected JPAQuery<T> createQuery() {
JPAQueryFactory queryFactory = new JPAQueryFactory(entityManager);
return queryFunction.apply(queryFactory);
}
protected void initResults() {
if (CollectionUtils.isEmpty(results)) {
results = new CopyOnWriteArrayList<>();
} else {
results.clear();
}
}
protected void fetchQuery(JPAQuery<T> query) {
if (!transacted) {
List<T> queryResult = query.fetch();
for (T entity : queryResult) {
entityManager.detach(entity);
results.add(entity);
}
} else {
results.addAll(query.fetch());
}
}
@Override
protected void doJumpToPage(int itemIndex) {
}
@Override
protected void doClose() throws Exception {
entityManager.close();
super.doClose();
}
}
모든 코드를 복사했기 때문에 달라진 부분만 보자면 먼저 람다 표현식을 사용할 수 있도록
Function<JPAQueryFactory, JPAQuery<T>> queryFunction
이 생성자 인자로 추가되었습니다.
두번째로는 트랜잭션과 관련된 코드가 사라졌습니다. 이 옵션을 제거하더라도 스프링 배치에서는 기본적으로 chunk 단위로 트랜잭션이 보장되고 있기 때문에 chunk 단위 롤백 등 트랜잭션 관리는 잘 작동되는 것을 확인했습니다.
QuerydslNoOffsetPagingItemReader
MySQL은 특성상 페이징이 뒤로 갈수록 느려집니다. (꼭 MySQL만 그런건 아니고 많은 RDBMS가 비슷하게 작동합니다.)
예를 들어서 limit 10000, 20이라고 하면 10,020개의 행을 읽어야 합니다. 그리고 이 중 앞의 10,000개의 행을 버립니다.
따라서 QuerydslNoOffsetPagingItemReader에서의 컨셉은 읽기 시작한 부분을 지정해 매번 첫 페이지만 읽도록 하는 방식입니다. 이는 쿼리가 매번 이전 페이지의 행을 건너 뛸 수 있음을 의미합니다. 즉, 아무리 페이지가 뒤로 가더라도 처음 페이지를 읽은 것과 같은 효과를 가지게 됩니다.
QuerydslNoOffsetPagingItemReader를 사용할 때의 고려사항은 다음과 같습니다.
1. 기존 배치 잡들의 Reader 쿼리에서 order by, group by가 없는지?
• 어떤 순서로 읽는게 중요하지 않고, 대량의 데이터를 가공하는게 중요한 경우에 사용하면 된다.
• order by, group by가 PK 이외의 다른 기준으로 복잡하게 사용해야 한다면 QuerydslNoOffsetPagingItemReader를 활용하기에는 어려움이 있다.
기존의 where 절에서 추가적으로 id < 마지막조회ID를 추가하는 것이다.
이에대한 특징은 이와 같다.
• offset이 제거된 limit 쿼리
• 조회된 페이지의 마지막 id값을 캐시
• 캐시된 마지막 id값을 다음 페이지 쿼리 조건문에 추가
• 정렬된 기준에 따라 조회 조건에 마지막 id의 조건이 자동 포함
asc는 id > 마지막id
desc는 id < 마지막id
이런 형식으로 구성됩니다.
여기서 좀 더 보편적으로 사용하기 위해서는 몇개의 조건이 추가됩니다.
-id 뿐만 아니라 다른 필드들도 정렬 조건에 사용할 수 있어야 함
--모든 테이블의 PK필드가 꼭 id가 아닐 수 있음
--PK필드 외에도 인덱스 필드를 사용할 수도 있음
--order by가 별도의 필드를 필요할 수도 있음
-Long(bigint) 외에도 정렬 기준이 가능해야 함
--String (varchar), Integer (int) 등도 언제든 조건으로 사용할 수 있음
-어떤 필드가 대상일지 문자열이 아닌, QClass 필드로 직접 지정할 수 있어야 함
--즉, "id"가 아닌 QProduct.product.id가 되어야 함을 의미
--문자열로 지정할 경우 오타, 필드 변경에 대해 컴파일 체크가 안되기 때문에 Querydsl의 QClass 필드로 지정
위의 여러 기능을 좀 더 관리하기 쉽도록 ItemReader외에 2개의 클래스를 추가로 개발해야 합니다.
-QuerydslNoOffsetOptions
--어떤 필드를 기준으로 사용할지 결정하는 추상 클래스이다.
--해당 필드의 타입에 따라 NumberOptions, StringOptions와 같은 하위 구현체를 사용한다.
package org.springframework.batch.item.querydsl.reader.options;
import com.querydsl.core.types.Path;
import com.querydsl.jpa.impl.JPAQuery;
import org.apache.commons.logging.Log;
import org.apache.commons.logging.LogFactory;
import org.springframework.batch.item.querydsl.reader.expression.Expression;
import javax.annotation.Nonnull;
import java.lang.reflect.Field;
public abstract class QuerydslNoOffsetOptions<T> {
protected Log logger = LogFactory.getLog(getClass());
protected final String fieldName;
protected final Expression expression;
public QuerydslNoOffsetOptions(@Nonnull Path field,
@Nonnull Expression expression) {
String[] qField = field.toString().split("\\.");
this.fieldName = qField[qField.length-1];
this.expression = expression;
if (logger.isDebugEnabled()) {
logger.debug("fieldName= " + fieldName);
}
}
public String getFieldName() {
return fieldName;
}
public abstract void initKeys(JPAQuery<T> query, int page);
protected abstract void initFirstId(JPAQuery<T> query);
protected abstract void initLastId(JPAQuery<T> query);
public abstract JPAQuery<T> createQuery(JPAQuery<T> query, int page);
public abstract void resetCurrentId(T item);
protected Object getFiledValue(T item) {
try {
Field field = item.getClass().getDeclaredField(fieldName);
field.setAccessible(true);
return field.get(item);
} catch (NoSuchFieldException | IllegalAccessException e) {
logger.error("Not Found or Not Access Field= " + fieldName, e);
throw new IllegalArgumentException("Not Found or Not Access Field");
}
}
public boolean isGroupByQuery(JPAQuery<T> query) {
return isGroupByQuery(query.toString());
}
public boolean isGroupByQuery(String sql) {
return sql.contains("group by");
}
}
-Expression
--where, order by 조건을 만들어주는 클래스이다.
--정렬 조건이 asc인지, desc인지에 따라 where 조건문을 자동으로 결정하는 역할도 한다.
package org.springframework.batch.item.querydsl.reader.expression;
import com.querydsl.core.types.OrderSpecifier;
import com.querydsl.core.types.dsl.BooleanExpression;
import com.querydsl.core.types.dsl.NumberPath;
import com.querydsl.core.types.dsl.StringPath;
/**
* Created by [email protected] on 23/01/2020
* Blog : http://jojoldu.tistory.com
* Github : http://github.com/jojoldu
*/
public enum Expression {
ASC(WhereExpression.GT, OrderExpression.ASC),
DESC(WhereExpression.LT, OrderExpression.DESC);
private final WhereExpression where;
private final OrderExpression order;
Expression(WhereExpression where, OrderExpression order) {
this.where = where;
this.order = order;
}
public boolean isAsc() {
return this == ASC;
}
public BooleanExpression where (StringPath id, int page, String currentId) {
return where.expression(id, page, currentId);
}
public <N extends Number & Comparable<?>> BooleanExpression where (NumberPath<N> id, int page, N currentId) {
return where.expression(id, page, currentId);
}
public OrderSpecifier<String> order (StringPath id) {
return isAsc() ? id.asc() : id.desc();
}
public <N extends Number & Comparable<?>> OrderSpecifier<N> order (NumberPath<N> id) {
return isAsc() ? id.asc() : id.desc();
}
}
그래서 결국 QuerydslNoOffsetPagingItemReader는 이렇게 정리할 수 있습니다.
public class QuerydslNoOffsetPagingItemReader<T> extends QuerydslPagingItemReader<T> {
private QuerydslNoOffsetOptions<T> options;
private QuerydslNoOffsetPagingItemReader() {
super();
setName(ClassUtils.getShortName(QuerydslNoOffsetPagingItemReader.class));
}
public QuerydslNoOffsetPagingItemReader(EntityManagerFactory entityManagerFactory,
int pageSize,
QuerydslNoOffsetOptions<T> options,
Function<JPAQueryFactory, JPAQuery<T>> queryFunction) {
this();
super.entityManagerFactory = entityManagerFactory;
super.queryFunction = queryFunction;
this.options = options;
setPageSize(pageSize);
}
@Override
@SuppressWarnings("unchecked")
protected void doReadPage() {
clearIfTransacted();
JPAQuery<T> query = createQuery().limit(getPageSize());
initResults();
fetchQuery(query);
resetCurrentIdIfNotLastPage(); // 조회된 페이지의 마지막 ID 캐시
}
@Override
protected JPAQuery<T> createQuery() {
JPAQueryFactory queryFactory = new JPAQueryFactory(entityManager);
options.initFirstId(queryFunction.apply(queryFactory), getPage()); // 제일 첫번째 페이징시 시작해야할 ID 찾기
return options.createQuery(queryFunction.apply(queryFactory), getPage()); // 캐시된 ID를 기준으로 페이징 쿼리 생성
}
private void resetCurrentIdIfNotLastPage() {
if (isNotEmptyResults()) {
options.resetCurrentId(getLastItem());
}
}
// 조회결과가 Empty이면 results에 null이 담긴다
private boolean isNotEmptyResults() {
return !CollectionUtils.isEmpty(results) && results.get(0) != null;
}
private T getLastItem() {
return results.get(results.size() - 1);
}
}
그리고 이제 사용방법은 이렇습니다.
네 여기까지 QuerydslPagingItemReader 와 QuerydslNoOffsetPagingItemReader에 대해서 알아봤습니다. 이제 배치를 사용할 때도 Querydsl을 사용할 수 있다니 가슴이 두근두근한걸요. 그럼 다음 포스팅에서 뵙겠습니다.
Reference
https://techblog.woowahan.com/2662/
https://github.com/jojoldu/spring-batch-querydsl
스프링 배치의 특징 ( + 다른 언어의 배치)
생각해보니 스프링 배치를 깊게 공부한다는 사람이 스프링 배치이 뭔지에 대한 포스팅이 없다는게 이상해서 스프링 배치의 특징 (장점) 에 대해서 포스팅 해보겠습니다.
추가적으로 다른 언어에서 배치 프로세스를 어떻게 처리하는지에 대해서도 살짝 알아보도록 하겠습니다.
배치 (Batch) 란?
우선 배치가 뭔지부터 알아야겠죠. 배치란 일괄 처리를 의미합니다. 저도 처음엔 한글인줄 알았는데요. 어디에 뭐를 배치하다. 뭐 대충 이런 의미로 생각하고 있었죠. 하지만 배치는 영어입니다. Batch란 '일괄' 이라는 뜻입니다. 즉 데이터를 일괄처리 할 때 사용하는 것이라고 생각하면 좋습니다.
일반적인 서비스 로직은 사용자의 request에 따라서 동작을 수행하는 것이 일반적인데, 배치는 사용자의 request를 받지 않고, 특정 주기를 바탕으로 실행되는 것이 일반적입니다.
예를 들면 매일 새벽 2시에 호출된 API의 횟수를 카운트해야 한다거나, 매출량을 정산해야 한다거나 하는 작업들이 있습니다.
이러한 개별 작업 단위를 배치 Job 이라고 합니다.
Spring Batch
제가 공부하는 것은 그중에서도 스프링 배치입니다. 스프링 배치는 배치 잡을 손쉽게 코딩하고 처리할 수 있도록 도와주는 프레임워크입니다. 엥? 스프링도 프레임워크 아닌가요? 맞습니다. 스프링 배치는 스프링안에 포함되어있는 서브 프레임워크입니다.
스프링의 서브 프레임워크라는 의미는 스프링에서 대표적인 기술인 DI나 AOP등이 사용가능하다는 의미이죠.
스프링 배치에 대해서 자세히 알고싶으시다면 아래의 링크를 참고해주시면 감사하겠습니다.
https://coding-review.tistory.com/category/Spring/Spring%20Batch
그럼 이제 스프링 배치의 특징 (장점) 에 대해서 한번 알아보도록 하죠
스프링 배치의 특징 (장점)
1. 스프링의 기술 및 철학을 활용한다.
말 그대로 스프링의 기술과 철학을 사용하기 대문에 스프링을 학습했다면 러닝커브가 상당히 낮아지고 활용하기가 쉽다는 장점이 있습니다.
물론 스프링 배치도 프레임워크이기 때문에 사용방법을 알아야하고 복잡한 Job을 만들어야 하는 상황이라면 깊이있는 공부가 필요한 것 또한 사실입니다.
하지만 스프링을 이전에 공부했던 사람이라면 스프링 배치를 처음 보는 사람에 비해서 공부하기가 조금 수월하다는 얘기입니다.
2. 다양한 Interface 및 구현체를 제공한다.
스프링이 추구하는 철학 중 하나인 확장성 덕분에 설령 스프링 배치에서 제공하지 않는 구현체가 있더라도 직접 만들어서 사용할 수 있습니다.
저도 얼마전 우아한 형제들 기술블로그에서 향로(jojoldu)님이 작성하신 'Querydsl과 Spring batch' 라는 글을 감명깊게 보고 실제 프로젝트에 적용하기 위해 QuerydslPagingItemReader를 직접 만들어서 사용해봤습니다.
이렇게 직접 구현체를 만드는 경우는 그리 흔한 경우는 아닙니다. 스프링은 호환성을 굉장히 중요하게 생각하기 때문에 다양한 구현체를 이미 만들어두고 있습니다. ItemReader를 예로 들자면 MyBatis를 사용할 때 사용하라고 만들어 둔 구현체인 MyBatisItemReader가 있구요, JDBC를 사용할 때 사용하라고 만들어 둔 구현체인 JdbcCursorItemReader, JdbcPagingItemReader도 있습니다. 물론 JPA에 관련된 ItemReader들도 있습니다.
3. 배치 사이즈를 지정할 수 있어서 대용량 처리에 용이하다.
배치 사이즈 즉, chunk를 지정할 수 있어서 대용량 데이터를 안전하게 커밋할 수 있게 도와줍니다. 스프링 배치에서는 chunk 지향처리를 바탕으로 chunk 단위로 트랜잭션의 원자성을 보장해주고 중간에 에러가 발생했을 때 chunk 단위만큼만 롤백하여 이미 커밋이 완료된 데이터를 안전하게 보호할 수 있습니다.
하지만 chunk를 사용할만큼 대용량이 아니라면 굳이 스프링 배치를 사용할 필요가 없다는 의미이기도 합니다.
4. 다양한 설정을 통해 유연한 처리가 가능하다.
여기서 말하는 다양한 설정이란 많이 있지만 몇개만 뽑아보자면 특정한 에러가 발생했을 때 재시도를 하라고 지정할 수도 있고, 또는 특정한 에러가 발생했을 때 건너뛰라고 지정할 수도 있습니다.
이러한 처리는 원래라면 try-catch문을 이용해 재시도를 하거나 스킵을 해야하지만 스프링 배치에서는 어떻게 재시도 할지에 대해서만 정의해주면 손쉽게 재시도 혹은 스킵이 가능합니다.
또한 배치 잡 중 특정 Step이 실행되지 않는다면 allowStartIfComplete 속성을 true로 주어 무조건 다시 실행되게 할 수도 있습니다.
5. 손쉬운 이벤트 처리가 가능하다.
스프링은 객체지향을 극한으로 끌어올린 프레임워크이기 때문에 배치 잡을 운용함에 있어서 객체지향스럽게 잘 짜여져 있습니다.
데이터를 읽어오는 ItemReader, 데이터를 가공하는 ItemProcessor, 데이터를 데이터베이스에 넣는 ItemWriter, 그리고 이 셋을 묶은 Step, 여러 Step을 묶은 Job 이런식으로 체계적으로 짜여져있기 때문에 어디서 어떤 일을 하고있는지 개발하는 개발자가 콕 찝어서 관리할 수 있습니다.
또한, 이렇게 체계적으로 쪼개어져있기 때문에 어디서 에러가 났는지 쉽게 파악할 수 있다는 장점도 있습니다.
6. 실행 이력에 대한 저장이 가능하다.
스프링 배치는 메타테이블을 이용해 하나의 배치 잡에 대한 실행 이력을 JobRepository를 이용해 저장할 수 있습니다.
또한, JobInstance, JobExecution이라는 존재로 인하여 하나의 잡이 재시도 될 때 JobInstance를 다시 만드는게 아니고 재사용할 수 있습니다.
물론 멱등성을 유지하고 싶은 경우 JobParameter를 조정해서 잡이 실행될 때마다 새로운 JobInstance를 만드는 경우도 많습니다. 하지만 특정 에러가 난다거나 해서 잡이 재시작하는 경우에 기존의 JobInstance를 사용하기 때문에 자원 낭비가 많지 않습니다.
여기까지 스프링 배치의 특징 (장점) 에대해서 알아봤습니다. 하지만 문득 궁금하더라구요. 다른 언어에서는 이 배치를 어떤 방식으로 풀어내고 있을까 굉장히 궁금했습니다.
그래서 구글링으로 다른 언어에서는 어떤 방식으로 배치를 처리하고있고 어떤 방식을 채택했는지에 대해서 간단하게 알아보도록 하겠습니다.
제가 알아본 백엔드에 쓰이는 프레임워크는 파이썬의 Django, C#의 닷넷 프레임워크, 자바스크립트의 Node.js, Ruby의 Ruby on Rails입니다.
하나씩 알아보죠
Django
우선 장고입니다. 파이썬의 장고는 스프링과 마찬가지로 백엔드 웹서비스를 만들 때 사용하는 프레임워크로 유명합니다.
장고의 배치는 Crontab이라는 라이브러리를 사용합니다. Crontab은 2016년에 릴리즈된 따끈따끈한 라이브러리입니다.
하지만 알아본 바로는 위의 스프링 배치에서 찾아볼 수 있는 특징을 찾을 수 없었고 마지막 커밋이 4년전이기 때문에 꽤나 낙후된 라이브러리입니다.
.NET framework
다음으로는 C#의 닷넷 프레임워크입니다. 신기하게 구글링에서 닷넷 프레임워크 배치를 검색하면 아무런 결과도 찾을 수 없습니다. 배치와 관련된 내용은 배치 파일을 만들어서 밀어넣는 방법에 대해서 포스팅된 것을 발견했습니다.
Node.js
자바스크립트의 Node.js입니다. Node.js는 아시는 분들은 아시겠지만 따지고보면 프레임워크는 아닙니다. Express나 Next.js가 자바스크립트의 프레임워크이지 Node.js는 구글의 자바스크립트 엔진중 하나인 V8엔진을 떼다 만든 툴(?)입니다.
하지만 Node.js로 백엔드를 만든다는 점 때문에 이번 구글링 대상에 넣었습니다.
Node.js에서는 배치 프로세스를 처리하기 위해 세가지 라이브러리가 존재합니다.
• Agenda
• node-cron
• node-schedule
이중에서 가장 많이 쓰이는 라이브러리는 node-schedule입니다. 함수형 프로그래밍의 대표주자인 자바스크립트답게 크론 표현식과 함수형프로그래밍이 합쳐진 형태이며 따로 설정이 있는 것 같지는 않은 라이브러리입니다.
Ruby on Rails
마지막으로 Ruby의 Ruby on Rails입니다. Ruby on Rails에는 ActiveRecord::Batches라는 배치를 지원하기 위한 ORM 모듈이 있고 그 편리함 덕분에 지금도 널리 사용중입니다.
스프링 배치와 마찬가지로 배치 사이즈를 지정해 대용량 데이터를 안전하게 처리할 수 있는 기능을 제공합니다.
하지만 스프링 배치에서의 특정 에러가 났을 경우 재시작 혹은 스킵 같은 세부적인 설정은 할 수 없는 듯 했습니다.
마치며
어떤가요 스프링 배치와 좀 더 친해진 느낌이 드시나요?
다른 언어에서 배치에 대해서 어떻게 해결하는지에 대해서는 제가 해당 언어를 깊이있게 공부해보지 않았기 때문에 틀린 정보가 있을 수도 있습니다.
제가 적은 정보는 구글링을 통해 접할 수 있는 표면적인 정보에 불과하며 깊이있게 공부할 경우 다른 결과가 충분히 나올 수 있음을 알립니다.
이렇게 스프링 배치에 대해서 쫙 정리하면서 느낀점은 왜 서비스가 커지면 자바로 전환하는지에 대해서 피부로 와닿게 되었습니다.
처음에 개발할 당시에는 빠르게 변화하는 개발환경과 피드백으로 빠르게빠르게 개발을 진행해야 하는 스타트업 특성상 안전하지만 개발 기간이 오래 걸리는 자바를 선택하기엔 조금 무리가 있을 수도 있습니다.
하지만 서비스가 커지면서 다뤄야 하는 데이터가 많아지면 스프링 배치의 강력한 기능을 사용하기 위해 자바로 전환하는 상황이 올 것 같습니다.
때문에 현재 한국에 존재하는 IT 기업들중 대부분이 자바 스프링을 사용하고 있는 이유이지 않을까 하는 개인적인 추측을 해봅니다.
여기까지 긴 글 읽어주셔서 감사합니다. 다음엔 더 질 좋은 포스팅으로 찾아뵙도록 하겠습니다.
Reference
https://blog.naver.com/PostView.naver?blogId=pjok1122&logNo=222172642938&parentCategoryNo=&categoryNo=52&viewDate=&isShowPopularPosts=false&from=postView (https://blog.naver.com/PostView.naver?blogId=pjok1122&logNo=222172642938&parentCategoryNo=&categoryNo=52&viewDate=&isShowPopularPosts=false&from=postView)
스프링 배치 개요
본 포스팅은 인프런의 정수원님의 스프링 배치 강의를 듣고 정리한 포스팅입니다. 더 자세한 내용은 강의를 참고해주세요.
1. 스프링 배치 탄생 배경
• 자바 기반 표준 배치 기술 부재
배치 처리에서 요구하는 재사용 가능한 자바 기반 배치 아키텍처 표준의 필요성이 대두
• 스프링 배치는 SprintSource(현재는 Pivotal)와 Accenture(경영 컨설팅 기업)의 합작품
Accenture - 배치 아키텍처를 구현하면서 쌓은 기술적인 경험과 노하우
• SpringSource - 깊이 있는 기술적 기반과 스프링의 프로그래밍 모델
• Accenture는 이전에 소유했던 배치 처리 아키텍처 프레임워크를 Spring Batch 프로젝트에 기증함
2. 배치 핵심 패턴
• Read - 데이터베이스, 파일, 큐에서 다량의 데이터를 조회한다.
• Process - 특정 방법으로 데이터를 가공한다.
• Write - 데이터를 수정된 양식으로 다시 저장한다.
3. 배치 시나리오
• 배치 프로세스를 주기적으로 커밋
• 동시 다발적인 Job의 배치 처리, 대용량 병렬 처리
• 실패 후 수동 또는 스케줄링에 의한 재시작
• 의존관계가 있는 Step 여러 개를 순차적으로 처리
• 조건적 Flow 구성을 통한 체계적이고 유연한 배치 모델 구성
• 반복, 재시도 Skip 처리
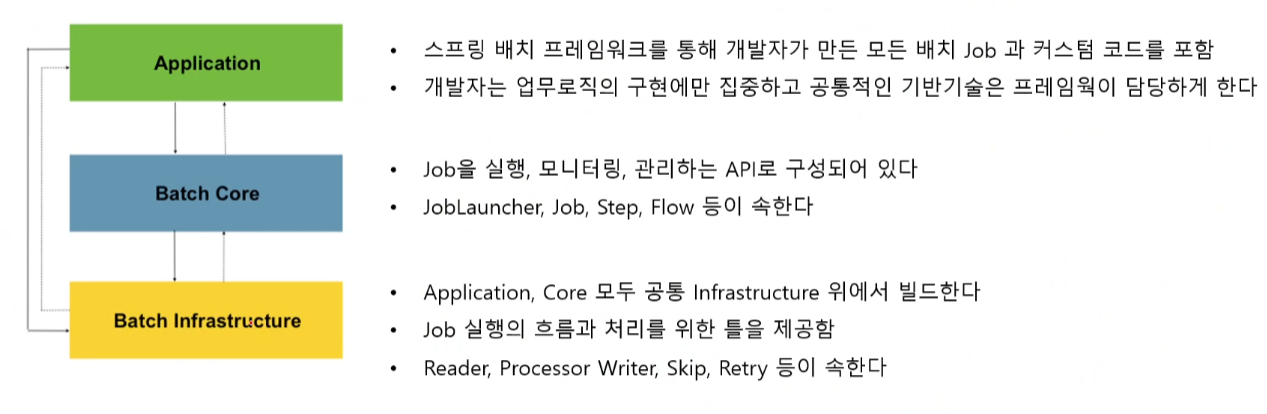
스프링 배치 메타 데이터
본 포스팅은 인프런의 정수원님의 스프링 배치 강의를 듣고 정리한 포스팅입니다. 더 자세한 내용은 강의를 참고해주세요.
스프링 배치는 실행 및 관리를 위한 목적으로 여러 도메인(Job, Step, JobParameter 등등)의 정보들을 저장, 업데이트, 조회할 수 있는 스키마를 제공합니다.
과거, 현재의 실행에 대한 세세한 정보, 실행에 대한 성공과 실패 여부 등을 일목요연하게 관리함으로써 배치운용에 있어 리스크 발생시 빠른 대치가 가능합니다.
DB와 연동할 경우 필수적으로 메타 테이블이 생성되어야 합니다.
DB 스키마 제공
파일 위치는 /org/springframework/batch/core/schema-*.sql에 존재하고 DB 유형별로 제공합니다.
이때 스키마 생성에 대한 설정을 할 수 있는데 application 파일에 spring.batch.jdbc.initialize-schema 설정을 세 단계로 나눠 처리할 수 있습니다.
• ALWAYS : 스크립트를 항상 실행합니다. RDBMS 설정이 되어 있을 경우 내장 DB 보다 우선적으로 실행됩니다.
• EMBEDDED : 내장 DB일 때만 실행되며 스키마가 자동 생성됩니다. EMBEDDED는 기본값입니다.
• NEVER : 스크립트가 항상 실행되지 않고 내장 DB일 경우 스크립트가 생성이 안되기 때문에 오류가 발생합니다. 운영에서 수동으로 스크립트 생성 후 설정하는 것을 권장하는 옵션입니다.
메타 테이블
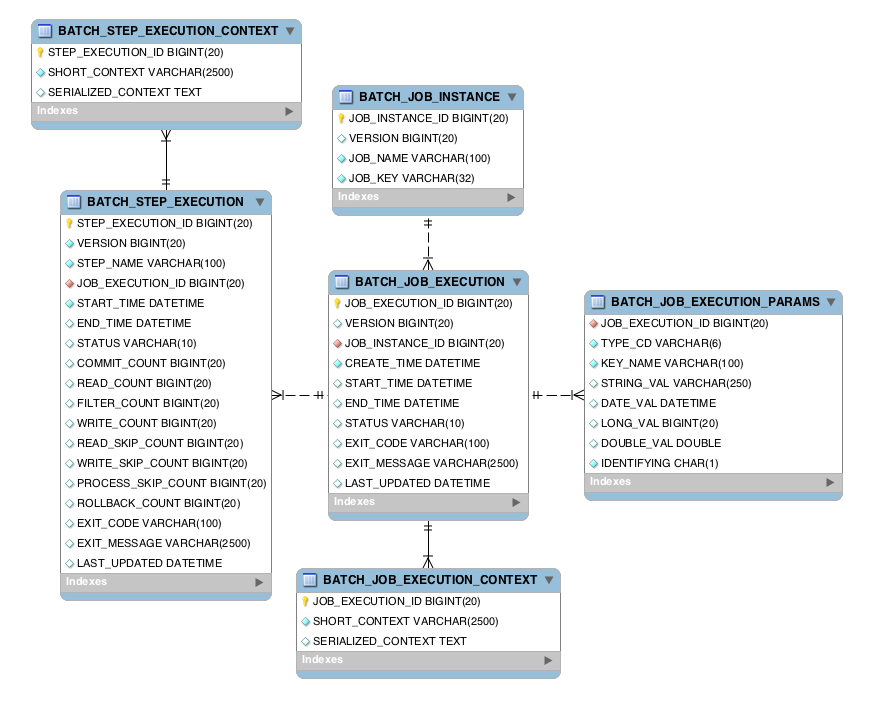
메타 테이블은 크게 나누면 두개로 나눌 수 있습니다. 바로 Job과 관련된 테이블과 Step과 관련된 테이블 이렇게 두개로 나눌 수 있습니다.
먼저 Job과 관련된 테이블부터 설명하겠습니다.
• BATCH_JOB_INSTANCE : Job이 실행될 때 JobInstance 정보가 저장되며 job_name과 job_key를 키로 하여 하나의 데이터가 저장됩니다. 이때 동일한 job_name과 job_key로 중복 저장될 수 없습니다. job_key는 JobParameter를 해시값으로 하는 값을 저장합니다. 즉, 동일한 해시값(JobParamter)은 중복저장되지 않으므로 이 말은 곧 동일한 해시값인 경우 JobInstance가 재시작한다는 의미로 받아들일 수 있습니다.
• BATCH_JOB_EXECUTION : Job의 실행정보가 저장되며 Job 생성, 시작, 종료 시간, 실행 상태, 메시지 등을 관리하는 테이블입니다.
• BATCH_JOB_EXECUTION_PARAMS : Job과 함께 실행되는 JobParameter의 정보를 저장하는 테이블입니다.
• BATCH_JOB_EXECUTION_CONTEXT : Job의 실행동안 여러가지 상태정보, 공유 데이터를 직렬화 (json 형식) 하여 저장합니다. 또한 해당 테이블은 Step 간 서로 공유가 가능하다는 특징이 있습니다.
다음은 Step과 관련된 테이블입니다.
• BATCH_STEP_EXECUTION : Step의 실행정보가 저장되며 생성, 시작, 종료 시간, 실행상태, 메시지 등을 관리합니다.
• BATCH_STEP_EXECUTION_CONTEXT : Step의 실행동안 여러가지 상태정보, 공유 데이터를 직렬화 (json 형식) 하여 저장합니다. 또한 해당 테이블은 Step 별로 저장되며 Step간 서로 공유할 수 없다는 특징을 가지고 있습니다.
이제 이 테이블들의 속성에 대해 하나씩 살펴보도록 하겠습니다.
BATCH_JOB_INSTANCE
• JOB_INSTANCE_ID : 고유하게 식별할 수 있는 기본 키
• VERSION : 업데이트 될 때마다 1씩 증가하는 값
• JOB_NAME : Job을 구성할 때 부여하는 Job의 이름
• JOB_KEY : JOB_NAME과 JobParameter를 합쳐 해싱한 값을 저장
BATCH_JOB_EXECUTION
• JOB_EXECUTION_ID : JobExecution을 고유하게 식별할 수 있는 기본 키, JOB_INSTANCE와 일대다의 관계입니다.
• VERSION : 업데이트 될 때마다 1씩 증가하는 값
• JOB_INSTANCE_ID : JOB_INSTANCE의 키 저장
• CREATE_TIME : 실행(Execution)이 생성된 시점을 TimeStamp 형식으로 기록
• START_TIME : 실행(Execution)이 시작된 시점을 TimeStamp 형식으로 기록
• END_TIME : 실행이 종료된 시점을 TimeStamp로 기록하며 Job 실행 도중 오류가 발생해서 Job이 중단된 경우 값이 저장되지 않을 수 있다는 특징이 있습니다.
• STATUS : 실행 상태(BatchStatus)를 저장 (COMPLETED, FAILED, STOPPED 등등)
• EXIT_CODE : 실행 종료 코드 (ExitStatus)를 저장 (COMPLETED, FAILED 등등)
• EXIT_MESSAGE : Status가 실패일 경우 실패 원인 등의 내용을 저장
• LAST_UPDATED : 마지막 실행 시점을 TimeStamp 형식으로 기록
BATCH_JOB_EXECUTION_PARAMS
• JOB_EXECUTION_ID : JobExecution 식별 키, JOB_EXECUTION과는 일대다 관계
• TYPE_CD : STRING, LONG, DATE, DUBLE 타입 정보
• KEY_NAME : 파라미터 키 값
• STRING_VAL : 파라미ㅏ터 문자 값
• DATE_VAL : 파라미터 날짜 값
• LONG_VAL : 파라미터 Long 값
• DOUBLE_VAL : 파라미터 Double 값
• IDENTIFYING : 식별 여부 (TRUE, FALSE)
BATCH_JOB_EXECUTION_CONTEXT
• JOB_EXECUTION_DE : JobExecution 식별 키, JOB_EXECUTION 마다 각각 생성
• SHORT_CONTEXT : Job의 실행 상태 정보, 공유 데이터등의 정보를 문자열로 저장
• SERIALIZED_CONTEXT : 직렬화된 전체 컨텍스트
BATCH_STEP_EXECUTION
• STEP_EXECUTION_ID : Step의 실행정보를 고유하게 식별할 수 있는 기본 키
• VERSION : 업데이트 될 때마다 1씩 증가하는 값
• STEP_NAME : Step.을 구성할 때 부여하는 Step 이름
• JOB_EXECUTION_ID : JobExecution 기본 키, JobExecution과는 일대다 관계
• START_TIME : 실행이 시작된 시점을 TimeStamp 형식으로 기록
• END_TIME : 실행이 종료된 시점을 TimeStamp로 기록하며 Job실행 도중 오류가 발생해서 Job이 중단된 경우 값이 저장되지 않을 수 있다는 특징이 있습니다.
• STATUS : 실행 상태 (BatchStatus)를 저장 (COMPLETED, FAILED, STOPPED 등등)
• COMMIT_COUNT : 트랜잭션 당 커밋되는 수를 기록
• READ_COUNT : 실행시점에 Read한 Item의 수를 기록
• FILTER_COUNT : 실행도중 필터링된 Item의 수를 기록
• WRITE_COUNT : 실행도중 저장되고 커밋된 Item의 수를 기록
• READ_SKIP_COUNT : 실행도중 Read가 Skip된 Item의 수를 기록
• WRITE_SKIP_COUNT : 실행도중 Write가 Skip된 Item의 수를 기록
• PROCESS_SKIP_COUNT : 실행도중 Process가 Skip된 Item의 수를 기록
• ROLLBACK_COUNT : 실행도중 Rollback이 일어난 수를 기록
• EXIT_CODE : 실행 종료 코드를 저장
• EXIT_MESSAGE : Status가 실패이ㅏㄹ 경우 실패 원인 등의 내용을 저장
• LAST_UPDATED : 마지막 실행시점을 TimeStamp 형식으로 기록
BATCH_STEP_EXECUTION_CONTEXT
• STEP_EXECUTION_ID : StepExecution 식별 키, STEP_EXECUTION 마다 각각 생성
• SHORT_CONTEXT : Step의 실행 상태정보, 공유 데이터등의 정보를 문자열로 저장
• SERIALIZED_CONTEXT : 직렬화된 전체 컨텍스트
이렇게 메타테이블에 대해서 알아봤습니다. 긴 글 읽어주셔서 감사합니다.
스프링 배치 도메인의 이해 : Job
본 포스팅은 인프런의 정수원님의 스프링 배치 강의를 듣고 정리한 포스팅입니다. 더 자세한 내용은 강의를 참고해주세요.
Job
기본 개념
배치 계층 구조에서 가장 상위에 있는 개념으로 하나의 배치 작업 자체를 의미합니다. 이는 API 서버의 접속 로그 데이터를 통계로 서버로 옮기는 배치인 Job 자체를 의미합니다.
Job Configuration을 통해 생성되는 객체 단위로서 배치작업을 어떻게 구성하고 실행할 것인지 전체적으로 설정하고 명세해 놓은 객체입니다.
배치 Job을 구성하기 위한 최상위 인터페이스이며 스프링 배치가 기본 구현체를 제공해줍니다. 여러 Step을 포함하고 있는 컨테이너로서 번드시 한개 이상의 Step으로 구성해야 합니다.
기본 구현체
• SimpleJob
순차적으로 Step을 실행시키는 Job
• 모든 Job에서 유용하게 사용할 수 있는 표준 기능을 갖고 있음
• FlowJob
특정한 조건과 흐름에 따라 Step을 구성하여 실행시키는 Job
• Flow 객체를 실행시켜 작업을 진행함
이제 간단한 Job을 만들어서 Job이 어떻게 구동되는지 흐름을 한번 파악해보도록 하겠습니다.
우선 Job을 만듭니다.
package io.sprintbatch.springbatchlecture;
import lombok.RequiredArgsConstructor;
import org.springframework.batch.core.Job;
import org.springframework.batch.core.Step;
import org.springframework.batch.core.StepContribution;
import org.springframework.batch.core.configuration.annotation.JobBuilderFactory;
import org.springframework.batch.core.configuration.annotation.StepBuilderFactory;
import org.springframework.batch.core.scope.context.ChunkContext;
import org.springframework.batch.core.step.tasklet.Tasklet;
import org.springframework.batch.repeat.RepeatStatus;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
@Configuration
@RequiredArgsConstructor
public class JobConfiguration {
private final JobBuilderFactory jobBuilderFactory;
private final StepBuilderFactory stepBuilderFactory;
@Bean
public Job job() {
jobBuilderFactory.get("job")
.start(step1())
.next(step2())
.build()
}
@Bean
public Step step1() {
return stepBuilderFactory.get("step1")
.tasklet(new Tasklet() {
@Override
public RepeatStatus execute(StepContribution stepContribution, ChunkContext chunkContext) throws Exception {
System.out.println("step1 was executed");
return RepeatStatus.FINISHED;
}
})
.build();
}
@Bean
public Step step2() {
return stepBuilderFactory.get("step2")
.tasklet(new Tasklet() {
@Override
public RepeatStatus execute(StepContribution stepContribution, ChunkContext chunkContext) throws Exception {
System.out.println("step2 was executed");
return RepeatStatus.FINISHED;
}
})
.build();
}
}
그리고 디버그모드로 흐름을 천천히 파악해보도록 하겠습나다.
이렇게 브레이크 포인트를 잡아놓고 따라가보도록 하겠습니다.
먼저 이동하는 곳은 SimpleJobBuilder 입니다. 이곳에서 JobBuilder는 Step들을 List로 관리합니다.
위의 JobBuilderFactory로 start라는 메서드를 호출했습니다. 이 start라는 메서드는 Step을 Argument로 받아 리스트에 하나씩 저장합니다.
그 다음 next라는 메서드를 호출해서 마찬가지로 List에 Step을 하나씩 담습니다.
이렇게 되면 최종적으로 List에는 두개의 Step이 담겨져있게 됩니다.
이제 build라는 메서드를 호출하게 되면 Job의 구현체 중 SimpleJob을 호출하게 됩니다. 그렇게 되면 SimpleJobBuilder로 이동해서
SimpleJob 객체를 만들고 아까 Step을 담아두었던 List를 setSteps를 통해 Job에 세팅합니다.
이렇게해서 Job에 대한 세팅이 완료되었습니다. 이후에 Job은 bean으로 등록될 때 자동으로 실행되게 되어있습니다. 바로 BatchAutoConfiguration 클래스에서 JobLauncherApplicationRunner를 이용해서 실행됩니다.
jobLauncher는 run 메서드를 이용해 job과 jobParameter를 가지고 Job을 실행시킵니다.
실행이 되고 나면 AbstractJob 으로 가서 doExecute를 실행하게 됩니다.
이제 doExecute 메서드를 실행함으로 인해서 드디어 SimpleJob 클래스로 넘어가게 됩니다.
여기서 StepExecution을 만들고 StepHandler 가 Step을 실행합니다. Step을 실행하게 되면 Step안에 존재하는 tasklet이 실행됩니다.
여기까지 Job이 설정되고 실행되는 사이클을 살펴봤습니다.
다음 포스팅에서는 JobInstance 에 대해서 알아보도록 하겠습니다. 긴 글 읽어주셔서 감사합니다.
스프링 배치 도메인의 이해 : JobInstance, JobParamter, JobExecution
본 포스팅은 인프런의 정수원님의 스프링 배치 강의를 듣고 정리한 포스팅입니다. 더 자세한 내용은 강의를 참고해주세요.
**본 포스팅은 앞선 포스팅과 이어지는 내용입니다.**
https://coding-review.tistory.com/190
JobInstance 에 대해서 들어가기 앞서 우리는 Job 과 JobInstance 의 차이에 대해 알아봐야 합니다.
Job 자체를 실행하기 위한 단계, 처리, 결과, 구성 등을 포함하고 있는 객체들이 바로 Job, Step, Flow, Tasklet 등등 입니다. 즉, Job 그 자체를 실행하기 위한 객체라는 의미이죠. 그럼 JobInstance 는 뭘까요?
JobInstance, JobExecution, JobParamter, StepExecution 등등은 Job 에 대한 상태정보, 실행정보 등을 데이터베이스에 저장하기 위한 객체들 입니다.
정리하자면 Job 은 Job 그 자체를 실행하기 위한 객체, Jobinstance는 Job 의 상태정보나 실행정보 등을 데이터베이스에 저장하기 위한 객체 라고 정리할 수 있습니다.
이제 정리가 되셨나요?
본격적으로 JobInstance에 대해서 들어가보도록 하겠습니다.
JobInstance
기본 개념
• Job이 실행될 때 생성되는 Job 의 논리적 실행 단위 객체로서 고유하게 식별 가능한 작업 실행을 나타냄
• Job의 설정과 구성은 동일하지만 Job 이 실행되는 시점에 처리하는 내용은 다르기 때문에 Job 의 실행을 구분해야 함
예를 들어서 하루에 한 번 씩 배치 Job 이 실행된다면 매일 실행되는 각각의 Job 을 JobInstance 로 표현한다.
• JobInstance 생성 및 실행
처음 시작하는 Job + JobParamter 일 경우 새로운 JobInstance 생성
• 이전과 동일한 Job + JobParamter 로 실행할 경우 이미 존재하는 JobInstance 리턴
내부적으로 JobName + JobKey (JobParameter 의 해시값) 를 가지고 JobInstance 객체를 얻음
• Job 과는 1 : N 관계
BATCH_JOB_INSTANCE 테이블과 매핑
• JOB_NAME (Job) 과 JOB_KEY (JobParamter의 해시값) 가 동일한 데이터는 중복해서 저장할 수 없음
다음으로 JobInstance의 생성 흐름에 대해서 살펴보도록 하겠습니다.
JobLauncher는 우리가 구성한 배치 잡을 실행하는 역할을 합니다. Job을 실행시킬 때는 두개의 객체를 인자로 받아서 실행합니다. 바로 Job 과 JobParameter 입니다.
위의 그림은 Job 으로 "일별 정산" JobParameter 로 2021.01.01 을 인자로 받았습니다.
JobRepository 는 데이터베이스를 조회해서 해당 Job이 존재한다면 기존 JobInstance를 리턴하고 존재하지 않다면 새로운 JobInstance 를 생성합니다.
만약 같은 JobParamter로 실행한다면 어떻게 될까요?
기존 JobInstance를 반환하면서 에러를 내뱉습니다.
Caused by : org.springframework.batch.core.repository.JobInstanceAlreadyCompleteException : A Job instance already exists and is complete for parameters={name=user1}, If you want to run this job again, change the parameters.
에러가 참 친절하네요 JobInstance가 해당 JobParameter로 이미 존재하기 때문에 다시 시작하고 싶으면 파라미터를 바꿔라 라는 에러입니다.
JobParamter
기본 개념
• Job 을 실행할 때 함께 포함되어 사용되는 파라미터를 가진 도메인 객체
• 하나의 Job 에 존재할 수 있는 여러개의 JobInstance 를 구분하기 위한 용도
• JobParameters 와 JobInstance 는 1 : 1 관계
생성 및 바인딩
• 애플리케이션 실행 시 주입
Java -jar LogBatch.jar requestDate=20210101
• 코드로 생성
JobParameterbuilder, DefaultJobParametersConverter
• SpEL 이용
@Value("#{jobParamter[requestDate]}"), @JobScope, @StepScope 선언 필수
BATCH_JOB_EXECUTION_PARAM 테이블과 매핑
• JOB_EXECUTION 과 1 : N 관계
JobParameter Wrapper 에는 JobParamter 가 LinkedHashMap 으로 저장되어 있습니다.
JobParameter 에는 parameter, parameterType 을 가지고 있습니다. parameter는 말 그대로 파라미터이구요 parameterType 은 parameter 로 담을 수 있는 클래스를 지정해놓고 있습니다.
parameter 에는 String , Date, Long, Double 이 네가지의 클래스만 들어갈 수 있습니다.
예를 들어서 위의 그림에서 세개의 파라미터가 들어갔는데요 requestDate, run.id, name 입니다. 이것이 BATCH_JOB_EXECUTION_PARAM 테이블에 이렇게 매핑 됩니다.
type_cd 에는 parameter 의 타입이, key_name 에는 우리가 지정한 key 값이, val (value) 에는 각각의 값이 저장되는 방식입니다.
우선 잡이 기본적으로 시작되지 않도록 application.yml 에서 설정을 바꿔줍니다.
그리고 JobParameter 를 테스트할 클래스를 만들어 줍니다.
package io.sprintbatch.springbatchlecture;
import lombok.RequiredArgsConstructor;
import org.springframework.batch.core.Job;
import org.springframework.batch.core.JobParameters;
import org.springframework.batch.core.JobParametersBuilder;
import org.springframework.batch.core.launch.JobLauncher;
import org.springframework.boot.ApplicationArguments;
import org.springframework.boot.ApplicationRunner;
import org.springframework.stereotype.Component;
import java.util.Date;
@Component
@RequiredArgsConstructor
public class JobParameterTest implements ApplicationRunner {
private final JobLauncher jobLauncher;
private final Job job;
@Override
public void run(ApplicationArguments args) throws Exception {
JobParameters jobParameters = new JobParametersBuilder()
.addString("name", "user1")
.addLong("seq", 2L)
.addDate("date", new Date())
.addDouble("age", 16.5)
.toJobParameters();
jobLauncher.run(job, jobParameters);
}
}
이렇게 설정하고 실행한 다음 BATCH_JOB_EXECUTION_PARAMS 테이블에 가보면
이렇게 값이 들어가 있는 것을 확인할 수 있습니다.
이런식으로 JobParameter를 넣었는데 이제 이걸 사용해야겠죠? 우선 tasklet에서 사용하는 방법은 다음과 같습니다.
JobParameters jobParameters = stepContribution.getStepExecution().getJobExecution().getJobParameters();
jobParameters.getString("name");
jobParameters.getLong("seq");
jobParameters.getDate("date");
jobParameters.getDouble("age");
tasklet 에 있는 StepContribution 에서 StepExecution 을 꺼내고 JobExecution 을 꺼내고 JobParameters 를 꺼냅니다.
이렇게 꺼낸 JobParameter 는 getString, getLong, getDate, getDouble 을 이용해 각각의 값을 꺼낼 수 있습니다.
많은 분들이 tasklet 으로 JobParameter 를 사용하시지는 않고 SpEL 로 꺼내는 방법 (@StepScope, @JobScope) 으로 꺼내는 방법을 많이들 알고 계실겁니다. 이 부분에 대해서는 추후에 포스팅 하도록 하겠습니다.
JobExecution
기본 개념
• JobInstance 에 대한 한번의 시도들을 의미하는 객체로서 Job 실행 중에 발생한 정보들을 저장하고 있는 객체
시작시간, 종료시간, 상태 (시작됨, 완료, 실패), 종료 상태의 속성을 가짐
• JobInstance 와의 관계
JobExecution 은 "FAILED" 또는 "COMPLETED" 등의 Job 의 실행 결과 상태를 가지고 있음
• JobExecution 의 실행 상태 결과가 "COMPLETED" 면 JobInstance 실행이 완료된 것으로 간주해서 재 실행이 불가능함
• JobExecution 의 실행 상태 결과가 "FAILED" 면 Jobinstance 실행이 완료되지 않은 것으로 간주해서 재 실행이 가능함
JobParameter 가 동일한 값으로 Job 을 실행할지라도 JobInstance 를 계속 실행할 수 있음
• JobExecution 의 실행 상태 결과가 "COMPLETED" 될 때까지 하나의 JobInstance 내에서 여러번의 시도가 생길 수 있음
BATCH_JOB_EXECUTION 테이블과 매핑
• JobInstance 와 JobExecution 은 1 : N 관계로서 JobInstance 에 대한 성공/실패의 내역을 가지고 있음
JobExecution 은 JobInstance 와 혼동하기 쉽습니다. 둘의 가장 큰 차이는 JobInstance는 같은 job_name, JobParameter를 가졌다면 반드시 하나만 생성되지만 JobExecution은 Job이 실행될때마다 새로 생성된다는 차이가 있습니다.
즉, JobExecution 은 Job 의 실행단위인 것입니다.
그 다음으로 알아봐야 하는 것은 JobInstance 와의 상관관계입니다. 위에서 말했지만 중요하기 때문에 다시 말씀드리겠습니다.
알기 쉽게 순서도로 설명드리겠습니다.
1. Job이 성공 -> BatchStatus = COMPLETED -> JobInstance 는 한개 JobExecution 도 한개 생성 -> 재시작 불가능
2. Job이 실패 -> BatchStatus = FAILED -> JobInstance 는 한개 JobExecution 도 한개 생성 -> 재시작 가능
만약 2번 Job을 다시 실행한다면 JobInstance는 변함없지만 JobExecution 이 하나 더 생성 된 모습을 볼 수 있습니다.
여기까지 Job 과 관련된 실행 정보, 상태 정보를 위한 JobInstance, JobParameter, JobExecution에 대해서 알아봤습니다. 다음 포스팅에서는 Step에 관련된 포스팅을 진행하도록 하겠습니다.
스프링 배치 도메인 이해 : Step, StepExecution
본 포스팅은 인프런의 정수원님의 스프링 배치 강의를 듣고 정리한 포스팅입니다. 더 자세한 내용은 강의를 참고해주세요.
Step
기본 개념
• Batch Job을 구성하는 독립적인 하나의 단계로서 실제 배치 처리를 정의하고 컨트롤 하는 데 필요한 모든 정보를 가지고 있는 도메인 객체
• 단순한 단일 테스크 뿐 아니라 입력과 처리 그리고 출력과 관련된 복잡한 비즈니스 로직을 포함하는 모든 설정들을 담고 있다.
• 배치 작업을 어떻게 구성하고 실행할 것인지 Job의 세부 작업을 Task 기반으로 설정하고 명세해 놓은 객체
• 모든 Job은 하나 이상의 Step으로 구성됨
기본 구현체
• TaskletStep
가장 기본이 되는 클래스로서 Tasklet 타입의 구현체들을 제어한다.
• PartitionStep
멀티 스레드 방식으로 Step을 여러개로 분리해서 실행한다.
• JobStep
Step내에서 Job을 실행하도록 한다.
• FlowStep
Step내에서 Flow를 실행하도록 한다.
그럼 이제 Step에 대해서 구조를 살펴보도록 하겠습니다.
Step 안에는 execute라는 메서드가 있고 이 메서드는 Step을 실행하는 역할을 합니다. 실행 결과 상태는 StepExecution에 저장됩니다.
Step 인터페이스를 구현한 추상 클래스인 AbstractStep에는 name, startLimit 등 다양한 필드가 존재합니다.
Job에 대해 좀 더 직관적인 구조도를 보겠습니다.
Job은 execute 메서드를 통해 Step을 실행합니다. Step 또한 execute를 이용해 tasklet을 실행합니다. tasklet 안에는 ItemReader, ItemProcessor, ItemWriter가 존재합니다. 이 세가지 도메인은 추후에 chunk 지향 처리 부분에서 따로 다루도록 하겠습니다.
간단하게 먼저 설명해드리자면 ItemReader는 데이터를 데이터베이스, 파일, json 등등에서 읽어오는 역할을 합니다. ItemProcessor는 이렇게 가져온 데이터를 비즈니스 로직에 맞춰 가공하는 역할을 합니다. ItemWriter는 가공된 데이터를 다시 저장하는 역할을 합니다.
이렇게 설계하면 객체지향스럽게 만들 수 있고 chunk 지향 처리에서 chunk 단위로 데이터를 가공할 때 유용한 모델입니다. 하지만 비즈니스 로직이 단순하거나 지금처럼 도메인의 구조를 이해하는 데는 굳이 ItemReader, ItemProcessor, ItemWriter로 나눌 이유가 없습니다. 때문에 지금은 tasklet으로만으로 이루어진 Step을 사용할 예정입니다.
하지만 tasklet 또한 만능은 아닌데요. 위에서 대충 짐작 하셨겠지만 chunk를 사용하고 싶다면 ItemReader, ItemProcessor, ItemWriter 이 세가지의 도메인을 사용해야 합니다. 이는 다시 말해서 tasklet을 사용한다면 chunk를 사용할 수 없습니다.
대용량 처리에 특화된 스프링 배치에서 chunk 기반의 처리를 하지 않는다는 것은 매우 이상합니다. 때문에 실무에서는 chunk 지향 처리를 많이 사용합니다.
*주의*
tasklet을 직접 생성하는 것과 chunk 지향 처리, 이 둘이 같을까요? 다를까요?
겉으로 보기엔 달라보입니다. 한쪽은 tasklet을 직접 생성해서 해당 메서드 안에 모든 로직을 다 때려 박았고 한쪽은 ItemReader, ItemProcessor, ItemWriter 이 세가지 도메인으로 작업을 쪼갰으니까요
하지만 이 둘은 같습니다. 위의 그림에서 보시다시피 Step의 구현체가 여러개 있는데 tasklet을 직접 생성하는 것과 chunk 지향 처리를 하는 것은 둘 다 TaskletStep 이라는 구현체로 구현됩니다.
StepExecution
기본 개념
• Step에 대한 한번의 시도를 의미하는 객체로서 Step 실행 중에 발생한 정보들을 저장하고 있는 객체
시작시간, 종료시간, 상태 (시작됨, 완료, 실패), commit count, rollback count 등의 속성을 가짐
• Step이 매번 시도될 때마다 생성되며 각 Step 별로 생성된다.
• Job이 재시작 하더라도 이미 성공적으로 완료된 Step은 재 실행되지 않고 실패한 Step만 실행된다.
• 이전 단계 Step이 실패해서 현재 Step을 실행하지 않았다면 StepExecution을 생성하지 않는다. Step이 실제로 시작됐을 때만 StepExecution을 생성한다.
• JobExecution 과의 관계
Step의 StepExecution이 모두 정상적으로 완료되어야 StepExecution이 정상적으로 완료된다.
• Step의 StepExecution중 하나라도 실패하면 JobExecution은 실패한다.
BATCH_STEP_EXECUTION 테이블과 매핑
• JobExecution과 StepExecution은 1 : N 관계
• 하나의 Job에 여러개의 Step으로 구성했을 경우 각 StepExecution은 하나의 JobExecution을 부모로 가진다.
StepExecution에 대해서 중요한 부분만 다시 체크하면서 넘어가도록 하겠습니다.
우선 StepExecution은 앞선 포스팅에서의 JobExecution과 비슷합니다. Step 하나하나에 대한 실행 단위라는 의미이기도 하죠
Step이 실행될때마다 StepExecution이 생성됩니다. Job이 실행될때마다 생성되는 JobExecution과 닮은 구석이 있죠?
그리고 Job이 재시작 하더라도 이미 성공적으로 완료된 Step은 재실행 되지 않고 실패한 Step만 실행됩니다. 어? 이부분에 대해서 스프링 배치를 조금 공부해보신 분들이라면 어디선가 느낀적 있으실 겁니다. 바로 chunk의 특징이죠
Job이 실패해서 재실행 하는 상황에서 chunk는 이미 처리된 데이터에 한해서는 재실행 하지 않고 실패했던 부분부터 다시 실행합니다. 때문에 앞선 데이터들을 보호하고 메모리도 보호할 수 있죠
하지만 Step의 구조상 후순위 Step을 실행하기 위해서 전단계의 Step이 반드시 실행되어야 하는 경우도 있을 것입니다. 제 포스팅 중 스프링 배치의 특징에 대해 포스팅 한 것에도 나와있지만 스프링 배치는 세부적인 설정까지도 할 수 있게끔 만들어져 있습니다. 따라서 이런 경우에는 allowStartIfComplete 속성을 true로 주면 Step이 재실행 될 때 성공한 Step이더라도 다시 시작할 수 있게끔 할 수 있습니다.
https://coding-review.tistory.com/183
또한, 이전 단계 Step이 실패해서 현제 Step을 실행하지 않았다면 즉, 앞선 Step이 실패해서 후순위 Step이 실행되지 않았다면 해당 StepExecution은 생성되지 않습니다.
이 얘기는 이런 의미입니다. Step1 Step2 Step3 가 있다고 가정하고 Step1은 성공 Step2는 실패 Step3은 실행되지 않았다고 가정합니다.
Step1 성공 -> StepExecution 생성
Step3 실행X -> StepExecution 생성X
여기까진 확실하죠?
그럼 실패한 Step2는 StepExecution이 생성될까요? 안될까요?
정답은 생성 된다 입니다. Step이 실행중에 실패한것이기 때문에 실패한것이 실행한 것보다 뒤에 일어난 일이라는 의미죠 그래서 실행은 됐기 때문에 StepExecution이 생성 됩니다. 다시 정리하면 이렇습니다.
Step1 성공 -> StepExecution 생성
Step2 실패 -> StepExecution 생성
Step3 실행X -> StepExecution 생성X
마지막으로 JobExecution은 StepExecution과 1 : N 관계이기 때문에 StepExecution이 하나라도 실패하면 JobExecution 또한 실패로 마무리 됩니다.
여기까지 Step, StepExecution에 대해서 알아봤습니다. 다음 포스팅에서는 ExecutionContext 에 대해서 알아보는 시간을 가져보도록 하겠습니다. 긴 글 읽어주셔서 감사합니다.
스프링 배치 도메인 이해 : ExecutionContext
본 포스팅은 인프런의 정수원님의 스프링 배치 강의를 듣고 정리한 포스팅입니다. 더 자세한 내용은 강의를 참고해주세요.
ExecutionContext
기본 개념
• 프레임워크에서 유지 및 관리하는 키/값으로 된 컬렉션으로 StepExecution 또는 JobExecution 객체의 상태를 저장하는 공유 객체
• DB에 직렬화 한 값으로 저장됨 - { "key" : "value" }
• 공유 범위
Step 범위 - 각 Step의 StepExecution에 저장되며 Step간 서로 공유 안됨
• Job 범위 - 각 Job의 JobExecution에 저장되며 Job간 서로 공유 안되며 해당 Job의 Step간 서로 공유됨
• Job 재 시작시 이미 처리한 Row 데이터는 건너뛰고 이후로 수행하도록 할 때 상태 정보를 활용한다.
JobInstance나 JobParameter, JobExecution, StepExecution은 어느정도는 직관적이라고 생각했는데... ExecutionContext는 뭐냐?
ExecutionContext는 스프링 배치에서의 세션입니다.
우리는 세션을 어떠한 경우에 사용하는지 복기해보면 됩니다.
세션은 페이지에서 페이지간 이동이 긴 경우 꽤 오랜 시간동안 데이터를 잡아두고 있어야 하는 경우에 사용합니다.
ExecutionContext는 이렇게 배치 내에서 데이터를 유지하고 싶은 경우에 사용합니다. ExecutionContext를 사용할 수 있는 방법은 두가지입니다. tasklet에서 사용하는 방법과 chunk 지향처리에서 사용하는 방법이죠.
tasklet에서 사용하는 방법에 대해서 우선 알아보겠습니다.
tasklet 에서의 ExecutionContext
@Component
public class ExecutionContextTasklet implements Tasklet {
@Override
public RepeatStatus execute(StepContribution contribution, ChunkContext chunkContext) throws Exception {
ExecutionContext jobExecutionContext = chunkContext.getStepContext().getstepExecution().getJobExecution().getExecutionContext();
ExecutionContext stepExecutionContext = chunkContext.getStepContext().getStepExecution().getExecutionContext();
jobExecutionContext.put("name", "name123");
stepExecutionContext.put("age", 25);
return RepeatStatus.FINISHED;
}
}
이렇게 선언한 뒤에는 다른 tasklet에서
ExecutionContext jobExecutionContext = chunkContext.getStepContext().getStepExecution().getJobExecution().getExecutionContext();
ExecutionContext stepExecutionContext = chunkContext.getStepContext().getStepExecution().getExecutionContext();
jobExecutionContext.get("name");
stepExecutionContext.get("age");
이런식으로 뽑아 쓸 수 있습니다.
그런데 왜 ExecutionContext를 두개를 만들었을까요? 둘이 꺼내는 방식도 다르네요.
그 이유는 JobExecution에서 꺼낸 ExecutionContext와 StepExecution에서 꺼낸 ExecutionContext는 같지만 다른 방식으로 작동합니다. 그 이유는 JobExecutionContext의 경우 Commit 시점에 저장되는 반면 StepExecutionContext는 실행 사이에 저장이 되기 때문입니다.
이 내용은 위에서도 언급되어있습니다. 적용 범위가 서로 다르다는 것을요. StepExecutionContext는 Step간 공유가 안됩니다. 다만 JobExecutionContext는 Step간 공유가 됩니다. 따라서 세션처럼 사용하고 싶다면 JobExecutionContext를 사용하는 것이 옳겠습니다.
chunk 지향 처리에서의 ExecutionContext
chunk 지향 처리에서의 ExecutionContext를 사용하는 방법은 조금 귀찮긴 합니다. 하지만 Step간 데이터를 보존해야 하는 경우에는 한번쯤 고려해볼만 합니다.
우선 ExecutionContext를 사용할 수 있는 super 클래스를 만들어야 합니다.
SuperStepExecution.java
package io.sprintbatch.springbatchlecture;
import lombok.Getter;
import lombok.Setter;
import org.springframework.batch.core.StepExecution;
import org.springframework.batch.item.ExecutionContext;
@Getter
@Setter
public class SuperStepExecution<T> {
private StepExecution stepExecution;
protected void putData(String key, T data) {
if (this.stepExecution == null) {
throw new NullPointerException("StepExecution is null");
}
ExecutionContext jobContext = stepExecution.getJobExecution().getExecutionContext();
jobContext.put(key, data);
}
protected Object getData(String key) {
if (this.stepExecution == null) {
throw new NullPointerException("StepExecution is null");
}
ExecutionContext jobContext = stepExecution.getJobExecution().getExecutionContext();
return jobContext.get(key);
}
}
그리고 chunk 지향 처리에 따른 ItemReader, ItemProcessor, ItemWriter에 대한 구현 클래스를 만들어야 합니다. 제가 이번에 사용한 예제에서는 Step1에서 ItemProcessor에서 ExecutionContext에 값을 넣어주고 Step2의 ItemReader에서 값을 꺼내는 형태로 작업했습니다.
먼저 Step1의 ItemProcessor를 구현한 MemberProcessor클래스입니다.
package io.sprintbatch.springbatchlecture.processor;
import io.sprintbatch.springbatchlecture.SuperStepExecution;
import io.sprintbatch.springbatchlecture.entity.Member;
import io.sprintbatch.springbatchlecture.service.MemberService;
import lombok.RequiredArgsConstructor;
import org.springframework.batch.core.StepExecution;
import org.springframework.batch.core.annotation.BeforeStep;
import org.springframework.batch.core.configuration.annotation.StepScope;
import org.springframework.batch.item.ItemProcessor;
import org.springframework.stereotype.Component;
@Component
@StepScope
@RequiredArgsConstructor
public class MemberProcessor extends SuperStepExecution<String> implements ItemProcessor<Member, Member> {
private final MemberService memberService;
@Override
public Member process(Member member) throws Exception {
return memberService.setName(member);
}
@BeforeStep
public void saveStepExecution(StepExecution stepExecution) {
super.setStepExecution(stepExecution);
super.putData("name", "user1");
}
}
그 다음은 Step2의 ItemReader 구현체인 MemberReader클래스입니다.
package io.sprintbatch.springbatchlecture.reader;
import io.sprintbatch.springbatchlecture.SuperStepExecution;
import io.sprintbatch.springbatchlecture.entity.Member;
import io.sprintbatch.springbatchlecture.repository.MemberRepository;
import lombok.RequiredArgsConstructor;
import lombok.extern.slf4j.Slf4j;
import org.springframework.batch.core.StepExecution;
import org.springframework.batch.core.annotation.BeforeStep;
import org.springframework.batch.core.configuration.annotation.StepScope;
import org.springframework.batch.item.ItemReader;
import org.springframework.batch.item.NonTransientResourceException;
import org.springframework.batch.item.ParseException;
import org.springframework.batch.item.UnexpectedInputException;
import org.springframework.stereotype.Component;
import javax.annotation.PostConstruct;
@Component
@StepScope
@Slf4j
@RequiredArgsConstructor
public class MemberReader extends SuperStepExecution<Member> implements ItemReader<Member> {
private boolean isRead;
private final MemberRepository memberRepository;
@PostConstruct
public void init() {
isRead = false;
}
@Override
public Member read() throws Exception, UnexpectedInputException, ParseException, NonTransientResourceException {
Object name = super.getData("name");
log.info("name : {}", name);
return memberRepository.findById(0L).orElse(null);
}
@BeforeStep
public void retrieveInterStepData(StepExecution stepExecution) {
super.setStepExecution(stepExecution);
}
}
chunk 지향 처리에 대한 구현체에서 주의하셔야 할 점은 두가지입니다. 바로 @Component와 @StepScope입니다. 이 두개를 반드시 붙여주셔야 ExecutionContext를 제대로 사용할 수 있습니다. 마치 JobParameter를 이용할 때 @Bean 과 @StepScope, @JobScope 를 붙이는 것과 비슷합니다.
하지만 @StepScope는 ItemReader, ItemProcessor, ItemWriter에 붙이는 어노테이션이고 @JobScope는 Step에 붙이는 어노테이션 이라는 차이점이 있습니다.
이제 구조적으로 분석해보도록 하겠습니다. 우선 각각의 구현 클래스에서는 @BeforeStep 어노테이션을 통해 Step이 시작되기 전 StepExecution을 주입받습니다.
그리고 주입받은 StepExecution을 바탕으로 각각의 값을 저장하거나 가져올 수 있습니다.
이렇게 저장한 뒤 Job에서 의존성 주입으로 해당 구현체들을 주입한 후 Job을 실행해보면 다음과 같이 로그가 찍히는 것을 확인할 수 있습니다.

이로써 각기 다른 Step에서 데이터를 보존할 수 있었습니다.
JobExecutionListener, StepExecutionListener를 이용한 (SpEL을 이용한) ExecutionContext
우선 LIstener를 설정해줍니다. Listener에 대해서는 추후에 포스팅 하겠지만 지금은 그냥 Job이나 Step이 시작하기 전과 끝난 후에 작업할 수 있는 용도로 쓰인다고만 알아주셔도 충분합니다.
Listener를 설정하는 방법은 다음과 같습니다.
먼저 Listener 클래스를 만듭니다.
package io.sprintbatch.springbatchlecture.listener;
import org.springframework.batch.core.ExitStatus;
import org.springframework.batch.core.StepExecution;
import org.springframework.batch.core.StepExecutionListener;
public class CustomStepListener implements StepExecutionListener {
@Override
public void beforeStep(StepExecution stepExecution) {
stepExecution.getJobExecution().getExecutionContext().put("name2", "user2");
}
@Override
public ExitStatus afterStep(StepExecution stepExecution) {
return null;
}
}
JobExecutionListener를 만들던 StepExecutionListener를 만들던 사용방법은 똑같습니다. 편하신 것으로 만들어주시면 됩니다.
위와 같이 클래스를 만들어주고 Step이 있는 곳으로 갑니다. 그리고 다음과 같이 설정해줍니다.
이 다음 @StepScope, @JobScope와 @Bean을 붙여줍니다. @StepScope는 ItemReader, ItemProcessor, ItemWriter, tasklet에 붙이는 어노테이션이고 @JobScope는 Step에 붙이는 어노테이션입니다.
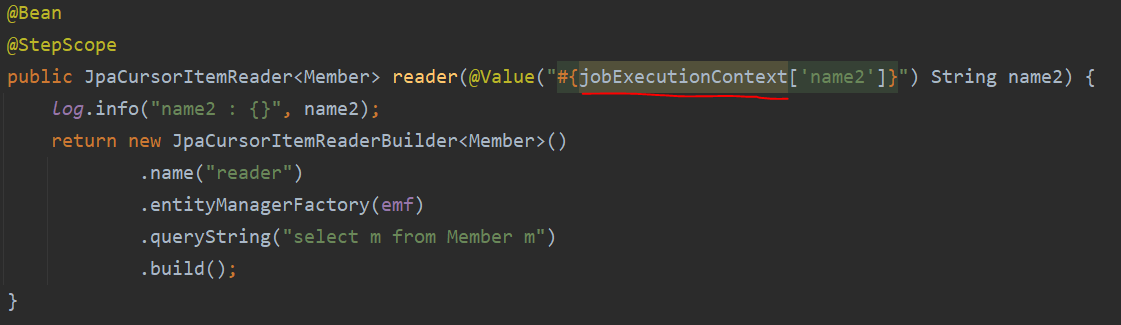
이렇게 설정하면 끝입니다. 이 후에 Job을 실행해보면?

위와 같이 로그가 찍히는 것을 볼 수 있습니다.
이렇게 ExecutionContext에 대해서 알아봤습니다. 흠... 이건 써먹을곳이 있을것 같으면서도 안쓸것 같으면서도 아리송하네요.
긴 글 읽어주셔서 감사합니다. 다음에는 JobLauncher, JobRepository에 대해서 포스팅 해보겠습니다. 감사합니다.
Reference
https://wckhg89.github.io/archivers/springbatch1
스프링 배치 도메인 이해 : JobRepository, JobLauncher
본 포스팅은 인프런의 정수원님의 스프링 배치 강의를 듣고 정리한 포스팅입니다. 더 자세한 내용은 강의를 참고해주세요.
JobRepository
기본 개념
• 배치 작업 중의 정보를 저장하는 저장소 역할
• Job이 언제 수행되었고, 언제 끝났으며, 몇 번이 실행되었고 실행에 대한 결과 등의 배치 작업의 수행과 관련된 모든 meta data를 저장함
JobLauncher, Job, Step 구현체 내부에서 CRUD 기능을 처리함
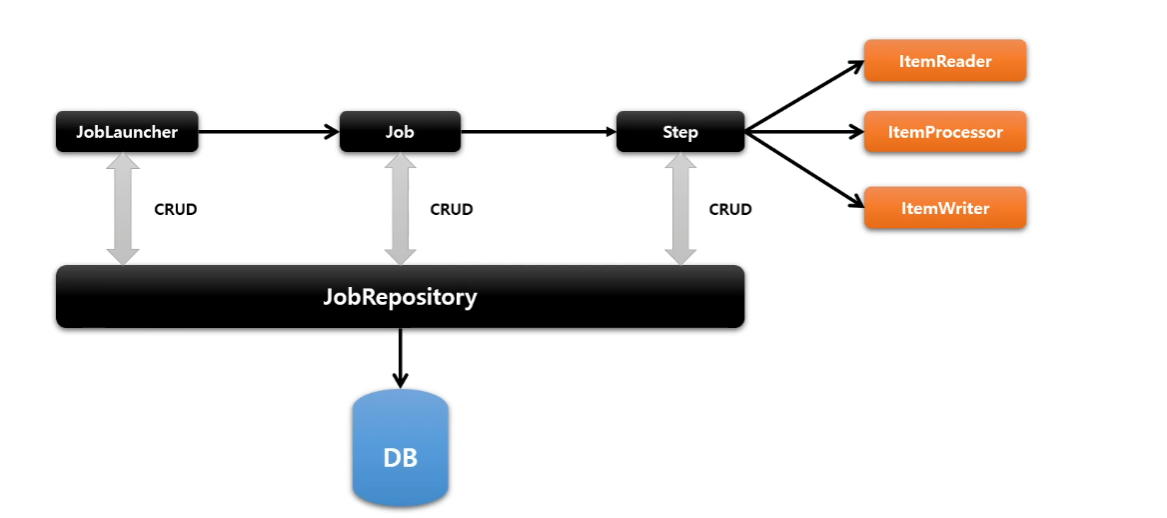
JobRepository는 JobLauncher, Job, Step 구현체 내부에서 CRUD 기능을 처리한다고 했는데 구체적으로 어떤 내용을 처리하는 걸까요?
우선 JobLauncher에서는 job_name과 job_parameter를 가지고 JobInstance를 조회해봅니다. 그리고 조회가 된다면 (중복되는 JobInstance가 있다면) 에러를 던져버리죠, 또한 JobExecution을 조회할 때도 마찬가지입니다.
Job에서는 JobInstance, JobExecution, JobExecutionContext 등을 조회하고 저장하는 데 JobRepository가 사용됩니다. Stiep에서도 마찬가지로 StepExecution, StepExecutionContext 등을 조회하고 저장하는 데 사용됩니다.
JobInstance, JobExecution, JobExecutionContext, StepExecution, StepExecutionContext 에 대한 내용은 이전 포스팅을 참고해주세요. 해당 포스팅에선 위의 내용을 다루지 않습니다.
JobRepository 설정
• @EnableBatchProcessing 어노테이션만 선언하면 JobRepository 가 자동으로 빈으로 생성됨
• BatchConfigurer 인터페이스를 구현하거나 BasicBatchConfigurer 를 상속해서 JobRepository 설정을 커스터마이징 할 수 있다.
JDBC 방식으로 설정 - JobRepositoryFactoryBean
내부적으로 AOP 기술을 통해 트랜잭션 처리를 해주고 있음
• 트랜잭션 isolation 의 기본값은 SERIALIZEBLE로 최고 수준, 다른 레벨로 지정 가능
• 메타 테이블의 Table Prefix 를 변경할 수 있음, 기본 값은 "BATCH"
• In Memory 방식으로 설정 - MapJobRepositoryFactoryBean
성능 등의 이유로 도메인 오브젝트를 굳이 데이터베이스에 저장하고 싶지 않을 경우
• 보통 Test나 프로토타입의 빠른 개발이 필요할 때 사용
JobLauncher
기본 개념
• 배치 Job을 실행시키는 역할을 한다.
• Job과 JobParameters를 인자로 받으며 요청된 배치 작업을 수행한 후 최종 client 에게 JobExecution을 반환함
• 스프링 부트 배치가 구동이 되면 JobLauncher 빈이 자동 생성된다.
• Job 실행
JobLauncher.run(Job, JobParameters)
• 스프링 부트 배치에서는 JobLauncherApplicationRunner 가 자동적으로 JobLauncher를 실행시킨다.
• 동기적 실행
taskExecutor 를 SyncTaskExecutor 로 설정할 경우 (기본 값은 SyncTaskExecutor)
• JobExecution 을 획득하고 배치 처리를 최종 완료한 이후 Client 에게 JobExecution을 반환
• 스케줄러에 의한 배치처리에 적합 함 - 배치 처리 시간이 길어도 상관없는 경우
• 비 동기적 실행
taskExecutor 가 SimpleAsyncTaskExecutor 로 설정할 경우
• JobExecution을 획득한 후 Client 에게 바로 JobExecution을 반환하고 배치처리를 완료한다.
• HTTP; 요청에 의한 배치처리에 적합함 - 배치처리 시간이 길 경우 응답이 늦어지지 않도록 함
기본 개념에서 중요하게 봐야할 부분은 바로 동기적 비동기적 실행입니다.
위에서도 언급되어있지만 동기적 실행은 JobExecution을 획득하고 배치 처리를 최종 완료한 이후 Client 에게 JobExecution을 반환합니다. 비동기적 실행은 JobExecution을 반환하고 배치 처리를 완료하죠.
순서의 문제입니다. 그럼 이 둘의 차이는 무엇일까요?
바로 배치 처리 시간입니다. 배치 처리 시간이 긴 경우 동기적 실행을 하는 것이 적합하고 배치 처리 시간이 길어도 응답이 늦어지지 않도록 하기 위해서는 비동기적 실행이 적합합니다.
이 둘의 차이에 대해 글로만 설명하면 이해하기 힘들 것입니다. 그래서 도식화해서 보도록 하겠습니다.
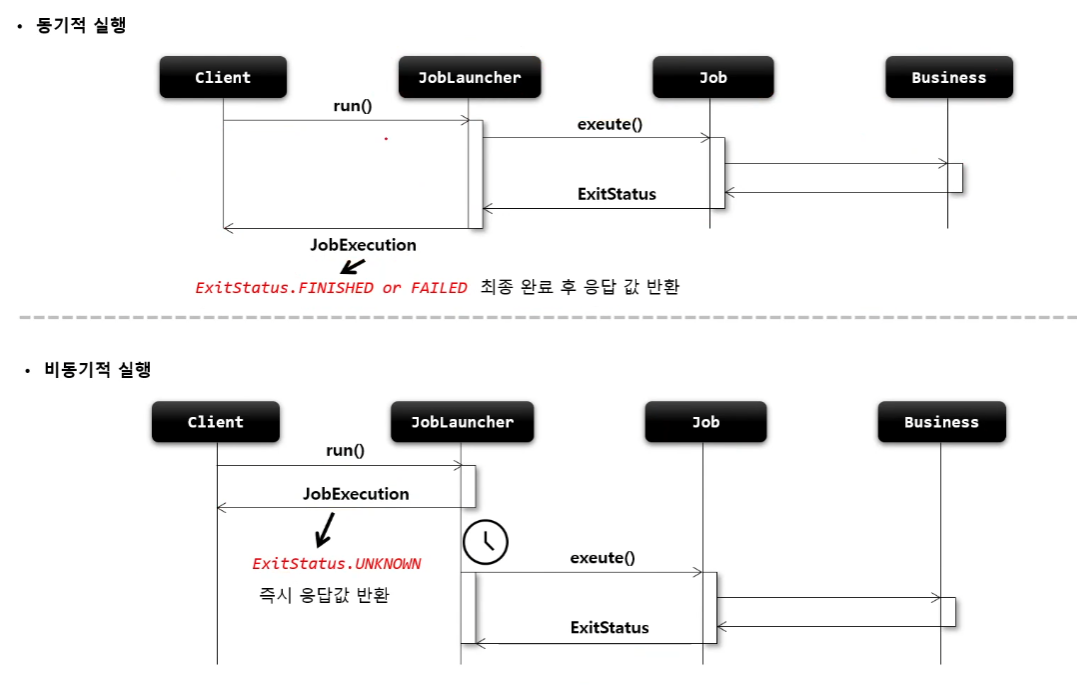
이렇게 보시면 좀 더 이해하기 편할 것입니다.
이렇게 JobRepository와 JobLauncher에 대해서 알아봤습니다. 다음 포스팅에선 @JobScope, @StepScope에 대해 깊게 공부해보는 시간을 갖도록 하겠습니다.
스프링 배치 @JobScope, @StepScope
본 포스팅은 인프런의 정수원님의 스프링 배치 강의를 듣고 정리한 포스팅입니다. 더 자세한 내용은 강의를 참고해주세요.
@JobScope, @StepScope 기본 개념
• Scope
스프링 컨테이너에서 빈이 관리되는 범위
• singleton, prototype, request, session, application 이 있으며 기본은 singleton 으로 생성됨
• 스프링 배치 스코프
@JobScope, @StepScope
Job과 Step의 빈 생성과 실행에 관여하는 스코프
• 프롯기 모드를 기본값으로 하는 스코프 - @Scope(value = "job", proxyMode = ScopedProxyMode.TARGET_CLASS)
• 해당 스코프가 선언되면 빈의 생성이 어플리케이션 구동시점이 아닌 빈의 실행 시점에 이루어진다.
@Values 를 주입해서 빈의 실행 시점에 값을 참조할 수 있으며 일종의 Lazy Binding이 가능해진다.
• @Value("#{jobParameters[파라미터명]}"), @Value("#{jobExecutionContext[파라미터명]}"), @Value("#{stepExecutionContext[파마리터명]}")
• @Values를 사용할 경우 빈 선언문에 @JobScope, @StepScope를 정의하지 않으면 오류를 발생하므로 반드시 선언해야 함
• 프록시 모드로 빈이 선언되기 때문에 어플리케이션 구동시점에는 빈의 프록시 객체가 생성되어 실행 시점에 실제 빈을 호출해준다.
• 병렬처리 시 각 스레드 마다 생성된 스코프 빈이 할당되기 때문에 스레드에 안전하게 실행이 가능하다.
• @JobScope
Step 선언문에 정의한다.
• @Value : jobParameter, jobExecutionContext만 사용 가능
• @StepScope
Tasklet이나 ItemReader, ItemProcessor, ItemWriter 선언문에 정의한다.
• @Value : jobParameter, jobExecutionContext, stepExecutionContext 사용 가능
Scope는 스프링 컨테이너에서 빈이 관리되는 범위인데 우리에게 익숙한 내용은 아마 빈 생성주기에서 다루던 내용일겁니다.
보통 빈 생성주기에는 singleton, prototype, request, session, application이 있습니다.
스프링 배치에서는 이러한 빈 생성주기에 두가지가 더 추가됩니다. 바로 @JobScope와 @StepScope이죠 즉 @JobScope와 @StepScope는 빈 생성주기와 관련된 내용이라는 것입니다. 때문에 빈 생성과 실행에 관여하는 스코프입니다.
이 @JobScope와 @StepScope에서 눈여겨 봐야 할 점은 바로 해당 스코프가 선언되면 빈의 생성이 어플리케이션 구동시점ㅁ이 아닌 빈의 실행시점에 이루어진다는 것입니다.
빈 생성주기를 공부해보신 분이라면 감이 빨리 잡힐것입니다. 예를들어서 빈 생성주기에 singleton은 어플리케이션 구동시에 생성됩니다. 하지만 request는 request되고 난 후에 빈이 생성되죠
@JobScope, @StepScope도 마찬가지입니다. @JobScope는 Job이 실행될 때, @StepScope는 Step이 실행될 때 빈이 생성됩니다.
스프링 배치를 조금 사용해보신 분들이라면 아마 더 이해하기 편하실건데요. 우리가 SpEL을 이용해서 jobParameter를 사용할 때 @Value를 이용해 주입받는데 이 값을 해당 메서드를 선언할 때는 null값을 넣는것을 기억하실겁니다.
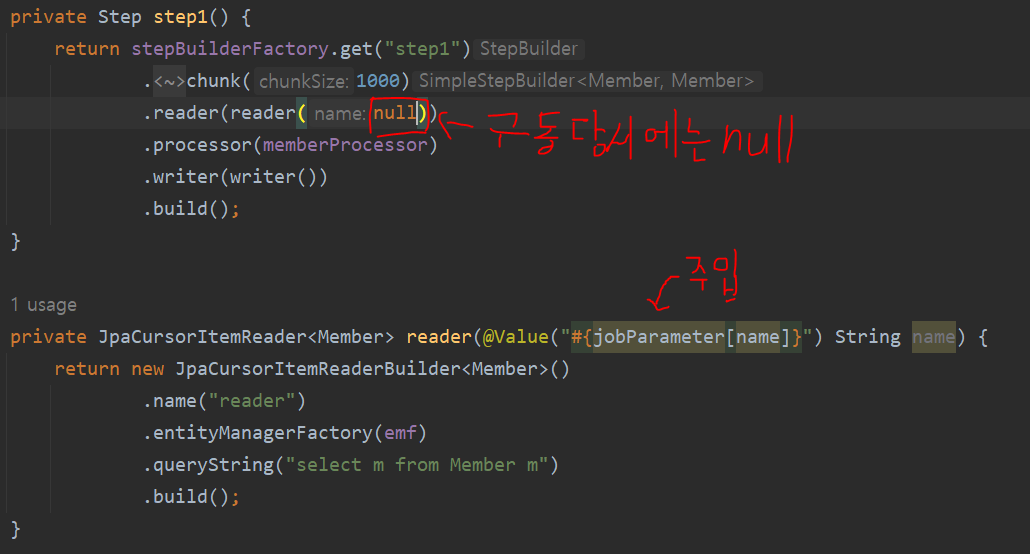
@JobScope, @StepScope 아키텍처
• Proxy 객체 생성
@JobScope, @StepScope 어노테이션이 붙은 빈 선언은 내부적으로 빈의 Proxy 객체가 생성된다.
@JobScope
@Scope(value = "job", proxyMode = ScopedProxyMode.TARGET_CLASS)
• @StepScope
Scope(value = "step", proxyMode = scopedProxyMode.TARGET_CLASS)
• Job 실행 시 Proxy 객체가 실제 빈을 호출해서 해당 메서드를 실행시키는 구조
• JobScope, StepScope
Proxy 객체의 실제 대상이 되는 Bean을 등록, 해제하는 역할
• 실제 빈을 저장하고 있는 JobContext, StepContext를 가지고 있다.
• JobContext, StepContext
스프링 컨테이너에서 생성된 빈을 저장하는 컨텍스트 역할
• Job의 실행 시점에서 프록시 객체가 실제 빈을 참조할 때 사용됨
@JobScope, @StepScope가 붙은 빈은 내부적으로 실제 객체가 아닌 Proxy 객체가 생성됩니다. 이는 흔히 알려지기로는 AOP 방식이라고 얘기합니다.
왜 이렇게 작동할 수 밖에 없는지는 뒤에서 설명해드리도록 하겠습니다.
JobScope, StepScope가 실제 빈을 저장하고 있는 JobContext, StepContext를 가지고 있다는 의미는 바로 ApplicationContext와 같은 일을 한다고 볼 수 있습니다.
ApplicationContext는 우리가 만든 빈을 저장하고 관리하는 역할을 하고 필요하다면 해당 빈을 꺼내 쓸 수도 있습니다. 이러한 역할과 비슷하게 JobContext, StepContext가 한다고 이해하시면 되겠습니다.
스프링 배치에서 Proxy객체로 만들어진 빈은 ApplicationContext로 참조하는 것이 아니라 JobContext, StepContext에서 참조하면 됩니다.
스프링 배치가 실행될 때 @JobScope, @StepScope 는 다음과 같은 방식으로 구동됩니다.
1. 우선 어플리케이션이 구동되면 ApplicationContext가 작동합니다. 그리고 빈을 만듭니다. 그때 @JobScope, @StepScope가 붙어있는지 확인합니다.
2. 안붙어있다면 singleton bean으로 빈을 만듭니다. 이때 @Value가 붙어있다면 오류가 발생합니다.
3. 붙어있다면 Proxy 객체로 빈을 생성합니다.
4. 그 후 스프링 초기화가 완료되고 JobLauncher에 의해 Job이 실행됩니다. 이때 Job은 프록시 객체를 저장하고 있습니다.
5. 프록시 객체는 실제 메소드를 호출 시 실제 빈 객체를 참조하는데 이 시점에 빈이 생성됩니다.
6. 프록시 객체는 실제 빈을 등록하고 관리하는 JobScope를 통해 실제 빈을 관리합니다.
7. 이후 JobContext에서 빈이 존재하면 JobContext에서 빈을 꺼냅니다. 그리고 실행을 시킵니다. 존재하지 않으면 스프링의 BeanFactory를 통해 해당 빈을 생성합니다. 이 시점에 해당 메소드를 실제로 실행합니다. 그리고 이때 @Value를 바인딩합니다.
7-1. 빈이 존재하지 않은 경우 BeanFactory를 이용해 빈을 생성하고 JobContext에 해당 빈을 저장하고 JobScope에서 관리합니다.
이를 그림으로 나타내면 다음과 같습니다. 그림으로 보시는게 좀 더 큰 그림을 이해하는데 도움이 될겁니다.
그럼 개인적인 궁금증이긴 하지만 조금 궁금해집니다. 왜 AOP를 선택했을까?
개인적인 추측이지만 아마 동적으로 @Value를 바인딩하기 위해 그런것이 아닐까 생각이 듭니다. 음...간단하게 제 생각을 말해보자면
예를 들어서 JobParameter를 사용한다고 가정합니다.
JobParameter를 선언하는 부분이 어딜까요? 바로 JobLauncher를 이용해 run 메소드를 호출할 때입니다. 이 말은 JobLauncher를 이용해 잡이 한번 run 되어야 한다는 의미입니다.
하지만 일반적인 ApplicationContext를 사용한다면 어플리케이션이 구동되자마자 빈들이 등록됩니다.
그렇다면 순서가 이렇게 됩니다.
1. ApplicationContext 가동 (빈 생성) @Bean이 붙어있는 그리고 @JobScope, @StepScope가 붙어있는 빈도 생성하겠죠
2. 그리고 이 다음 JobLauncher로 Job이 run 됩니다. 그럼 이때 JobParameter가 생성되겠죠
3. 실제 객체가 실행됨에따라 JobParameter를 바인딩 하려고 합니다. 근데 이미 Step이나 다른 ItemReader나 ItemProcessor나 ItemWriter 빈이 생성되어있습니다. JobParameter는 null이겠죠
4. 따라서 이렇게 작동되면 JobParameter를 SpEL로 주입받아서 사용할 수가 없습니다.
때문에 Proxy 객체를 이용하는 것입니다.
1. ApplicationContext 가동 (빈 생성) @Bean이 붙어있는 빈을 생성합니다.
2. Proxy 객체로 가짜 빈을 생성해두고 다음으로 넘어갑니다.
3. JobLauncher를 이용해 run이 됩니다. 이때 JobParameter가 생성됩니다.
4. 이제 실제 객체를 실행합니다. 이때 실제 객체를 실행하면서 JobParameter를 바인딩합니다.
5. 그럼 JobParameter를 사용할 수 있습니다.
대충 이런 느낌때문에 프록시를, AOP를 이용하는게 아닌가 싶습니다. 단순한(?) 순서 문제 때문에 이런 방식을 사용하는 것 같습니다.
이렇게 @JobScope, @StepScope에 대해 깊게 알아봤습니다. 이정도로 깊게 공부하니 뭔가 마음이 꽉 찬거같이 뿌듯하네요. 긴 글 읽어 주셔서 감사합니다. 다음 포스팅은 chunk 지향처리에 대해 알아보도록 하겠습니다.
Chunk 지향 처리 : Chunk, ChunkProvider, ChunkProcessor
본 포스팅은 인프런의 정수원님의 스프링 배치 강의를 듣고 정리한 포스팅입니다. 더 자세한 내용은 강의를 참고해주세요.
Chunk
기본 개념
• Chunk 란 여러 개의 아이템을 묶은 하나의 덩어리, 블록을 의미
• 한번에 하나씩 아이템을 입력 받아 Chunk 단위의 덩어리로 만든 후 Chunk 단위로 트랜잭션을 처리함, 즉, Chunk 단위의 Commit 과 Rollback 이 이루어짐
• 일반적으로 대용량 데이터를 한번에 처리하는 것이 아닌 청크 단위로 쪼개어서 더 이상 처리할 데이터가 없을 때까지 반복해서 입출력하는데 사용됨
• Chunk<I> vs Chunk<O>
Chunk<I>는 ItemReader로 읽은 하나의 아이템을 Chunk 에서 정한 개수만큼 반복해서 저장하는 타입
• Chunk<O>는 ItemReader로부터 전달받은 Chunk<I> 를 참조해서 ItemProcessor에서 적절하게 가공, 필터링 한 다음 ItemWriter 에 전달하는 타입
우선 Chunk에 대해서 간단하게 설명해보도록 하겠습니다.
Chunk는 간단하게 설명해서 트랜잭션 커밋을 이루는 단위입니다.
너무 대충 설명했나요?
트랜잭션은 트랜잭션의 특징(ACID) 중에 A에 해당하는 Atom 즉 원자성을 보장해야 합니다. 예를 들어서 10건의 데이터가 있으면 5건까지는 잘 되다가 6건째부터 갑자기 예외가 터져서 프로그램이 다운됐다. 그럼 5건의 데이터만 완료되고 나머지 5건의 데이터는 완료되지 않은 상황이 벌어집니다. 이건 꽤 큰일이죠
엥 그게 왜? 라고 하신다면 아직 트랜잭션에 대해 감이 없으신것입니다.
예를 들어서 10명의 사원에게 월급을 보내는 로직이라고 가정해봅시다. 자 사원 1부터 순서대로 10까지 300만원의 월급이 들어갑니다. 근데 5명의 월급은 정상적으로 들어갔는데 6번째에서 예외가 터져서 나머지 5명은 월급이 안들어갔습니다. 이때 우리는 어떻게 해야할까요?
1. 월급을 처음부터 다시 준다.
이 방법은 잘못됐습니다. 그렇게 되면 처음 받았던 5명은 월급을 또 받게 되니까요.
2. 못준 사람에게 월급을 준다.
이 방법도 좋은 방법은 아닐겁니다. 프로그램이 용빼는 재주가 있는 것도 아니고 받았는지 안받았는지 어떤 수로 알까요?
3. 월급 줬던 사람것을 다시 돌려받고 처음부터 다시 준다.
이 방법이 가장 현실적인 방법일 것입니다.
따라서 트랜잭션은 위의 세가지 방법 중에서 3번을 채택하고 있습니다.
자 이제 우리는 트랜잭션의 원자성에 대해서 간단하게 알아봤습니다. 그럼 Chunk가 트랜잭션의 원자성을 보장하기 위한 단위라는 것도 아시겠죠.
하지만 Chunk는 단순히 원자성을 보장해주는 정도의 수준이 아닙니다. Chunk의 매력에 대해서 좀 더 설명해보겠습니다. 그리고 이 매력을 알게 되면 왜 스프링 배치가 대용량 데이터를 관리하는데에 특화됐다고 하는지 아실겁니다.
자 위의 예제는 큰 문제가 있습니다. 만약 10건이 아니라 100만건이라면 어떨까요? 100만건이라면 두가지 문제가 있습니다.
1. 100만건을 모두 메모리에 올린다
JVM이 버텨줄지 모르겠네요...
2. 중간에 끊기는 경우
100만건을 다 메모리에 올렸다고 가정해봅시다. 50만건까지는 잘 이행됐습니다. 하지만 50만1번째에서 예외가 터졌습니다. 그럼 50만건의 성공을 전부 롤백하고 다시 처음부터 시작해야합니다. 이는 다시 1번 문제로 돌아갑니다.
때문에 우리는 Chunk를 이용해서 100만건이라면 Chunk사이즈를 1만건으로 잡아두고 50만건이 쭉쭉 성공하고 51만번째에서 예외가 터졌다면 Chunk사이즈인 1만건에 대해서만 롤백을 하면 됩니다. 이는 더 효율적이죠
Chunk에 대해 조금 이해가 되셨나요?
이제 청크 프로세스에서 프로그래밍적으로 한번 접근해보도록 하겠습니다.
먼저 Source에서 ItemReader를 이용해 Item을 Chunk<I>에 하나씩 쌓습니다. 이때 Soucre는 파일이 될 수도 있고, 데이터베이스가 될 수도 있고, json이 될 수도 있습니다.
Chunk<I>는 내부적으로 가져온 데이터를 List로 저장해 관리합니다. 이 List로 관리되고 있는 데이터들이 Chunk Size에 도달했는지 확인합니다. 도달하지 못했다면 다시 ItemReader로 돌아가 데이터를 하나씩 List에 쌓습니다.
Chunk Size에 도달했다면 List에 있는 데이터를 모아서 ItemProcessor에 넘겨줍니다. ItemProcessor에서는 Iterator로 하나씩 넘겨가며 데이터를 가공합니다.
최종적으로 가공된 Item들은 Chunk<O>에 담아서 내부적으로 List로 정리해서 ItemWriter에게 넘겨줍니다. ItemWriter는 정리된 List를 DB에 저장합니다.
이를 그림으로 표현하면 다음과 같습니다.
이 때 ItemReader와 ItemProcessor는 하나씩 수행되고 ItemWriter에서 Chunk 단위로 일괄 처리됩니다.
ChunkOrientedTasklet
기본 개념
• ChunkOrientedTasklet은 스프링 배치에서 제공하는 Tasklet의 구현체로서 Chunk 지향 프로세싱을 담당하는 도메인 객체
• ItemReader, ItemProcessor, ItemWriter를 사용해 Chunk 기반의 데이터 입출력 처리를 담당한다.
• TaskletStep에 의해서 반복적으로 실행되며 ChunkOrientedTasklet이 실행 될 때마다 매번 새로운 트랜잭션이 생성되어 처리가 이루어진다.
• Exception이 발생할 경우, 해당 Chunk는 롤백 되며 이전에 커밋한 Chunk는 완료된 상태가 유지된다.
• 내부적으로 ITemReader를 핸들링하는 ChunkProvider와 ItemProcessor, ItemWriter를 핸들링하는 ChunkProcessor 타입의 구현체를 가진다.
이러한 구조를 그림으로 보면 이런 형태입니다.
TaskletStep에서부터 ChunkProvider, ChunkProcessor로 이어지는 순서도를 확인하면 다음과 같습니다.
1. 우선 TaskletStep이 ChunkOrientedTasklet으로 execute() 명령을 내립니다.
2. 그 다음 ChunkOrientedTasklet은 ChunkProvider에게 데이터를 읽을 것을 명령합니다 (provide()). 그럼 Chunk Size만큼 반복하면서 데이터를 읽고 Chunk<I>에 저장합니다.
3. Chunk Size 만큼 저장했으면 ChunkOrientedTasklet은 ChunkProcessor에 process(inputs) 명령을 내립니다. 여기서 inputs은 Chunk<I>에 저장된 데이터들입니다.
4. ChunkProcessor는 ItemProcessor를 이용해 Chunk Size만큼 반복하면서 데이터를 가공합니다.
5. 그리고 마지막으로 ChunkProcessor는 ItemWriter에게 데이터 저장을 명령으로 끝이납니다.
이게 한 사이클이고 ChunkOrientedTasklet은 다시 처음으로 돌아와 읽을 데이터가 없을 때까지 해당 사이클을 계속 반복합니다.
ChunkProvider
기본 개념
• ItemReader를 사용해서 소스로부터 아이템을 Chunk Size 만큼 읽어서 Chunk 단위로 만들어 제공하는 도메인 객체
• Chunk<I>를 만들고 내부적으로 반복문을 사용해서 ItemReader.read()를 계속 호출하면서 Item을 Chunk에 쌓는다.
• 외부로부터 ChunkProvider가 호출될 때마다 항상 새로운 Chunk가 생성된다.
• 반복문 종료 시점
Chunk Size만큼 Item을 읽으면 반복문이 종료되고 ChunkProcessor로 넘어감
• ItemReader가 읽은 Item이 null일 경우 반복문 종료 및 해당 Step 반복문까지 종료
• 기본 구현체로서 SimpleChunkProvider와 FaultTolerantChunkProvider가 있다.
구조를 보면 다음과 같이 확인할 수 있다.
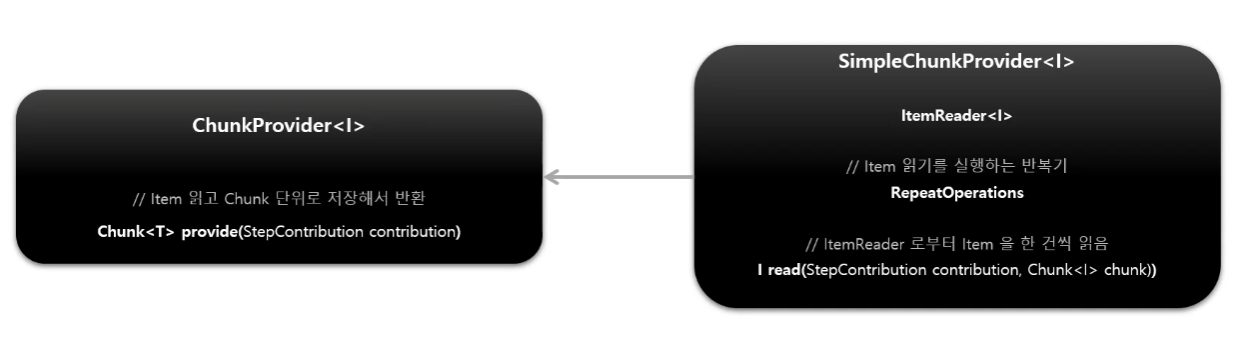
ChunkProvider의 내부 메서드 중 하나인 provide()를 확인해보도록 하겠습니다.
우선 Item을 담을 Chunk<I>를 생성합니다. 그리고 provide() 메소드 호출마다 새롭게 생성됩니다. 그리고 Chunk Size만큼 반복문을 실행하면서 read()를 호출합니다.
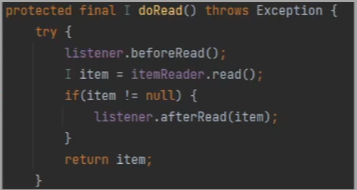
그 후 ItemReader가 Item을 한개 씩 읽어서 리턴합니다.
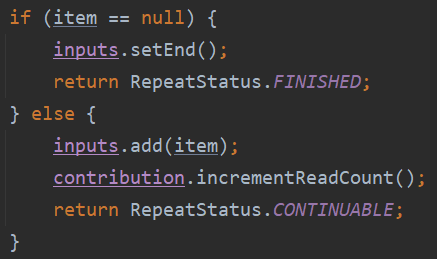
더 이상 읽을 Item이 없는 null 일 경우 반복문 종료 및 전체 Chunk 프로세스를 종료합니다.
이렇게 ChunkProvider가 할 일을 마칩니다.
ChunkProcessor
기본 개념
• ItemProcessor를 사용해서 Item을 변형, 가공, 필터링하고 ItemWriter를 사용해서 Chunk 데이터를 저장, 출력한다.
• Chunk<O>를 만들고 앞에서 넘어온 Chunk<I>의 Item을 한 건씩 처리한 후 Chunk<O>에 저장한다.
• 외부로부터 ChunkProcessor가 호출될 때마다 항상 새로운 Chunk가 생성된다.
• ItemProcessor는 설정 시 선택사항으로서 만약 객체가 존재하지 않을 경우 ItemReader에서 읽은 Item그대로가 Chunk<O>에 저장된다.
• ItemProcessor 처리가 완료되면 Chunk<O>에 있는 List<Item>을 ItemWriter에게 전달한다.
• ItemWriter 처리가 완료되면 Chunk 트랜잭션이 종료하게 되고 Step 반복문에서 ChunkOrientedTasklet이 새롭게 생성된다.
• ItemWriter는 Chunk Size 만큼 데이터를 Commit 처리하기 때문에 Chunk Size는 곧 Commit Interval (커밋 주기) 이 된다.
• 기본 구현체로서 SimpleChunkProcess or와 FaultTolerantChunkProcessor가 있다.
ChunkProcessor 의 구조를 확인하면 다음과 같습니다.
ChunkProcessor 의 process 메서드를 한번 확인해보겠습니다.
1. ChunkProvider에서 받은 Chunk<I>를 가지고 아이템 가공 및 저장을 Chunk<O>를 생성합니다.
2. 읽은 아이템 개수만큼 반복하면서 doProcess()를 호출합니다. 이때 ItemProcessor가 없다면 Item을 그대로 반환하고 ItemProcessor가 있다면 process로 가공 후 반환합니다.
3. ItemProcessor로 필터링 된 아이템 개수를 저장하고
4. 가공 처리된 Chunk<O>의 List<Item>을 ItemWriter에게 전달합니다.
5. 마찬가지로 ItemWriter가 없으면 그대로 반환하고 있다면 write메서드를 이용해 Item들을 일괄 처리합니다.
여기까지 Chunk 지향처리 그중에서도 Chunk, ChunkProvider, ChunkProcessor에 대해서 알아봤는데요. 다음 포스팅에선 ItemReader, ItemProcessor, ItemWriter에 대해 자세히 알아보는 시간을 가져보도록 하겠습니다.
스프링 배치 키워드 정리
이제까지 올렸던 키워드들을 바탕으로 정리해보는 시간을 가져보도록 하겠습니다.
스프링 배치 키워드
Job
• Job의 최상위 단위
• 여러개의 Step을 포함하는 컨테이너
• JobBuilderFactory를 이용해 생성 가능
• 여러개의 Job 구현체가 있지만 우리는 그 중 SimpleJob을 메인으로 사용
Step
• tasklet, ItemReader, ItemProcessor, ItemWriter를 포함하는 Job 하나하나의 실행 단위
• StepBuilderFactory를 이용해 생성 가능
• 여러개의 Step 구현체가 있지만 기본적으로 사용되는 것은 tasklet을 사용할 때 생성되는 TaskletStep이 있고 TaskletStep을 상속한 Chunk 지향 처리를 사용할 때 생성되는 ChunkOrientedTasklet이 있다.
JobInstance
• Job이 한번 실행 될 때 생성되고 Job에 대한 정보를 가지고 있는 도메인
• 같은 JobParameter는 같은 JobInstance를 반환, 같은 JobInstance로 두번 이상 실행 시 오류 발생
• job_name과 job_parameter를 합친 해시값으로 같은 JobInstance인지 확인할 수 있음
• BATCH_JOB_INSTANCE 메타 테이블과 매핑
JobExecution
• Job이 실행될 때마다 생성되는 Job의 실행 단위
• 기본적으로는 같은 JobInstance는 실행이 불가능 하지만 실패한 JobExecution 이력이 있는 경우는 같은 JobInstance를 사용할 수 있다.
• BATCH_JOB_EXECUTION 메타 테이블과 매핑
JobParameter
• JobInstance를 구별해주는 인자 값
• JobParameter의 값에 따라 JobInstance가 달라짐
• JobParameter에는 String, Date, Integer, Double 이 네가지 타입만 저장 가능
• BATCH_JOB_EXECUTION_PARAMS 메타테이블과 매핑
StepExecution
• Step이 실행될 때마다 생성되는 Step의 실행 단위
• Step이 실패한다면 BATCH_STEP_EXECUTION 테이블에 실패 이력이 저장 StepExecution이 FAILED가 되고 이어서 JobExecution도 FAILED가 된다. 그래서 최종적으로 Job이 실패로 저장
• BATCH_STEP_EXECUTION 메타테이블과 매핑
ExecutionContext
• 스프링 배치에서 HTTP Session과 같은 역할을 하는 객체
• JobExecution에서 꺼내는 방법 : Step간 공유 가능, Commit시 데이터가 저장되는데 그 때의 값을 꺼내오는 것
• StepExecution에서 꺼내는 방법 : Step간 공유 불가능, Job이 실행시 데이터가 저장되는데 그 때의 값을 꺼내오는 것
• 사용하는 방법이 여러가지인데 tasklet에서 JobExecution, StepExecution을 꺼내 사용하는 방법, Chunk 지향 처리에서 Super클래스를 사용하는 방법, 리스너와 SpEL을 이용해 사용하는 방법 등이 있다.
• DB에 직렬화 된 값으로 저장됨
• DB에 저장할 때 2500자의 제한이 있음
JobRepository
• Job에 대한 실행이력, 실행했을 때의 상태 값을 각종 도메인들의 DB와 매핑해주는 객체
• Job이 언제 수행되었고, 언제 끝났으며, 몇 번이 실행되었고 실행에 대한 결과 등의 배치 작업의 수행과 관련된 모든 meta data를 저장함
JobLauncher
• Job을 실행시키기 위해서만 존재하는 객체
• 구현체인 SimpleJobLauncher를 통해 Job이 run됨
• Job과 JobParameter를 인자값으로 받으며 JobExecution을 반환함
• 동기적 실행 : Job이 전부 완료 되고 JobExecution을 반환함, 스케줄러에 의한 배치 잡에 유용 (배치 처리시간이 길어도 상관 없는 경우)
• 비동기적 실행 : Job이 실행되자마자 JobExecution을 반환함, HTTP 요청에 의한 배치 잡에 유용 (배치 처리시간이 길어지면 안되는 경우)
@JobScope, @StepScope
• 빈 생성주기인 singleton, prototype, request, application 등과 같은 빈 생성과 실행에 관여하는 Scope
• @JobScope는 Step에 선언, @StepScope는 tasklet, ItemReader, ItemProcessor, ItemWriter에 선언
• @Value를 이용해 값을 바인딩
• 해당 어노테이션이 달려있는 빈은 Proxy 객체로 생성되어 @Value의 값을 Lazy Binding 해줌
Chunk
• Chunk는 트랜잭션의 원자성을 보장해주는 데이터 처리 단위
• Chunk<I>와 Chunk<O>를 이용해 값을 전달
• Chunk<I> : ItemReader를 이용해 값을 하나씩 담아놓는 공간
• Chunk<O> : ItemReader를 이용해 담아온 데이터를 ItemProcessor에 넘겨 데이터를 가공하는데에 쓰이는 공간
ChunkProvider
• ItemReader를 이용해 Chunk Size만큼 반복해 Chunk<I>에 데이터를 쌓는 작업을 하는 객체
• ChunkProvider가 호출될 때마다 새로운 Chunk가 생성됨
ChunkProcessor
• ChunkProvider가 생성한 Chunk<I>를 가지고 ItemProcessor와 ItemWriter를 이용해 데이터를 가공하고 저장하는 작업을 하는 객체
• Chunk Size만큼 반복하면서 ItemProcessor로 작업 수행
• ItemReader, ItemProcessor에서는 Chunk Size만큼 반복하며 하나씩 실행하는 반면 ItemWriter는 Chunk Size만큼 일괄 처리
Chunk 지향 처리 : ItemReader, ItemProcessor, ItemWriter 개요
본 포스팅은 인프런의 정수원님의 스프링 배치 강의를 듣고 정리한 포스팅입니다. 더 자세한 내용은 강의를 참고해주세요.
ItemReader
기본 개념
• 다양한 입력으로부터 데이터를 읽어서 제공하는 인터페이스
플랫(Flat) 파일 - csv, txt (고정 위치로 정의된 데이터 필드나 특수문자로 구별된 데이터의 행)
• XML, Json
• Database
• JMS, RabbitMQ 와 같은 Message Queuing 서비스
• Custom Reader - 구현 시 멀티 스레드 환경에서 스레드에 안전하게 구현할 필요가 있음
• ChunkOrientedTasklet 실행 시 필수적인 요소로 설정해야 한다.
구조
• T read()
입력 데이터를 읽고 다음 데이터로 이동한다.
• 아이템 하나를 리턴하며 더 이상 아이템이 없는 경우 null 리턴
• 아이템 하나는 파일의 한줄, DB의 한 row 혹은 XML 파일에서 하나의 엘리먼트가 될 수 있다.
• 더 이상 처리해야 할 Item이 없어도 예외가 발생하지 않고 ItemProcessor 와 같은 다음 단계로 넘어간다.
ItemProcessor
기본 개념
• 데이터를 출력하기 전에 데이터를 가공, 변형, 필터링하는 역할
• ItemReader 및 ItemWriter 와 분리되어 비즈니스 로직을 구현할 수 있다.
• ItemReader로 부터 받은 아이템을 특정 타입으로 변환해서 ItemWriter에게 넘겨줄 수 있다.
• ItemReader로 부터 받은 아이템들 중 필터과정을 거쳐 원하는 아이템들만 ItemWriter에게 넘겨줄 수 있다.
ItemProcessor 에서 process() 실행결과 null을 반환하면 Chunk<O> 에 저장되지 않기 때문에 결국 ItemWriter에 전달되지 않는다.
• ChunkOrientedTasklet 실행 시 선택적 요소이기 때문에 청크 기반 프로세싱에서 ItemProcessor 단계가 만드시 필요한 것은 아니다.
구조
• O process
<I> 제네릭은 ItemReader에서 받을 데이터 타입 지정
• ;<O> 제네릭은 ItemWriter에게 보낼 데이터 타입 지정
• 아이템 하나씩 가공 처리하며 null을 리턴할 경우 해당 아이템은 Chunk<O>에 저장되지 않음
ItemWriter
기본 개념
• Chunk 단위로 데이터를 받아 일괄 출력 작업을 위한 인터페이스
플랫(Flat) 파일 - csv, txt
• XML, Json
• Database
• JMS, RabbitMQ와 같은 Message Queuing 서비스
• Mail Service
• Custom Writer
• 아이템 하나가 아닌 아이템 리스트를 전달 받는다.
• ChunkOrientedTasklet 실행 시 필수적 요소로 설정해야 한다.
구조
• void wirte(List<? extends T> items)
출력 뎅디터를 아이템 리스트로 받아 처리한다.
• 출력이 완료되고 트랜잭션이 종료되면 새로운 Chunk 단위 프로세스로 이동한다.
이렇게 Chunk 지향 처리 ItemReader, ItemProcessor, ItemWriter에 대해서 알아봤습니다. 추후에 각각에 대한 내용들에 대해 포스팅할 예정입니다.
여기까지 포스팅 읽어주셔서 감사합니다. 다음 포스팅에선 ItemStream에 대해서 포스팅 하도록 하겠습니다.
Chunk 지향 처리 : ItemReader (심화)
본 포스팅은 인프런의 정수원님의 스프링 배치 강의를 듣고 정리한 포스팅입니다. 더 자세한 내용은 강의를 참고해주세요.
ItemReader에는 다양한 구현체가 존재합니다. Flat File에 대한 구현체도 있고, XML을 읽는 구현체, json에서 읽는 구현체 다양한 구현체가 있습니다.
우리는 그 중에서 DB와 관련된 ItemReader에 대해 본격적으로 공부해볼 것입니다. 그 이유는 기본적으로 Flat File이나 XML이나 json을 읽는 것은 흔하지 않기 때문입니다.
따라서 우리는 이번 포스팅에서 ItemReader의 구현체 중 JbdcCursorItemReader, JpaCursorItemReader, JdbcPagingItemReader, JpaPagingItemReader 이 네가지 구현체에 대해서 알아보도록 하겠습니다.
그럼 시작해보겠습니다.
JdbcCursorItemReader
기본 개념
• Cursor 기반의 JDBC 구현체로서 ResultSet과 함께 사용되며 Datasource에서 Connection을 얻어와 SQL을 실행한다.
• Thread 안전성을 보장하지 않기 때문에 멀티 스레드 환경에서 사용할 경우 동시성 이슈가 발생한다. 때문에 동시성 이슈를 방지하기 위해 별도의 동기화 처리가 필요하다.
API
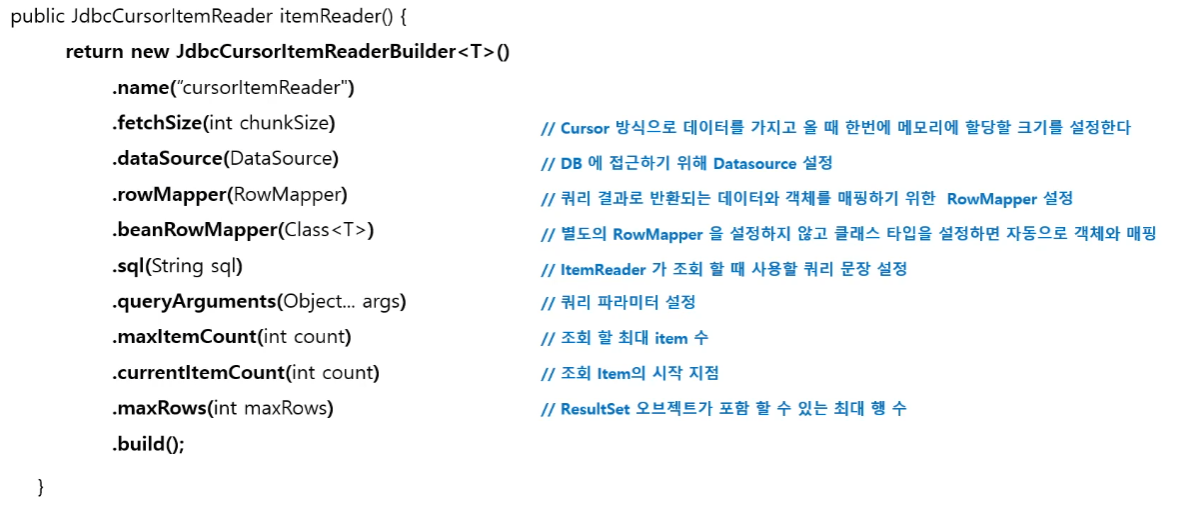
동시성 이슈가 발생한다는게 어떤 느낌이냐면
예를 들어서 Thread 1번이 DB의 데이터에 접근하기 위해 read() 메서드를 호출했습니다. 그렇게 커서 방식으로 첫번째 row 를 가져왔죠.
그 때 Thread 2번이 DB에 동시에 접근합니다. 그렇게 read() 메서드를 호출하면 이 때 동시성 문제가 발생합니다. 바로 똑같은 첫번째 row를 가져오게 되는겁니다.
이런 상황이 발생하지 않기 위해 동기화 처리를 별도로 해줘야 한다는 의미입니다.
작동 순서
• 맨 처음으로 Step이 ItemStream을 open() 메서드를 이용해 엽니다. 이 때 DB Connection과 PreparedStatement, ResultSet 까지 모두 객체를 생성합니다.
• 그 다음 JdbcCursorItemReader 에서 read() 메서드를 통해 객체를 하나씩 DB에서 읽습니다. 이 때 중간에 RowMapper가 ResultSet을 호출하고 DB에서 값을 하나씩 꺼내오는 중개역할을 합니다.
• 2번의 과정이 Chunk Size만큼 계속 반복됩니다.
• 마지막으로 Step이 ItemStream의 close() 메서드를 호출해 ResultSet, PreparedStatement, Connection을 역순으로 닫습니다.
사용 방법
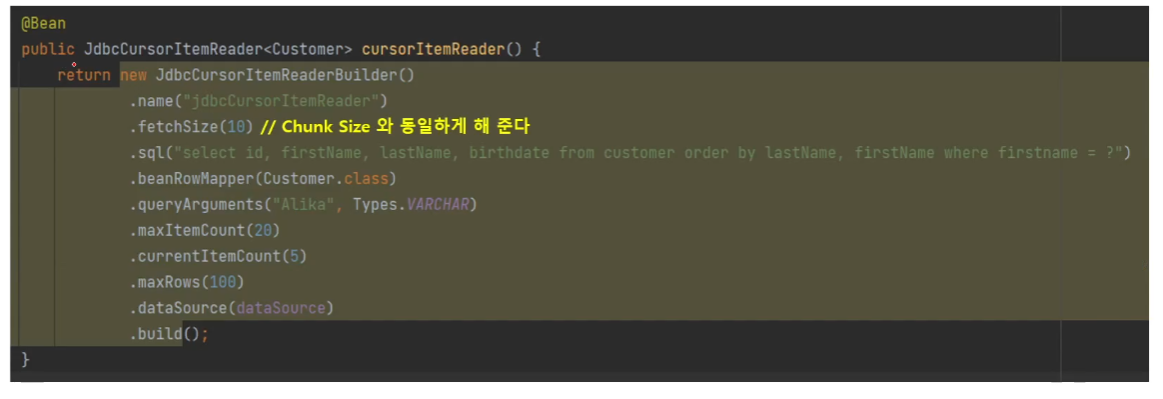
이렇게 하나의 사이클이 완료됩니다. 이후 더 이상 읽을 데이터가 없을 때까지 Chunk Size만큼 반복해서 계속 돌아갑니다.
JpaCursorItemReader
기본 개념
• Spring Batch 4.3 버전부터 지원함
• Cursor 기반의 JPA 구현체로서 EntityManagerFactory 객체가 필요하며 쿼리는 JPQL을 사용한다.
API
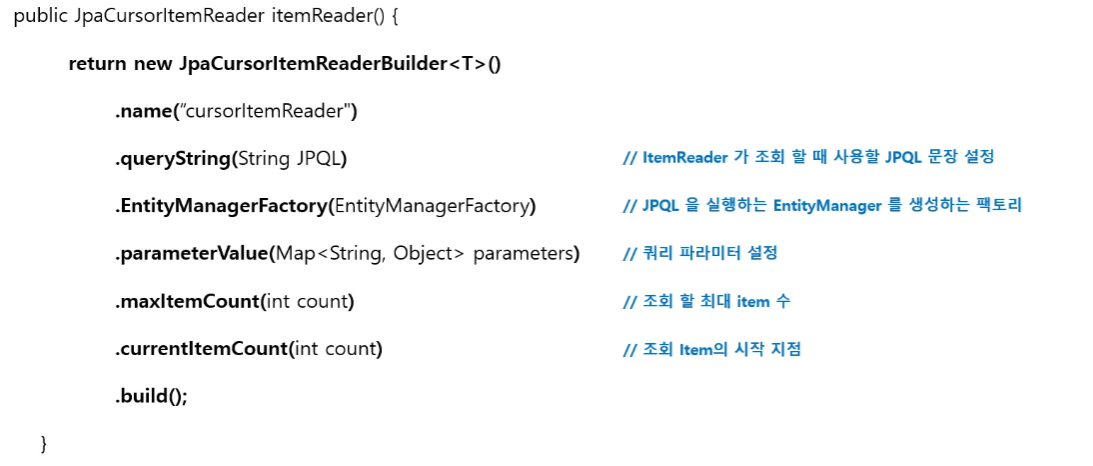
동작 순서
JpaCursorItemReader는 JdbcCursorItemReader와 동작방식이 약간 다릅니다.
• 맨 처음 Step이 ItemStream을 open()메서드를 이용해 엽니다. 그리고 EntityManagerFactory를 가지고 EntityManager를 만듭니다. 그리고 JPQL을 Query로 만들어서 DB에 접근합니다. 그리고 해당되는 값들을 ResultStream에 담아놓습니다.
• 그 이후 JpaCursorItemReader 구현체에서 doRead() 메서드로 ResultStream에 접근해 Iterator로 데이터를 돌리면서 객체를 가져옵니다.
• 2번의 과정이 Chunk Size만큼 Streaming 방식으로 반복됩니다.
• 마지막으로 ItemStream을 close() 메서드로 호출해 EntityManager를 닫습니다.
JdbcCursorItemReader와 다른 점은 우선 ItemStream으로 객체들을 생성할 때 데이터를 전부 가져온다는 점이 있겠습니다.
next()를 호출해서 하나의 row씩 DB에 접근하는 Jdbc와 다르게 Jpa는 next()를 호출할 때 ResultStream에 접근해 Iterator로 데이터를 하나씩 가져옵니다.
그렇기 때문에 JpaCursorItemReader의 API에는 fetchSize를 설정할 수 있는 부분이 빠져있습니다. DB와 연결은 하지만 ResultSet이 DB와 연결하는 부분이 생략되어있기 때문에 그런것으로 추정됩니다.
사용 방법
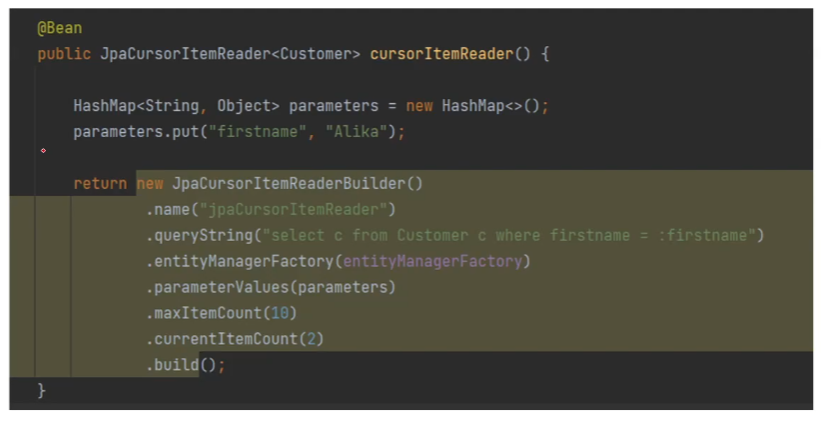
보통은 maxItemCount와 currentItemCount 가 빠져있는 형태로 많이 만듭니다.
JdbcPagingItemReader
기본 개념
• Paging 기반의 JDBC 구현체로서 쿼리에 시작 행 번호 (offset) 와 페이지에서 반환 할 행 수 (limit) 를 정해서 SQL을 실행한다.
• 스프링 배치에서 offset과 limit을 PageSize에 맞게 자동으로 생성해 주며 페이징 단위로 데이터를 조회할 때마다 새로운 쿼리가 실행된다.
• 페이지마다 새로운 쿼리를 실행하기 때문에 페이징 시 결과 데이터의 순서가 보장될 수 있도록 order by 구문이 작성되도록 한다.
• 멀티 스레드 환경에서 Thread 안정성을 보장하기 때문에 별도의 동기화를 할 필요가 없다.
PagingQueryProvider
• 쿼리 실행에 필요한 쿼리문을 ItemReader에게 제공하는 클래스
• 데이터베이스마다 페이징 전략이 다르기 때문에 각 데이터베이스 유형마다 다른 PagingQueryProvider를 사용한다.
• select 절, from 절, sortKey는 필수로 설정해야 하며 where, group by 절은 필수가 아니다.
API
동작 순서
• 첫 번째로 Step이 ItemStream을 open() 메서드를 이용해 열어서 ExecutionContext를 업데이트 합니다.
• 그 다음 Step이 read() 메서드를 이용해 JdbcPagingItemReader에 접근합니다. 그리고 doReadPage()메서드를 이용해 JdbcTemplate을 가지고 쿼리를 날립니다.
• 쿼리에 해당하는 결과를 ResultSet에 담아서 DB에서 next() 메서드를 호출하며 결괏값을 rowMapper를 이용해 List에 담습니다. 그리고 해당 List를 return 합니다.
• 3번의 과정이 ChunkSize만큼 반복됩니다.
• 마지막으로 ItemStream을 close()메서드로 호출해 페이징을 닫습니다.
사용 방법
PagingItemReader는 스레드 세이프하다고 앞에서 설명해드렸는데요 이 부분이 어떻게 구현되어 있을지 한번 확인해보도록 하겠습니다.
synchronized 라는 키워드를 통해 멀티 스레드에서도 안전하게 처리할 수 있도록 처리가 되어있는 모습입니다.
synchronized에 대해 간단하게 설명하자면 여러개의 스레드가 해당 메서드에 접근하더라도 synchronized가 붙어있는 메서드는 하나의 스레드만 들어와서 처리할 수 있습니다.
하나의 스레드가 해당 메서드가 처리될 때까지 lock을 가지고 있고 처리가 완료되면 lock이 풀리는 구조이기 때문에 조금이라도 뒤에 도착한 스레드는 해당 메서드에 접근할 수 없습니다.
JpaPagingItemReader
기본 개념
• Paging 기반의 JPA 구현체로서 EntityManagerFactory 객체가 필요하며 쿼리는 JPQL을 사용한다.
API
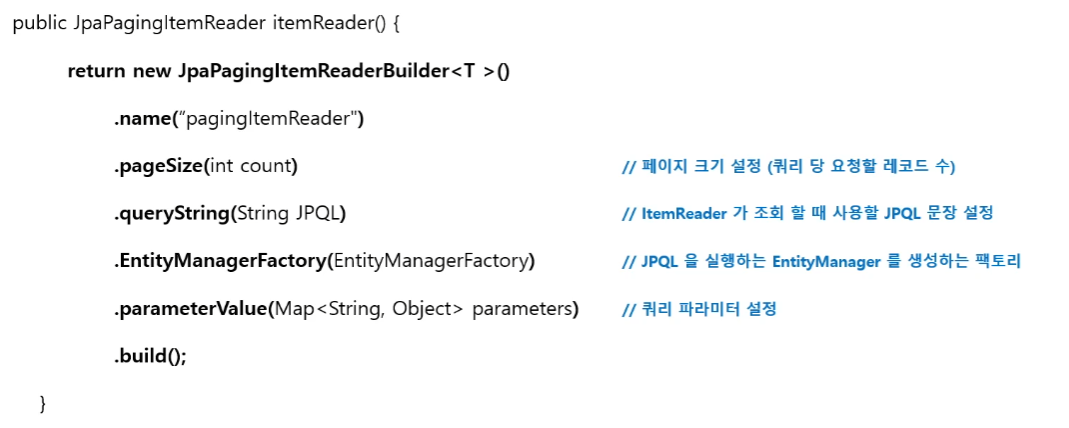
동작 순서
• 첫 번째로 ItemStream에서 oepn()메서드를 이용해 EntityManager를 생성합니다.
• JpapagingItemReader의 read()메서드를 이용해 EntityManager를 참조해서 Query를 만듭니다. 이 Query는 ResultList를 만들어서 반환합니다.
• 2번의 과정이 ChunkSize만큼 반복됩니다.
• 마지막으로 ItemStream에서 EntityManager를 닫습니다.
사용 방법
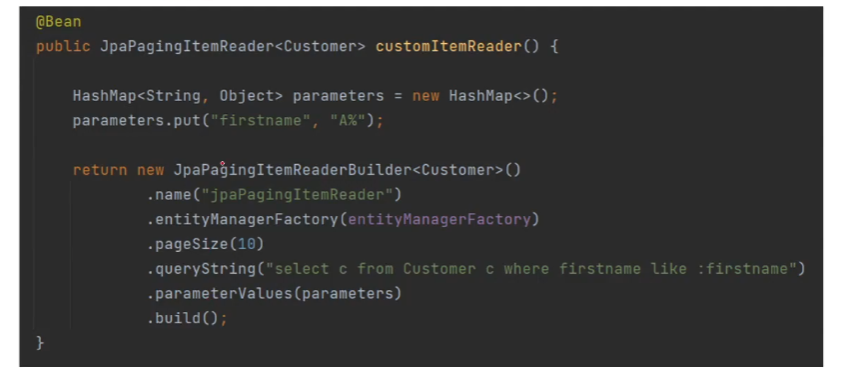
정리
여기까지 JdbcCursorItemReader, JpaCursorItemReader, JdbcPagingItemReader, JpaPagingItemReader 이렇게 네가지의 ItemReader에 대해서 알아봤습니다.
JPA의 API들이 간단하고 단순해서 사용하기 더 용이해 보이는 장점이 있는 것 같습니다. JPA를 사용할 줄 안다면 JPA관련 ItemReader들이 좀 더 쉽게 접근할 수 있을 것 같습니다.
Cursor 기반의 ItemReader와 Paging 기반의 ItemReader의 차이점에 대해서 궁금하신 분은 아래의 링크에서 확인할 수 있습니다.
https://coding-review.tistory.com/181
JDBC나 JPA 모두 쿼리를 직접 적어야 한다는 부담 때문에 사용하기 조금 꺼려질 수도 있습니다. 그럴때는 QuerydslPagingItemReader를 따로 만들어서 해당 문제를 해결하는 방법이 있습니다. 이 내용에 대해서는 향로(jojoldu)님의 "스프링 배치와 Querydsl" 포스팅을 참고해주시면 감사하겠습니다.
https://techblog.woowahan.com/2662/
여기까지 긴 글 읽어주셔서 감사합니다. 다음엔 ItemWriter 심화에 대해 포스팅해보도록 하겠습니다.
Chunk 지향 처리 : ItemWriter (심화)
본 포스팅은 인프런의 정수원님의 스프링 배치 강의를 듣고 정리한 포스팅입니다. 더 자세한 내용은 강의를 참고해주세요.
ItemReader와 마찬가지로 ItemWriter 또한 Flat File이나 XML, json과 같이 데이터를 저장할 수 있지만 분량 관계상 DB와 관련된 JdbcItemWriter, JpaItemWriter 이 두가지에 대해서만 포스팅 할 예정입니다. 이 부분 참고해서 봐주시면 감사하겠습니다.
JdbcBatchItemWriter
기본 개념
• JdbcCursorItemReader 설정과 마찬가지로 DataSource 를 지정하고 SQL 속성에 실행할 쿼리를 설정
• JDBC의 Batch 기능을 사용하여 bulk insert/update/delete 방식으로 처리
• 단건 처리가 아닌 일괄 처리이기 때문에 성능에 이점을 가진다.
JdbcBatchItemWriter의 핵심적인 내용은 bulk로 처리한다는 것입니다. bulk로 처리한다는게 무엇일까요?
JPA를 공부해보신 분들이라면 어떤 내용인지 아시겠지만 그렇지 않은 분들을 위해 간단하게 설명하고 넘어가도록 하겠습니다.
기존의 insert/update/delete 처리방식은 어떤 방식인지 먼저 알아야합니다.
기존의 방식은 예를 들어 1000건의 데이터가 있다고 가정했을 때 한건 한건씩 데이터를 처리했습니다. 그렇게 처리할 때마다 DB Connection에 연결을 해야하고 트랜잭션 처리도 있을 것입니다.
이렇게 1000개를 반복하다 보면 엄청난 리소스 낭비일 것입니다.
bulk 연산은 Chunk Size 만큼 일종의 버퍼를 두고 한번에 insert/update/delete 처리를 한다는 개념으로 받아들이시면 될 것 같습니다.
때문에 리소스 낭비가 적고 위에서 언급한대로 성능상 이점을 가지고 갈 수 있는 것입니다.
API
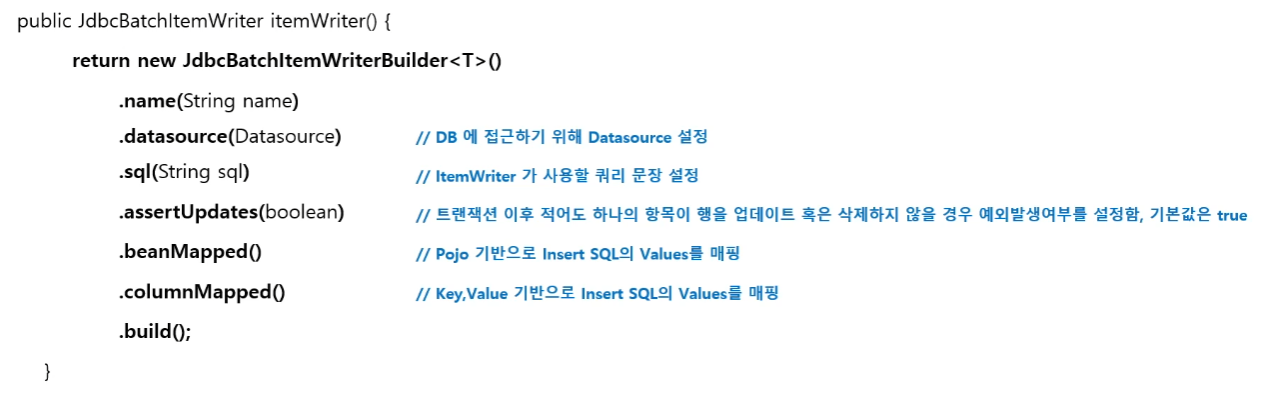
동작 방식
• 우선 Step 과정에서 List로 items 들을 받아오게 될 것입니다. 이렇게 받아온 List들은 JdbcBatchItemWriter에 전달됩니다.
• 넘어오는 items 의 타입이 Map인지 아닌지를 그 다음에 판별하게 됩니다. 만약 Pojo 기반이라면 beanMapped() 메서드를 통해 BeanPropertyItemSqlParameterSourceProvider (좀 기네요 ㅎㅎ..) 를 사용하고 Map 기반이라면 columnMapped() 메서드를 통해 ColumnMapItemPreparedStatementSetter 를 사용합니다.
• 둘 중 하나의 클래스로 SQL문을 받아서 JdbcTemplate이 Batch 처리를 일괄 처리합니다.
JpaItemWriter
기본 개념
• JPA Entity 기반으로 데이터를 처리하며 EntityManagerFactory를 주입받아 사용한다.
• Entity 를 하나씩 chunk 크기 만큼 insert 혹은 merge 한 다음 flush 한다.
• ItemReader 나 ItemProcessor로 부터 아이템을 전달 받을 때는 Entity 클래스 타입으로 받아야 한다.
세 번째 내용이 무슨 내용인지 한번 알아보도록 하겠습니다.
JdbcBatchItemWriter와 다르게 JpaItemWriter는 Map이나 Pojo 클래스로 데이터를 저장할 수 없다는 의미입니다.
그렇다는 얘기는 ItemReader로 값을 받아와서 ItemProcessor로 적당히 Entity 클래스로 변환해주어야 ItemWriter에서 처리할 수 있다는 뜻이겠지요.
그럼 왜 Entity로 받아와야 할까요?
그 이유는 EntityManager가 Item 을 Persist나 merge로 바로 insert 하기 때문입니다. 따라서 ItemWriter에는 반드시 Entity클래스가 넘어와야 합니다.
JdbcBatchItemWriter와 다른 점 중 하나는 JpaItemWriter는 bulk 처리가 안된다는 것을 알 수 있습니다. 따라서 위에서 설명드렸다시피 성능상 큰 단점을 가지고 있습니다.
둘의 성능 차이에 대해서는 포스팅 마지막에 테스트를 통해 수치상으로 확인해보도록 하겠습니다.
API
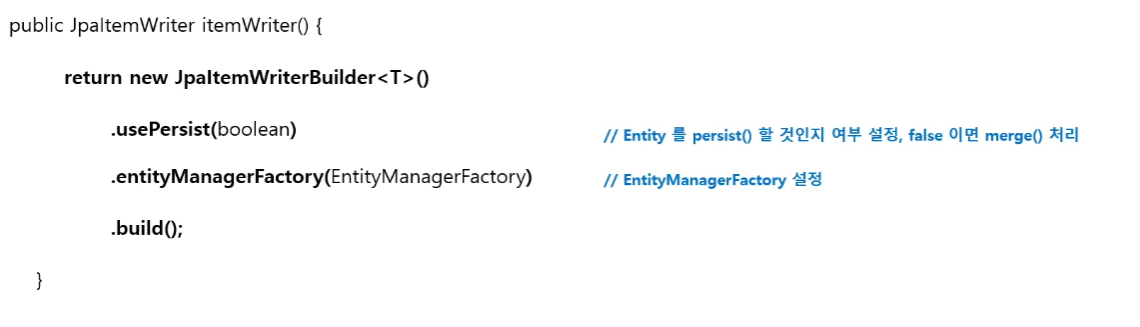
동작 방식
• Step이 Item을 List 형태로 ItemWriter에 전달합니다.
• 그럼 JpaItemWriter는 EntityManager를 통해 값을 저장합니다. 이 때 usePersist 값이 true 면 persist를 false라면 merge를 수행합니다. (기본 값은 true 입니다.)
• 모든 작업이 완료되면 DB에 데이터들을 밀어 넣습니다.
성능 테스트 JdbcBatchItemWriter VS JpaItemWriter
둘의 차이에 대해 성능 테스트를 한번 해보도록 하겠습니다.
우선 사용한 데이터 접근 방식은 Spring Data JPA를 사용했음을 미리 알려드리겠습니다.
먼저 Entity 클래스입니다.
@Getter
@Setter
@Entity
@NoArgsConstructor
public class Member {
@Id @GeneratedValue(strategy = GenerationType.IDENTITY)
@Column(name = "member_id")
private Long id;
private String name;
private int age;
public Member(String name, int age) {
this.name = name;
this.age = age;
}
public Member setName(String name) {
this.name = name;
return this;
}
}
JdbcBatchItemWriter를 사용한 Job 입니다. JdbcWriterJob.java
@Configuration
@RequiredArgsConstructor
public class JdbcWriterJob {
private final JobBuilderFactory jobBuilderFactory;
private final StepBuilderFactory stepBuilderFactory;
private final DataSource dataSource;
private final EntityManagerFactory emf;
private static final int chunk = 1000;
@Bean
public Job jdbcJob() {
return jobBuilderFactory.get("jdbcJob")
.start(jdbcStep())
.build();
}
@Bean
public Step jdbcStep() {
return stepBuilderFactory.get("jdbcStep")
.<Member, Member>chunk(chunk)
.reader(jdbcReader())
.processor(jdbcProcessor())
.writer(jdbcWriter())
.allowStartIfComplete(true)
.build();
}
@Bean
public JpaPagingItemReader<Member> jdbcReader() {
return new JpaPagingItemReaderBuilder<Member>()
.pageSize(chunk)
.entityManagerFactory(emf)
.queryString("select m from Member m")
.name("jdbcReader")
.build();
}
@Bean
public ItemProcessor<Member, Member> jdbcProcessor() {
return member -> {
return member.setName(member.getName() + "test");
};
}
@Bean
public JdbcBatchItemWriter<Member> jdbcWriter() {
return new JdbcBatchItemWriterBuilder<Member>()
.dataSource(dataSource)
.sql("update member set name = :name, age = :age where id = :id")
.build();
}
}
JpaItemWriter를 사용한 Job입니다. JpaWriterJob.java
@Configuration
@RequiredArgsConstructor
public class JpaWriterJob {
private final JobBuilderFactory jobBuilderFactory;
private final StepBuilderFactory stepBuilderFactory;
private final EntityManagerFactory emf;
private static final int chunk = 1000;
@Bean
public Job jpaJob() {
return jobBuilderFactory.get("jpaJob")
.start(jpaStep())
.build();
}
@Bean
public Step jpaStep() {
return stepBuilderFactory.get("jpaStep")
.<Member, Member>chunk(chunk)
.reader(jpaReader())
.processor(jpaProcessor())
.writer(jpaWriter())
.allowStartIfComplete(true)
.build();
}
@Bean
public JpaPagingItemReader<Member> jpaReader() {
return new JpaPagingItemReaderBuilder<Member>()
.entityManagerFactory(emf)
.pageSize(chunk)
.name("jpaReader")
.queryString("select m from Member m")
.build();
}
@Bean
public ItemProcessor<Member, Member> jpaProcessor() {
return member -> {
return member.setName(member.getName() + "test");
};
}
@Bean
public JpaItemWriter<Member> jpaWriter() {
return new JpaItemWriterBuilder<Member>()
.entityManagerFactory(emf)
.build();
}
}
둘의 다른 점은 확인해보시면 아시겠지만 빈 이름과 ItemWriter의 차이만 존재합니다.
테스트를 실행하기 전 미리 10만행의 데이터를 데이터베이스에 적재해둔 상태입니다. 이 10만행으로 둘의 성능 차이를 테스트 해보도록 하겠습니다.
테스트 코드입니다.
@SpringBootTest
public class BatchTest {
@Autowired
MemberRepository memberRepository;
@Autowired
JobLauncher jobLauncher;
@Autowired
JobExplorer jobExplorer;
@Autowired
JdbcWriterJob jdbcWriterJob;
@Autowired
JpaWriterJob jpaWriterJob;
@Test
@DisplayName("jdbcBatchWriterTest")
public void jdbcWriterTest() throws Exception {
jobLauncher.run(
jdbcWriterJob.jdbcJob(), new JobParametersBuilder(jobExplorer)
.addString("requestDate", LocalDateTime.now().toString())
.toJobParameters()
);
}
@Test
@DisplayName("jpaItemWriter")
public void jpaWriterTest() throws Exception {
jobLauncher.run(
jpaWriterJob.jpaJob(), new JobParametersBuilder(jobExplorer)
.addString("requestDate", LocalDateTime.now().toString())
.toJobParameters()
);
}
}
이제 돌려보도록 하겠습니다.
그랬을 때 결과는?
JdbcBatchItemWriter는 0.57초 JpaItemWriter는 33.259초가 걸린 것을 확인할 수 있습니다.
참고로 데이터가 1만행이었을 때는 JdbcBatchItemWriter가 0.13초 JpaItemWriter가 1.1초로 큰 차이가 있진 않았지만 확실히 데이터가 많아지면 많아질수록 더 급격한 차이를 보입니다.
직접 실행해보면서 느낀 점은 확실히 JdbcBatchItemWriter는 쿼리문 자체가 많이 날라가지 않는걸 볼 수 있습니다. 반면에 JpaItemWriter는 update문이 한줄씩 쭉쭉쭉 올라가는 모습을 볼 수 있었습니다.
*주의!
ItemWriter에 대한 단위 테스트가 아닌 통합테스트이므로 단위테스트를 할 경우 조금 다른 결과를 얻을 수 있을 것입니다. 하지만 스프링 배치는 단위 테스트가 굉장히 복잡하기 때문에 통합 테스트로 진행했다는 점 유의해주세요!
오늘은 ItemWriter 그중에서도 DB에 접근하는 JdbcBatchItemWriter, JpaItemWriter에 대해서 알아보고 성능 차이도 테스트 해봤습니다. 여기까지 긴 글 읽어주셔서 감사합니다. 다음엔 ItemProcessor 심화에 대해서 알아보도록 하겠습니다.
멀티 스레드 환경에서의 스프링 배치 (개요)
본 포스팅은 인프런의 정수원님의 스프링 배치 강의를 듣고 정리한 포스팅입니다. 더 자세한 내용은 강의를 참고해주세요.
기본 개념
단일 스레드 vs 멀티 스레드
• 프로레스 내 특정 작업을 처리하는 스레드가 하나일 경우 단일 스레드, 여러 개 일 경우 멀티 스레드로 정의할 수 있다.
• 작업 처리에 있어서 단일 스레드와 멀티 스레드의 선택 기준은 어떤 방식이 자원을 효율적으로 사용하고 성능 처리에 유리한가 하는 점이다.
• 일반적으로 복잡한 처리나 대용량 데이터를 다루는 작업일 경우 전체 소요 시간 및 성능상의 이점을 가져오기 위해 멀티 스레드 방식을 선호한다.
• 멀티 스레드 처리 방식은 데이터 동기화 이슈가 존재하기 때문에 최대한 고려해서 결정해야 한다.
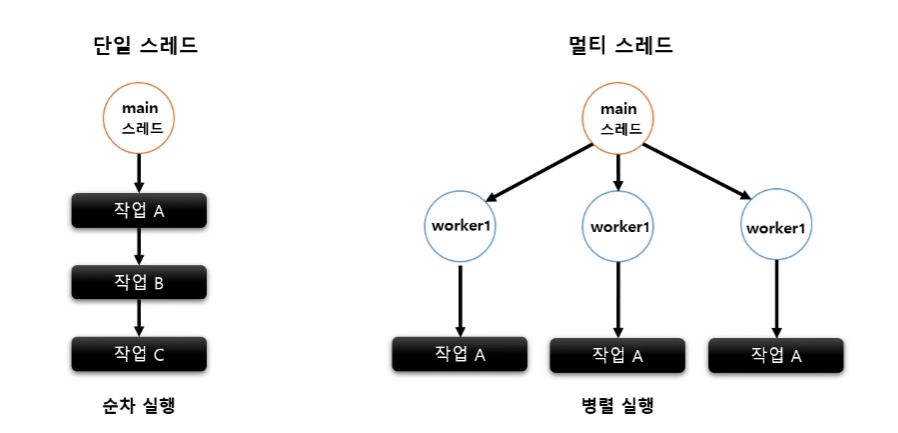
스프링 배치 스레드 모델
• 스프링 배치는 기본적으로 단일 스레드 방식으로 작업을 처리한다.
• 성능 향상과 대규모 데이터 작업을 위한 비동기 처리 및 Scale out 기능을 제공한다.
• Local 과 Remote 처리를 지원한다.
1. AsyncItemProcessor / AsyncItemWriter
• ItemProcessor 에게 별도의 스레드가 할당되어 작업을 처리하는 방식
2. Multi-threaded Step
• Step 내 Chunk 구조인 ItemReader, ItemProcessor, ItemWriter 마다 여러 스레드가 할당되어 실행하는 방법
3. Remote Chunking
• 분산환경처럼 Step 처리가 여러 프로세스로 분할되어 외부의 다른 서버로 전송되어 처리하는 방식
4. Parallel Steps
• Step 마다 스레드가 할당되어 여러개의 Step을 병렬로 실행하는 방법
5. Partitioning
• Master/Slave 방식으로 Master가 데이터를 파티셔닝 한 다음 각 파티션에게 스레드를 할당하여 Slave가 독립적으로 작동하는 방식
멀티 스레드 환경에서의 스프링 배치 : AsyncItemProcessor/AsyncItemWriter
본 포스팅은 인프런의 정수원님의 스프링 배치 강의를 듣고 정리한 포스팅입니다. 더 자세한 내용은 강의를 참고해주세요.
AsyncItemProcessor/AsyncItemWriter
기본 개념
• Step 안에서 ItemProcessor 가 비동기적으로 동작하는 구조
• AsyncItemProcessor와 AsyncItemWriter가 함께 구성이 되어야 함
• AsyncItemProcessor 로부터 AsyncItemWriter 가 받는 최종 결괏값은 List<Future<T>> 타입이며 비동기 실행이 완료될 때까지 대기한다.
• spring-batch-integration 의존성이 필요하다.
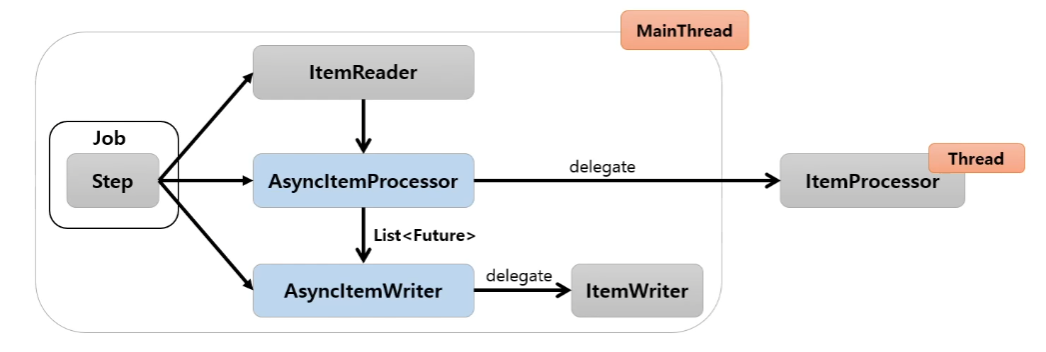
AsyncItemProcessor는 작업 처리를 ItemProcessor에게 맡기고 ItemProcessor는 Async한 작업과정을 거치는 것입니다.
ItemReader는 데이터를 AsyncItemProcessor에 전달하고 AsyncItemProcessor는 ItemProcessor에 작업을 위임합니다. 위임할 때 별도의 스레드로 위임하고 결괏값을 List<Future> 타입으로 받아옵니다.
List<Future>에는 Item이 들어있고 이 Item을 기반으로 AsyncItemWriter가 ItemWriter에게 작업을 위임해서 작업을 마무리 짓습니다.
구조
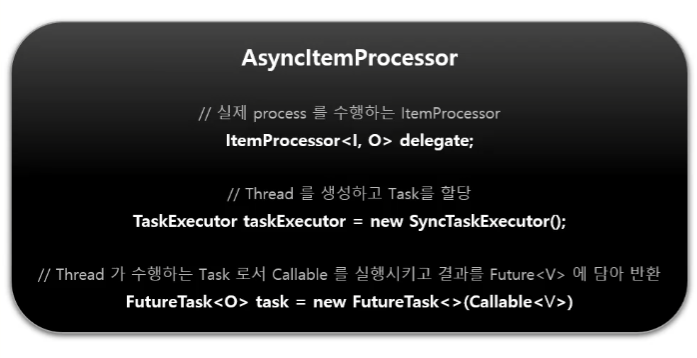
AsyncItemProcessor에는 실제 prcess 를 수행하는 delegate라는 객체가 있고 Thread를 할당해주는 TaskExecutor도 있습니다.
내부적으로는 Task 로서 Callable을 실행시키고 결과를 FutureTask로 받았습니다. 그리고 이 task 라는 하나의 작업을 TaskExecutor를 이용해 execute 하는 모습입니다.
이 구조를 하나의 Job의 관점에서 보기 편하게 그림으로 살펴보도록 하겠습니다.
Job은 TaskletStep을 실행하고 TaskletStep의 구현체인 ChunkOrientedTasklet이 실행됩니다. 이 때 순차적으로 ItemReader, ItemProcessor, ItemWriter가 실행됩니다.
ItemReader에서 값을 가져와서 Chunk<I>에 담아 ItemProcessor 에 넘기는데 ItemProcessor가 아닌 AsyncItemPrcessor가 실행되고 내부적으로 TaskExecutor는 스레드를 생성해 ItemPrcessor를 실행하고 반환값으로 FutureTask를 받습니다.
이후 ItemWriter 대신 AsyncItemWriter가 실행되고 AsynsItemProcessor에서 받아온 Future<T>를 List로 받아 내부적으로 아이템들을 List에 넣어 DB에 작업을 끝마칩니다.
이 때 ItemWriter가 write하는 과정에서 비동기 실행 결과 값들을 모두 받아오기 전까지 대기(wait())하고 있다가 ItemProcessor의 모든 과정이 끝나면 그 때 작업을 끝냅니다.
사용 방법
사용 방법은 아주 간단합니다.
@Configuration
@RequiredArgsConstructor
public class JpaWriterJob {
private final JobBuilderFactory jobBuilderFactory;
private final StepBuilderFactory stepBuilderFactory;
private final EntityManagerFactory emf;
private static final int chunk = 1000;
@Bean
public Job jpaJob() {
return jobBuilderFactory.get("jpaJob")
.start(jpaStep())
.build();
}
@Bean
public Step jpaStep() {
return stepBuilderFactory.get("jpaStep")
.<Member, Member>chunk(chunk)
.reader(jpaReader())
.processor(asyncItemProcessor())
.writer(asyncItemWriter())
.build();
}
@Bean
public JpaPagingItemReader<Member> jpaReader() {
return new JpaPagingItemReaderBuilder<Member>()
.entityManagerFactory(emf)
.pageSize(chunk)
.name("jpaReader")
.queryString("select m from Member m")
.build();
}
@Bean
public AsyncItemProcessor asyncItemProcessor() {
AsyncItemProcessor<Member, Member> asyncItemProcessor = new AsyncItemProcessor<>();
asyncItemProcessor.setDelegate(jpaProcessor());
asyncItemProcessor.setTaskExecutor(new SimpleAsyncTaskExecutor());
return asyncItemProcessor;
}
@Bean
public AsyncItemWriter asyncItemWriter() {
AsyncItemWriter<Member> asyncItemWriter = new AsyncItemWriter<>();
asyncItemWriter.setDelegate(jpaWriter());
return asyncItemWriter;
}
@Bean
public ItemProcessor<Member, Member> jpaProcessor() {
return member -> {
Thread.sleep(30);
return member.setName(member.getName() + "test");
};
}
@Bean
public JpaItemWriter<Member> jpaWriter() {
return new JpaItemWriterBuilder<Member>()
.entityManagerFactory(emf)
.build();
}
}
기존에 만들던대로 ItemProcessor와 ItemWriter를 만들어주고 AsyncItemProcessor, AsyncItemWriter를 빈으로 등록하는 작업을 끝내면 완성입니다.
눈여겨 볼 점이라면 setDelegate를 통해 ItemProcessor, ItemWriter를 주입받는다는 점과 AsyncItemProcessor에서 TaskExecutor를 SimpleAsyncTaskExecutor로 주입받는다는 점입니다.
그리고 확연한 성능 차이를 보기 위해 jpaProcessor() 메서드의 process() 작업에 0.03초의 텀을 주었습니다.
실제 같았으면 동기적 실행이기 때문에 0.03초의 딜레이가 큰 영향을 줍니다. 실제로 테스트 해보고 싶으시다면 새로운 Step을 만들고 그 Step의 processor, writer에 AsyncItemProcessor가 아닌 일반 ItemProcessor를 넣어보면 됩니다.
정리
이번 포스팅에선 멀티 스레드 환경에서의 스프링 배치 그 첫 번째 시간 AsyncItemProcessor, AsyncItemWriter에 대해서 알아봤습니다.
이번 AsyncItemProcessor, AsyncItemWriter는 여러번 테스트 해본 결과 Reader, Writer의 성능을 커버해주진 못했습니다.
즉, 직접적인 성능 차이가 있는 JpaItemWriter와 JdbcBatchItemWriter 두개 중 JpaItemWriter는 멀티 스레드로 돌렸음에도 여전히 성능상 많이 뒤쳐지는 것을 확인했습니다.
10만건의 데이터를 기준으로 JpaItemWriter는 평균 34~35초 정도 걸렸는데 멀티 스레드를 사용하더라도 대충 평균 정도로 나왔습니다. 멀티 스레드로 붙여도 능사가 아니라는 말이겠죠.
아마 제 생각엔 멀티 스레드가 강력한 효과가 발휘하는 때는 바로 process 단계에서 오래 걸리는 작업인 경우인 것 같습니다.
예를 들어 SMTP를 이용해 이메일을 보낸다고 생각해보면 이메일 하나 보내는데 1~2초정도 걸리기 때문에 데이터가 많아지면 엄청난 차이가 보일 것으로 생각됩니다. 이 때 멀티 스레드로 붙여주면 꽤나 큰 성능 향상이 있을 것으로 예측됩니다.
멀티스레드 환경에서의 스프링 배치 : Multi-threaded Step
본 포스팅은 인프런의 정수원님의 스프링 배치 강의를 듣고 정리한 포스팅입니다. 더 자세한 내용은 강의를 참고해주세요.
Multi-threaded Step
기본 개념
• Step내에서 멀티 스레드로 Chunk 기반 처리가 이루어지는 구조
• TaskExecutorRepeatTemplate이 반복자로 사용되며 설정한 개수 만큼의 스레드를 생성하여 수행한다.
이를 그림으로 알아보면 다음과 같습니다.
기존에는 TaskletStep이 RepeatCallback을 수행하고 이 때 ChunkOrientedTasklet이 수행됩니다.
하지만 Multi-threaded Step 에서는 TaskExecutorRepeatTemplate이 Runnable을 실행하고 그 안에서 RepeatCallback이 수행됩니다.
이 부분이 원래 싱글 스레드로 동작할 때와 다른 점입니다.
또한 멀티 스레드 환경에서 ChunkOrientedTasklet을 수행하는 경우 주의해야 하는 점이 ItemReader가 Thread-safe한지를 체크해야 합니다. 만약 Thread-safe 하지 않다면 데이터 처리에 문제가 생길 수도 있습니다.
Multi-threaded Step 에서 실행 순서를 보면
• Job이 TaskletStep을 실행합니다.
• TaskletStep이 TaskExecutorRepeatTemplate을 실행합니다.
• TaskExecutorRepeatTemplate이 TaskExecutor를 이용해 스레드를 생성합니다.
• 각각의 스레드는 새로 생성되어 Runnable에 접근합니다. 동시에 ChunkOrientedTasklet을 실행합니다.
• 각 스레드는 ItemReader, ItemProcessor, ItemWriter에 접근해 데이터를 가공후 처리합니다.
이 때 ItemReader, ItemProcessor, ItemWriter는 서로 데이터가 공유되지 않고 Chunk를 스레드마다 새로 생성하기 때문에 Thread-safe 합니다.
하지만 각각의 스레드가 ItemReader를 공유하기 때문에 ItemReader가 DB에서 데이터를 가져올 때 동시성 문제가 발생할 수 있기 때문에 ItemReader의 Thread-safe는 따로 신경써야 합니다.
사용 방법
Multi-threaded Step 을 사용하는 방법은 아주 간단합니다. 앞선 시간 포스팅 했던 AsyncItemProcessor 만큼 간단하고 쉽죠
우선 Job을 만들어줍니다. 이 때 주의해야 하는 점은 앞서 말했듯이 Thread-safe한 ItemReader를 만들어야 합니다. ItemReader 중에선 PagingItemReader가 Thread-safe합니다. CursorItemReader는 안됩니다.
저는 JpaPagingItemReader를 사용했고 ItemProcessor는 직접 구현했습니다. ItemWriter는 JpaItemWriter를 사용했습니다.
Step을 build 할 때 taskExecutor() API를 이용해 taskExecutor를 만들어주면 됩니다.
@Bean
public Step jpaStep() {
return stepBuilderFactory.get("jpaStep")
.<Member, Member>chunk(chunk)
.reader(jpaReader())
.processor(jpaProcessor())
.writer(jpaWriter())
.taskExecutor(taskExecutor())
.build();
}
taskExecutor는 디폴트가 SyncTaskExecutor입니다. 따라서 디폴트 생성자로 만들어주면 사용하는 의미가 없습니다. 따라서 개발자가 따로 만들어준 TaskExecutor를 사용해야 합니다.
TaskExecutor는 이렇게 생겼습니다.
@Bean
public TaskExecutor taskExecutor() {
ThreadPoolTaskExecutor taskExecutor = new ThreadPoolTaskExecutor();
taskExecutor.setCorePoolSize(4);
taskExecutor.setMaxPoolSize(8);
taskExecutor.setThreadNamePrefix("async-thread");
return taskExecutor;
}
TaskExecutor는 우선 CoreThread를 몇개로 생성할 것인지 선언해 주어야 합니다. 우선 저는 네개로 설정했구요. MaxPoolSize는 Thread가 지연됐을 경우 스레드를 추가로 생성해주는 API입니다. 최대 8개까지 만드는 것으로 설정했습니다.
그리고 스레드 이름을 정해주고 Bean으로 만들어주면 끝입니다. 이 상태로 데이터 1000건에 대해 얼마나 걸리는지 테스트를 해보도록 하겠습니다.
기존 싱글 스레드로 1000건의 데이터를 테스트 해봤을 때는
32.661초가 걸렸습니다.
이렇게 오래 걸린 이유는 아무래도 JpaItemWriter가 단건으로 데이터를 업데이트 하기 때문에 그럴 것입니다. 더 나은 성능을 원하신다면 JdbcBatchItemWriter를 사용하시는 것을 추천드립니다. 둘의 차이에 대해 비교 분석하고 테스트 해본 포스팅은 아래에 있습니다.
https://coding-review.tistory.com/203
같은 멀티 스레드 방식인 AsyncItemProcessor, AsyncItemWriter에서는 ItemReader, ItemWriter에서 생기는 성능 문제를 해결해주지 못했습니다.
이 문제에 대해 자세히 포스팅 되어있는 아래의 링크를 확인해주시면 감사합니다.
https://coding-review.tistory.com/206
아무래도 AsyncItemProcessor, AsyncItemWriter는 Process 과정에서만 멀티 스레드로 운영되기 때문에 그런 것 같았습니다. 따라서 위의 포스팅에서 결론적으로 Process 과정이 오래 걸리는 작업 (Ex. 이메일 보내기) 에서 큰 효과를 볼 것으로 기대했습니다.
하지만 이번 Multi-threaded Step은 하나의 Chunk 과정을 스레드로 각각 나눠 작업하는 것이기 때문에 성능에 문제가 있는 부분을 어느정도 커버할 수 있을 것이라고 추측했습니다.
실제로 테스트를 돌려보니 네개의 스레드로 돌렸기 때문에 정확히 네배 성능이 좋아진 것을 확인할 수 있었습니다.
정리
이렇게 Multi-threaded Step에 대해서 학습해보고 테스트까지 해봤습니다.
AsyncItemProcessor, AsyncItemWriter 와 Multi-threaded Step 은 각각 장단점이 확실히 있는 것 같습니다.
현업에서는 어떻게 사용하는지 모르겠지만 제가 프로젝트에서 실전으로 사용해야 한다면 Process가 오래 걸리는 작업에는 AsyncItemProcessor를, 일반적인 상황에서는 Multi-threaded Step을 사용할 것 같습니다.
스레드를 몇개까지 늘릴 수 있는지는 테스트 해보지 못했지만 CPU의 스레드 개수만큼 늘어나는 것이 최대일 것으로 추측됩니다.
Multi-threaded Step은 앞선 튜닝에서와 다르게 드라마틱한 성능향상이 이뤄지진 않았습니다. 따라서 대중적으로 사용될 수는 있지만 정말 압도적인 성능 향상을 원한다면 ItemReader에는 QuerydslNoOffsetPagingItemReader를 사용하고, ItemProcessor에는 AsyncItemProcessor를 사용하고, ItemWriter에는 jdbcBatchItemWriter를 사용하면 될 것 같습니다.
하지만 보통의 대용량 배치 작업은 트래픽이 많지 않은 새벽에 돌아간다는 점으로 미루어 봤을 때 굳이 그렇게까지 성능에 집착해야 되나 싶긴 합니다.
아무튼 여기까지 Multi-threaded Step 이었습니다. 다음 포스팅에서는 다른 멀티스레드 환경에서의 배치를 알아보도록 하겠습니다. 긴 글 읽어주셔서 감사합니다.
멀티스레드 환경에서의 스프링 배치 : Parallel Steps
본 포스팅은 인프런의 정수원님의 스프링 배치 강의를 듣고 정리한 포스팅입니다. 더 자세한 내용은 강의를 참고해주세요.
Parallel Steps
기본 개념
• SplitState 를 사용해서 여러 개의 Flow 들을 병렬적으로 실행하는 구조
• 실행이 다 완료된 후 FlowExecutionStatus 결과들을 취합해서 다음 단계를 결정한다.
구조
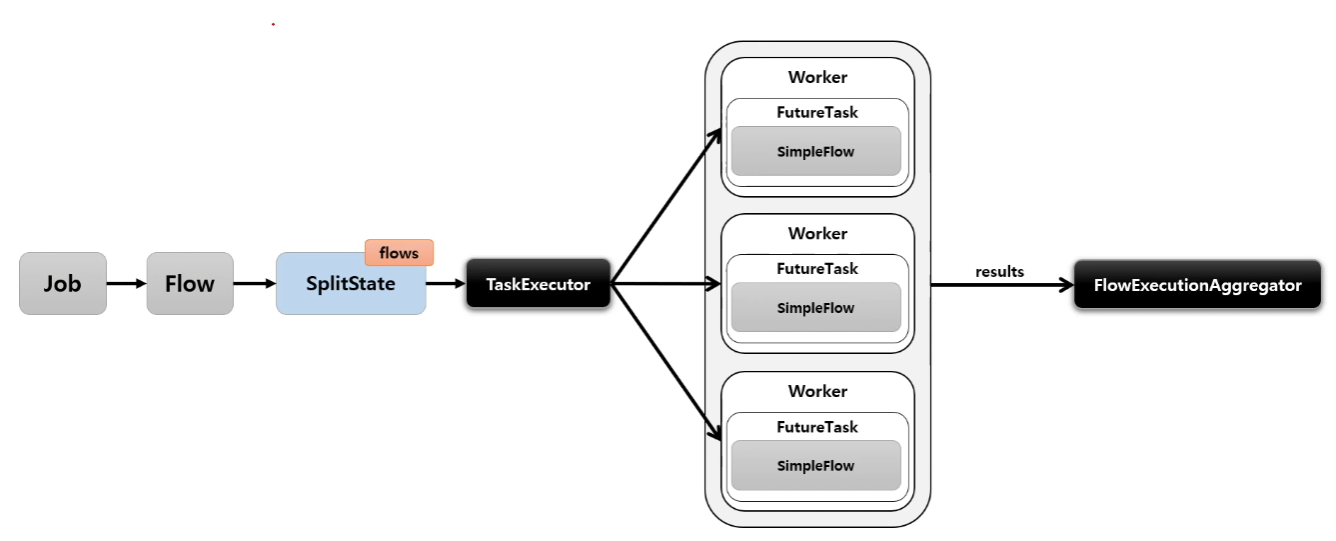
Job이 Flow를 통해 SplitState를 만들어서 TaskExecutor를 통해 스레드를 생성하고 각각의 FutureTask를 통해 멀티테스킹을 유도합니다.
앞선 포스팅에서 AsyncItemProcessor, AsyncItemWriter와 Multi-threaded Step 처럼 Step을 멀티스레드로 처리하는 것이 아닌 Flow를 멀티스레드로 처리하고 싶을 때 사용할 수 있습니다.
이 구조를 좀 더 자세히 보면 다음과 같습니다.
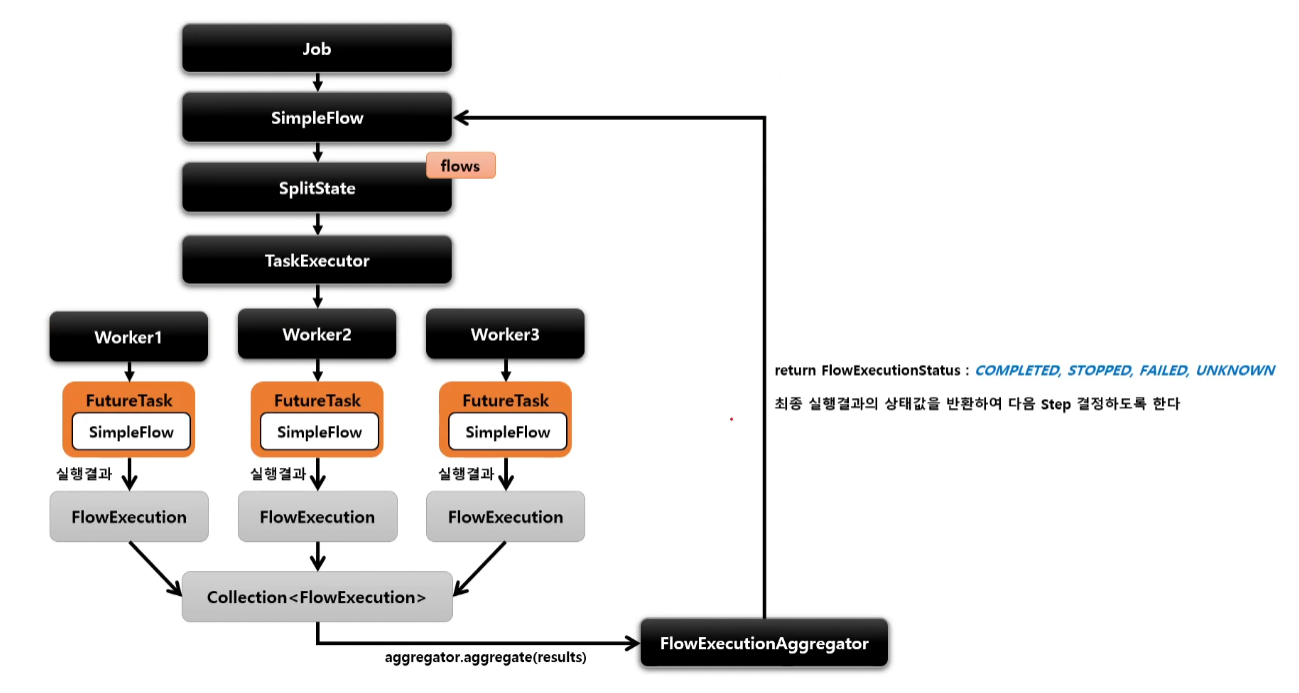
이 때 눈여겨 볼 점은 앞선 멀티스레드 환경에서의 배치잡들처럼 각각의 스레드간 데이터 공유가 일어나지 않아 Thread-safe 하다는 점입니다.
또한, 각각의 SimpleFlow들의 결괏값으로 FlowExecutionStatus가 나오고 이를 모아 최종 실행 결과에 따라 다음 Step으로 이동할지 안할지를 결정합니다.
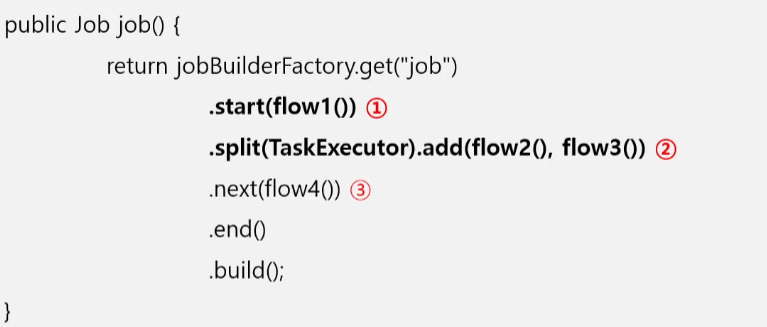
API를 확인해보면 start를 통해 Flow를 시작합니다. 그 이후 split메서드를 이용해 TaskExecutor를 주입합니다. 이렇게 스레드를 만들고 flow를 추가합니다. 마지막으로 next 메서드를 통해 마지막 Flow를 실행시킵니다.
순서로 나타내면 다음과 같습니다.
• Flow 1을 생성한다.
• Flow 2와 Flow 3 을 생성하고 총 3개의 Flow를 합친다. - TaskExecutor 에서 Flow 개수만큼 스레드를 생성해서 각 Flow를 실행시킨다.
• Flow 4는 split 처리가 완료된 후 실행이 된다.
실행
우선 실행할 Job입니다. FlowJob.java
@Configuration
@RequiredArgsConstructor
public class FlowJob {
private final JobBuilderFactory jobBuilderFactory;
private final StepBuilderFactory stepBuilderFactory;
@Bean
public Job flowJob() {
return jobBuilderFactory.get("flowJob")
.start(flow1())
.next(flow2())
// .split(taskExecutor()).add(flow2())
.end()
.build();
}
@Bean
public Flow flow1() {
TaskletStep step1 = stepBuilderFactory.get("step1")
.tasklet(tasklet())
.build();
TaskletStep step2 = stepBuilderFactory.get("step2")
.tasklet(tasklet())
.build();
return new FlowBuilder<Flow>("flow1")
.start(step1)
.next(step2)
.build();
}
@Bean
public Flow flow2() {
TaskletStep step3 = stepBuilderFactory.get("step3")
.tasklet(tasklet())
.build();
return new FlowBuilder<Flow>("flow2")
.start(step3)
.build();
}
@Bean
public Tasklet tasklet() {
return new CustomTasklet();
}
@Bean
public TaskExecutor taskExecutor() {
ThreadPoolTaskExecutor taskExecutor = new ThreadPoolTaskExecutor();
taskExecutor.setCorePoolSize(4);
taskExecutor.setMaxPoolSize(8);
taskExecutor.setThreadNamePrefix("async-thread");
return taskExecutor;
}
}
tasklet입니다. CustomTasklet.java
@Slf4j
public class CustomTasklet implements Tasklet {
private long sum;
@Override
public RepeatStatus execute(StepContribution stepContribution, ChunkContext chunkContext) throws Exception {
for (int i = 0; i < 1000000000; i++) {
sum++;
}
log.info("sum : {}", sum);
log.info("Tread Name : {}", Thread.currentThread().getName());
return RepeatStatus.FINISHED;
}
}
우선 Job에서 주석처리 한 부분은 비교를 위해 주석처리를 한 것입니다. 첫 번째는 멀티스레드를 적용하지 않은 단일 스레드 환경에서의 Job이고 두 번째 실행은 멀티스레드를 적용한 Job입니다.
@SpringBootTest
public class FlowJobTest {
@Autowired
private JobExplorer jobExplorer;
@Autowired
private JobLauncher jobLauncher;
@Autowired
private FlowJob config;
@Test
@DisplayName("Parallel Steps Test")
public void test() throws Exception {
jobLauncher.run(
config.flowJob(), new JobParametersBuilder(jobExplorer)
.addString("requestDate", LocalDateTime.now().toString())
.toJobParameters()
);
}
}
테스트 설정은 이렇게 했습니다.
1차 테스트
1차 테스트는 단일 스레드로 만든 Job입니다. 1.226초가 걸렸네요.
스레드 이름도 메인스레드이고 sum 값도 잘 찍히는 모습입니다. tasklet이 세번 실행됐으니 30억이 찍히는게 맞는 결과입니다.
2차 테스트
솔직히 엄청 놀랐습니다. 왜 시간이 더 걸리는거지..? 내가 테스트를 잘못했나? 몇번을 살펴보고 테스트 해봤는데 결과는 동일했습니다.
심지어 더 큰일인점은
멀티 스레드로 잘 적용 되었는데 멀티스레드의 문제점 중 하나인 동시성 문제가 발생했습니다.
sum을 10억번 더하는 과정에서 10억번이 다 완료되지 않은 상태에서 두 번째 스레드가 sum에 접근해서 생기는 문제입니다.
일단 결과는 굉장히 실망이었습니다. 멀티스레드는 성능 향상을 위해 사용하는 방법 중 하나인데 오히려 성능이 떨어져버리니... 거기다 단일스레드라면 신경쓰지 않아도 되는 동시성 문제도 발생했습니다.
이렇게 Parallel Steps는 구립니다! 하고 포스팅을 마치면 안되겠죠 동시성 문제정도는 해결하고 마치도록 하겠습니다.
동시성 문제
갑자기 동시성 문제 포스팅으로 바뀐것 같지만... 동시성 문제에 대해서는 예~전에 포스팅 한 적이 있습니다.
https://coding-review.tistory.com/92
위의 포스팅에서는 동시성 문제를 해결하는 방안 중 하나로 Thread-Local을 선택했습니다.
자바에서 동시성 문제를 해결하는 방법은 여러가지지만 가장 대표적인 방법은 synchronized 키워드를 적는 것입니다.
위의 예제에서 synchronized 를 사용하는 방법은 다음과 같습니다.
@Slf4j
public class CustomTasklet implements Tasklet {
private long sum;
private Object lock = new Object();
@Override
public RepeatStatus execute(StepContribution stepContribution, ChunkContext chunkContext) throws Exception {
synchronized (lock) {
for (long i = 0; i < 1000000000; i++) {
sum++;
}
log.info("sum : {}", sum);
log.info("Tread Name : {}", Thread.currentThread().getName());
}
return RepeatStatus.FINISHED;
}
}
이렇게 사용하면 동시성 문제가 해결됩니다. 실제로 이렇게 코드를 작성하고 테스트를 돌려보면 동시성 문제가 해결되는 것을 볼 수 있습니다.
하지만 synchronized 키워드는 효과는 확실하지만 성능적인 부분에서 아쉬운 부분이 있습니다. 왜냐하면 lock 이라는게 말그대로 해당 메서드 혹은 해당 코드에 lock을 걸어버려서 synchronized 가 붙은 부분이 끝나기 전까지 다른 스레드가 접근할 수 없기 때문입니다.
이 때문에 사용되는 것이 바로 스레드 로컬 (Thread-Local) 입니다.
스레드 로컬의 자세한 동작방식에 대해서 알고 싶으신 분들은 위의 링크를 타고 들어가시면 자세히 적어놨으니 확인해주시면 감사하겠습니다.
스레드 로컬의 사용방법은 어렵지 않습니다.
@Slf4j
public class CustomTasklet implements Tasklet {
private ThreadLocal<Long> sumStore = new ThreadLocal<>();
private long sum;
@Override
public RepeatStatus execute(StepContribution stepContribution, ChunkContext chunkContext) throws Exception {
sumStore.set(sum);
Long threadLocalSum = sumStore.get();
for (long i = 0; i < 1000000000; i++) {
threadLocalSum++;
}
sumStore.remove();
log.info("sum : {}", threadLocalSum);
log.info("Tread Name : {}", Thread.currentThread().getName());
return RepeatStatus.FINISHED;
}
}
이렇게 스레드 로컬을 사용하면 동시성 문제를 해결할 수 있습니다.
다만 이렇게 사용하면 한가지 문제가 생기는데..
동시성 문제를 너무 잘 해결해버려서 우리가 원했던 10억 20억 30억이 차례대로 찍히는 것은 할 수 없었습니다.
우리가 원하는 결과를 얻으려면 ExecutionContext를 사용해야 할 것 같습니다.
정리
이렇게 Parallel Steps에 대해서 알아봤습니다. 솔직히 결과는 만족스럽지 못했습니다. 멀티스레드를 활용해서 성능 향상을 기대했는데 기대하는 수치는 나오지 않았습니다.
왜 이런 결과가 나오게 됐는지 알 수 없지만 사용하는 방법부터 일반적인 방법이 아니기 때문에 대중적으로 사용되지는 않을 것 같습니다.
동시성 문제에 대해서 총 정리하는 느낌으로 포스팅을 계획중입니다. 스프링 배치 포스팅이 전체적으로 마무리가 되면 동시성 문제를 해결하는 다양한 방법으로 찾아뵙도록 하겠습니다.
긴 글 읽어주셔서 감사합니다.
스프링 부트 5.0 JobBuilderFactory, StepBuilderFactory Deprecated
스프링 부트가 5.0에 들어오면서 기존 Job과 Step을 작성할 때 사용하던 JobBuilderFactory, StepBuilderFactory가 Deprecated 되었습니다.
때문에 기존 방법 대신 아래와 같은 방법으로 사용해야합니다.
@Configuration
@RequiredArgsConstructor
@Slf4j
public class MonthClickToZeroBatch {
private final EntityManagerFactory emf;
private final JobRepository jobRepository;
private final PlatformTransactionManager platformTransactionManager;
private static final int PAGE_SIZE = 1000;
@Bean
public Job clickToZeroBatchJob() {
return new JobBuilder("MonthClickToZeroBatchJob")
.repository(jobRepository)
.incrementer(new UniqueRunIdIncrementer())
.start(clickToZeroBatchStep())
.build();
}
@Bean
public Step clickToZeroBatchStep() {
return new StepBuilder("MonthClickToZeroBatchStep", jobRepository)
.<Item, Item>chunk(PAGE_SIZE, platformTransactionManager)
.reader(itemReader())
.processor(itemProcessor())
.writer(jdbcBatchItemWriter())
.allowStartIfComplete(true)
.build();
}
또한 chunk(int pageSize) 메서드도 Deprecated 되었습니다.
때문에 PlatformTransactionManager를 주입받아서 사용하시면 됩니다.
p.s 근데 5.2에 JobBuilder도 Deprecated 됐는데 어쩌라는거지..