Java
개발개발 ·
자바 추상클래스
추상 메소드
추상 메소드란 자식 클래스에서 반드시 오버라이딩해야만 사용할 수 있는 메소드를 의미한다.
추상 메소드를 선언하는 목적은, 이 메소드가 포함된 클래스를 상속받는 자식 클래스가 반드시 그 메소드를 구현하도록 강제하기 위함이다.
예를 들어 모듈처럼 중복되거나 공통적인 부분은 미리 만들어 둔 것을 쓰고, 이를 받아 쓰는 쪽에서는 자신에게 필요한 부분만 재정의한다. 그러면 생산성이 오르고 배포도 쉬워진다.
추상 메소드는 선언부만 존재하고 구현부는 비어 있다. 바로 이 비어 있는 구현부를 자식 클래스가 오버라이딩해서 채우는 것이다.
문법은 다음과 같다.
abstract 반환타입 메소드이름();
추상 클래스
하나 이상의 추상 메소드를 포함하는 클래스를 추상 클래스라고 한다.
추상 클래스는 객체지향의 중요한 특징인 다형성을 가지는 메소드의 집합을 정의할 수 있게 해 준다. 즉 반드시 사용되어야 하는 메소드를 추상 클래스에 추상 메소드로 선언해 두면, 이 클래스를 상속받는 모든 클래스는 그 메소드를 반드시 재정의해야 한다.
문법은 다음과 같다.
abstract class 클래스이름 {
abstract 반환타입 메소드이름();
}
추상 클래스는 동작이 정의되지 않은 추상 메소드를 포함하므로 인스턴스를 생성할 수 없다.
먼저 상속을 통해 자식 클래스를 만들고, 그 자식 클래스에서 모든 추상 메소드를 오버라이딩하고 나서야 비로소 자식 클래스의 인스턴스를 생성할 수 있다.
추상 메소드를 쓰는 이유
만약 일반 메소드로 구현한다면 사용하는 사람에 따라 그 메소드를 구현할 수도, 하지 않을 수도 있다.
하지만 추상 메소드가 포함된 추상 클래스를 상속받은 모든 자식 클래스는 그 메소드를 구현해야만 인스턴스를 만들 수 있으므로 반드시 구현하게 된다.
자바 인터페이스
인터페이스
자식 클래스가 여러 부모 클래스를 상속받을 수 있다면 다양한 동작을 수행할 수 있다는 장점이 생긴다.
하지만 클래스로 다중 상속을 하면 메소드 출처의 모호성 같은 여러 문제가 생길 수 있어, 자바는 클래스를 통한 다중 상속을 지원하지 않는다.
그렇다고 다중 상속의 이점을 버릴 수는 없기에, 자바는 인터페이스를 통해 다중 상속을 지원한다.
인터페이스란 다른 클래스를 작성할 때 기본이 되는 틀을 제공하면서, 클래스 사이의 중간 매개 역할까지 담당하는 일종의 추상 클래스다.
추상 클래스는 추상 메소드뿐 아니라 생성자, 필드, 일반 메소드도 포함할 수 있다. 하지만 인터페이스는 오직 추상 메소드와 상수만 포함할 수 있다.
인터페이스의 선언
선언하는 방법은 클래스를 작성하는 방법과 같다. 접근 제어자와 함께 `interface` 키워드를 쓰면 된다.
접근제어자 interface 인터페이스이름 {
public static final 타입 상수이름 = 값;
...
public abstract 메소드이름(매개변수목록);
}
단, 클래스와 달리 인터페이스의 모든 필드는 `public static final`이어야 하고 모든 메소드는 `public abstract`이어야 한다.
이는 모든 인터페이스에 공통으로 적용되는 부분이므로 제어자를 생략할 수 있다. 생략하면 컴파일 시 자바 컴파일러가 자동으로 붙여 준다.
인터페이스의 구현
인터페이스도 추상 클래스와 마찬가지로 스스로 인스턴스를 만들 수는 없다. 따라서 인터페이스가 가진 추상 메소드를 구현해 줄 클래스를 작성해야 한다.
class 클래스이름 implements 인터페이스이름 { ... }
인터페이스의 장점
인터페이스를 쓰면 다중 상속이 가능할 뿐 아니라 다음과 같은 장점도 있다.
1. 대규모 프로젝트에서 일관되고 정형화된 개발을 위한 표준화가 가능하다.
2. 클래스 작성과 인터페이스 구현을 동시에 진행할 수 있어 개발 시간을 단축할 수 있다.
3. 클래스와 클래스 사이의 관계를 인터페이스로 연결하면 클래스마다 독립적인 개발이 가능하다.
자바 제네릭
자바에서 제네릭(generic)이란 데이터 타입을 일반화(generalize)한다는 뜻이다. 클래스나 메소드에서 사용할 내부 데이터 타입을 컴파일 시점에 미리 지정하는 방법이다.
이렇게 컴파일 시점에 타입 검사를 하면 다음과 같은 장점이 있다.
1. 클래스나 메소드 내부에서 쓰이는 객체의 타입 안정성을 높일 수 있다.
2. 반환값에 대한 타입 변환과 타입 검사에 드는 수고를 줄일 수 있다.
제네릭의 선언과 생성
자바에서 제네릭은 클래스와 메소드에만 다음과 같이 선언할 수 있다.
class MyArray<T> {
T element;
void setElement(T element) { this.element = element; }
T getElement() { return element; }
}
위 예제의 `T`를 타입 변수라고 하며, 임의의 참조형 타입을 의미한다. 꼭 `T`가 아니어도 되고 어떤 문자를 써도 상관없다. 여러 개의 타입 변수는 쉼표로 구분해 명시한다.
타입 변수는 클래스뿐 아니라 메소드의 매개변수나 반환값으로도 쓸 수 있다.
이렇게 선언된 제네릭 클래스를 생성할 때에는 타입 변수 자리에 사용할 실제 타입을 명시해야 한다.
MyArray<Integer> myArr = new MyArray<Integer>();
`MyArray` 클래스의 타입 변수로 `Integer`를 사용하는 예제다. 이렇게 실제 타입을 명시하면 내부적으로 정의된 타입 변수가 그 타입으로 변환되어 처리된다.
또한 Java SE 7부터는 인스턴스 생성 시 타입을 추론할 수 있는 경우 타입을 생략할 수 있다.
MyArray<Integer> myArr = new MyArray<>();
제네릭은 언제 사라지는가
자바 코드에서 선언되고 사용된 제네릭 타입은 컴파일 시 컴파일러가 자동으로 검사해 타입 변환을 수행한다.
그리고 코드 안의 모든 제네릭 타입은 제거된다. 그래서 컴파일된 `.class` 파일에는 어떠한 제네릭 타입도 남지 않는다.
이렇게 동작하는 이유는 제네릭을 쓰지 않는 코드와의 호환성을 유지하기 위해서다.
자바 List 컬렉션 클래스
List 컬렉션 클래스
List 인터페이스를 구현한 모든 List 컬렉션 클래스는 다음 특징을 가진다.
1. 요소의 저장 순서가 유지된다.
2. 같은 요소의 중복 저장을 허용한다.
대표적인 List 컬렉션 클래스는 다음과 같다.
1. `ArrayList<E>`
2. `LinkedList<E>`
3. `Vector<E>`
4. `Stack<E>`
ArrayList<E>
가장 많이 쓰이는 컬렉션 클래스 중 하나다. JDK 1.2부터 제공되었고, 내부적으로 배열을 이용해 요소를 저장한다.
배열을 쓰기 때문에 인덱스로 요소에 빠르게 접근할 수 있다.
하지만 배열은 크기를 바꿀 수 없는 인스턴스다. 그래서 크기를 늘리려면 새 배열을 만들고 기존 요소를 전부 옮기는 복잡한 과정을 거쳐야 한다. 물론 이 과정은 자동으로 수행되지만, 요소의 추가·삭제에 걸리는 시간이 매우 길어진다는 단점이 생긴다.
LinkedList<E>
ArrayList가 배열을 쓰기 때문에 생기는 단점을 극복하려고 고안되었다. JDK 1.2부터 제공되었고, 내부적으로 연결 리스트를 이용해 요소를 저장한다.
배열은 요소가 순차적으로 저장된다. 반면 연결 리스트는 요소가 비순차적으로 흩어져 있고, 이들 사이를 링크로 연결해 구성한다.
다음 요소를 가리키는 참조만 가지는 연결 리스트를 단일 연결 리스트라고 한다.
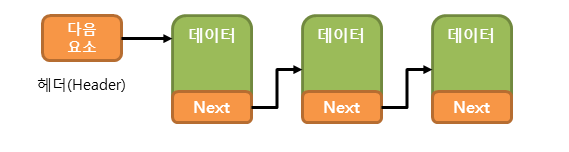
단일 연결 리스트는 요소를 저장하고 삭제할 때 다음 요소를 가리키는 참조만 바꾸면 되므로 아주 빠르게 처리된다. 하지만 현재 요소에서 이전 요소로 접근하기가 매우 어렵다.
그래서 이전 요소를 가리키는 참조까지 함께 가지는 이중 연결 리스트가 더 많이 쓰인다.
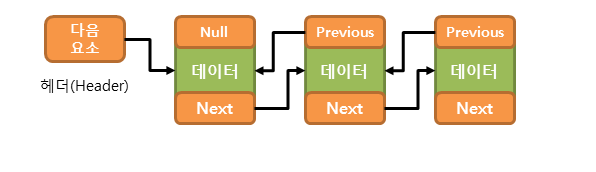
LinkedList 클래스도 위와 같은 이중 연결 리스트를 내부적으로 구현한 것이다. LinkedList 역시 List 인터페이스를 구현하므로 ArrayList와 쓸 수 있는 메소드가 거의 같다.
자바 Stack 과 Queue
Stack<E> 클래스
Stack 클래스는 List 컬렉션의 Vector 클래스를 상속받아, 전형적인 스택 메모리 구조를 제공한다.
스택은 선형 메모리 공간에 데이터를 저장하면서 후입선출(LIFO)을 따르는 자료구조다. 즉 가장 나중에 저장된 데이터가 가장 먼저 나온다.
Stack 클래스는 스택 구조를 표현하기 위해 Vector의 메소드 중 다섯 개만 상속받아 쓴다.
• `boolean empty()` — 스택이 비어 있으면 `true`, 아니면 `false`를 반환한다.
• `E peek()` — 스택 제일 위(가장 마지막에 저장된) 요소를 반환한다.
• `E pop()` — 스택 제일 위 요소를 반환하고, 그 요소를 스택에서 제거한다.
• `E push(E item)` — 스택 제일 위에 전달된 요소를 삽입한다.
• `int search(Object o)` — 스택에서 전달된 객체가 있는 위치의 인덱스를 반환한다. 이때 인덱스는 제일 위 요소를 0이 아니라 1부터 센다.
Queue<E> 인터페이스
클래스로 구현된 스택과 달리, 자바의 큐는 별도의 인터페이스 형태로 제공된다. Queue 인터페이스를 상속받는 하위 인터페이스는 다음과 같다.
1. `Deque<E>`
2. `BlockingDeque<E>`
3. `BlockingQueue<E>`
4. `TransferQueue<E>`
그래서 Queue 인터페이스를 직간접적으로 구현한 클래스는 상당히 많다. 그중에서도 Deque를 구현한 LinkedList가 큐 구조를 만드는 데 가장 많이 쓰인다.
큐는 선형 메모리 공간에 데이터를 저장하면서 선입선출(FIFO)을 따르는 자료구조다. 즉 가장 먼저 저장된 데이터가 가장 먼저 나온다.
Queue 인터페이스는 큐 구조를 표현하기 위해 Collection 인터페이스의 다음 메소드만 상속받아 쓴다.
• `boolean add(E e)` — 큐의 맨 뒤에 요소를 삽입한다. 성공하면 `true`를 반환하고, 여유 공간이 없어 실패하면 `IllegalStateException`을 던진다.
• `E element()` — 큐의 맨 앞에 있는 요소를 반환한다.
• `boolean offer(E e)` — 큐의 맨 뒤에 요소를 삽입한다.
• `E peek()` — 큐의 맨 앞(가장 먼저 저장된) 요소를 반환한다. 큐가 비어 있으면 `null`을 반환한다.
• `E poll()` — 큐의 맨 앞 요소를 반환하고 큐에서 제거한다. 비어 있으면 `null`을 반환한다.
• `E remove()` — 큐의 맨 앞 요소를 제거한다.
자바 Map컬렉션 클래스
Map 컬렉션 클래스
Map 인터페이스는 Collection 인터페이스와 저장 방식이 다르다. Map을 구현한 컬렉션 클래스들은 키와 값을 하나의 쌍으로 저장한다. 여기서 키란 실질적인 값을 찾기 위한 이름 역할을 한다.
Map을 구현한 모든 컬렉션 클래스는 다음 특징을 가진다.
1. 요소의 저장 순서를 유지하지 않는다.
2. 키는 중복을 허용하지 않지만, 값의 중복은 허용한다.
대표적인 Map 컬렉션 클래스는 다음과 같다.
1. `HashMap<K, V>`
2. `Hashtable<K, V>`
3. `TreeMap<K, V>`
HashMap<K, V>
Map 컬렉션 클래스 중 가장 많이 쓰이는 클래스다. JDK 1.2부터 제공되었고, 해시 알고리즘을 사용해 검색 속도가 매우 빠르다.
Map 인터페이스를 구현하므로 중복된 키로는 값을 저장할 수 없다. 다만 같은 값을 다른 키로 저장하는 것은 가능하다.
Hashtable<K, V>
JDK 1.0부터 사용해 온, HashMap과 같은 동작을 하는 클래스다. 현재의 Hashtable도 HashMap과 마찬가지로 Map 인터페이스를 상속받는다. 따라서 Hashtable에서 쓸 수 있는 메소드는 HashMap에서 쓸 수 있는 메소드와 같다.
다만 지금은 기존 코드와의 호환성을 위해서만 남아 있으므로, Hashtable보다는 HashMap을 쓰는 것이 좋다.
TreeMap<K, V>
키와 값을 한 쌍으로 하는 데이터를 이진 검색 트리 형태로 저장한다. 이진 검색 트리는 데이터를 추가하거나 제거하는 기본 동작이 매우 빠르다.
JDK 1.2부터 제공된 TreeMap은 NavigableMap 인터페이스를, 기존 이진 검색 트리의 성능을 개선한 레드-블랙 트리로 구현한다.
TreeMap도 Map 인터페이스를 구현하므로 중복된 키로는 값을 저장할 수 없다. 같은 값을 다른 키로 저장하는 것은 가능하다.
자바 람다식표현
람다 표현식
람다 표현식이란 간단히 말해 메소드를 하나의 식으로 표현한 것이다.
int min(int x, int y) {
return x < y ? x : y;
}
이 메소드를 람다 표현식으로 바꾸면 이렇게 된다.
(x, y) -> x < y ? x : y;
위 예제처럼 메소드를 람다 표현식으로 쓰면 클래스를 작성하고 객체를 생성하지 않아도 메소드를 쓸 수 있다.
그런데 자바에서는 클래스 선언과 동시에 객체를 생성하며, 단 하나의 객체만 만들 수 있는 클래스를 익명 클래스라고 한다. 따라서 자바의 람다 표현식은 익명 클래스와 같다고 할 수 있다.
람다 표현식은 메소드의 매개변수로 전달될 수도 있고, 메소드의 결괏값으로 반환될 수도 있다. 그래서 람다 표현식을 쓰면 불필요한 코드가 줄고 가독성이 올라간다.
Java SE 8부터는 이 람다 표현식 덕분에 자바에서도 함수형 프로그래밍이 가능해졌다.
람다 표현식 작성법
화살표 기호를 사용해 작성한다.
(매개변수목록) -> { 함수몸체 }
작성할 때 유의할 점은 다음과 같다.
1. 매개변수의 타입을 추론할 수 있으면 타입을 생략할 수 있다.
2. 매개변수가 하나면 괄호를 생략할 수 있다.
3. 함수 몸체가 하나의 명령문만으로 이루어지면 중괄호를 생략할 수 있다.
4. 함수 몸체가 하나의 `return` 문만으로 이루어져도 중괄호를 생략할 수 있다.
5. `return` 문 대신 표현식을 쓸 수 있으며, 이때 반환값은 그 표현식의 결괏값이 된다.
자바 스트림API
스트림 API
Java SE 8부터 추가된 스트림 API는 파일 입출력에서의 스트림과는 전혀 다른 개념이다.
자바에서는 많은 양의 데이터를 저장하기 위해 배열이나 컬렉션을 쓴다. 그런데 이렇게 저장된 데이터에 접근하려면 반복문이나 반복자를 써서 매번 새로운 코드를 작성해야 했다.
이런 코드는 길이가 너무 길고 가독성도 떨어지며 재사용이 거의 불가능하다. 즉 데이터베이스의 쿼리처럼 정형화된 처리 패턴이 없어서 데이터마다 다른 방법으로 접근해야만 했다.
이 문제를 극복하기 위해 Java SE 8부터 스트림 API가 도입되었다. 스트림 API는 데이터를 추상화해 다루므로, 다양한 방식으로 저장된 데이터를 읽고 쓰는 공통된 방법을 제공한다. 그래서 배열이나 컬렉션뿐 아니라 파일에 저장된 데이터도 모두 같은 방법으로 다룰 수 있다.
스트림 API의 특징
1. 외부 반복으로 작업하는 컬렉션과 달리 내부 반복으로 작업을 수행한다.
2. 재사용이 가능한 컬렉션과 달리 단 한 번만 쓸 수 있다.
3. 원본 데이터를 변경하지 않는다.
4. 필터-맵 기반의 API를 사용해 지연 연산으로 성능을 최적화한다.
5. `parallelStream()` 메소드로 손쉬운 병렬 처리를 지원한다.
스트림의 생성
스트림 API는 다음과 같은 다양한 데이터 소스에서 생성할 수 있다.
1. 컬렉션
2. 배열
3. 가변 매개변수
4. 지정된 범위의 연속된 정수
5. 특정 타입의 난수
6. 람다 표현식
7. 파일
8. 빈 스트림
1. 컬렉션
모든 컬렉션의 최상위 조상인 `Collection` 인터페이스에 `stream()` 메소드가 정의되어 있다. 따라서 이를 구현한 모든 List와 Set 컬렉션 클래스에서도 `stream()`으로 스트림을 만들 수 있다. `parallelStream()`을 쓰면 병렬 처리가 가능한 스트림을 만들 수 있다.
`Stream` 클래스의 `forEach()`는 스트림의 요소를 하나씩 소모하며 순차적으로 접근하는 메소드다. 그래서 같은 스트림으로는 `forEach()`를 한 번밖에 호출할 수 없다.
단, 원본 데이터의 요소를 소모하는 것은 아니므로, 같은 데이터에서 또 다른 스트림을 만들어 `forEach()`를 호출하는 것은 가능하다.
2. 배열
배열에 대한 스트림을 만들기 위해 `Arrays` 클래스에 다양한 형태의 `stream()` 메소드가 정의되어 있다.
또한 기본 타입인 `int`, `long`, `double`을 저장하는 배열에 대한 스트림이 별도로 있다. 이들은 `java.util.stream` 패키지의 `IntStream`, `LongStream`, `DoubleStream` 인터페이스로 각각 제공된다.
3. 가변 매개변수
`Stream` 클래스의 `of()` 메소드를 쓰면 가변 매개변수를 전달받아 스트림을 만들 수 있다.
4. 지정된 범위의 연속된 정수
`IntStream`이나 `LongStream`에 `range()`와 `rangeClosed()` 메소드가 정의되어 있다.
• `range()` — 시작 정수는 포함하지만 마지막 정수는 포함하지 않는 스트림을 만든다.
• `rangeClosed()` — 시작 정수뿐 아니라 마지막 정수까지 포함하는 스트림을 만든다.
5. 특정 타입의 난수
`Random` 클래스에 `ints()`, `longs()`, `doubles()` 같은 메소드가 정의되어 있다.
이들은 매개변수로 스트림의 크기를 `long` 타입으로 받을 수 있다. 매개변수를 주지 않으면 크기가 정해지지 않은 무한 스트림을 반환하므로, 이때는 `limit()`으로 크기를 제한해야 한다.
6. 람다 표현식
람다 표현식을 받아 그 반환값을 요소로 하는 무한 스트림을 만들기 위해, `Stream` 클래스에 `iterate()`와 `generate()`가 정의되어 있다.
• `iterate()` — 시드로 명시된 값을 람다에 넣고, 반환된 값을 다시 시드로 쓰는 방식으로 무한 스트림을 만든다.
• `generate()` — 매개변수가 없는 람다를 써서 반환된 값으로 무한 스트림을 만든다.
7. 파일
파일의 한 행을 요소로 하는 스트림을 만들기 위해 `java.nio.file.Files` 클래스에 `lines()`가 정의되어 있다. 또한 `java.io.BufferedReader`의 `lines()`를 쓰면 파일뿐 아니라 다른 입력에서도 데이터를 행 단위로 읽어 올 수 있다.
8. 빈 스트림
아무 요소도 없는 빈 스트림은 `Stream` 클래스의 `empty()`로 만들 수 있다.
스트림의 중개 연산
초기 스트림은 중개 연산을 거쳐 또 다른 스트림으로 변환된다. 중개 연산은 스트림을 받아 스트림을 반환하므로 연속으로 연결해서 쓸 수 있다.
또한 필터-맵 기반 API를 사용하므로 지연 연산으로 성능을 최적화할 수 있다.
대표적인 중개 연산은 다음과 같다.
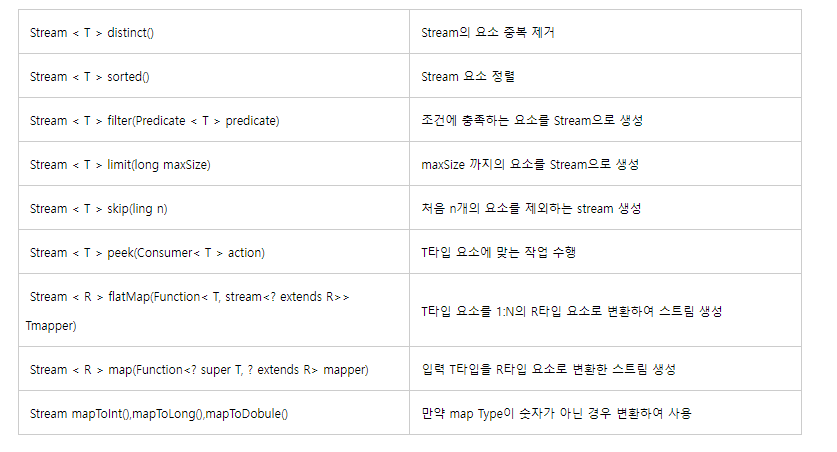
1. 스트림 필터링 : `filter()`, `distinct()`
2. 스트림 변환 : `map()`, `flatMap()`
3. 스트림 제한 : `limit()`, `skip()`
4. 스트림 정렬 : `sorted()`
5. 스트림 연산 결과 확인 : `peek()`
1. 스트림 필터링
`filter()`는 주어진 조건에 맞는 요소만으로 구성된 새 스트림을 반환한다.
`distinct()`는 중복된 요소가 제거된 새 스트림을 반환한다. 내부적으로 `Object` 클래스의 `equals()`를 써서 중복을 비교한다.
2. 스트림 변환
`map()`은 스트림의 요소들을 주어진 함수에 인수로 전달하고, 그 반환값들로 이루어진 새 스트림을 반환한다.
요소가 배열이라면 `flatMap()`을 써서 각 배열의 각 요소의 반환값을 하나로 합친 새 스트림을 얻을 수 있다.
3. 스트림 제한
`limit()`은 첫 번째 요소부터 전달된 개수만큼의 요소로 이루어진 새 스트림을 반환한다.
`skip()`은 첫 번째 요소부터 전달된 개수만큼을 제외한 나머지 요소로 이루어진 새 스트림을 반환한다.
4. 스트림 정렬
`sorted()`는 주어진 비교자로 스트림을 정렬한다. 비교자를 전달하지 않으면 기본적으로 사전 편찬 순으로 정렬한다.
5. 스트림 연산 결과 확인
`peek()`은 결과 스트림에서 요소를 가져와 추가로 명시된 동작을 수행한다. 원본 스트림의 요소를 소모하지 않으므로 주로 연산과 연산 사이에 결과를 확인하고 싶을 때 쓴다. 그래서 개발자가 디버깅 용도로 많이 쓴다.
스트림의 최종 연산
중개 연산으로 변환된 스트림은 마지막으로 최종 연산을 통해 각 요소를 소모하고 결과를 낸다. 즉 지연되었던 모든 중개 연산이 최종 연산 시점에 한꺼번에 수행된다.
이렇게 모든 요소를 소모한 스트림은 더는 쓸 수 없다.
대표적인 최종 연산은 다음과 같다.
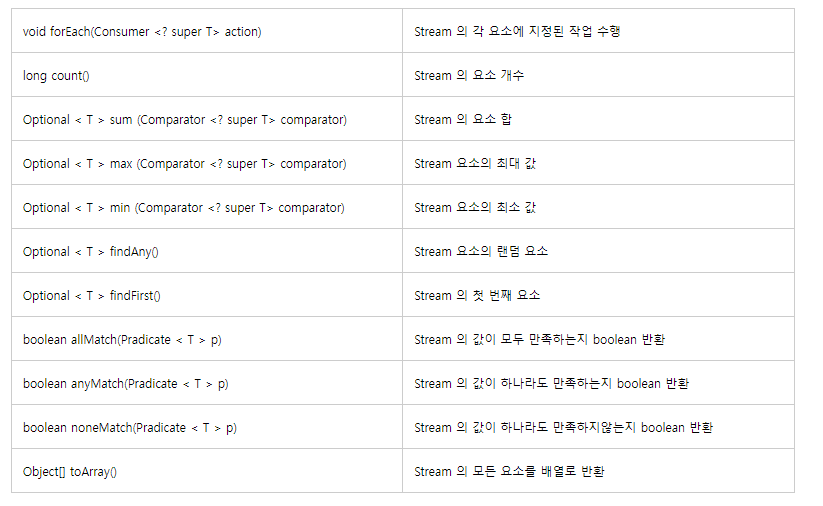
1. 요소의 출력 : `forEach()`
2. 요소의 소모 : `reduce()`
3. 요소의 검색 : `findFirst()`, `findAny()`
4. 요소의 검사 : `anyMatch()`, `allMatch()`, `noneMatch()`
5. 요소의 통계 : `count()`, `min()`, `max()`
6. 요소의 연산 : `sum()`, `average()`
7. 요소의 수집 : `collect()`
1. 요소의 출력
`forEach()`는 각 요소를 소모하며 명시된 동작을 수행한다. 반환 타입이 `void`이므로 보통 모든 요소를 출력하는 용도로 많이 쓴다.
2. 요소의 소모
최종 연산은 모두 각 요소를 소모하며 연산을 수행한다.
그중 `reduce()`는 첫 번째와 두 번째 요소로 연산한 뒤, 그 결과와 세 번째 요소로 다시 연산하는 식으로 모든 요소를 소모하고 결과를 반환한다.
인수로 초깃값을 전달하면 초깃값과 첫 번째 요소부터 연산을 시작하고, 그 결과와 두 번째 요소로 계속 이어 간다.
3. 요소의 검색
`findFirst()`와 `findAny()`는 스트림의 첫 번째 요소를 참조하는 `Optional` 객체를 반환한다. 두 메소드 모두 비어 있는 스트림에서는 비어 있는 `Optional`을 반환한다.
4. 요소의 검사
특정 조건을 만족하는 요소가 있는지, 모두 만족하는지, 모두 만족하지 않는지를 다음 메소드로 확인할 수 있다.
1. `anyMatch()` — 일부 요소가 조건을 만족하면 `true`
2. `allMatch()` — 모든 요소가 조건을 만족하면 `true`
3. `noneMatch()` — 모든 요소가 조건을 만족하지 않으면 `true`
세 메소드 모두 인수로 `Predicate` 객체를 받고 결과는 `boolean`으로 반환한다.
5. 요소의 통계
`count()`는 요소의 총 개수를 `long` 타입으로 반환한다.
`max()`와 `min()`을 쓰면 가장 큰 값과 가장 작은 값을 가지는 요소를 참조하는 `Optional` 객체를 얻을 수 있다.
6. 요소의 연산
`IntStream`이나 `DoubleStream` 같은 기본 타입 스트림에는 모든 요소의 합과 평균을 구하는 `sum()`과 `average()`가 각각 정의되어 있다. 이때 `average()`는 기본 타입으로 래핑된 `Optional` 객체를 반환한다.
7. 요소의 수집
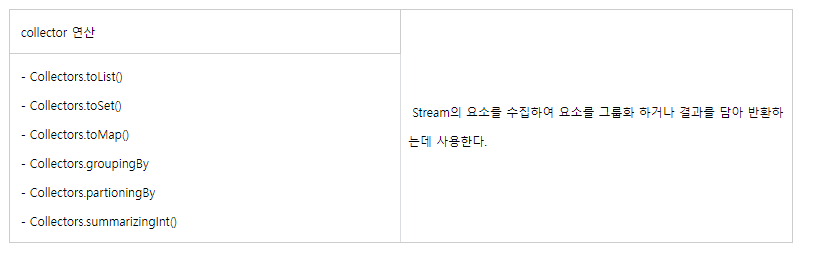
`collect()`는 인수로 전달되는 `Collectors` 객체에 구현된 방법대로 스트림의 요소를 수집한다. `Collectors` 클래스에는 미리 정의된 다양한 방법이 클래스 메소드로 준비되어 있다.
이 외에도 사용자가 직접 `Collector` 인터페이스를 구현해 자신만의 수집 방법을 정의할 수도 있다.
Timer / TimerTask
사용법
① 선언
import java.util.Timer;
import java.util.TimerTask;
② 초기화
Timer timer = new Timer();
TimerTask task = new TimerTask() { @Override ... };
③ 구현
Timer timer = new Timer();
TimerTask task = new TimerTask() {
@Override
public void run() {
반복하고싶은 코드
}
};
timer.scheduleAtFixedRate(task, 1000, 60 * 1000);
`scheduleAtFixedRate`의 인자는 다음과 같다.
• 첫 번째 — 반복하고 싶은 `TimerTask`
• 두 번째 — 이만큼 지난 뒤에 실행 (지연 시간)
• 세 번째 — 몇 단위마다 반복할지
단위는 ms다. `1000ms = 1s`로 생각하고 맞추면 된다.
자바 Optional
Optional 클래스
`Optional<T>` 클래스는 `Integer`나 `Double`처럼 `T` 타입의 객체를 포장해 주는 래퍼 클래스(Wrapper class)다. 따라서 모든 타입의 참조 변수를 담을 수 있다.
Optional 객체를 쓰면 예상치 못한 `NullPointerException`을 제공되는 메소드만으로 간단히 회피할 수 있다. 즉 복잡한 조건문 없이도 null로 인한 예외를 처리할 수 있다.
Optional 객체를 만들려면 전용 메서드를 써야 한다. Optional도 Stream API처럼 생성 → 중개 연산 → 최종 연산 구조를 가진다.
Optional 객체 생성
`Optional.of`
값이 `null`이면 예외가 터진다. 반드시 값이 있어야 하는 객체라면 이 메서드를 쓴다.
Optional<String> opt = Optional.of("result");
`Optional.ofNullable`
값이 `null`이면 비어 있는 Optional을 반환한다. 값이 null일 수도 있다면 이 메서드를 쓴다.
Optional<String> opt = Optional.ofNullable(null);
`Optional.empty`
비어 있는 Optional 객체를 만든다. 조건에 따라 분기해야 하는데 반환할 값이 없을 때 쓴다.
Optional<String> opt = Optional.empty();
Optional 중개 연산
`filter`
`predicate`가 참이면 통과시키고, 거짓이면 통과시키지 않는다.
Optional.of("True").filter((val) -> "True".equals(val)).orElse("No Data");
`map`
`mapper` 함수로 입력값을 다른 값으로 변환한다.
Optional.of("1").map(Integer::valueOf).orElseThrow(NoSuchElementException::new);
`flatMap`
`map`과 마찬가지로 입력값을 다른 값으로 변환한다. 다른 점은 메서드 시그니처의 매개변수다.
Optional.of("result").flatMap((val) -> Optional.of("good")).get();
`stream`
중개 연산자다. 자바 8에서 Optional 객체가 스트림 객체로 바로 전환되지 않아 불편했던 부분을 해소해 준다.
Optional.of("result").stream().map(MemberDto::new).collect(Collectors.toList());
Optional 최종 연산
`ifPresent`
연산을 끝낸 뒤 값이 비어 있지 않으면 그 값이 입력으로 주어진다. 이 값으로 원하는 작업을 하면 된다. 다만 중개 연산 도중 비어 있는 Optional을 받으면 아무것도 수행하지 않는다.
Optional.of("test").ifPresent((value) -> { /* something to do */ });
`isPresent`
연산을 끝낸 뒤 객체가 존재하는지 판별한다.
Optional.ofNullable("test").isPresent(); // true
`get`
연산을 끝낸 뒤 객체를 꺼낸다. 비어 있는 Optional이었다면 예외가 발생한다.
Optional.ofNullable(null).get(); // NoSuchElementException
`orElse`
연산을 끝냈는데도 Optional이 비어 있다면 기본값으로 제공할 객체를 지정한다.
Optional.ofNullable(null).orElse("default");
`orElseGet`
연산을 끝냈는데도 Optional이 비어 있다면 기본값으로 제공할 함수를 지정한다.
Optional.ofNullable("input").filter(x -> "test".equals(x)).orElseGet(() -> "default");
`orElseThrow`
연산을 끝냈는데도 Optional이 비어 있다면 예외 공급자 함수로 예외를 발생시킨다.
Optional.ofNullable("input").filter("test"::equals).orElseThrow(NoSuchElementException::new);
cf) `orElse`와 `orElseGet` 중 무엇을 써야 하나?
`orElse`는 Optional이 비어 있든 아니든 반드시 실행된다. 반면 `orElseGet`은 비어 있을 때만 실행된다.
따라서 기본값을 구하는 과정이 오래 걸린다면 `orElseGet`을 쓰자.
자바 람다식에 대한 고찰
람다식에 대한 고찰
람다식은 내 입장에서 다른 자바 8 내용인 Optional이나 LocalDateTime과 달리 이해하기 상당히 까다로웠다. 내가 나름대로 이해한 내용을 기록으로 남긴다.
Stream API에서의 람다식
사고의 시작
Map<String, String> paramMap = new HashMap<>();
request.getParameterNames().asIterator().forEachRemaining(paramName -> paramMap.put(paramName, request.getParameter(paramName)));
람다식 안에 있는 `paramName`은 어떻게 구분하지? 자바 코드는 뭘 보고 `paramName`을 지정하는 거지? `request.getParameter(paramName)`의 `paramName`은 어디서 들어왔길래 `paramMap`에 넣을 수 있는 거지?
이 의문은 Stream API에서 번뜩 풀렸다.
Map<String, String> map = new HashMap<>();
map.values().stream().filter(x -> x.contains("m")).forEach(System.out::println);
여기서도 마찬가지다. `x`는 뭔 줄 알고 `m`이 들어 있는 것을 식별해 콘솔에 띄워 주지? 잘 보면 `stream` 앞에 있는 `map.values()`가 그 값을 한정한다는 것을 알 수 있다.
위 코드를 해석하면 이렇게 된다.
> `map.values()`에 있는 값들을 `x`에 넣고 반복하면서, `"m"`이 들어 있는 `x`를 콘솔에 띄운다.
그럼 처음의 그 람다식도 같은 방식으로 읽을 수 있다.
> `request.getParameterNames().asIterator()`에서 뽑아온 파라미터를 `paramName`에 저장해 반복하면서, `paramMap`에 `paramName`을 키로 하고 `request.getParameter(paramName)`을 값으로 하는 항목을 순차적으로 저장한다.
함수형 람다식
Stream API에서의 람다식은 비교적 직관적이었다. 하지만 함수형 람다식은 더 난해했다. `() -> { }` 이런 형태는 아무리 봐도 직관적이지 않았다.
처음에는 이해하지 못한 채 그냥 하라는 대로 코드를 적어 내려갔다. 그렇게 계속 쓰다 보니(물론 계속 의심은 했다. '왜 이걸 이렇게 쓸까, 왜 이렇게 쓸까…' 하면서 말이다) 어느 순간 번뜩 떠올랐다.
사고의 시작
@Bean
public AuditorAware<String> auditorProvider() {
return () -> {
ServletRequestAttributes attr = (ServletRequestAttributes) RequestContextHolder.currentRequestAttributes();
String loginId = (String) attr.getRequest().getSession().getAttribute("loginId");
if (loginId != null) {
return Optional.of(loginId);
}
else {
return Optional.of("Anonymous");
}
};
}
스프링 데이터 JPA의 Auditing을 공부하다 만난 코드다.
내가 알던 `return`은 특정 값을 돌려주는 것이었는데, 여기서는 반환값으로 함수형 람다식을 쓰고 있었다. 내가 알던 게 맞다면 함수를 리턴한다는 얘기가 된다. 함수를 리턴할 수 있나? 잠시 혼란스러웠지만, 생각해 보니 나도 종종 함수를 리턴한다. 그럼 함수 안에서 또 `return`을 하면 리턴값을 리턴하는 논리가 이어진다.
여기서 나는 람다식을 다시 한번 지긋이 바라봤다. 람다식의 철학이 뭘까? 왜 람다식이 등장했을까?
내가 내린 결론은 코드의 간소화다. Stream API만 봐도 향상된 for문으로 처리할 수 있는 것들을 람다식으로 간소화해 냈다.
요는 이렇다. 함수형 람다식은 함수를 만들 때 밖으로 뺄 일을 만들지 않는 것이다. 위 코드도 원래대로라면 `return 메서드명();`이라고 쓰고 밖에 메서드를 따로 만들어야 한다. 함수형 람다식은 그 번거로움을 줄여 준 것이라고 이해했다.
이중 콜론 연산자 ( :: )
Stream API를 쓰다 보면 가끔 이런 연산자가 등장한다. `forEach(System.out::println)`이 내가 처음 이중 콜론 연산자를 만난 표현이었다.
처음엔 이게 뭔가 싶었다. 이것도 함수형 람다식과 마찬가지로 아무것도 모르고 하라는 대로 적어 내려갔다.
그러다 인텔리제이에서 제공하는 기능 중 `x -> something`을 `x::something`으로 바꿔 주는 기능을 발견했다. 이걸 보고 번뜩 떠올랐다. 저 둘은 같은 뜻이고, 표현 방식만 다른 게 아닐까? 그래서 찾아보니 예상이 맞았다.
x -> new MemberDto(x) == MemberDto::new
x -> String.valueOf(x) == String::valueOf
x -> System.out.println(x) == System.out::println
이런 식으로 서로 치환할 수 있는 것이었다. 알고 보니 별거 아니라는 생각이 잠깐 들었다.
람다식은 아직도 아리송한 개념 중 하나다. 자바의 어떤 문법보다도 개인적으로 제일 난해하고 직관적이지 않아서 이해하기 어려웠던 것 같다. 그래도 이제 조금씩 이해가 되는 것 같아 기분은 좋다.
스레드와 멀티스레드
스레드
스레드를 알기 전에 우리는 프로세스부터 알아야 한다.
프로세스는 무엇인가?
프로세스란 단순히 실행 중인 프로그램이라고 할 수 있다. 즉 사용자가 작성한 프로그램이 운영체제로부터 메모리 공간을 할당받아 실행되고 있는 것을 말한다. 프로세스는 프로그램에 사용되는 데이터와 메모리 등의 자원, 그리고 스레드로 구성된다.
그럼 스레드는 무엇인가?
스레드란 프로세스 안에서 실제로 작업을 수행하는 주체를 의미한다. 모든 프로세스는 한 개 이상의 스레드를 가지고 작업을 수행한다. 두 개 이상의 스레드를 가지는 프로세스를 멀티스레드 프로세스라고 한다.
예를 들어 Controller → Service → Repository로 이어지는 로직을 하나의 프로세스라고 하면, 이 프로세스는 하나의 스레드가 할당되어 실행된다는 뜻이다.
이제 스레드의 생성과 실행을 알아보자. 자바에서 스레드를 만드는 방법은 두 가지다.
1. `Runnable` 인터페이스를 구현하는 방법
2. `Thread` 클래스를 상속받는 방법
두 방법 모두, 스레드로 처리하고 싶은 내용을 `run()` 메서드에 작성하면 된다.
1. Runnable 인터페이스를 구현하는 방법
Runnable thread = new Runnable() {
@Override
public void run() {
//스레드가 실행할 로직
}
}
이 방법은 자바 8의 람다를 이용하면 더 간단해진다.
Runnable thread = () -> {
//스레드가 실행할 로직
};
개인적으로는 람다를 이용한 스레드 생성을 주로 쓴다. 상속해야 하는 귀찮음이 없어서 제일 깔끔하고 편하다.
2. Thread 클래스를 상속받는 방법
class ThreadWithClass extends Thread {
public void run() {
//스레드가 실행할 로직
}
}
스레드 생성자
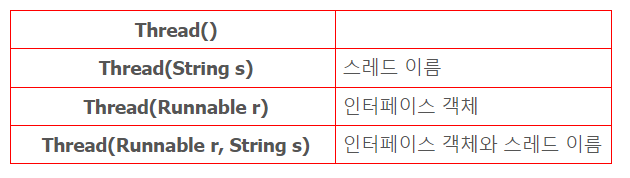
스레드 메서드
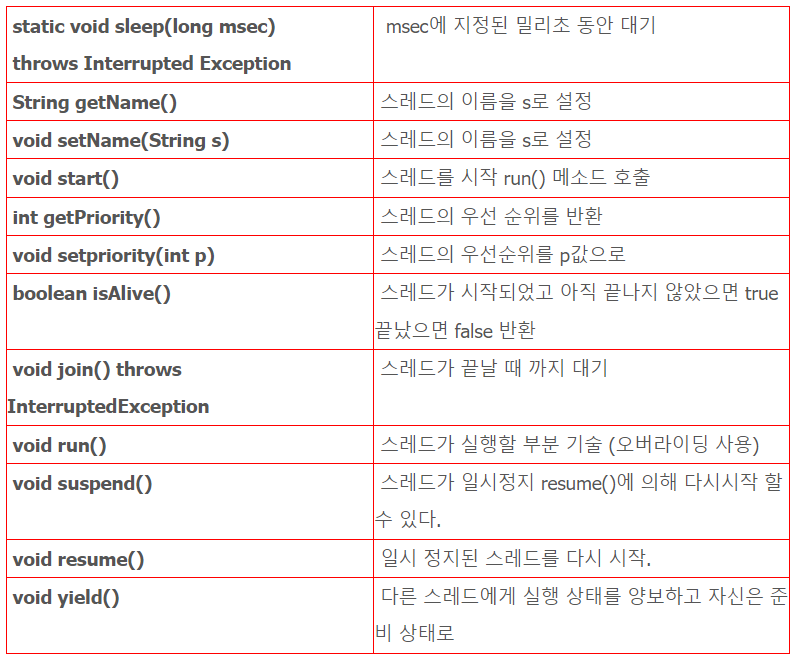
스레드의 종류
스레드의 종류로는 멀티스레드, 데몬 스레드 등이 있다. 하나씩 알아보자.
멀티스레드
일반적으로 하나의 프로세스는 하나의 스레드로 작업을 수행한다. 멀티스레드란 하나의 프로세스 안에서 둘 이상의 스레드가 동시에 작업을 수행하는 것을 의미한다. 이와 달리 멀티프로세스는 여러 개의 CPU를 사용해 여러 프로세스를 동시에 수행하는 것을 말한다.
둘 다 여러 흐름을 동시에 수행한다는 공통점이 있다. 차이는 메모리다. 멀티프로세스는 각 프로세스가 독립적인 메모리를 가지고 별도로 실행되지만, 멀티스레드는 각 스레드가 자신이 속한 프로세스의 메모리를 공유한다.
메모리를 공유하므로 시스템 자원의 낭비가 적다. 또한 하나의 스레드가 작업하는 동안 다른 스레드가 별도의 작업을 할 수 있어 사용자에 대한 응답성도 좋아진다.
데몬 스레드
데몬 스레드란 다른 일반 스레드의 작업을 돕는 보조적인 역할을 하는 스레드를 가리킨다. 그래서 일반 스레드가 모두 종료되면 할 일이 없어지므로 데몬 스레드도 자동으로 종료된다.
생성 방법과 실행 방법은 일반 스레드와 같다. 다만 실행하기 전에 `setDaemon()` 메소드를 호출해 데몬 스레드로 지정하기만 하면 된다.
데몬 스레드는 일정 시간마다 자동으로 수행되는 저장이나 화면 갱신 등에 쓰인다.
(궁금증 해소) CPU의 스레드와 자바의 스레드는 과연 같은 의미일까? 다른 의미일까?
스레드에 대해 공부하다 보니 문득 궁금증이 생겼다.
관련 글: https://coding-review.tistory.com/90
생각해 보니 우리는 '스레드'라는 말을 어디선가 들어 봤다. 바로 CPU의 코어와 스레드다. 자바의 스레드와 CPU의 스레드는 같은 의미일까, 다른 의미일까?
들어가기 앞서, CPU의 스레드를 하드웨어 스레드, 자바 같은 언어가 지원하는 스레드를 소프트웨어 스레드라고 부르겠다.
하드웨어 스레드
하드웨어 스레드를 설명하기 전에 CPU의 코어부터 알아보자.
CPU는 Central Processing Unit이라는 이름 그대로 컴퓨터의 뇌 역할을 하는 하드웨어다. 이 CPU 안에서 물리적인 계산을 실제로 수행하는 유닛을 코어(Core)라고 한다.
CPU 하나에 코어는 하나일까? 그렇지 않다. 실제로 듀얼 코어(2Core), 쿼드 코어(4Core), 옥타 코어(8Core)가 일반적이고 최상위 CPU 중에는 16코어도 있다. 즉 하나의 CPU가 여러 계산을 동시에 병렬로 처리할 수 있는 여력이 늘어난다는 뜻이다.
그럼 하드웨어 스레드는 뭘까? 컴퓨터 부품에 관심이 있거나 CPU를 한 번이라도 알아본 사람이라면 이런 표기를 봤을 것이다. 4코어 8스레드, 8코어 16스레드, 16코어 32스레드. 여기서 말하는 스레드가 바로 하드웨어 스레드다.
하드웨어 스레드는 OS가 스케줄링할 수 있는 최소 단위의 일의 모음이다. 1코어에 1스레드가 기본이지만, 요즘은 1코어에 2스레드가 일반적이다.
소프트웨어 스레드
2코어 4스레드를 예로 들어 보겠다. 실제로 한 번에 수행할 수 있는 능력은 네 개가 최대다.
하지만 자바에서 `Executors`의 `newFixedThreadPool` 메서드를 쓰면 스레드 개수를 마음대로 지정할 수 있다. 이때의 스레드가 소프트웨어 스레드다.
이 스레드는 소프트웨어에서 일을 병렬로 나누고 할당할 때 쓰이며, 그대로 하드웨어 스레드에 올라가 실행된다. 즉 소프트웨어 스레드가 100개여도 동시에 실행되는 것은 하드웨어 스레드 개수만큼이다. 2코어 4스레드라면 동시에 네 개가 한계다.
도서관에 어떤 책이 있다고 해 보자. 이 책은 100명에게 빌려줄 수 있다. 하지만 한 번에 읽을 수 있는 사람은 4명뿐이다. 그럼 나머지 96명은 뭘 하고 있을까? 실제로 네 명밖에 못 읽으니, 96명은 자기 차례를 기다리는 수밖에 없다.
추상클래스와 인터페이스
도입
GOF 디자인 패턴 중 템플릿 메서드 패턴을 공부하다가, 공통 로직인 `AbstractTemplate`을 구성하는 요소 중 `abstract`라는 키워드를 발견했다. 검색해 보니 기능이 인터페이스와 비슷했다.
둘의 차이라곤 추상 클래스는 `extends`로 상속하고, 인터페이스는 `implements`를 쓴다는 것 정도였다.
둘 다 추상 메서드를 가지고 있고, 이 추상 메서드를 자식 클래스나 구현체에서 반드시 구현해야 한다는 공통점도 있었다.
이렇게 공통점이 많은데도 서로 다른 역할을 할 것 같아서, 둘의 차이점을 정리해 봤다. 아울러 가벼운 예제 코드로 각각을 어떤 상황에서 쓰는지도 짚어 보겠다.
추상 클래스
추상 개념은, 객체 간의 관계를 상속으로 정립하며 점차 상위 클래스를 정의하다 보면 마주치는 "구체적인 행동 내용을 부모 입장에서는 정의할 수 없는 것"을 묘사하기 위해 쓴다고 생각하면 된다.
즉 자식 시점에서는 행동을 구체적으로 정의할 수 있지만 부모 입장에서는 그럴 수 없고, 그러면서도 모든 자식이 반드시 구현해야 하는 행동일 때 추상 클래스를 쓴다.
이때 메소드를 부모 단계에서 추상화해서, "내 시점에서는 행동을 특정할 수 없지만 자식 시점에서는 반드시 구현되어야 하고 구현될 수 있는 행동"임을 설계 시점에 명시하면 된다.
1. `Event`라는 부모 클래스가 있다.
public class Event {
...
}
2. `Event`를 상속받은 자식 클래스 `aEvent`, `bEvent`, `cEvent`가 있고, 각각 `isRelevant()` 메서드를 구현한다.
public class aEvent extends Event {
public boolean isRelevant(Data data) {
return logic.a;
}
}
public class bEvent extends Event {
public boolean isRelevant(Data data) {
return logic.b;
}
}
public class cEvent extends Event {
public boolean isRelevant(Data data) {
return logic.c;
}
}
3. 그리고 다른 클래스의 어느 메서드에서, `Event` 타입으로 선언된 배열 `events[]`의 각 원소를 `isRelevant()`로 검증하는 로직을 작성했다.
public class someClass() {
...
Event events[] = new Event[100];
...
public void someMethod() {
for(int i=0; i<n; i++)
if(events[i].isRelevant(someData)) // 컴파일 에러!!!
system.out.println( events[i].toString());
}
}
그런데 `isRelevant()`에서 컴파일 에러가 발생한다.
`events[]` 배열은 `Event` 타입으로 선언되었는데, `Event` 클래스에는 `isRelevant()`가 정의되어 있지 않기 때문이다.
배열의 각 원소가 `Event`를 상속받은 클래스의 객체이고 각 클래스에 `isRelevant()`가 구현되어 있더라도, 컴파일러는 `Event` 클래스에 그 메서드가 없는 것을 허용하지 않는다.
4. 단순히 컴파일 에러만 피하고 싶다면, 아래처럼 `Event`에 쓰일 일 없는 `isRelevant()`를 정의할 수도 있다.
public class Event {
public boolean isRElevant(Data data) {
return false;
}
}
이렇게 하면 컴파일 에러는 사라지고 정상적으로 동작한다. 하지만 쓰이지 않을 메서드를 구현하는 것은 올바른 해결책이 아니다.
5. 이 문제를 제대로 해결하려면 `isRelevant()`를 추상 메서드로 만들면 된다.
public abstract class Evnet {
public abstract boolean isRelevant(Data data);
}
인터페이스
소스 코드를 작성할 때 클래스를 처음부터 전부 구현한다면 가독성도 떨어지고 시간도 오래 걸린다. 또한 팀별로 각기 다른 모듈을 만들 때 팀마다 방식이 달라, 서로 호환되지 않고 일관성이 떨어진다.
인터페이스로 기본적으로 구현해야 할 메소드의 규격을 알려 준다면 훨씬 효율적일 것이다.
즉 인터페이스란 특정 기능을 개발하는 데 있어 공통 기능을 명시하고 강제로 구현하게 하는 역할이다. 인터페이스를 쓰면 자바의 다형성을 활용할 수 있고, 이를 통해 유지보수성을 높일 수 있다.
1. 우리가 현업 개발자라고 가정하자. 오픈 날짜가 정해져 있는 애플리케이션을 개발하는 중이고, 할인 정책은 크게 정률 할인 정책(RateDiscountPolicy)과 정량 할인 정책(FixDiscountPolicy) 두 개로 정한 상태다.
그런데 사장님이, 할인 정책은 비즈니스 로직에서 중요한 부분을 차지하는 만큼 오픈 직전까지 결정을 보류하고 싶다고 말했다. 우리가 할 수 있는 건 두 가지다.
• 오픈 직전까지 개발을 안 한다. (할인 정책이 정해지면 시작한다)
• 두 정책을 다 만들어 두고, 정해지면 해당 정책으로 갈아 끼운다.
첫 번째는 있을 수 없는 방법이다. 그럼 두 번째를 택하자. 어떻게 하면 좋을까? 자바의 다형성을 이용하면 된다.
2. `DiscountPolicy`라는 인터페이스를 만든다.
public interface DiscountPolicy {
int discount(int money);
}
3. 이를 구현하는 `FixDiscountPolicy`, `RateDiscountPolicy`를 만든다.
public class FixDiscountPolicy implements DiscountPolicy {
private static final int discount = 1000;
@Override
public int discount (int money) {
return money - discount;
}
}
public class RateDiscountPolicy implements DiscountPolicy {
private static final int discountRate = 10;
@Override
public int discount (int money) {
return money * (1 - discountRate * 0.01);
}
}
4. 우선 `FixDiscountPolicy`라고 가정하고 스프링 빈으로 등록해 보자.
@Configuration
public class DiscountPolicyConfig {
@Bean
public DiscountPolicy discountPolicy() {
return new FixDicountPolicy();
}
}
5. 이제 두 개의 할인 정책을 만들었다. 할인 정책이 사용되는 코드를 보자.
@Controller
@RequiredArgsConstructor
public class DiscountController {
private final DiscountPolicy discountPolicy;
@PostMapping(blahblah)
public String discount(HttpServletRequest request) {
...
int money = request.getParameter("money");
int discountMoney = discountPolicy.discount(money);
...
}
}
6. 우리는 정량 할인 정책이라고 가정하고 코드를 짰다. 그런데 갑자기 사장님이 오픈 직전에, 소비자 친화적이지 않은 정량 할인보다 정률 할인이 좋아 보인다며 바꾸자고 하셨다.
우리가 인터페이스로 만들어 둔 덕분에, `DiscountPolicy`의 스프링 빈을 `RateDiscountPolicy`로 바꿔 주기만 하면 된다!
@Configuration
public class DiscountPolicyConfig {
@Bean
public DiscountPolicy discountPolicy() {
return new RateDiscountPolicy();
}
}
추상 클래스와 인터페이스의 차이점
개념적인 관점에서 보면 이렇다.
• 추상 클래스 : `extends` 키워드를 사용하며, 다중 상속이 불가능하다.
• 인터페이스 : `implements` 키워드를 사용하며, 다중 상속이 가능하다.
개념이 아니라 실제 적용의 관점에서 보면, 추상 클래스는 `extends`(상속·확장의 느낌)라는 키워드 그대로 자신의 기능을 하위로 확장시키는 것으로 볼 수 있다. 인터페이스는 `implements`(구현의 느낌)처럼 정의된 메서드를 각 클래스의 목적에 맞게 동일한 기능으로 구현하는 것으로 볼 수 있다.
또 다른 관점도 있다. 추상 클래스는 이를 상속할 객체들의 공통점을 찾아 추상화해 놓은 것이라, 상속 관계를 거슬러 올라갔을 때 같은 부모를 상속하며 그 부모가 가진 기능을 구현해야 하는 경우에 쓴다.
반면 인터페이스는 상속 관계를 거슬러 올라갔을 때 서로 다른 부모를 상속하더라도, 같은 기능이 필요한 경우에 쓴다.
JVM (Java Virtual Machine)
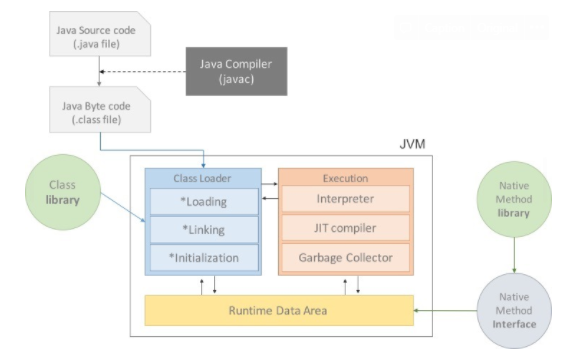
위 그림은 자바 코드의 실행 과정을 간략하게 보여 준다.
• 프로그램이 실행되면 JVM은 OS로부터 필요한 메모리를 할당받는다. (이때 JVM은 메모리를 용도에 따라 여러 영역으로 나누어 관리한다.)
• 자바 파일(`.java`)이 자바 컴파일러에 의해 자바 바이트코드(`.class`)로 변환된다.
• 클래스 로더가 자바 바이트코드를 필요한 시점에 JVM으로 로딩한다.
• 해석된 바이트코드는 런타임 데이터 영역에 배치되어 실질적인 수행이 이루어진다.
• 실행 과정에서 JVM은 필요에 따라 GC 같은 관리 작업을 수행한다.
이 과정을 보면 C/C++과 다르다는 것을 알 수 있다. C/C++은 운영체제별로 컴파일러가 존재해서 해당 운영체제가 인식할 수 있는 기계어로 변환된다. 반면 자바는 컴파일러가 하나뿐이고, 기계어가 아닌 중간 단계의 바이트코드로 변환되며, 운영체제가 아니라 JVM이 실행한다.
바이트코드란?
바이트코드란 JVM에서 작동하도록 만든 이진 코드다. 즉 JVM이 이해할 수 있는 언어로 변환된 코드다.
명령어의 크기가 1바이트라서 자바 바이트코드라 불리며, 자바 코드를 배포하는 가장 작은 단위다. 확장자는 `.class`다.
JVM의 특징
스택 기반의 가상 머신
인텔 x86이나 ARM 같은 대표적인 하드웨어 아키텍처가 레지스터 기반으로 동작하는 데 비해, JVM은 스택 기반으로 동작한다.
심볼릭 레퍼런스
참조하는 클래스의 특정 메모리 주소를 참조 관계로 구성하는 것이 아니라, 참조 대상의 이름만 지칭한 것이다.
자바 바이트코드가 JVM에 올라가면, 심볼릭 레퍼런스는 그 이름에 맞는 객체의 물리적 주소를 찾아 연결하는 작업을 수행한다.
기본 자료형을 제외한 모든 타입을 명시적인 메모리 주소가 아니라 심볼릭 레퍼런스로 참조한다.
가비지 컬렉션
클래스 인스턴스는 사용자 코드에 의해 명시적으로 생성되고, 가비지 컬렉션에 의해 자동으로 파괴된다.
기본 자료형을 명확히 정의해 플랫폼 독립성 보장
C/C++ 등 전통적인 언어는 플랫폼에 따라 `int`형의 크기가 달라진다. 하지만 JVM은 기본 자료형을 명확하게 정의해 호환성을 유지하고 플랫폼 독립성을 보장한다.
네트워크 바이트 오더
자바 클래스 파일은 네트워크 바이트 오더를 사용한다.
인텔 x86이 쓰는 리틀 엔디안과 RISC 계열이 주로 쓰는 빅 엔디안 사이에서 플랫폼 독립성을 유지하려면 고정된 바이트 오더가 필요하다. 그래서 네트워크 전송에 쓰이는 바이트 오더를 채택했고, 이는 빅 엔디안이다.
JVM의 구조
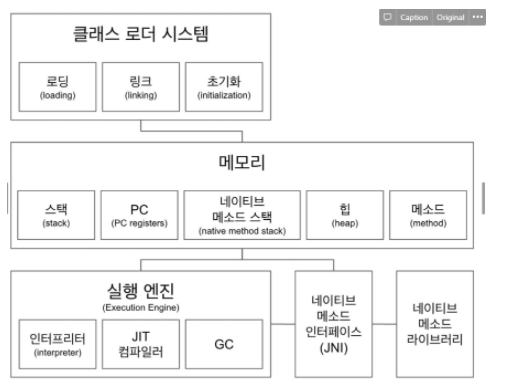
클래스 로더 (Class Loader)
자바는 동적 로드, 즉 컴파일 타임이 아니라 런타임에 클래스를 로드하고 링크하는 특징이 있다. 이를 담당하는 것이 클래스 로더다. 클래스 로더는 로드 → 링크 → 초기화 단계로 나뉜다.
로드
• 각 자바 바이트코드는 JVM에 의해 메소드 영역에 다음 정보를 저장한다.
• 로드된 클래스와 그 부모 클래스의 정보
• 클래스 파일이 Class, Interface, Enum 중 무엇인지
• 변수나 메소드 등의 정보
링크
• 검증 : 읽어 들인 클래스가 자바 언어 명세 및 JVM 명세에 맞게 잘 구성되어 있는지 검사한다.
• 준비 : 클래스가 필요로 하는 메모리를 할당하고, 클래스에 정의된 필드·메소드·인터페이스를 나타내는 데이터 구조를 준비한다.
• 분석 : 심볼릭 메모리 레퍼런스를 메소드 영역에 있는 실제 레퍼런스로 교체한다.
초기화
• 클래스 변수를 적절한 값으로 초기화한다. 즉 `static` 필드들이 설정된 값으로 초기화된다.
런타임 데이터 영역 (Runtime Data Areas)
JVM이 운영체제 위에서 실행될 때 할당받는 메모리 영역이며, 총 6개로 나눌 수 있다. 기준은 스레드가 공유하는 공간인지 아닌지다.
스레드마다 하나씩 생성되는 공간
• PC 레지스터
• JVM 스택
• 네이티브 메소드 스택
모든 스레드가 공유하는 공간
• 힙
• 메소드 영역
• 런타임 상수 풀
#### PC 레지스터
각 스레드마다 하나씩 존재하며 스레드가 시작될 때 생성된다. 메소드 안에서 바이트코드의 몇 번째 줄을 실행하고 있는지 같은 정보를 갖는다.
#### JVM 스택
각 스레드마다 하나씩 존재하며 스레드가 시작될 때 생성된다. 스택 프레임이라는 구조체로 이루어져 있고, 새로운 메소드가 호출될 때마다 push, 실행이 끝나면 pop 한다.
각 스택 프레임은 지역 변수 배열, 피연산자, 프레임 데이터를 갖는다. 프레임 데이터란 현재 실행 중인 메소드가 속한 클래스의 런타임 상수 풀, 이전 스택 프레임에 대한 정보, 현재 메소드가 속한 클래스와 객체에 대한 참조 등을 말한다.
#### 네이티브 메소드 스택
자바 바이트코드가 아닌 다른 언어로 작성된 네이티브 코드를 위한 스택이다. 성능 향상을 목적으로 만들어졌다.
JVM 스택과 네이티브 스택이 나뉘어 있다 하더라도, 자바 코드를 수행하다 JNI를 호출하면 JVM 스택에서 네이티브 메소드 스택으로 확장될 뿐이다.
#### 힙 (Heap)
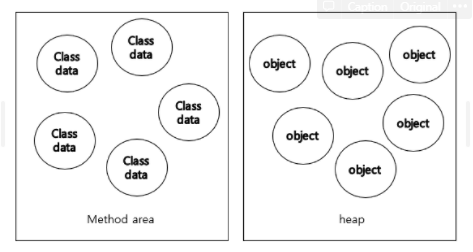
모든 스레드가 공유하는 영역이다. 프로그램을 실행하면서 생성된 모든 인스턴스와 객체를 저장하는 공간이다.
#### 메소드 영역
모든 스레드가 공유하는 영역으로 JVM이 시작될 때 생성된다.
클래스 로더가 클래스 파일을 읽어 오면 클래스 정보를 파싱해서 런타임 상수 풀, 필드와 메소드 정보, `static` 변수, 메소드의 바이트코드 등을 보관한다.
메소드 영역은 JVM 벤더마다 다양한 형태로 구현할 수 있으며, 오라클 핫스팟 JVM에서는 흔히 PermGen(자바 1.7 이전), MetaSpace(자바 1.8 이후)로 부른다.
#### 런타임 상수 풀
메소드 영역에 포함되는 영역이지만, JVM 동작에서 가장 핵심적인 역할을 하기 때문에 JVM 명세에서도 따로 중요하게 기술한다.
각 클래스와 인터페이스의 상수뿐 아니라 메소드와 필드에 대한 모든 레퍼런스까지 담고 있는 테이블이다. 즉 어떤 메소드나 필드를 참조할 때, JVM은 런타임 상수 풀을 통해 실제 메모리상 주소를 찾아 참조한다.
실행 엔진 (Execution Engine)
실행 엔진은 메모리에 적재된 바이트코드를 기계어로 바꿔 명령어 단위로 실행하고, 바이트코드를 운영체제에 맞게 해석해 주는 역할을 한다. 여기에는 크게 두 가지 방식이 쓰인다.
#### 인터프리터
런타임 중에 바이트코드를 한 줄씩 읽고 실행한다. 그래서 컴파일보다 속도가 느리다.
#### JIT 컴파일러
인터프리터의 속도 이슈를 해결하기 위해 함께 쓴다. 자주 실행되는 바이트코드 영역을 런타임 중에 기계어로 컴파일해서 사용한다.
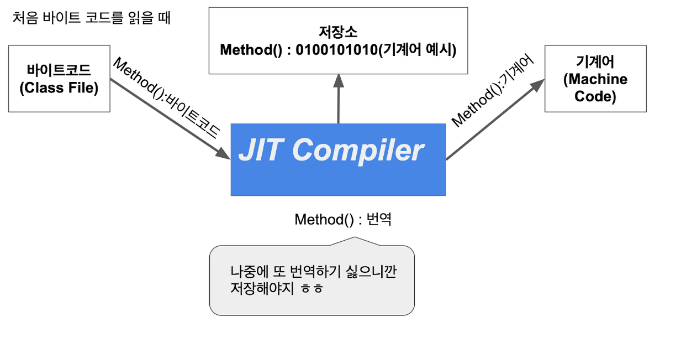
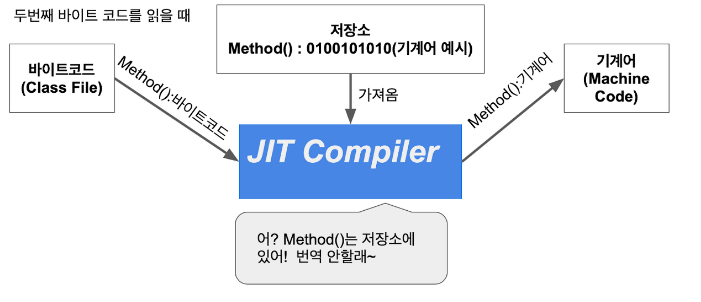
정확히는 JIT 컴파일러가 '번역 안 할래'라고 하기보다는, 인터프리터가 해당 바이트코드를 읽지 않아도 된다는 뜻이다.
JVM 구조 정리
JVM의 구조는 Class Loader, Execution Engine, Runtime Data Areas, JNI, Native Method Library로 이루어져 있다.
• Class Loader : JVM 내로 클래스를 로드하고 링크를 통해 배치하는 작업을 수행하는 모듈
• Execution Engine : 바이트코드를 실행시키는 역할
- 인터프리터 : 바이트코드를 한 줄씩 실행
- JIT 컴파일러 : 인터프리터의 효율을 높이기 위한 컴파일러. 인터프리터가 반복되는 코드를 발견하면 JIT 컴파일러가 그 코드를 네이티브 코드로 바꿔 준다
- GC : 힙 영역에서 쓰이지 않는 객체를 제거하는 작업 수행
• Runtime Data Areas : 프로그램 실행 중에 사용되는 다양한 영역
- PC Register : 스레드가 시작될 때 생성되며 현재 수행 중인 JVM 명령의 주소를 갖는다
- Stack Area : 지역 변수, 파라미터 등이 생성되는 영역. 실제 객체는 Heap에 할당되고 그 레퍼런스만 Stack에 저장된다
- Heap Area : 동적으로 생성된 오브젝트와 배열이 저장되는 곳으로 GC의 영역이다
- Method Area : 클래스 멤버 변수, 메서드 정보, Type 정보, 상수 풀, `static` 변수, `final` 변수 등이 생성된다
• JNI(Java Native Interface) : 자바 애플리케이션에서 C, C++, 어셈블리어로 작성된 함수를 쓸 수 있는 방법을 제공한다
• Native Method Library : C, C++로 작성된 라이브러리
Reference
https://steady-coding.tistory.com/587
GC (Garbage Collection)의 알고리즘
GC의 정의
GC는 Garbage Collector의 약자로, 힙 영역에서 쓰이지 않는 객체를 제거하는 작업을 통틀어 부르는 말이다.
이런 작업이 필요한 이유는 자바가 개발자가 메모리를 직접 해제할 수 없는 언어이기 때문이다. 그래서 객체를 쓰고 제거해 주는 기능이 필요하다.
GC의 동작 방식
정리하면 다음과 같다.
• 가장 단순한 Serial GC를 기준으로 설명한다.
• GC는 Minor GC와 Major GC로 구분한다.
• Minor GC는 young 영역에서, Major GC는 old 영역에서 일어난다.
• GC를 수행할 때는 GC를 수행하는 스레드를 뺀 모든 스레드가 정지한다.
• Minor GC는 Eden 영역이 가득 차면 시작한다.
• Eden 영역에서 참조가 남아 있는 객체를 마킹해 survivor 영역으로 복사한 뒤, Eden 영역을 지운다.
• survivor 영역도 가득 차면 다른 survivor 영역으로 복사하고 비운다. 이를 반복하다 보면 계속 살아남는 객체는 old 영역으로 이동한다.
• Major GC는 old 영역에서 일어난다. Minor GC와 반대로 삭제되어야 하는 객체를 마킹하고 지운다.
• 이때 메모리가 단편화된 상태이므로 한군데로 모아 주어야 한다. 이를 Compaction이라 하며, 전체 과정을 Mark-Sweep-Compact 알고리즘이라 한다.
• 이것이 중요한 이유는, GC가 수행될 때 시스템이 멈추므로 의도치 않은 장애의 원인이 될 수 있기 때문이다.
동작 방식을 더 잘 이해하려면 GC가 채용하는 알고리즘을 살펴보면 된다.
GC의 알고리즘
GC 알고리즘의 중요한 목적은 무엇일까? 크게 두 가지로 나눌 수 있다.
① 어떻게 하면 불필요한 Object를 잘 선별하는가, ② GC가 동작하는 동안 프로그램이 중단되는 시간을 어떻게 줄일 것인가.
불필요한 Object를 발견하고 그 메모리 주소를 되찾는 방법에는 세 가지 알고리즘이 있다.
1) Mark and Sweep 알고리즘
Mark — 필요한 Object를 표시한다. 이를 위해 Garbage Collection Root라고 불리는 특별한 Object를 계속 추적한다. GC Root는 현재 실행되고 있는 메서드의 지역 변수일 수도 있고, 로드된 클래스의 `static` 변수일 수도 있다. GC는 모든 GC Root 그래프를 돌아다니며 필요한 Object를 찾는다.
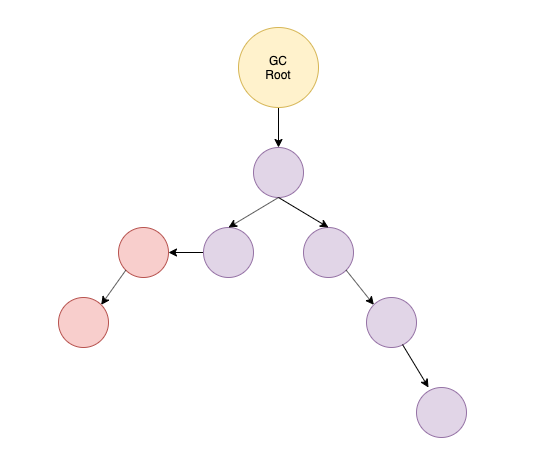
위 그림은 GC Root 그래프다. 보라색은 참조되어 있는 Object이고, 빨간색은 특정 시기에는 참조되었지만 지금은 범위를 벗어나 참조되지 않는 Object들이다.
Sweep — 그래프를 다 돌고 난 뒤, 마크되지 않은(참조되지 않은) Object를 메모리에서 지우고 그 공간을 되찾는다.
만약 GC가 작동할 때 프로그램을 중단시키지 않으면, 관리하는 도중에 새로운 Object가 생성될 수도 있다. 그 Object는 현재 GC가 다루고 있는 Object들과 연결되지 않았을 가능성이 높고, 그로 인해 GC가 방금 생성된 Object를 지워 버릴 수 있다.
2) Mark-Sweep-Compact 알고리즘
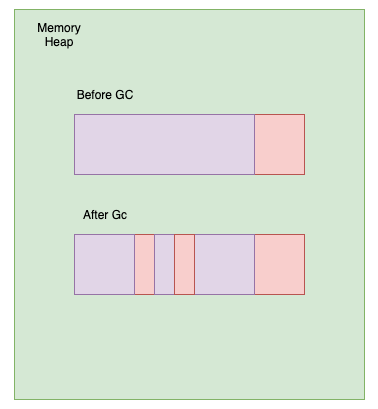
위 그림은 GC 실행 전과 후의 힙 메모리 영역이다. GC가 동작한 뒤 힙에 새로운 공간이 생긴 것을 알 수 있고, 그 공간에 새 Object를 할당할 수 있다.
하지만 보다시피 메모리 공간이 조각조각 나 있다(앞서 설명한 단편화 상태). 그래서 새 Object를 할당할 때, 남아 있는 조각 하나하나로는 그 크기를 담아낼 수 없는 경우가 생긴다. 이 경우 JVM은 메모리를 할당하지 못해 `OutOfMemoryError`를 발생시킨다.
그래서 우리는 Mark-Sweep-Compact 알고리즘을 함께 쓴다. 이 알고리즘을 쓰면 아래와 같이 조각난 공간을 합쳐 준다.
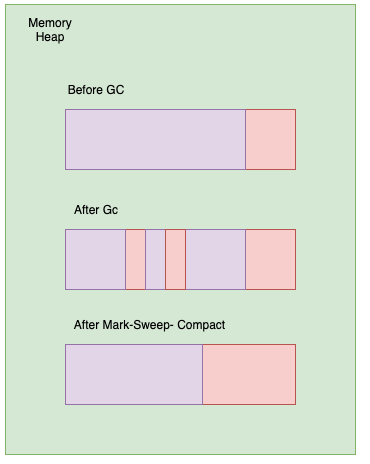
3) Mark and Copy 알고리즘
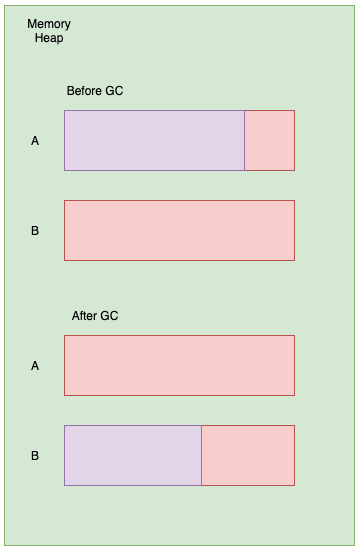
Mark-Sweep-Compact와 마찬가지로, 사용 중인 메모리 주소를 새로 할당하는 알고리즘이다.
Mark and Copy는 GC를 하기 전 두 개의 메모리 공간을 사용한다. A 메모리 안에는 사용된 공간과 사용되지 않은 공간이 섞여 있고, B는 완전히 비어 있다. GC가 실행될 때 다음 두 단계를 수행한다.
• Mark된 Object를 모두 A 메모리에서 지운다.
• 이후 Mark된 Object를 B에 다시 할당한다.
이 단계는 Object가 Mark되는 것과 동시에 진행될 수 있어, 프로그램이 GC 때문에 중단되는 시간을 줄여 준다.
컬렉션 프레임워크 (Collection Framework)
컬렉션 프레임워크란?
배열을 쓰다 보면 여러 가지 비효율이 생긴다. 가장 큰 문제는 크기가 고정적이라는 점이다. 배열의 크기는 생성할 때 결정되고, 그 크기를 넘으면 더 이상 데이터를 저장할 수 없다. 또 데이터를 삭제하면 해당 인덱스가 비어 있는 채로 남아 메모리가 낭비된다.
그래서 자바는 이런 문제를 해결하기 위해, 널리 알려진 자료구조를 바탕으로 객체나 데이터를 효율적으로 관리할 수 있는 자료구조들을 만들어 두었다. 이 자료구조들이 모여 있는 라이브러리를 컬렉션 프레임워크라고 한다. 대표적으로 List, Set, Map, Stack, Queue 등이 있다.
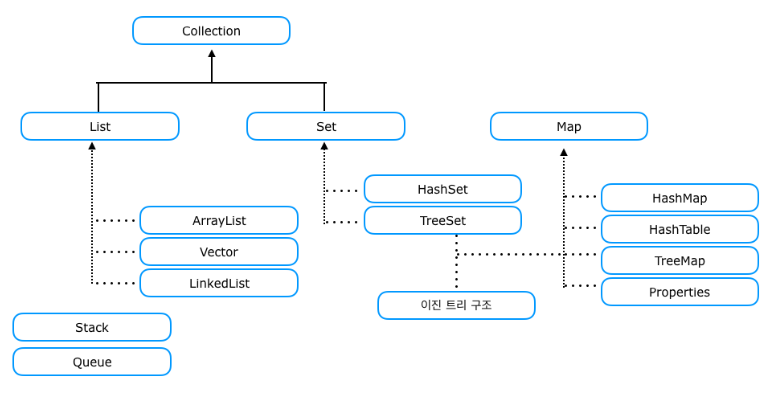
List 컬렉션
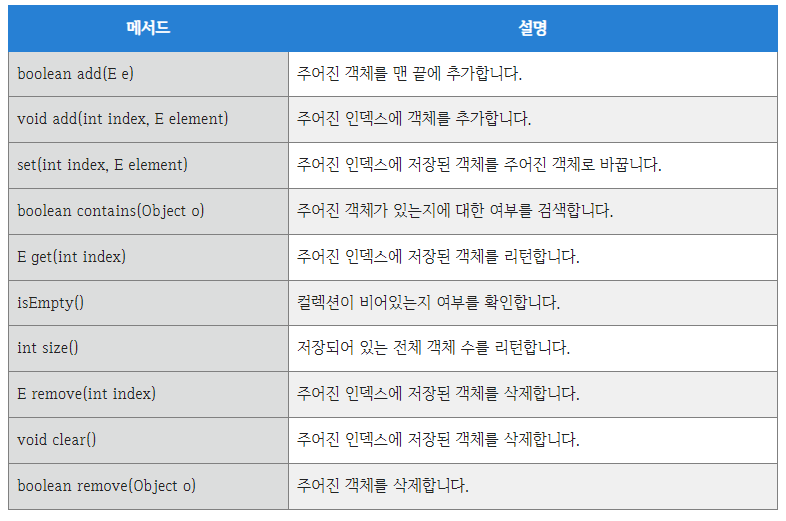
컬렉션 프레임워크를 상속받는 List 컬렉션은 객체를 일렬로 늘어놓은 구조를 가진다. 객체를 인덱스로 관리하기 때문에, 저장하면 자동으로 인덱스가 부여되고 그 인덱스로 검색하거나 삭제할 수 있다.
List 컬렉션은 객체 자체를 저장하는 것이 아니라 객체의 번지를 참조한다. 동일한 객체를 중복 저장할 수 있는데, 이 경우 같은 번지가 참조된다. `null`도 저장할 수 있으며 이때 해당 인덱스는 어떤 객체도 참조하지 않는다.
List를 구현하는 대표 클래스는 `ArrayList`, `LinkedList`, `Vector`다. 이 셋은 모두 List 인터페이스를 상속하므로 공통으로 쓸 수 있는 메서드가 많다. 기본적인 메서드는 아래와 같다.
Set 컬렉션
앞서 본 List는 선형 구조라 추가한 순서대로 저장되어 순서가 유지되지만, Set은 저장 순서가 유지되지 않는다.
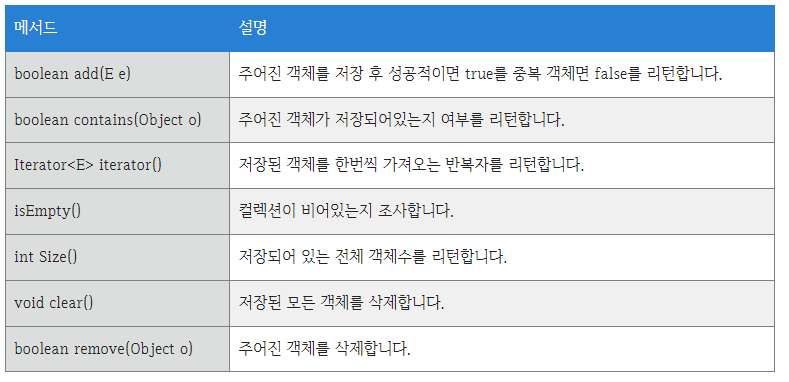
순서 자체가 없으므로 인덱스로 객체를 꺼내는 `get(index)` 메서드도 없다. 대신 전체 객체를 한 번씩 반복해 가져오는 반복자(Iterator)를 제공한다. 반복자는 `iterator()` 메서드를 호출하면 얻을 수 있다.
또한 Set은 객체를 중복 저장할 수 없다. 중복이 안 되므로 `null` 값도 하나만 저장할 수 있다.
Set 컬렉션은 수학의 집합에 비유할 수 있다. 집합도 순서와 상관없고 중복을 허용하지 않기 때문이다. 대표 구현 클래스는 `HashSet`과 `TreeSet`이며, 둘 다 Set 인터페이스를 상속하므로 공통으로 쓸 수 있는 메서드가 있다. 기본 메서드는 아래와 같다.
Map 컬렉션
Map 컬렉션은 키(key)와 값(value)으로 구성된 객체를 저장하는 자료구조다. 키는 중복 저장할 수 없고 값은 중복 저장할 수 있다. 중복된 키가 들어오면 기존 값이 사라지고 새 값으로 대치된다.
Map은 사물함을 떠올리면 쉽다. 사물함에는 번호가 있고 그 안에 물건이 들어 있다. 사물함 번호가 키, 안의 물건이 값이 되는 것이다. 자바의 Map은 이런 대응 관계를 쉽게 표현할 수 있게 해 주는 자료형이다.
Map은 리스트나 배열처럼 순차적으로 값을 구하지 않고 키를 통해 값을 얻는다. 이것이 Map의 가장 큰 특징이다.
대표 구현 클래스는 `HashMap`, `Hashtable`, `LinkedHashMap`, `TreeMap` 등이다. 이들도 Map 인터페이스를 상속하므로 공통으로 쓸 수 있는 메서드가 있다. 기본 메서드는 다음과 같다.
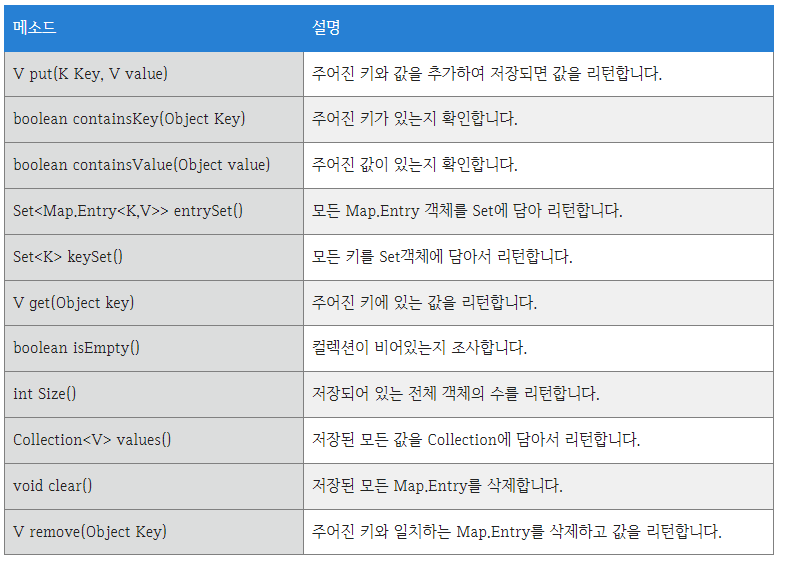
제네릭
제네릭
자바에서 제네릭이란 데이터 타입을 일반화한다는 뜻이다. 클래스나 메소드에서 사용할 내부 데이터 타입을 컴파일 시점에 미리 지정하는 방법이다.
이렇게 컴파일 시점에 타입 검사를 하면 다음 장점이 있다.
• 클래스나 메소드 내부에서 쓰이는 객체의 타입 안전성을 높일 수 있다.
• 반환값에 대한 타입 변환과 타입 검사에 드는 수고를 줄일 수 있다.
자바 5 이전에는 여러 타입을 다루는 대부분의 클래스나 메소드에서 인수나 반환값으로 `Object` 타입을 썼다. 하지만 이 경우 반환된 `Object`를 다시 원하는 타입으로 변환해야 하고, 그 과정에서 오류가 날 가능성이 있다.
자바 5부터 도입된 제네릭을 쓰면 컴파일 시점에 타입이 정해지므로 이런 번거로운 작업을 생략할 수 있다.
그래, 다 좋다. 타입 안전성 때문에 제네릭을 쓴다는 것도 알겠고, 평소에 `List` 객체를 그렇게 쓰는 것도 알겠다. 그런데 문제는 제네릭 클래스와 제네릭 메서드다. 얘네는 왜 쓸까?
제네릭을 쓰는 이유
class StudentInfo {
public int grade;
StudentInfo(int grad) { this.grade = grade; }
}
class StudentPerson {
public StudentInfo info;
StudentPerson(StudentInfo info) { this.info = info; }
}
class EmployeeInfo {
public int rank;
EmployeeInfo(int rank) { this.rank = rank; }
}
class EmployeePerson {
public EmployeeInfo info;
EmployeePerson(EmployeeInfo info) { this.info = info; }
}
public class GenericDemo {
public static void main(String[] args) {
StudentInfo si = new StudentInfo(2);
StudentPerson sp = new StudentPerson(si);
System.out.println(sp.info.grade); // 2
EmployeeInfo ei = new EmployeeInfo(1);
EmployeePerson ep = new EmployeePerson(ei);
System.out.println(ep.info.rank); // 1
}
}
위 코드를 보면 `StudentPerson`과 `EmployeeInfo`가 사실상 같은 구조다. 중복이 발생하고 있다. 중복을 제거해 보자.
class StudentInfo {
public int grade;
StudentInfo(int grade) { this.grade = grade; }
}
class EmployeeInfo {
public int rank;
EmployeeInfo(int rank) { this.rank = rank; }
}
class Person {
public Object info;
Person(Object info) { this.info = info; }
}
public class GenericDemo {
public static void main(String[] args) {
Person p1 = new Person("부장");
EmployeeInfo ei = (EmployeeInfo) p1.info;
System.out.println(ei.rank);
}
}
이 코드는 성공적으로 컴파일된다. 하지만 실행하면 오류가 난다. 어디서 나는 걸까? 바로 이 부분이다.
Person p1 = new Person("부장");
클래스 `Person`의 생성자는 매개변수 `info`의 타입이 `Object`다. 따라서 모든 객체가 올 수 있다. 그래서 위처럼 `EmployeeInfo`가 아니라 `String`이 와도 컴파일 에러가 나지 않는다. 대신 런타임 에러가 난다.
컴파일 언어의 기본은 모든 에러가 컴파일 시점에 발생하도록 유도하는 것이다. 런타임은 실제로 애플리케이션이 동작하고 있는 상황이라, 거기서 나는 에러는 항상 심각한 문제를 부르기 때문이다.
이런 상태를 타입에 안전하지 않다고 한다. 모든 타입이 올 수 있어 타입을 엄격하게 제한할 수 없게 된 것이다.
이것을 제네릭으로 바꿔 보자.
class StudentInfo {
public int grade;
StudentInfo(int grade) { this.grade = grade; }
}
class EmployeeInfo {
public int rank;
EmployeeInfo(int rank) { this.rank = rank; }
}
class Person<T> {
publit T info;
Person(T info) { this.info = info; }
}
public class GenericDemo {
public static void main(String[] args) {
Person<EmployeeInfo> p1 = new Person<EmployeeInfo>(new EmployeeInfo(1));
EmployeeInfo ei1 = p1.info;
System.out.println(ei1.rank); //성공
Person<String> p2 = new Person<String>("부장");
String ei2 = p2.info;
System.out.println(ei2.rank); //컴파일 실패
}
}
`p1`은 잘 작동한다. 중요한 것은 `p2`다. `p2`는 컴파일 오류가 나는데, `p2.info`가 `String`이고 `String`에는 `rank` 필드가 없는데 이를 호출하고 있기 때문이다.
여기서 중요한 점을 정리하면 이렇다.
• 컴파일 단계에서 오류가 검출된다.
• 중복 제거와 타입 안전성을 동시에 얻을 수 있다.
출처 : https://edu.goorm.io/learn/lecture/41/%EB%B0%94%EB%A1%9C%EC%8B%A4%EC%8A%B5-%EC%83%9D%ED%99%9C%EC%BD%94%EB%94%A9-%EC%9E%90%EB%B0%94-java/lesson/807/%EC%A0%9C%EB%84%A4%EB%A6%AD%EC%9D%84-%EC%82%AC%EC%9A%A9%ED%95%98%EB%8A%94-%EC%9D%B4%EC%9C%A0
어노테이션
어노테이션의 정의
어노테이션은 인터페이스를 기반으로 한 문법으로, 주석처럼 코드에 달아 클래스에 특별한 의미를 부여하거나 기능을 주입할 수 있다.
어노테이션의 종류
어노테이션에도 종류가 있다.
• 내장 어노테이션 : 자바가 기본적으로 제공하는 어노테이션
• 메타 어노테이션 : 어노테이션을 위한 어노테이션
• 사용자 정의 어노테이션 : 사용자가 직접 정의하는 어노테이션
내장 어노테이션
메타 어노테이션을 제외한 내장 어노테이션은 다음과 같다.
• `@Override`
• `@Deprecated`
• `@FunctionalInterface`
• `@SuppressWarnings`
하나씩 살펴보자.
@Override
오버라이딩을 올바르게 했는지 컴파일러가 확인해 준다. 오버라이딩할 때 메서드 이름을 잘못 적는 실수를 막아 준다.
@Deprecated
앞으로 쓰지 않기를 권장하는 필드나 메서드에 붙인다.
쓰지 않을 거면 없애 버리면 될 텐데 굳이 붙이는 이유는 뭘까? 자바는 하위 호환성을 굉장히 중요하게 여기는 언어이기 때문이다. 이미 그 메소드로 개발한 프로젝트들이 있으니 유지는 하되, 권장하지는 않는 것이다.
@FunctionalInterface
함수형 인터페이스에 붙이면 컴파일러가 올바르게 작성했는지 확인한다. "하나의 추상 메서드만 가져야 한다"는 제약을 검사해 주고, 이것이 함수형 인터페이스임을 알려 주는 역할도 한다.
@SuppressWarnings
컴파일러의 경고 메시지가 나타나지 않게 해 준다. 보통 경고가 많을 때 이미 확인한 경고를 가려서, 새로 생긴 경고를 놓치지 않도록 하기 위해 쓴다.
메타 어노테이션
메타 어노테이션은 어노테이션을 위한 어노테이션이다. 종류는 다음과 같다.
• `@Target`
• `@Retention`
• `@Documented`
• `@Inherited`
• `@Repeatable`
@Target
어노테이션을 적용할 위치를 정한다. 종류는 다음과 같다.
• `ElementType.PACKAGE` : 패키지 선언
• `ElementType.TYPE` : 타입 선언
• `ElementType.ANNOTATION_TYPE` : 어노테이션 타입 선언
• `ElementType.CONSTRUCTOR` : 생성자 선언
• `ElementType.FIELD` : 멤버 변수 선언
• `ElementType.LOCAL_VARIABLE` : 지역 변수 선언
• `ElementType.METHOD` : 메서드 선언
• `ElementType.PARAMETER` : 전달인자 선언
• `ElementType.TYPE_PARAMETER` : 전달인자 타입 선언
• `ElementType.TYPE_USE` : 타입 선언
@Retention
자바 컴파일러가 어노테이션을 다루는 방법을 기술하며, 어느 시점까지 영향을 미치는지를 결정한다.
• `RetentionPolicy.SOURCE` : 컴파일 전까지만 유효 (컴파일 이후 사라짐)
• `RetentionPolicy.CLASS` : 컴파일러가 클래스를 참조할 때까지 유효
• `RetentionPolicy.RUNTIME` : 컴파일 이후에도 JVM이 계속 참조 가능 (리플렉션 사용)
@Documented
해당 어노테이션을 Javadoc에 포함시킨다.
@Inherited
어노테이션의 상속을 가능하게 한다.
@Repeatable
JDK 1.8부터 지원하며, 연속적으로 어노테이션을 선언할 수 있게 해 준다.
사용자 정의 어노테이션
메타 어노테이션을 이용해 만든 어노테이션이다. 스프링이 제공하는 어노테이션은 대부분 사용자 정의 어노테이션이다. 간단한 예시만 보고 끝내자.
@Target(ElementType.METHOD)
@Retention(RetentionPolicy.RUNTIME)
@Inherited
@Documented
public @interface TimeCheck {
String value();
}
@TimeCheck
public Long save(Member member) {
memberRepository.save(member);
return member.getId();
}
면접 준비 : 클래스와 객체
Q. 클래스와 객체에 대해 설명해 주세요.
A. 클래스는 객체를 정의하는 틀 또는 설계도를 뜻합니다. 객체는 식별 가능한 개체나 사물을 의미하며, 구별 가능한 식별자와 특징적인 행동, 그리고 변경 가능한 상태를 가집니다. 인스턴스를 통칭하는 용어로도 쓰입니다.
정적 (static)
static
Java에서 `static` 키워드를 쓴다는 것은 메모리에 한 번 할당되어 프로그램이 종료될 때 해제된다는 뜻이다. 이를 정확히 이해하려면 메모리 영역에 대한 이해가 필요하다.
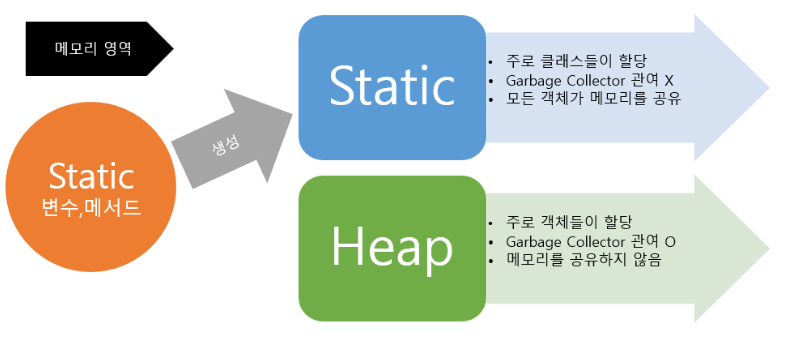
일반적으로 우리가 만든 클래스는 static 영역에 생성되고, `new` 연산자로 동적 할당된 객체들은 Heap 영역에 생성된다.
객체 생성 시 할당된 Heap 영역의 메모리는 GC가 수시로 관리한다. 반면 `static` 키워드로 static 영역에 할당된 메모리는 모든 객체가 공유한다는 장점이 있지만, GC의 관리 영역 밖에 있어서 프로그램이 끝날 때까지 할당된 채로 남는다.
그래서 너무 남발하면 시스템 성능에 악영향을 줄 수 있다.
자바의 Metaspace
Metaspace
Java 8부터 JVM의 메모리 영역 중 PermGen(Permanent Generation)이 사라지고 Metaspace 영역이 생겼다.
Metaspace는 간단히 말해 Java의 클래스 로더가 로드한 클래스들의 메타데이터가 저장되는 공간이다.
여기서 잠깐, 메타데이터가 뭘까?
메타데이터란?
컴퓨터 사이언스에서 말하는 메타데이터는 흔히 이렇게 정의한다. "어떤 목적을 가지고 만들어진 데이터"
디지털 카메라를 예로 들어 보자. 사진을 찍어 기록할 때마다 카메라 자체의 정보와 촬영 당시의 시간, 노출도, 플래시 사용 여부, 해상도, 사진 크기 같은 정보가 화상 데이터와 함께 저장된다.
이런 데이터를 분석해 활용하면 나중에 사진을 정리하거나 가공할 때 아주 유용하다. GPS를 써서 위치 정보까지 넣어 두면 사진이 어디서 촬영되었는지 쉽게 알 수 있고, 같은 지역에서 찍은 다른 사진을 찾는 것도 쉬워진다.
추상적인 이야기는 여기까지 하고, 그래서 자바에서 메타데이터가 뭔데? 뭐가 Metaspace에 저장되는데? 자바에서 가장 대표적인 메타데이터는 바로 어노테이션이다.
자바 입장에서 메타데이터란, 애플리케이션이 처리해야 할 데이터가 아니라 컴파일과 실행 과정에서 코드를 어떻게 컴파일하고 처리할지 알려 주는 데이터다.
이제 본문으로 돌아오자.
Java 7까지의 PermGen과 Java 8 이후 Metaspace의 가장 큰 차이는, Metaspace가 Heap 영역이 아니라 Native Memory 영역에 위치한다는 점이다. 아래 그림을 참고하자.
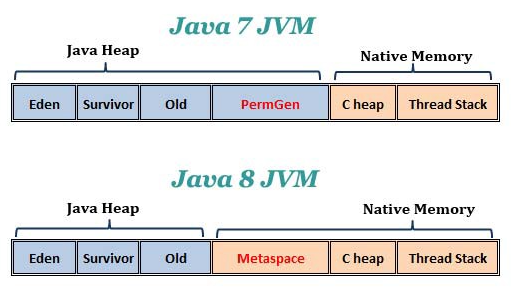
그럼 Native Memory도 알아봐야 하지 않을까?
Native Memory
Native Memory는 Heap 바깥인 Off-Heap 공간을 의미한다. 쉽게 말해 시스템의 기본 메모리라고 생각하면 된다. Java 애플리케이션은 크게 Heap과 Off-Heap 두 공간을 활용해 동작한다.
그래서 애플리케이션을 배포할 때 메모리를 몇 GB 할당할지 정하면서 `-Xmx`(Heap 최대치) 값만 생각하면 OOME에 빠지기 쉽다.
실제로는 `-Xmx`에 MaxMetaspace 값을 더하고, 추가로 프로그램에서 NIO로 Native Memory를 직접 할당받는 로직까지 고려해서 Heap + Native Memory 총량으로 잡아야 비교적 정확하다.
다시 본문으로 돌아와서.
이제 `java.lang.OutOfMemoryError: PermGen space` 같은 종류의 OOM은 더 이상 마주칠 일이 없다. Metaspace의 크기는 `-Xmx`가 아니라 호스트 운영체제에 의해 제약되기 때문이다.
그런데 이 말은 곧, 애플리케이션이 많은 클래스를 로드하면 단순한 애플리케이션 OOM이 아니라 전체 서버를 다운시킬 수도 있다는 뜻이 된다. 따라서 적절한 flag 값(`-XX:MaxMetaspaceSize` 등)을 설정해 주는 것이 필요할 수 있다.
Metaspace는 언제 할당되고 해제될까? 할당은 클래스가 로드되어 런타임이 JVM에 준비될 때, 클래스 메타데이터 저장을 위해 클래스로더에 의해 이루어진다. 즉 런타임 시점이다. 해제는 클래스로더가 언로드될 때만 일어난다.
Metaspace의 크기를 지정하는 대표적인 파라미터는 다음과 같다.
• `-XX:MetaspaceSize` : 초기(최소) Metaspace 크기
• `-XX:MaxMetaspaceSize` : 최대 Metaspace 크기
• `-XX:CompressedClassSpaceSize` : Metaspace의 중요한 부분인 Compressed Class Space의 가상 크기를 지정한다. 기본값은 1GB, 최댓값은 3GB다.
GC와 연관된 이야기
앞서 말했듯 Metaspace 공간의 해제는 오직 클래스가 언로드되고 GC가 일어날 때만 발생한다.
따라서 Heap 입장에서는 GC로 얻을 것이 많지 않은 경우라도, Metaspace 안의 오래된 클래스 메타데이터를 청소하기 위해 GC를 수행하는 편이 효율적일 수 있다.
Metaspace에서 유도되는 GC는 대표적으로 두 가지가 있다.
• Metaspace 할당 시 : 지속적으로 메타데이터를 쌓으며 Metaspace를 확장시키는 대신, 효율적 활용을 위해 어느 임계점에서 오래된 클래스로더들을 GC로 정리하려 시도한다.
• Metaspace OOME 시 : 커밋된 메모리의 합계가 `MaxMetaspaceSize`를 넘었거나 Compressed Class Space가 부족할 때 GC가 쓰일 수 있다.
Reference
(순서대로 메타스페이스, 메타데이터, Native Memory)
https://jaemunbro.medium.com/java-metaspace%EC%97%90-%EB%8C%80%ED%95%B4-%EC%95%8C%EC%95%84%EB%B3%B4%EC%9E%90-ac363816d35e
https://veneas.tistory.com/entry/Java-Annotation-%EB%A9%94%ED%83%80%EB%8D%B0%EC%9D%B4%ED%84%B0
https://m.post.naver.com/viewer/postView.nhn?volumeNo=23726161&memberNo=36733075
객체지향 5대 원칙 SOLID
객체지향 프로그래밍의 5가지 설계 원칙, SOLID
SOLID란 객체지향 프로그래밍에서 지켜야 하는 5대 원칙이다. SRP(단일 책임 원칙), OCP(개방-폐쇄 원칙), LSP(리스코프 치환 원칙), ISP(인터페이스 분리 원칙), DIP(의존관계 역전 원칙)의 앞 글자를 따서 만들어졌다.
SOLID 원칙을 철저히 지키면 시간이 지나도 변경이 쉽고, 유지보수와 확장이 편한 소프트웨어를 만드는 데 도움이 된다고 알려져 있다.
이제부터 하나씩 살펴보자.
단일 책임 원칙 SRP (Single Responsibility Principle)
단일 책임 원칙은 하나의 모듈은 한 가지 책임만 가져야 한다는 것으로, 모듈이 변경되는 이유가 한 가지여야 함을 의미한다.
여기서 변경의 이유가 한 가지라는 것은, 그 모듈이 여러 대상 또는 액터에 대해 책임을 가져서는 안 되고 오직 하나의 액터에 대해서만 책임을 져야 한다는 뜻이다.
어떤 모듈이 여러 액터에 대해 책임을 지고 있다면, 여러 액터로부터 변경 요구가 올 수 있으므로 그 모듈을 수정해야 하는 이유도 여러 개가 된다. 반면 단 하나의 책임만 갖고 있다면 변경해야 하는 이유와 시점이 명확해진다.
예를 들어 사용자 정보를 입력받아 비밀번호를 암호화해 데이터베이스에 저장하는 로직이 있다고 하자.
@Service
@RequiredArgsConstructor
public class UserService {
private final UserRepository userRepository
public void addUser(final String email, final String pw) {
final StringBuilder sb = new StringBuilder();
for (byte b : pw.getBytes(StandardCharsets.UTF_*)) {
sb.append(Integer.toString((b & 0xff) + 0x100, 16).substring(1));
}
final String encryptedPassword = sb.toString();
final User user = User.builder().email(email).pw(encryptedPassword).build();
userRepository.save(user);
}
}
위 `UserService`의 사용자 추가 로직에는 다음처럼 다양한 액터로부터 변경이 발생할 수 있다.
• 기획팀 : 사용자를 추가할 때 역할에 대한 정의가 필요하다.
• 보안팀 : 사용자의 비밀번호 암호화 방식에 개선이 필요하다.
• 기타 등등
이런 문제가 생기는 이유는 `UserService`가 단 하나의 책임만 갖고 있지 못하기 때문이다. 해결하려면 비밀번호 암호화에 대한 책임을 분리해야 한다.
아래처럼 비밀번호 암호화를 책임지는 별도의 클래스를 만들어 `UserService`로부터 추상화하고, 그 클래스를 합성해 사용하면 문제를 해결할 수 있다. 그러면 "비밀번호 암호화 방식을 개선해 달라"는 변경을 `UserService`로부터 분리할 수 있다.
@Component
public class SimplePasswordEncoder {
public void encryptPassword(final String pw) {
final StringBuilder sb = new StringBuilder();
for(byte b : pw.getBytes(StandardCharsets.UTF_8)) {
sb.append(Integer.toString((b & 0xff) + 0x100, 16).substring(1));
}
return sb.toString();
}
}
@Service
@RequiredArgsConstructor
public class UserService {
private final UserRepository userRepository;
private final SimplePasswordEncoder passwordEncoder;
public void addUser(final String email, final String pw) {
final String encryptedPassword = passwordEncoder.encryptPassword(pw);
final User user = User.builder()
.email(email)
.pw(encryptedPassword).build();
userRepository.save(user);
}
}
단일 책임 원칙을 제대로 지키면 변경이 필요할 때 수정할 대상이 명확해진다. 그리고 이 장점은 시스템이 커질수록 극대화된다. 서로 많은 의존성을 갖게 되는 상황에서도 변경 요청이 오면 딱 한 가지만 수정하면 되기 때문이다.
책임과 관심이 다른 코드를 적절히 분리하고 서로 영향을 주지 않도록 추상화하면, 애플리케이션의 변화에 손쉽게 대응할 수 있다.
개방-폐쇄 원칙 OCP (Open-Closed Principle)
개방-폐쇄 원칙은 확장에는 열려 있고 수정에는 닫혀 있어야 한다는 원칙이다. 각각의 의미는 다음과 같다.
• 확장에 열려 있다 : 요구사항이 바뀔 때 새로운 동작을 추가해 기능을 확장할 수 있다.
• 수정에 닫혀 있다 : 기존 코드를 수정하지 않고 동작을 추가하거나 변경할 수 있다.
이번에는 비밀번호 암호화를 강화해야 한다는 요구사항이 새로 들어왔다고 하자. 그래서 SHA-256 알고리즘을 쓰는 새로운 `PasswordEncoder`를 만들었다.
(물론 SHA-256을 비밀번호 암호화에 쓰는 것은 적절하지 않다. 해시된 값들을 미리 적어 두고 대조하는 레인보우 테이블 공격이 가능하기 때문이다. 다만 여기서는 개방-폐쇄 원칙을 설명하기 위한 예시로만 쓴다.)
@Component
public class SHA256PasswordEncoder {
private final static String SHA_256 = "SHA-256";
public String encryptPassword(final String pw) {
final MessageDigest digest;
try {
digest = MessageDigest.getInstance(SHA_256);
} catch (NoSuchAlgorithmException e) {
throw new IllegalArgumentException();
}
final byte[] encodedHash = digest.digest(pw.getBytes(StandardCharsets.UTF_8));
return bytesToHex(encodedHash);
}
private String bytesToHex(final byte[] encodedHash) {
final StringBuilder hexString = new StringBuilder(2 * encodedHash.length);
for (final byte hash : encodedHash) {
final String hex = Integer.toHexString(0xff & hash);
if (hex.length() == 1) {
hexString.append('0');
}
hexString.append(hex);
}
return hexString.toString();
}
}
그런데 새 암호화 정책을 적용하려고 보니, 정작 그 정책과 무관한 `UserService`를 아래처럼 수정해 주어야 하는 문제가 생겼다.
@Service
@RequiredArgsConstructor
public class UserService {
private final UserRepository userRepository;
private final SHA256PasswordEncoder passwordEncoder;
...
}
이는 기존 코드를 수정하지 않아야 한다는 개방-폐쇄 원칙에 위배된다. 게다가 나중에 또 정책을 바꿔야 한다는 요구가 오면 `UserService`를 또 고쳐야 한다.
이 문제를 해결하고 개방-폐쇄 원칙을 지키려면 추상화에 의존해야 한다.
추상화란 핵심적인 부분만 남기고 불필요한 부분을 제거해 복잡한 것을 간단히 하는 것이다. 변하지 않는 부분만 남김으로써 기능을 구체화하고 확장할 수 있다. 변하지 않는 것은 고정하고 변하는 것은 생략해 추상화하면, 변경이 필요할 때 생략된 부분만 수정하면 된다.
위 예제에서 변하지 않는 것은 사용자를 추가할 때 암호화가 필요하다는 사실이고, 변하는 것은 구체적인 암호화 정책이다. 그러므로 `UserService`는 어떤 정책이 쓰이는지 알 필요 없이, `passwordEncoder` 객체로부터 암호화된 비밀번호를 받기만 하면 된다.
즉 `UserService`가 구체 클래스가 아니라 `PasswordEncoder`라는 인터페이스에 의존하도록 추상화하면, 개방-폐쇄 원칙을 충족하는 코드를 쓸 수 있다.
public interface PasswordEncoder {
String encryptPassword(final String pw);
}
@Component
public class SHA256PasswordEncoder implements PasswordEncoder {
@Override
public String encryptPassword(final String pw) {
...
}
}
@Service
@RequiredArgsConstructor
public class UserService {
private final UserRepository userRepository;
private final PasswordEncoder passwordEncoder;
public void addUser(final String email, final String pw) {
final String encryptedPassword = passwordEncoder.encryptPassword(pw);
final User user = User.builder()
.email(email)
.pw(encryptedPassword).build();
userRepository.save(user);
}
}
개방-폐쇄 원칙이 본질적으로 말하는 것은 추상화이며, 이는 결국 런타임 의존성과 컴파일타임 의존성에 대한 이야기다. 런타임 의존성이란 애플리케이션 실행 시점의 객체 관계를 의미하고, 컴파일타임 의존성이란 코드에 표현된 클래스들의 관계를 의미한다.
다형성을 지원하는 객체지향 프로그래밍에서 이 둘은 같지 않다. 위 예제에서 `UserService`는 컴파일 시점에는 추상화된 `PasswordEncoder`에 의존하지만, 런타임 시점에는 구체 클래스인 `SHA256PasswordEncoder`에 의존한다.
객체가 알아야 하는 지식이 많으면 결합도가 높아지고, 결합도가 높아질수록 개방-폐쇄 원칙을 따르는 구조를 설계하기 어려워진다. 추상화로 변하는 것은 숨기고 변하지 않는 것에 의존하게 하면, 기존 코드를 수정하지 않은 채 애플리케이션을 확장할 수 있다.
인터페이스 분리 원칙 ISP (Interface Segregation Principle)
객체가 충분히 높은 응집도의 작은 단위로 설계됐더라도, 목적과 관심이 다른 클라이언트가 있다면 인터페이스로 적절히 분리해 줄 필요가 있다. 이를 인터페이스 분리 원칙이라 부른다.
즉 클라이언트의 목적과 용도에 적합한 인터페이스만 제공하는 것이다. 이를 지키면 모든 클라이언트가 자신의 관심에 맞는 퍼블릭 인터페이스(외부에서 접근 가능한 메시지)만 접근하게 되어 불필요한 간섭을 최소화할 수 있고, 기존 클라이언트에 영향을 주지 않고도 유연하게 기능을 확장하거나 수정할 수 있다.
어떤 구현체에 부가 기능이 필요하다면, 그 인터페이스를 구현하는 다른 인터페이스를 만들어 해결할 수 있다. 예를 들어 파일 읽기/쓰기 기능을 가진 구현 클래스가 있는데 어떤 클라이언트는 읽기만 필요하다면, 별도의 읽기 인터페이스를 만들어 제공하는 것이다.
예를 들어 사용자가 비밀번호를 변경할 때 입력한 비밀번호가 기존 것과 같은지 검사하는 로직을, 다른 Authentication 로직에 추가해야 한다고 하자. 그러면 아래처럼 `isCorrectPassword`라는 퍼블릭 인터페이스를 `SHA256PasswordEncoder`에 추가하게 될 것이다.
@Component
public class SHA256PasswordEncoder implements PasswordEncoder {
@Override
public String encryptPassword(final String pw) {
...
}
public String isCorrectPassword(final String rawPw, final String pw) {
final String encryptedPw = encryptPassword(rawPw);
return encryptedPw.equals(pw);
}
}
하지만 `UserService`는 암호화를 위한 `encryptPassword()`만 필요하고 `isCorrectPassword`는 알 필요가 없다.
현재 `UserService`는 `PasswordEncoder`를 주입받아 `encryptPassword`에만 접근할 수 있으니 분리가 잘 된 것처럼 보인다. 하지만 새로 추가될 Authentication 로직은 `isCorrectPassword`에 접근하려고 구체 클래스인 `SHA256PasswordEncoder`를 주입받아야 하는데, 그러면 불필요한 `encryptPassword`에도 접근 가능해져 인터페이스 분리 원칙을 위배하게 된다.
물론 `PasswordEncoder`에 `isCorrectPassword`를 추가할 수도 있다. 하지만 클라이언트의 목적과 용도에 맞는 인터페이스만 제공한다는 원칙을 지키기 위해서라도, 이미 만든 인터페이스는 건드리지 않는 것이 좋다.
그러므로 이 상황을 해결하려면 비밀번호 검사를 의미하는 별도의 인터페이스(`PasswordChecker`)를 만들고, 그 인터페이스로 주입받게 하는 것이 적합하다.
public interface PasswordChecker {
String isCorrectPassword(final String rawPw, final String pw);
}
@Component
public class SHA256PasswordEncoder implements PasswordEncoder, PasswordChecker {
@Override
public String encryptPassword(final String pw) {
...
}
@Override
public String isCorrectPassword(final String rawPw, final String pw) {
final String encryptedPw = encryptPassword(rawPw);
return encryptedPw.equals(pw);
}
}
클라이언트에 따라 인터페이스를 분리하면 변경에 대한 영향을 더 세밀하게 제어할 수 있다.
리스코프 치환 원칙 LSP (Liskov Substitution Principle)
리스코프 치환 원칙은 1988년 바바라 리스코프가 올바른 상속 관계의 특징을 정의하기 위해 발표한 것으로, 하위 타입은 상위 타입을 대체할 수 있어야 한다는 원칙이다.
즉 그 객체를 쓰는 클라이언트는 상위 타입이 하위 타입으로 바뀌어도 차이를 인식하지 못한 채, 상위 타입의 퍼블릭 인터페이스로 서브 클래스를 쓸 수 있어야 한다.
이해를 위해 기존 예시들과 다른, "정사각형은 직사각형이다(Square is a Rectangle)"라는 예시를 보자. 직사각형과 정사각형을 각각 구현하면 다음과 같다.
@Getter
@Setter
@AllArgsConstructor
public class Rectangle {
private int width, height;
public int getArea() {
return width * height;
}
}
public class Square extends Rectangle {
public Square(int size) {
super(size, size);
}
@Override
public void setWidth(int width) {
super.setWidth(width);
super.setHeight(width);
}
@Override
public void setHeight(int height) {
super.setWidth(height);
super.setHeight(height);
}
}
public class Main
{
public static void main(String[] args)
{
Rectangle rectangle = new Rectangle();
rectangle.setWidth(10);
rectangle.setHeight(5);
System.out.println(rectangle.getArea());
}
}
`Rectangle`의 넓이를 구하는 코드는 다음과 같다. 너비 10, 높이 5가 할당되었으므로 넓이 50이 정상적으로 반환된다.
리스코프 치환 원칙에 따르면 자식 객체는 부모 객체를 완전히 대체할 수 있어야 하므로, `Rectangle`을 상속받은 `Square`로 바꿔 넓이를 구해 보자. 완전히 대체됐다면 동일하게 50이 나와야 한다.
public class Main
{
public static void main(String[] args)
{
Rectangle rectangle = new Square();
rectangle.setWidth(10);
rectangle.setHeight(5);
System.out.println(rectangle.getArea());
}
}
하지만 50이 아닌 25가 반환된다. 자세히 보니 마지막에 수행된 `setHeight(5)`가 너비와 높이를 모두 5로 할당했다. 그러니 넓이도 25가 될 수밖에 없었다. 즉 이 코드는 리스코프 치환 원칙에 위배된다.
곰곰이 생각해 보면 직사각형과 정사각형은 상속 관계가 될 수 없다. 사각형의 특징을 서로 갖고 있긴 하지만, 둘 다 사각형의 한 종류일 뿐 하나가 다른 하나를 완전히 포함하지 못하는 구조이기 때문이다.
이렇게 잘못된 객체를 상속하거나 올바르게 확장하지 못하면, 겉보기에는 정상이지만 올바른 객체는 아니다.
그렇다면 이 코드를 어떻게 고쳐야 할까? 답은 올바른 상속과 구현에 있다. 앞서 말했듯 직사각형과 정사각형은 상속 관계가 성립하기 어렵다. 따라서 이보다 상위 개념인 사각형 객체를 만들고 둘이 이를 상속받으면 된다.
@Getter
@Setter
public class Shape {
protected int width;
protected int height;
public int getArea() {
return width * height;
}
}
위와 같이 `Shape`라는 사각형 객체를 만든다.
class Rectangle extends Shape {
public Rectangle(int width, int height) {
setWidth(width);
setHeight(height);
}
}
class Square extends Shape {
public Square(int length) {
setWidth(length);
setHeight(length);
}
}
`Shape`를 상속받는 `Rectangle`과 `Square`는 위와 같다. `Rectangle`은 인스턴스 생성 시 `width`와 `height`를 받고, `Square`는 각 변의 길이가 모두 같으므로 `length` 하나만 받는다.
public class Main
{
public static void main(String[] args)
{
Shape rectangle = new Rectangle(10, 5);
Shape square = new Square(5);
System.out.println(rectangle.getArea());
System.out.println(square.getArea());
}
}
이렇게 하면 값이 50과 25로 각각 올바르게 나오며, 리스코프 치환 원칙 위반에서 벗어난다.
의존관계 역전 원칙 DIP (Dependency Inversion Principle)
의존 역전 원칙이란 고수준 모듈은 저수준 모듈의 구현에 의존해서는 안 되며, 저수준 모듈이 고수준 모듈에서 정의한 추상 타입에 의존해야 한다는 것이다.
객체지향에서는 객체끼리 메시지를 주고받기 위해 의존성이 생기는데, 의존 역전 원칙은 올바른 의존 관계를 위한 원칙이다. 여기서 고수준 모듈과 저수준 모듈은 각각 다음을 의미한다.
• 고수준 모듈 : 변경이 없는 추상화된 클래스(또는 인터페이스)
• 저수준 모듈 : 변하기 쉬운 구체 클래스
즉 의존 역전 원칙이란 결국 추상화에 의존하고 구체화에는 의존하지 않는 설계 원칙이다.
우리는 앞의 예시들에서 이미 이 원칙에 맞게 코드를 고쳐 본 경험이 있다. 앞서 살펴봤던 `SimplePasswordEncoder`는 변하기 쉬운 구체 클래스인데, `UserService`가 여기에 직접 의존하는 것은 의존 역전 원칙에 위배된다.
그래서 `UserService`가 변하지 않는 추상화에 의존하도록, `PasswordEncoder` 인터페이스를 만들어 그것에 의존하게 바꿨다. 그 덕분에 암호화 정책이 바뀌어도 변경이 다른 곳으로 전파되지 않는 유연한 애플리케이션이 된다.
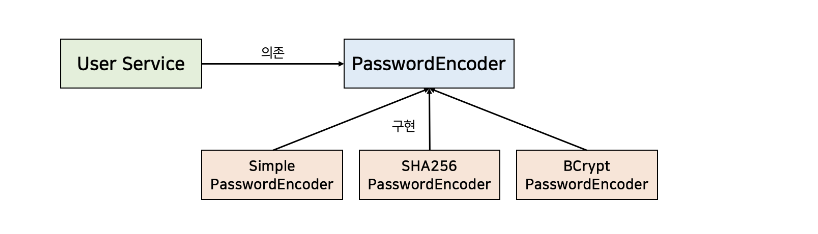
살펴보았듯 의존 역전 원칙은 개방-폐쇄 원칙과 밀접한 관련이 있으며, 의존 역전 원칙이 위배되면 개방-폐쇄 원칙도 위배될 가능성이 높다.
또한 주의할 점이 있다. 의존성이 역전되는 시점은 컴파일 시점이라는 것이다. 런타임 시점에는 `UserService`가 `SHA256PasswordEncoder`라는 구체 클래스에 의존하게 된다. 의존 역전 원칙은 컴파일 시점, 즉 소스 코드 단계에서의 역전을 의미하며, 코드상에서는 `UserService`가 `PasswordEncoder` 인터페이스에 의존한다.
여기까지 읽으면서 느꼈겠지만, 5가지 객체지향 설계 원칙 SOLID가 말하는 핵심은 결국 추상화다. 구체 클래스가 아니라 추상 클래스에 의존함으로써 우리는 유연하고 확장 가능한 애플리케이션을 만들 수 있다.
Reference
https://mangkyu.tistory.com/194
동일성(identity)과 동등성(equality)
동일성
동일성은 두 객체가 완전히 같은 경우를 의미한다. 여기서 완전히 같다는 것은 두 객체를 사실상 하나로 봐도 무방하다는 뜻이다. 주소 값이 같아서 두 변수가 같은 객체를 가리키게 된다.
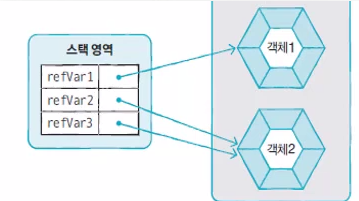
위 예제에서 `refVar1`은 객체1을, `refVar2`와 `refVar3`는 객체2를 가리키고 있다. `refVar2`와 `refVar3`는 동일한 객체를 가리키므로 동일하다고 말할 수 있다. 동일한지는 `==` 연산자로 판별한다.
참고로 Primitive 타입은 객체가 아니라 주소가 없으므로, `==` 연산자를 썼을 때 내용이 같으면 동일하다고 판단한다.
동등성
동등성은 두 객체가 같은 정보를 갖고 있는 경우를 의미한다. 참조하는 객체의 주소가 서로 다르더라도 내용만 같으면 동등하다고 말할 수 있다.
즉 동일하면 동등하지만, 동등하다고 동일한 것은 아니다. 동등한지는 `equals` 메소드로 판별한다.
String str1 = new String("aaa");
String str2 = new String("aaa");
System.out.println(str1 == str2);
System.out.println(str1.equals(str2));
`new` 연산자로 서로 다른 `String` 객체를 메모리에 할당했으므로 `str1`과 `str2`가 가리키는 주소 값은 다르다. 따라서 동일하지 않다. 하지만 `String`이 재정의한 `equals()` 메서드에 의해 두 객체의 내용이 같으므로 동등하다.
equals() 메서드
어떤 객체든 `equals` 메서드만 쓰면 동등성 판단이 되는 것은 아니다. 먼저 이 메서드가 최초로 정의된 형태를 보자.
public boolean equals(Object obj) {
return (this == obj);
}
위 메서드는 모든 객체의 조상인 `Object`에서 정의하고 있는 `equals`다. 내용을 보면 알 수 있듯 단순히 동일성 비교를 하고 있다.
즉 자식 객체에서 재정의하지 않는 이상, `equals` 메서드는 `==` 연산자와 다르지 않다. 대표적으로 `equals`를 재정의한 객체 몇 가지를 살펴보자.
String의 equals 메서드
public boolean equals(Object anObject) {
if (this == anObject) {
return true;
}
if (anObject instanceof String) {
String anotherString = (String)anObject;
int n = value.length;
if (n == anotherString.value.length) {
char v1[] = value;
char v2[] = anotherString.value;
int i = 0;
while (n-- != 0) {
if (v1[i] != v2[i])
return false;
i++;
}
return true;
}
}
return false;
}
`String` 클래스는 위와 같이 `equals`를 재정의해 인자로 전달된 문자열을 비교한다.
코드를 보면 먼저 `==`로 두 객체의 동일성을 판단하고, 동일하지 않다면 `String`인지 확인한 뒤, 문자 하나하나가 같은지 비교한다. 모든 문자가 같다면 내용이 같은 것이므로 동등하다고 판별한다.
Integer의 equals 메서드
public boolean equals(Object obj) {
if (obj instanceof Integer) {
return value == ((Integer)obj).intValue();
}
return false;
}
`Integer` 클래스는 위와 같이 `equals`를 재정의해 인자로 전달된 값을 비교한다.
먼저 인자가 `Integer`인지 확인하고, 내용에 해당하는 정수를 `==` 연산자로 비교한다. 정수가 같다면 내용이 같은 것이므로 동등하다고 판별한다.
Object의 equals 메서드
public static boolean equals(Object a, Object b) {
return (a == b) || (a != null && a.equals(b));
}
`Object` 클래스는 위와 같이 `equals`를 재정의해 두 객체가 동등한지 비교한다.
`==` 연산자로 두 객체가 동일하다면 동등하므로 `true`를 반환하고, 그렇지 않다면 첫 번째 매개변수로 들어온 객체의 `equals`를 호출해 동등성을 판단한다.
즉 이 메서드는 전적으로 첫 번째 매개변수로 들어온 객체에 의존한다. 만약 그 객체가 `equals`를 재정의하지 않았다면 결국 동일성 비교를 하게 된다.
따라서 개발자가 커스텀 객체를 만들었고 동등성 비교가 필요하다면, 반드시 `equals` 메서드를 재정의해야 한다.
Reference
https://steady-coding.tistory.com/534
원시타입과 참조타입
원시타입
원시타입은 정수, 실수, 문자, 논리 리터럴 등 실제 데이터 값을 저장하는 타입이다.
`int a = 10;`이라고 작성하면, 정수 값을 담을 수 있는 `a`라는 이름의 메모리 공간이 스택 영역에 생성되고 그 안에 `10`이 들어간다. 즉 원시타입은 메모리 공간에 실제 데이터 값이 저장되어 있다.
참조타입
참조타입은 기본타입을 제외한 타입으로, 객체의 주소를 저장하는 타입이다. 문자열, 배열, 열거형 상수, 클래스, 인터페이스 등이 여기 속한다.
Java에서 실제 객체는 힙 영역에 저장되고, 참조타입 변수는 그 객체의 주소를 스택 영역에 저장한다. 객체를 쓸 때마다 참조 변수에 저장된 주소를 불러와 사용한다.
`Person p = new Person();`이라고 작성하면 `p`라는 메모리 공간이 스택 영역에 생기고, 생성된 인스턴스는 힙 영역에 만들어진다. 즉 스택 영역의 참조 변수는 힙 영역에 있는 인스턴스의 주소 값을 가지게 된다.
원시타입 vs 참조타입
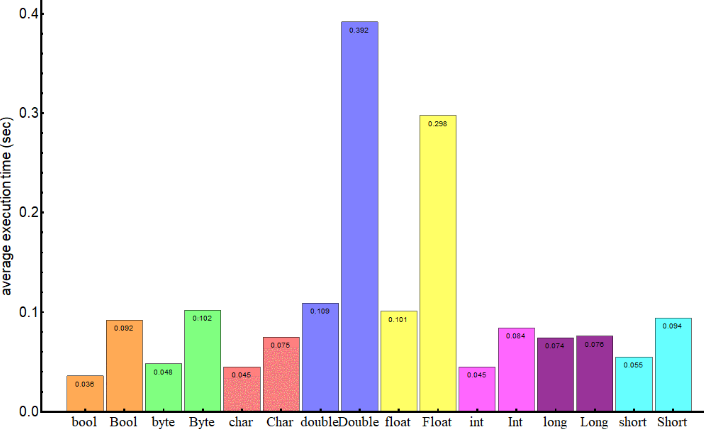
원시타입은 스택 영역에 존재한다. 반면 참조타입은 스택 영역에 참조 값만 있고 실제 값은 힙 영역에 있다.
그래서 참조타입은 최소 두 번 메모리에 접근해야 한다. 게다가 일부 타입은 값이 필요할 때 언박싱 과정(예: `Double` → `double`, `Integer` → `int`)을 거쳐야 하므로, 원시타입보다 접근 속도가 느린 편이다.
메모리 관점
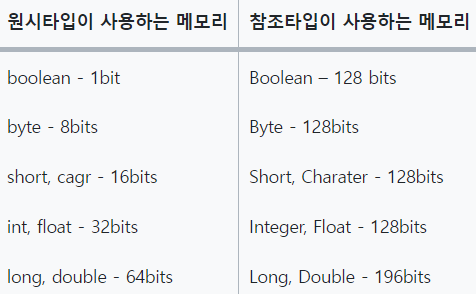
원시타입보다 참조타입이 쓰는 메모리 양이 압도적으로 많다. 참조타입은 최근 들어 64비트 JVM을 많이 쓰므로 일반적으로 64비트를 차지한다고 한다.
null 관점
원시타입은 `null`을 담을 수 없지만 참조타입은 담을 수 있다. 원시타입은 값이 없으면 디폴트 값을 반환하기 때문이다. (예: `int`는 `0`, `String`은 `""`)
제네릭 관점
원시타입은 제네릭 타입에 쓸 수 없지만, 참조타입은 쓸 수 있다.
Reference
https://steady-coding.tistory.com/606
GC (Garbage Collection)
관련 글: https://coding-review.tistory.com/125
기존 면접 질문에서 Mark-Sweep-Compact 알고리즘이 나와서, 꼬리질문을 대비해 GC의 알고리즘을 자세히 알아봤다. 이번 포스팅에서는 GC를 좀 더 깊이 파고들어 볼 것이다.
GC의 개념
GC는 메모리 관리 기법 중 하나로, 동적으로 할당했던 메모리 영역 중 필요 없게 된 영역을 해제하는 기능이다.
여기서 동적으로 할당했던 메모리 영역은 프로그램 런타임에 쓰이는 Heap 영역을 뜻하고, 필요 없게 된 영역은 어떤 변수도 가리키지 않게 된 영역을 뜻한다.
Person person = new Person();
person.setName("Jayon");
person = null;
person = new Person();
person.setName("Jerry");
`person` 변수는 처음에 Jayon이라는 이름이 붙은 `Person` 객체가 있는 메모리 영역을 가리키다가, 이후 Jerry라는 이름이 붙은 객체의 영역을 가리키게 된다.
이때 Jayon이 붙어 있던 객체의 메모리 영역은 그 어떤 변수도 가리키지 않는다. 이 영역을 어느 시점에 자동으로 해제하는 것이 바로 GC의 역할이다.
C와 C++에서 Heap 메모리를 쓰려면 코드 레벨에서 직접 할당하고 해제하는 과정을 작성해야 했다. 하지만 이를 수동으로 관리하는 것은 번거롭고 실수하기도 쉽다. 할당하고 해제하지 않으면 메모리 누수가 생기고, 이미 해제한 영역을 또 해제하면 에러가 난다.
반면 자바는 GC가 알아서 해 주므로 개발자는 편하게 개발에 집중할 수 있다.
참고로 `System.gc()`로 GC를 의도적으로 호출할 수 있지만, 오버헤드가 굉장히 크므로 GC에게 믿고 맡기는 편을 추천한다.
GC의 장단점
장점
• 메모리를 수동으로 관리하다 생기는 에러를 예방할 수 있다.
• 개발자의 실수로 인한 메모리 누수
• 해제된 메모리를 또 해제하는 이중 해제
• 해제된 메모리에 접근
단점
• GC의 메모리 해제 타이밍을 개발자가 정확히 알기 어렵다.
• 어떤 메모리 영역이 해제 대상인지 검사하고 실제로 해제하는 일이 모두 오버헤드다.
이제 GC의 알고리즘을 알아보자.
Reference Counting 알고리즘
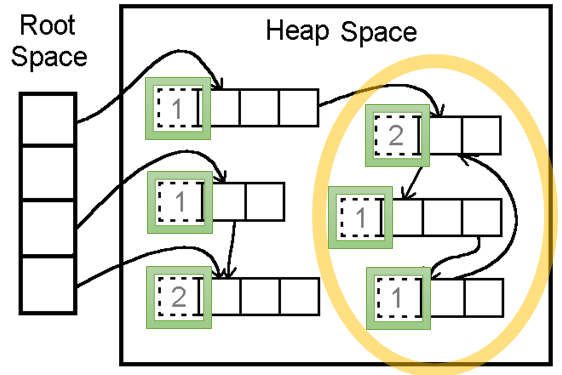
그림 속 Root Space는 스택 변수, 전역 변수 등 Heap 영역 참조를 가리키고 있는 공간이다.
Reference Counting은 힙 영역의 객체들이 각각 reference count라는 숫자를 가지고 있다고 생각하면 좋다. 이 숫자는 몇 가지 방법으로 해당 객체에 접근할 수 있는지를 뜻한다.
만약 reference count가 0이 되면 그 객체에 접근할 방법이 없다는 뜻이므로 메모리 해제 대상이 된다. Swift가 이 방식으로 메모리를 관리한다.
하지만 Reference Counting은 순환 참조 문제를 일으킬 수 있다. 그림에서 Root Space가 모든 Heap Space의 참조를 끊었다고 가정해 보자. 그러면 노란색 고리 안의 객체들은 서로가 서로를 참조하고 있어 reference count가 1로 유지된다. 결국 쓰지 않는 메모리가 해제되지 못하고 메모리 누수가 발생한다.
Mark And Sweep 알고리즘
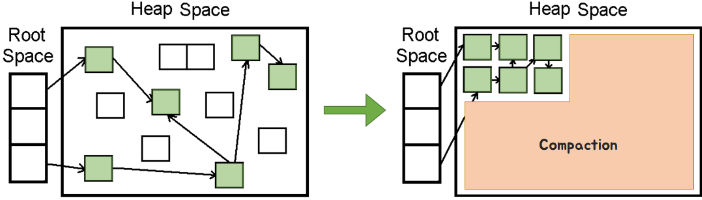
Mark And Sweep은 Reference Counting의 순환 참조 문제를 해결하려고 등장했다. 어떻게 극복하는지 설명하기 전에 개념부터 살펴보자.
이 알고리즘은 Root Space부터 해당 객체에 접근 가능한지 아닌지를 해제의 기준으로 삼는다. Root Space에서 연결된 객체는 Reachable, 연결되지 않은 객체는 Unreachable이라고 부른다.
그림에서는 Sweep 이후 분산되어 있던 메모리가 예쁘게 정리된 것을 볼 수 있는데, 이는 메모리 단편화를 방지하는 Compaction 과정이다. 다만 Mark And Sweep에서 Compaction이 필수는 아니다.
이 방식을 쓰면 Root Space에서 연결이 끊긴, 순환 참조되는 객체도 지울 수 있다. Java와 JavaScript가 이 방식으로 메모리를 관리한다.
하지만 단점도 있다. reference count가 0이 되면 바로 지우는 Reference Counting과 달리, Mark And Sweep은 의도적으로 특정 순간에 GC를 실행해야 한다. 즉 어느 순간에는 실행 중인 애플리케이션이 GC에게 컴퓨터 리소스를 내어 주어야 한다는 뜻이다.
따라서 애플리케이션의 사용성을 유지하면서 효율적으로 GC를 실행하는 것이 중요하다.
Root Space
앞서 Root Space는 Heap 영역 메모리를 참조하고 있는 영역이라고 했는데, 구체적으로 무엇이 있는지 살펴보자. JVM 메모리 영역 중 다음 세 가지가 해당된다.
• Stack의 로컬 변수
• Method Area의 `static` 변수
• Native Method Stack의 JNI 참조
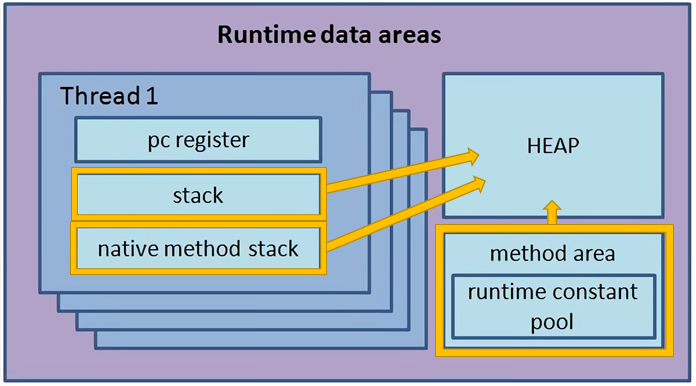
노란색 박스 안의 영역이 바로 Root Space다.
GC 실행의 타이밍
Mark And Sweep의 첫 번째 특징은 의도적으로 GC를 실행한다는 것이었다. 그렇다면 그 순간은 언제일까? 이를 알려면 Heap 영역을 조금 더 자세히 봐야 한다.
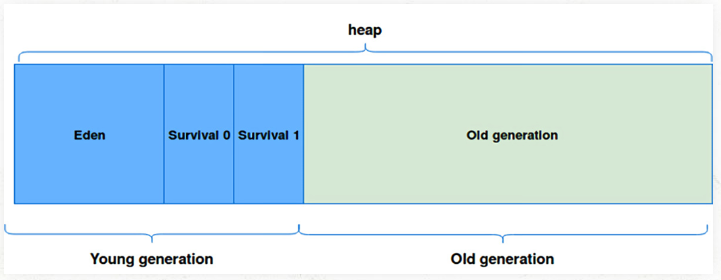
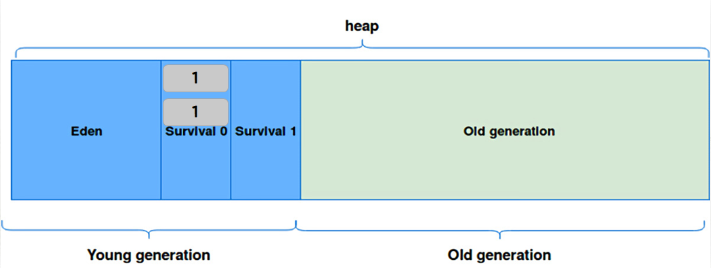
JVM의 Heap은 크게 Young Generation과 Old Generation으로 나뉜다. 전자에서 발생하는 GC를 minor GC, 후자에서 발생하는 GC를 major GC라고 부른다.
Young Generation은 다시 Eden, Survival 0, Survival 1 영역으로 나뉜다. Eden은 새로 생성된 객체가 할당되는 영역이고, Survival은 minor GC에서 살아남은 객체가 있는 영역이다. 이때 Survival 0과 1 중 하나는 꼭 비어 있어야 한다는 규칙이 있다.
minor GC의 실행 타이밍은 바로 Eden 영역이 꽉 찼을 때다. 아래 그림을 살펴보자.
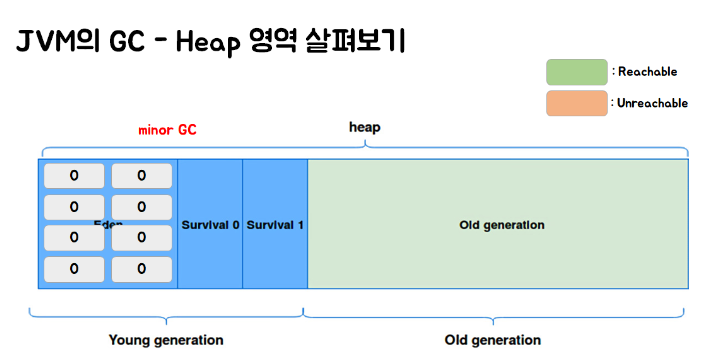
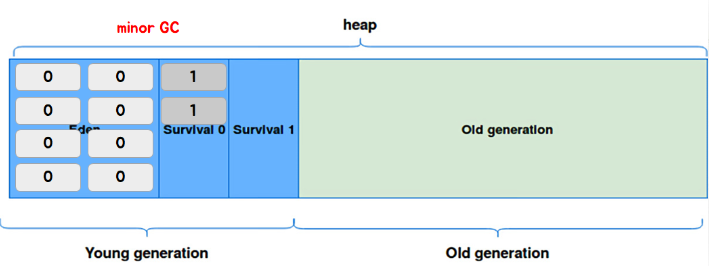
그림에서 회색 네모는 메모리에 할당된 객체라고 생각하면 된다. minor GC가 발생한 뒤 Reachable이라 판단된 객체는 Survival 0 영역으로 옮겨진다.
이때 살아남은 객체들의 숫자가 0에서 1로 바뀐 것을 알 수 있는데, 이것이 age bit다. minor GC에서 살아남을 때마다 1씩 증가하며, 용도는 아래에서 설명한다.
또다시 Eden 영역이 꽉 찼다.
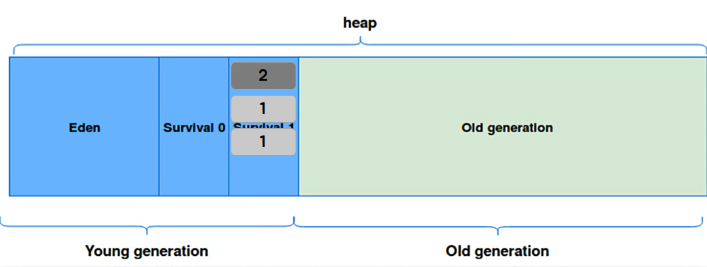
그러면 minor GC가 발생해 Reachable이라 판단된 객체들이 Survival 1 영역으로 이동한다.
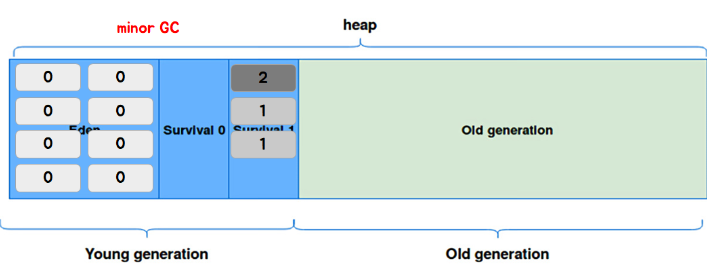
이후 또 Eden 영역이 가득 찼다.
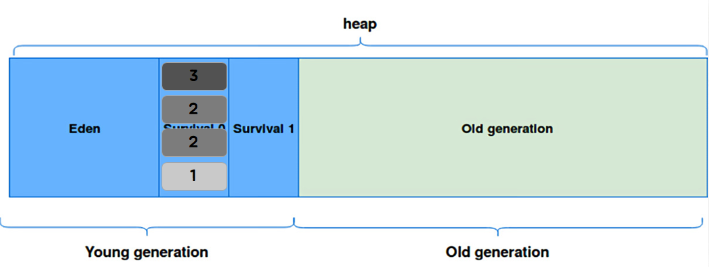
그러면 minor GC가 발생해 Reachable 객체들이 Survival 0 영역으로 이동한다. 어느덧 오래 살아남아 age bit가 3이 된 객체가 보인다.
JVM은 일정 수준의 age bit를 넘어가면 오래도록 참조될 객체라고 판단하고 Old Generation으로 넘겨주는데, 이를 Promotion이라 부른다.
Java 8에서는 Parallel GC 기준으로 age bit가 15가 되면 Promotion이 진행된다.
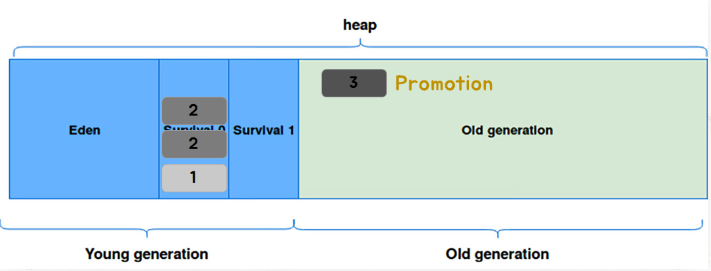
이번 예제에서는 age bit가 3일 때를 Promotion 기준으로 잡았다. 그래서 Survival 0의 age bit 3인 객체가 Old Generation으로 넘어갔다.
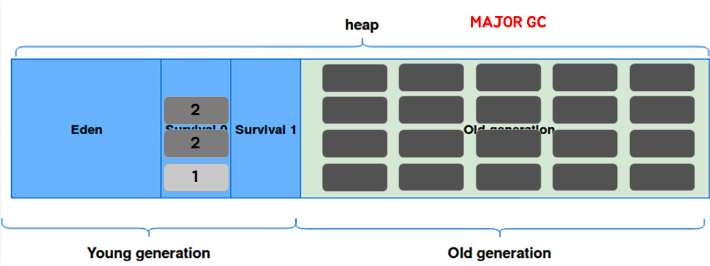
시간이 아주 많이 지나면 언젠가 Old Generation도 가득 차는 날이 올 텐데, 이때 major GC가 발생하면서 Mark And Sweep 방식으로 필요 없는 메모리를 비운다.
major GC는 minor GC보다 시간이 오래 걸린다. 또한 아래에서 자세히 이야기하겠지만, GC가 실행되면 JVM이 잠시 멈추는 Stop The World 현상이 발생하는데, minor GC보다 major GC의 STW가 더 길다.
그렇다면 Heap 영역을 굳이 Young과 Old로 나눈 이유는 무엇일까?
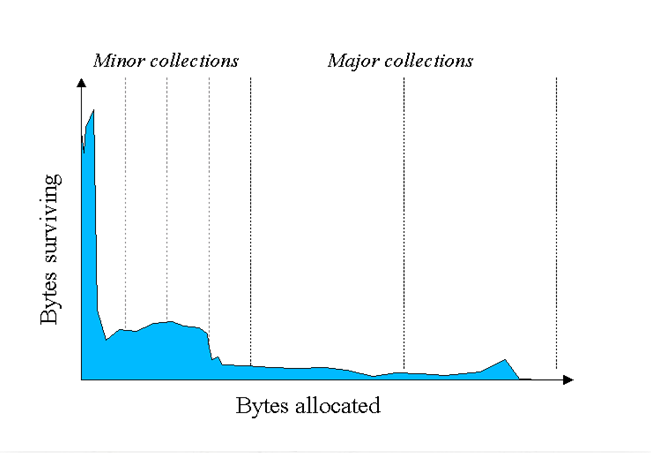
바로 GC 설계자들이 애플리케이션을 분석해 보니 대부분의 객체가 수명이 짧다는 것을 깨달았기 때문이다.
GC도 결국 비용이 드는 작업이니, 메모리 전체가 아니라 특정 부분만 탐색해 해제해야 효율적이다. 그래서 어차피 대다수 객체가 금방 사라지니 Young Generation 안에서 최대한 해제하도록 설계한 것이다.
GC의 실행 방식
Mark And Sweep의 두 번째 특징은 애플리케이션과 GC 실행이 병행된다는 것이었다. 즉 JVM은 이 둘을 병행할 수 있는 여러 옵션을 제공한다.
살펴보기 전에 STW 개념을 알아야 한다. STW란 GC를 실행하기 위해 JVM이 애플리케이션 실행을 멈추는 것을 말한다.
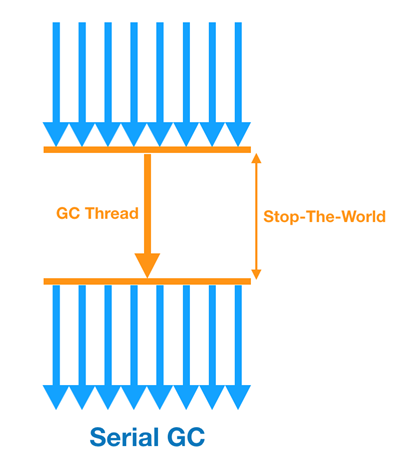
Serial GC는 하나의 스레드로 GC를 실행하는 방식이다. 그래서 STW 시간이 긴 것을 알 수 있다. 싱글 스레드 환경이나 Heap이 매우 작을 때 쓰인다. 참고로 Mark And Sweep 이후 메모리 단편화를 막는 Compaction 과정도 진행된다.
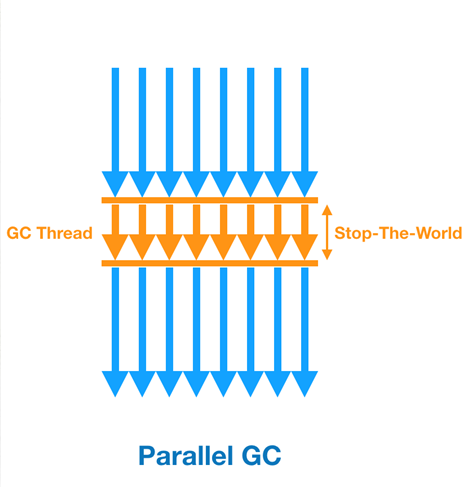
Parallel GC의 기본 처리 과정은 Serial GC와 같다. 하지만 여러 개의 스레드로 GC를 실행하므로 STW 시간이 짧아진 것을 알 수 있다. 멀티 코어 환경에서 처리 속도를 높이려고 쓰며, Java 8의 기본 GC 방식이다.
Parallel GC가 오버헤드를 상당히 줄여 주었지만 애플리케이션이 멈추는 것은 피할 수 없었고, 그래서 다른 알고리즘이 더 등장했다. 일반적인 Parallel GC는 minor GC에 대해서만 멀티 스레딩을 하고 major GC는 싱글 스레딩으로 수행한다.
Parallel Old GC는 Parallel GC의 업그레이드 버전이다. major GC도 멀티 스레딩으로 수행하고, 기존 Mark-Sweep-Compact의 개선 버전인 Mark-Summary-Compact 알고리즘을 쓴다.
사실상 Java 7 Update 4부터는 Parallel GC를 설정해도 Parallel Old GC가 동작한다. 엄밀히 말하면 Java 8의 디폴트는 Parallel Old GC인 셈이다.
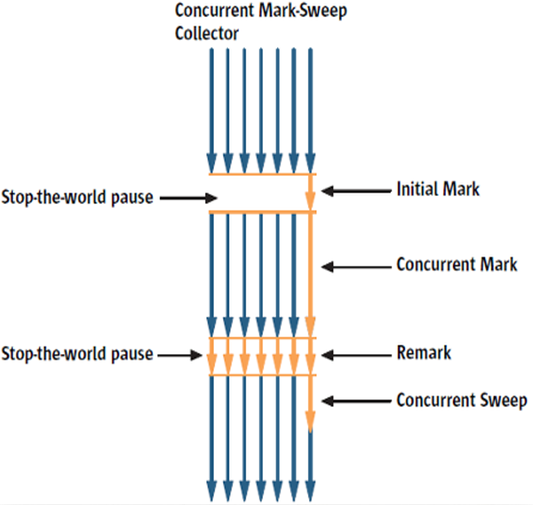
• Initial Mark : 클래스 로더에서 가장 가까운 객체 중 살아 있는 객체만 찾는다.
• Concurrent Mark : 위에서 살아 있다고 확인한 객체가 참조하는 객체를 확인한다.
• Remark : 위 단계에서 새로 추가되거나 참조가 끊긴 객체를 확인한다.
• Concurrent Sweep : 쓰레기를 정리한다.
CMS GC에서 CMS는 Concurrent-Mark-Sweep의 줄임말로, STW 시간을 최소화하기 위해 고안되었다. 대부분의 수집 작업을 애플리케이션 스레드와 동시에 수행해 STW를 최소화한다.
하지만 메모리와 CPU를 많이 쓰고, Mark And Sweep 이후 단편화를 해결하는 Compaction이 기본 제공되지 않는다는 단점이 있다. 이 때문에 시스템이 장기간 운영되다 조각난 메모리가 많아져 Compaction을 수동으로 수행하면 오히려 STW 시간이 길어진다. CMS GC는 Java 9부터 deprecated되었고 Java 14부터는 중단되었다.
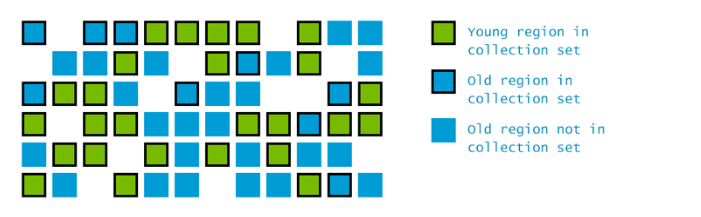
G1 GC에서 G1은 Garbage First의 줄임말로, Heap 영역을 앞서 설명한 방식과 다르게 사용한다. Heap을 일정 크기의 Region으로 잘게 나누어, 어떤 영역은 Young Generation으로 어떤 영역은 Old Generation으로 쓴다.
런타임에 따라 G1 GC가 필요에 맞게 영역별 Region 개수를 튜닝함으로써 STW를 최소화할 수 있다. Java 9 이상부터는 G1 GC가 기본 실행 방식이다.
Reference
https://steady-coding.tistory.com/584
String, StringBuilder, StringBuffer
Java에서 문자열을 다루는 대표적인 클래스로 `String`, `StringBuilder`, `StringBuffer`가 있다.
연산이 많지 않을 때는 어떤 클래스를 쓰더라도 문제가 될 가능성이 거의 없다. 그러나 연산 횟수가 많아지거나 멀티스레드, Race Condition 같은 상황이 자주 생긴다면 각 클래스의 특징을 이해하고 상황에 맞는 클래스를 골라 써야 한다.
String vs StringBuilder, StringBuffer
가장 큰 차이점은 `String`은 불변, `StringBuilder`와 `StringBuffer`는 변경 가능이라는 점이다.
String str = "hello"; // String str = new String("hello");
str = str + "world"; // [ hello world ]
직관적이라 가장 많이 쓸 법한 위 예제를 보면, `"hello"`를 가지고 있던 참조 변수 `str`이 가리키는 곳에 `"world"`를 더해 `"hello world"`로 바꾼 것처럼 착각하기 쉽다.
하지만 실제로는 다르다. 기존에 `"hello"`가 들어 있던 참조 변수 `str`은 `"hello world"`라는 값을 가진 새로운 메모리 영역을 가리키도록 바뀐다. 처음에 `"hello"`가 할당되어 있던 메모리 영역은 Garbage로 남아 있다가 GC에 의해 사라진다.
`String`은 불변이기 때문에, 문자열을 수정하는 시점에 새로운 String 인스턴스가 생성되는 것이다.
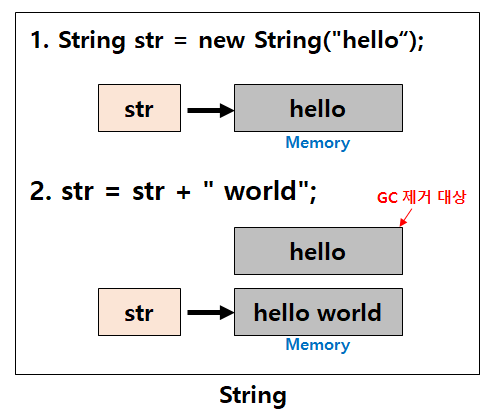
이렇게 `String`은 불변성을 가지므로, 변하지 않는 문자열을 자주 읽어 들이는 경우에 쓰면 좋은 성능을 기대할 수 있다.
그러나 문자열 추가·수정·삭제가 빈번한 알고리즘에 `String`을 쓰면 힙에 많은 임시 가비지가 쌓이고, 힙 메모리 부족으로 애플리케이션 성능에 치명적인 영향을 준다.
이를 해결하려고 Java는 가변성을 가지는 `StringBuilder`와 `StringBuffer`를 도입했다. 이들은 가변이므로 `.append()`, `.delete()` 등의 API로 같은 객체 안에서 문자열을 변경할 수 있다. 따라서 추가·수정·삭제가 빈번하다면 `String`이 아니라 이쪽을 써야 한다.
StringBuffer sb = new StringBuffer("hello");
sb.append(" world");
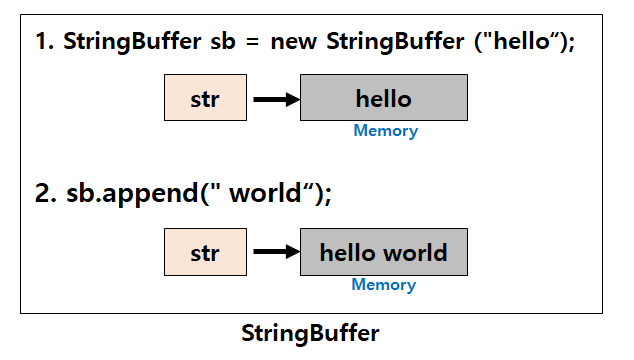
StringBuilder vs StringBuffer
그렇다면 같은 API를 가진 이 둘의 차이는 무엇일까?
가장 큰 차이는 동기화의 유무다. `StringBuffer`는 동기화를 지원해 멀티스레드 환경에서 안전하다. 참고로 `String`도 불변성 덕분에 멀티스레드 환경에서 안전하다.
반대로 `StringBuilder`는 동기화를 지원하지 않아 멀티스레드 환경에는 적합하지 않다. 대신 동기화를 고려하지 않는 만큼 단일 스레드에서의 성능은 StringBuffer보다 뛰어나다.
정리
마지막으로 클래스별 특징을 정리해 보겠다. 컴파일러의 최적화에 따라 다른 성능이 나올 수도 있지만, 일반적으로는 아래에 맞춰 쓰면 된다.
• String : 문자열 연산이 적고 멀티스레드 환경인 경우
• StringBuffer : 문자열 연산이 많고 멀티스레드 환경인 경우
• StringBuilder : 문자열 연산이 많고 단일 스레드이거나 동기화를 고려하지 않아도 되는 경우
Reference
https://ifuwanna.tistory.com/221
CheckedException, UncheckedException
자바의 예외는 크게 세 가지로 나눌 수 있다.
• 체크 예외 (CheckedException)
• 언체크 예외 (UncheckedException)
• 에러 (Error)
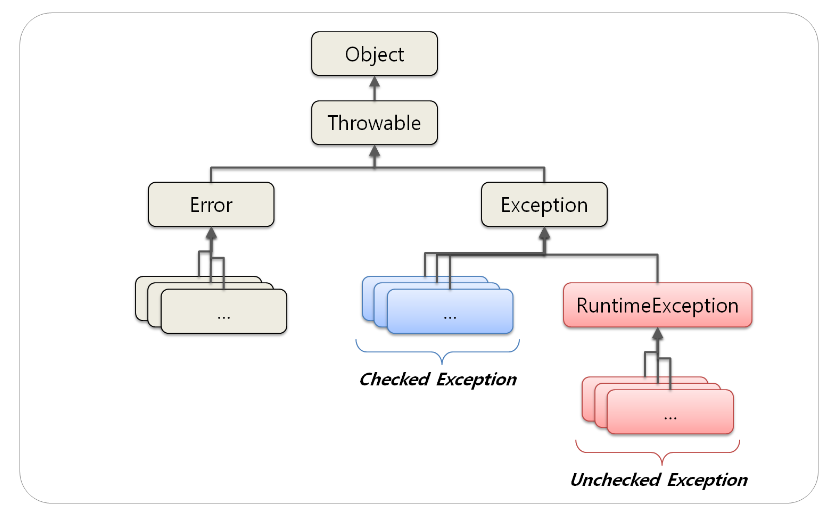
자바에서 에러·예외와 관련된 클래스의 계층 구조는 위와 같다. `Throwable`을 기준으로 `Error`와 `Exception`으로 나뉜다.
왼쪽의 `Error`는 말 그대로 에러와 관련된 클래스이고, 오른쪽의 `Exception`은 예외와 관련된 클래스다. 자바는 실행 시(Runtime) 발생할 수 있는 프로그램 오류를 이렇게 에러와 예외 두 가지로 구분한다.
Error란?
에러는 시스템에 비정상적인 상황이 발생했을 때 생긴다. 대표적으로 OOME로 알려진 `OutOfMemoryError`나 `StackOverflowError`처럼 복구할 수 없는 것들이다.
이런 에러는 개발자가 예측하기도 쉽지 않고, 잡아서 처리한다 해도 의미가 없다.
예외란?
예외는 프로그램 실행 중 개발자의 실수로 예기치 않은 상황이 발생했을 때를 말한다.
예를 들어 배열의 범위를 벗어난 `ArrayIndexOutOfBoundsException`, 값이 `null`인데 참조한 `NullPointerException`, 존재하지 않는 파일 이름을 입력한 `FileNotFoundException` 등이 있다. 이런 것들은 보기만 해도 복구할 수 없는 수준은 아니라는 것을 알 수 있다.
예외는 두 가지로 나눌 수 있다.
• 체크 예외 (CheckedException)
• 언체크 예외 (UncheckedException)
계층 구조에서 `RuntimeException`의 하위 클래스들을 언체크 예외라 하고, `RuntimeException`의 하위가 아닌 `Exception`의 하위 클래스들을 체크 예외라고 한다.
CheckedException
체크 예외는 `RuntimeException`의 하위가 아니면서 `Exception`의 하위인 클래스들이다. 특징은 반드시 예외 처리를 해야 한다는 점이다.
예외를 잡아서 처리할 수 없을 때는 밖으로 던지는 `throws`를 필수로 선언해야 한다. 그러지 않으면 컴파일 오류가 난다. 이 때문에 장점과 단점이 동시에 존재한다.
장점 — 개발자가 실수로 예외를 누락하지 않도록 컴파일러가 문제를 잡아 주는 훌륭한 안전장치다.
단점 — 하지만 모든 체크 예외를 반드시 잡거나 던지도록 처리해야 하므로 너무 번거롭다. 크게 신경 쓰고 싶지 않은 예외까지 전부 챙겨야 한다. 여기에 더해 의존관계에 따른 단점도 있다.
UncheckedException
언체크 예외는 `RuntimeException`의 하위 클래스들이다. 말 그대로 컴파일러가 예외를 체크하지 않는다는 뜻이다.
기본적으로는 체크 예외와 같지만, 예외를 던지는 `throws`를 생략할 수 있다는 점이 다르다. 생략하면 자동으로 던져진다. 이 때문에 역시 장단점이 함께 존재한다.
장점 — 신경 쓰고 싶지 않은 예외를 무시할 수 있다. 체크 예외는 처리할 수 없는 예외를 밖으로 던지려면 항상 `throws`를 선언해야 하지만, 언체크 예외는 이 부분을 생략할 수 있다. 신경 쓰고 싶지 않은 예외에 대한 의존관계를 참조하지 않아도 된다는 장점도 있다.
단점 — 개발자가 실수로 예외를 누락할 수 있다. 반면 체크 예외는 컴파일러가 누락을 잡아 준다.
체크 예외 vs 언체크 예외
그렇다면 언제 무엇을 써야 할까?
기본 원칙
기본적으로 언체크(런타임) 예외를 쓴다. 체크 예외는 비즈니스 로직상 의도적으로 던지는 예외에만 쓰면 된다. 그중에서도 반드시 잡아서 처리해야 하는 문제일 때만 체크 예외를 쓴다. 예를 들면 이런 경우다.
• 계좌 이체 실패 예외
• 결제 시 포인트 부족 예외
• 로그인 ID·PW 불일치 예외
물론 이 경우에도 100% 체크 예외로 만들어야 하는 것은 아니다. 다만 이체 실패처럼 매우 심각한 문제는 개발자가 실수로 놓치면 안 된다고 판단할 수 있다. 그럴 때 체크 예외로 만들어 두면 컴파일러를 통해 놓친 예외를 인지할 수 있다.
체크 예외의 문제점
체크 예외는 컴파일러가 누락을 체크해 주므로 실수로 예외를 놓치는 것을 막아 준다. 그래서 항상 명시적으로 잡아서 처리하거나, 처리할 수 없으면 `throws`로 선언해야 한다.
여기까지 들으면 체크 예외가 런타임 예외보다 더 안전하고 좋아 보이는데, 왜 체크 예외를 기본으로 쓰는 것이 문제가 될까? 두 가지 문제가 있다.
• 복구 불가능한 예외
• 의존관계에 대한 문제
#### 복구 불가능한 예외
대부분의 예외는 복구가 불가능하다. 일부 복구 가능한 예외도 있지만 아주 적다.
`SQLException`을 예로 들어 보자. 데이터베이스에 문제가 있어서 발생하는 예외인데, SQL 문법에 문제가 있을 수도 있고 데이터베이스 자체에 문제가 생겼을 수도 있으며 서버가 중간에 다운되었을 수도 있다. 이런 문제는 대부분 복구가 불가능하다. 특히 서비스나 컨트롤러는 이런 문제를 해결할 수 없다.
따라서 이런 문제들은 일관성 있게 공통으로 처리해야 한다. 오류 로그를 남기고 개발자가 빠르게 인지하게 하는 것이 필요하다. 서블릿 필터, 스프링 인터셉터, 스프링의 `@ControllerAdvice`를 쓰면 이 부분을 깔끔하게 공통 처리할 수 있다.
#### 의존관계에 대한 문제
체크 예외의 또 다른 심각한 문제는 예외에 대한 의존관계다.
앞서 대부분의 예외는 복구 불가능하다고 했다. 그런데 체크 예외이기 때문에 컨트롤러나 서비스는 본인이 처리할 수 없어도 어쩔 수 없이 `throws`로 예외를 선언해야 한다.
class Controller {
public void request() throws SQLException, ConnectException {
service.logic();
}
}
class Service {
public void logic() throws SQLException, ConnectException {
repository.call();
networkClient.call();
}
}
`throws SQLException, ConnectException`처럼 예외를 코드에 선언하는 것이 왜 문제가 될까? 바로 서비스와 컨트롤러가 `SQLException`에 의존하게 되기 때문이다.
향후 리포지토리를 JDBC가 아닌 다른 기술로 바꿔서 `SQLException`이 아니라 `JPAException`으로 변경된다면 어떻게 될까?
`SQLException`에 의존하던 모든 서비스와 컨트롤러 코드를 전부 고쳐야 한다. 서비스나 컨트롤러 입장에서는 어차피 처리할 수도 없는 예외를 의존해야 하는 큰 단점이 생기는 것이다.
결과적으로 OCP와 DI를 통해 클라이언트 코드 변경 없이 구현체를 바꿀 수 있다는 장점이, 체크 예외 때문에 발목을 잡히게 된다.
Reference
https://devlog-wjdrbs96.tistory.com/351
김영한님의 인프런 강의 「데이터베이스 접근 기술 1편」 PDF
람다식과 Stream API
람다 함수란?
람다 함수는 프로그래밍 언어에서 익명 함수를 가리키는 용어다. 현재 쓰이는 람다의 근간은 수학과 기초 컴퓨터과학 분야의 람다 대수다. 람다 대수는 간단히 말해 수학에서 쓰는 함수를 더 단순하게 표현하는 방법이다.
람다의 장단점
장점
• 코드의 간결성 — 불필요한 반복문을 없앨 수 있고, 복잡한 식을 단순하게 표현할 수 있다.
• 지연 연산 — 지연 연산을 수행함으로써 불필요한 연산을 최소화할 수 있다.
• 병렬 처리 — 멀티스레드를 활용한 병렬 처리를 쓸 수 있다.
단점
• 람다식의 호출이 까다롭다.
• 람다 Stream을 쓸 때 단순 `for`문이나 `while`문보다 성능이 떨어진다.
• 불필요하게 남용하면 오히려 가독성을 떨어뜨릴 수 있다.
람다의 표현식
//정상적인 유형
() -> {}
() -> 1
() -> { return 1; }
(int x) -> x+1
(x) -> x+1
x -> x+1
(int x) -> { return x+1; }
x -> { return x+1; }
(int x, int y) -> x+y
(x, y) -> x+y
(x, y) -> { return x+y; }
(String lam) -> lam.length()
lam -> lam.length()
(Thread lamT) -> { lamT.start(); }
lamT -> { lamT.start(); }
//잘못된 유형 선언된 type과 선언되지 않은 type을 같이 사용 할 수 없다.
(x, int y) -> x+y
(x, final y) -> x+y
람다식 예제
기존 자바 문법
new Thread(new Runnable() {
@Override
public void run() {
System.out.println("Welcome Heejin blog");
}
}).start();
람다식 문법
new Thread(()->{
System.out.println("Welcome Heejin blog");
}).start();
함수형 인터페이스
@FunctionalInterface
Functional Interface는 일반적으로 '구현해야 할 추상 메서드가 하나만 정의된 인터페이스'를 가리킨다. 자바 컴파일러는 이렇게 명시된 함수형 인터페이스에 두 개 이상의 메서드가 선언되면 오류를 낸다.
//구현해야 할 메소드가 한개이므로 Functional Interface이다.
@FunctionalInterface
public interface Math {
public int Calc(int first, int second);
}
//구현해야 할 메소드가 두개이므로 Functional Interface가 아니다. (오류 사항)
@FunctionalInterface
public interface Math {
public int Calc(int first, int second);
public int Calc2(int first, int second);
}
함수형 인터페이스 람다 사용 예제
함수형 인터페이스 선언
@FunctionalInterface
interface Math {
public int Calc(int first, int second);
}
추상 메서드 구현 및 함수형 인터페이스 사용
public static void main(String[] args){
Math plusLambda = (first, second) -> first + second;
System.out.println(plusLambda.Calc(4, 2));
Math minusLambda = (first, second) -> first - second;
System.out.println(minusLambda.Calc(4, 2));
}
cf) 함수형 인터페이스가 추상 메서드 하나뿐인 인터페이스에 한해 동작하는 이유는, 자바가 다중 상속을 지원하지 않는 것과 같은 맥락일 것으로 추측된다. 즉 람다로 구현할 때 어떤 추상 메서드를 쓰는지 알 수 없기 때문에 하나만 선언할 수 있는 것 같다.
Stream API
Stream이란 다양한 데이터를 표준화된 방법으로 다루기 위한 라이브러리다. 자바 8부터 추가되었으며 다음과 같이 구성된다.
example.stream().filter(x -> x < 2).count
• `stream()` — 스트림 생성
• `filter` — 중간 연산 (연속해서 수행 가능)
• `count` — 최종 연산 (마지막에 단 한 번만 사용 가능)
Stream의 특징
• 데이터를 변경하지 않는다.
• 1회용이다.
• 지연 연산을 수행한다.
• 병렬 실행이 가능하다.
Stream의 종류
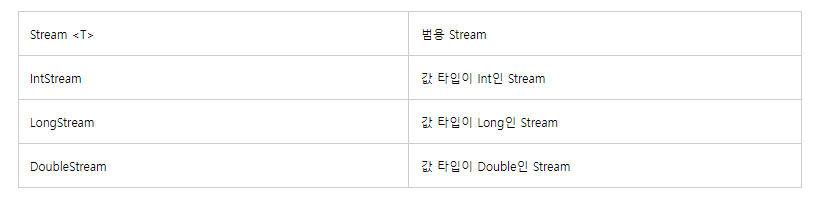
Stream의 중간 연산 명령어
Stream의 최종 연산 명령어
Collector 연산
Reference
https://khj93.tistory.com/entry/JAVA-%EB%9E%8C%EB%8B%A4%EC%8B%9DRambda%EB%9E%80-%EB%AC%B4%EC%97%87%EC%9D%B4%EA%B3%A0-%EC%82%AC%EC%9A%A9%EB%B2%95
Optional
Optional이란?
NPE란?
개발할 때 가장 많이 마주치는 예외 중 하나가 NPE(NullPointerException)다.
NPE를 피하려면 `null` 여부를 검사해야 하는데, 검사할 변수가 많으면 코드가 복잡해지고 번거롭다. 그래서 `null` 대신 초깃값을 쓰라고 권하기도 한다.
List<String> names = getNames();
names.sort(); // names가 null이라면 NPE가 발생함
List<String> names = getNames();
// NPE를 방지하기 위해 null 검사를 해야함
if(names != null){
names.sort();
}
Optional이란?
Java 8에서는 `Optional<T>` 클래스로 NPE를 방지할 수 있게 도와준다.
`Optional<T>`는 `null`이 올 수 있는 값을 감싸는 Wrapper 클래스로, 참조하더라도 NPE가 나지 않게 해 준다. 값을 `value`에 저장하기 때문에 그 값이 `null`이어도 바로 NPE가 발생하지 않으며, 클래스이기 때문에 각종 메서드도 제공한다.
Optional 활용하기
Optional 생성하기
`Optional.empty()` — 값이 null인 경우
Optional은 Wrapper 클래스라 값이 없을 수도 있는데, 이때는 `Optional.empty()`로 생성한다.
Optional<String> optional = Optional.empty();
System.out.println(optional); // Optional.empty
System.out.println(optional.isPresent()); // false
Optional 클래스는 내부에서 `static` 변수로 `EMPTY` 객체를 미리 만들어 두고 있다. 그래서 빈 객체를 여러 번 생성해야 하는 경우에도 하나의 `EMPTY` 객체를 공유해 메모리를 절약한다.
public final class Optional<T> {
private static final Optional<?> EMPTY = new Optional<>();
private final T value;
private Optional() {
this.value = null;
}
...
}
`Optional.of()` — 값이 null이 아닌 경우
어떤 데이터가 절대 `null`이 아니라면 `Optional.of()`로 생성할 수 있다. 만약 `Optional.of()`로 `null`을 저장하려 하면 NPE가 발생한다.
// Optional의 value는 절대 null이 아니다.
Optional<String> optional = Optional.of("MyName");
`Optional.ofNullable()` — 값이 null일 수도, 아닐 수도 있는 경우
`null`이 올 수도 있고 아닐 수도 있다면 `Optional.ofNullable`로 생성한다. 이후 `orElse`나 `orElseGet`을 이용하면 값이 없는 경우에도 안전하게 값을 가져올 수 있다.
Optional 사용법 예시
예시 1
기존에는 아래처럼 `null` 검사를 한 뒤 `null`이면 새 객체를 만들어 주어야 했다. 코드로 나타내면 다소 번잡한데, `Optional<T>`와 람다를 쓰면 훨씬 간단해진다.
// Java8 이전
List<String> names = getNames();
List<String> tempNames = list != null
? list
: new ArrayList<>();
// Java8 이후
List<String> nameList = Optional.ofNullable(getNames())
.orElseGet(() -> new ArrayList<>());
람다식에 대해서는 아래 포스팅을 참고하자.
관련 글: https://coding-review.tistory.com/151
예시 2
아래와 같이 우편번호를 꺼내는 `null` 검사 코드가 있다고 하자. `null` 검사 때문에 상당히 복잡하다.
public String findPostCode() {
UserVO userVO = getUser();
if (userVO != null) {
Address address = user.getAddress();
if (address != null) {
String postCode = address.getPostCode();
if (postCode != null) {
return postCode;
}
}
}
return "우편번호 없음";
}
하지만 Optional을 쓰면 이렇게 표현할 수 있다.
public String findPostCode() {
// 위의 코드를 Optional로 펼쳐놓으면 아래와 같다.
Optional<UserVO> userVO = Optional.ofNullable(getUser());
Optional<Address> address = userVO.map(UserVO::getAddress);
Optional<String> postCode = address.map(Address::getPostCode);
String result = postCode.orElse("우편번호 없음");
// 그리고 위의 코드를 다음과 같이 축약해서 쓸 수 있다.
String result = user.map(UserVO::getAddress)
.map(Address::getPostCode)
.orElse("우편번호 없음");
}
예시 3
이름을 대문자로 바꾸면서 NPE 처리를 해 준다고 하자.
String name = getName();
String result = "";
try {
result = name.toUpperCase();
} catch (NullPointerException e) {
throw new CustomUpperCaseException();
}
위 코드는 다소 번잡하고 가독성이 떨어지는데, Optional을 활용하면 아래와 같이 쓸 수 있다.
Optional<String> nameOpt = Optional.ofNullable(getName());
String result = nameOpt.orElseThrow(CustomUpperCaseExcpetion::new)
.toUpperCase();
Optional 정리
Optional은 `null` 또는 값을 감싸서 NPE의 부담을 줄이기 위해 등장한 Wrapper 클래스다.
다만 값을 감싸고 다시 풀고, `null`일 때는 대체 함수를 호출하는 등의 오버헤드가 있으므로 잘못 쓰면 시스템 성능이 저하된다.
그래서 메소드의 반환값이 절대 `null`이 아니라면 Optional을 쓰지 않는 편이 좋다. 즉 Optional은 메소드의 결과가 null이 될 수 있고, 그로 인해 오류가 발생할 가능성이 매우 높을 때 반환값으로만 써야 한다.
또한 Optional은 파라미터로 넘기는 것이 아니라 반환 타입으로서 제한적으로 쓰도록 설계되었다.
orElse와 orElseGet의 차이
Optional API의 단말 연산에는 `orElse`와 `orElseGet`이 있다. 비슷해 보이는 이 둘에는 엄청난 차이가 있다.
• orElse : 파라미터로 값을 받는다.
• orElseGet : 파라미터로 함수형 인터페이스를 받는다.
실제 Optional 코드를 보면 각각 다음과 같이 구현되어 있다.
public final class Optional<T> {
... // 생략
public T orElse(T other) {
return value != null ? value : other;
}
public T orElseGet(Supplier<? extends T> other) {
return value != null ? value : other.get();
}
}
값이 넘어가느냐 함수가 넘어가느냐는 상당히 큰 차이다. 이로 인해 호출 결과가 달라질 수 있기 때문인데, 코드로 살펴보자.
차이를 보여 주는 예시 코드
다음 예시 코드가 있다고 하자. 첫 번째 함수는 값이 비어 있을 때 `orElse`를, 두 번째 함수는 `orElseGet`을 호출하도록 되어 있다. 바로 아래로 내려가지 말고 각각의 출력 결과를 예상해 보자.
public void findUserEmailOrElse() {
String userEmail = "Empty";
String result = Optional.ofNullable(userEmail)
.orElse(getUserEmail());
System.out.println(result);
}
public void findUserEmailOrElseGet() {
String userEmail = "Empty";
String result = Optional.ofNullable(userEmail)
.orElseGet(this::getUserEmail);
System.out.println(result);
}
private String getUserEmail() {
System.out.println("getUserEmail() Called");
return "[email protected]";
}
실행해 보면 다음과 같다. 왜 이런 결과가 나왔는지 자세히 살펴보자.
// 1. orElse인 경우
getUserEmail() Called
Empty
// 2. orElseGet인 경우
Empty
먼저 `orElse`는 다음 순서로 처리된다.
• `Optional.ofNullable`로 `"Empty"`를 갖는 Optional 객체 생성
• `getUserEmail()`이 실행되어 반환값을 `orElse` 파라미터로 전달
• `orElse` 호출. `"Empty"`가 `null`이 아니므로 `"Empty"`를 그대로 가짐
이렇게 동작하는 이유는 `orElse()`가 값을 파라미터로 받기 때문이다. 파라미터로 넘길 값을 만들려고 `getUserEmail()`이 먼저 호출된 것이다.
하지만 함수형 인터페이스를 받는 `orElseGet`은 동작이 다르다.
• `Optional.ofNullable`로 `"Empty"`를 갖는 Optional 객체 생성
• `getUserEmail()` 함수 자체를 `orElseGet` 파라미터로 전달
• `orElseGet` 호출. `"Empty"`가 `null`이 아니므로 그대로 가지며 `getUserEmail()`은 호출되지 않음
파라미터로 넘어간 것이 함수이므로, 값이 `null`이 아니면 `.get()`이 불리지 않아 함수도 실행되지 않는다.
만약 Optional의 값이 `null`이라면 다음 흐름으로 `getUserEmail()`이 실행된다.
public void findUserEmailOrElseGet() {
String result = Optional.ofNullable(null)
.orElseGet(this::getUserEmail);
System.out.println(result);
}
private String getUserEmail() {
System.out.println("getUserEmail() Called");
return "[email protected]";
}
• `Optional.ofNullable`로 `null`을 갖는 Optional 객체 생성
• `getUserEmail()` 자체를 `orElseGet` 파라미터로 전달
• `orElseGet` 호출. 값이 `null`이므로 `other.get()`이 호출되어 `getUserEmail()`이 실행됨
orElse 때문에 생길 수 있는 장애
살펴보았듯 `orElse`와 `orElseGet`에는 명확하고 중요한 차이가 있다. 이를 정확히 인식하지 못하면 장애가 발생할 수 있다.
예를 들어 `userEmail`을 Unique로 갖는 시스템에서 아래와 같은 코드를 작성했다고 하자.
public void findByUserEmail(String userEmail) {
// orElse에 의해 userEmail이 이미 존재해도 유저 생성 함수가 호출되어 에러 발생
return userRepository.findByUserEmail(userEmail)
.orElse(createUserWithEmail(userEmail));
}
private String createUserWithEmail(String userEmail) {
User newUser = new User(userEmail);
return userRepository.save(newUser);
}
이 예제는 단말 연산으로 `orElse`를 쓰고 있기 때문에, 조회 결과와 무관하게 `createUserWithEmail`이 반드시 실행된다. 하지만 데이터베이스에서 `userEmail`이 Unique로 설정되어 있으므로 오류가 발생할 것이다.
그래서 이런 경우에는 `orElseGet`으로 수정해야 한다. 그러면 파라미터로 함수 자체가 넘어가므로, 조회 결과가 없을 때만 사용자를 생성하는 로직이 호출된다.
public void findByUserEmail(String userEmail) {
// orElseGet에 의해 파라미터로 함수를 넘겨주므로 Null이 아니면 유저 생성 함수가 호출되지 않음
return userRepository.findByUserEmail(userEmail)
.orElseGet(createUserWithEmail(userEmail));
}
private String createUserWithEmail(String userEmail) {
User newUser = new User(userEmail);
return userRepository.save(newUser);
}
실제 서비스에서 이런 오류를 범하면 큰 시스템 장애로 돌아온다. 설령 문제가 없더라도 `orElse`는 값을 생성하므로 `orElseGet`보다 비용이 크다. 최대한 사용을 피하고, 두 메서드의 차이를 정확히 이해하고 쓰도록 하자.
정리
orElse
• 파라미터로 값을 필요로 한다.
• 값이 미리 존재하는 경우에 쓴다.
orElseGet
• 파라미터로 함수를 필요로 한다.
• 값이 미리 존재하지 않는 거의 대부분의 경우에 쓰면 된다.
Reference
https://mangkyu.tistory.com/70 [MangKyu's Diary]
try-with-resouce
Java 7 이전에는 다 쓴 자원을 반납하기 위해 `try-catch-finally` 구문을 썼다.
Java 7에서 추가된 try-with-resources는 `try` 구문에 리소스를 선언하면, 다 쓰고 난 뒤 자동으로 반납해 주는 기능이다. `java.lang.AutoCloseable` 인터페이스를 구현한 객체가 이 리소스로 쓰일 수 있다.
기존 방식 (try-catch-finally)
리소스 생성 / 반납
public class ResourceClose {
public static void main(String[] args) {
Scanner scanner = null;
try {
scanner = new Scanner(new File("input.txt"));
System.out.println(scanner.nextLine());
} catch (FileNotFoundException e) {
e.printStackTrace();
} finally {
if (scanner != null) {
scanner.close();
}
}
}
}
Java 7 이전에 `try-catch-finally`로 리소스를 생성하고 반납하는 코드다.
리소스 생성은 `try` 구문에서, 반납은 `finally` 구문에서 하다 보니 생성해 놓고 반납을 빼먹는 경우가 종종 생겼다.
이렇게 객체를 만들고 해제하지 않으면 메모리 누수로 이어질 수 있으므로 반드시 해제해 주어야 한다.
새로운 방식 (try-with-resources)
리소스 생성 / 반납하기
public class ResouceClose {
public static void main(String[] agrs) {
try (Scanner scanner = new Scanner(new File("input.txt"))) {
System.out.println(scanner.nextLine());
} catch (FileNotFoundException e) {
e.printStackTrace();
}
}
}
Java 7 이후에는 try-with-resources로 리소스를 생성하고 자동으로 반납한다. 위 코드는 앞서 `try-catch-finally`로 작성한 예제와 같은 내용이다.
try (Scanner scanner = new Scanner(new File("input.txt")))
`try-catch-finally`와 달리 `try` 옆 괄호 안에서 리소스를 생성한다. 그리고 어디에도 리소스를 반납하는 코드가 없다. try-with-resources를 쓰면 자동으로 반납되기 때문이다.
여기 쓰이는 리소스는 반드시 `java.lang.AutoCloseable`을 구현해야 한다. 예제에 쓰인 `Scanner` 클래스도 `AutoCloseable`이 구현되어 있다.
여러 개의 리소스 생성·반납
public class ResourceClose {
public static void main(String[] args) {
try (Scanner scanner = new Scanner(new File("input.txt"));
PrintWriter pw = new PrintWriter(new File("output.txt"))) {
System.out.println(scanner.nextLine());
} catch (FileNotFoundException e) {
e.printStackTrace();
}
}
]
여러 개의 리소스를 함께 생성하고 반납할 수도 있다. `try`에서 리소스를 만들 때 위 예제처럼 세미콜론으로 구분하면 된다.
반납 순서는 마지막에 생성된 객체부터 차례로 해제된다.
Reference
https://hianna.tistory.com/546
final 키워드
자바에서 `final` 키워드는 상수를 표현하기 위한 예약어다. '마지막'이라는 뜻처럼 선언한 그대로 쓰라는 의미다. 변수, 메서드, 클래스에 모두 쓰이는데 지금부터 각각의 의미를 살펴보자.
final 변수
• 상수라고도 불린다.
• 선언과 동시에 초기화하며, 이후에 값을 수정할 수 없다.
• 오직 읽기만 가능하다.
public class Fruit {
public static void main(String[] args) {
// 선언 및 초기화
final int coiunt = 10;
// 수정
count = 15; //컴파일 에러
}
}
`count` 변수를 선언할 때 `final`을 붙여 상수임을 나타냈고, 선언과 동시에 `10`을 대입했다. 이후 값을 `15`로 바꾸려 하면 다음과 같은 에러가 발생한다. `count` 변수에 값을 넣을 수 없다는 뜻이다.

일반적으로 `final` 변수는 프로그램 전체에 걸쳐 쓰이는 경우가 많다. 그래서 위처럼 특정 메서드 안에서 선언하기보다는, 클래스에 `static`과 함께 정의해 쓴다.
public class Fruit {
static final int COUNT = 10;
static final double PI = 3.14;
static final String FILE_NAME = "Config";
public static void main(String[] args) {
//TODO
}
}
모든 변수 타입에 적용할 수 있으며, 폴더·파일 이름이나 DB 칼럼명, 사이즈 같은 정보를 표현하는 데 유용하다.
소스 곳곳에서 필요할 때마다 `"Config"`라는 값을 직접 입력해야 한다면 오타가 날 확률이 높다. 게다가 개발 중에 `"Setting"`으로 이름을 바꿔야 하는 상황이 생기면 일일이 수정해야 하는 불편이 따른다.
이럴 때 `static final` 변수로 선언해 두면 안전성과 편리함을 동시에 얻을 수 있다.
final 메서드
• 오버라이딩이 불가능하다.
• 상속받은 그대로 써야 한다.
public class Fruit {
public String name;
public void setName(String name) {
this.name = name;
}
public final String getName() {
return name;
}
}
public class Banana extends Fruit {
@Override
public void setname(String name) {
this.name = "Fruit Name : " + name;
}
public String getName() {
return name;
}
public static void main(String[] args) {
//TODO
}
}
`Fruit` 클래스에는 `name`에 대한 setter와 getter가 있다. 여기서 집중해야 할 부분은 `getName()` 메서드 앞의 `final` 키워드다. `Banana` 클래스는 `Fruit`을 상속받아 `setName()`을 원하는 형태로 오버라이딩했다.
그런데 `final` 메서드인 `getName()`은 오버라이딩할 수 있을까? 다음과 같은 에러가 발생한다. 즉 오버라이딩이 불가능하다.
final 클래스
• 상속이 불가능하다.
• 하위 클래스를 만들 수 없다.
publc final class Fruit {
public String name;
public void setName(String name) {
this.name = name;
}
public String getName() {
return name;
}
}
public class Banana extends Fruit { //컴파일 에러
public static void main(String[] args) {
//TODO
}
}
이번에는 `Fruit` 클래스 앞에 `final`이 붙어 있다. 앞에서처럼 `Banana`에서 `Fruit`을 상속하려고 하면, 예상대로 상속이 불가능하다는 에러가 나타난다.
`final` 메서드와 클래스는 주로 라이브러리 형태의 프로젝트를 작성할 때 쓴다. 라이브러리를 완전히 이해하지 못한 상태에서 재정의하면 에러가 날 확률이 높기 때문에, 원천적으로 수정이 불가능하도록 막아 놓은 것이다.
자신이 작성한 메서드와 클래스를 다른 사람이 상속받아 쓰지 못하게 막고 싶을 때 이용하면 좋을 듯하다.
상속과 super 그리고 super()
구글링을 하며 많은 코드를 보다 보니 문득 궁금증이 생겼습니다.
`super`, `super()` 이런 게 뭘까? 스프링을 공부한다는 사람이 자바의 기본 문법도 모르는 게 조금 부끄럽긴 하지만, 그래도 '모르니까 배우지'라는 마음으로 한번 정리해 보겠습니다.
super
`super`는 자손 클래스에서 조상 클래스로부터 상속받은 멤버를 참조하는 데 쓰이는 참조 변수다.
멤버 변수와 지역 변수의 이름이 같을 때 `this`로 구별했듯, 상속받은 멤버와 자신의 클래스에 정의된 멤버의 이름이 같을 때는 `super`로 구별할 수 있다.
조상 클래스로부터 상속받은 멤버도 결국 자손 클래스 자신의 멤버이므로 `super` 대신 `this`를 써도 된다. 그래도 조상의 멤버와 자손의 멤버가 중복 정의되어 서로 구별해야 할 때만 `super`를 쓰는 것이 좋다.
조상의 멤버와 자신의 멤버를 구별하는 데 쓰인다는 점을 빼면 `super`와 `this`는 근본적으로 같다.
모든 인스턴스 메서드에는 자신이 속한 인스턴스의 주소가 지역 변수로 저장되는데, 이것이 참조 변수 `this`와 `super`의 값이 된다.
`static` 메서드는 인스턴스와 관련이 없다. 그래서 `this`와 마찬가지로 `super` 역시 static 메서드에서는 쓸 수 없고 인스턴스 메서드에서만 쓸 수 있다.
super()
`this()`와 마찬가지로 `super()` 역시 생성자다. `this()`가 같은 클래스의 다른 생성자를 호출하는 데 쓰인다면, `super()`는 조상 클래스의 생성자를 호출하는 데 쓰인다.
자손 클래스의 인스턴스를 생성하면 자손의 멤버와 조상의 멤버가 모두 합쳐진 하나의 인스턴스가 만들어진다. 그래서 자손 클래스의 인스턴스가 조상 클래스의 멤버를 쓸 수 있는 것이다.
이때 조상 클래스 멤버의 생성과 초기화 작업이 수행되어야 하므로, 자손 클래스의 생성자에서 조상 클래스의 생성자가 호출되어야 한다.
생성자의 첫 줄에서 조상 클래스의 생성자를 호출해야 하는 이유는, 자손 클래스의 멤버가 조상 클래스의 멤버를 쓸 수도 있으므로 조상의 멤버가 먼저 초기화되어 있어야 하기 때문이다.
이런 조상 생성자 호출은 상속 관계를 거슬러 올라가며 계속 반복된다. 그리고 마지막으로 모든 클래스의 최고 조상인 `Object` 클래스의 생성자 `Object()`까지 가서야 끝난다.
그래서 `Object`를 제외한 모든 클래스의 생성자는 첫 줄에 반드시 자신의 다른 생성자나 조상의 생성자를 호출해야 한다. 그러지 않으면 컴파일러가 첫 줄에 `super();`를 자동으로 추가한다.
마치며
이렇게 `super`와 `super()`를 알아봤습니다. 개인적으로 `super`를 한 번도 써 보지 않아서 지금까지 배우기를 미루고 미뤘던 것 같습니다.
이제라도 공부했으니 다행이라고 생각합니다. 다음에도 더 질 좋은 포스팅으로 찾아뵙겠습니다.
Reference
플래시로 배우는 자바 (책)
ConcurrentMap, ConcurrentHashMap
이번 포스팅은 기존 Map 인터페이스의 구현체 중 thread-safe하다고 알려져 있는 바로 그 구현체, ConcurrentMap입니다.
앞선 Map 포스팅의 기본적인 내용과 지금 다룰 내용은 지식의 깊이부터 다르기 때문에, 성격이 맞지 않다고 판단해 따로 분리했습니다.
들어가기에 앞서
Map은 자바 컬렉션 중에서 가장 대중적으로 쓰이는 것 중 하나입니다.
그리고 그중 가장 많이 쓰는 `HashMap`은 thread-safe하지 않은 구현체입니다. Java 1.5 이전, 즉 ConcurrentMap이 나오기 전에는 `Hashtable`을 많이 썼습니다.
`Hashtable`은 `HashMap`과 달리 멀티스레드 환경에서 thread-safe를 보장합니다. 하지만 문제가 있습니다.
public synchronized int size() {
return count;
}
public synchronized boolean isEmpty() {
return count == 0;
}
public synchronized Enumeration<K> keys() {
return this.<K>getEnumeration(KEYS);
}
public synchronized Enumeration<V> elements() {
return this.<V>getEnumeration(VALUES);
}
public synchronized boolean contains(Object value) {
if (value == null) {
throw new NullPointerException();
}
Entry<?,?> tab[] = table;
for (int i = tab.length ; i-- > 0 ;) {
for (Entry<?,?> e = tab[i] ; e != null ; e = e.next) {
if (e.value.equals(value)) {
return true;
}
}
}
return false;
}
....이하생략
보시면 모든 메서드에 `synchronized`를 붙여서 thread-safe를 보장하고 있습니다.
그래서 `Hashtable`을 쓰면 thread-safe는 보장되지만 효율 측면에서 많이 떨어집니다. 마치 데이터베이스 격리 수준의 Serializable이 떠오르는 구조네요.
thread-safe를 보장하면서 높은 성능도 내는 것이 바로 Java 1.5부터 등장한 ConcurrentMap입니다.
ConcurrentMap
ConcurrentMap은 Map 인터페이스의 확장 버전입니다. thread-safety 문제를 해결하기 위한 구조 혹은 가이드를 제공하려고 설계되었습니다.
몇몇 인터페이스의 디폴트 메서드를 오버라이딩함으로써, ConcurrentMap은 thread-safety와 메모리 일관성(원자적 실행)을 제공하기 위한 구현 가이드라인을 제시합니다.
• `getOrDefault`
• `forEach`
• `replaceAll`
• `computeIfAbsent`
• `computeIfPresent`
• `compute`
• `merge`
위 메서드들은 오버라이딩했을 때 key나 value에 `null`을 허용하지 않습니다.
• `putIfAbsent`
• `remove`
• `replace(key, oldValue, newValue)`
• `replace(key, value)`
위 메서드들은 기존 디폴트 인터페이스의 구현체 없이도 원자성을 보장합니다.
ConcurrentHashMap
ConcurrentHashMap은 ConcurrentMap을 그대로 계승하면서, bucket이라는 특이한 개념을 도입해 thread-safe를 보장합니다.
bucket의 개념을 딱딱하게 설명하기보다는, 계속 등장하는 bucket의 '느낌'을 살려 보시면 이해하기 편할 것 같습니다.
이 bucket은 늦게 초기화되는데, 각 bucket은 그 안의 첫 번째 노드를 잠금으로써 독립적으로 lock을 획득할 수 있습니다. 반면 읽기 작업은 잠그지 않아 update contention이 최소화됩니다.
Contention이란?

resource contention이란 메모리에 랜덤으로 접근하거나, 디스크 저장소나 캐시 메모리에 접근하거나, 내부 버스나 외부 네트워크 디바이스에 접근하는 것처럼 공유 리소스에 접근하며 생기는 모든 충돌 상태를 말합니다.
쉽게 말해 리소스에 접근하기 위해 치르는 비용(disadvantage)이라고 할 수 있습니다.
즉 "리소스 접근 비용을 최소화해서 성능이 더 빠르고 좋다"라고 해석해도 될 것 같습니다.
정리하면 ConcurrentHashMap은 읽기 작업은 여러 스레드가 동시에, 쓰기 작업은 특정 bucket에 대한 lock을 사용합니다. 그래서 여러 스레드가 동시에 데이터를 삽입하거나 참조하더라도, 그 데이터가 서로 다른 세그먼트(bucket)에 있다면 락을 얻기 위해 경쟁하지 않습니다.
ConcurrentHashMap은 멀티스레드 환경에서 key-value를 쓰는 작업의 메모리 일관성을 보장합니다.
이를 확인하기 위해 공식 문서의 예제 코드를 잠깐 보겠습니다. 크게 어렵지 않으니 잘 따라오실 수 있을 겁니다.
import java.util.ArrayList;
import java.util.HashMap;
import java.util.List;
import java.util.Map;
import java.util.concurrent.ConcurrentHashMap;
import java.util.concurrent.ExecutorService;
import java.util.concurrent.Executors;
import java.util.concurrent.TimeUnit;
public class Memo2 {
public static void main(String[] args) throws InterruptedException {
// HashMap<String, Integer> map = new HashMap<>();
Map<String, Integer> map = new ConcurrentHashMap<>();
List<Integer> list = parallelSum100(map, 100);
long count = list.stream().filter(x -> x != 100).count();
System.out.println(count);
}
private static List<Integer> parallelSum100(Map<String, Integer> map,
int executionTimes) throws InterruptedException {
List<Integer> sumList = new ArrayList<>(1000);
for (int i = 0; i < executionTimes; i++) {
map.put("test", 0);
ExecutorService executorService = Executors.newFixedThreadPool(4);
for (int j = 0; j < 10; j++) {
executorService.execute(() -> {
for (int k = 0; k < 10; k++)
map.computeIfPresent(
"test",
(key, value) -> value + 1
);
});
}
executorService.shutdown();
executorService.awaitTermination(5, TimeUnit.SECONDS);
sumList.add(map.get("test"));
}
return sumList;
}
}
조금 복잡해 보이니 하나하나 설명하겠습니다.
List<Integer> sumList = new ArrayList<>(1000);
for (int i = 0; i < executionTimes; i++) {
map.put("test", 0); // map에 key는 test value는 0으로 초기화합니다.
ExecutorService executorService = Executors.newFixedThreadPool(4);
//스레드를 네개 생성합니다.
for (int j = 0; j < 10; j++) {
executorService.execute(() -> { //각각의 스레드를 for문에 맞춰 실행합니다.
for (int k = 0; k < 10; k++)
map.computeIfPresent( // map에 test라는 key가 존재하면
"test", // value를 1 증가시킵니다.
(key, value) -> value + 1
);
});
}
executorService.shutdown(); // 스레드를 종료시키고
executorService.awaitTermination(5, TimeUnit.SECONDS); // 5초의 시간을 줍니다.
sumList.add(map.get("test")); // 그리고 리스트에 결괏값을 넣습니다.
}
5초의 시간을 주는 이유는 저 시간이 존재하지 않는 경우 바로 실행횟수만큼 for문이 돌기 때문에
그때 동시성 문제가 발생하여 값이 꼬여버리지 않게 하기 위해 하는 작업이라고 생각합니다.
위 로직을 진행하고 `parallelSum100`에 넘겨주는 파라미터인 Map에 따라 결괏값이 달라집니다.
Main 메서드에서는 `parallelSum100`이 반환한 List를 Stream API의 `filter`로 걸러, Map에 담긴 값이 100이 아닌(= 동시성 문제로 값이 꼬인) 개수를 셉니다.
넘겨주는 Map이 `HashMap`이면 29가 나옵니다. 동시성 문제가 발생한 개수가 29개라는 뜻입니다. 반면 `ConcurrentHashMap`을 넘기면 0이 나옵니다. 동시성 문제가 하나도 없었다는 뜻이죠.
마치며
이렇게 ConcurrentMap과 ConcurrentHashMap을 알아봤습니다. 개념을 살펴보고 검증까지 하면서 ConcurrentHashMap이 동시성 문제에서 자유롭다는 것을 확인했습니다.
여기까지 긴 글 읽어 주셔서 감사합니다. 오늘도 즐거운 하루 되세요~
출처
https://www.baeldung.com/java-concurrent-map
Java8 StreamAPI
Stream API는 제가 자주 쓰는 문법 중 하나인데, 정작 뭐가 어떻게 동작하는지는 잘 모르고 썼던 것 같습니다. 그래서 정리하면서 사용법까지 훑어보겠습니다.
Stream API란?
자바 8부터 지원하게 된 Stream API는 Collection을 함수형 인터페이스로 다뤄 함수형 프로그래밍을 지원하려는 목적으로 나왔습니다.
덕분에 우리는 Collection에 담긴 객체들로 `for`문을 돌리고 `if`문을 쓰던 것을 Stream API로 깔끔하게 줄일 수 있게 되었습니다.
Stream API는 람다식을 이용해 함수형 프로그래밍을 지원합니다. 대부분 Collection에 `stream()`을 붙여서 씁니다. 예시 코드와 함께 보시죠.
List<Bucket> findBucket = bucketRepository.findByMemberId(findMember.getId());
for (Bucket bucket : findBucket) {
}
------ 위와 아래가 똑같다 ------
bucketRepository.findByMemberId(findMember.getId()).stream();
`stream()`을 붙여 주면 사실 위와 아래 코드가 똑같습니다. 내부적으로 `for`문을 돌리는 것이기 때문이죠. 핵심은 가독성입니다.
"어? 사실 위가 가독성이 나쁘지는 않은데…?"
그럼 이런 코드는 어떨까요? 실제 제 프로젝트 코드 일부를 보여 드리겠습니다.
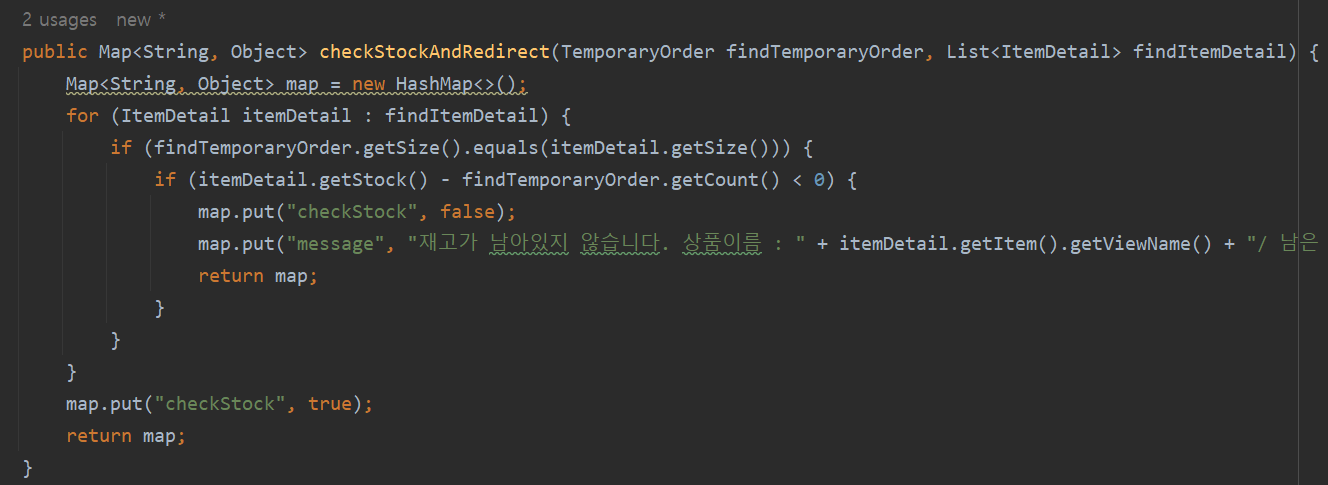
위 코드는 장바구니에 담고 결제를 진행하려 할 때, 장바구니에 담긴 상품의 사이즈(옷이라면 100·105, 신발이라면 270·280)와 실제 데이터베이스에 있는 상품의 사이즈를 비교합니다.
그다음 장바구니에 담은 개수(예: 2개)와 데이터베이스에 남아 있는 개수(예: 1개)를 비교해서, 담은 개수가 재고보다 많은 경우(즉 실제 상품은 1개인데 2개를 주문한 경우) 재고가 없다는 메시지를 띄우는 코드입니다.
제가 만든 거니까 이해하지만, 이걸 처음 본다면 어떨까요? 저 코드는 들여쓰기가 세 번이나 되어 있습니다. 제 코드 컨벤션상 들여쓰기가 세 번이면 리팩토링해야 한다는 주의입니다.
이 코드를 Stream API로 읽기 쉽게 바꿨습니다. 결과가 궁금하다면 아래 링크를 참고해 주세요.
관련 글: https://coding-review.tistory.com/491
Stream API는 크게 네 가지 유형이 있습니다.
• Consumer 계열 : 매개값이 있고, 반환값은 없다.
• Supplier 계열 : 매개값은 없고, 반환값은 있다.
• Function 계열 : 매개값이 있고, 반환값도 있다.
• Predicate 계열 : 매개값은 있고, 반환 타입은 `boolean`이다.
여기서 매개값이란 람다식을 시작할 때 선언해 주어야 하는 변수이고, 반환값이란 말 그대로 함수가 `void`인지 반환값이 있는지 여부입니다. 자세한 내용은 뒤에서 다루겠습니다.
Stream API 중 제가 자주 썼던 것을 위주로 정리해 보겠습니다.
filter (Predicate 계열)
사실 이 친구만 잘 써도 코드의 대부분이 줄어듭니다. `if`문을 대신하는 인터페이스입니다.
List<Bucket> findBucketByMemberId = bucketRepository.findByMemberId(1L);
findBucketBymemberId.stream().filter((bucket) -> bucket.getName().equals("상의"));
`filter()`를 쓰려면 매개값이 있어야 합니다. 위 코드에서 매개값은 `bucket`입니다. 이 코드의 뜻은 아래와 같습니다.
List<Bucket> findBucketByMemberId = bucketRepository.findByMemberId(1L);
for (Bucket bucket : findBucketByMemberId) {
if (findBucket.getName().equals("상의")) {
}
}
`filter` 안에 들어 있는 `bucket`이라는 매개변수는 Collection에서 `for`문을 돌릴 때 필요한 변수입니다. 예제 코드에서 알아보기 쉽게 변수명을 일치시켰으니 비교하며 보시면 됩니다.
`filter`는 Predicate 계열인 만큼 매개값(예시의 `bucket`)이 필요하고, 반환값으로 `boolean`을 돌려주기 때문에 `true`인 것들만 다음 계산으로 넘어갑니다.
예를 들어
List<Bucket> findBucketByMemberId = bucketRepository.findByMemberId(1L);
findBucketBymemberId.stream()
.filter((bucket) -> bucket.getName().equals("상의"))
.filter((bucket) -> bucket.getSize().equals("105"));
이렇게 되면 아래 코드와 같은 겁니다.
List<Bucket> findBucketByMemberId = bucketRepository.findByMemberId(1L);
for (Bucket bucket : findBucketByMemberId) {
if (findBucket.getName().equals("상의")) {
if (findBucket.getSize().equals("105")) {
}
}
}
주로 `for`문과 `if`문이 함께 있는 경우에 쓰면 좋습니다.
map (Function 계열)
`map`은 자바스크립트를 해 보셨다면 익숙한 바로 그것입니다. 다른 타입으로의 변환을 주로 담당합니다.
예를 들어 자바에서 JPA를 쓴다면 entity를 DTO로 변환하고 싶은 경우가 있습니다.
이렇게 변환하는 이유는 entity에 너무 많은 정보가 들어 있기 때문입니다. 회원 정보 entity라면 이름, 나이, 성별, 로그인 아이디, 비밀번호, 가입 날짜, 생년월일, 주소 등 다양한 정보가 있죠.
이걸 그대로 프론트에 던지면 OverFetching이 일어날 수 있습니다. (이 포스팅에서는 자세히 다루지 않겠습니다.) 쉽게 말해 필요한 정보보다 더 많은 정보를 반환한다는 뜻입니다. 반대로 필요한 정보보다 적게 반환하는 UnderFetching도 있습니다.
프론트에서 필요한 정보는 이름·나이·성별인데 entity에는 정보가 너무 많습니다. 그래서 우리는 그 셋만 필드로 가지는 DTO를 만들어 변환한 뒤 던져 줘야 할 겁니다.
만약 `map`을 안 쓴다면 어떻게 변환해야 할까요?
@Data
public class MemberDto {
private String name;
private String age;
private String birth;
}
List<Member> findByName = memberRepository.findByName("폴폴");
List<MemberDto> memberDto = new ArrayList<>();
for (Member member : findByName) {
MemberDto dto = new MemberDto();
dto.setName(member.getName());
dto.setAge(member.getAge());
dto.setBirth(member.getBirth());
memberDto.add(dto);
}
return ResponseEntity.ok(memberDto);
이렇게 해 줘야 합니다. 하지만 `map`을 쓴다면?
List<MemberDto> memberDto = memberRepository.findByName("폴폴").stream()
.map((member) -> new MemberDto(member.getName(), member.getAge(), member.getBirth()));
.collect(Collectors.toList());
return ResponseEntity.ok(memberDto);
정말 간단해졌습니다.
collect (Supplier 계열)
보통 Stream API에서 마지막에 실행되는 연산입니다. `filter`나 `map`을 쓰면 리턴값이 `Stream<>` 형태가 되는데, 이를 우리가 쓰기 편한 Collection으로 다시 바꾸기 위해 씁니다.
Supplier 계열인 만큼 `filter`나 `map`처럼 매개값이 있어야 하는 건 아니고, 반환값은 있습니다.
사용법은 위의 `map` 예시처럼 `collect(Collectors.toList());` 이렇게 쓰면 됩니다. 굉장히 간단하죠?
번외
findAny
얘는 아무 계열도 아니고 반환값은 `Optional`입니다. 저는 보통 `filter` 다음에 쓰는 편입니다.
List<Bucket> findBucketByMemberId = bucketRepository.findByMemberId(1L);
findBucketBymemberId.stream()
.filter((bucket) -> bucket.getName().equals("상의"))
.filter((bucket) -> bucket.getSize().equals("105"))
.findAny().orElseGet(Bucket::new);
`findAny()`는 `filter`로 걸러진 것들 중 하나라도 있으면 그 객체를 반환합니다.
`Optional`로 반환되기 때문에 우리가 쓰려면 `get()`, `orElse()`, `orElseGet()`, `orElseThrow()`, `or()` 등으로 조물조물 해 줘야 합니다.
`Optional`도 기회가 되면 자세히 다뤄 보겠습니다.
ifPresent (Consumer 계열)
이 친구는 Consumer 계열인데 왜 번외로 뺐냐고요? 바로 `Optional`에서만 존재하는 API이기 때문입니다.
Stream API에는 Consumer 계열이 없어서, 그 계열을 설명하려고 가져왔습니다. Consumer 계열답게 매개값이 있고 반환값이 없습니다.
보통 `Optional`에 하나라도 존재하면 다음 연산을 진행하도록 설계할 수 있습니다.
memberRepository.findByLogindId("ks3254").ifPresent((member) -> {
throw new IllegalStateException("이미 존재하는 회원입니다. login id = " + member.getLoginId())
})
이 로직은 회원가입할 때 로그인 아이디의 중복 검사를 하기 위한 것입니다. 만약 `ks3254`라는 아이디가 있으면 예외를 던져 회원가입을 막습니다.
물론 실제로 쓸 때는 `ks3254` 자리에 저렇게 하드코딩하는 것이 아니라, 중복 검사를 하려는 아이디 값이 들어가야 합니다.
번외 2) Stream API와 시간 복잡도
코드를 리팩토링하면서 '저게 과연 루프를 몇 바퀴 도는 걸까?' 하는 궁금증이 생겼습니다.
'설마 `filter`, `map` 이런 함수가 들어갈 때마다 루프를 돌겠어…?'라는 생각을 막연히 하고 있었는데요. 결론부터 말하면 Stream API의 시간 복잡도는 O(n)입니다.
Stream API는 말 그대로 "stream", 즉 흐름처럼 메서드를 타고 들어가는 것이 특징입니다. 예를 들어
Collections.stream().filter().filter().map().findAny().orElseGet()
이런 코드가 있다고 가정해 볼까요?
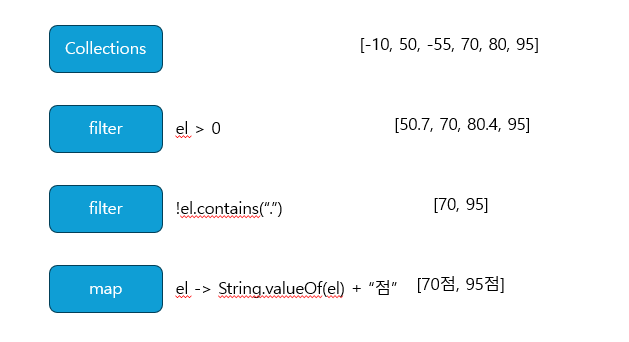
흐름도를 순서도로 볼까요? 예를 들어 95는
• 0보다 큰가? → yes
• `.`(dot)이 포함되지 않았는가? → yes
• 뒤에 점이라는 문자를 붙인다.
이렇게 하나의 흐름이 생성되는 것입니다.
첫 번째 `filter`가 O(n), 두 번째 `filter`가 O(n), 세 번째 `map`이 O(n)이니 O(3n)이고, 결국 O(n)이 됩니다.
마치며
Stream API는 제가 많이 쓰는 문법인데, 예전에 정리한 내용이 자바를 처음 공부하던 꼬꼬마 시절의 것이라 부족한 게 많아 다시 정리할 겸 써 봤습니다.
저도 Stream API를 익숙하게 쓰기까지 꽤 오랜 시간이 걸렸습니다. 처음엔 이해가 잘 안 되지만 익숙해지면 코드도 깔끔해지니 종종 써 보시면 좋겠습니다.
다만 단점은 재사용이 불가능하다는 점이니, 단발적인 로직에서만 쓰시면 될 것 같습니다.
출처
https://medium.com/javarevisited/java-8s-consumer-predicate-supplier-and-function-bbc609a29ff9
자바의 미래 : 가상 스레드
이번 포스팅에서는 가상 스레드를 알아보겠습니다. 우아한형제들 기술 블로그의 가상 스레드 포스팅을 보고 주제를 정하게 되었습니다.
글을 정말 재밌게 잘 쓰셨더군요. 흥미가 생겨서 공식 문서를 정독하며 공부해 봤습니다. 거두절미하고 바로 시작해 보죠!
가상 스레드
기존 자바의 스레드는 OS가 제공하는 네이티브 스레드를 그대로 썼습니다. OS와 JVM 사이의 JNI라는 인터페이스를 통해서요. 자바 진영에서는 이 네이티브 스레드를 플랫폼 스레드라고 부릅니다.
가상 스레드는 가상 메모리와 닮아 있습니다. 가상 메모리는 프로세스가 일을 처리할 때 실제 메모리 주소가 아닌 가상 주소를 바라보게 함으로써, 프로세스와 스레드가 일하면서 메모리 충돌이 일어나지 않게 합니다.
가상 스레드는 자바에 존재하는 플랫폼 스레드를 더 잘게 쪼갠 것입니다.
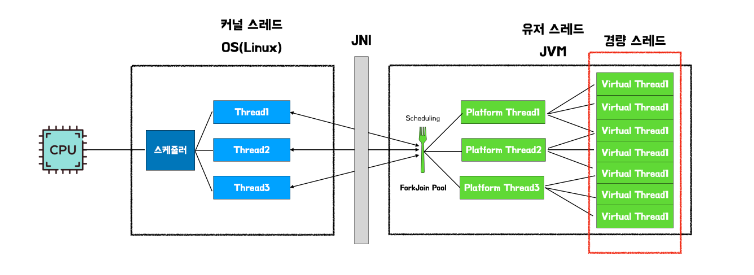
가상 스레드를 통해 기존에 서버가 처리할 수 있던 처리량(throughput)을 기하급수적으로 늘릴 수 있게 되었습니다.
그런데 가상 스레드는 JDK 21부터 등장했단 말이죠? JDK 21은 23년 9월에 나왔단 말이죠? 처리량을 기하급수적으로 늘릴 수 있는 걸 왜 이제서야 만든 걸까요?
가상 스레드 탄생 배경
기존 자바의 스레드는 스레드 풀을 적절히 쓰면 로직을 처리하는 데 큰 문제가 없었습니다. 그만큼 확장성이 높을 필요가 없었던 것이죠. 그래서 자바 언어 개발자들은 스레드를 초창기에 만들어 놓고 그대로 두었습니다.
하지만 인터넷 최강 전성기인 2020년대에는, 서버 증설만으로는 I/O 처리량을 늘리는 데 한계가 생길 정도로 엄청난 트래픽을 맞이하는 애플리케이션도 존재합니다.
이렇게 거대한 트래픽 앞에서는 물리적으로 CPU 코어 수를 높이고 메모리를 많이 장착해 스레드 수를 늘려도 부족해졌습니다.
또한 이와 일맥상통하는 문제로 스레드의 크기가 있습니다. 어떤 요청은 스레드가 처리하기에 너무 작은데도 스레드를 통째로 부여받아야 했기 때문에, 스레드의 성능을 100퍼센트 끌어내지 못하는 경우도 있었습니다.
그리고 또! 아무리 스레드가 프로세스보다 컨텍스트 스위칭 비용이 낮다고 해도, 가상 스레드에 비하면 플랫폼 스레드의 스위칭 비용도 무시할 수 없었습니다.
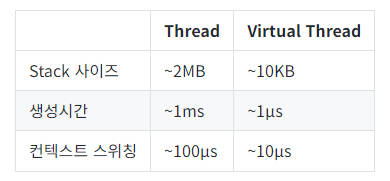
가상 스레드 사용하기
만드는 방법은 정말 간단합니다. 두 가지가 있는데 모두 소개해 드리겠습니다.
Thread thread = Thread.ofVirtual().start(() -> System.out.println("Hello"));
thread.join();
첫 번째는 `Thread` 클래스를 쓰는 것입니다. `Thread`의 `ofVirtual()` 메서드를 쓰면 가상 스레드를 만들 수 있습니다.
`Thread`의 builder를 활용해서도 시작할 수 있는데, 아래와 같습니다.
Thread.Builder builder = Thread.ofVirtual().name("MyThread");
Runnable task = () -> {
System.out.println("Running thread");
};
Thread t = builder.start(task);
System.out.println("Thread t name: " + t.getName());
t.join();
여담이지만, 자바 언어 개발자들이 기존 플랫폼 스레드와의 호환성을 유지하려고 가상 스레드의 분기를 만들어서 100퍼센트 호환성을 달성할 수 있었습니다.
두 번째는 `Executor`를 이용하는 방법입니다. `@Async`를 설정할 때 한 번씩 보던 그 `Executor`를 쓰면 쉽게 사용할 수 있습니다. 다만 이 방법은 자원을 JVM에 돌려줘야 하기 때문에, 오라클은 `try-with-resources` 활용을 권장합니다.
try (ExecutorService myExecutor = Executors.newVirtualThreadPerTaskExecutor()) {
Future<?> future = myExecutor.submit(() -> System.out.println("Running thread"));
future.get();
System.out.println("Task completed");
// ...
가상 스레드 사용 가이드
이제 주제를 살짝 바꿔서, 가상 스레드를 어떻게 쓰면 좋을지 알아보겠습니다.
동기에 블로킹? 그럼 쓰면 좋다!
공식 문서를 읽다가 아하! 하고 무릎을 탁 쳤습니다.
기존 스레드는 로직 처리가 동기 처리이고 블로킹 I/O인 경우, 스레드를 다시 스레드 풀에 돌려놓고 재사용하기까지 오랜 시간이 걸립니다. 이는 서버 성능에 악영향을 줄 수 있죠.
가상 스레드는 스레드를 잘게 쪼갠 것이기 때문에 이런 상황에 특화되어 있습니다.
synchronized와 잘 안 맞는다! pinned 문제
가상 스레드의 동작 방식은 다음과 같습니다.
• 플랫폼 스레드에서 떨어져 나온다.
• 가상 스레드가 생성되고 로직을 처리한다.
• 로직이 완료되면 자원을 반납한다.
• 다시 사용한다.
결국 빠르게 쓰고 빠르게 반납해 순환시켜야 가상 스레드의 장점을 백분 활용할 수 있습니다.
그런데 가상 스레드를 쓰면서 `synchronized` 키워드를 함께 쓰면 서버 성능에 문제가 생길 수 있습니다.
일례로 데이터베이스 I/O에서는 JDBC 드라이버 내부에 `synchronized`가 삽입되어 있어서, 그리 큰 성능 향상을 얻을 수 없습니다.
비동기에선 NO!
자바가 제공하는 `Future`나 `Callable`로 이미 비동기를 구현했다면, 그냥 그대로 두는 것이 좋습니다. 어차피 큰 성능 향상을 얻을 수 없기 때문이죠.
가상 스레드는 동기 + 블로킹에 주로 쓰면 될 것 같습니다.
ThreadLocal은 최소한으로!
스레드로컬은 스레드가 힙 메모리를 공유하며 쓸 때 벌어지는 동시성 문제를 막기 위한 방책 중 하나입니다.
가상 스레드는 크기가 작아진 만큼 스레드로컬도 최소한으로 써야 장점을 백분 활용할 수 있습니다. 스레드로컬 때문에 스레드가 무거워지면 가상 스레드를 쓰는 의미가 없어지기 때문입니다.
Thread Pool은 쓰지 말 것!
플랫폼 스레드는 귀중한 자원이고 만드는 데 큰 비용이 들기 때문에, 한 번 만든 것을 버리지 않고 재사용하는 것이 자원 측면에서 이점이 있었습니다.
하지만 기존 플랫폼 스레드가 몇만 개 정도로 활용되었다면, 가상 스레드는 몇백만 개까지 생성될 수 있는 일회용품 같은 존재입니다.
그래서 가상 스레드는 그냥 쓰고 GC가 버리도록 놔두는 편이 성능상 이점을 가져올 수 있습니다.
I/O 작업은 최고! 하지만 CPU 작업은 흠…
가상 스레드는 I/O 작업에서 현재보다 압도적으로 많은 처리를 하기 위해 개발되었습니다.
그래서 개발자가 좋아하는 두 단어인 응답 속도(latency)와 처리량(throughput) 중 처리량에 중점을 둔 만큼, 응답 속도는 크게 차이가 나지 않습니다. 오히려 CPU 작업에서는 기존 플랫폼 스레드보다 떨어지는 모습을 보이기도 하죠.
오라클도 가상 스레드를 CPU 작업 말고 I/O 작업에 더 적극적으로 쓰라고 권장했는데요. 아마 가상 스레드가 만능이 아니라는 것을 말하고 싶었던 것 같습니다. 뚜렷한 목적을 가지고 나왔다는 의미겠죠.
번외) 다른 언어에서의 가상 스레드
최근 대규모 엔터프라이즈를 중심으로 코틀린이 점점 뜨고 있습니다. 저는 그 이유를 코틀린의 coroutine 때문이라고 생각합니다.
coroutine은 Go의 goroutine을 벤치마킹한 가상 스레드입니다. Go는 GC가 있지만 이 goroutine 덕분에 같은 계열인 Rust와 성능 면에서 견줄 수 있게 되었습니다.
coroutine 덕분에 코틀린은 트래픽이 엄청나게 많은 서비스에 쓰기 안성맞춤이었죠. 하지만 자바밖에 모르는 개발자에게는 코틀린을 배워야 한다는 러닝 커브가 있었습니다.
자바도 발 빠르게 가상 스레드를 추가하면서 코틀린으로의 이동을 막으려 한 것일까요? JDK 21부터 추가된 가상 스레드를 적극 추천하는 모습을 보여 줬죠.
마치며
JDK 21만 검색해도 가상 스레드가 연관 검색어 최상단에 뜰 만큼 굉장히 핫하다고 볼 수 있을 것 같습니다. 이제 훌륭한 S급 개발자분들이 가상 스레드를 좀 써 보시고, 제가 낙수효과를 받을 수 있기를 기원해 봅니다.
긴 글 읽어 주셔서 감사합니다. 오늘도 즐거운 하루 되세요~
출처
https://docs.oracle.com/en/java/javase/21/core/virtual-threads.html#GUID-68216B85-7B43-423E-91BA-11489B1ACA61
자바는 스레드 생성비용이 어느정도길래 스레드 풀을 둘까?
안녕하세요. 이번 포스팅에서는 스레드 풀의 존재 의의를 스레드 생성 비용의 관점에서 공부하고 정리했습니다!
흔히 데이터베이스 커넥션과 JVM 스레드는 생성 비용이 크기 때문에 커넥션 풀, 스레드 풀을 적극 활용한다고 알려져 있습니다. 이런 내용의 글은 많지만, 그 생성 비용이 정확히 어느 정도인지 알려 주는 곳은 없더군요.
저와 같은 생각을 하신 분이 "널널한 개발자" 유튜버분께 질문을 올리셨고, 그에 대한 답변 영상에서 영감을 얻어 공부했습니다.
운영체제가 관리하는 스레드
스레드는 프로세스에 속해 있는 실행 단위죠. 보통 운영체제는 프로세스를 PID로 관리하고, 이 프로세스가 컴퓨터의 파일(여기서 파일은 소켓일 수도, 실제 파일일 수도 있습니다)을 읽거나 쓰거나 실행하도록 되어 있습니다.
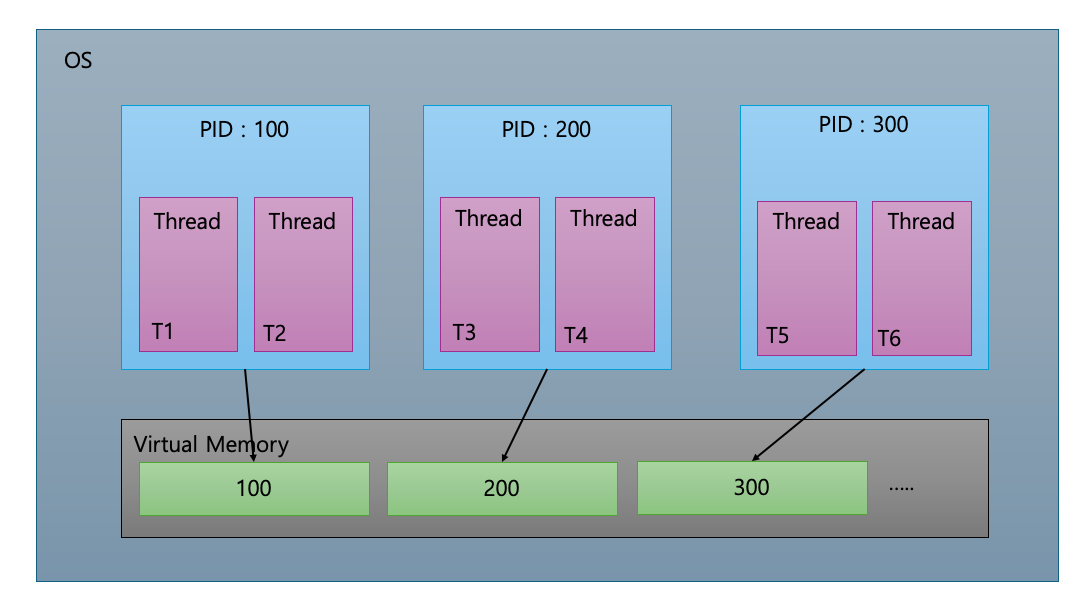
이렇게 OS가 프로세스를 PID로 관리하고, 프로세스는 그 안에서 스레드를 만들어 작업을 진행합니다.
각 프로세스는 OS가 작업량에 따라 메모리를 할당해 주고, 스레드가 그 메모리를 공유하며 실행된다는 것은 익히 알려진 사실입니다.
이 상황에서 만약 프로세스가 OS에게 "나 메모리 더 필요해!"라고 요구하면 어떻게 될까요?
물론 OS는 메모리를 할당해 줄 겁니다. 그러면 프로세스는 늘어난 일만큼 스레드를 추가로 생성할 텐데요. 우리는 이 부분을 잘 뜯어봐야 합니다.
Thread Control Block
Thread Control Block(이하 TCB)은 운영체제가 스레드를 잘 관리할 수 있도록 만든 자료구조입니다. 여기에는 스레드의 식별자와 이름, 어떤 프로세스에 속해 있는지, 스레드의 상태 등 각종 정보가 들어 있습니다.
마찬가지로 Process Control Block(이하 PCB)도 비슷한 방식으로 동작합니다.
아무튼 스레드를 생성하면 OS가 무슨 일을 해야 하는지 간단히 정리해 보겠습니다.
• TCB에 등록
• PCB에도 등록
• TCB 등록과 동시에 프로세스에 속한 시스템 자원도 할당 (메모리 등)
• 기타 등등
이 작업은 애플리케이션 레벨에서 개발하는 서비스 개발자에게는 큰일이 아닌 것처럼 보일 수 있습니다.
"에게, 그냥 슥삭 하면 되는 거지 뭐가 어렵다고."
하지만 이는 절대 작은 비용이 아닙니다.
예를 들어 제가 오마카세 식당을 크게 운영하고 있다고 해 봅시다.
오마카세에서 요리사 한 명이 처리할 수 있는 손님 수는 정해져 있습니다. 저희 가게에는 요리사가 5명 있고, 요리사당 최대 5명을 대접할 수 있다고 가정하죠.
그럼 총 25명을 맞이할 수 있을 텐데, 여기서 비현실적인 가정을 하나 하자면 저희 가게는 예약제가 아닙니다.
이런 상황에서 기존에 20명 남짓 오던 손님이 갑자기 50명이 몰려들기 시작했습니다.
그럼 요리사를 더 뽑아야겠죠? 요리사를 더 뽑는 것이 스레드를 생성하는 로직과 비슷합니다.
• 우선 요리사 지원 서류를 받아야 하고
• 서류도 읽어 봐야 하고
• 서류를 통과하면 면접도 봐야 하고
• 면접에 합격하면 계약서도 써야 하고
• 계약서를 다 쓰면 옷이나 칼 같은 도구도 준비해야 하고
지금 손님이 바글바글해서 식당이 꽉 찼는데, 주인인 저는 머리가 터져 버리기 직전일 겁니다.
그래서 나온 전략이 바로 스레드를 미리 생성해 두는 것입니다. 생성 비용이 크니까 미리 만들어 두고, 반납하고, 재사용하는 로직을 생각해 낸 겁니다.
JVM에서의 스레드
JVM에서는 스레드를 미리 만들어 두고 요청에 맞게 분배한 뒤 반납하면 재사용할 수 있습니다.
JVM의 스레드와 일반적으로 말하는 OS의 물리 스레드는 다르긴 하지만, JVM 스레드도 결국 물리 스레드를 기반으로 만들어지므로 연관이 없는 것은 아닙니다.
이에 대한 내용은 아래 링크에 잘 정리해 두었습니다.
관련 글: https://coding-review.tistory.com/520
흔히 JVM 진영에서 플랫폼 스레드라고 부르는 것이 바로 운영체제의 스레드를 가져와 만드는 것입니다. 스레드 스케줄링을 이용해서 만들죠.
서비스 개발자는 이 스레드 풀을 적절히 조절해 애플리케이션의 성능을 어느 정도 관리할 수 있습니다.
그런데 여기서 잠깐. 스레드 풀, 보통 어느 정도로 설정하시나요?
128, 256처럼 간단하게 정하는 경우도 많은 것으로 압니다. 하지만 이 스레드 풀을 설정하는 공식이 있다는 거 알고 계셨나요?
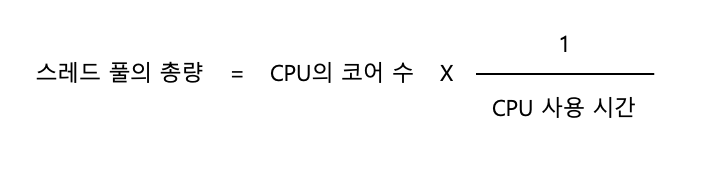
스레드 풀의 총량은 CPU 코어 수에 CPU 사용 시간의 역수를 나눈 값이 적정량이라고 하는데…
CPU 코어는 알겠는데 CPU 사용 시간은 뭘까요?
CPU 사용 시간은 [특정 요청에 걸린 시간 + 운영체제가 I/O를 처리하는 데 걸린 시간]입니다.
예를 들어 2코어이고 특정 요청에 걸린 시간이 0.1초, 운영체제가 I/O를 처리한 시간이 0.05초라면 스레드 풀의 적정량은 13입니다. 대충 15 정도로 잡으면 되겠네요.
이때 주의할 점이 있습니다. 커넥션 풀이 10인 경우 스레드 풀을 15로 설정해도 결국 10개만 동작하므로, 스레드 풀과 커넥션 풀을 함께 조절해야 합니다.
스레드 풀의 총량은 API 성능 테스트를 하면서 요청 시간이 가장 오래 걸린 것을 기준으로 잡으면 될 것 같네요.
마치며
이번 포스팅에서는 스레드 풀의 존재 의의를 스레드 생성 비용의 관점에서 알아보고 정리해 봤습니다. 생성 비용이 커서 스레드 풀을 운용한다는 것은 알고 있었지만, 이 정도로 클 줄은 몰랐네요. 괜히 스레드 풀을 쓰는 게 아닌 것 같습니다.
이 글에서는 프로세스와 스레드의 컨텍스트 스위칭 비용은 다루지 않았습니다. 물론 중요한 내용이지만 본문과 직접 연관이 없어서, 내용을 간결하게 하려고 뺐습니다.
긴 글 읽어 주셔서 감사합니다! 오늘도 즐거운 하루 되세요~