사이드 프로젝트
개발개발 ·
순수 자바로 스프링 만들기 : 시작
공부를 시작한지는 만으로 4년 3개월 햇수로는 5년차에 접어들면서 이것저것 많이 공부해봤는데요. 그래서 블로그 포스팅도 어느새 600개를 향해 가고있습니다. 물론 그 중에서 코딩 테스트나 영어 공부, 면접 준비를 뺀 진짜 포스팅은 500개 남짓이지만요.
처음엔 코딩하는게 재밌었습니다. 프로젝트 만드는게 재밌었거든요. 영한님 강의 들으면서 복습할겸 사이드 프로젝트로 하나 만들어보고 강의 듣고 사이드 프로젝트 만들고를 반복했습니다. 그렇게 2년정도를 공부하니 웬만한 프로젝트는 만들 수 있겠더군요.
그리고 그 때 이론이 부족한 것을 자각하고 코딩은 하지 않고 이론 공부만 매진했습니다. 특히 데이터베이스를 위주로 네트워크, 운영체제, 보안, 아키텍처, 데브옵스 가리지 않고 공부했죠.
제가 가장 이상적이라고 생각하는 공부법은 실전에서 모르는 것을 집에와서 공부하는 것입니다. 근데 지금 다니는 회사는 다람쥐 챗바퀴 돌리듯이 개발하여 늘은건 비즈니스 관점을 강화하는 것이었는데요. 물론 매우 훌륭한 경험이었습니다. 하지만 기술적인 갈증은 풀지 못했죠.
순수 자바로 스프링 만들기
저는 옛날부터 꼭 해보고싶은 프로젝트가 있었습니다. 순수 자바로 스프링을 만드는 것인데요. 근데 어디서부터 손을 대야할지 감도 안잡히고 스프링 프로젝트를 까봐도 너무나 많은 코드에 압도당해 어느게 중요한 메서드이고 어느게 중요한 변수인지 헷갈려서 포기했었죠.
이제 본격적으로 할 때가 된 것 같습니다.
CS지식들은 데이터베이스 동작 원리를 운영체제와 엮어서 본다던가, 카프카의 zero copy, dirty page 활용 같이 깊이있게 파면서 정작 백엔드 개발자로 일하면서 스프링을 깊이있게 공부하지 않았다는게 조금 아쉽게 느껴지더라구요.
이참에 순수 자바로 스프링을 만들어볼까합니다. 일단은 프로젝트라고 하지만 공부가 목적인 프로젝트이고 AI의 도움을 받을 생각입니다. 아마 코딩은 AI가, 코드레벨 이해는 제가 담당하게 될 것 같습니다. 그러면서 모르는게 있으면 AI한테 중간중간 물어보면서 공부하려고 합니다.
일단 프레임워크에 해당하는 폴더와 실제 기능을 테스트하는 데모 버전으로 깃허브를 운영하려고 합니다. 많은 관심 부탁드립니다.
https://github.com/garlicpollpoll/springlite
프로젝트 이름은 SQLite에서 영감을 받아 springlite로 지었습니다.
스프링의 핵심 기능들은 웬만한건 다 공부할 예정이라 혹시 스프링을 깊이있게 공부하고 싶으신 분들 이 카테고리에 올리는 포스팅 따라가면서 같이 공부하는 것도 좋을 것 같습니다.
순수 자바로 ApplicationContext 구현하기
이번 포스팅에선 AnnotationApplicationContext를 깊이있게 파헤쳐보고 정리해보도록 하겠습니다. 코드는 깃허브를 참고해주시면 감사하겠습니다. 코드는 웬만하면 적지 않을 예정입니다. 제 블로그 포스팅은 기본적으로 코드를 되도록 적지 않는데 그 이유는 코드가 많아지면 설명해야할게 많아지고 그럼 가독성이 떨어진다고 생각하기 때문입니다.
또한, 저도 공부하면서 포스팅을 수백개 봤지만 사실 코드를 잘 안봅니다... 그리고 깃허브를 들어가서 실제 코드를 보면 아시겠지만 변수명과 함수명이 실제 스프링 프로젝트와 다른 부분이 있습니다. 그 이유는
• 실제 스프링 프로젝트는 훨씬 더 복잡한 계층 구조와 다양한 팩토리 클래스를 가지고 있습니다. 그래서 제 프로젝트는 최대한 가볍게 만들기 위해서 변수명을 조정했습니다.
• 사실 코드는 별로 중요하지 않다고 생각하고 흐름만 공부하면 좋겠다고 생각했습니다.
• AI의 도움을 받긴 했지만 커서와 같은 AI는 도움만 주었고 실제 코드 작성은 제가 하는 편입니다. 그 중에서 AI가 적어준 변수명보다 제가 이해하기 편한 변수명을 사용한 것도 있습니다.
https://github.com/garlicpollpoll/springlite
AnnotationApplicationContext는 Spring boot에서도 아주 밀접하게 사용되는 Application Context 중 하나입니다. 어노테이션 기반으로 개발자가 가독성 좋게 개발할 수 있도록 도와줍니다.
이번 포스팅에선 AnnotationApplicationContext의 동작 원리를 공부할 예정이고 Bean을 등록하는 과정, 그리고 그 과정에서 일어나는 재귀, 이렇게 두 가지 관점에서 포스팅을 정리해보겠습니다.
Bean 등록
빈을 등록하는 과정도 크게 두가지 과정이 있습니다.
• 애플리케이션이 시작될 때 스캔하는 과정
• 스캔한 빈을 등록하는 과정
두 가지 과정을 모두 정리해보려고합니다.
Scan
스캔하는 과정은 크게 여섯 단계로 나눠집니다.
• scan
• scanPackages
• scanPackage
• scanDirectory
• registerBean
• findAutowiredMembers
이제 이 여섯 단계를 더 자세히 풀어보겠습니다.
• scan() : 스캔 단계에서는 @ComponentScan이 달려있는 최상위 패키지를 기준으로 아래로 내려가는 구조입니다. 이 베이스패키지를 기준으로 scanPackages를 호출합니다.
• scanPackages() : basePackages를 for문을 돌면서 scanPackage()를 호출합니다.
• scanPackage() : 여기서 클래스로더가 등장합니다. 클래스로더가 패키지의 베이스네임을 이용해서 getResource() 메서드를 호출해서 URL 형태로 가져옵니다. 그리고 이 것을 이용해서 new File()로 파일형태로 바꿔주죠.
• scanDirectory() : 3번에서 만든 파일을 이용해서 이 파일이 디렉토리인지 파일인지 확인합니다. 운영체제 입장에선 폴더건 파일이건 모두 파일로 판단하기 때문에 이 곳에서 디렉토리인지 확인하게 됩니다.
만약 파일이라면 곧장 registerBean을 호출하고 디렉토리라면 다시 scanDirectory를 호출해서 재귀를 만들어내죠. 이렇게 파일들을 모두 찾아서 registerBean을 호출합니다.
• registerBean() : 이 파일들 중에서 @Component가 붙어있는지 확인합니다. 일단 저는 지금 @Component만 빈으로 등록하게 했지만 추후에 업데이트를 통해 @Bean도 등록하도록 변경할 예정입니다.
5번 과정에서 눈여겨볼 점은 클래스에서 @Component가 붙은 빈을 클래스단위로 가져와서 이 클래스안에 다시 @Autowired가 붙어있는지 확인한다는 점입니다. 그럼 이제 마지막 스캔 단계인 findAutowiredMembers로 넘어가죠
• findAutowiredMembers() : 이 단계에서 @Autowired가 붙어있는 필드, 메서드, 생성자를 순서대로 찾습니다. 그리고 BeanDefinition에 차례대로 적재하죠. BeanDefinition에는 필드에 붙어있는 @Autowired를 List<Field> 형태로 가지고 있고 메서드에 붙어있는 @Autowired를 List<Method> 형태로 가지고 있고 생성자에 붙어있는 @Autowired를 Constructor<?> 형태로 들고 있습니다.
이 변수들을 이용해서 추후에 빈을 등록할 때 사용하는데 여기서이 변수들에 담겨있는 것은 실제로 스프링이 사용하는 것은 아니고 첫 번째 단계인 스캔 단계와 두 번째 단계인 등록 단계를 구분짓기 위해서 나눈 변수로 보입니다.
이 변수들을 이용해서 실제로 AnnotationApplicationContext 안에 singletonBeans라는 스프링이 사용하는 빈 목록으로 변환해주는 것이죠.
Refresh
두 번째 단계는 실제로 BeanDefinition에 있는 변수들에 접근해서 빈을 직접 등록하는 단계입니다. 여기서는 크게 네가지 단계로 다시 세분화되는데요.
• refresh
• instantiateBeans
• getBean
• createBean
이제 다시 깊이있게 정리해보겠습니다.
• refresh() : refresh 단계에서는 단순히 instantiateBeans를 호출하는 역할입니다.
• instantiateBeans() : BeanDefinition에 있는 변수인 beanDefinitionMap을 돌면서 Bean을 가져옵니다.
• getBean() : AnnotationApplicationContext에 있는 고유 변수인 singletonBeans (실제 스프링에서는 DefaultSingletonBeanRegistry라는 변수명을 사용하고 있습니다.) 을 돌면서 있으면 해당 객체를 바로 리턴하고 없으면 빈을 등록하는 과정을 거칩니다.
• createBean() : createBean에서는 객체 인스턴스를 생성하는 instantiateBean, 빈을 직접 등록하는 populateBean으로 나뉩니다. 이제 populateBean까지 간다면 진짜 빈이 등록되는 것이죠.
여기서 제가 제일 헷갈렸던 부분이 바로 instantiateBean과 populateBean인데요. 왜 이 둘을 나누게 되었는지 간단한 예제로 알아보도록 하겠습니다.
@Controller
@RequestMapping("/api/users")
public class UserController {
@Autowired
private UserService userService; // 필드 주입
// 생성자에 @Autowired가 없음
}
첫 번째 경우에서는 생성자 주입 없이 필드주입을 한 상태입니다.
• instantiateBean에서는 UserController의 생성자에 @Autowired가 없다는 것을 보고 기본 생성자를 만듭니다. new UserController()로 말이죠.
• 이 때 UserService는 아직 null인 상태입니다.
• populateBean을 호출하면서 @Autowired가 붙어있는 필드나 메서드를 확인합니다. 보니까 필드에 @Autowired가 붙어있네요. 이 객체를 getBean(UserService.class)로 빈을 찾아옵니다.
• 리플렉션으로 userService필드에 값을 주입
• 이제 userService 필드가 실제 UserService 인스턴스를 가리킴
두 번째 경우는 생성자 주입이 있는 경우입니다.
@Controller
@RequestMapping("/api/users")
public class UserController {
private final UserService userService;
@Autowired
public UserController(UserService userService) {
this.userService = userService;
}
}
• instantiateBean에서 @Autowired가 붙은 생성자를 발견했습니다. 그럼 바로 getBean을 이용해서 UserService.class 타입의 빈을 가져옵니다.
• 그리고 생성자를 이용해서 new UserController(userService)를 실행합니다.
• 그리고 생성 시점에 바로 의존성이 주입됩니다.
• populateBean에서는 필드나 메서드가 없으므로 아무것도 하지 않습니다.
실제 코드를 한번 볼까요?
private Object instantiateBean(BeanDefinition beanDefinition) {
try {
Class<?> beanClass = beanDefinition.getBeanClass();
Constructor<?> autowiredConstructor = beanDefinition.getAutowiredConstructor();
if (autowiredConstructor != null) {
// @Autowired 생성자 사용
Class<?>[] paramTypes = autowiredConstructor.getParameterTypes();
Object[] args = new Object[paramTypes.length];
for (int i = 0; i < paramTypes.length; i++) {
args[i] = getBean(paramTypes[i]);
}
return autowiredConstructor.newInstance(args);
} else {
// 기본 생성자 사용
return beanClass.getDeclaredConstructor().newInstance();
}
} catch (Exception e) {
throw new RuntimeException("Failed to instantiate bean: " + beanDefinition.getBeanName(), e);
}
}
private void populateBean(Object instance, BeanDefinition beanDefinition) {
// 필드 주입
for (Field field : beanDefinition.getAutowiredFields()) {
try {
Object dependency = getBean(field.getType());
field.set(instance, dependency);
} catch (Exception e) {
throw new RuntimeException("Failed to inject field: " + field.getName(), e);
}
}
// 메소드 주입
for (Method method : beanDefinition.getAutowiredMethods()) {
try {
Class<?>[] paramTypes = method.getParameterTypes();
Object[] args = new Object[paramTypes.length];
for (int i = 0; i < paramTypes.length; i++) {
args[i] = getBean(paramTypes[i]);
}
method.invoke(instance, args);
} catch (Exception e) {
throw new RuntimeException("Failed to inject method: " + method.getName(), e);
}
}
}
instantiateBean에서는 이미 우리가 아까 스캔할 때 Constructor<?>에 집어넣은 변수를 이용해서 객체를 만들고 그 생성자에 포함되어있는 객체들을 훑으면서 인스턴스 (객체) 를 만듭니다.
populateBean에서는 앞서 instantiateBean에서 만든 객체를 이용해서 리플렉션으로 값을 직접 세팅해줍니다.
이렇게 빈을 등록하는 모든 과정이 끝나게 됩니다.
이 때 스프링의 대단한 점이 엿보이는데 바로 getBean을 이용해서 재귀를 만들어 의존하고 있는 모든 클래스들을 돌면서 @Autowired가 붙은 모든 생성자, 필드, 메서드를 싹다 빈으로 등록하는 것인데요. 이제 스프링이 만든 노련함을 보겠습니다.
재귀의 마술사 스프링
처음 scanDirectory를 할 때 재귀를 하는것은 크게 놀랍지 않았지만 빈을 등록하는 과정은 확실히 노련함이 엿보이더군요.
예시는 UserController -> UserService -> UserRepository 이렇게 의존한다고 가정해보겠습니다. 그리고 각각 필드 주입으로 넣었다고 가정해보겠습니다.
순서와 함께 살펴보시죠.
• instantiateBeans()에서 getBean("userController") 호출
• getBean("userController") 실행
singletonBeans에서 확인 -> 없음
• createBean("userController") 호출
• "userController"를 빈으로 등록
• instantiateBean(userController) 호출 -> 기본 생성자로 new UserController() 생성
• populateBean(userController 인스턴스) 호출
• UserController의 @Autowired UserService userService 필드 발견
• getBean(UserService.class) 호출 **이 때 재귀 시작**
getBean("userService") 실행
• singletonBeans에서 확인 -> 없음
• createBean("userService") 호출
• "userService"를 빈으로 등록
• instantiateBean(userService) 호출 -> 기본 생성자로 new UserService() 생성
• populateBean(userService 인스턴스) 호출
• UserService의 @Autowired UserRepository userRepository 필드 발견
• getBean(UserRepository.class) 호출 **이 때 재귀 시작**
getBean("userRepository") 실행
• singletonBeans에서 확인 -> 없음
• createBean("userRepository") 호출
• "userRepository"를 빈으로 등록
• instantiateBean(userRepository) 호출 -> 기본 생성자로 new UserRepository() 생성
• populateBean(userRepository 인스턴스) 호출
• UserService로 복귀하면서 리턴받은 UserRepository 인스턴스를 리플렉션으로 필드주입
• UserController로 복귀하면서 리턴받은 UserService 인스턴스를 리플렉션으로 필드주입
만약 이런 구조를 사용하고 있다면 의존하고 있는 클래스가 엄청나게 많아도 끝까지 찾아가서 모든 빈을 등록하는데요. 이 때 만약 이미 등록된 빈이라면 싱글톤 구조 때문에 재귀를 스킵할 수도 있습니다.
이 재귀는 DFS이고 역시 알고리즘을 잘 쓸 수 있어야 스프링같은 대형 오픈소스 프로젝트를 할 수 있나봅니다.. 새삼 대단하게 느껴지네요.
마치며
이렇게 AnnotationApplicationContext를 빈등록과 재귀의 관점에서 깊이있게 알아봤습니다. 사실 세군데서 작업해야해서 공부가 조금 바쁘긴 합니다. 프로젝트 개발과 깃허브 관리, 블로그 포스팅까지 엄청 빠듯한 일정인데요.
그래도 간만에 너무 재밌는 공부였습니다. 앞으로 @Transactional을 추가하고 @Bean도 추가하면서 더 다채롭게 꾸며보도록 하겠습니다. 아직 추가해야할게 많아서 두근거리네요.
이번 포스팅은 여기서 마치도록 하겠습니다. 긴 글 읽어주셔서 감사합니다. 오늘도 즐거운 하루 되세요~
순수 자바로 Spring MVC 구현하기
이번 포스팅에선 Spring MVC를 깊이있게 파헤쳐보고 정리해보도록 하겠습니다. 코드는 깃허브를 참고해주시면 감사하겠습니다. 코드는 웬만하면 적지 않을 예정입니다. 제 블로그 포스팅은 기본적으로 코드를 되도록 적지 않는데 그 이유는 코드가 많아지면 설명해야할게 많아지고 그럼 가독성이 떨어진다고 생각하기 때문입니다.
또한, 저도 공부하면서 포스팅을 수백개 봤지만 사실 코드를 잘 안봅니다... 그리고 깃허브를 들어가서 실제 코드를 보면 아시겠지만 변수명과 함수명이 실제 스프링 프로젝트와 다른 부분이 있습니다. 그 이유는
• 실제 스프링 프로젝트는 훨씬 더 복잡한 계층 구조와 다양한 팩토리 클래스를 가지고 있습니다. 그래서 제 프로젝트는 최대한 가볍게 만들기 위해서 변수명을 조정했습니다.
• 사실 코드는 별로 중요하지 않다고 생각하고 흐름만 공부하면 좋겠다고 생각했습니다.
• AI의 도움을 받긴 했지만 커서와 같은 AI는 도움만 주었고 실제 코드 작성은 제가 하는 편입니다. 그 중에서 AI가 적어준 변수명보다 제가 이해하기 편한 변수명을 사용한 것도 있습니다.
https://github.com/garlicpollpoll/springlite
이제 본격적으로 포스팅 시작해보겠습니다. DispatcherServlet을 중심으로 Spring MVC는 다양한 구조체들로 이루어져있습니다.
• DispatcherServlet : DispatcherServlet은 모든 요청을 받아서 적절한 Controller로 라우팅 해주는 역할을 합니다. Spring MVC에서 핵심적인 역할을 맡고 있습니다.
• HandlerMapping : Spring MVC에선 HandlerMapping이라는 객체를 이용해서 DispatcherServlet이 처리할 다양한 정보들을 저장하고 있습니다. 주로 어떤 Controller인지 그 안에 메서드는 어떤게 있는지 url pattern은 뭔지 같은 정보들을 가지고 있습니다. DTO 비슷한거라고 생각해주시면 될 것 같습니다.
• HandlerAdapter : HandlerAdapter는 Spring MVC에서 다양한 매개변수들의 처리를 담당하고 있습니다. @PathVariable, @RequestParam, @RequestBody와 같은 매개변수에 사용하는 어노테이션을 처리하기위해 존재하고 있죠.
• ViewResolver : ViewResolver는 다양한 View구현체들로 연결해주는 매개체입니다. 우리는 경우에 따라서 JSP를 사용할 수도 있고 Thymeleaf같은 다양한 템플릿 엔진을 사용합니다. 그 때마다 적절한 View 구현체 (JspView, ThymeleafView) 로 라우팅해주는 역할을 합니다.
• View : 실제로 렌더링되는 규칙을 가지고 있는 구현체입니다. 보통 템플릿 엔진에 의존하고 있으며 render라는 중요한 메서드가 렌더링에대한 프로토콜을 구현하고 있습니다.
• 번외) ModelAndView : Model은 데이터를 운반하는 객체입니다. 이 데이터를 이용해서 템플릿 엔진에 값을 뿌려주는 것이죠. 보통 DispatcherSerlvet에서 ViewResolver가 View를 렌더링 할 때 Model에 있는 다양한 값들을 템플릿 엔진으로 넘겨주는 역할을 합니다.
우리의 목표는 다음과 같습니다.
• JSP 렌더링 요청은 JSP 페이지를 렌더링 해줘야한다.
• @PathVariable 요청이 정상작동해야함
• @RequestParam 요청이 정상작동해야함
• @RequestBody 요청이 정상작동해야함
Springlite에서는 이정도만 구현하는 것을 목표로 했습니다. 더 나아가서 thymeleaf로 렌더링하는 경우와 JSP를 렌더링하는 경우에 따라 인터페이스로 분리하고 추상화하는 작업이 요구되지만 프로젝트의 복잡성을 최대한 줄이고자 이 것은 구현하지 않도록 결정했습니다.
코드는 많이 업로드하지 않겠습니다. 핵심 로직만 짚고 넘어가겠습니다.
순수 자바로 Spring MVC 구현하기
/**
* HTTP 요청을 처리할 Handler(Controller 메소드)와 URL 패턴 정보를 담는 클래스
* Spring MVC의 HandlerMapping 개념을 구현
*/
public class HandlerMapping {
private final Object handler; // Controller 인스턴스
private final Method method; // Controller 메소드
private final String urlPattern; // URL 패턴 (예: /api/users/{id})
public HandlerMapping(Object handler, Method method, String urlPattern) {
this.handler = handler;
this.method = method;
this.urlPattern = urlPattern;
}
public Object getHandler() {
return handler;
}
public Method getMethod() {
return method;
}
public String getUrlPattern() {
return urlPattern;
}
@Override
public String toString() {
return "HandlerMapping{" +
"handler=" + handler.getClass().getSimpleName() +
", method=" + method.getName() +
", urlPattern='" + urlPattern + '\'' +
'}';
}
}
우선 HandlerMapping이라는 클래스를 이용해서 HandlerAdapter에서 처리할 요청들에 대한 정보를 저장하고 있는 클래스를 만들어야합니다.
크게 보면 DispatcherServlet에서 사용할 다양한 정보들을 가지고 있고 작게 보면 HandlerAdapter에서 리플렉션으로 실제로 실행해야되는 메서드들의 정보를 가지고 있습니다.
private void initHandlerMappings() {
String[] beanNames = applicationContext.getBeanDefinitionNames();
for (String beanName : beanNames) {
Object bean = applicationContext.getBean(beanName);
Class<?> beanClass = bean.getClass();
if (beanClass.isAnnotationPresent(Controller.class)) {
String baseMapping = "";
if (beanClass.isAnnotationPresent(RequestMapping.class)) {
RequestMapping requestMapping = beanClass.getAnnotation(RequestMapping.class);
baseMapping = requestMapping.value();
}
Method[] methods = beanClass.getDeclaredMethods();
for (Method method : methods) {
if (method.isAnnotationPresent(RequestMapping.class) ||
method.isAnnotationPresent(GetMapping.class) ||
method.isAnnotationPresent(PostMapping.class)) {
String path = getMethodPath(method);
String fullPath = baseMapping + path;
String httpMethod = getHttpMethod(method);
String key = httpMethod + ":" + fullPath;
handlerMappings.put(key, new HandlerMapping(bean, method, fullPath));
System.out.println("Mapped [" + httpMethod + " " + fullPath + "] -> " +
beanClass.getSimpleName() + "." + method.getName());
}
}
}
}
}
DispatcherServlet이 처음 생성되는 시점인 런타임 때 RequestMapping, GetMapping, PostMapping이 붙어있는 메서드들을 HandlerMapping에 저장합니다.
이후 Request에서 어떤 HTTP Method인지, 어떤 URL Path 인지에 대한 값을 이용해서 해당 값을 key로 HandlerAdapter가 어떤 컨트롤러에 어떤 메서드를 실행해야하는지를 위해 저장해놓는 값들입니다.
@Override
public Object handle(HttpServletRequest request, HttpServletResponse response, Object handler) throws Exception {
HandlerMapping handlerMapping = (HandlerMapping) handler;
Object controllerInstance = handlerMapping.getHandler();
Method controllerMethod = handlerMapping.getMethod();
System.out.println("RequestMappingHandlerAdapter: Executing " +
controllerInstance.getClass().getSimpleName() + "." + controllerMethod.getName());
// 확장된 매개변수 해결: @PathVariable, @RequestParam, @RequestBody 지원
Object[] methodArgs = resolveMethodArguments(controllerMethod, request, response, handlerMapping);
// Controller 메소드 실행
return controllerMethod.invoke(controllerInstance, methodArgs);
}
위의 코드는 HandlerAdapter의 구현체 중 제가 만든 RequestMappingHandlerAdapter입니다. 이 구현체에서 리플렉션을 이용해 실제 resolveMethodArguments라는 메서드를 이용해서 메서드 값들을 가져와 Controller의 메서드를 실행합니다.
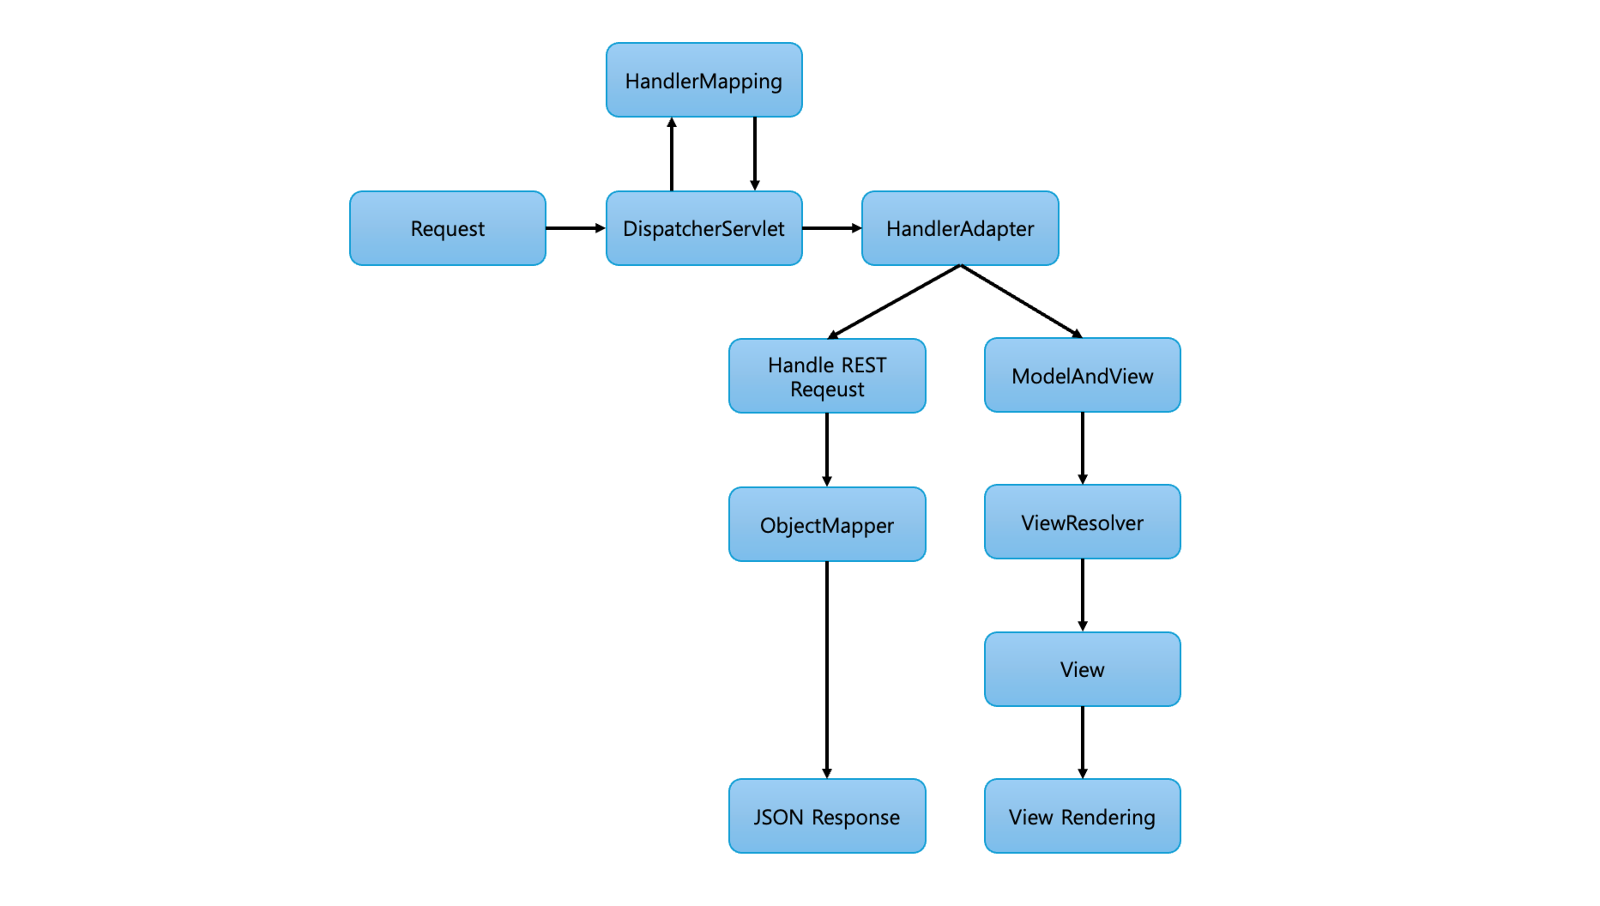
• Request 가 들어온다
• DispatcherServlet이 Request Method와 URL Path를 key로 하는 HandlerMapping을 가져온다.
• DispatcherServlet이 HandlerMapping에 있는 값을 이용해서 HandlerAdapter를 이용해 실제 메서드를 실행시키고 리턴값이 ModelAndView인지 아닌지에 따라 분기를 태운다.
ModelAndView인 경우 ViewResolver를 이용해서 View를 만들어 JSP를 렌더링한다
• ModelAndView가 아닌 경우 ObjectMapper를 이용해서 JSON으로 만들어 리턴한다.
이렇게 한사이클을 돌면 Request에 의한 응답이 완성됩니다.
트러블 슈팅
Spring MVC 이놈 구현하는데 꽤 고생을 했습니다.
1. 무한루프
• View에서 JSP를 렌더링하는 과정에서 forward를 사용하면 StackOverFlow가 발생한다.
• 그래서 include를 사용했더니 이번엔 무한루프는 발생하지 않았지만 HandlerAdapter를 찾을 수 없다고 에러 메세지가 나옴
Spring MVC가 JSP 렌더링을 구현하는 방식은 forward이기 때문에 forward를 사용하긴 해야했는데 무한루프가 발생하기에 첫 요청은 forward로 그 이후 요청이 있는지 확인하고 있다면 include로 빠지게하여 무한루프를 방지했습니다.
2. JSP가 되니까 REST가 안되고 REST가 되니까 JSP가 안됨
모든 요청을 DispatcherServlet이 받는 것이 Spring MVC의 핵심이지만 이는 핸들러가 있는 상황에서만 유효합니다.
Spring MVC에서 DispatcherServlet -> HandlerMapping -> HandlerAdapter -> ViewResolver -> View 으로 이어지는 상황에서 HandlerMapping을 찾았을 때 없으면 다른 서블릿으로 위임하는 과정이 필요했습니다.
그래서 delegateToNextServlet이라는 메서드를 이용해서 HandlerMapping이 없는 상황에선 다음 서블릿으로 넘어가주는 로직을 추가했습니다.
사실 추가한게 아니구요. Spring MVC에서는 실제로 다음 서블릿으로 위임하는 과정이 있더군요. 제가 AI를 잘 활용하지 못한것이죠..
마치며
저번 포스팅에선 Spring 에서 가장 중요한 빈을 등록하고 관리하는 과정을 개발했다면 이번엔 Spring Framework에서 큰 부분을 차지하고 있는 Spring MVC를 구현해봤습니다.
물론 제가 A to Z 전부 구현한건 아니지만 AI가 만들어준 코드를 이해하기 위해 열심히 노력했습니다.
영한님이 Spring MVC를 설명해주실 때 그냥 달달 외우기만 했던 개념들이라 사실 이해하고있다고 얘기할 수 없었는데 이번에 구현하면서 흐름정도는 완벽하게 이해한 것 같습니다.
DispatcherServlet에서 View까지 이르는 흐름만 익혔다면 사실 이번 포스팅의 목적은 거의 다 이뤘다고 할 수 있죠.
세부적인 구현같은 것들은 아직 완벽하게 이해하진 못했지만 사실 구현이 중요하다고는 생각하지 않습니다. Spring이 어떻게 자바라는 객체지향 언어를 십분 활용하는지, 어떤 흐름으로 프레임워크를 만들었는지, 끝까지 놓지 못하는 중요한 철학은 무엇인지 이런것들을 학습하는 것이 이번 프로젝트의 목표라고 생각합니다.
이번 포스팅은 여기서 마치도록 하겠습니다. 긴 글 읽어주셔서 감사합니다. 오늘도 즐거운 하루 되세요~
순수 자바로 스프링 빈 라이프 사이클 구현하기
이번 포스팅에선 Spring Bean LifeCycle을 깊이있게 파헤쳐보고 정리해보도록 하겠습니다. 코드는 깃허브를 참고해주시면 감사하겠습니다. 코드는 웬만하면 적지 않을 예정입니다. 제 블로그 포스팅은 기본적으로 코드를 되도록 적지 않는데 그 이유는 코드가 많아지면 설명해야할게 많아지고 그럼 가독성이 떨어진다고 생각하기 때문입니다.
또한, 저도 공부하면서 포스팅을 수백개 봤지만 사실 코드를 잘 안봅니다... 그리고 깃허브를 들어가서 실제 코드를 보면 아시겠지만 변수명과 함수명이 실제 스프링 프로젝트와 다른 부분이 있습니다. 그 이유는
• 실제 스프링 프로젝트는 훨씬 더 복잡한 계층 구조와 다양한 팩토리 클래스를 가지고 있습니다. 그래서 제 프로젝트는 최대한 가볍게 만들기 위해서 변수명을 조정했습니다.
• 사실 코드는 별로 중요하지 않다고 생각하고 흐름만 공부하면 좋겠다고 생각했습니다.
• AI의 도움을 받긴 했지만 커서와 같은 AI는 도움만 주었고 실제 코드 작성은 제가 하는 편입니다. 그 중에서 AI가 적어준 변수명보다 제가 이해하기 편한 변수명을 사용한 것도 있습니다.
https://github.com/garlicpollpoll/springlite
이제 본격적으로 시작해보겠습니다.
우선 스프링에선 빈 라이프 사이클이 크게 두가지 있습니다. PostConstruct와 PreDestroy 이렇게 두 종류입니다.
각각 어디서 호출되는지 알아보고 더 깊게 정리해보겠습니다.
• 빈 생성
• 의존성 주입
• @PostConstruct 메서드 호출
• 빈을 런타임 때 사용 가능
• 애플리케이션 종료 신호
• @PreDestroy 메서드 호출
• 빈 소멸
여기서 중요한건 @PostConstruct 메서드가 호출되는 시점이 모든 의존성이 주입되고 난 뒤라는 점입니다. @PostConstruct가 호출되는 시점을 모든 빈이 주입되고 나서 작업을 해야합니다.
이제 핵심 코드를 확인해보겠습니다.
private Object createBean(BeanDefinition beanDefinition) {
String beanName = beanDefinition.getBeanName();
// 순환 의존성 체크
if (creatingBeans.contains(beanName)) {
throw new RuntimeException("Circular dependency detected for bean: " + beanName);
}
creatingBeans.add(beanName);
try {
Object instance;
// @Bean 메서드로 생성된 빈인지 확인
if (beanDefinition.isBeanMethod()) {
instance = createBeanFromMethod(beanDefinition);
} else {
instance = instantiateBean(beanDefinition);
populateBean(instance, beanDefinition);
}
// 빈 초기화 (라이프사이클 메서드 호출)
initializeBean(instance, beanDefinition);
// @Transactional이 있으면 프록시 생성
if (needsProxy(beanDefinition.getBeanClass())) {
instance = proxyFactory.createProxy(instance);
}
return instance;
} catch (Exception e) {
throw new RuntimeException("Failed to create bean: " + beanName, e);
} finally {
creatingBeans.remove(beanName);
}
}
다음 포스팅 내용이긴 하지만 @Configuration으로 인한 @Bean 메서드들을 빈으로 등록하고 나서 모든 것이 끝나고 나면 initializeBean을 호출해서 PostConstruct 메서드를 호출하는 작업을 수행해줍니다.
getBean에서 instantiateBean -> populateBean으로 이어지는 재귀를 이용한 빈 등록 과정은 아래의 포스팅에 자세히 기록되어있습니다.
https://coding-review.tistory.com/595
private void initializeBean(Object bean, BeanDefinition beanDefinition) throws Exception {
// 1. @PostConstruct 메서드들 호출
for (Method postConstructMethod : beanDefinition.getPostConstructMethods()) {
postConstructMethod.setAccessible(true);
postConstructMethod.invoke(bean);
System.out.println("@PostConstruct 호출: " + beanDefinition.getBeanName() + "." + postConstructMethod.getName());
}
// 2. @Bean의 initMethod 호출 (있는 경우)
String initMethodName = beanDefinition.getInitMethodName();
if (initMethodName != null && !initMethodName.isEmpty()) {
try {
Method initMethod = bean.getClass().getDeclaredMethod(initMethodName);
initMethod.setAccessible(true);
initMethod.invoke(bean);
System.out.println("initMethod 호출: " + beanDefinition.getBeanName() + "." + initMethodName);
} catch (NoSuchMethodException e) {
System.err.println("initMethod 를 찾을 수 없습니다: " + initMethodName);
}
}
}
initializeBean 내부는 이렇게 생겼고 BeanDefinition에 등록된 PostConstruct 메서드들을 하나씩 for문으로 돌리면서 실행시키는 모습입니다.
BeanDefinition에 등록하는 과정은
private void scanLifecycleMethods(Class<?> clazz, BeanDefinition beanDefinition) {
Method[] methods = clazz.getDeclaredMethods();
for (Method method : methods) {
if (method.isAnnotationPresent(PostConstruct.class)) {
beanDefinition.getPostConstructMethods().add(method);
System.out.println(" 📋 @PostConstruct 메서드 발견: " + method.getName());
}
if (method.isAnnotationPresent(PreDestroy.class)) {
beanDefinition.getPreDestroyMethods().add(method);
System.out.println(" 📋 @PreDestroy 메서드 발견: " + method.getName());
}
}
}
바로 registerBean에서 @Autowired 어노테이션이 붙은 생성자, 메서드, 필드를 찾고 나서 BeanDefinition에 등록하는 findAutowiredMembers 메서드 이후입니다.
더 자세한 코드가 있지만 해당 포스팅에서는 생략하도록 하겠습니다.
그리고 gradle을 빌드하고 테스트를 해보겠습니다.
LifecycleTestService 두 번째 초기화 메서드 호출!
@PostConstruct 호출: lifecycleTestService.secondInit
LifecycleTestService 초기화 완료! (시작 시간: 1749370310456)
@PostConstruct 호출: lifecycleTestService.init
@PostConstruct
public void init() {
startTime = System.currentTimeMillis();
status = "INITIALIZED";
System.out.println("LifecycleTestService 초기화 완료! (시작 시간: " + startTime + ")");
}
@PostConstruct
public void secondInit() {
System.out.println("LifecycleTestService 두 번째 초기화 메서드 호출!");
}
이렇게 등록한 @PostConstruct가 위의 로그처럼 찍히는 것을 볼 수 있습니다.
마치며
빈 라이프 사이클을 순수 자바로 구현해보니 왜 @PostConstruct와 @PreDestroy로 라이프 사이클을 나누는지 대강 알 것 같습니다. 아마 의도는 빈이 모두 주입된 뒤 초기화해야하는 작업들을 위해 만들어 두었을 것이고 생성자를 만들면서 곧장 초기화하지 않고 @PostConstruct로 나눈 이유는 다른 생성자에서 주입한 빈을 초기화하려면 객체지향이랑 멀어지긴 하는 것 같습니다.
그 이유는 A클래스에서 생성자 주입으로 A' 를 주입했고 B클래스에서 생성자 주입으로 B' 를 주입했다고 가정해보면 @PostConstruct에서 A' B' 를 이용해서 초기화 해야하는데 만약 생성자 주입을 하는 동시에 초기화를 해버리면 A클래스에서, B클래스에서 각각 초기화를 해줘야합니다.
생성자 주입으로 A' B' 를 주입하고 초기화 작업은 @PostConstruct라는 메서드 한 군데에서만 작업하면 A' B' 에 대한 정보가 변해서 초기화 작업을 변경해야하더라도 각각의 클래스에서 변경하는 것이 아니라 @PostConstruct에서 작업해주는 것이 객체지향스럽긴 합니다.
이런걸 보면 스프링이 객체지향에 얼마나 목숨을 걸었고 추상화, 다형성에 얼마나 진심인지 알 수 있는 대목이었습니다.
이번 포스팅은 여기서 마치도록 하겠습니다. 긴 글 읽어주셔서 감사합니다. 오늘도 즐거운 하루 되세요~
순수 자바로 @Configuration, @Bean 구현하기
이번 포스팅에선 @Configuration, @Bean을 깊이있게 파헤쳐보고 정리해보도록 하겠습니다. 코드는 깃허브를 참고해주시면 감사하겠습니다. 코드는 웬만하면 적지 않을 예정입니다. 제 블로그 포스팅은 기본적으로 코드를 되도록 적지 않는데 그 이유는 코드가 많아지면 설명해야할게 많아지고 그럼 가독성이 떨어진다고 생각하기 때문입니다.
또한, 저도 공부하면서 포스팅을 수백개 봤지만 사실 코드를 잘 안봅니다... 그리고 깃허브를 들어가서 실제 코드를 보면 아시겠지만 변수명과 함수명이 실제 스프링 프로젝트와 다른 부분이 있습니다. 그 이유는
• 실제 스프링 프로젝트는 훨씬 더 복잡한 계층 구조와 다양한 팩토리 클래스를 가지고 있습니다. 그래서 제 프로젝트는 최대한 가볍게 만들기 위해서 변수명을 조정했습니다.
• 사실 코드는 별로 중요하지 않다고 생각하고 흐름만 공부하면 좋겠다고 생각했습니다.
• AI의 도움을 받긴 했지만 커서와 같은 AI는 도움만 주었고 실제 코드 작성은 제가 하는 편입니다. 그 중에서 AI가 적어준 변수명보다 제가 이해하기 편한 변수명을 사용한 것도 있습니다.
https://github.com/garlicpollpoll/springlite
제가 기존에 만들었던 AnnotationApplicationContext 에서는 @Component가 붙은 @Repository, @Service, @Controller 이렇게 세 가지만 빈으로 등록하고 있었습니다.
하지만 스프링에서는 @Configuration 어노테이션 기반의 @Bean 메서드도 빈으로 등록하고 있는데요.
제 프로젝트에도 이 부분이 반드시 필요하다고 생각해 곧바로 개발에 들어갔습니다.
@Target(ElementType.TYPE)
@Retention(RetentionPolicy.RUNTIME)
@Component
public @interface Configuration {
String value() default "";
boolean proxyBeanMethods() default true;
}
@Target(ElementType.METHOD)
@Retention(RetentionPolicy.RUNTIME)
public @interface Bean {
String[] value() default {};
String initMethod() default "";
String destroyMethod() default "";
boolean defaultCandidate() default true;
}
이미 개발해두었던 @Component를 적극 활용하게 되어 아주 기분이 좋습니다.
기존 @Component와 @Configuration 어노테이션을 이용한 빈 등록은 조금 차이가 있습니다.
• 기존 : instantiateBean으로 생성자를 만들고 만약 @Autowired 어노테이션이 생성자에 붙었다면 getBean으로 빈을 가져와 생성자를 만듦과 동시에 주입. 만약 생성자 주입이 아니라면 메서드를 호출하면서 getBean으로 가져온 빈을 인자값으로 넘기면서 주입. 필드 주입이라면 필드에 곧장 주입
• @Bean : @Bean으로 만든 메서드에 인자값으로 이미 빈으로 등록된 객체를 받아 추가공정을 거쳐 return값으로 온전한 객체를 받아야 하기에 인자값으로 적은 빈을 등록하고 주입하는 과정이 필요함
보통 우리가 @Bean으로 등록하는 과정에서 다음과 같은 시나리오를 생각할 수 있습니다.
@Configuartion
public class TestConfig {
@Bean
public DatabaseService dataService() {
return new DatabaseService();
}
@Bean
public NotificationService notificataionService(DatabaseService databaseService) {
return new NotificationService(databaseService);
}
}
예시가 조금 부실해도 양해부탁드립니다..
DatabaseService를 먼저 빈으로 만들고 NotificationService를 만들 때 빈으로 주입받아서 온전한 객체인 NotificationService를 리턴된 값을 빈으로 등록해야하기에 이런 사전 작업이 필요합니다.
때문에, 기존의 instantiateBean -> populateBean 의 흐름을 따라갈 수 없는 것이죠.
즉, 다시 정리하자면
기존 방식은 @Component가 작성된 클래스를 객체로 만들고 그 안에 생성자, 메서드, 필드를 주입하는 과정이기 때문에
@Component가 적힌 클래스 객체 생성 (new 연산자로) -> 생성자 주입이라면 생성자 생성과 동시에 주입 생성자 주입이 없다면 빈객체 생성 -> 메서드에 주입, 필드에 주입
이런 흐름을 가져간다면 @Bean으로 빈을 등록하는 과정은
@Configuration이 적힌 클래스 객체 생성 -> @Bean이 적힌 메서드에 인자 값 확인 -> 인자가 있으면 빈으로 등록 후 메서드에 주입 -> @Bean이 적힌 메서드 실행 -> 그 때 리턴된 객체를 빈으로 등록
이렇기 때문에 이 둘은 BeanDefinition에서 @Bean이 적힌 메서드인지 확인하는 과정이 있어야하고 이 둘은 다른 분기를 타야합니다.
private Object createBean(BeanDefinition beanDefinition) {
String beanName = beanDefinition.getBeanName();
// 순환 의존성 체크
if (creatingBeans.contains(beanName)) {
throw new RuntimeException("Circular dependency detected for bean: " + beanName);
}
creatingBeans.add(beanName);
try {
Object instance;
// @Bean 메서드로 생성된 빈인지 확인
if (beanDefinition.isBeanMethod()) {
instance = createBeanFromMethod(beanDefinition);
} else {
instance = instantiateBean(beanDefinition);
populateBean(instance, beanDefinition);
}
// 빈 초기화 (라이프사이클 메서드 호출)
initializeBean(instance, beanDefinition);
return instance;
} catch (Exception e) {
throw new RuntimeException("Failed to create bean: " + beanName, e);
} finally {
creatingBeans.remove(beanName);
}
}
instantiateBean -> populateBean으로 이어지는 빈 생성과 주입은 아래의 포스팅에 자세히 기술되어있으니 아래의 링크를 참고해주시기바랍니다.
https://coding-review.tistory.com/595
createBeanFromMethod를 자세히 한번 보면
private Object createBeanFromMethod(BeanDefinition beanDefinition) throws Exception {
Method beanMethod = beanDefinition.getBeanMethod();
Object configInstance = beanDefinition.getConfigurationInstance();
// 메서드 파라미터들에 대한 의존성 주입
Parameter[] parameters = beanMethod.getParameters();
Object[] args = new Object[parameters.length];
for (int i = 0; i < parameters.length; i++) {
Parameter parameter = parameters[i];
// 파라미터에 대한 의존성 주입
Object dependency = getBean(parameter.getType());
args[i] = dependency;
}
// @Bean 메서드 호출
beanMethod.setAccessible(true);
Object bean = beanMethod.invoke(configInstance, args);
System.out.println("🔧 @Bean 메서드로 빈 생성: " + beanDefinition.getBeanName() + " = " + bean);
return bean;
}
순서가 조금 뒤죽박죽이지만 정리해보자면
• scan 과정에서 @Component 가 적힌 클래스를 찾고 @Autowired가 적힌 객체들을 전부 BeanDefinition (빈 등록 후보) 에 등록
• refresh 과정에서 @Configuration을 먼저 찾고 해당 객체를 빈으로 등록
• @Bean이 적힌 메서드를 발견하고 이를 BeanDefinition에 등록 (@Bean은 @Autowired가 아니기에 1번에서 BeanDefinition으로 등록 안됨)
• BeanDefinition에 있는 @Bean이 적힌 메서드들을 돌면서 빈으로 등록
getBean으로 빈찾기
• 없으면 createBean을 호출 (이게 위에 있는 두 개의 코드 블럭 중 첫 번째 코드 블럭)
• @Bean이 적힌 메서드라면 createBeanFromMethod를 호출
• getBean으로 재귀 호출 (위의 예시처럼 @Bean으로 등록하려는 메서드에 인자값으로 빈을 주입받아야 하는 경우이므로)
• @Bean이 모두 등록되면 이후 instantiateBean -> populateBean 흐름대로 빈 등록 후 주입
즉, 기존 로직 이전에 @Bean이 등록이 되고 이후 @Component 에 있는 @Autowired 빈들이 주입된다는 것입니다.
마치며
ApplicationContext에서 가장 주요한 빈 등록 방식인 @Bean을 이용한 방식과 @Component를 이용한 방식 모두 구현이 완료되었습니다.
이제 조금 구실을 갖추고 있는 것이 느껴지네요. 그리고 @Component를 먼저 구현해놨더니 @Configuration을 구현할 때 유용하게 사용하면서 제가 가장 이상적으로 생각하는 구현이 나오게 되었습니다.
저는 스프링의 코드를 보면서 자신들이 구현해놓은 기능을 이용해서 추가 기능을 구현하는게 정말 멋있어 보였거든요. 앞서 언급했듯이 @Component를 먼저 구현해놓고 @Configuration을 구현할 때 사용한다던가, AOP를 구현하고 AOP를 이용해서 추가기능을 구현한다거나 하는 것들말이죠.
스프링의 생태계는 방대하고 내가 감히 이 흐름을 따라갈 수 있을까 싶었지만 이제 점점 구실을 하고 있는 것을 보니 정말 뿌듯하고 좋습니다.
순수 자바로 스프링 구현하기는 앞으로도 계속됩니다! 이번 포스팅은 여기서 마무리 짓도록 하겠습니다. 긴 글 읽어주셔서 감사합니다. 오늘도 즐거운 하루 되세요~
순수 자바로 Spring AOP 프레임워크 만들기
이번 포스팅에선 Spring AOP를 깊이있게 파헤쳐보고 정리해보도록 하겠습니다. 코드는 깃허브를 참고해주시면 감사하겠습니다. 코드는 웬만하면 적지 않을 예정입니다. 제 블로그 포스팅은 기본적으로 코드를 되도록 적지 않는데 그 이유는 코드가 많아지면 설명해야할게 많아지고 그럼 가독성이 떨어진다고 생각하기 때문입니다.
또한, 저도 공부하면서 포스팅을 수백개 봤지만 사실 코드를 잘 안봅니다... 그리고 깃허브를 들어가서 실제 코드를 보면 아시겠지만 변수명과 함수명이 실제 스프링 프로젝트와 다른 부분이 있습니다. 그 이유는
• 실제 스프링 프로젝트는 훨씬 더 복잡한 계층 구조와 다양한 팩토리 클래스를 가지고 있습니다. 그래서 제 프로젝트는 최대한 가볍게 만들기 위해서 변수명을 조정했습니다.
• 사실 코드는 별로 중요하지 않다고 생각하고 흐름만 공부하면 좋겠다고 생각했습니다.
• AI의 도움을 받긴 했지만 커서와 같은 AI는 도움만 주었고 실제 코드 작성은 제가 하는 편입니다. 그 중에서 AI가 적어준 변수명보다 제가 이해하기 편한 변수명을 사용한 것도 있습니다.
https://github.com/garlicpollpoll/springlite
본격적으로 시작해보도록 하겠습니다.
순수 자바로 Spring AOP 개발하기
AOP (Aspect Oriented Programming) 가 생각보다 볼륨이 매우 큰 프레임워크인 것을 이번에 개발하면서 알게 되었습니다. AOP의 가장 큰 부분을 차지하는 것은 @Aspect가 붙어있는 클래스를 프록시로 만들어 실제 빈이 실행되는 것이 아니라 프록시가 실행되도록 하는 것입니다.
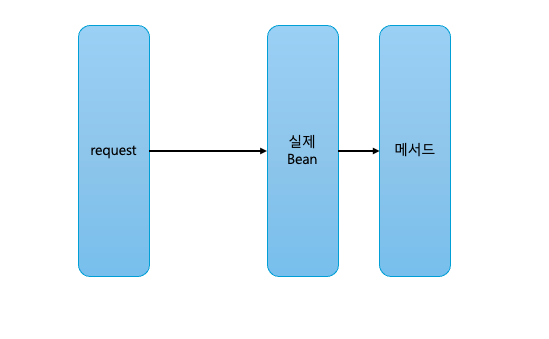
보통 위의 그림처럼 되어있는 것이 일반적이라면 AOP는
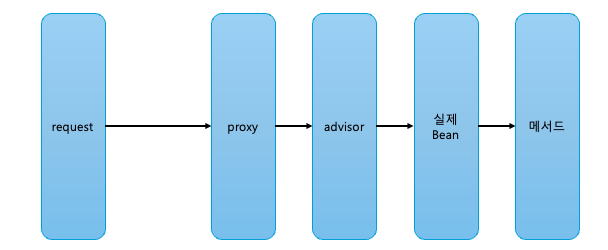
이렇게 프록시가 앞에서 실제 빈을 흉내내듯이 동작하여 우리가 원하는 동작을 수행할 수 있게 합니다.
이에 관한 자세한 내용은 아래의 링크에 기술되어있습니다. 아래의 링크를 참고해주세요!
https://coding-review.tistory.com/426
AOP의 구조
AOP는 크게 여섯개의 구조로 나눠져있습니다.
• ProxyFactory : 프록시 팩토리는 만들어진 프록시가 어떻게 행동할지 정하는 AOP의 심장입니다. 여기서 만들어진 프록시들의 행동강령이 정해지는 것이죠.
• AspectScanner : @Aspect가 붙어있는 클래스를 스캔하는 용도로 사용되는 클래스입니다.
• JoinPoint : JoinPoint는 AOP에서 메서드 실행 지점 (Join Point) 이며 AOP를 사용해본 분들은 아시겠지만 JoinPoint를 메서드 인자값으로 받아서 내가 원하는 시점에 메서드를 실행시키게 되는데 이 때 사용하게 됩니다.
• Metadata : 메타데이터는 AdviceMetadata와 AspectMetadata가 있고 이 두개 모두 AspectScanner때 스캔되고 메타데이터로 등록됩니다.
• PointcutMatcher : PointcutMatcher는 우리가 AOP에서 사용하는 pointcut 문법을 해독하기위해 사용됩니다.
• InvocationHandler : InvocationHandler는 어드바이저가 실행되는 순서인 어드바이저 체인을 위해 사용됩니다.
이제 구조는 알았으니 흐름도를 알아보도록 하겠습니다.
AOP의 흐름
AOP의 흐름을 하나하나 뜯어보면 정말 복잡하지만 제가 이해하기 편하게 나름대로 정리해서 포스팅해보려고 합니다.
• AnnotationApplicationContext에서 @Aspect가 붙은 클래스를 찾아내서 빈으로 등록합니다.
• AspectScanner에서 어드바이저들을 검색해서 메타데이터로 저장합니다.
• ApplicationContext에서 빈으로 등록될 때 createBean을 호출하고 여기서 @Aspect가 붙었다면 프록시를 생성합니다.
• 실제로 빈이 실행될 때 InvocationHandler에서 어드바이저 순서대로 실행됩니다.
AOP의 흐름은 이정도로 정리할 수 있을 것 같습니다.
AOP의 어드바이저 순서
어드바이저는 @Before, @Around, @After, @AfterReturning, @AfterThrowing 이렇게 다섯개가 있는데 실행 순서는 다음과 같습니다.
• @Before 실행
• @Around 실행 (proceed 실행 전)
• 메서드 실행
• @AfterReturning / @AfterThrowing (이 두개는 메서드가 실행되고 정상작동한다면 @AfterReturning, 에러가 발생한다면 @AfterThrowing이 실행됩니다.)
• @Around 실행 (proceed 실행 후)
마치며
이번 포스팅에는 코드는 생략하도록 하겠습니다. 코드가 너무 많아서 여기에 적기시작하면 끝이 없을 것 같습니다. 하지만 이번에 개발한 AOP를 하나하나 뜯어보면서 정말 많은 공부가 된 것 같습니다.
오늘 포스팅을 끝내고 AOP 프레임워크의 아키텍처를 그려보면서 다시 복습해서 아키텍처 프로젝트에 업로드할 예정입니다.
혹시 순수 자바로 Spring 프레임워크를 만들어보고 싶으신 분들은 cursor에 context7이라는 mcp붙여서 해보시면 편하게 라이트버전으로 만들어주니까 개발된거 하나씩 뜯어보면서 공부하면 많은 도움이 될 것 같습니다.
이번 포스팅은 여기서 마무리 짓도록 하겠습니다. 긴 글 읽어주셔서 감사합니다. 오늘도 즐거운 하루되세요~
순수 자바로 @Transactional 구현하기
이번 포스팅에선 Spring의 @Transactional를 깊이있게 파헤쳐보고 정리해보도록 하겠습니다. 코드는 깃허브를 참고해주시면 감사하겠습니다. 코드는 웬만하면 적지 않을 예정입니다. 제 블로그 포스팅은 기본적으로 코드를 되도록 적지 않는데 그 이유는 코드가 많아지면 설명해야할게 많아지고 그럼 가독성이 떨어진다고 생각하기 때문입니다.
또한, 저도 공부하면서 포스팅을 수백개 봤지만 사실 코드를 잘 안봅니다... 그리고 깃허브를 들어가서 실제 코드를 보면 아시겠지만 변수명과 함수명이 실제 스프링 프로젝트와 다른 부분이 있습니다. 그 이유는
• 실제 스프링 프로젝트는 훨씬 더 복잡한 계층 구조와 다양한 팩토리 클래스를 가지고 있습니다. 그래서 제 프로젝트는 최대한 가볍게 만들기 위해서 변수명을 조정했습니다.
• 사실 코드는 별로 중요하지 않다고 생각하고 흐름만 공부하면 좋겠다고 생각했습니다.
• AI의 도움을 받긴 했지만 커서와 같은 AI는 도움만 주었고 실제 코드 작성은 제가 하는 편입니다. 그 중에서 AI가 적어준 변수명보다 제가 이해하기 편한 변수명을 사용한 것도 있습니다.
https://github.com/garlicpollpoll/springlite
이제 본격적으로 시작해보겠습니다.
순수 자바로 @Transactional 구현하기
Spring에서는 트랜잭션을 굉장히 세밀하게 관리합니다. 일반적인 동작 방식은 기존 AOP의 구조에 대한 학습이 선행되어있다면 크게 어렵진 않지만 조금씩 변수가 생기면 복잡해지는 것 같습니다.
일단 기본적인 구조와 흐름도로 정리하고 예외상황에 대해서 살펴보도록 하겠습니다.
@Transactional 구조
@Transactional은 크게 다섯가지로 구분됩니다.
• TransactionAspect : @Transactional이 붙어있는 메서드를 AOP를 이용해서 실행하는 역할을 합니다. 우리가 구현한 AOP에서 사용하는 어노테이션들이 사용됩니다.
• TransactionDefinition : @Transactional 어노테이션에 붙어있는 값들 (isReadOnly, propagation 등) 을 가져오는 역할을 합니다.
• TransactionManager : commit, rollback등 실제 트랜잭션이 실행되는 로직을 담고 있습니다.
• TransactionStatus : 트랜잭션에 대한 정보를 가지고 있는 클래스입니다. 해당 클래스에 Connection이 안전하게 보관되고 있습니다.
• TransactionException : 실제 롤백에 사용될 트리거인 예외입니다. 이 예외가 감지되면 롤백하는 것으로 간주합니다.
여기서 가장 중요한 클래스는 아무래도 TransactionManager와 TransactionAspect가 아닐까 싶습니다. TransactionAspect에서 AOP가 적용되는데 이 AOP를 기반으로 REQUIRES_NEW 전파단계도 처리할 수 있기 때문입니다.
TransactionManager는 사실 스프링에선 여러개의 구현체를 가지고 있지만 저는 JdbcTemplate을 사용할 것이기 때문에 JdbcTransactionManager를 구현했습니다.
TransactionManager는 전파 단계에 따라 다른 로직을 타기 때문에 이는 이 뒤의 섹션에서 다루도록 하겠습니다.
@Transactional 흐름도
@Transactional의 흐름도 이전 AOP와 마찬가지로 단순화해서 제가 이해하기 편한대로 정리해보도록 하겠습니다.
전파 단계가 REQUIRED인 경우 (디폴트)
• 메서드 호출
• AOP 프록시가 인터셉트
• 기존 트랜잭션이 있는지 확인 ( getTransaction() )
있으면 기존 트랜잭션에 편입
• 없으면 새로운 트랜잭션 생성 (setAutoCommit(true)를 호출 -> 원자성 / isolation 설정 -> 격리성)
• 트랜잭션 안에 모든 로직이 실행되다가 예외 터지면 롤백 -> 일관성
• 모든 로직 실행 후 commit 호출 -> 내구성
이렇게 트랜잭션의 ACID를 모두 만족하게 됩니다.
전파 단계가 REQUIRES_NEW인 경우
• 메서드 호출
• AOP 프록시가 인터셉트
• 기존 트랜잭션이 있는지 확인 ( getTransaction() )
있으면 현재 트랜잭션을 삭제하고 새로운 트랜잭션을 생성 (기존 트랜잭션은 스택에 보관, Connection도 새로 생성)
• 로직 실행 후 성공하면 커밋, 실패하면 롤백
• 현재 트랜잭션 삭제 후 스택에서 pop한 트랜잭션을 현재 트랜잭션으로 세팅
• 기존 로직 이어서 실행
• 트랜잭션 안에 모든 로직이 실행되고 예외 터지면 롤백
• 모든 로직 실행 후 commit 호출
@Transactional과 ThreadLocal
트랜잭션이 REQUIRES_NEW에 의해 새로 생성될 때 기존 트랜잭션을 잠깐 옆으로 밀어두고 새로운 트랜잭션을 실행시켜야 하기에 스프링에서는 내부적으로 ThreadLocal을 사용합니다.
위에서 스택에 보관, 삭제후 세팅 이런 것들이 전부 ThreadLocal에서 이루어지고 있던 것이죠.
ThreadLocal은 현재 스레드가 바라보고 있는 포인터로서 이 값을 변경해주고 재활용하면 현재 스레드가 어떤 트랜잭션을 바라보고 메서드를 실행해야하는지 알 수 있습니다.
private static final ThreadLocal<TransactionStatus> currentTransaction = new ThreadLocal<>();
// REQUIRES_NEW를 위한 중단된 트랜잭션 스택
private static final ThreadLocal<Stack<TransactionStatus>> suspendedTransactions = new ThreadLocal<>();
이렇게 두 종류의 ThreadLocal을 사용하고 순서는 흐름은 다음과 같습니다. A트랜잭션이 B트랜잭션을 호출하고 B는 REQUIRES_NEW로 되어있다고 가정해보겠습니다.
• currentTransaction을 A트랜잭션으로 생성
• currentTransaction.get()으로 A트랜잭션 가져와서 A메서드 실행
• B트랜잭션이 등장
• currentTransaction.remove()로 현재 트랜잭션 삭제 후 suspendedTransactions.set(stack.push(A트랜잭션)) 이렇게 잠시 밀어둠
• currentTransaction.set(B트랜잭션) B트랜잭션으로 세팅
• B메서드 실행 후 종료
• currentTransaction.remove() 로 B트랜잭션 삭제
• suspendedTransactions.get() 으로 스택가져온 뒤 stack.pop으로 트랜잭션 꺼내기
• currentTransaction.set(pop한 트랜잭션) 잠깐 밀어뒀던 A트랜잭션 가져오기
• A메서드 마저 실행
여기서 제가 궁금했던 것은 A트랜잭션을 스택으로 관리해서 가져온다고해서 어떻게 로직까지 같이 돌아갈 수 있을까? 였는데요.
AOP에서 JoinPoint로 메서드가 어디서 실행될지 정했던 거 기억하시나요?
JoinPoint를 설정해주고 메서드를 마저 실행하면 어차피 getTransaction() 메서드는 현재 트랜잭션인 currentTransaction을 바라보고 있기 때문에 A트랜잭션을 가져와서 무사히 메서드를 마저 실행시킬 수 있는 것입니다.
REQUIRES_NEW의 롤백 전략
만약 우리가 methodA에서 methodB를 호출했는데 methodB가 REQUIRES_NEW인 경우에 methodB에서 예외가 발생하면 어떻게 될까요?
보통 REQUIRES_NEW로 methodB를 설정했다는 것은 methodA와 다른 격리된 트랜잭션을 사용하고 싶어서일 것인데요.
그럼 우리는 여기서 methodB만 롤백되고 methodA는 그대로 커밋되는 것을 기대해볼 수 있습니다.
하지만 상황은 그렇게 흘러가지 않습니다.
methodB에서 예외가 터진 것이 A로 전파되면서 UnexpectedRollbackException이 터지고 rollbackMarked가 되어 methodA에서도 롤백이 됩니다.
이 때문에 methodA는 커밋, methodB는 롤백을 원한다면 이 방법을 쓰면 됩니다.
• methodA에서 try / catch로 예외를 잡는다.
methodA에서 예외를 잡아버리면 methodB에서 전파된 예외가 처리되면서 methodB는 정상적으로 롤백, methodA는 예외를 처리했으므로 커밋이 되게 됩니다.
만약 methodB에서 잡으면 어떻게 될까요?
methodB에서 예외를 잡으면 methodB에서도 rollbackMarked가 되지 않아 methodB도 커밋이 됩니다.
하지만 이런 경우 REQUIRES_NEW로 선언하지 않겠죠? 어차피 한몸처럼 움직일거면 REQUIRED를 할테니까요.
위의 내용에 대해 예시와 함께 자세히 기술한 포스팅이 아래의 링크에 정리되어있습니다. 참고해보시면 좋을 것 같습니다.
https://coding-review.tistory.com/541
마치며
기존 스프링을 공부할 때도 제가 가장 깊이있게 공부했던 것이 바로 @Transactional이었는데요. 이번에 직접 구현하면서 클래스를 하나하나 뜯어보니 옛날 생각도 나고 많은 공부가 되었습니다.
이정도로 깊이있게 클래스를 뜯어가면서 공부한 적은 없었지만 동작방식이라던가 예외 전략같은 것들을 미리 공부하고 보니 감회가 새롭네요.
다음 포스팅은 아마 @Valid와 @ExceptionHandler가 될 것같습니다. 다시 MVC로 돌아가서 한번 불태워보도록 하겠습니다.
오늘 포스팅은 여기서 마치도록 하겠습니다. 긴 글 읽어주셔서 감사합니다. 오늘도 즐거운 하루 되세요~
캡스톤 디자인 : 간단한 홈쇼핑 만들기 (개요)
티스토리 카테고리 아래 카테고리를 또 나눌 수 있다는 것을 오늘에서야 알았다.(머쓱..) 이미 앞선 카테고리들은 망했으니까 지금이라도 잘 써야겠습니다. (추후에 정리할듯..?)
시작하기전에
Q. 캡스톤 디자인이란?
A. 그냥 졸업 작품입니다. 학교에서도 졸업 작품을 좀 멋드러지게 표현하고 싶었나봅니다.
시작하기 전에 (2)
Q. 좋은 포트폴리오란 무엇일까요?
A. 저같은 애송이가 답변하긴 좀 뭣하지만... 좋은 포트폴리오는 제 생각에 스토리가 있는 포트폴리오라고 생각합니다. 그 이유는 너무 길어서 생략하겠습니다. 스토리라함은 내가 어떤 문제가 있어서 혹은 세간에 어떤 문제가 있어서 그것을 해결하는 프로젝트를 만드는 것입니다.
예를 들어서 내가 뭘 하다가 음...이게 있으면 좋을거같다. 해서 만드는 포트폴리오를 가장 베스트로 꼽습니다. 그런 의미에서 제가 적을 캡스톤은 그런 포트폴리오냐? 제목을 보면 아시겠지만 아닙니다. 그냥 어디에나 있는 홈쇼핑을 참고했습니다.
시작하기 전에 (3)
Q. 왜 다른 캡스톤 디자인에는 제작 과정이 있는데 이것만 없나요?
A. 제가 이 캡스톤을 진행할 때만 하더라도 블로그에 캡스톤 제작 과정을 올려야겠다. 라는 생각 자체가 없었습니다. 해당 캡스톤을 다 만들고 나서야 아 올릴걸 그랬다. 싶어서 올리는 포스팅입니다.
시작하기 전에 (4)
Q. 온라인 쇼핑몰이면 이미지는 어떻게 하셨나요?
A. 무신사측에 전화해서 이미지를 사용해도 되냐고 물어보고 퍼왔습니다. 배포해서 수익만 창출하지 않으면 된다고 해서 로컬호스트에서 작업하고 영상으로 대체했습니다.
각설하고 시작하겠습니다.
1. 프로젝트 개요
실제로 제출한 프로젝트의 개요에 여러가지 요소가 있고 설명이 있지만 말만 되게 써놓은거지 사실 이 프로젝트를 선택한 이유는 할만한 주제를 선택하지 못했기 때문입니다. 그냥 뭐하지..? > 할게 없네 > 온라인 쇼핑몰이나 하자 이런 흐름에서 만든거라 개요는 딱히 없습니다.
2. 구현에 사용한 기술
IDEA : IntelliJ, VS code
프론트엔드 : html, css, javascript
백엔드 : Springboot, Gradle
DB : MySQL
ORM : Spring Data JPA
보조기술 : 부트스트랩
3. 영상
영상이 두개인 이유는 아주 간단합니다. 첫번째 찍었던거에서 까먹은게 있어서 다시 찍었을 뿐입니다.
Q. 그럼 편집을 하시지 왜 따로 올리시나요?
A. 그게... 귀찮아서... (꾸벅 _ _)
온라인 홈쇼핑 ver.2 (개요)
유튜브를 보다가 시니어 개발자분들이 나와서 얘기하는 것 중에 Version 2 를 만들어봐라 시간이 된다면 3, 4 이렇게 점진적으로 고도화시켜봐라 그것이 반드시 도움이 될것이다 라는 얘기를 들었습니다.
ver.2 를 만들기 위해서는 어느정도 큰 규모의 서비스여야 한다고 생각이 들어서 제가 만든 프로젝트 중에 가장 규모가 큰 온라인 홈쇼핑을 ver.2로 만들기로 했습니다.
기존 ver.1 에서의 문제점을 분석하고 해결할 수 있는 기술을 공부하고 테스트하고 적용하기까지의 블로그 포스팅이 될 것 같습니다.
우선 제가 분석한 제 온라인 홈쇼핑 ver.1의 문제점은 다음과 같습니다.
• 인증, 인가에 Spring Security를 사용하고 있는데 추가적인 레이어가 필요할 것 같다 현재는 세션을 쓰고있음
• 데이터베이스에서 조회할 때 중복코드가 발견됨 (Member, User를 조회하는 코드) 데이터도 고정되어있고 캐싱을 사용하면 좋을 것 같음
• 로그인을 하고 다시 돌아오면 세션이 풀려버리는 상황이 발생 => Remember Me를 이용하면 될 것 같음
• MANAGER 등급이 상품을 업로드할 때 한땀한땀 상품을 업로드 해야함 = 대량으로 업로드하기 매우 불편함 => 엑셀을 업로드해서 엑셀에 있는 데이터를 한방에 넣는 방식으로 하면 좋을 것 같음 (이미지는 따로 넣어야하긴 함)
• 이메일을 보내서 사용자를 2차 인증하는 방식이 너무 느림 (SMTP가 동기 네트워킹이라 그런듯함) => 비동기 통신으로 바꿔주면 더 깔끔한 사용자 경험을 유도할 수 있음
일단 제가 생각한 문제점은 이정도인 것 같은데 추후에 더 생기면 추가적으로 업데이트 하도록 하겠습니다.
온라인 쇼핑몰 ver.2 (1) : Redis를 이용해 Session 과 Caching 적용하기
기존 프로젝트의 방식
• "누가"에 대한 데이터가 굉장히 많이 필요합니다.
• "누가" 장바구니를 담았는지, "누가" 좋아요를 눌렀는지, "누가" 결제를 했는지, "누가" 로그인을 했는지 등등...
• 총 42개의 API 중 66%에 해당하는 28개의 API에서 "누가"에 해당하는 데이터를 요청했습니다.
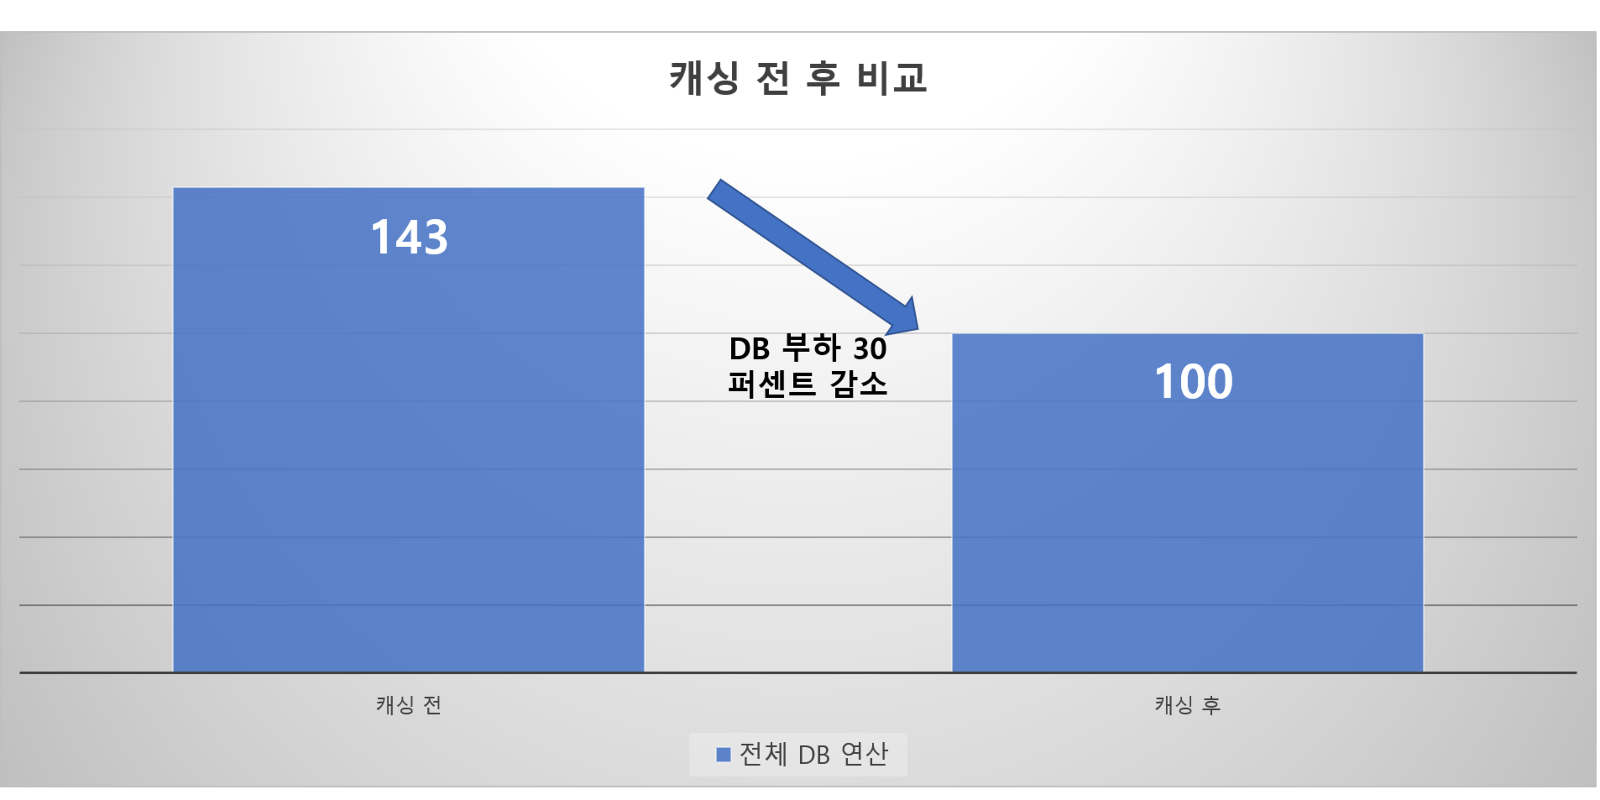
• 총 DB 연산 143개 중 약 30%에 해당하는 43개의 DB 연산이 "누가"에 해당하는 데이터를 요청합니다.
기존 프로젝트의 문제점
• 정적 데이터를 항상 DB에서 조회하기 때문에 조금만 트래픽이 몰리면 DB의 심각한 부하가 우려됩니다.
ver.2에서 개선한 문제점
• 정적 데이터이기 때문에 캐싱을 적용하면 좋겠다고 판단하였습니다.
• EHcache, Memcached, Redis 중 고민하였고 세션까지 분리할 수 있고 다양한 자료구조를 지원하는 Redis를 선택하게 되었습니다.
단순 세션 사용의 취약점
악의적인 사용자들은 취약 웹 애플리케이션에 직접 로그인하여 세션 ID를 발급받고 XSS 같은 교차 스크립트 공격을 병행하여 이메일을 열람 시 공격자의 세션 ID를 사용하여 서비승네 접근하도록 하면 사용자들은 공격자와 동일한 세션 ID를 사용하게 됩니다.
여기서 관리자 페이지나 기타 개인정보를 포함하고 있는 페이지를 사용할 경우 공격자는 자신의 페이지를 Refresh (F5) 하여 추가 정보를 획득하거나 사용자의 행세를 하게 됩니다.
XSS 공격에 의해 세션 아이디가 갈취당할 수 있다는 얘기이고 만약 더 높은 권한을 가진 사용자의 인가를 마음대로 이용한다면 인가되지 않은 사용자가 마구 날 뛸 수 있어서 조심해야 합니다.
XSS 공격을 방어하기 위해서는 방화벽을 이용할 수 없습니다. XSS를 막기 위해서 가장 중요한 것은 역시 입력값 검증입니다.
client side에서 검증과 server side에서의 검증이 모두 이루어져야 해결할 수 있습니다.
거기에 추가적으로 session을 httpOnly 에 담아둔다거나 session을 애플리케이션과 분리하는 작업을 거치면 더 안전하게 사용자를 보호할 수 있습니다.
이번 포스팅에선 session을 애플리케이션과 분리하는 작업을 통해 보안적으로 개선한 경험을 먼저 적도록 하겠습니다.
Session 과 Application을 분리해라
먼저 dependency를 추가합니다.
implementation 'org.springframework.session:spring-session-data-redis'
그리고 아래와 같이 적었습니다.
@SpringBootApplication
@EnableRedisHttpSession
public class CapstonApplication {
public static void main(String[] args) {
SpringApplication.run(CapstonApplication.class, args);
}
}
이렇게 시작이되는 IoC 컨테이너에 @EnableRedisHttpSession을 적어 세션을 애플리케이션과 분리했습니다.
이렇게 설정하면 WAS가 나뉘어진 로드밸런싱 상태의 애플리케이션에서 발생하는 문제인 각기 다른 WAS에서 다른 JSESSION이 설정된다는 문제도 해결할 수 있습니다.
거기다 session을 애플리케이션과 분리하여 XSS 공격에 간접적으로 도움이 됩니다.
캐싱으로 데이터베이스 부하를 줄여라
제 프로젝트인 온라인 쇼핑몰에선 특성상 "누가" 에 해당하는 객체가 굉장히 많이 필요합니다.
"누가" 장바구니에 물건을 담았는지, "누가" 어떤 상품에 좋아요를 눌렀는지, "누가" 결제를 했는지, "누가" 상품을 구매했는지 등등이 있습니다.
지금 위의 예시만 적었지 사실 굉장히 많은 곳에서 "누가"에 해당하는 객체가 필요했습니다.
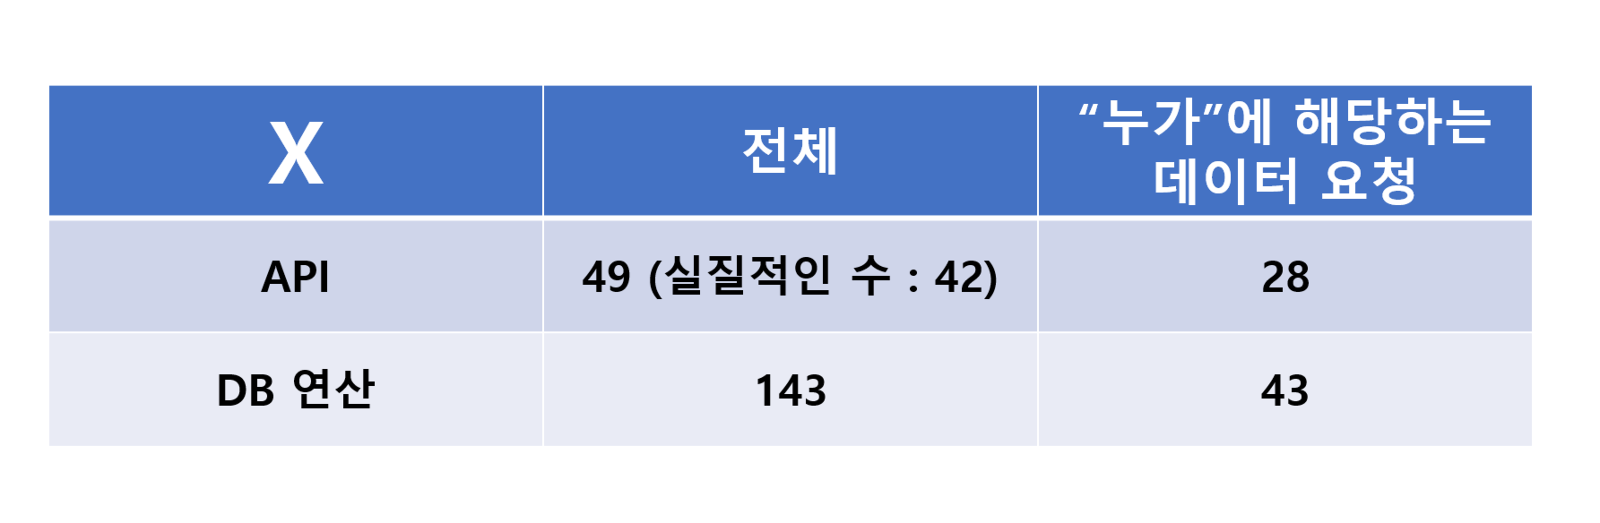
개수를 세어본 결과 총 49개의 API에서 28개의 API가 이 "누가"에 해당하는 데이터를 요청했습니다. 49개의 API중 7개는 단순 redirect API였기 때문에 따지고보면 42개의 API중 28개인 즉, 66퍼센트의 API에서 "누가"에 해당하는 데이터를 필요로 했습니다.
심지어 이 28개의 API에서 한번만 요청한 것도 아닙니다. 조회를 요청한 API에서 총 43번의 데이터베이스 쿼리 요청이 있었습니다. 이는 하나의 API에서 Member (일반 로그인), User (소셜 로그인) 둘 다 조회를 요구하는 API가 있었기 때문입니다.
이는 만약 사용자가 조금만 늘어나도 DB부하를 견디지 못할 것이라고 판단했습니다.
이러한 문제의 해결책으로 Redis를 이용한 캐싱을 선택했습니다.
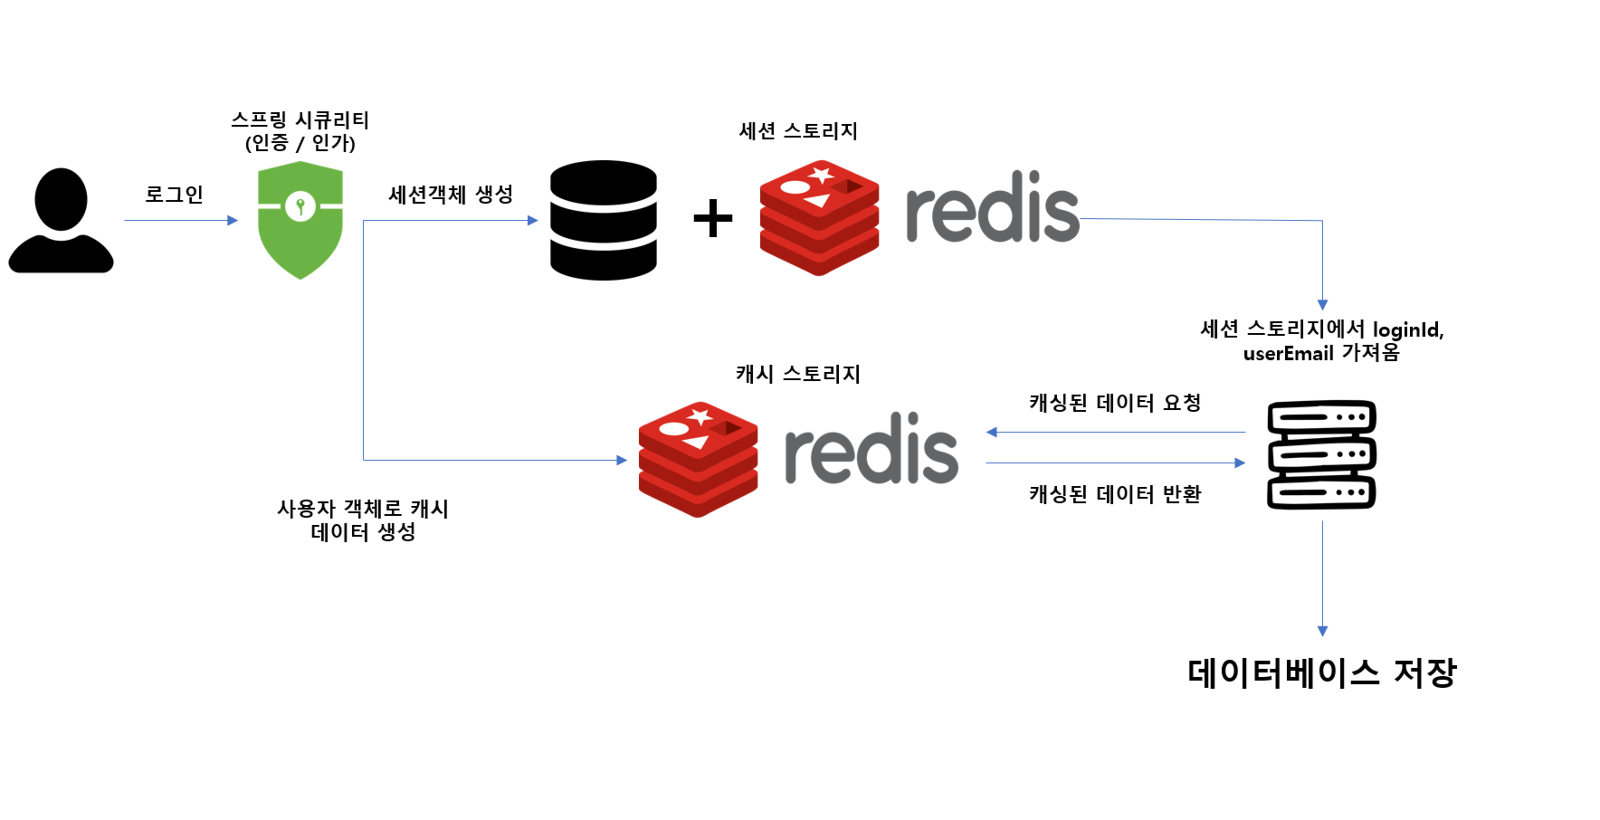
"누가"에 해당하는 Member와 User의 객체를 Redis 객체로 저장하고 API에서 해당 객체를 요청할 때마다 데이터베이스에 쿼리를 날리는 것이 아닌 캐싱된 데이터를 가져오게 만드는 것이 저의 과제였습니다.
그리고 저는 아래와 같은 설계를 위해 노력했습니다.
package com.hello.capston.repository.cache;
import com.hello.capston.entity.Member;
import com.hello.capston.entity.User;
import com.hello.capston.repository.MemberRepository;
import com.hello.capston.repository.UserRepository;
import lombok.RequiredArgsConstructor;
import org.springframework.data.redis.core.RedisTemplate;
import org.springframework.stereotype.Repository;
import java.util.concurrent.TimeUnit;
@Repository
@RequiredArgsConstructor
public class CacheRepository {
private final RedisTemplate<String, Object> redisTemplate;
private final UserRepository userRepository;
public void addMember(Member member) {
String key = KeyGenerator.memberKeyGenerate(member.getUsername());
if (!isMemberWasFound(member.getUsername())) {
redisTemplate.opsForValue().set(key, member);
redisTemplate.expire(key, 60, TimeUnit.MINUTES);
}
}
public void addUser(Long userId) {
User findUser = userRepository.findById(userId).orElseThrow(
() -> new RuntimeException("Not Found User")
);
String key = KeyGenerator.userKeyGenerate(findUser.getEmail());
if (!isUserWasFound(findUser.getEmail())) {
redisTemplate.opsForValue().set(key, findUser);
redisTemplate.expire(key, 60, TimeUnit.MINUTES);
}
}
public Member findMemberAtCache(String loginId) {
String key = KeyGenerator.memberKeyGenerate(loginId);
return (Member) redisTemplate.opsForValue().get(key);
}
public User findUserAtCache(String email) {
String key = KeyGenerator.userKeyGenerate(email);
return (User) redisTemplate.opsForValue().get(key);
}
private boolean isMemberWasFound(String loginId) {
Member findMember = findMemberAtCache(loginId);
if (findMember != null) {
return true;
}
return false;
}
private boolean isUserWasFound(String email) {
User findUser = findUserAtCache(email);
if (findUser != null) {
return true;
}
return false;
}
}
이렇게 CacheRepository를 만들어서 캐시를 관리하고
String logindId = (String) session.getAttribute("loginId");
String userEmail = (String) session.getAttribute("userEmail");
Member findMember = MemberService.findMemberWithLoginId(loginId);
User findUser = UserService.findUserWithUserEmail(userEmail);
위와같은 코드에서 아래와 같은 코드로 바꿨습니다.
String loginId = (String) session.getAttribute("loginId");
String userEmail = (String) session.getAttribute("userEmail");
Member findMember = cacheRepository.findMemberAtCache(loginId);
User findUser = cacheRepository.findUserAtCache(userEmail);
이렇게 Member와 User가 필요한 API에서 캐싱된 객체를 반환하도록 하였습니다.
이러한 해결책으로 데이터베이스 쿼리를 날리는 총 143개의 요청에서 43번의 쿼리를 캐싱으로 처리할 수 있었습니다. 이는 DB부하를 30퍼센트정도 줄일 수 있는 정도의 성능 개선이었습니다.
부수적으로 단순히 Member, User를 조회하기 위해 사용되었던 MemberService, UserService 두개의 의존관계에서 CacheRepository 하나만 의존관계를 맺음으로써 낮은 결합도를 유지하도록 설계하였습니다.
느낀점
Redis를 이용해 세션을 애플리케이션과 분리하고 캐싱을 통해 DB의 부하를 줄여주는 경험은 저에게 있어서 첫번째 성능개선 경험이었습니다.
실제로 성능이 30퍼센트가 개선된 것은 분명 아닐 것입니다. 다만 DB의 부하를 30퍼센트 줄였다는 것은 그에 못지않은 성능 개선을 이루어냈다고 봐도 무방할 것입니다.
또한, 처음 프로젝트를 만들 때 이런 것을 전혀 고려하지 않았다는 점에서 여러가지를 느끼게 되었습니다.
첫번째로 많은 개발자분들께서 말씀하시는 레거시 코드에서 "왜 이렇게 만들었지?" 라는 의문에 "그 당시에는 그것이 최선이었다" 라고 말씀하신 것이 어떤 느낌인지 알게 되었습니다.
두번째로 제 프로젝트는 현존하는 많은 애플리케이션에 미치지는 못하겠지만 어느정도 규모가 있는 프로젝트에서 문제점을 발견하고 개선한다는 것은 의미가 있는 작업이었습니다.
이번 ver.2 프로젝트를 통해 문제는 한번에 보이지 않는다는 것을 깨달았습니다. 두번 세번 여러번을 보고 고민해야 문제점을 개선할 수 있다는 것을 알게된 의미있는 프로젝트였습니다.
온라인 쇼핑몰 ver.2 (2) : SMTP 비동기 통신으로 바꾸기
기존 SMTP
• SMTP 는 stateful 프로토콜 + 동기 네트워킹입니다.
기존 방식의 문제점
• 이메일은 회원가입시 2FA로 이용됩니다. 회원 가입을 할 때 이메일을 보내면 이메일이 전송되는데 걸리는 시간인 3~4초 가량을 아무것도 할 수 없습니다.
• 이는 부정적인 유저 경험으로 이어질 우려가 있습니다.
ver.2에서 개선한 SMTP
• SMTP를 @Async 어노테이션으로 비동기 처리를 하였습니다.
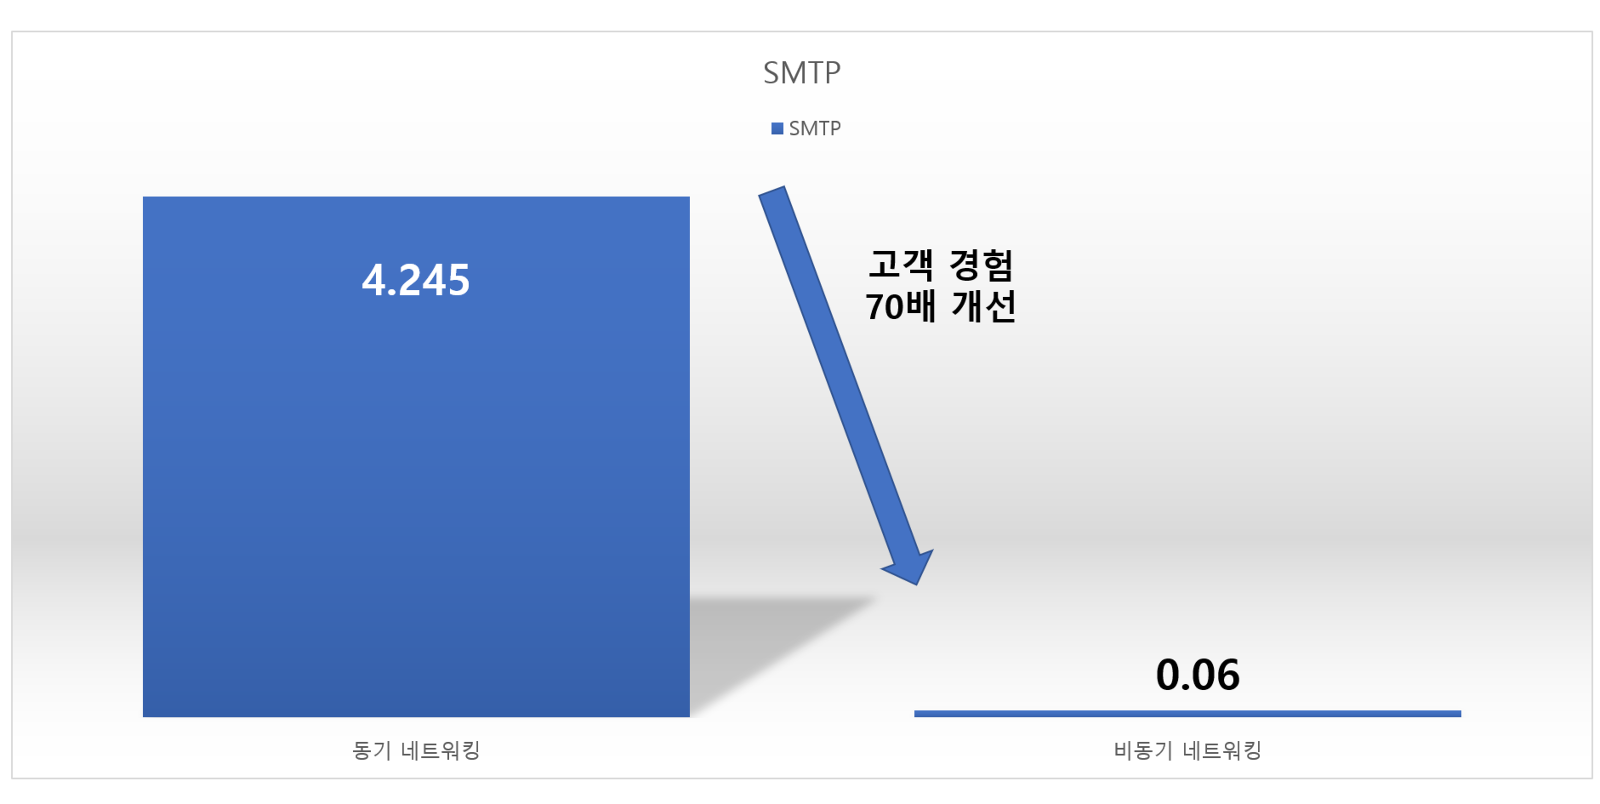
• 기존 방식대비 고객경험을 90배가량 개선할 수 있었습니다.
먼저 JavaMailSender를 빈으로 등록해줬습니다.
package com.hello.capston.config;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
import org.springframework.mail.javamail.JavaMailSender;
import org.springframework.mail.javamail.JavaMailSenderImpl;
import java.util.Properties;
@Configuration
public class JavaMailSenderConfig {
private String protocol = "smtp";
private boolean auth = true;
private boolean starttls = true;
private boolean debug = true;
private String host = "smtp.gmail.com";
private int port = 587;
private String username = "gmail 계정";
private String password = "패스워드";
private String encoding = "UTF-8";
@Bean
public JavaMailSender javaMailSender() {
JavaMailSenderImpl javaMailSender = new JavaMailSenderImpl();
Properties properties = new Properties();
// properties
properties.put("mail.transport.protocol", protocol);
properties.put("mail.smtp.auth", auth);
properties.put("mail.smtp.starttls.enable", starttls);
properties.put("mail.smtp.debug", debug);
// mail sender
javaMailSender.setHost(host);
javaMailSender.setPort(port);
javaMailSender.setUsername(username);
javaMailSender.setPassword(password);
javaMailSender.setJavaMailProperties(properties);
javaMailSender.setDefaultEncoding(encoding);
javaMailSender.setProtocol(protocol);
return javaMailSender;
}
}
@Async를 위한 서브 스레드를 만들어줬습니다. 서브 스레드는 AsyncConfigurer를 구현한 Configuration 클래스입니다.
package com.hello.capston.config;
import lombok.extern.slf4j.Slf4j;
import org.springframework.aop.interceptor.AsyncUncaughtExceptionHandler;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
import org.springframework.scheduling.annotation.AsyncConfigurer;
import org.springframework.scheduling.annotation.EnableAsync;
import org.springframework.scheduling.concurrent.ThreadPoolTaskExecutor;
import java.util.concurrent.Executor;
@Configuration
@EnableAsync
@Slf4j
public class AsyncConfiguration implements AsyncConfigurer {
@Override
@Bean(name = "mailExecutor")
public Executor getAsyncExecutor() {
ThreadPoolTaskExecutor executor = new ThreadPoolTaskExecutor();
executor.setCorePoolSize(2);
executor.setMaxPoolSize(5);
executor.setQueueCapacity(10);
executor.setThreadNamePrefix("MailExecutor-");
executor.initialize();
return executor;
}
@Override
public AsyncUncaughtExceptionHandler getAsyncUncaughtExceptionHandler() {
return (ex, method, params) -> {
log.error("Exception handler for async method : ", method.toGenericString(), " threw unexpected exception itself", ex);
};
}
}
이메일을 보낼 Service 클래스를 만들어줬습니다.
package com.hello.capston.service.email;
import lombok.RequiredArgsConstructor;
import org.springframework.mail.javamail.JavaMailSender;
import org.springframework.mail.javamail.MimeMessageHelper;
import org.springframework.mail.javamail.MimeMessagePreparator;
import org.springframework.scheduling.annotation.Async;
import org.springframework.stereotype.Service;
@Service
@RequiredArgsConstructor
public class MailService {
private final JavaMailSender mailSender;
@Async("mailExecutor")
public void sendMail(String to, String subject, String checkNum) {
System.out.println("[sendMail :: " + Thread.currentThread().getName() + "]");
MimeMessagePreparator messagePreparator = mimeMessage -> {
final MimeMessageHelper helper = new MimeMessageHelper(mimeMessage, true, "UTF-8");
helper.setFrom("[email protected]");
helper.setTo(to);
helper.setSubject(subject);
helper.setText(checkNum);
};
mailSender.send(messagePreparator);
}
}
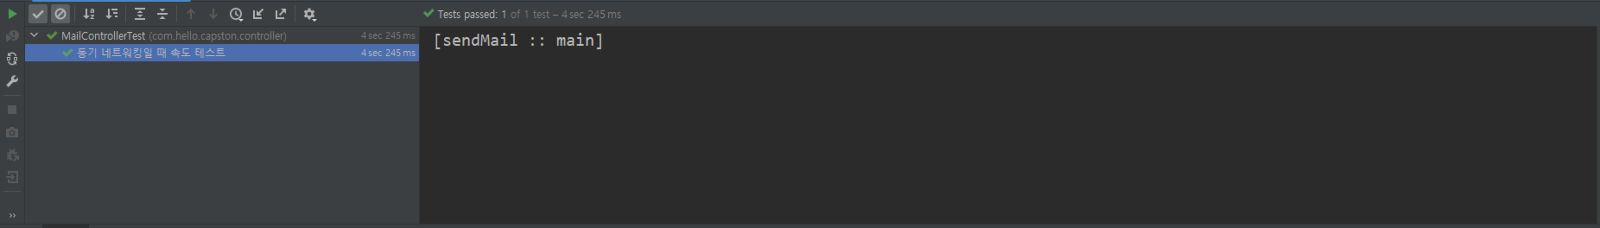
기존 SMTP가 동기 네트워킹으로 돌아가는 것을 확인했고 시간은 4.245초가 걸렸습니다.
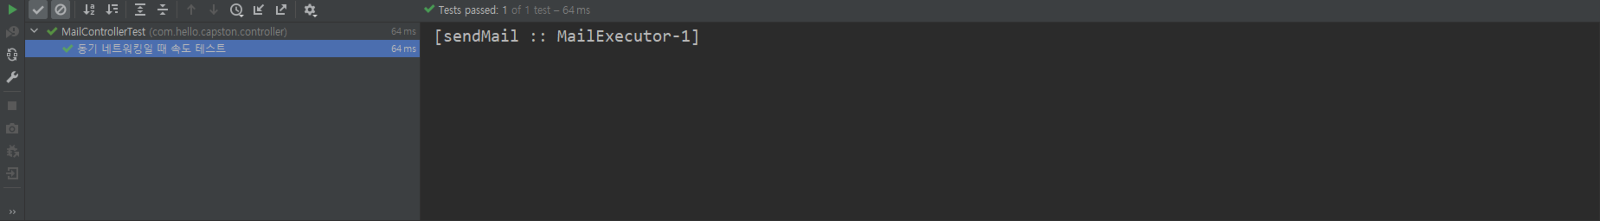
비동기 네트워킹을 처리하고 나서 제가 작성한 서브 스레드로 돌아가는 것을 확인했고 시간은 0.06초가 걸렸습니다.
느낀점
스프링에서 동기 네트워킹으로 작동하던 SMTP를 비동기 통신으로 바꾸면서 단순히 성능이 빨라지는 것만이 고객경험을 긍정적으로 바꾸는 것이 아니라는 것을 깨달았습니다.
동기 네트워킹으로 작동하던 것을 비동기 네트워킹으로 바꾸는 것은 개발자 입장에선 조금 불편하지만 고객의 입장에선 정말 속도가 빠른 것을 체감하는 긍정적인 경험으로 이어진다는 것을 보며 고객의 경험을 우선시해야하는 개발자로서 더 노력해야 한다는 것을 알게되었습니다.
온라인 쇼핑몰 ver.2 (3) : JWT 토큰으로 인증 레이어 추가하기
기존 인증 방식
• 스프링 시큐리티에 100퍼센트 의존하는 방식이었습니다.
• 스프링 시큐리티는 웹 세션으로 동작합니다.
기존 인증 방식의 문제점
• 추후에 MSA로 변경하는 과정에서 필요한 stateless한 인증 방식이 필요했습니다.
ver.2에서 개선한 인증 방식
• 스프링 시큐리티의 Authentication 객체를 이용해 JWT를 만들어 회원 인증에 사용했습니다.
• 인증 레이어를 기존 스프링 시큐리티 하나에서 JWT를 추가해 두개의 인증 레이어를 사용할 수 있었습니다.
• 스프링 시큐리티에 100퍼센트 의존했으면 구현할 수 없었던 OAuth 의 Remember-me 기능을 JWT를 이용해 구현할 수 있었습니다.
JWT로 인증 추가
0. 고민
사실 이 프로젝트를 진행할까 말까 수많은 고민이 오갔습니다.
이미 인증으로 스프링 시큐리티를 사용하고 있는데 새로운 인증이 필요할까가 우선 걱정되었습니다.
어떤 포스팅의 댓글에서 JWT인증 정말 좋지만 구현하기 까다롭고 유지보수에도 스프링 시큐리티를 단독으로 사용하는 것보다 떨어질 수 있다. 라는 글을 보고 더 의욕이 꺾였습니다.
또한 JWT를 인증에 사용한다는 것은 세션을 기반으로한 인증을 사용하지 않겠다는 것을 의미하는데 스프링 시큐리티가 HTTP Session을 기반으로 작동한다는 사실을 알고 더 고민했습니다.
1. Chat GPT
이 고민을 챗지피티한테 물어봤습니다. 역시라면 역시일까 GPT는 대단했습니다. 이런 제 고민을 한방에 뒤집어줬습니다.
GPT가 스프링 시큐리티와 JWT를 섞었을 때의 장점을 몇가지 말해주는데 하나하나가 묵직했습니다.
• stateless 한 인증 : JWT는 인증 정보를 그 안에 가지고 있는 내장된 토큰이기 때문에 서버가 유저의 인증을 위해 server-side에서 기록들을 유지하거나 세션을 유지할 필요가 없습니다. 동시에 시스템을 무상태로 유지할 수 있죠. 이 상황은 특히 애플리케이션을 확장할 때 굉장히 유용한데 그 이유는 공유하고 있는 세션 스토리지를 제거할 수 있기 때문입니다.
• 마이크로서비스 준비 : 마이크로서비스 아키텍처에서 유저는 다양한 서비스에서 인증할 필요가 있습니다. JWT를 사용하면 유저가 한번 인증하고 토큰을 생성하면 이 토큰은 다음 요청을 인증하기위해 사용될 수 있습니다. 이것은 인증을 구현하기위해 각각의 마이크로서비스들을 만들 때 필요성이 완화될 것입니다.
• 성능 : 서버가 세션을 유지할 필요가 없어진다면, 각각의 요청에서 세션 정보를 찾을 필요가 없습니다. 이는 단순히 토큰이 유효한지 검증하기 위해 토큰의 신호를 받기만 하면 된다는 의미입니다.
• 모바일 친화적 : JWt는 다른 도메인에서 같은 방식으로 동작합니다. 그래서 다른 디바이스나 다른 도메인으로부터의 요청을 핸들링하기 더 쉽습니다. 이는 특히 모바일 애플리케이션을 구현할 때 더 두드러집니다.
• 세분화된 Access Control : JWT는 유저의 특정한 정보나 허가를 가지고 있을 수 있습니다. 이는 세분화된 접근 컨트롤을 할 수 있게 해줍니다. 이러한 방식은 유저가 접근할 수 있는 실행이나 자원을 인가하는데 유용하게 사용될 수 있습니다.
• CORS 지원 : JWT는 RESTful API에 잘 맞게 만들면서 CORS 정책을 잘 준수합니다. 그리고 그곳에서 AJAX요청이 다른 도메인으로부터 만들어질 때 유용합니다.
• 스프링 시큐리티 통합 : 스프링 시큐리티는 자바 애플리케이션을 위한 포괄적인 보안 방법들을 제공합니다. 이는 유연하고 커스텀하기 쉬운데 우리가 스프링 시큐리티에서 JWT를 사용하게 된다면 우리는 session fixation이나 clickjacking이나 XSS공격과 같은 것을 처리할 때 이점이 있습니다.
이 중 마이크로 서비스 준비가 제 맘에 와닿았습니다. 저는 이 프로젝트를 단순한 성능 개선을 넘어 CI/CD와 이후 마이크로서비스까지 도전해볼 생각이기 때문입니다.
2. 험난한 과정
저는 JWT를 말로만 들었지 직접 구현할 것이라고는 생각도 못했습니다. 그래서 그랬던 것일까요 정말 힘들었습니다.
제가 참고한 코드의 성질이 저와 완전히 달라 그대로 작성하면 땡치는 그런 구조가 아니었습니다.
그나마 최근에 Redis를 이용해 캐싱을 구현해본 것이 큰 도움이 되었습니다.
거의 모든 것을 제가 손수 커스터마이징 해야 했습니다. 뼈대는 다른 사람이 만든 코드를 기반으로 했지만 제 프로젝트에 알맞은 기술로 정착시키기 위해서는 뼈를 깎는 노력이 필요했습니다.
2-1. 저는 프론트는 모릅니다만...
제가 참고한 코드는 프론트와의 통신을 기본으로 깔고 들어갔습니다. 때문에 제 프로젝트와 결이 많이 달랐습니다. 저는 프론트의 ㅍ자도 모르는 사람이었기 때문에 특히 리턴타입을 제 프로젝트에 맞게 고치는 일이 허다했습니다.
2-2. header로 토큰 검증 그거 어떻게 하는건데
참고한 코드는 Authorization 헤더에 토큰을 유지하는 방식을 사용하고 있었습니다. 하지만 프론트에선 가능할지 몰라도 server-side에선 Authorization 헤더를 추가할 수 없다는 충격적인 사실을 알아버렸습니다.
때문에 저는 기존 헤더에 토큰을 유지하는 방식에서 쿠키에 유지하는 방식을 선택했습니다.
2-3. 쿠키가 안보입니다?
제 개인적인 생각이지만 쿠키와 세션은 기본적으로 갈취된다고 가정하고 코딩을 하는 것이 속편했습니다. JWT토큰같은 경우는 갈취당했을 때 답이 없기 때문에 단순히 쿠키에 토큰을 넣으면 정말 위험합니다.
그래서 제가 참고한 코드에선 헤더에 담아서 보관한 것이겠지요.
그래서 저는 HttpOnly 내부에 쿠키를 두기로 결심했습니다. 하지만 쿠키가 안보이더군요.
몇시간을 삽질 끝에 ResponseCookie라는 객체를 스프링에서 지원해주고 거기서 path(), sameSite(), httpOnly(), secure()과 같은 설정을 할 수 있었습니다.
2-4. 저기요 OAuth는요..?
제가 참고한 코드는 로그인 폼 기반 인증을 기반으로 두고 있습니다. 때문에 OAuth도 같이 사용하는 제 프로젝트에선 OAuth에 대한 추가적인 인증이 필요했습니다.
정말 막막했습니다. 기존 문제들은 뼈대에서 조금씩 변형하면 해결됐지만 이젠 진짜 없는걸 만들어야 했습니다.
기존에 남들이 만든 코드를 복붙하고 제가 원하는 방향대로 조금씩 수정하던 방식과는 전혀 달랐습니다.
하지만 이 때 스프링 시큐리티의 동작 원리에 대한 전반적인 이해가 엄청난 도움이 됐습니다.시큐리티 코드를 하나씩 디버깅해보며 어떤 클래스를 상속하거나 구현할지 고민했습니다.
처음엔 Filter를 커스텀하게 만들까 고민했습니다. 때문에 OAuth2LoginAuthenticationFilter와 그 부모인 AbstractAuthenticationProcessingFilter가 후보대상이었습니다.
하지만 필터는 인증이 되기 전에 작동하는건데 과연 인증된 값으로 쿠키를 만들 수 있을지 의문이 들었습니다.
우선 인증과정이 모두 끝나야 쿠키를 만들던 Redis에 RefreshToken을 만들건 할 것 같았습니다.
때문에 모든 인증이 끝나고 작동하는 SuccessHandler를 이용하기로 결정했습니다. 다행히 제가 찾고있던 인터페이스가 있었습니다. 바로 AuthenticationSuccessHandler였습니다.
이 핸들러를 구현하고나니 OAuth에대한 인증을 끝마칠 수 있었습니다.
3. 결론 (느낀점)
이번 경험은 저에게 정말 뜻깊은 경험이었습니다. 제가 드디어 제가 생각하던 개발자와 조금 가까워진 기분이 들었기 때문입니다.
제가 개발 공부를 막 시작했을 때는 나만의 코드에 대한 집착이 강했습니다. 때문에 구글링해서 코드를 복붙하는 것을 부끄러워했습니다.
주변 지인들은 복붙해서 나만의 것으로 커스터마이징 하는 것도 실력이 없으면 할 수 없는 것이라고 위로해줬지만 저는 코드를 직접 만들고 싶었습니다.
마치 그림을 그리는 사람들이 모작을 하는 것이 아니라 나만의 그림, 나만의 그림체, 나만의 캐릭터를 갖는 것을 원하듯이 말이죠.
이번 프로젝트에선 나만의 코드를 만들 수 있었습니다. 상속, 인터페이스 구현을 적극 사용해서 드디어 제가 생각하던 개발자에 조금 더 다가간 기분이었습니다.
JWT를 이용한 인증 레이어 추가 프로젝트가 모두 끝났을 때 정말 날아갈 듯이 기뻤습니다. 이번 프로젝트에선 느리던 것이 빨라진 것도 아니고 DB 부하를 줄여준 것도 아니었습니다.
사실 기존에도 잘 돌아가던 인증 체계를 커스텀하게 만든 것 뿐이었습니다.
하지만 나만의 코드를 만들었다는 그 기분은 제 개발공부 인생 최고의 자랑거리이지 않을까 싶습니다.
4. 이후 개선해야할 점
이후에 개선되어야할 점은 동시성문제입니다.
기존 프로젝트에 결제 로직쪽에서 동시성 문제가 확인되었습니다. 저는 이 부분을 synchronized 키워드를 가지고 해결했습니다.
이 프로젝트를 마치고 한참 뒤에 프로세스 동기화에 대해서 공부할 때쯤 동기화에는 뮤텍스와 세마포어가 있다는 것을 공부하게 되었습니다.
제가 구현한 것은 뮤텍스였죠.
하지만 이용자가 많아지면 뮤텍스 방식은 한계가 있을 것이라고 판단했습니다. 때문에 프로세스 동기화를 공부하자마자 저는 기존 뮤텍스방식의 제 프로젝트를 세마포어 방식으로 바꿔봐야겠다는 생각이 들었습니다.
다음 포스팅은 아마도 뮤텍스에서 세마포어로 바꾸는 작업을 진행할 것 같습니다. 긴 글 읽어주셔서 감사합니다.
온라인 쇼핑몰 ver.2 (4) : 동시성 문제 해결하기
기존 동시성 문제
• 기존에도 동시성 문제가 발생한다는 것을 느낌적으로 알아차렸습니다.
• 이에 Synchronized 키워드를 이용해 동시성 문제를 해결했습니다.
기존 동시성 문제의 문제점
• Synchronized 키워드는 다른 동시성 문제를 해결하는 방법보다 성능상 좋지못합니다.
ver.2에서 개선한 동시성 문제
• JPA의 특징 때문에 Synchronized 키워드는 어울리지 않는다고 판단하여 JPA와 어울리는 낙관적 락 / 비관적 락 중 하나를 선택하였습니다.
우선 테스트 코드를 통해 "동시성 문제가 발생합니다" 라고 증명하는 것부터가 문제였습니다.
그 때 마침 "단위 테스트" 라는 것에 꽂혀서 어디선가 DB를 불러오는 단위 테스트는 안티 패턴이다 라는 말이 생각났습니다. 그래서 Mock 객체를 이용한 단위 테스트에 대해 공부했습니다.
Mockito 프레임워크에 대해 공부하게 되었고 처음엔 조금 헤맸지만 이내 원리를 파악하고 곧잘 하기 시작했습니다. 하지만 단위 테스트를 작성하고 보니 문제가 생겼습니다.
'동시성 문제가 발생한다는 것을 단위 테스트로는 검증할 수가 없네..?'
어차피 Mock을 이용한 단위 테스트는 지금 하려는 동시성 문제를 해결하고 다음에 해야할 과제였기 때문에 좋은게 좋은거지 싶어서 넘어갔습니다.
이제 동시성 문제가 발생한다는 것을 테스트로 증명해야한다. 라는 과제는 저에게 큰 시련을 주었습니다. 우선 테스트 코드를 작성하는 것을 많이 해보지 않아서 쉽지 않았는데 거기다 동시성 문제를 검증한다니...
구글링을 통해 동시성 문제가 발생했고 해결했다는 포스팅을 미친듯이 검색해서 어떤 패턴이 동시성 문제를 일으키는지에 대해 공부했습니다.
제가 겪은 동시성 문제는 재고가 1개밖에 남지 않은 상황에서 동시에 두세개씩 요청이 들어오는 상황입니다.
단일 스레드로는 이를 클라이언트 사이드에서 막을 수 있었습니다. 결제를 할 때마다 재고가 남아있는지 확인하는 로직이 들어있기 때문입니다.
하지만 이런 상황은 굉장히 골치아팠습니다.
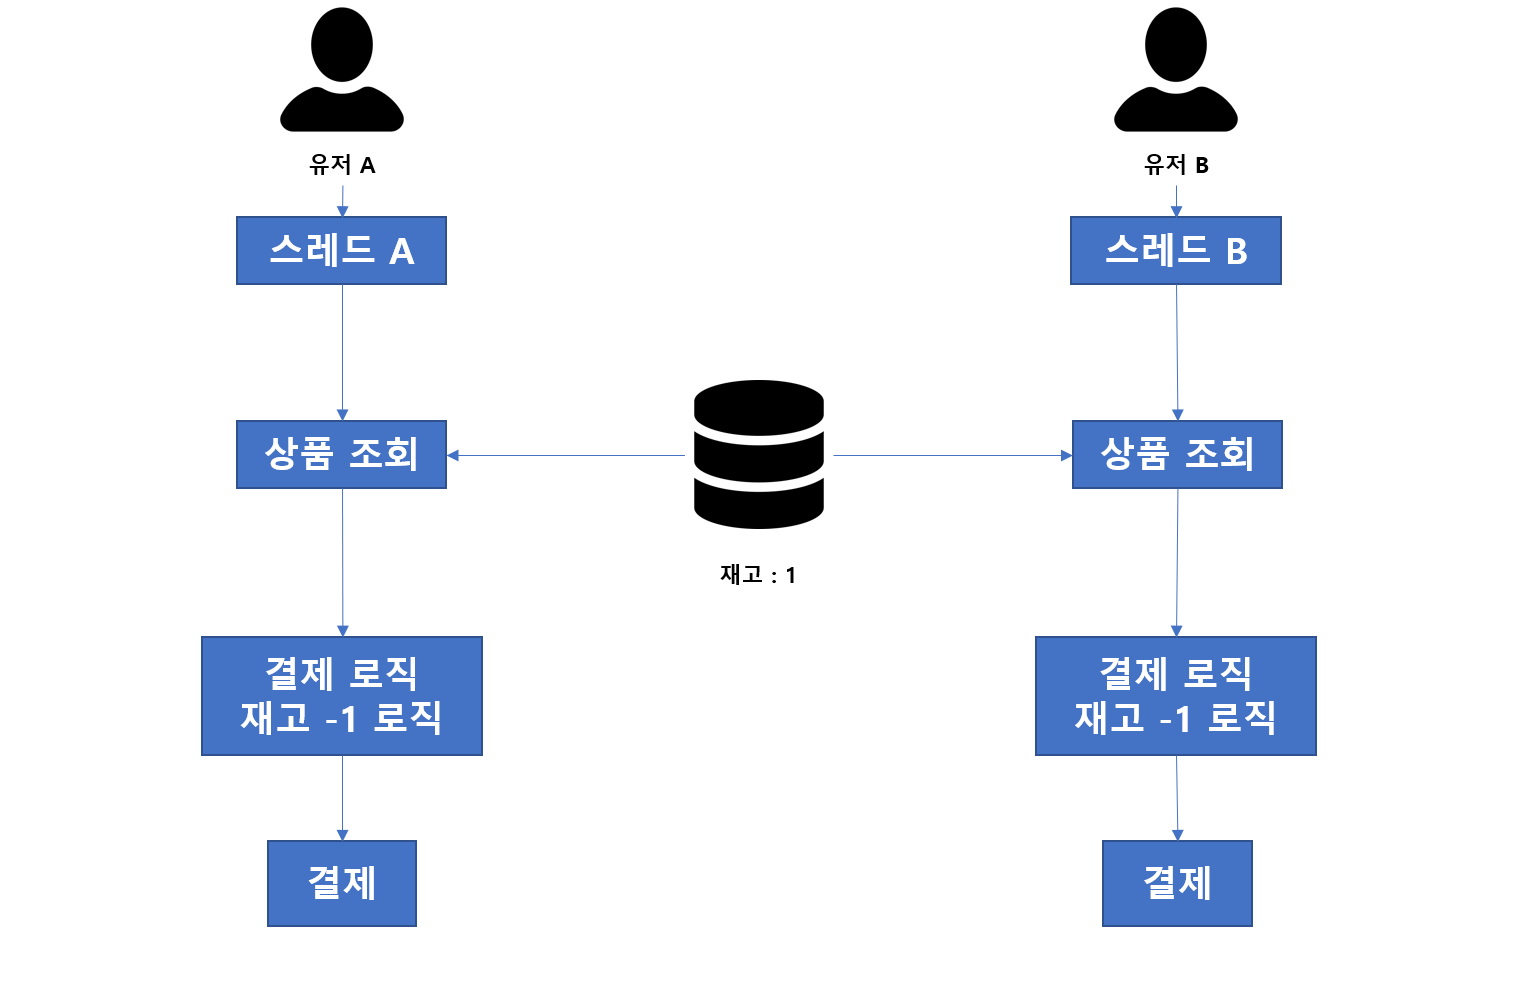
몇번의 고민 끝에 저와 같은 상황에서 동시성 문제를 해결하기 위해서는 세가지 방법이 존재했습니다.
• synchronized 키워드
• 데이터베이스 격리 수준을 Serializable로 격상
• 낙관적 락, 비관적 락
이 세가지에 대해서 알아보면서 기존에 알고 있던 CS 지식이 많은 도움이 됐습니다.
JPA 전파 단계, 데이터베이스 격리수준, 프로세스 동기화, 뮤텍스와 세마포어, 낙관적 락 / 비관적 락, 교착상태와 기아상태
다양한 분야가 제가 동시성 문제를 해결할 때까지 많은 도움이 되었습니다.
1. synchronized 키워드
synchronized 키워드만큼 동시성 문제를 간결하고 빠르게 해결할 수 있는건 없을 것입니다.
하지만 JPA는 기본적으로 각각의 스레드에 다른 트랜잭션이 부여되고 이 트랜잭션들은 ACID를 준수하며 데이터베이스 격리수준에 기반해 웬만해선 동시성 문제가 발생하지 않습니다.
때문에 데이터베이스 레벨에서 락을 걸던가 낙관적, 비관적 락을 사용하거나, 데이터베이스 격리수준을 격상하는 방법이 JPA를 사용한다면 조금 더 적합해 보였습니다.
2. 데이터베이스 격리 수준을 Serializable로 격상
이것도 고려해보고 테스트를 진행했지만 만족스럽지 못한 결과물이 나왔기 때문에 채택되지 못했습니다.
왜냐하면 기존 synchronized 로 동기화를 했다면 생각하지 않아도 되는 문제인 데드락이 발생했기 때문입니다.
물론 List를 sort()메서드를 이용해 정렬해서 락을 획득하는 우선순위를 정해주면 '국지적으로' 데드락이 발생하지 않는 사실을 알게 되었지만 어디까지나 국지적으로 데드락이 예방되기 때문에 채택하지 못했습니다.
또한 Serializable로 격상하는 것은 단순히 synchronized 키워드를 사용하는 것과 성능상 큰 차이를 보여주지 못했기 때문에 채택하지 못했습니다.
3. 낙관적 락, 비관적 락
낙관적 락과 비관적 락에 대해서 이론적으로만 알고 있다가 이번에 실전에서 써먹어 봤습니다.
낙관적 락과 비관적 락에 대해서 제가 알게된 내용은 다음과 같습니다.
• 낙관적 락 (Optimistic Lock) : 낙관적 락은 충돌이 빈번하게 일어나지 않는 경우에 비관적 락보다 성능상 이점이 있을 수 있고 충돌이 일어났을 경우 개발자가 다시 요청하는 로직을 try / catch 문을 이용해 구현해야 합니다.
• 비관적 락 (Pessimistic Lock) : 비관적 락은 충돌이 빈번하게 일어나는 경우 낙관적 락보다 성능상 이점이 있을 수 잇고 락을 통해 업데이트를 제어하기 때문에 데이터의 정합성이 어느정도 보장됩니다. 하지만 락에 의한 성능 저하는 감수해야 합니다.
제 프로젝트에는 비관적 락을 선택하는 것이 올바르다고 판단했습니다.
그 이유는 다음과 같습니다.
• 재고가 1개 밖에 없는데 세명이 동시에 결제를 요청했다면 뒤에 두사람은 결제가 일어나지 않아야합니다.
• 재고가 0개인데 주문이 들어가는 상황은 반드시 막아야할만큼 중요한 상황입니다.
• 낙관적으로 JPA에 의해 커밋이 되는 순간 충돌을 판단하여 OptimisticLockingFailuerException을 이용해 처리하는 방법도 있겠지만 재고가 1개인 상황에서 처음 사용자를 제외하고 모든 사용자를 통과하게 두면 안됩니다.
때문에 저는 비관적 락을 이용해 동시성 문제를 해결했습니다. 이에 따르는 테스트 케이스도 작성을 완료했고 정상적으로 통과하는 것을 확인했습니다.
느낀점
동시성 문제는 직관적이지 않지만 특정한 패턴이 있기 때문에 이번 프로젝트를 통해 동시성 문제에 대한 냄새(?)를 맡을 수 있게 된 것 같습니다.
또한 동시성 문제를 확인할 때 고려해야 하는 상황이 정말 많고 많은 클래스들이 꼬여있는 상황에선 정말 발견하기 힘들겠다는 생각도 했습니다.
하지만 이번 경험을 통해 JPA가 어떤 방식으로 동시성 문제를 해결하기위해 방법론들을 준비해 뒀는지에 대해서 학습할 수 있었습니다.
또한 멀티 스레드 환경의 테스트를 구축하는 방법도 터득하게 되어 추후에 멀티스레드 환경을 테스트하는 일이 있으면 요긴하게 사용할 것 같습니다.
온라인 쇼핑몰 ver.2 (5) : 검색 성능 개선하기
1. 기존 검색 방식
• LIKE 연산자를 이용한 검색을 했습니다.
2. 기존 검색의 문제점
• 인덱스 설정을 할 수 없습니다.
• 인덱스를 설정하면 시간 복잡도가 O(log n)이지만 인덱스를 설정하지 못하기 때문에 시간 복잡도가 O(n)에 바인딩 즉, 풀스캔으로 조회합니다.
3. ver.2에서 개선한 점
• Elasticsearch의 역색인을 이용해 검색 성능을 20배 (100만행 기준) 끌어올렸습니다.
Elasticsearch
고난
항상 느끼는 것이지만 NoSQL은 진입장벽이 어마어마한 것 같습니다. RDBMS에 너무 익숙해진 것도 있겠지만 하나부터 열까지 새롭지 아니한게 없었습니다.
RESTful API로 테이블 (인덱스)를 만들고 모든 CRUD 또한 RESTful API를 따르고 있었습니다. 또한, GUI도 굉장히 낯설었고 데이터를 어떻게 봐야하는지도 몰랐습니다.
오히려 스프링에서 Elasticsearch를 사용하는 것은 그렇게 난이도 있지 않았지만 다른 부차적인 것들이 저를 괴롭혔습니다.
데이터 마이그레이션
제가 기존에 사용하고 있던 데이터 셋은 약 200개정도 되는 데이터 셋이었습니다. 이것을 검색하기 위해서는 MySQL에 있는 데이터를 Elasticsearch로 마이그레이션 해야 하는 상황이 발생했습니다.
마이그레이션을 하는 방법에는
• 일일이 집어넣기
• Logstash 사용하기
• go-mysql-elasticsearch 사용하기
이렇게 세 가지 였습니다.
사실 200개정도 밖에 안되는 데이터셋이기 때문에 일일이 집어넣는 것도 무리는 아니었습니다. 하지만 제 컨셉상 1000만명의 이용자 수가 있다면 데이터셋이 어마어마하게 클 것이기 때문에 1번은 이행할 수 없었습니다.
남은 두 가지 방법들은 각자 장단점이 있었습니다.
Logstash같은 경우는 SQL문으로 내가 원하는 데이터를 뽑아서 마이그레이션을 할 수 있다는 것과 그렇기 때문에 진입장벽이 상대적으로 낮다는 것이었고, 무엇보다 ELK 스택 덕분에 Elasticsearch와 호환도 잘 된다는 것이 장점이었습니다.
하지만 메모리를 많이 잡아먹고 그렇기 때문에 속도가 느리다는 것이 단점으로 꼽혔습니다.
go-mysql-elasticsearch는 Logstash와 장단점이 반대로 뒤집으면 되기 때문에 고민을 했습니다.
저는 여기서 SQL문을 이용해 데이터를 뽑아낼 수 있다는 사실이 굉장한 메리트로 받아들였습니다.
때문에 저는 Logstash를 이용해 데이터 마이그레이션을 진행했습니다.
JPA와 성능비교
저는 Elasticsearch가 검색에 최적화된 엔진이라고 하길래 성능이 압도적으로 JPA보다 좋을 것이라고 생각했습니다만, 실제로 1000번의 조회를 진행해본 결과
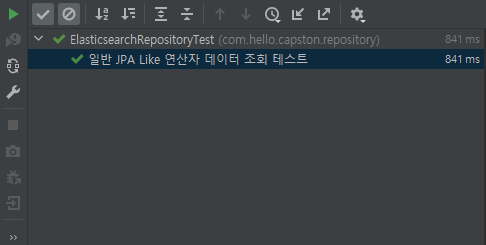
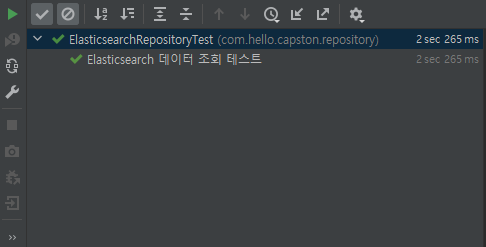
단순 결과만 보고 믿을 수 없었습니다. 많은 엔터프라이즈에서 Elasticsearch를 채택했을 것인데 왜 이런 결과가 나올까?
이 답은 Chat GPT가 알려줬습니다.
• Caching : JPA는 캐싱 매커니즘을 사용했을 것이기 때문에 (1차 캐시) 만약 테스트에서 같은 쿼리를 빠르게 재시작 했을 경우에 데이터베이스는 캐시된 데이터 셋들을 리턴할 수 있을 것이고 그럼 연산이 매우 빨라진다는 것이었죠.
• Overhead of HTTP communication : Elasticsearch는 HTTP에서 작동합니다. 그리고 그것은 JPA와 같이 로컬 SQL을 실행하는 것과 다르게 약간의 오버헤드가 가미될 수 있습니다. 이러한 오버헤드는 특히 루프를 통해 많은 수의 요청을 실행했을 때 더 부각되어 보입니다.
• Setup Time : Elasticsearch는 다수의 필드와 document를 통한 복잡하고 큰 스케일의 텍스트 검색 실행을 위해 설계되었습니다. 이것은 큰 데이터 셋이나 복잡한 검색 연산을 위해 최적화 되어있습니다. 때문에, 작은 텍스트 검색으로도 굉장히 많은 자원이 필요로 합니다. 하지만 LIKE 연산자는 비교적 간단한 연산이기 떄문에 데이터베이스 엔진은 빠르게 실행될 수 있던 것입니다.
• Size of the dataset : 만약 데이터셋이 작다면 Elasitcsearch의 역색인과 분산된 검색의 이점은 뚜렷하지 않을 것입니다. 몇몇 케이스에서 전통적인 RDBMS가 작은 데이터 셋에선 더 빠를수도 있습니다.
이 결과를 보고 그나마 Elasticsearch를 적용하는 것이 더 나은 선택이라는 것을 알 수 있었습니다.
2023-05-27 Update
Chat GPT의 말대로 데이터 셋이 작기 때문에 어쩔 수 없이 성능 차이를 보기 위해선 반복문을 돌려서 테스트를 하는 수밖에 없었습니다.
때문에 데이터 셋을 크게 늘리기로 결정했고 데이터 셋은 100만행으로 늘렸습니다.
그리고 제일 마지막에 있는 Primary Key 기준 테스팅한 결과입니다.
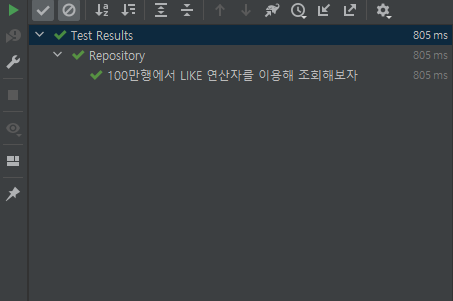
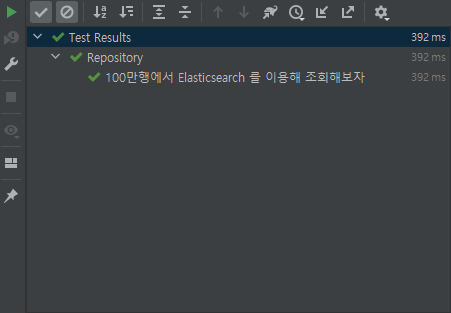
스프링 구동시간을 빼서 진짜 조회하는 시간만 구해봤습니다.
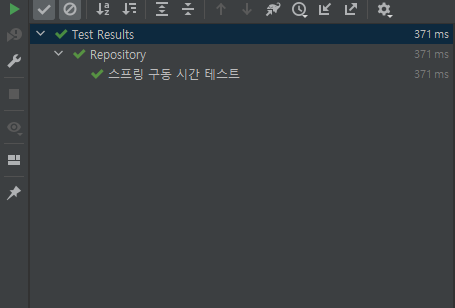
결론
JPA LIKE 연산자를 사용해 100만번째 데이터 검색하는 데 걸린 시간 : 0.434 초
Elasticsearch 를 사용해 100만번째 데이터 검색하는 데 걸린 시간 : 0.021 초
이를 수치로 환산해보면 약 20배의 성능 향상이 있다는 것을 알 수 있었습니다.
이 프로젝트를 통해 얻은 것
• 많은 데이터 셋일 때 검색 성능의 향상
• 데이터 마이그레이션 경험
• MSA로 넘어가기 위한 준비 단계
온라인 쇼핑몰 ver.3 (1) : Docker + Nginx + Jenkins 무중단 배포
기왕 시작한거 끝을 보자는 느낌으로 배포까지 진행하자고 생각했습니다. 또한, 단순히 배포하는 것이 아니라 실제 프로덕트에서 사용중인 무중단 배포를 진행해보고 싶었습니다.
무중단 배포에는 크게 세가지 방법이 있었는데 그 중 블루 그린 배포가 매력적이라고 느껴져 무중단 배포에 블루그린 배포를 진행하였습니다.
1. 기존 프로젝트의 배포
• Cafe 24의 웹 호스팅을 이용해 배포
• WAR 파일을 이용해 배포
2. 기존 프로젝트에서 배포의 문제점
• 단일 서버이기 때문에 DB 서버만 키운다던가 하는 유연한 대처가 불가능
• 가장 큰 문제점은 배포를 하고 나서 정상적으로 배포가 안되는 경우가 많았음
• 항상 서버를 몇번씩 재시작을 해줘야 정상적으로 서버가 작동되었는데 이 시간이 대략 5분정도 걸렸음
3. ver.2에서 개선한 점
• AWS 클라우드를 이용해 확장성과 유연성을 개선
• Docker를 이용한 배포로 버저닝을 쉽게 개선
• Docker와 Nginx를 이용해 블루 그린 배포로 무중단 배포
4. ver.2에서 추가적으로 더 개선한 점
• Jenkins를 이용해 CI / CD 자동화
이번 무중단 배포 프로젝트에서 컴포트 존을 벗어나기 위해 다양한 시도들을 했습니다.
• AWS 생태계에 대해서 학습 : EC2, Route 53, S3, ACM, ELB, IAM, ECR 등 제가 지금 당장 써야하는 클라우드 서비스에 대해서 학습했습니다. 이를 통해 하나의 프로덕트가 배포될 때 진행되는 사이클을 이해할 수 있게 되었습니다.
• AWS를 위한 linux 학습 : 저는 리눅스를 공부하는 것을 주저했습니다. Windows에 익숙해져있어서 시작하는 것이 쉽지 않았지만 기본 문법부터 차근차근 공부해가니 오히려 Windows보다 리눅스가 더 편한 것도 있었습니다.
• linux 환경에서만 작동하는 docker : 대부분 사람들이 도커를 이용해 배포를 진행했고 Baeldung같은 튜토리얼 사이트에서도 도커를 이용했기 때문에 이참에 docker에 대해 배워야겠다고 생각했습니다.
• Ningx와 같은 프록시 서버 학습 : 기본적인 Nginx의 동작 방식이라든가 configuration 파일을 작성하는 방법에 대해서 학습했습니다.
• Jenkins와 같은 CI / CD 자동화 툴 학습 : Jenkins를 공부하면서 점점 편해지는 배포를 맛볼 수 있어서 정말 뜻깊은 경험이었습니다.
다양한 기술들을 접할 수 있는 소중한 경험이었습니다.
5. 이번 프로젝트를 통해 느낀점
CI / CD의 대략적인 개념을 직접 몸으로 체득할 수 있었습니다. 어떤 방식으로 진행이 되며 어떤 방식으로 구현해야 하는지에 대한 전체적인 맥락을 이해하는데 도움이 많이 됐습니다.
특히 도커를 이용한 애플리케이션의 컨테이너화에 대한 개념을 이해하는데 좋은 경험이 되었습니다. 또한, 컴포트 존을 벗어나야 성장할 수 있다는 느낌도 받을 수 있었습니다.
또한, 점점 배포가 쉬워지고 간편해지는 것을 느끼면서 왜 요즘 시대에 배포가 잦아졌는지에 대해서 느낄 수 있었던 좋은 경험이었습니다.
6. 추가 설명
1. Cafe 24 배포
기존 프로젝트는 배포를 하는데 아주 심각한 문제가 있었습니다. 제일 처음엔 Cafe 24에 WAR파일을 배포하면서 배포에 대한 기본적인 이해를 높였습니다.
하지만 이 방법은 굉장히 문제가 있었습니다. 만약 업데이트해야 할 내용이 있으면 업데이트를 진행하고 WAR파일을 덮어씌운 다음 서버를 재시작하는데 한번에 서버가 안뜨고 버벅였습니다.
그래서 여러번 재시작을 해줘야했고 이 시간이 5분에서 오래걸리면 10분도 걸릴 때가 있었습니다.
2. AWS EC2 배포
어디서 AWS로 배포했다는 포스팅을 발견하고 저도 시도해보고 싶어서 AWS EC2로 배포를 해봤습니다.
하지만 결과는 실패였습니다. 그 때 당시 리눅스 기본 명령어도 모르던 시기였는데 MySQL을 설치하고 기존 데이터와 마이그레이션 하는 과정에서 문제가 생겼습니다.
MySQL Server도 깔아보고 MySQL client도 깔아보고 별에별 짓을 다했는데 결국 해결하지 못하고 저만치 밀어뒀습니다.
3. AWS EC2 + Docker 배포
그렇게 1년이 지나고 이제 배포에 대해 본격적으로 관심을 가지고 Docker라는 기술을 배워야겠다는 생각을 가졌습니다.
Docker를 이용한 배포는 정말 신세계가 아닐 수 없었습니다. 단순 EC2 배포에서 속을 썩였던 MySQL도 뚝딱 만들 수 있고 무엇보다 버전관리를 하는 것이 매우 편했습니다.
만약 EC2 배포에서 MySQL 버전을 높여야한다면 MySQL의 그 지겹도록 복잡한 삭제부터 시작해서 다시 처음부터 다운로드 하는게 만만치않은 일일거라고 생각했습니다.
Docker를 신세계였고 저에게 적잖은 충격을 줬습니다. 하지만 이 방법에도 문제는 있었습니다.
Docker 컨테이너를 내렸다가 다시 배포할 때 30초~1분 가량 시간이 필요하다는 점이었습니다. 제 프로젝트 컨셉은 이용자수가 1000만명일 때 발생하는 문제들을 개선하는 것이기 때문에 이는 큰 문제가 됐습니다.
만약 1000만명이 있다면 30초~1분내에 일어날 어마어마한 결제량이 모두 손실로 이어지는 것이었습니다.
4. AWS EC2 + Docker + Nginx 무중단 배포
무중단 배포를 위해 블루 그린 배포에 대해서 공부하게 되었고 Nginx 와 같은 프록시 서버를 앞에 두고 로드밸런서로써 사용해 블루 그린 배포를 성공적으로 완료할 수 있었습니다.
굉장히 혁신적이었습니다. 직접 경험해본 블루 그린 배포의 장점은 사용자 입장에서 새로고침 혹은 다른 액션을 취하면 곧바로 버전 업이 된 상태로 진행할 수 있다는 점이었습니다.
하지만 이 방법의 문제점은 배포 과정이 엄청나게 복잡하다는 것이었습니다. 다른 버전으로 갈아 끼우기 위해선 8개의 단계를 거쳐야 했고 이는 굉장한 낭비였습니다.
5. AWS EC2 + Docker + Nginx + Jenkins CI / CD 자동화
Jenkins를 이용해 배포를 자동화하는 경험은 저에게 그야말로 다른 세상이었습니다. 파이프라인을 구축하면서 다양한 트러블이 있었지만 모두 해결한 다음에는 정말 큰 충격이었습니다.
여덟개의 복잡한 단계가 원클릭으로 해결되는 모습을 직접 보고있으니 점점 무서워지기 시작했습니다.
(6. Kubernetes)
이 단계는 아직 적용하지 않았지만 쿠버네티스로 서버를 관리하는 모습을 본 적이 있습니다. 그 경험은 제가 Jenkins를 이용해 자동화에 성공했을 때와 같은 충격이었습니다.
CI / CD 자동화를 넘어 컨테이너를 자동으로 관리해주는 기술이라니 미쳤다는 말 밖에 할 수 없었습니다.
이 기술도 언젠가 꼭 경험해보고 싶은 기술 중 하나입니다.
온라인 쇼핑몰 ver.3 (2) : 기술 선택 이유
프로젝트를 구현할 때 어떤 기술을 어떻게 구현했는지도 물론 중요하겠지만 왜 그 기술을 선택했는지에 대한 고찰이 조금 부족했다는 생각이 들었습니다.
물론 사전에 조사는 다 했지만 직접 써보고 단점을 겪어본 것이 아니기 때문에 추상적일 뿐이었습니다.
이번 기회에 정확히 어떤 기술이 어떤 장점과 단점이 있고 내 프로젝트에 어떤 이유때문에 이 기술을 선택하게 되었는지에 대한 정리를 해봤습니다.
기술 선택 이유
제 프로젝트에는 다음과 같은 기술이 선택되었습니다.
• 캐싱에 Redis
• 검색엔진에 Elasticsearch
• 인증에 JWT
• 동시성 문제 해결에 비관적 락
• 배포에 docker
• 자동화에 jenkins
1. 캐싱에 Redis
스프링에서 캐싱을 사용하기 위해서 다양한 방법이 존재합니다.
• Redis
• Memcached
• EHcache
제 프로젝트를 처음 기획할 때 이 세가지 유형의 캐시 중 Redis를 선택했습니다.
그 이유는 Memcached와 EHcache의 단점 때문입니다.
Memcached
Memcached는 String 타입의 자료구조만 지원합니다. 또한 자체적인 레플리케이션을 지원하지 않기 때문에 확장성에 매우 불리합니다. 제가 추후에 레플리케이션에 대해서 적용해볼 예정이지만 Memcached는 위와 같은 이유 때문에 제 프로젝트에 부적합하다고 생각해서 제외했습니다.
EHcache
스프링에서 자체적으로 제공하고 있는 캐시중 하나입니다. EHcache는 인스턴스가 여러개 떠있는 MSA에서 불리한 모습을 보여줍니다. 세션 클러스터링을 하듯 데이터 싱크를 맞춰줘야 한다는 문제가 있습니다. 때문에 인스턴스가 여러개인 경우에는 기술의 복잡도가 올라가게 되어있습니다. 때문에 EHcache를 제외했습니다.
2. 검색엔진에 Elasticsearch
사실 검색 엔진에는 선택의 여부가 없었습니다. Elasticsearch가 독보적이었기 때문입니다.
아직 추가하진 않았지만 추후에 추가할 예정인 ELK스택을 이용해 로그 관리를 할 예정이기 때문에 검색엔진에 Elasticsearch를 사용하는 것은 제 프로젝트에 당연하다고 생각했습니다.
3. 인증에 JWT
인증 레이어를 스프링 시큐리티만 단독으로 사용하다 JWT와 섞어서 사용했습니다.
제 꿈 중 하나인 제 프로젝트를 MSA로 바꾸는 작업을 위한 준비과정으로써 사용했습니다. MSA가 되면 각각의 도메인들이 격리된 인스턴스로 존재하게 되는데 각각의 도메인끼리 통신을 할 때 인증 방식으로 stateless한 JWT가 적절하다는 판단하에 인증을 JWT로 바꾸게 되었습니다.
4. 동시성 문제 해결에 비관적 락
우선 낙관적 락과 비관적 락을 얘기하기 전에 synchronized 키워드와 serializable 격리수준으로의 격상을 얘기하고 넘어가겠습니다.
synchronized 키워드
syncrhonized 키워드도 물론 동시성 문제를 해결하는데 탁월한 모습을 보여주지만 JPA를 사용하고 있는 제 입장에서는 별로 매력적으로 느껴지지 않았습니다.
기본적으로 JPA는 각각의 스레드에 트랜잭션이 부여되어 데이터베이스 격리수준에 따라 트랜잭션이 고립성을 가지고 있습니다. 때문에 웬만한 일이 아니고서는 동시성 문제가 발생하지 않습니다.
때문에 syncrhonized 키워드로 모든 결제 로직에 락을 거는 것은 자원의 낭비라고 생각했습니다.
serializable 격리수준으로 격상
serializable 격리수준으로 데이터베이스 격리수준을 격상하는 것 또한 동시성 문제를 해결하는 좋은 방법이 될 수 있습니다.
하지만 serializable 격리 수준에서는 Deadlock (이하 데드락) 현상이 발생했습니다. synchronized 키워드로 동시성 문제를 해결했으면 걱정하지 않아도 될 데드락문제 때문에 선택하지 않게 되었습니다.
데드락 문제를 해결하기 위해 데이터 조회 결과 값을 Collections.sort() 를 이용해 정렬해주면 데드락 문제가 해결되었습니다만, sort() 메서드는 정렬하는데 시간복잡도가 O(nlogn)이 걸리기 때문에 serializable 격리수준으로 생기는 성능 문제와 정렬에 필요한 시간복잡도를 고려하면 성능적인 이슈가 상당할 것으로 예상되었습니다.
낙관적 락과 비관적 락
이제 낙관적 락과 비관적 락에 대해서인데, 기본적으로 낙관적 락과 비관적 락의 차이점을 잘 알고 있습니다.
낙관적 락은 커밋시에 충돌이 일어날 경우 예외가 발생하여 그 예외를 처리해줌으로써 동시성 문제를 해결할 수 있습니다. 때문에 충돌이 빈번하지 않은 경우에 사용하면 좋습니다.
비관적 락은 동시성 문제가 발생한다고 가정하고 데이터 조회에 락을 거는 것이기 때문에 성능상 낙관적 락에 비해 손해를 보지만 컨셉 자체가 이용자 수가 1000만명을 가정하고 있기 때문에 충돌이 빈번할 것으로 예상되어 비관적 락을 선택했습니다.
5. 배포에 Docker
도커를 경험해보고 무조건 배포엔 도커를 사용해야겠다고 생각했습니다.
제가 느낀 도커의 장점은 다음과 같습니다.
• 버전 관리가 너무 쉽다 : MySQL의 버전을 올리고 싶으면 이미지를 새로운 MySQL의 이미지를 받아오면 됩니다. 이전에는 우분투에 깔려있던 MySQL을 지우기 위해서 귀찮은 짓을 해야했지만 이젠 이미지만 없애고 다음 버전의 이미지만 풀링해오면 됩니다.
• 추상화로 배포의 단조로움 : 컨테이너로 추상화한다는 개념 자체가 신기했는데, OS위에 컨테이너를 띄우고 그 컨테이너안에서 추가적으로 관리가 가능하다는 점이 매력적이었습니다.
• 블루 그린 배포 : 블루 그린 배포에 도커가 제격이었습니다. 작동하지 않는 애클리케이션 서버를 미리 띄워두고 기존 포트를 삭제하면서 새로 띄운 포트를 장착시켜주기만 하면 되는 구조는 정말 편했습니다. 도커 컴포즈를 이용해 정말 쉽게 스위칭이 됐습니다.
사실 도커는 경쟁상대가 없기 때문에 제 프로젝트 선택에서 당연한 선택이 되었습니다.
6. 자동화에 jenkins
CI 자동화에 jenkins와 github action이 있다고 들었는데 많은 개발자들에게서 각각의 장단점에 대해서 알 수 있었습니다.
jenkins는 유지보수가 힘들고 github action은 잡 스케쥴링에 이슈가 있다.
저는 CI 자동화에 잡 스케쥴링 이슈는 치명적이라고 (개인적으로) 생각합니다. 또한, jenkins가 넓은 커뮤니티를 가지고 있어 트러블 슈팅하는 과정이나 어떻게 사용해야 하는지에 대한 레퍼런스를 많이 참고할 수 있었습니다.
이렇게 제 프로젝트인 온라인 쇼핑몰 ver.2에서 어떤 기술을 사용했고 왜 사용했는지에 대해서 기술했습니다.
온라인 쇼핑몰 ver.3 (3) Graceful Shutdown
0. Introduce
블루 그린 배포까지 성공적으로 완료했고 Jenkins라는 CI 자동화 툴로 자동화까지 성공했습니다만 실전에서는 어떻게 배포를 하는지에 대해서 궁금해졌습니다.
때문에 Graceful Shutdown을 도입하게 되었습니다.
1. 기존 배포
• 블루 그린 배포에서 이전 버전이 내려가고 새로운 버전이 올라간다.
2. 기존 배포의 문제점
• 블루 => 그린으로 배포하는 과정에서 이전 버전을 갑자기 닫아버리면 이전 버전을 이용하고 있던 사용자의 시스템이 멈춰버립니다.
• 이 때 결제를 진행하고 있다거나 데이터베이스를 이용하는 로직 도중 서버가 내려가버리면 트랜잭션이 에러에의해 롤백되는 것이 아니기 때문에 도중에 로직이 멈춰버릴 가능성이 있습니다.
• 이는 부정적인 사용자 경험으로 이어질 뿐더러 롤백을 제대로 진행하지 못했기 때문에 개발자가 해결해야 하는 상황입니다.
3. ver.3 에서 개선한 점
• Graceful Shutdown 을 도입함으로써 기존 버전에서의 로직을 모두 완료한 뒤 새로운 버전으로 갈아탑니다.
4. 이번 프로젝트에서 느낀점
배포만 하고 실전에서 일어날 수 있는 상황에 대한 인지가 좀 늦었습니다. 때문에 놓치고 있었던 부분이었는데 이번 기회에 실전에서 일어날 수 있는 다양한 상황들에 대해 복기해보고 이에 맞춰 알맞은 설정을 통해 부정적인 사용자 경험을 줄이는 방법이 인상깊었습니다.
5. 세부 사항
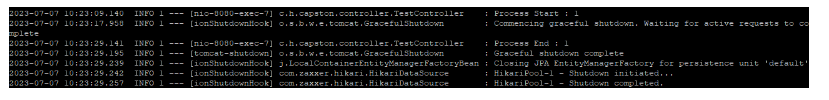
우선 비즈니스 로직을 가정하고 앞뒤로 로그를 찍어서 정상적으로 완료됨을 확인합니다.
정상 작동되는 로직 확인

Graceful Shutdown을 설정하기 전

Graceful Shutdown을 설정한 후
온라인 쇼핑몰 ver.3 (4) 클래스 로더 Warm Up, JIT 컴파일러 Warm Up
0. Introduce
• 배포를 진행할 때 고려해야 하는 점을 공부하다 Warm Up 이라는 개념에 대해서 알게 되었습니다. 그리고 클래스 로더, JIT 컴파일러를 Warm Up 하는 방법에 대해서 학습하고 실습했습니다.
1. 기존 프로젝트의 배포
• 배포를 진행하고 클래스 로더의 지연로딩, JIT 컴파일러의 활성화 조건을 만족하지 않았습니다.
2. 기존 프로젝트의 문제
• 배포를 하고 난 조금 뒤에는 지연 시간이 안정되지만 배포를 한 직후에는 지연 시간이 많이 발생할 수 있는 문제점을 파악했습니다.
3. ver.3 에서 해결한 점
• ApplicationRunner를 구현함으로써 클래스 로더의 지연 로딩을 해결했습니다.
• Jenkins의 CI 파이프 라인에서 curl 명령어를 통해 많은 요청이 예상되는 API를 warm up 시켰습니다.
• 모든 warm up이 끝나기 전에는 Interceptor를 이용해 400 코드로 내려주고, 모든 warm up이 끝난다면 200 코드로 내려줘서 health check를 진행했습니다.
4. 느낀점
• 배포를 진행할 때 다양한 것들을 고려해야 한다는 것을 알게 되었습니다. 이런것도 이슈가 되는구나... 하는 감정을 느끼게 되었습니다. 아직 배울게 많이 남아있다는 것을 실감하게 되는 프로젝트였습니다.
온라인 쇼핑몰 ver.3 (5) 모니터링 환경 구축
0. Introduce
실제 운영은 모니터링 환경을 구축한다는 것을 알고 있었습니다. 때문에 실제 운영환경을 가정하고 모니터링 환경을 구축해야겠다는 니즈를 느꼈습니다.
이에 프로메테우스, 그라파나, 스프링 Actuator와 같은 기술을 공부하고 제 프로젝트에 적용했습니다.
1. 기존 프로젝트의 모니터링
기존 프로젝트엔 모니터링 기능이 없었습니다.
2. 기존 프로젝트의 문제
기존 프로젝트는 모니터링의 부재로 실제 애플리케이션의 상태를 알 수 없었습니다. 때문에 어떤 부분이 문제이고 어떤 부분을 고려하여 확장해야 하는지 알 수 없었습니다.
3. ver.3 에서 해결한 문제
기존 프로젝트의 문제점에 대해서 인지하고 있었으며 ver.3에서 모니터링 기능을 제공하기로 결정했습니다. 모니터링 문제를 해결함으로써 CPU 사용량이나 메모리 사용량, 디스크 I/O, 네트워크, JVM 메모리, GC 부하, 로그 트레이스, 스레드 상태, 클래스 로더 등의 다양한 부분을 모니터링 할 수 있게 되었습니다.
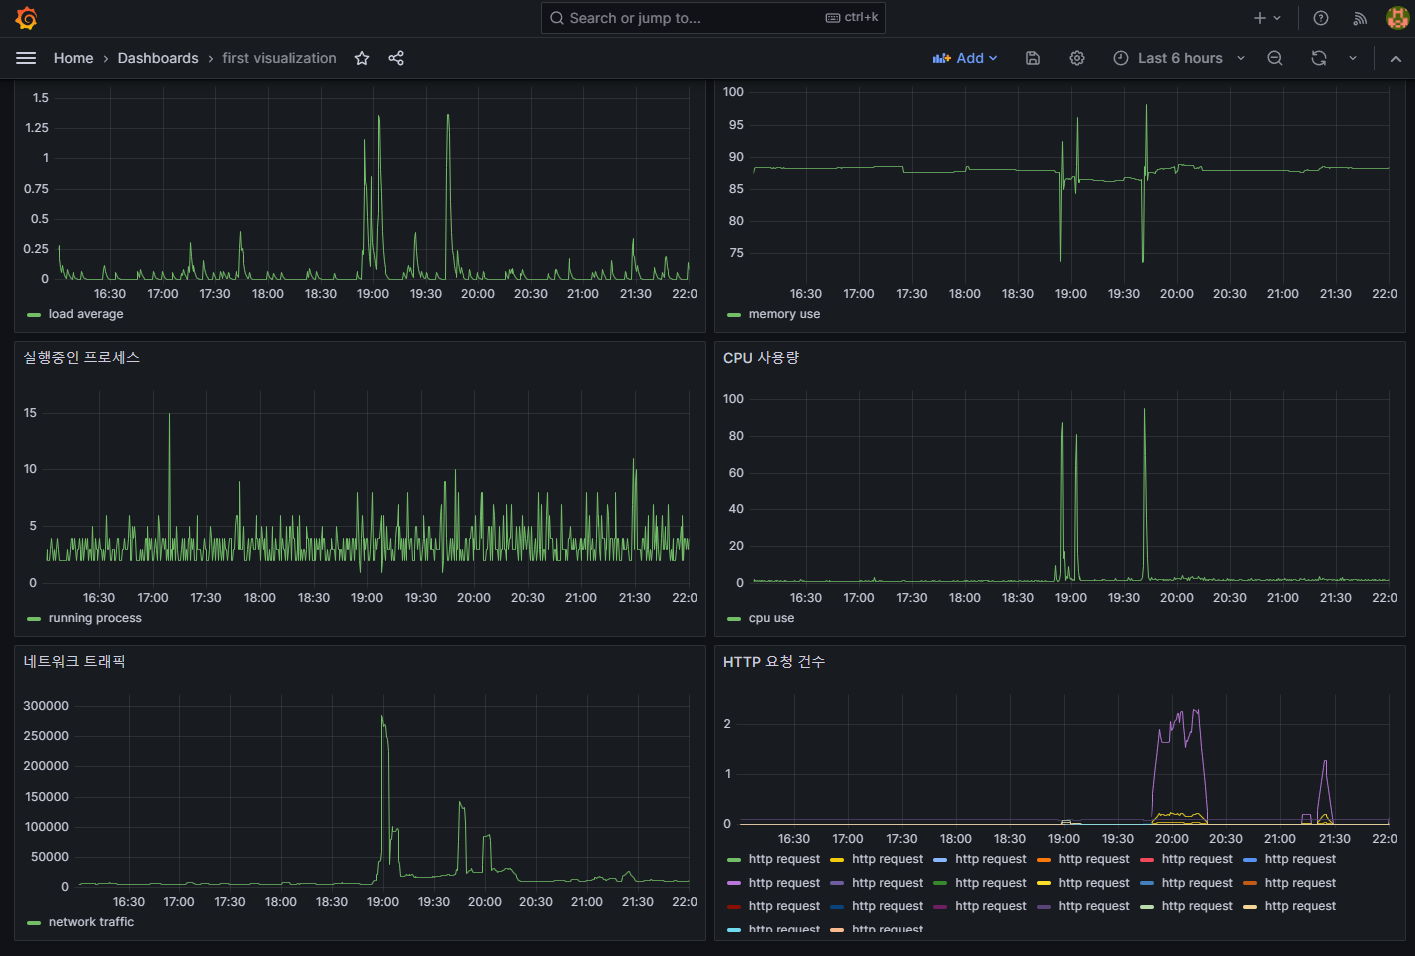
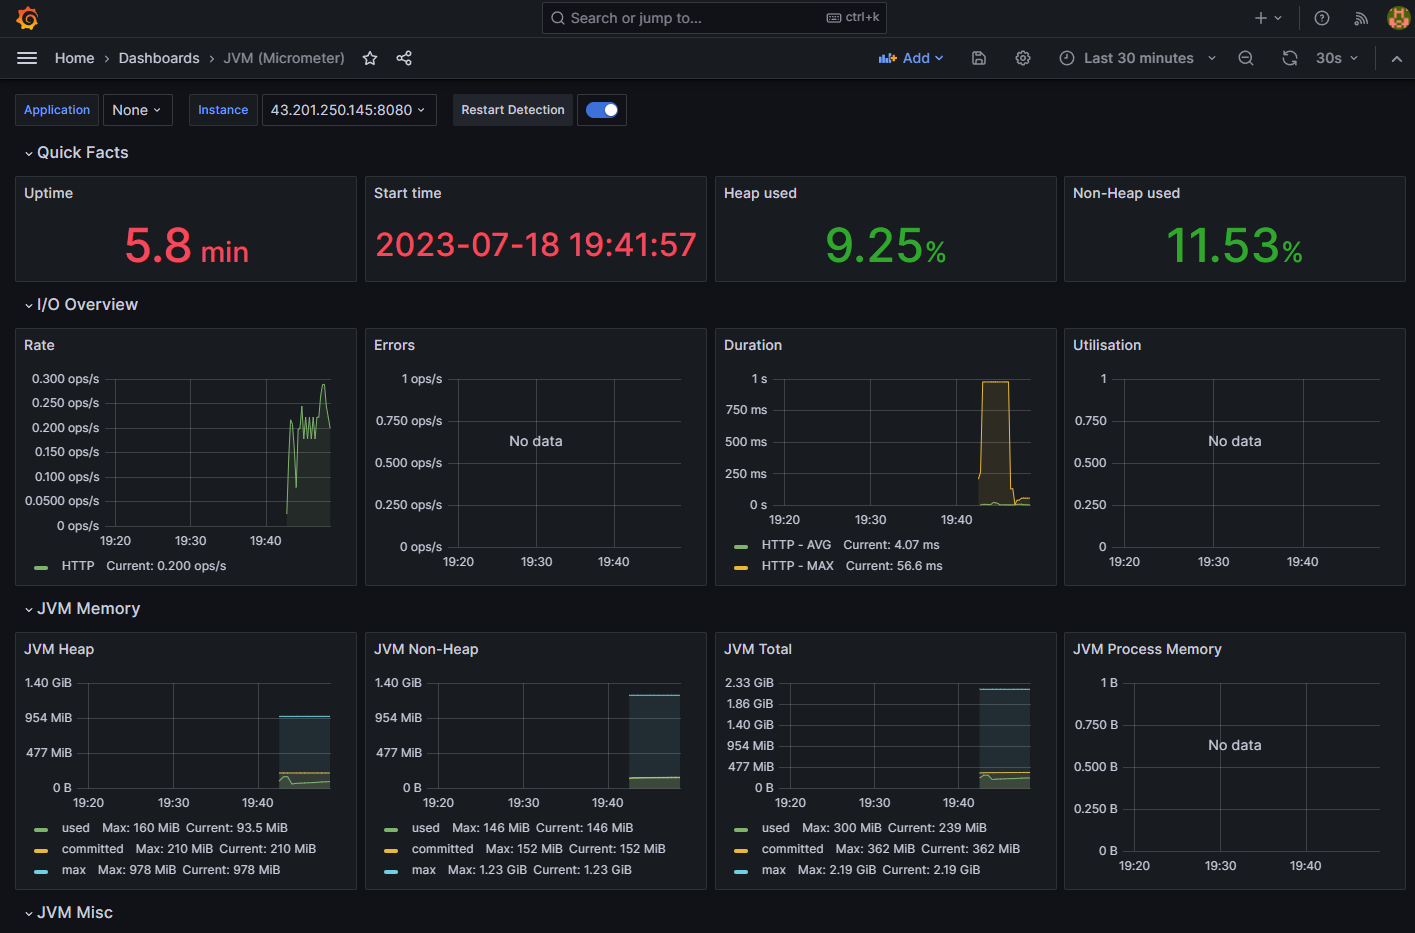
4. 느낀점
모니터링 환경을 구축함으로써 문제가 발생한다면 어떤 부분에서 문제가 발생하고 있는지 대처하기 더 쉬워졌습니다. 이는 배포 과정에서 생길 수 있는 다양한 문제를 해결할 수 있는 상황이라고 생각합니다.
ACM + ALB 를 이용해 HTTPS 적용하기 (1)
이번 포스팅에선 AWS에서 HTTPS 적용하는 방법에 대해서 포스팅해보도록 하겠습니다.
조금 복잡할 수 있으니 순서대로 차근차근 알려드리겠습니다.
시작하죠!
HTTPS 적용하기
1. 도메인 구매하기
우선 도메인을 구매해야합니다. 저는 cafe24에서 구매했습니다. 우선 구매하고 잠심 대기해주세요. 도메인의 네임서버를 바꿔줘야하는데 지금은 바꾸지 않습니다.
2. Route 53 도메인 등록
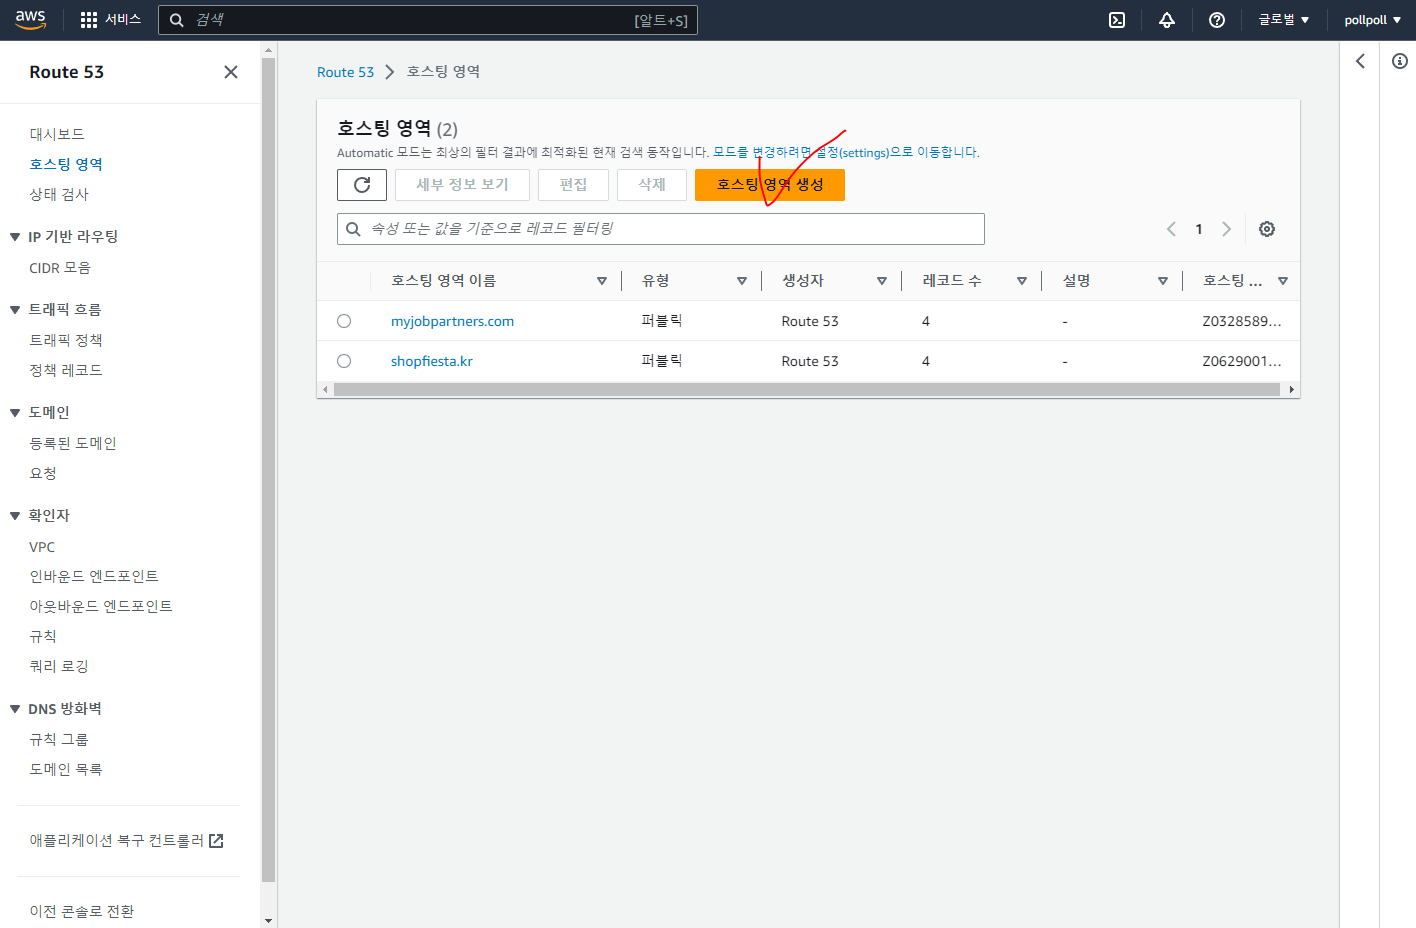
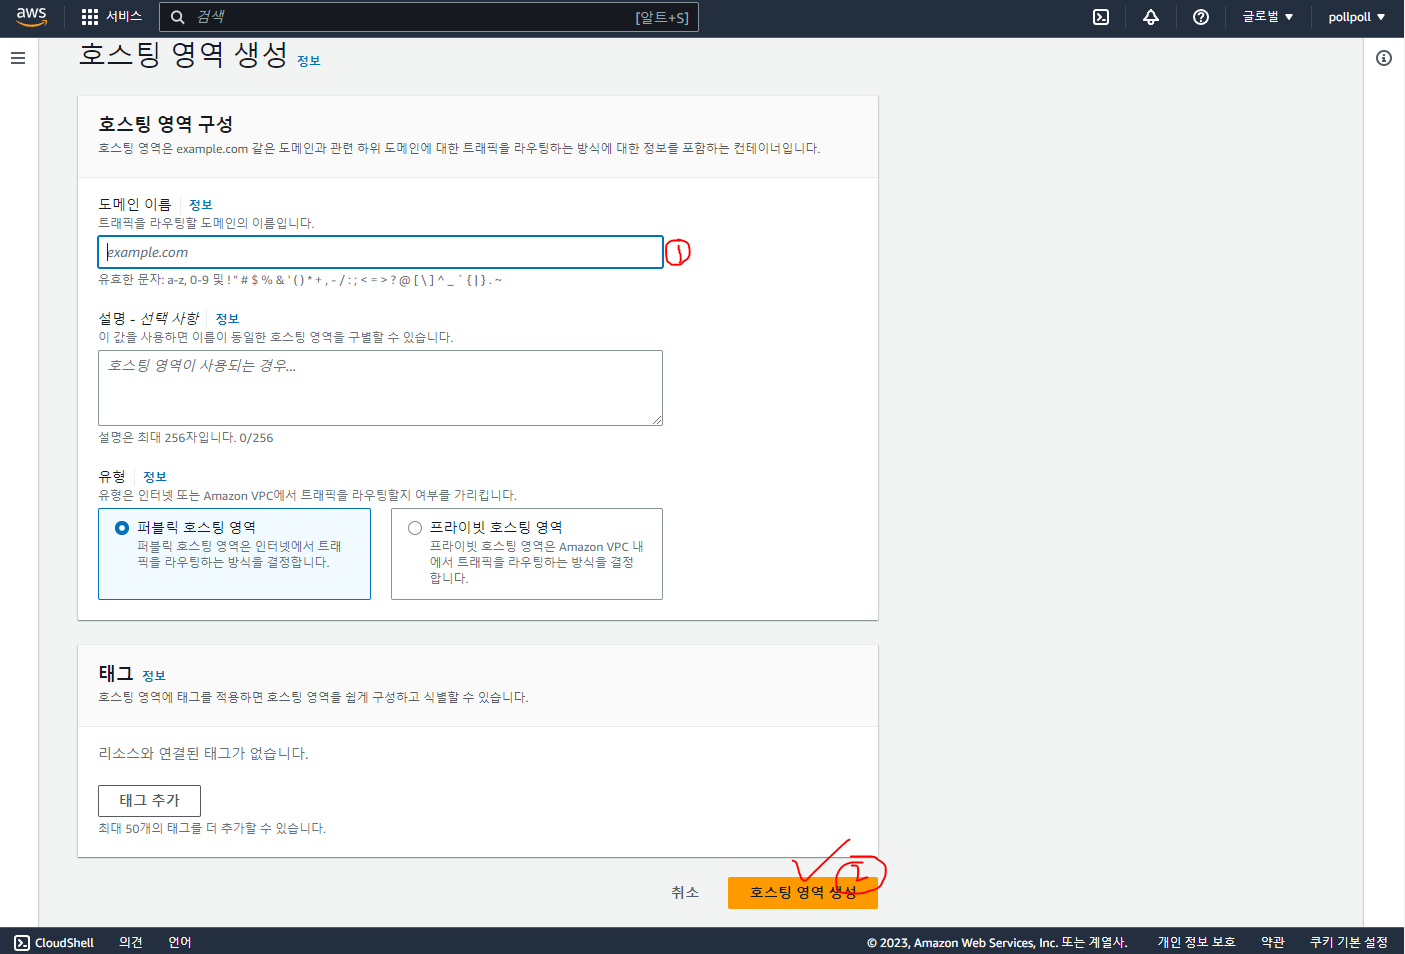
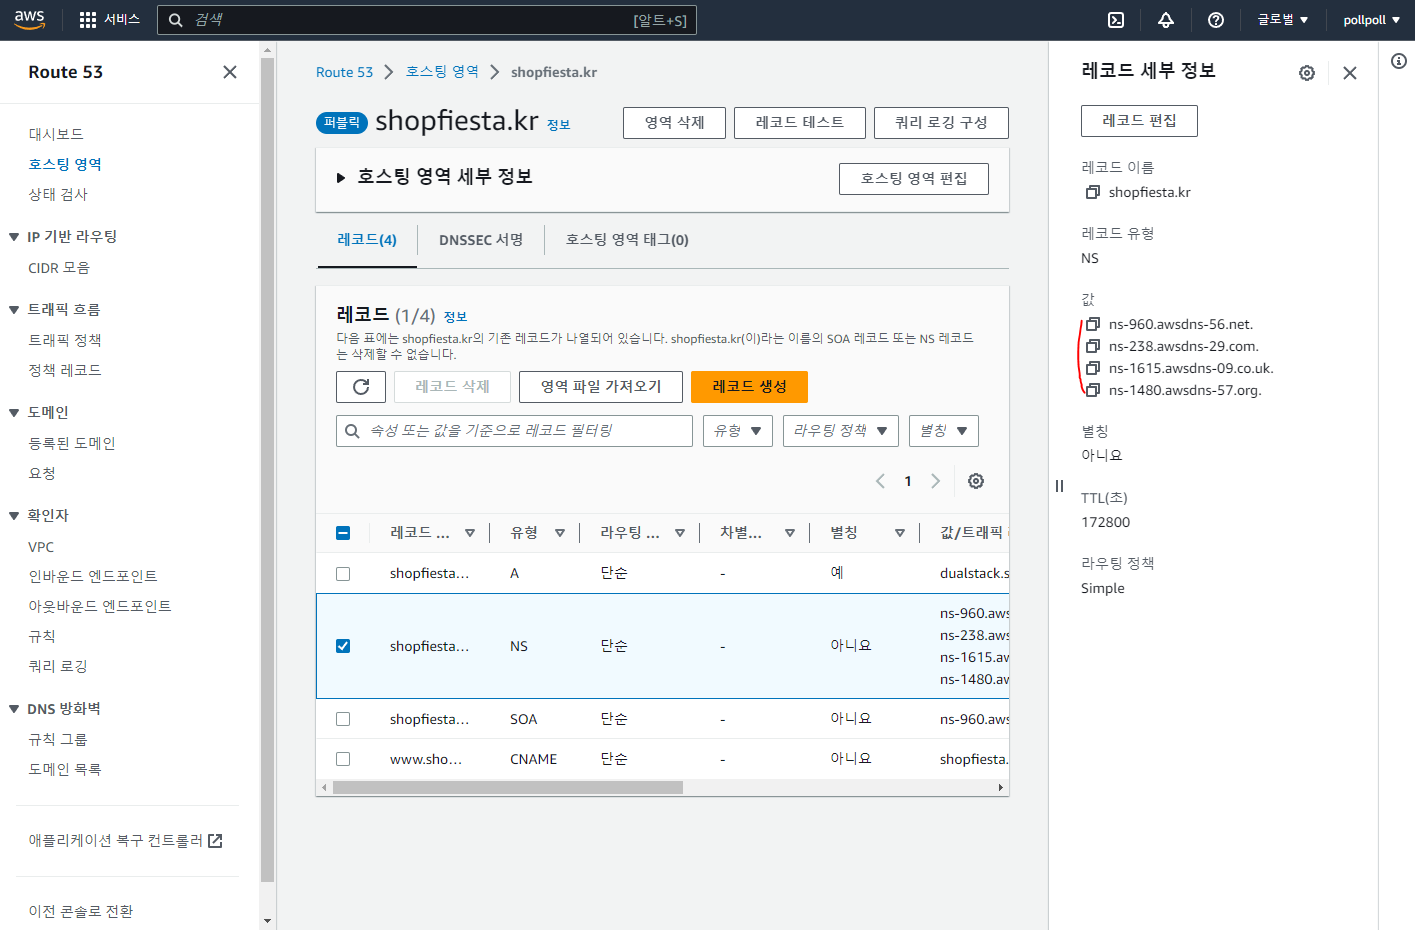
유형 NS를 클릭하면 레코드 세부 정보가 나오는데 값에 해당하는 저 네개를 cafe24 관리자 페이지에 들어가 네임서버를 변경해주면 됩니다.
연결하는 방법은 아래의 링크에 자세히 나와있습니다.
https://jsikim1.tistory.com/153
3. ACM 발급
AWS 검색창에 ACM을 검색하면 Certificate Manager 라는 탭이 있습니다. 그곳에 들어가서 우리의 도메인이름으로 인증서를 발급받아야합니다.
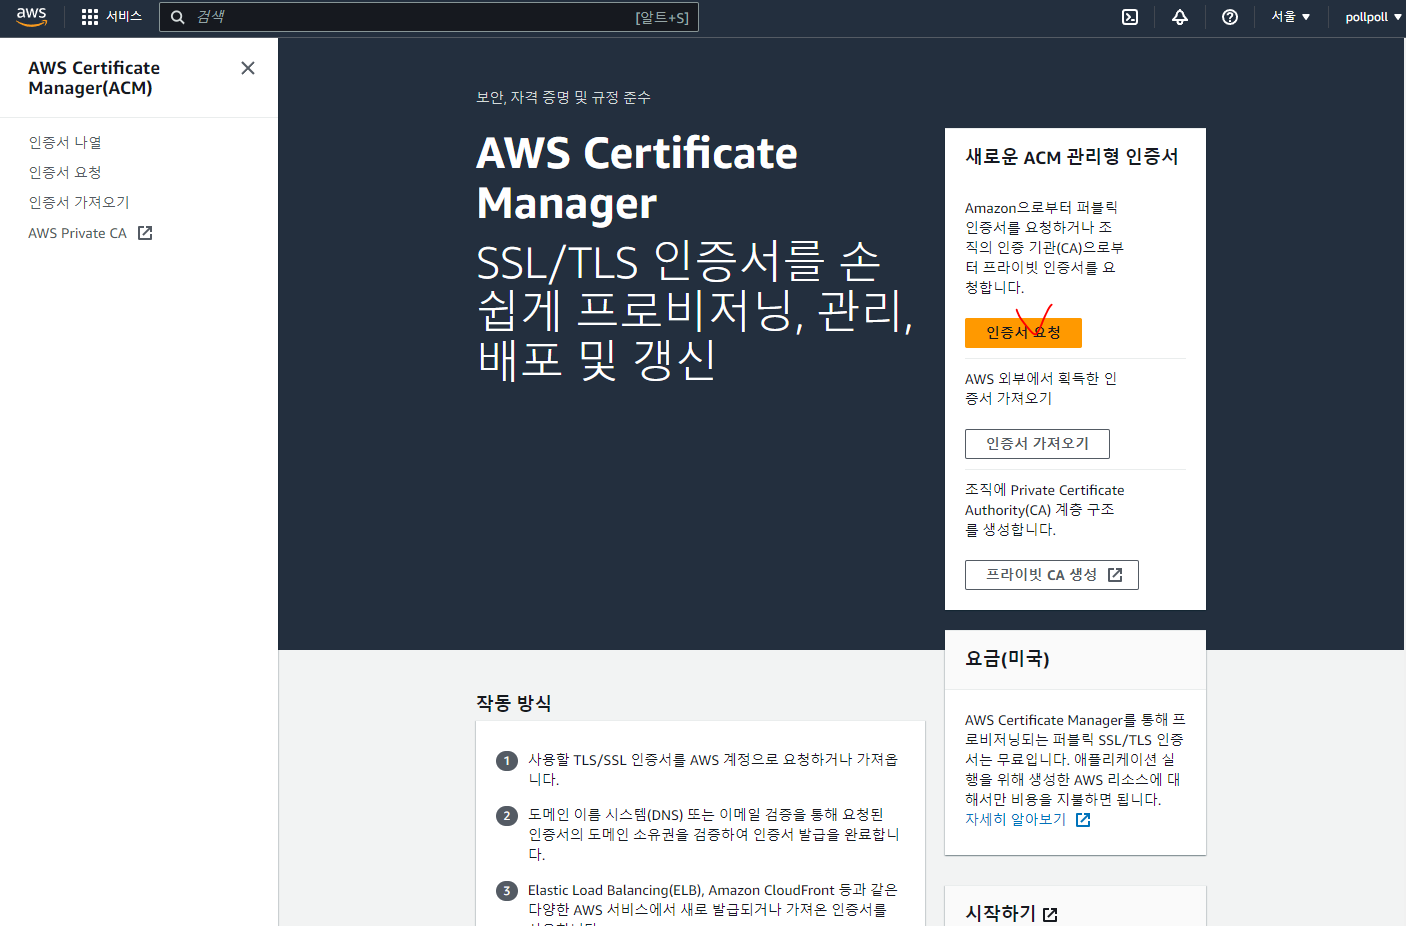
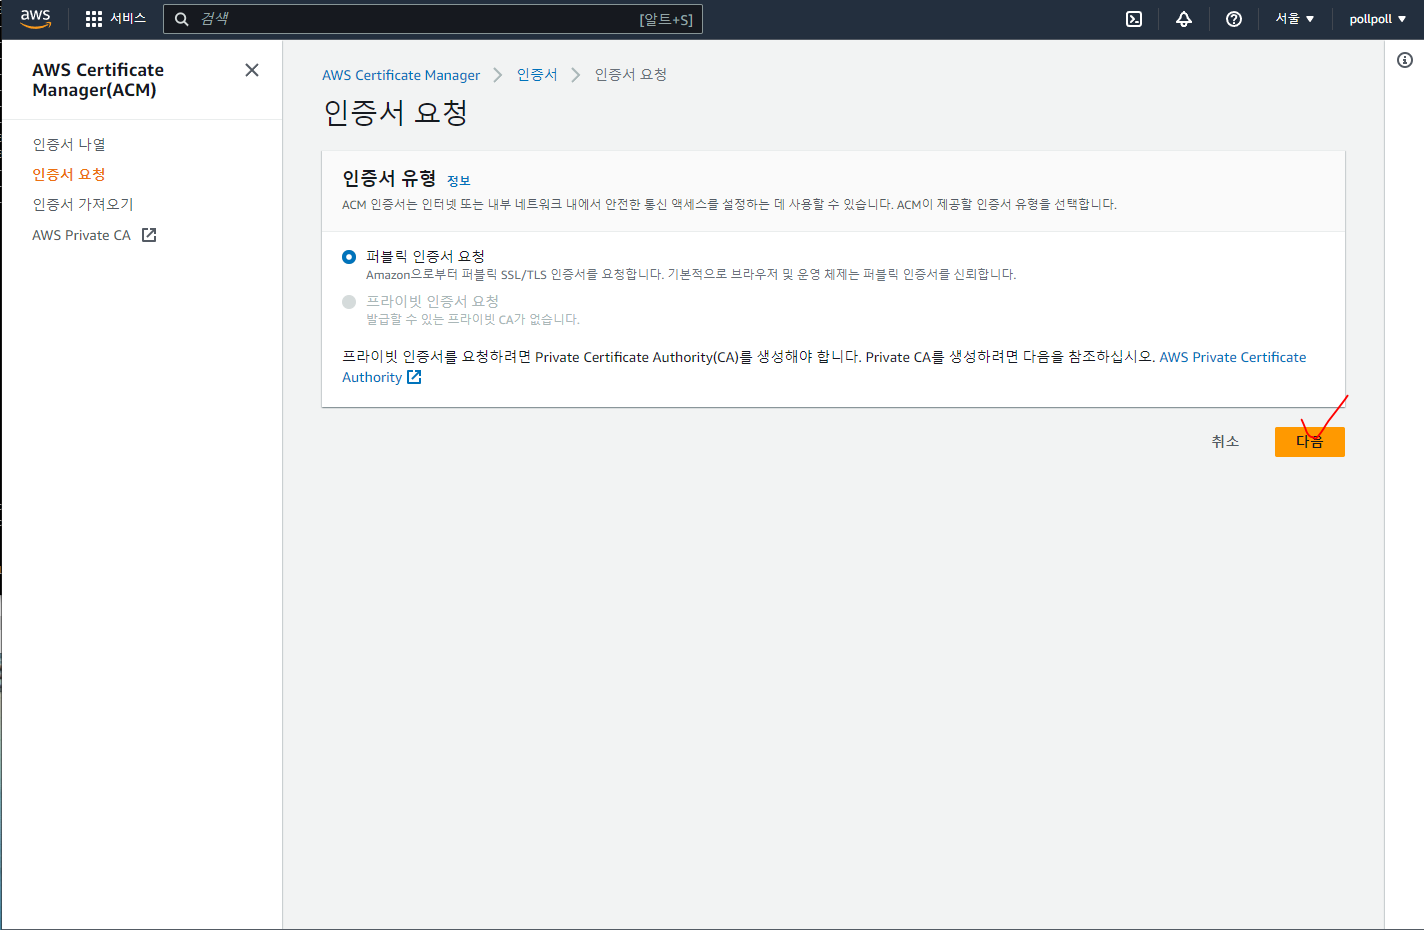
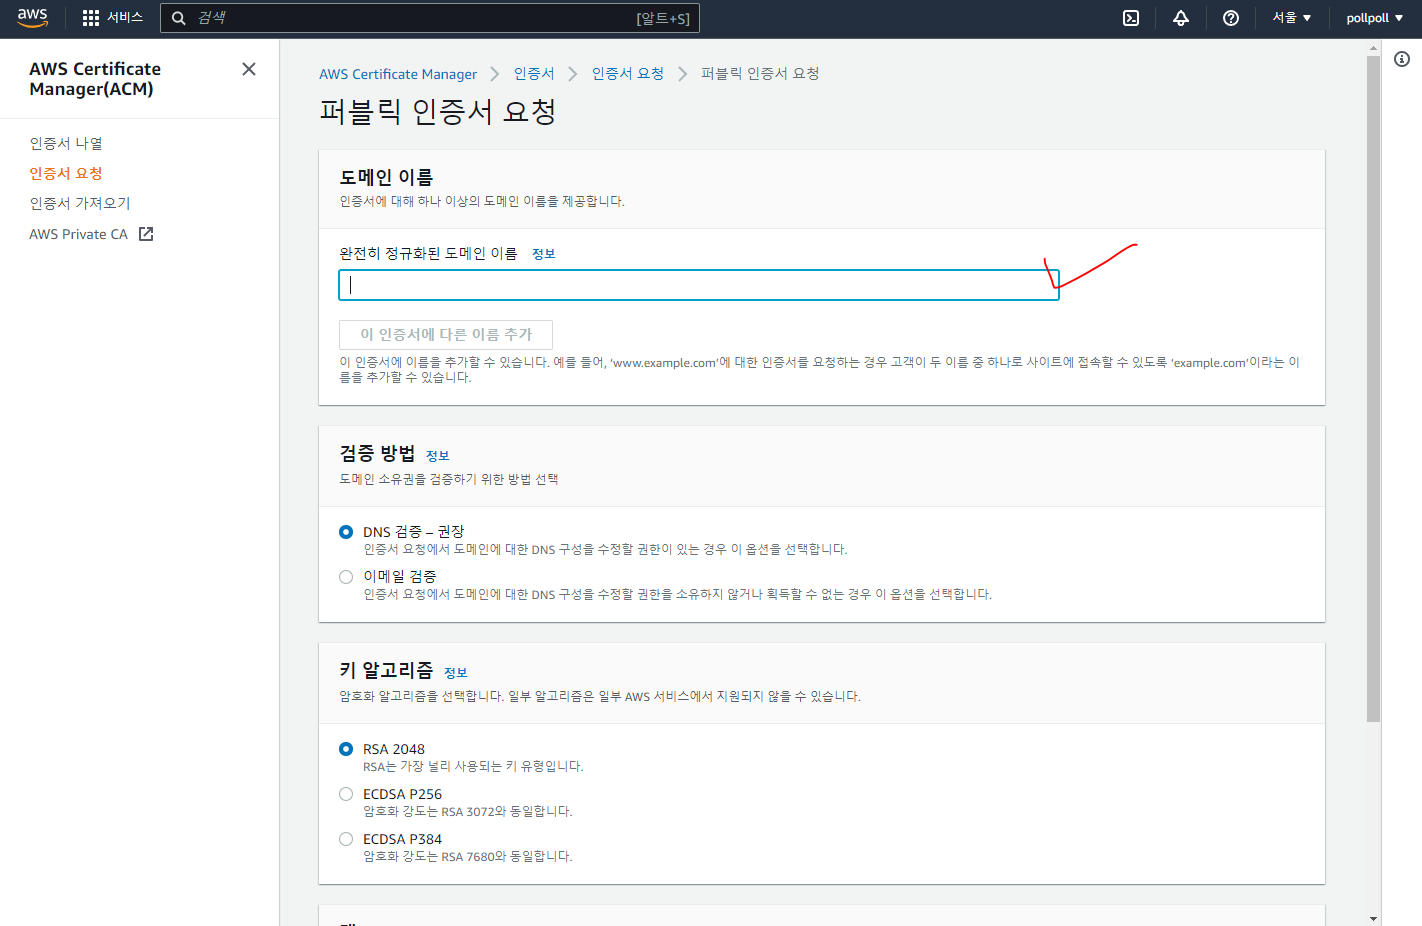
도메인 이름을 적고 나머지는 디폴트 설정으로 냅둔 뒤 "요청" 버튼을 누릅니다.
그러고 나면?
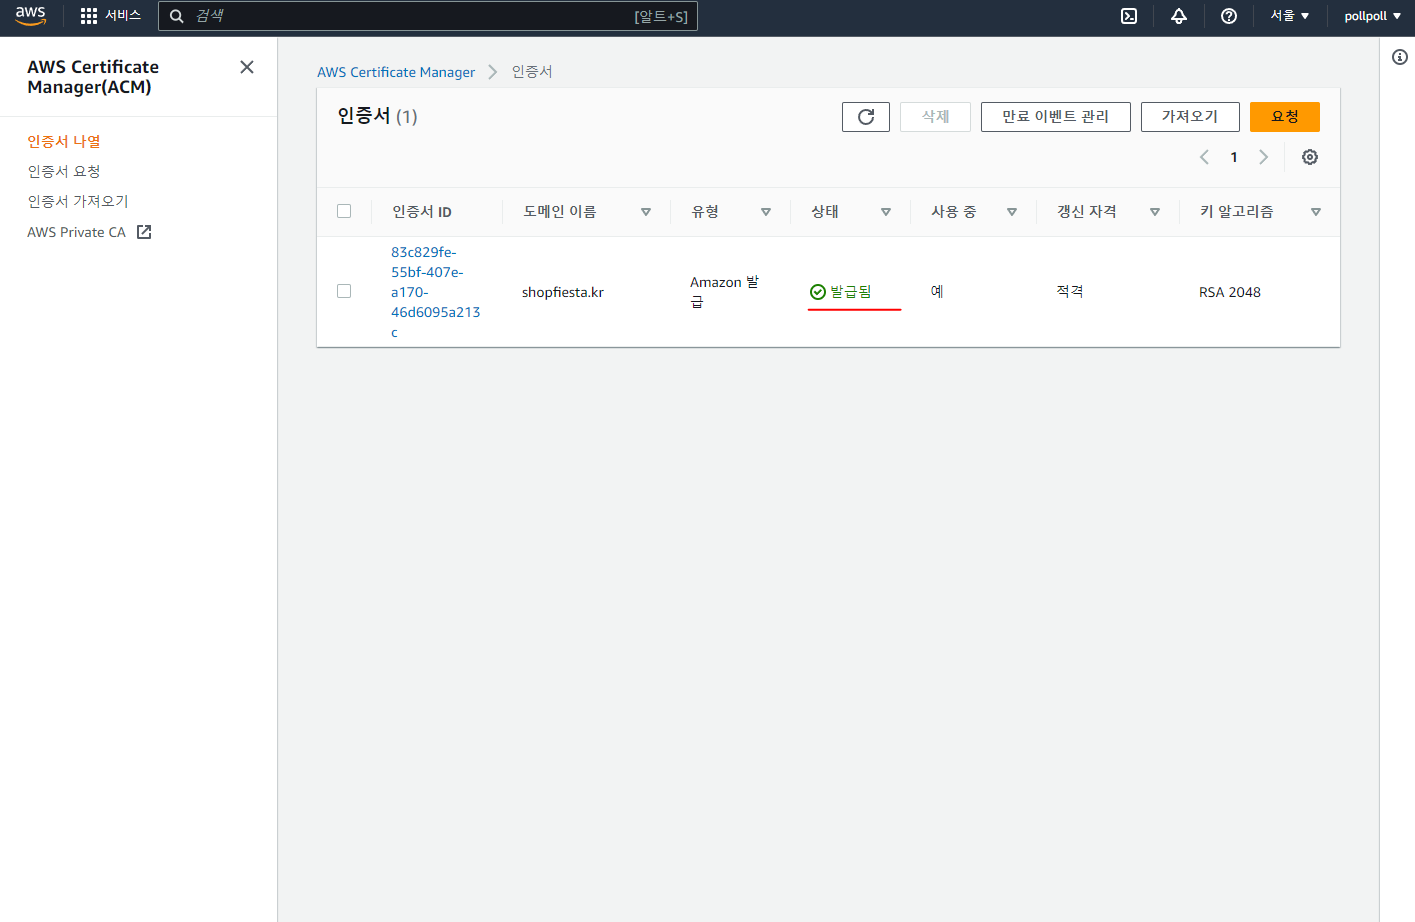
30분정도 기다리시면 발급이 됩니다.
혹시 이 과정에서 너무 발급이 안되는 분들은 아래와 같은 지침을 따라주세요.
• 인증서 ID 클릭
• 세부 내역으로 들어간 다음 "Route 53에서 레코드 생성" 을 클릭
• 아까 등록했던 Route 53을 클릭하고 다시 기다려보기
4. Target Group 생성하기
Target Group(대상그룹)은 EC2에 왼쪽 탭 아래부분에 존재합니다.
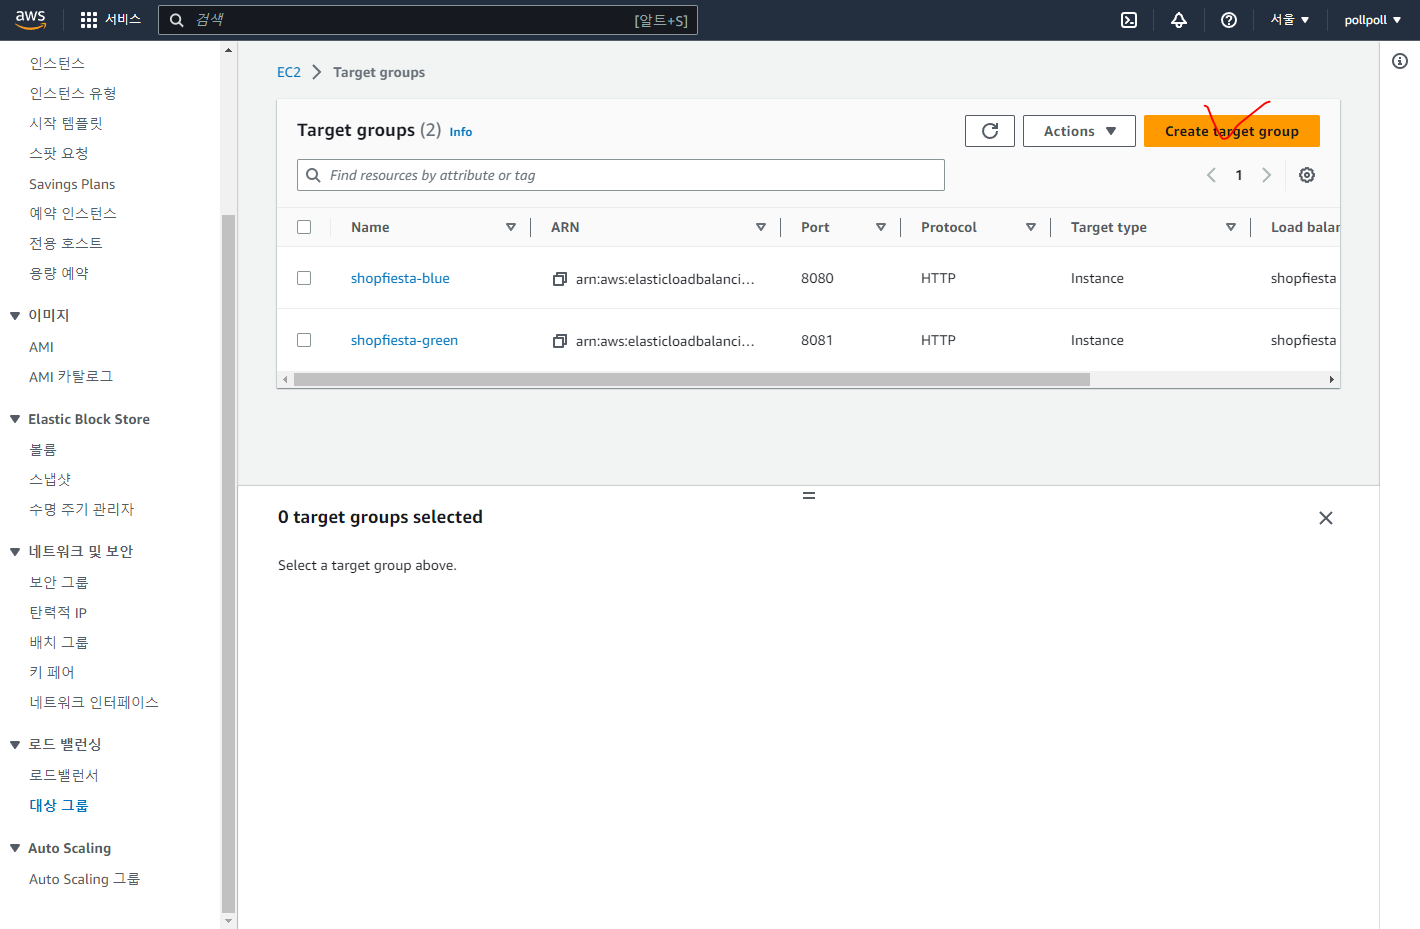
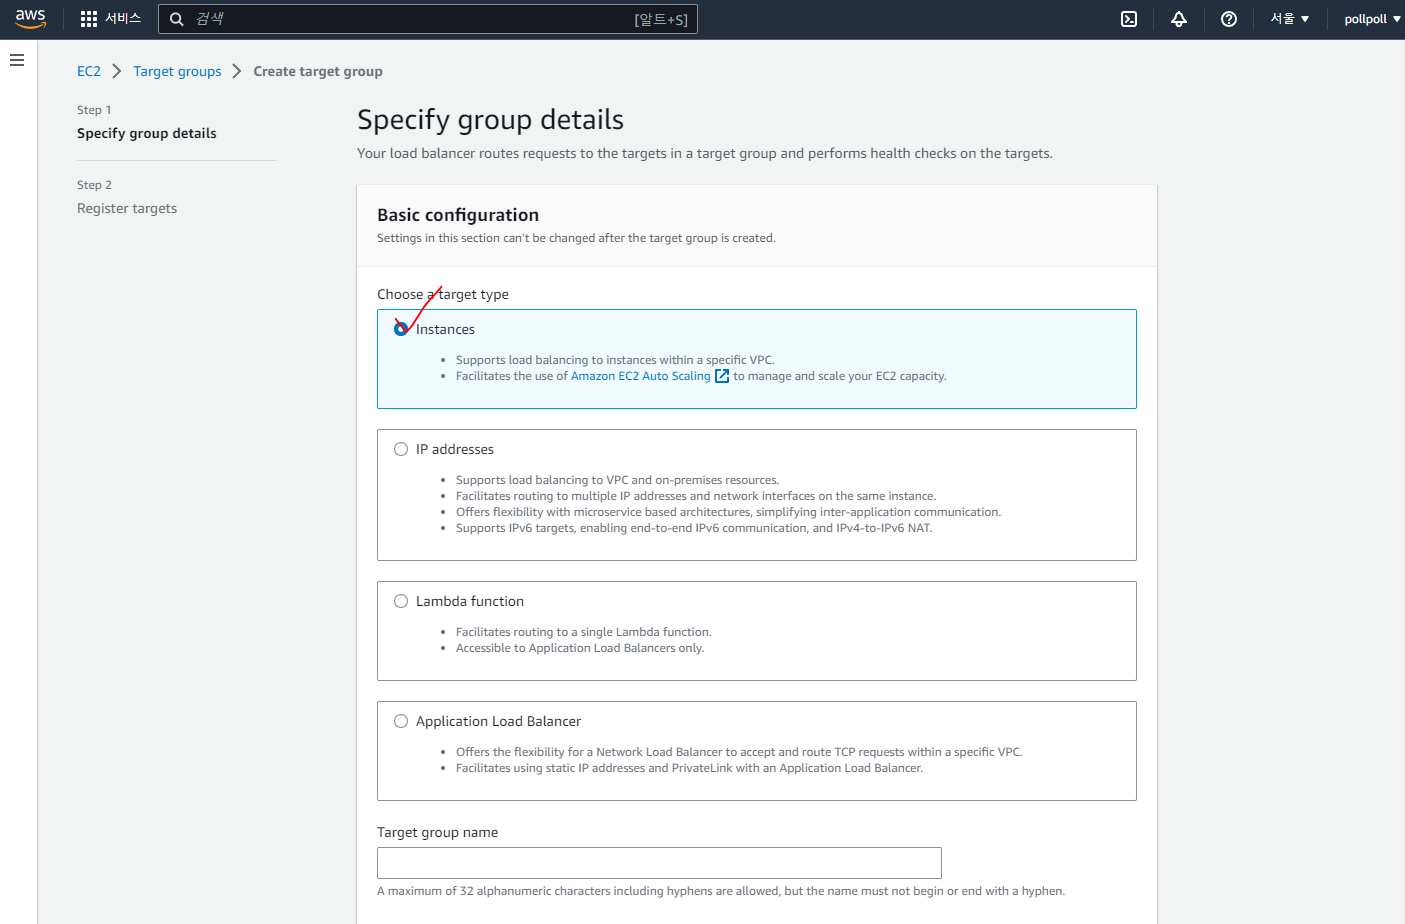
먼저 Target Type을 선택합니다. 디폴트 설정으로 되어있으므로 냅두시면 됩니다.
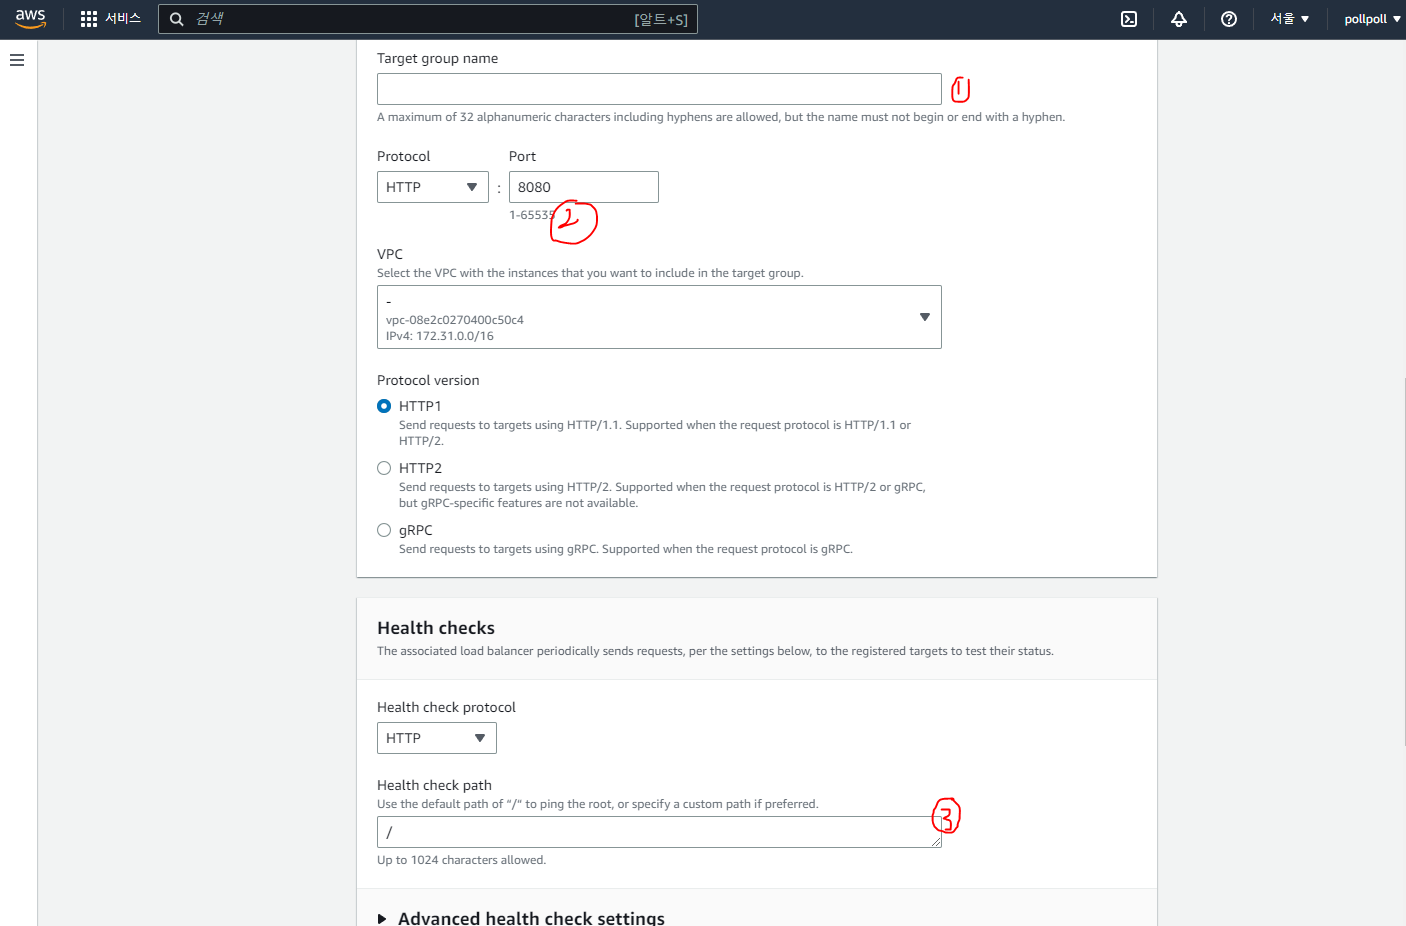
Target Group 이름을 고르고 현재 애플리케이션이 어떤 포트로 열려있는지 확인 후 적어줍니다.
그리고 Health check를 입력해야하는데 저는 Health check를 위한 API를 하나 만들어놨습니다. 이 부분을 제대로 설정하지 않으면 접근이 불가능하기 때문에 잘 설정하셔야합니다.
그리고 다음을 누르면?
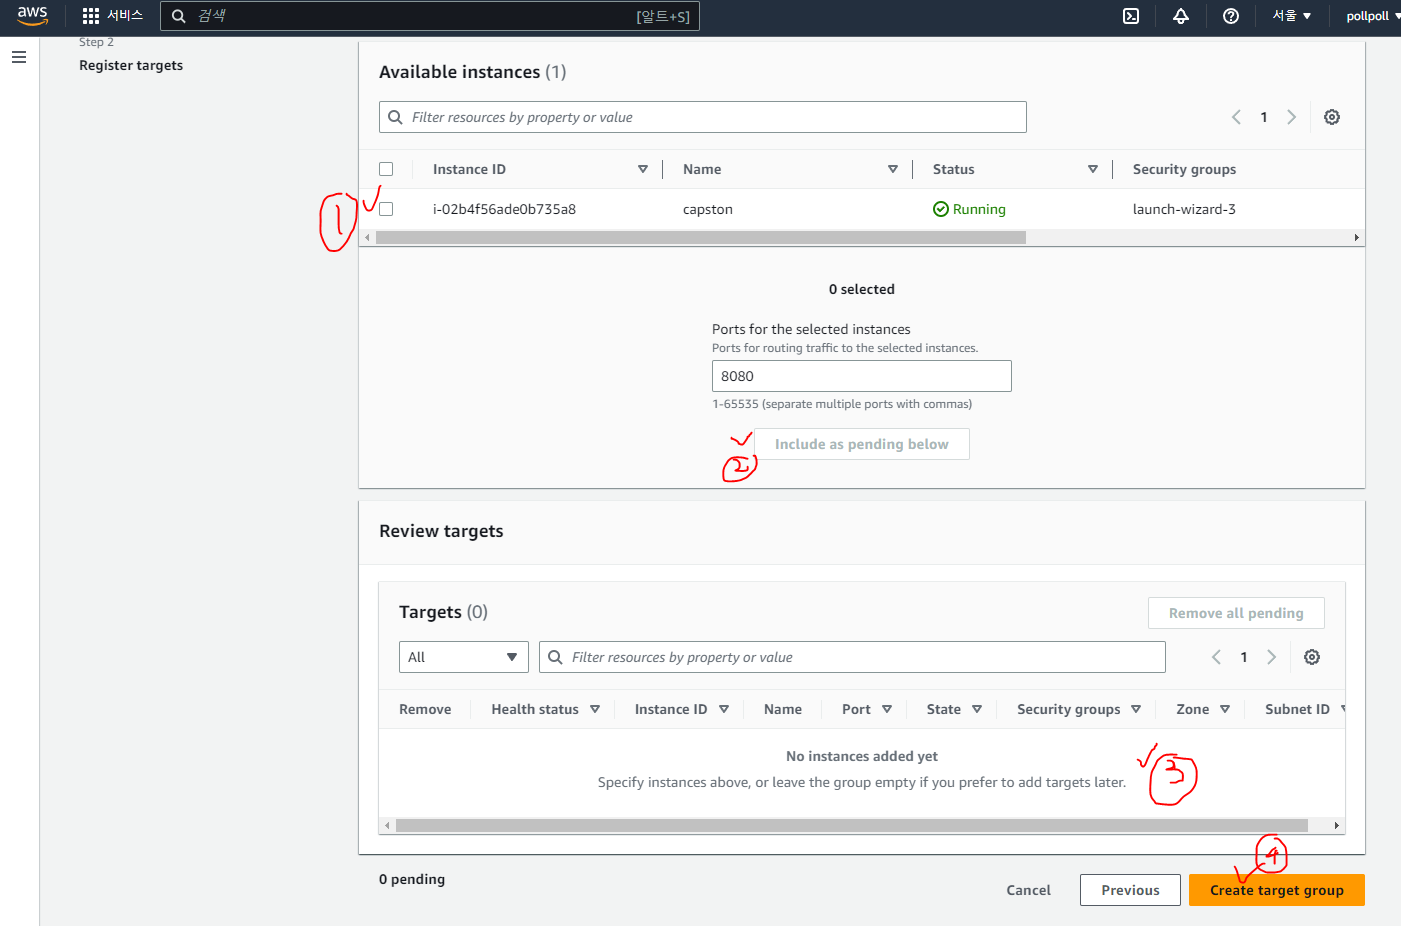
이 창이 나오는데 먼저 사용 가능한 EC2 인스턴스를 클릭하고 Include as pending below를 누릅니다. 그럼 3번에 선택된 인스턴스가 보여지게 되고 이후 Create target group을 누르면 됩니다.
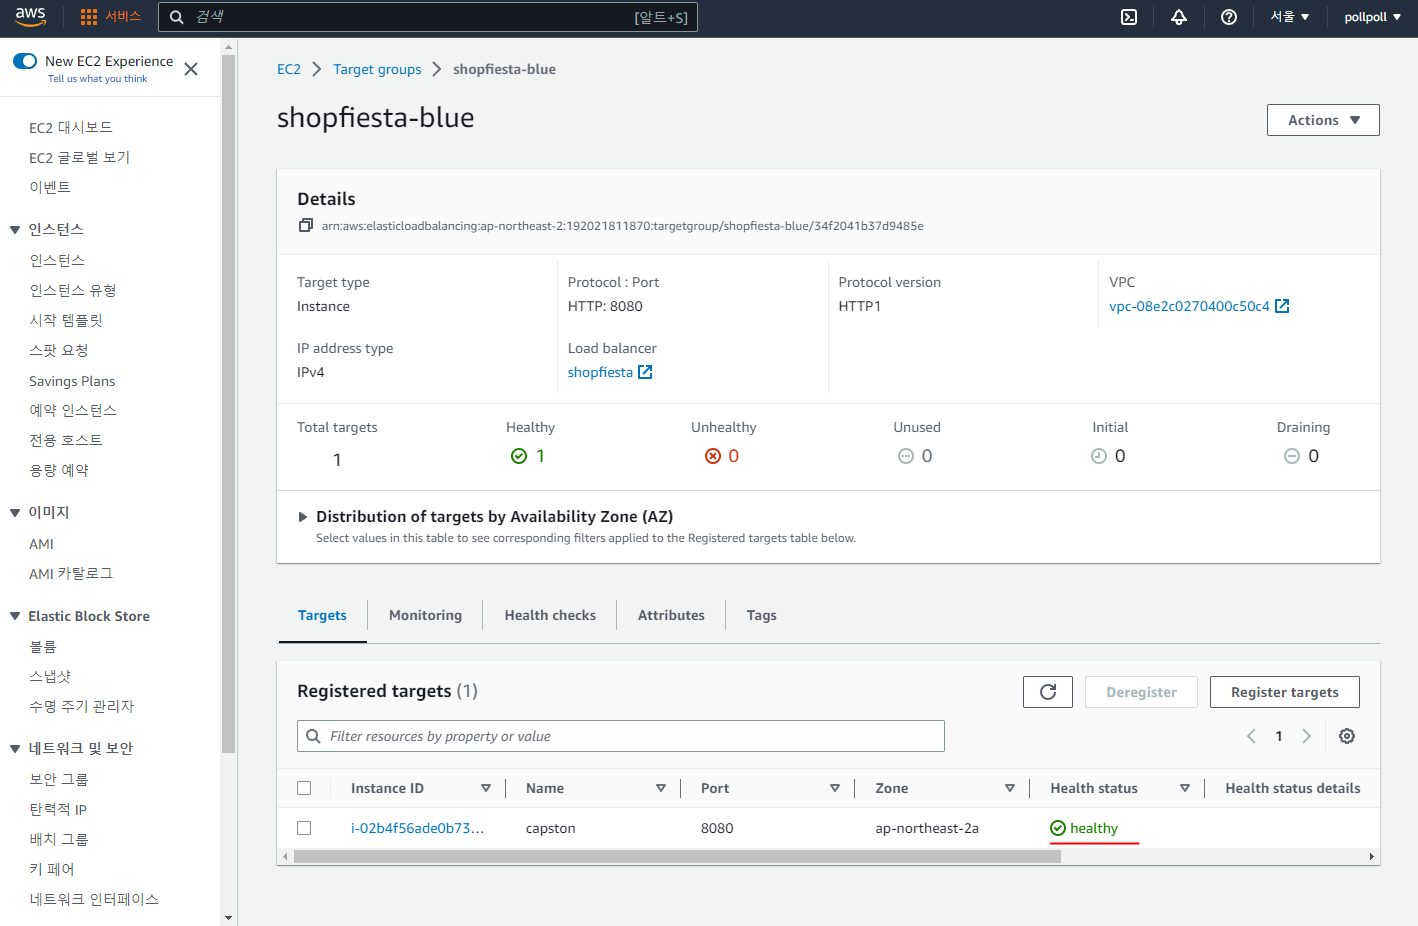
지금은 Health status가 unused 혹은 unhealthy로 되어있을 수 있습니다. 아직 괜찮습니다. 로드밸런서를 설정하고 다시 이부분으로 돌아오겠습니다.
포스팅이 너무 길어졌으니 다음편으로 나눠서 진행하겠습니다.
ACM + ALB 를 이용해 HTTPS 적용하기 (2)
이전 포스팅과 이어집니다.
https://coding-review.tistory.com/432
5. ELB (ALB) 설정하기
로드 밸런서는 EC2 왼쪽 탭 아래쪽에 존재합니다.
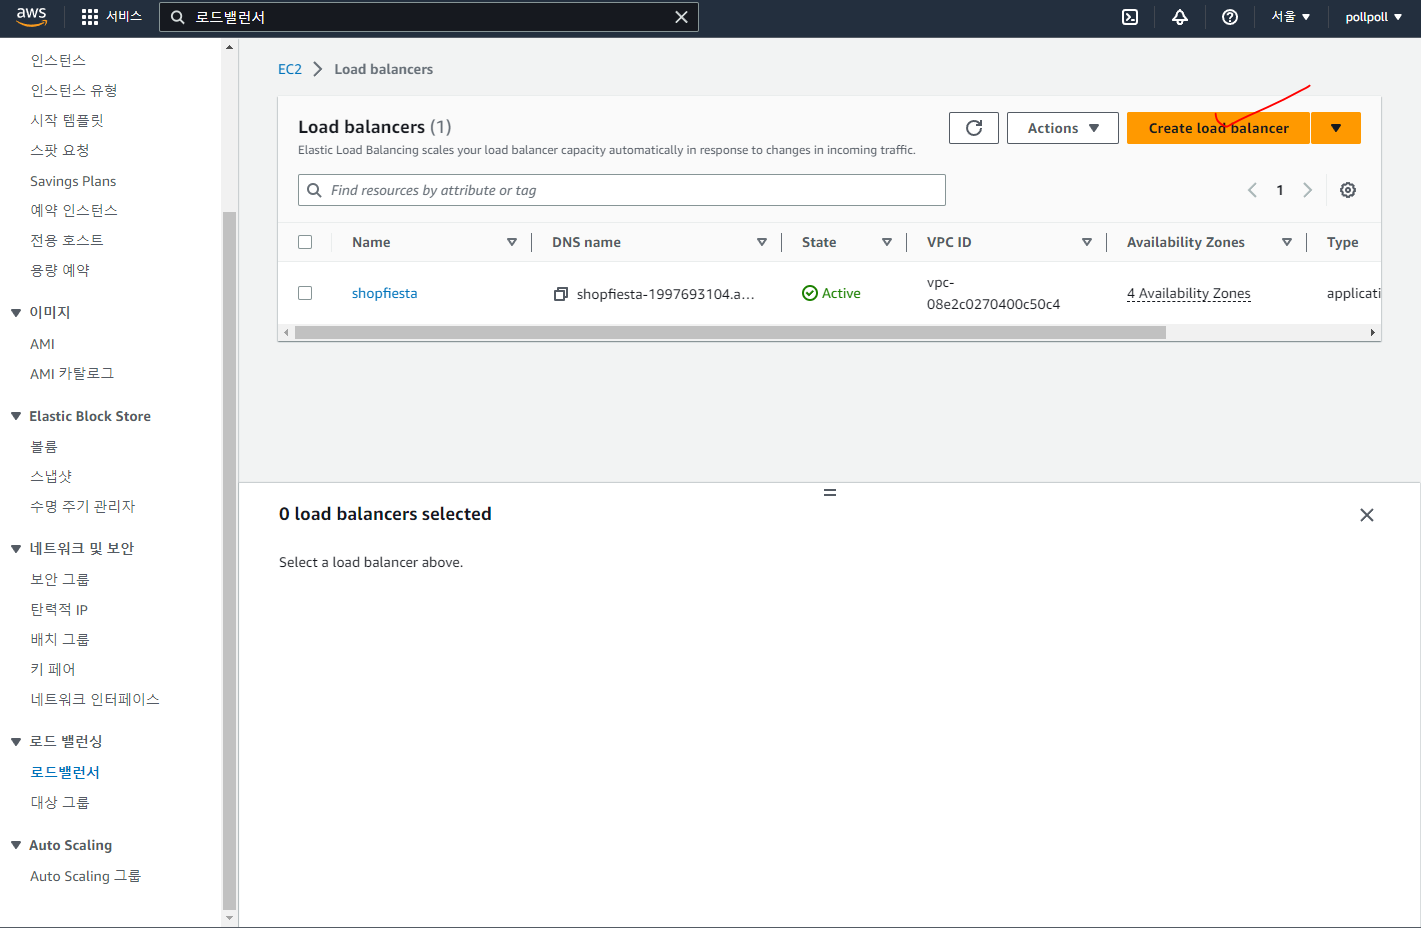
우리는 ALB 를 선택할겁니다. Application Load Balancer 를 선택합니다.
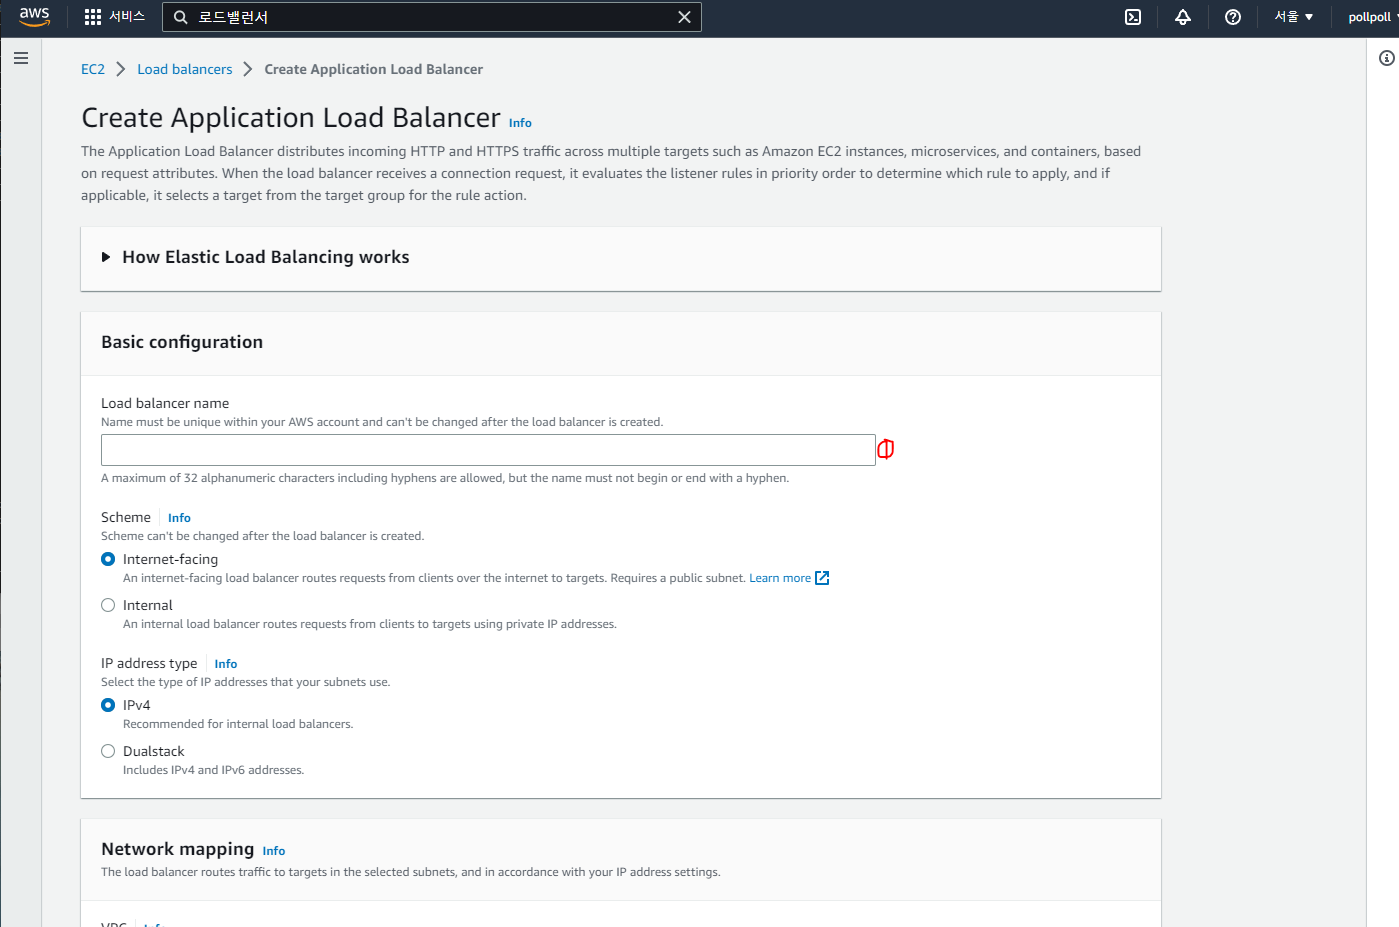
우선 로드밸런서 이름을 작성하고요.
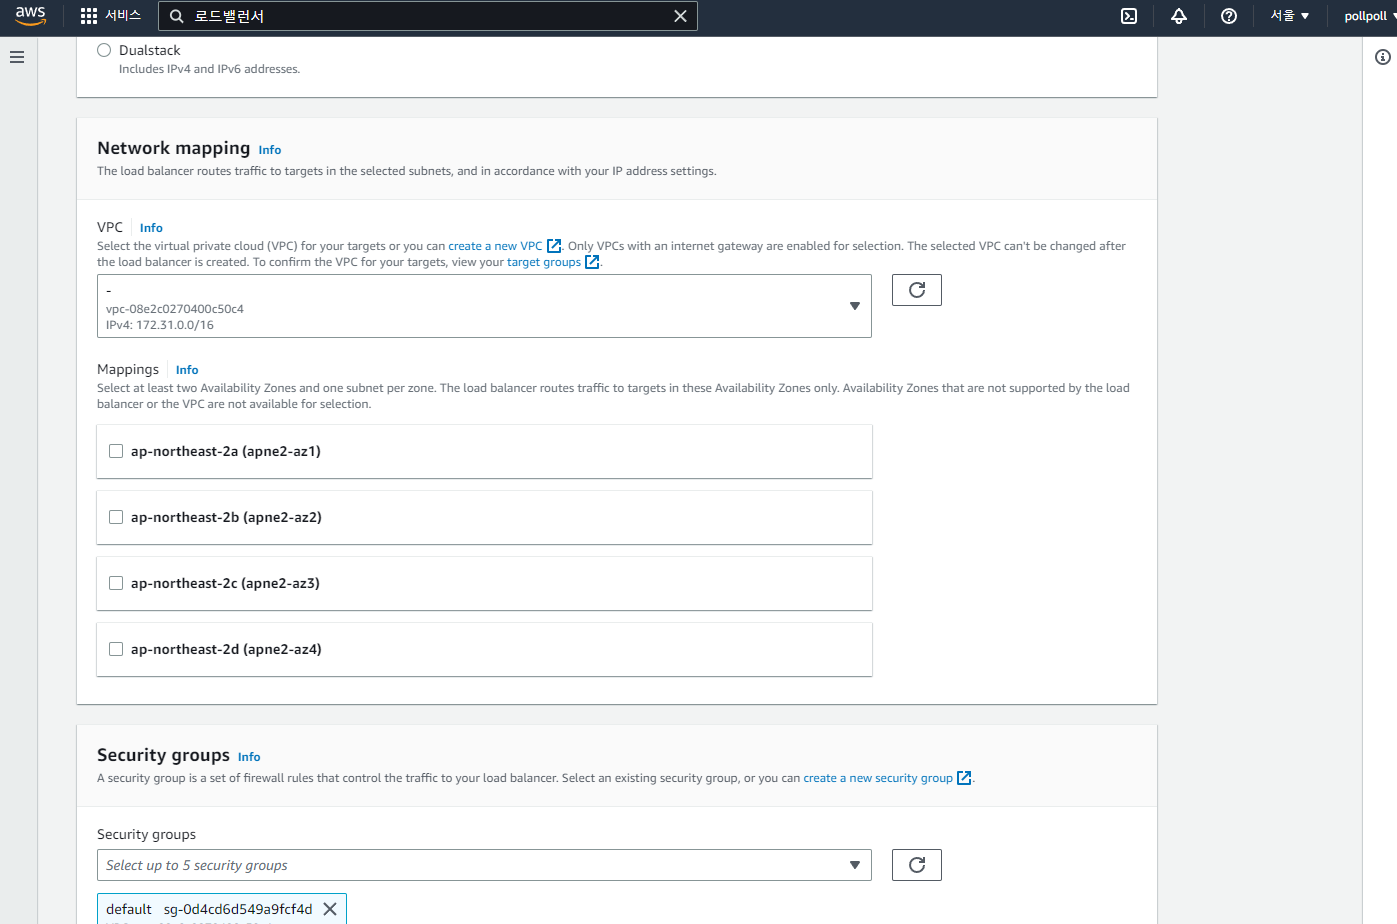
네트워크 매핑은 자신의 EC2가 어떤 지역에 떠있는지에 따라 선택해야 하는것이 다릅니다. (사실 네개 전부 클릭하면 됩니다.) 저는 시원하게 네개 전부 클릭했습니다.
최소 두개만 선택하면 되기 때문에 두개만 선택하고 싶으신 분들은 자신의 EC2 인스턴스가 어떤 지역에서 운영되고 있는지 확인하고 그 지역에 해당하는 네트워크 매핑을 선택하시면 됩니다.
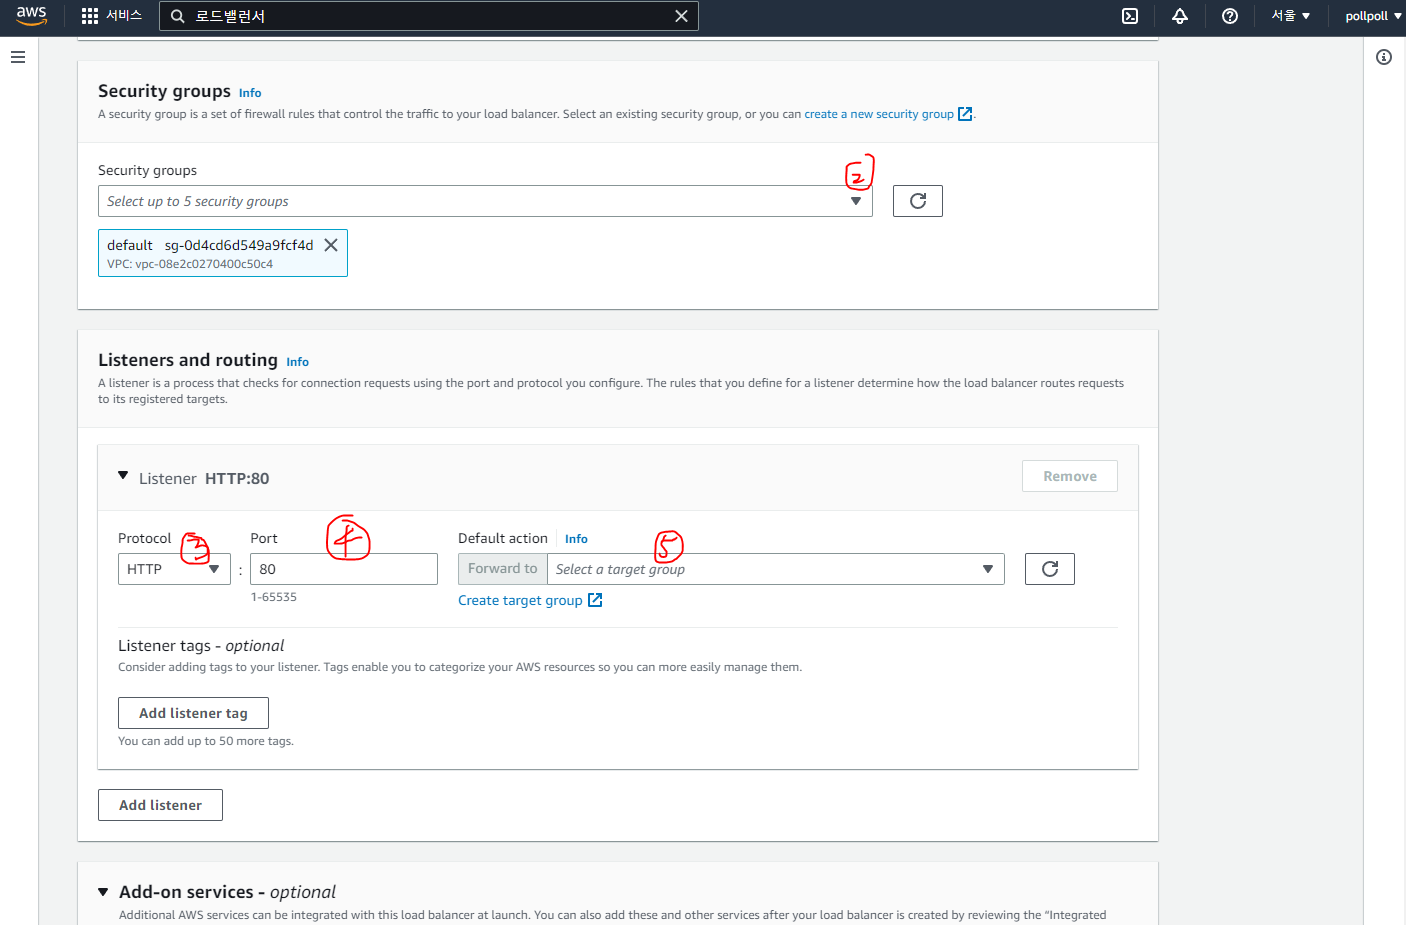
③ HTTPS를 선택하고 ④ 어떤 포트로 매핑할 것인지 입력해줍니다. ⑤그리고 아까 우리가 만든 Target Group 을 선택해줍니다.
이제 Create Load Balancer 를 눌러주면 됩니다.
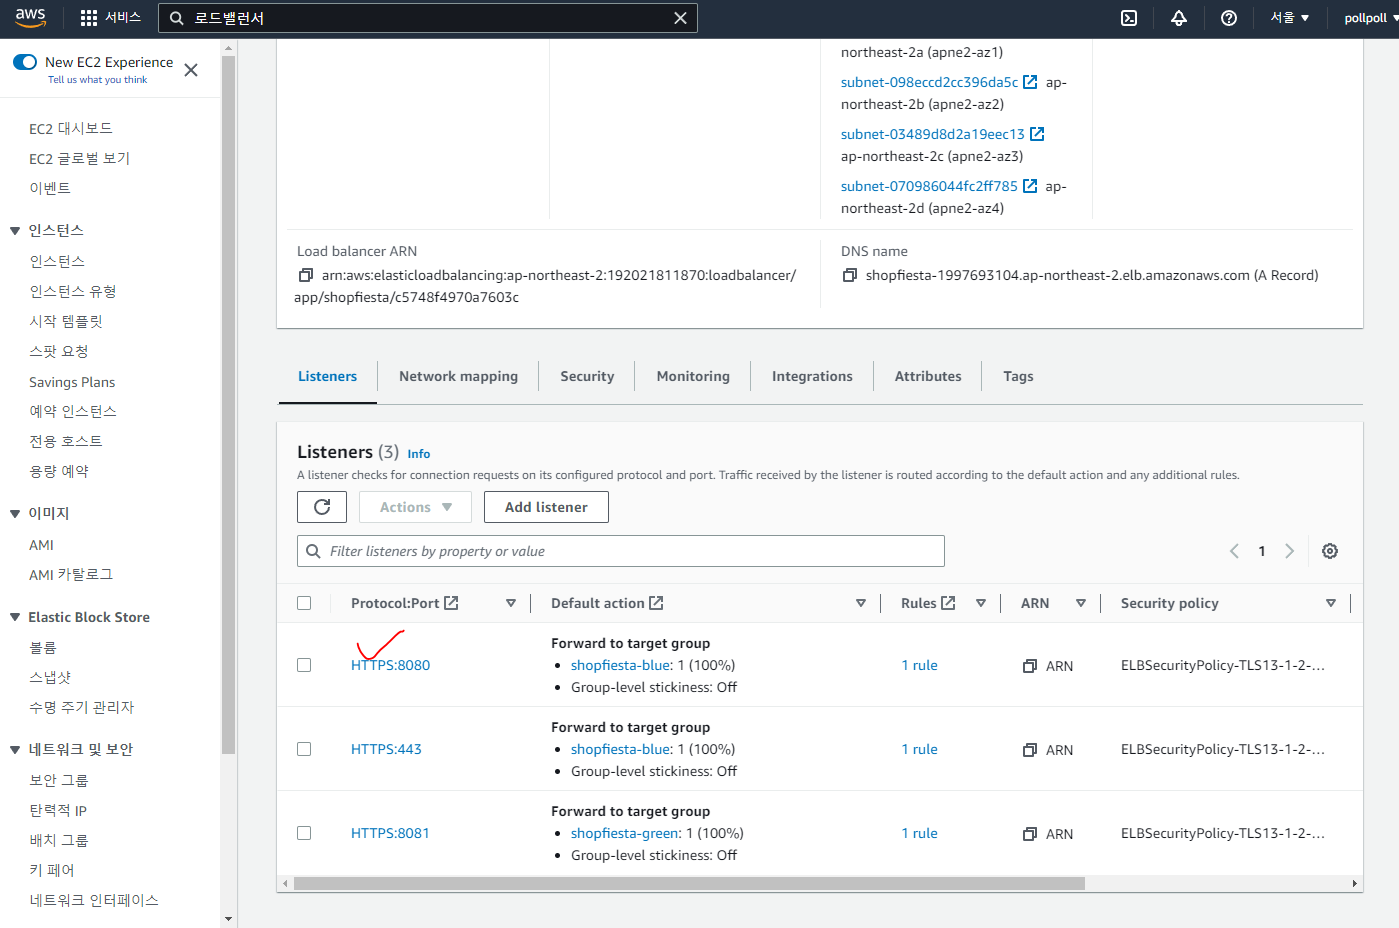
우리의 로드밸런서로 들어와서 방금 만든 리스너를 클릭합니다.
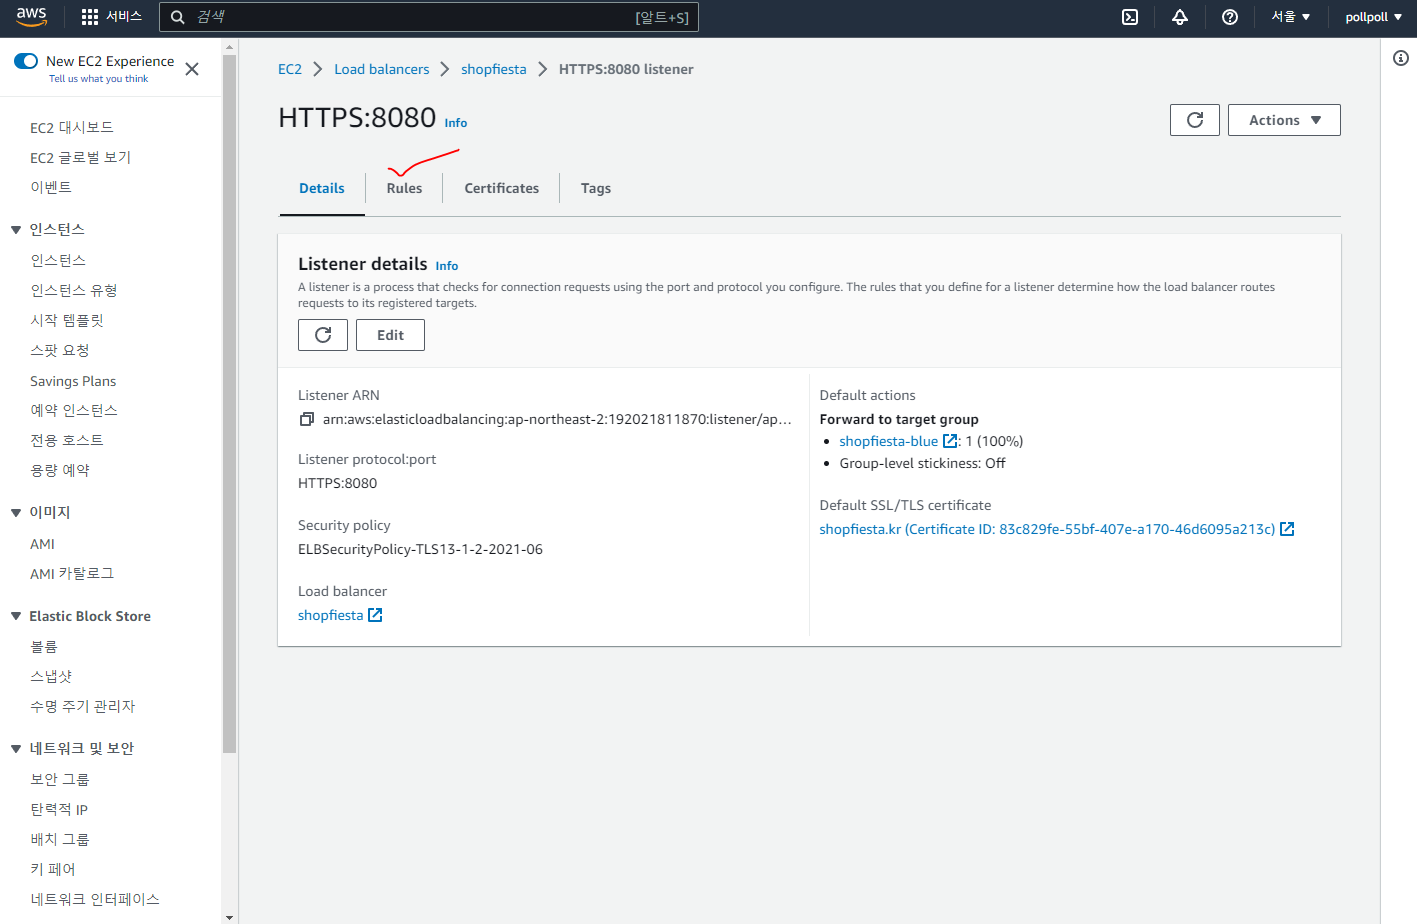
Rules로 들어오시고
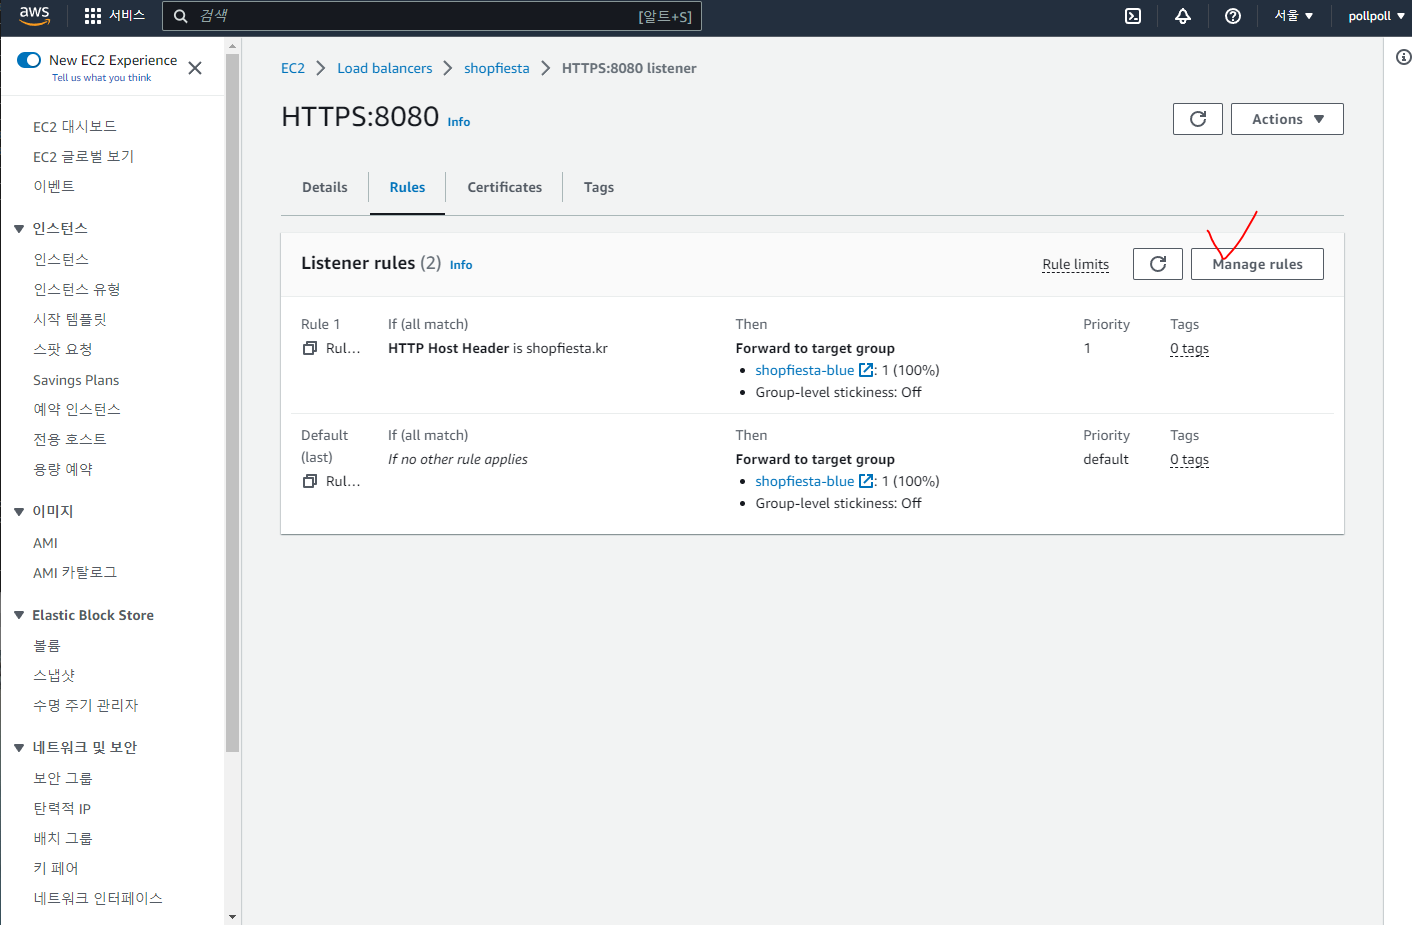
Manage rules를 클릭합니다.
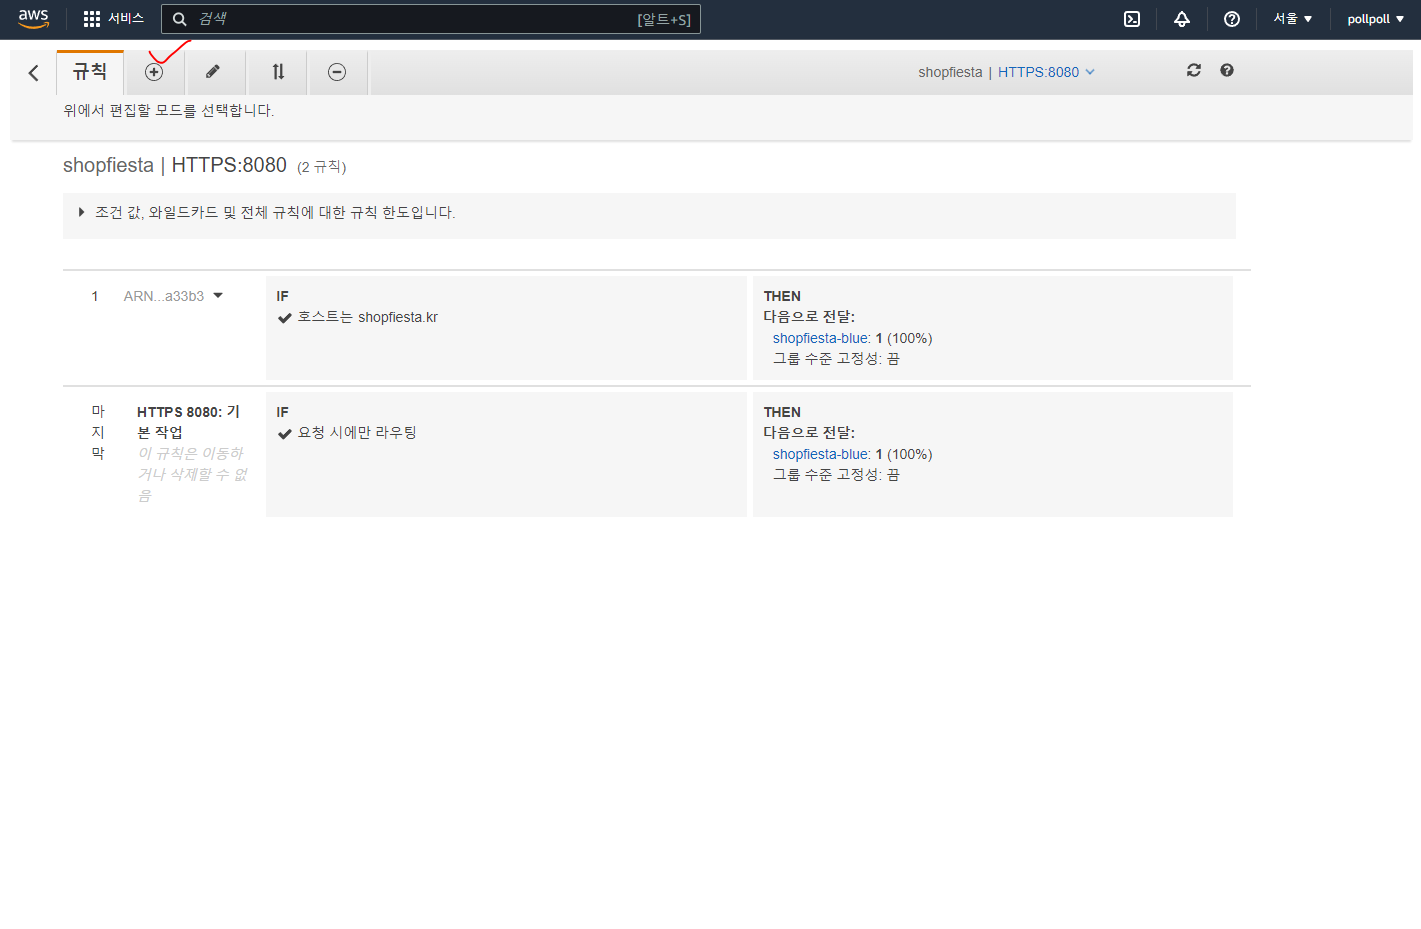
위에 플러스 버튼을 누릅니다.
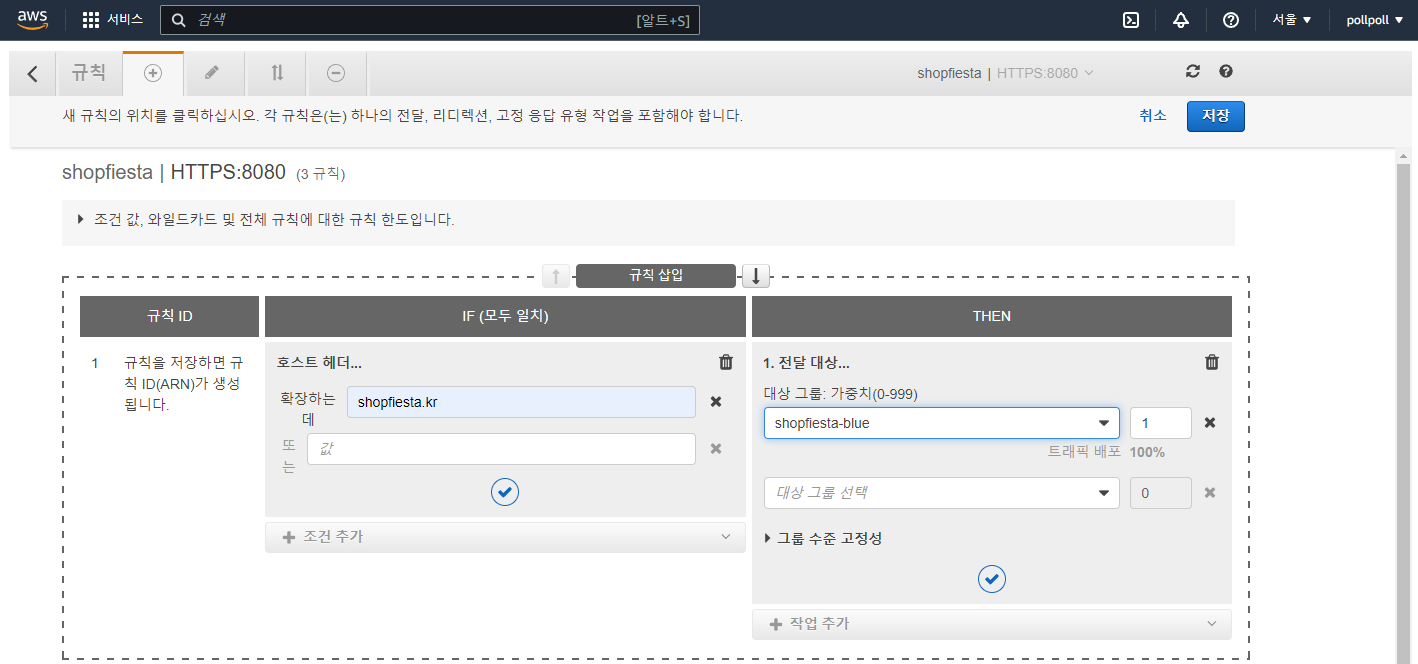
위와같이 설정해줍니다. IF 부분에는 호스트헤더 클릭 > 자신의 도메인 입력 > THEN 부분에는 전달 대상 클릭 > 우리가 만든 대상 그룹 선택
이제 다시 대상 그룹으로 돌아와봅니다.
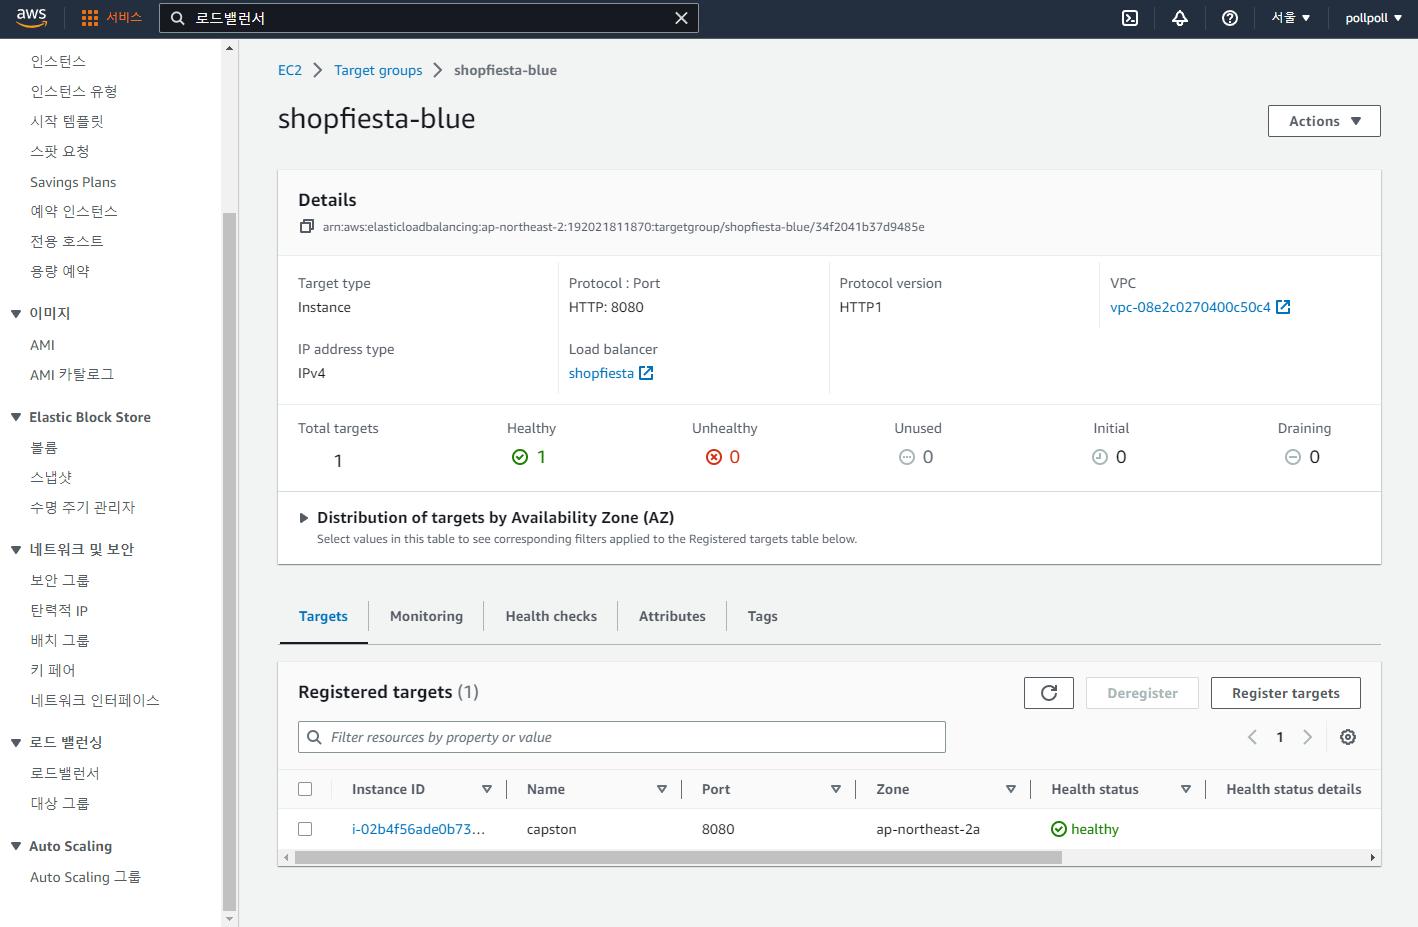
Health status가 healthy가 떴습니다. 여기까지 오시면 거의 다온겁니다.
6. Route 53에 우리의 로드밸런서 등록하기
다시 Route 53으로 돌아갑니다.
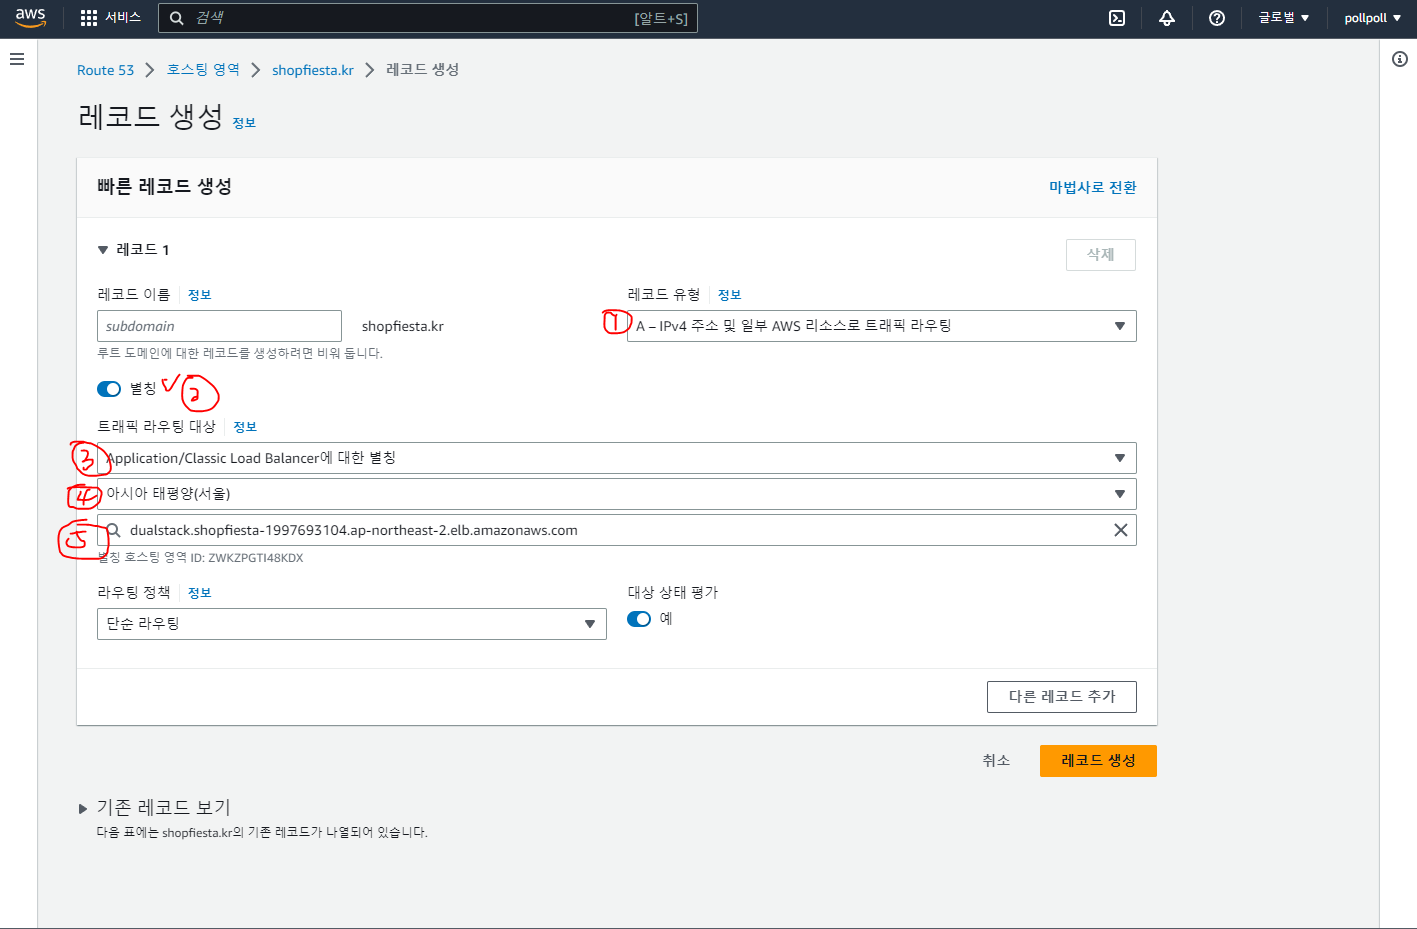
레코드 생성을 누르시고 위와같이 설정합니다.
그리고 8080포트로 들어가보면?
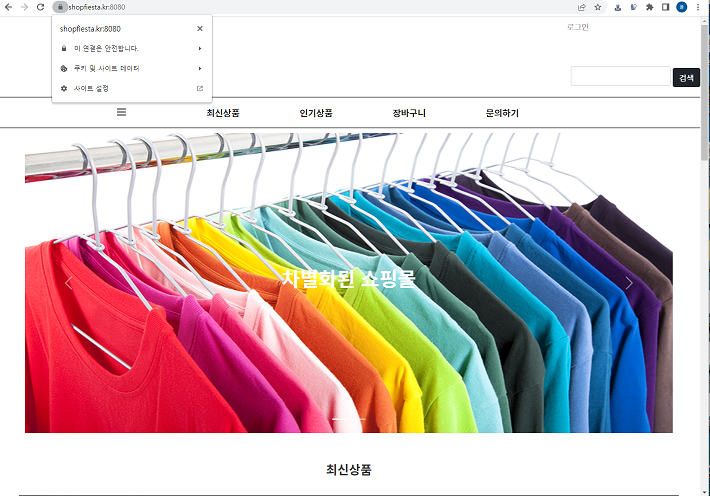
잘 적용됐습니다.
마치며
이렇게 AWS로 HTTPS를 적용해봤습니다. 역시 클라우드는 정말 힘드네요... 데브옵스 개발자는 할게 못되는 것 같습니다. 뭐가 잘 안되면 로그를 볼 수도 없고... 디버깅도 못하고... 레퍼런스도 부족하고... 정말 쉽지않았습니다.
수많은 삽질이 있었는데요. 수많은 삽질을 이겨내고 성공해서 다행입니다.
긴 글 읽어주셔서 감사합니다. 오늘도 즐거운 하루 되세요~
스프링 Redirect 시 HTTPS 접근이 아니라 막히는 현상
배포 버전에서 HTTPS 접근이 아닌 HTTP 접근이기 때문에 넘어갈 수 없다는 페이지를 만났습니다.
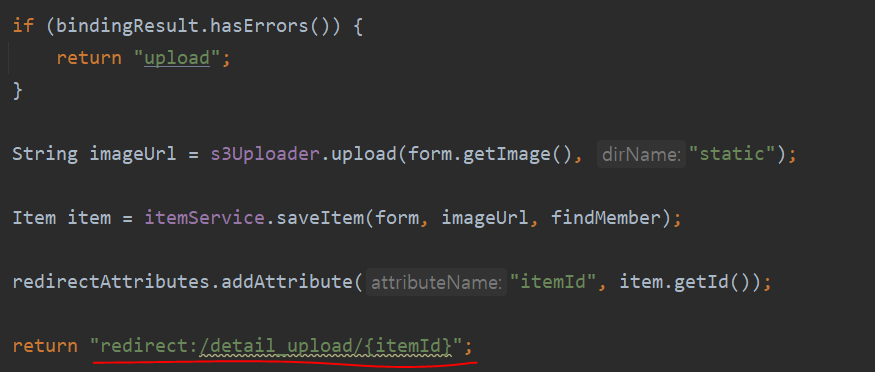
때문에 다음으로 넘어가야 하는 상황에서 다음으로 넘어가지 못하고 멈추는 상황이 반복되었습니다.
이는 반드시 해결해야 하는 문제였기 때문에 어떤 부분이 문제일까 고민했습니다.
문제에 대해 몇가지 해결책이 떠올랐습니다.
• HttpServletResponse 객체를 받아와서 sendRedirect로 바꾼다.
• 로드밸런서의 80포트를 HTTPS로 열어준다.
1번같은 경우는 시도해봤지만 다시 페이지로 리턴해야 하는 상황이었어서 성공하지 못했습니다.
때문에 2번으로 넘어갔습니다.
"HTTPS 요청이 와야하는데 HTTP 요청이 왔다는 얘기니까 HTTP 요청을 HTTPS로 바꿔주면 되는거 아냐?"
접근 자체는 좋았지만 이런다고 문제가 해결되지는 않았습니다.
여러번 고민한 끝에 저는 "그럼 HTTP 요청을 80포트로 받고 443 포트 (HTTPS 포트) 로 리다이렉트 시켜줄까?"
결과적으로 이 방법이 옳았습니다.
먼저 AWS EC2에서 로드밸런서에 들어가줍니다.
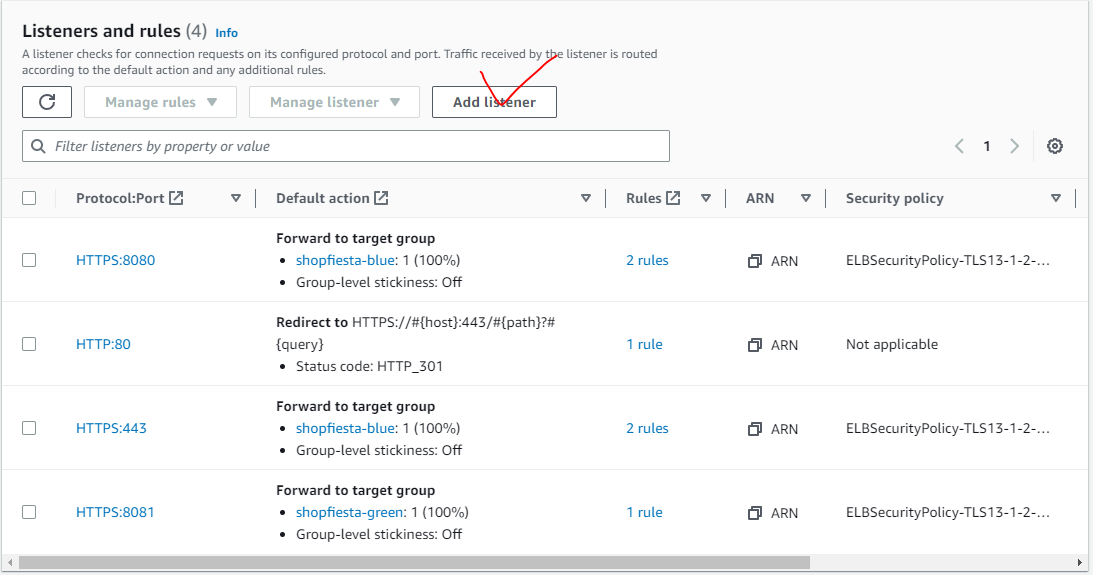
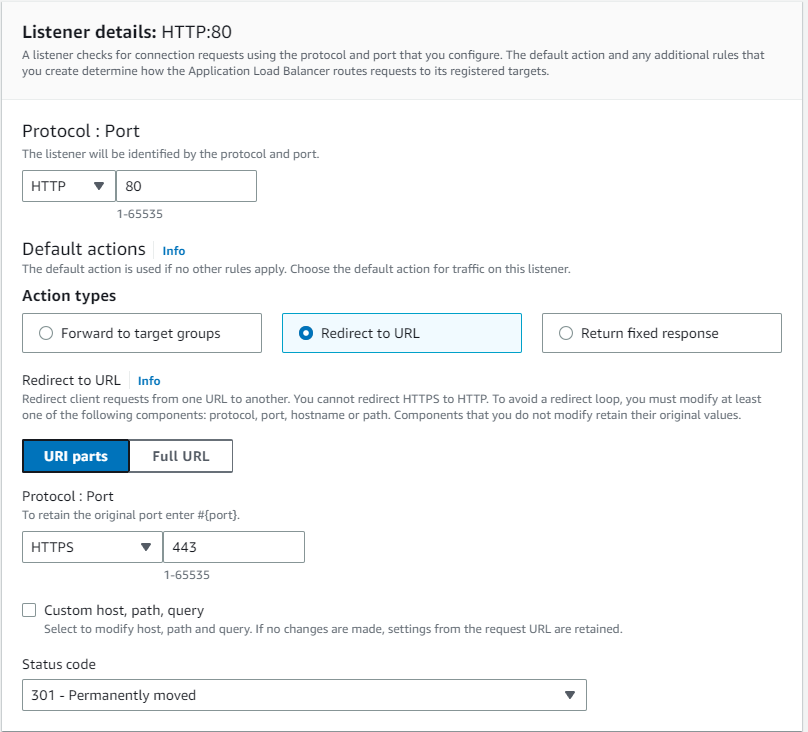
이렇게 리다이렉트 조건을 걸어주면?
문제가 해결됩니다...
마치며
문제를 해결하느데만 초점이 맞춰져서 스샷을 찍지 못한 점 양해부탁드립니다. 로드밸런서를 만져준다는게 정말 어렵군요... Nginx로 하면 더 어려울거같은데 나중엔 Nginx로도 로드밸런서 설정을 만져보도록 하겠습니다.
긴 글 읽어주셔서 감사합니다. 오늘도 즐거운 하루 되세요~
AWS CLI로 로드밸런서 타겟그룹 바꾸기
블루 그린 배포를 하는 과정에서 한 가지 문제가 생겼습니다. AWS의 로드밸런서인 ALB의 타겟그룹을 수동으로 바꿔줘야 한다는 것이었죠.
CLI로 타겟 그룹을 바꿀 수 있다는 사실을 몰랐던지라 이를 어떻게 자동화할지 몰랐고 덕분에 컨테이너와 이미지를 없애고 다시 블루 버전을 띄워서 블루 그린 배포인데 블루 버전만 사용하는 아이러니함이 생겼죠.
새로운 프로젝트를 진행하다가 챗 지피티한테 궁금해서 물어봤습니다.
"AWS CLI로 타겟 그룹을 변경할 수 있어?"
"그럼요~"
예제 코드까지 친절하게 알려줘서 덕분에 성공할 수 있었습니다 (GPT 최고!).
그럼 이제 본격적으로 AWS CLI로 타겟 그룹을 변경하는 포스팅을 진행해보도록 하겠습니다.
AWS CLI가 뭐야?
우리는 AWS의 시스템을 이용할 때 AWS 사이트에서 진행합니다. 이는 정말 편하지요. 하지만 우리는 AWS를 리눅스 환경에서 조작하고 싶을 때가 있습니다.
그럴 때 사용하는 것이 바로 CLI (씨엘아이) 입니다. 같은 느낌으로 깃허브도 CLI가 있습니다.
AWS CLI를 사용하기 위해서는 먼저 리눅스 환경에 AWS CLI를 설치해야합니다.
$ curl "https://awscli.amazonaws.com/awscli-exe-linux-x86_64.zip" -o "awscliv2.zip"
$ unzip awscliv2.zip
$ sudo ./aws/install
$ aws --version
aws-cli/2.7.9 Python/3.9.11 Linux/5.13.0-51-generic exe/x86_64.ubuntu.20 prompt/off
$ rm -f awscliv2.zip # 설치 되었으면 zip 파일은 지워주도록 합시다. 용량이 넉넉하지 않으니..
이렇게 하고 이제 AWS의 설정정보를 갱신해줘야합니다. 우리가 사용할 사용자를 만들어야한다는 의미이죠.
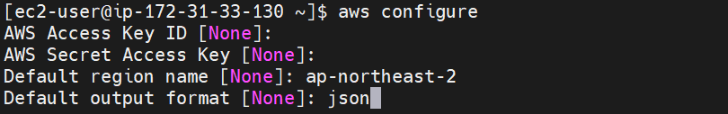
이렇게 aws 설정을 통해 자신이 누구인지 리눅스 운영체제에 알려야합니다. 이 데이터를 기반으로 IAM같은 클라우드 정보도 이용할 수 있기 때문입니다.
자신의 Access Key와 Secret Access Key를 입력하고 지역, 포맷을 입력하면 끝입니다.
이제 준비는 끝났습니다. CLI로 AWS를 조종해봅시다.
$ AWS_PAGER="" aws elbv2 describe-listeners --load-balancer-arn <YOUR-LOAD-BALANCER-ARN>
어? 근데 ARN은 뭘까요?
ARN은 쉽게 말해서 UUID와 같은 역할을 한다고 보시면 됩니다. CLI를 위한 UUID이죠.
이 ARN은 다양한 곳에서 확인할 수 있습니다.
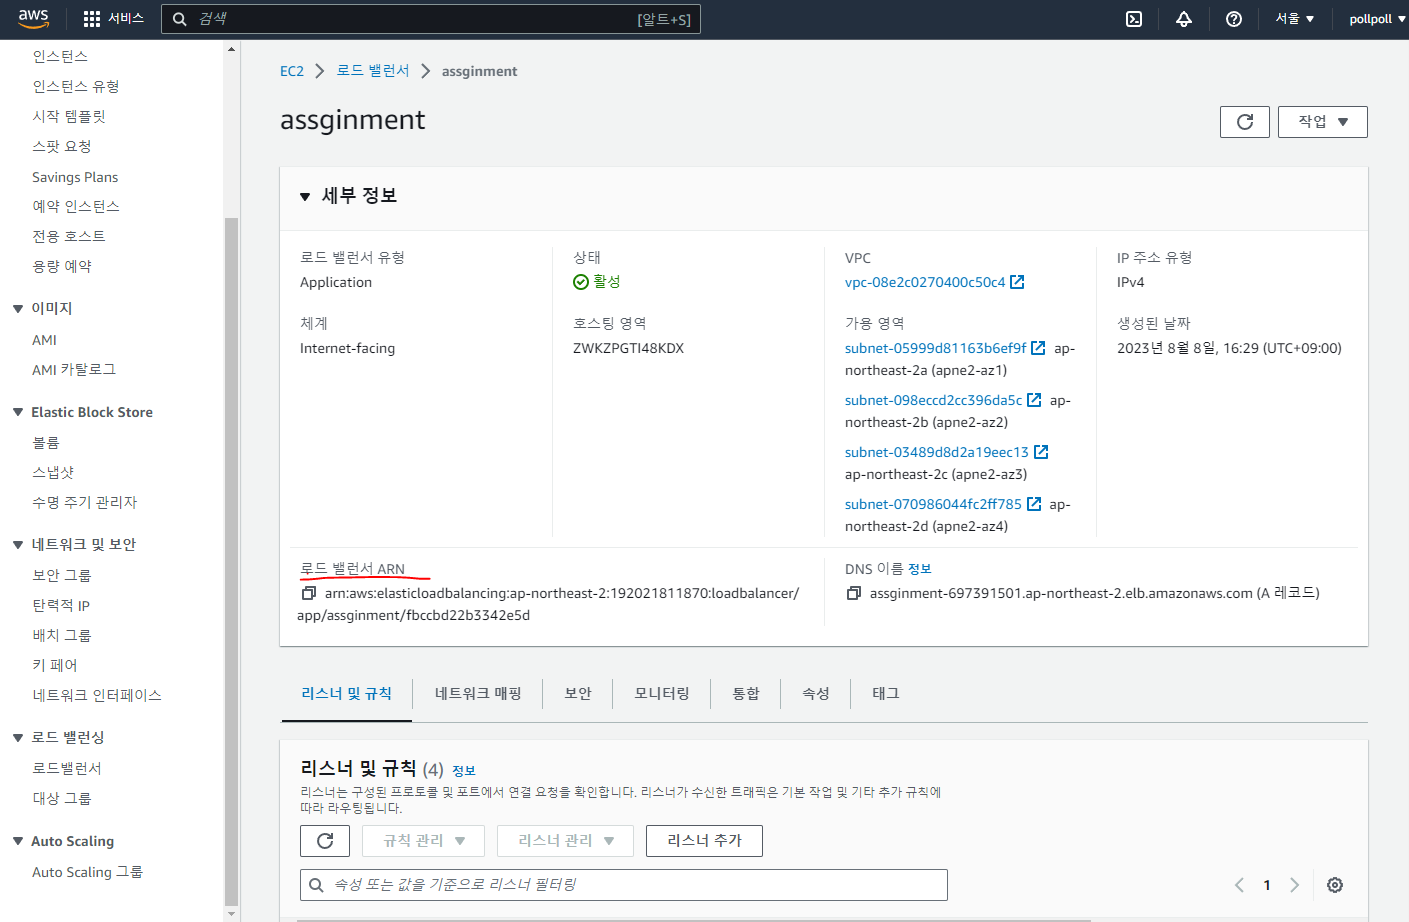
우리의 로드 밸런서에도 이렇게 볼 수 있구요.
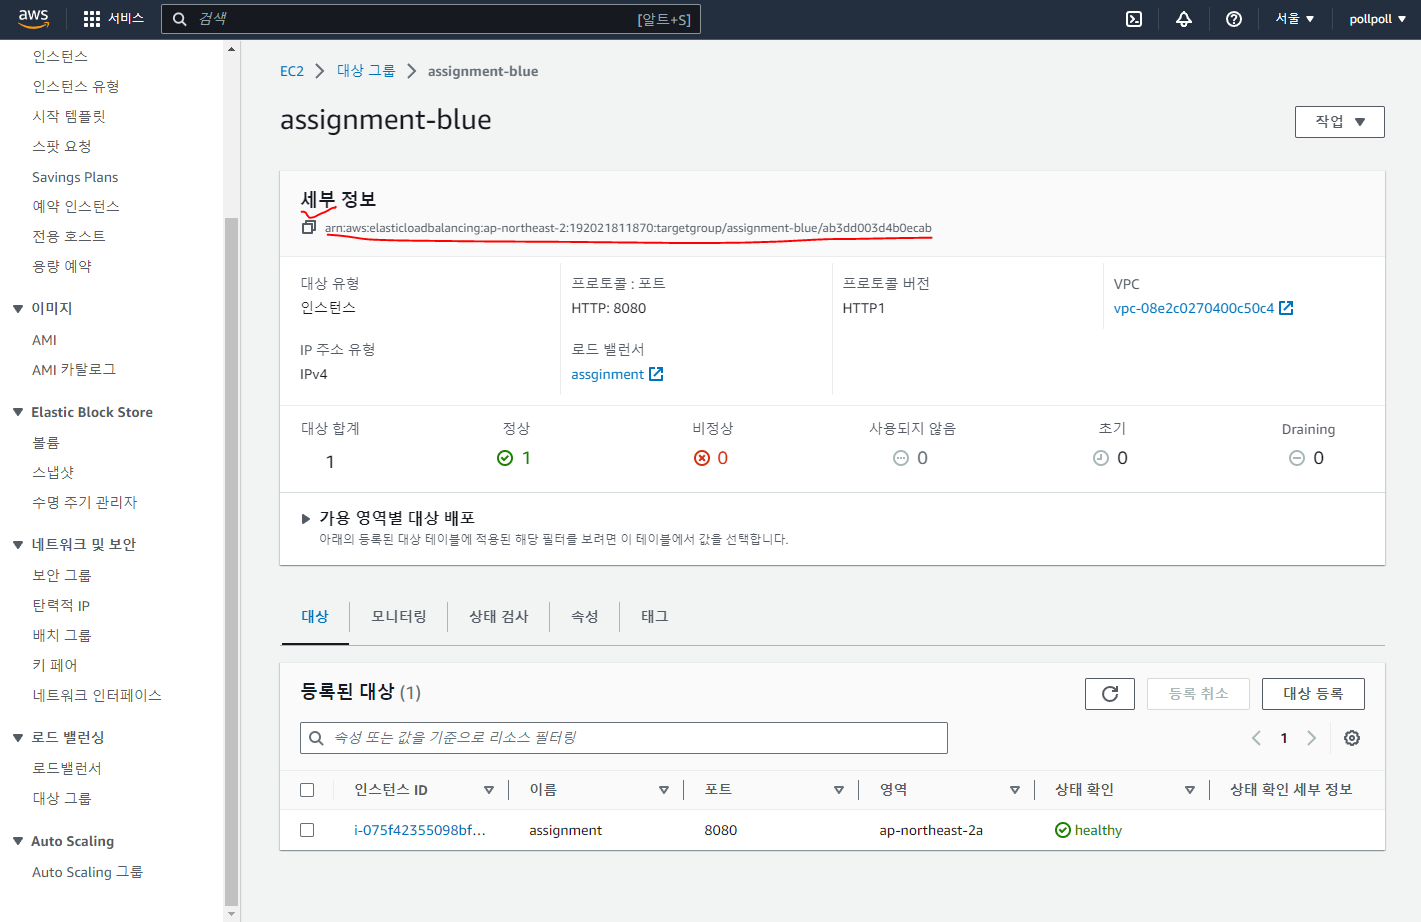
EC2의 타겟 그룹도 이렇게 ARN을 확인할 수 있습니다.
다시 CLI로 돌아와서요.
AWS_PAGER="" aws elbv2 describe-listeners --load-balancer-arn <YOUR-LOAD-BALANCER-ARN>
여기 <YOUR-LOAD-BALANCER-ARN> 이 부분을 자신의 ARN으로 적어주시면 됩니다.
이 때 주의해야할 점은 오타가 한글자라도 나면 적용이 안된다는 점입니다. 주의해주세요!
이렇게 로드 밸런서를 선택해주었고 이제 타겟 그룹을 변경해보겠습니다.
aws elbv2 modify-listener \
--listener-arn <YOUR-LISTENER-ARN> \
--default-actions Type=forward,TargetGroupArn=<YOUR-GREEN-TARGET-GROUP-ARN>
우리의 리스너와 타겟그룹의 ARN을 입력해주면?
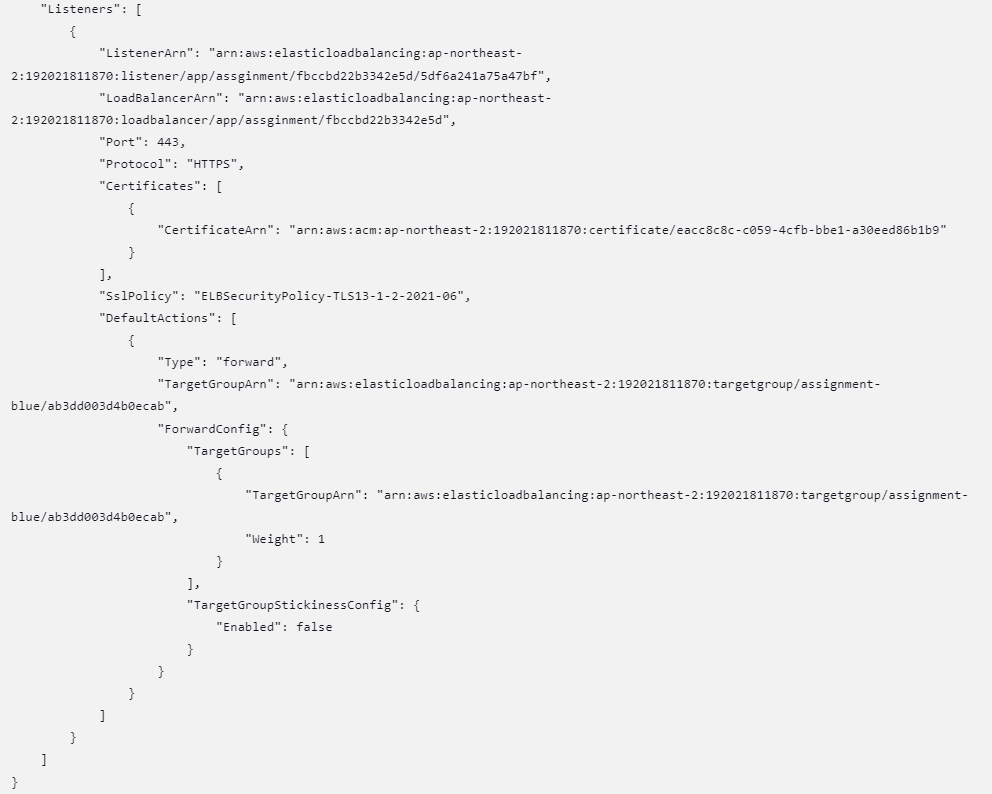
이건 제 Jenkins 로그를 따온건데 보시면 맨 아래 부분에 TargetGroups 가 변경된 것을 볼 수 있습니다. 자세히 보면 assignment-blue로 변경되었네요.
실제로도 변경되었는지 볼까요?

타겟 그룹이 잘 변경되었습니다.
마치며
이렇게 AWS CLI로 로드밸런서의 타겟 그룹을 변경시켜봤습니다.
CLI로 로드밸런서의 타겟 그룹을 변경시켜주지 않으면 블루 / 그린 배포를 진행할 때 굉장히 힘들었을 것입니다. 직접 AWS 사이트에 들어가서 타겟 그룹 변경해주고 설정까지 완료해줘야 하니까요.
나사 하나 빠진 블루 그린 배포에서 이제 완벽한 블루 그린 배포로 거듭났습니다.
여기까지 긴 글 읽어주셔서 감사합니다. 오늘도 즐거운 하루 되세요~
데이터베이스 서버와 애플리케이션 서버를 분리해보자 : 개념
저는 항상 의문점이 있었던 것이 애플리케이션 서버와 데이터베이스 서버를 나누게 되면 이 둘은 어떻게 통신을 하는가? 였습니다.
제가 기존에 배포하던 방식인 EC2 인스턴스에 애플리케이션과 데이터베이스를 동시에 두게 되면 보안상 좋지 않다는 말을 들었습니다.
그래서 이 부분에 대해서 GPT에게 물어봤더니 VPC를 사용하면 된다는 말만 끊임없이 하더군요. 그 당시에는 VPC가 뭔지 도 몰랐고 그냥 VPC를 쓰면 되는구나 하고 넘어갔습니다.
이번 포스팅에선 본격적으로 VPC를 이용해 애플리케이션 서버와 데이터베이스 서버를 분리시켜보도록 하겠습니다. 시작해보죠.
VPC가 뭐야?
VPC는 Virtual Private Cloud의 약자로 직역하면 가상의 클라우드 환경이라는 말입니다.
만약 VPC가 없다면 각각의 인스턴스들이 거미줄처럼 서로 복잡하게 엮여있을 것입니다.
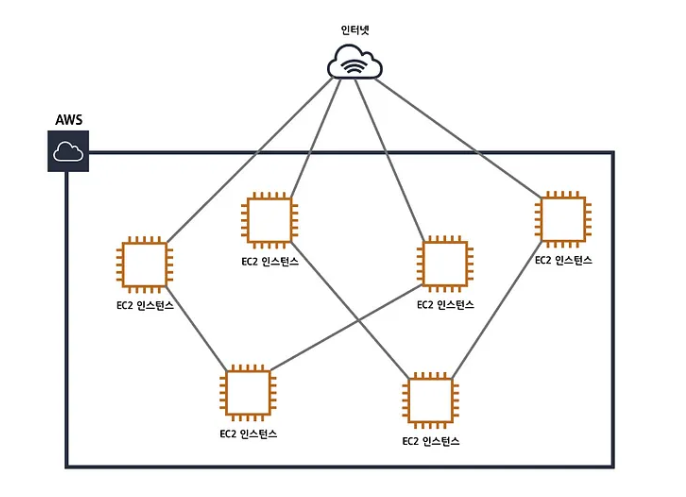
이러한 구조는 시스템의 복잡도를 높일 뿐만 아니라 하나의 인스턴스만 추가되어도 모든 인스턴스를 수정해야하는 불편함이 생깁니다.
이런 구조에서 VPC는 인스턴스를 정리해주고 객체지향스럽게 서버를 구성할 수 있게 됩니다.
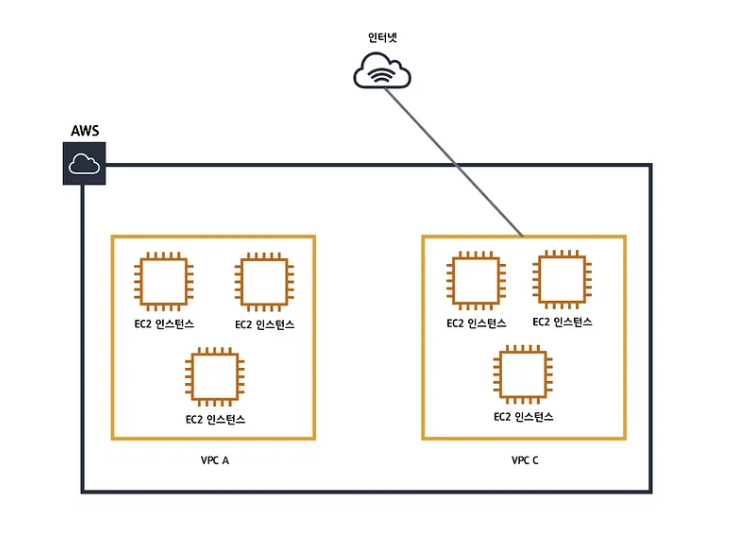
서브넷
VPC를 알았다면 이제 서브넷 차례입니다. 서브넷은 VPC안에서 EC2 인스턴스들을 더 잘게 세분화할 수 있도록 도와주는 개념입니다.
서브넷을 통해 EC2 인스턴스를 조금 더 유연하게 관리할 수 있고, VPC만 사용할 때보다 더 객체지향스럽게 설계할 수 있다는 부분에서 저도 애용하는 시스템입니다.
서브넷에는 private subnet과 public subnet이 있어서 이 둘을 이용하면 어떤 서브넷을 격리시키고 어떤 서브넷을 노출시킬지 결정할 수 있습니다.
눈치 빠르신 분들은 여기서 대충 감이 오셨겠지만 private subnet에 데이터베이스 서버를, public subnet에 애플리케이션 서버를 두어 데이터베이스 서버의 보안을 한층 더 끌어올릴 수 있게 됩니다.
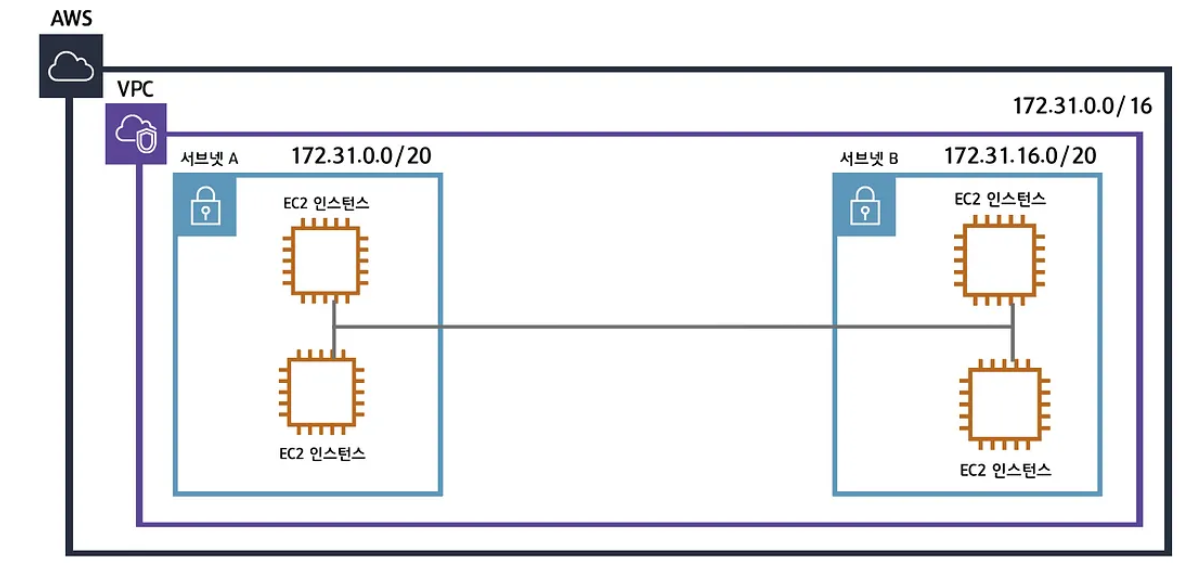
서브넷은 VPC안에 포함되는 개념이기 때문에 이 둘을 상속관계라고 나타내기위해 우리는 CIDR ("사이더" 라고 부릅니다.) 설정을 해줘야합니다.
위 그림에서 VPC에 붙어있는 172.31.0.0/16 과 서브넷에 붙어있는 172.31.0.0/20 이 바로 그것입니다.
CIDR에 대해서는 제가 아직 공부가 부족해서 더 공부한 후에 포스팅에 추가하도록 하겠습니다.
대충 VPC와 서브넷의 상속관계를 표한하기 위한 수단이라고 생각해주시면 됩니다.
라우터와 라우팅 테이블
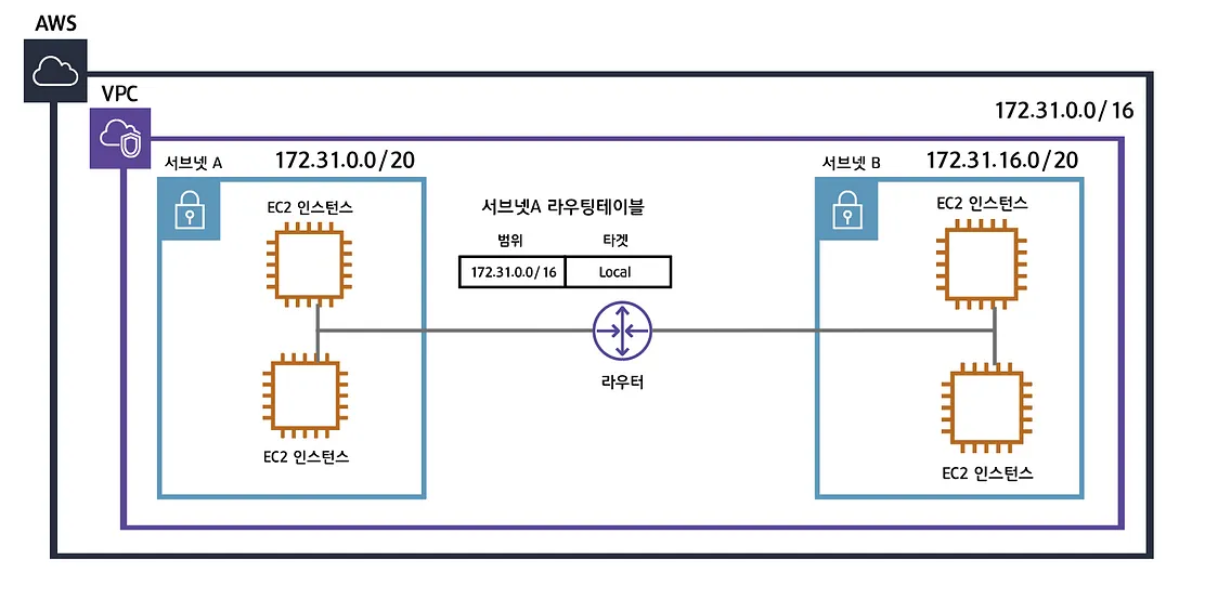
서브넷끼리 서로 통신할 수 있도록 라우터를 중간에 두면 서브넷끼리 유동적인 네트워크 통신이 가능해집니다.
중간에 라우터를 두면서 동시에 우리는 서브넷의 라우팅 테이블을 설정해줘야합니다. 라우팅 테이블은 해당 서브넷이 어떤 규칙에 의해 외부에서 요청을 받을 수 있게 될것인지를 설정합니다.
위 그림에서 서브넷A의 라우팅 테이블에서 172.31.0.0/16 이 범위이고 타겟은 Local인 것은 서브넷A는 외부와 연결되지 않고 내부적으로만 통신하겠다는 의미로서 그림에선 나와있지 않지만 서브넷A는 private subnet으로 추측할 수 있습니다.
인터넷 게이트웨이
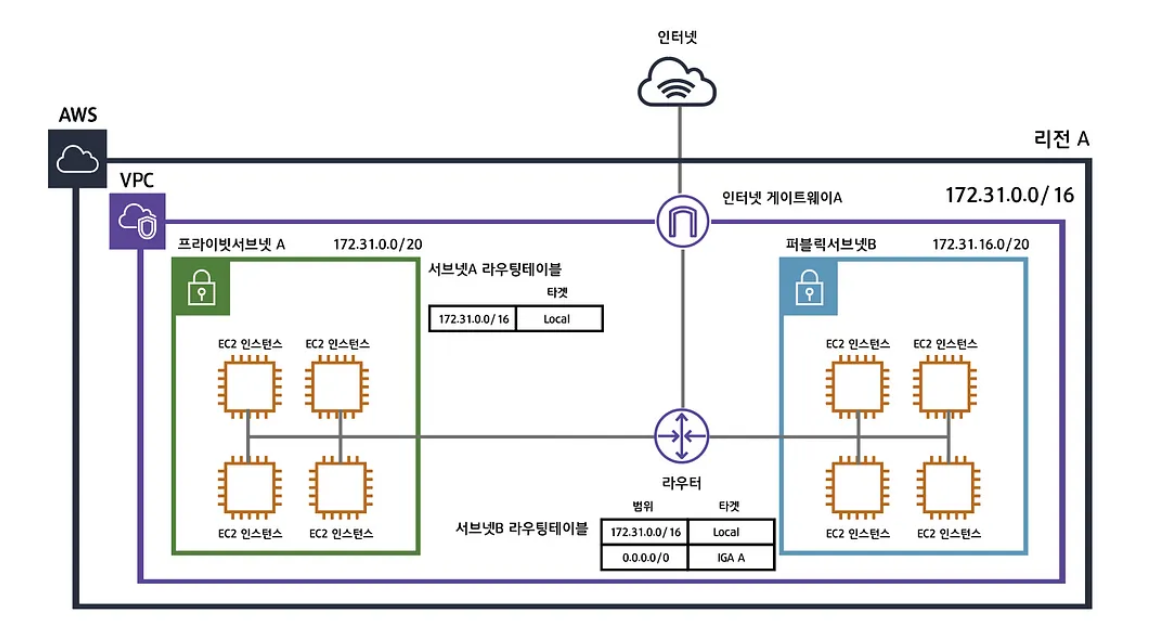
인터넷 게이트웨이는 외부 네트워크망과 VPC를 연결해주는 개념으로 무슨 요청이 어떤 VPC로 향하게 할 것인지 나타냅니다.
따라서 VPC가 여러개인 경우에는 인터넷 게이트웨이도 여러개를 설정해줘야 합니다.
NAT 게이트웨이
NAT 게이트웨이는 인터넷 게이트웨이와 다르게 private subnet이 외부와 통신할 수 있도록 해주는 개념입니다.
private subnet은 인터넷 게이트웨이와 연결되지 않아 외부와 네트워크 통신을 할 수 없습니다. 그렇다는 말은 우리가 흔히 패키지를 다운 받을 때 사용하는 apt-get 같은 명령어도 사용할 수 없다는 의미가 됩니다.
이건 좀 곤란하긴 하죠. 우리는 필요에 의해서 도커도 다운받아야할 수도 있고, 무엇보다도 데이터베이스를 다운받아야 하기 때문이죠.
따라서 우리는 NAT 게이트웨이를 설정해줌으로써 private subnet이 외부와 통신할 수 있도록 설정해줍니다.
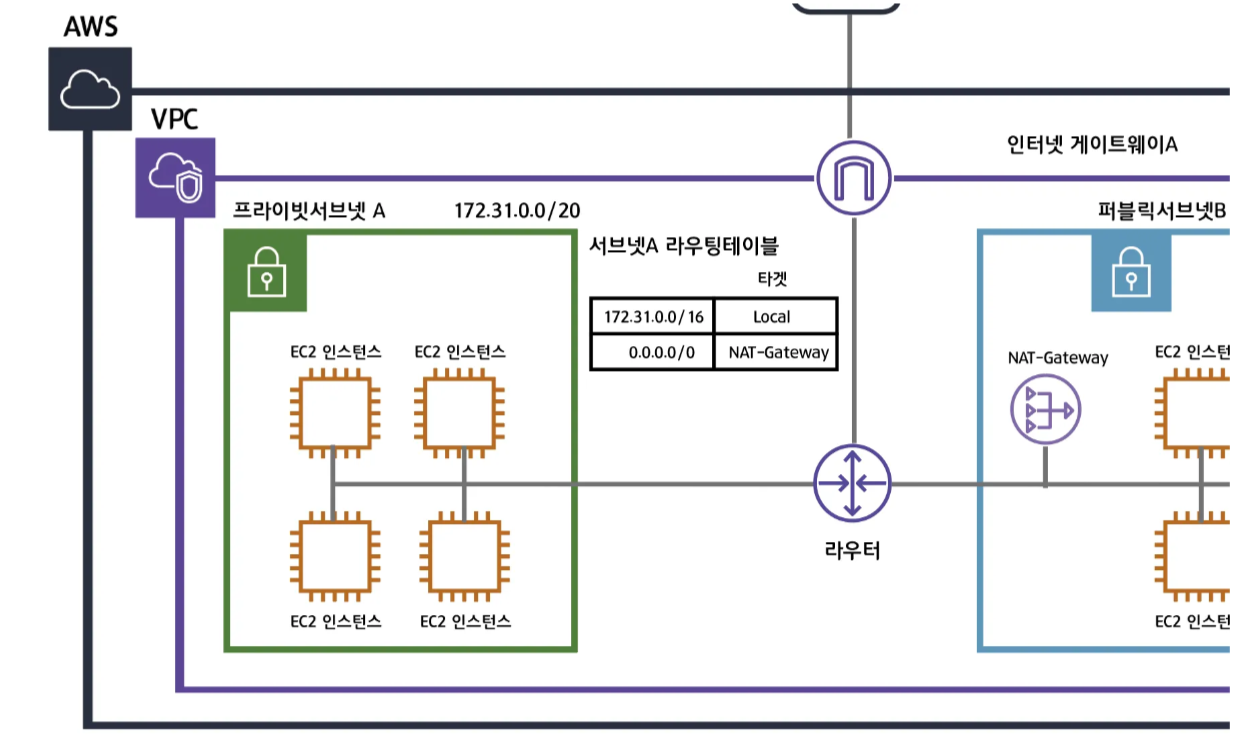
그림이 잘렸지만 NAT 게이트웨이는 public subnet에 위치해있게 됩니다.
어? private subnet이 외부와 네트워크 통신할 수 있도록 해주는 것인데 왜 public subnet에 위치해있나요?
NAT 게이트웨이는 인터넷 게이트웨이와 통신해야 하기 때문에 public subnet에 위치하게 됩니다. 때문에 NAT 게이트웨이는 public subnet에 위치해있습니다.
마치며
이렇게 VPC와 서브넷, 라우터와 라우팅 테이블, 인터넷 게이트웨이, NAT 게이트웨이까지 개념적인 부분에 대해서 알아봤습니다.
이제 우리는 다음 포스팅에서 실전에 들어갑니다. VPC를 설정하고 서브넷, 라우터, 라우팅 테이블, 인터넷 게이트웨이, NAT 게이트웨이까지 설정하면서 궁극적으로 데이터베이스 서버와 애플리케이션 서버를 분리해보도록 하겠습니다.
다음 포스팅
https://coding-review.tistory.com/452
이미지 출처
https://medium.com/harrythegreat/aws-%EA%B0%80%EC%9E%A5%EC%89%BD%EA%B2%8C-vpc-%EA%B0%9C%EB%85%90%EC%9E%A1%EA%B8%B0-71eef95a7098
데이터베이스 서버와 애플리케이션 서버를 분리해보자 : 실전1 (VPC와 서브넷)
앞선 포스팅에서 우리는 VPC와 서브넷, 라우터와 라우팅 테이블, 인터넷 게이트웨이, NAT 게이트웨이까지 알아봤습니다. 이번 포스팅에선 그 중 첫 번째 단계라고 볼 수 있는 VPC와 서브넷을 만들어 볼 것입니다.
개념적인 부분에 대해서 아직 모르고 계시다면 앞선 포스팅을 참고해주세요!
https://coding-review.tistory.com/451
VPC 생성과 서브넷 생성
1. VPC 생성
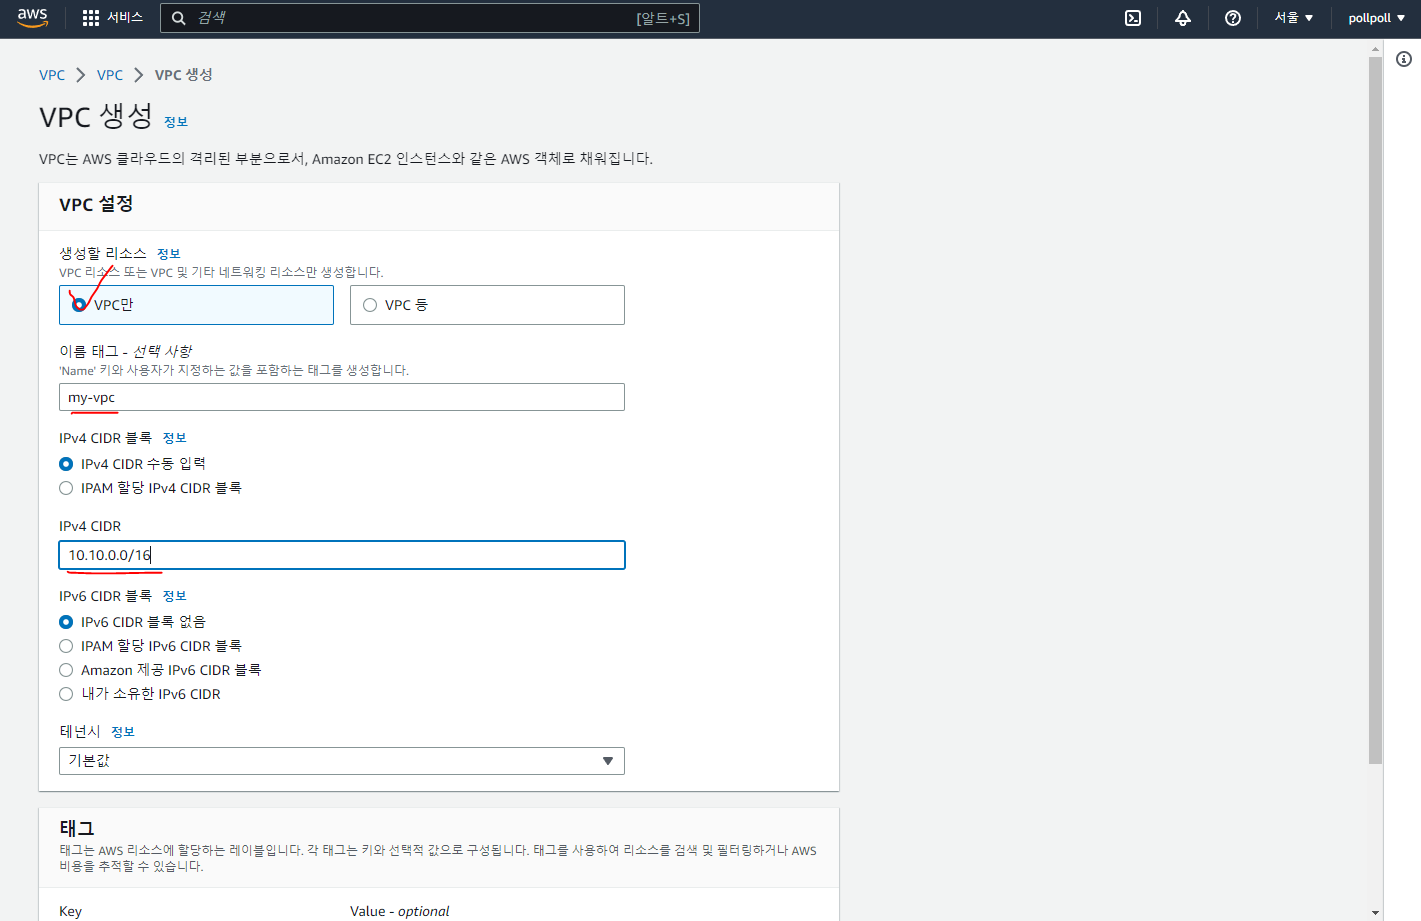
AWS 검색창에 VPC를 입력하고 들어간 곳에서 VPC 생성을 누릅니다.
그리고 생성할 리소스에 VPC만, 이름 태그, CIDR를 입력해줍니다. CIDR에 대해서는 조금 더 공부가 필요하기 때문에 우선 똑같이 따라해달라고 부탁드리겠습니다.
그리고 아래있는 VPC 생성을 누르면 끝입니다.
2. 서브넷 생성
왼쪽 카테고리에서 서브넷을 클릭하고 서브넷 생성을 클릭합니다.
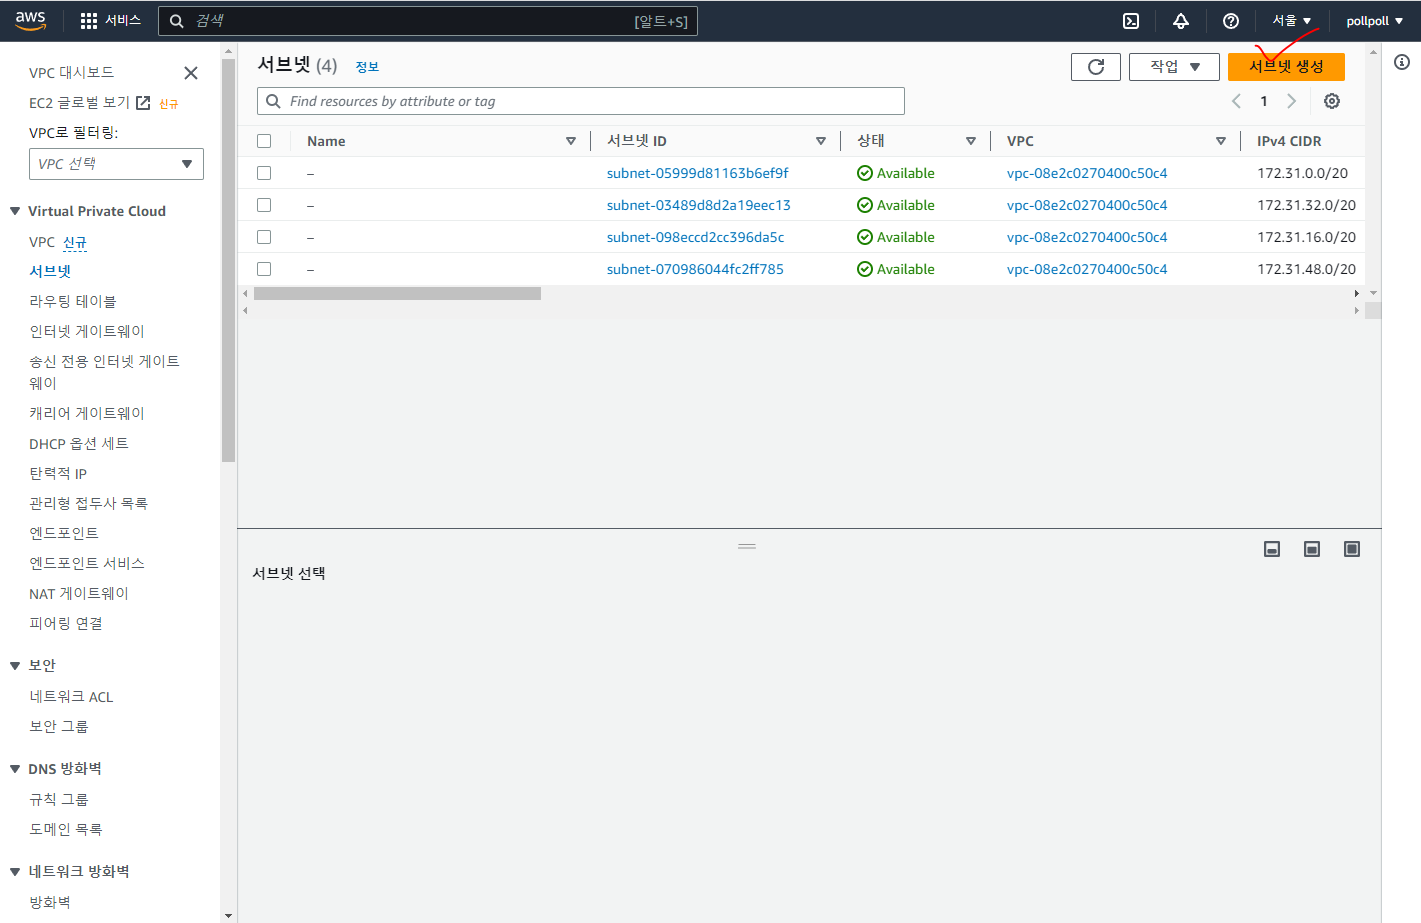
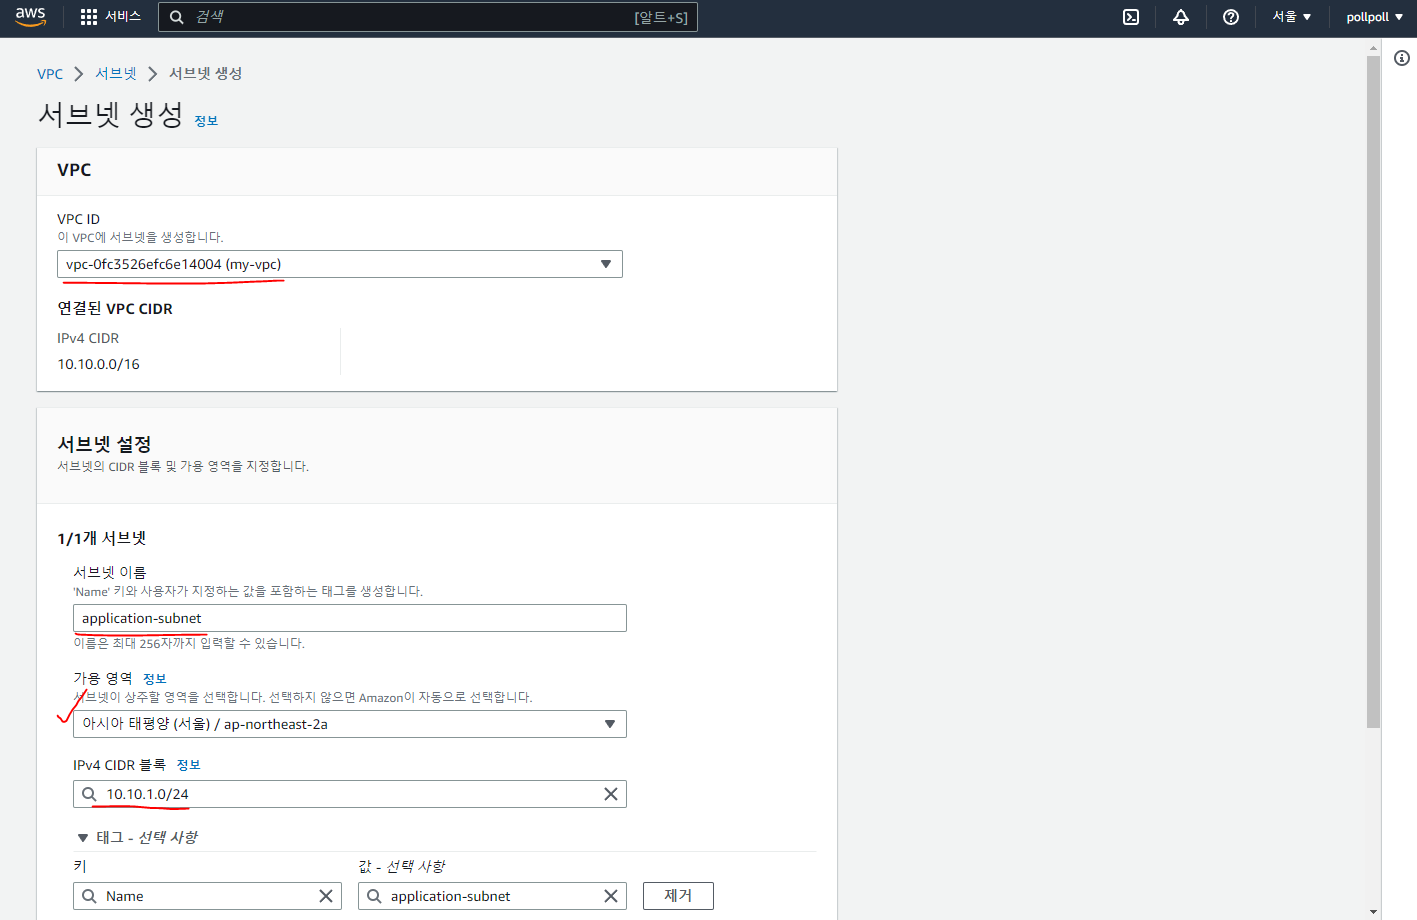
우리가 방금 만든 VPC를 선택하고 서브넷 이름, 가용 영역, CIDR를 입력해줍니다.
여기서 서브넷의 CIDR는 VPC의 CIDR에 포함되는 CIDR만 가능합니다.
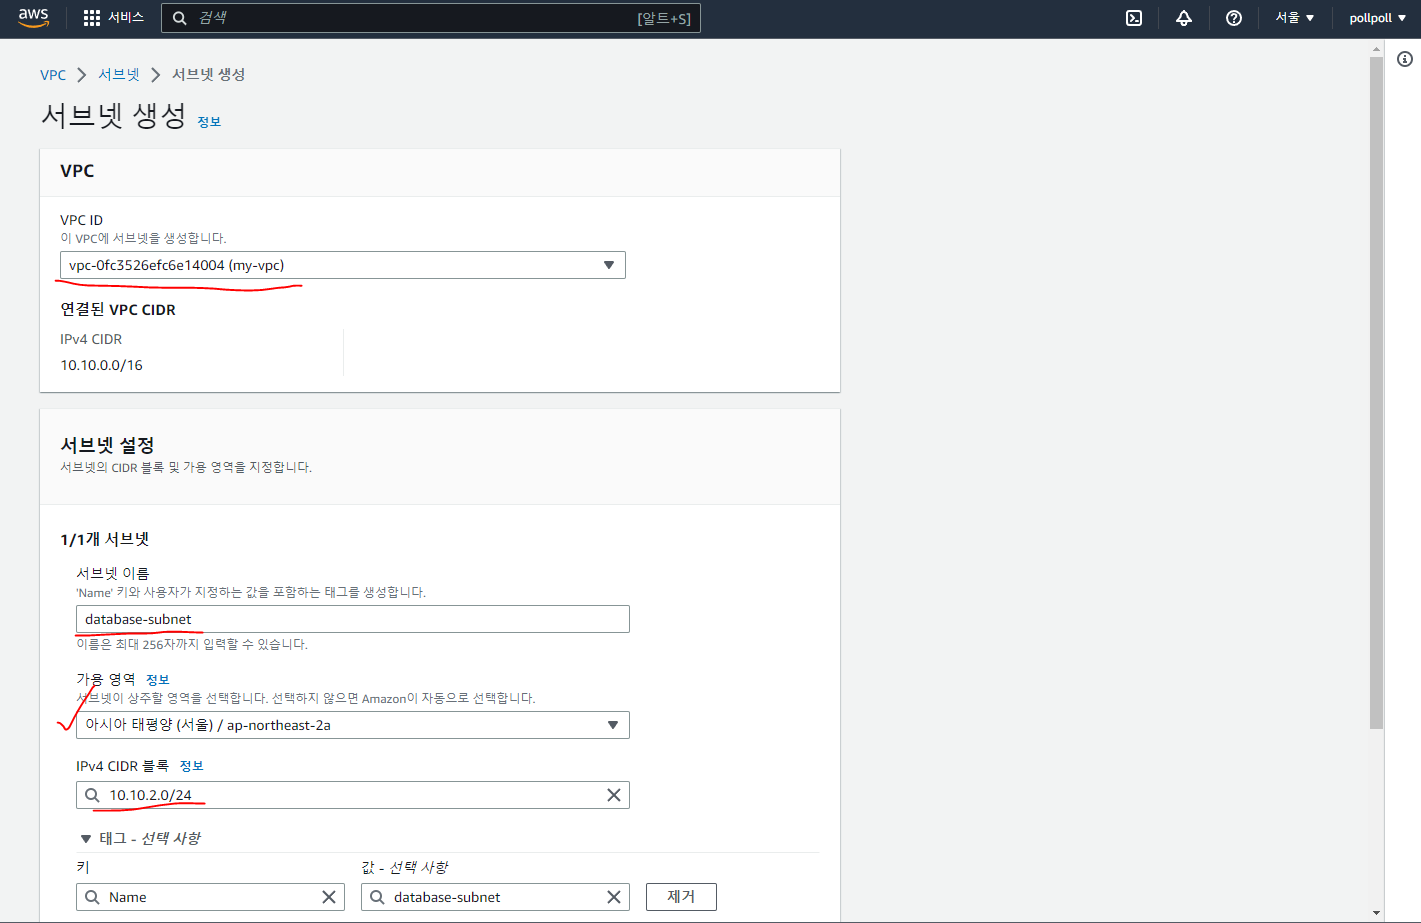
이어서 두 번째 서브넷도 만들어줍니다. 이 서브넷은 private subnet으로 운영할 생각입니다.
3. 인터넷 게이트웨이 생성
왼쪽 카테고리에서 인터넷 게이트웨이를 선택하고 "인터넷 게이트웨이 생성"을 누릅니다.
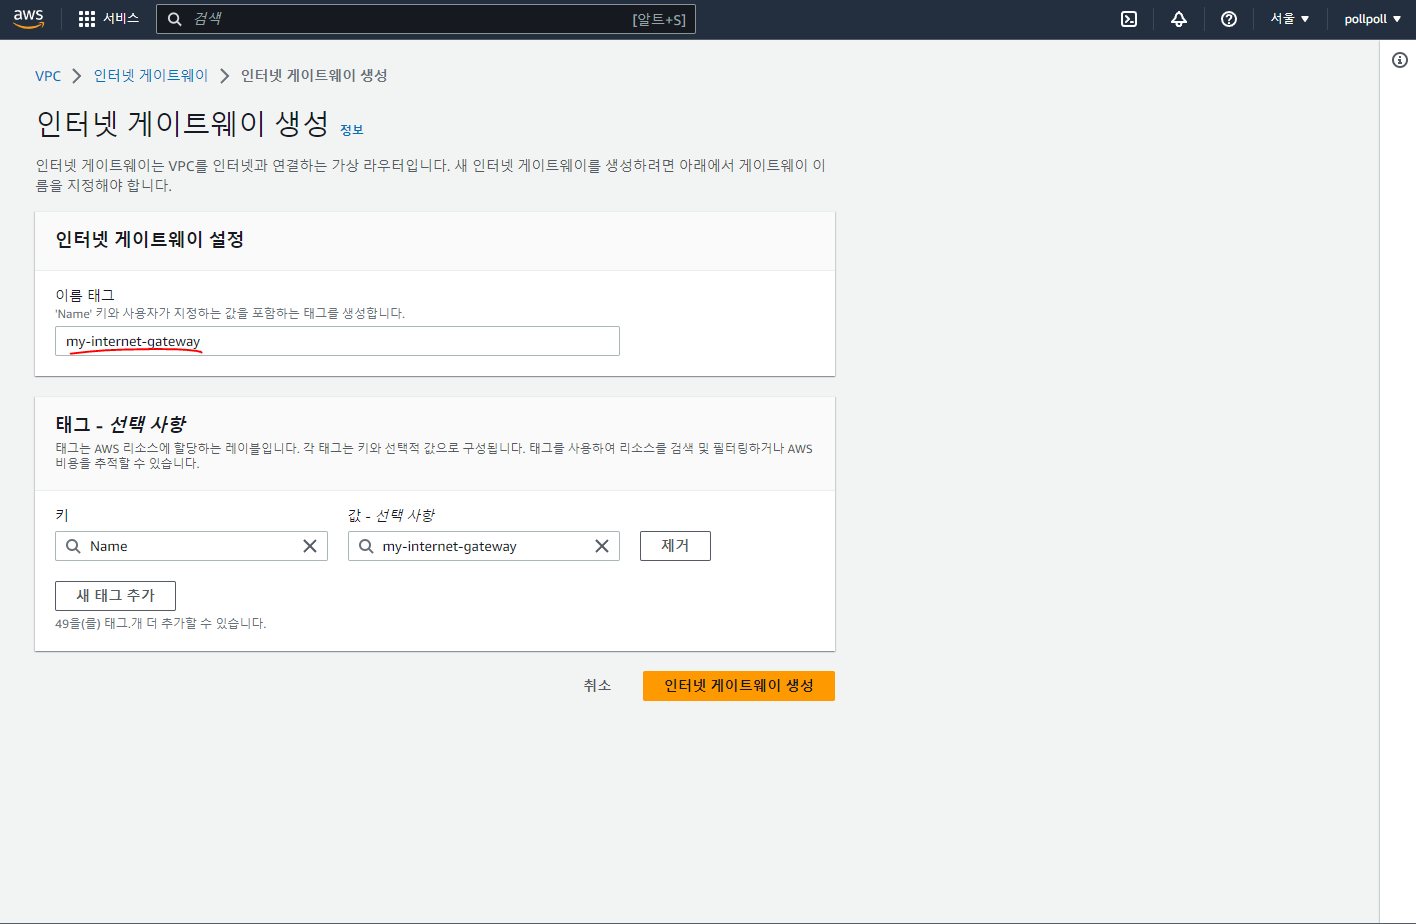
인터넷 게이트웨이는 간단하게 이름 태그만 적어주면 됩니다.
4. 라우팅 테이블 생성
왼쪽에 라우팅 테이블 카테고리를 선택하고 "라우팅 테이블 생성"을 누릅니다.
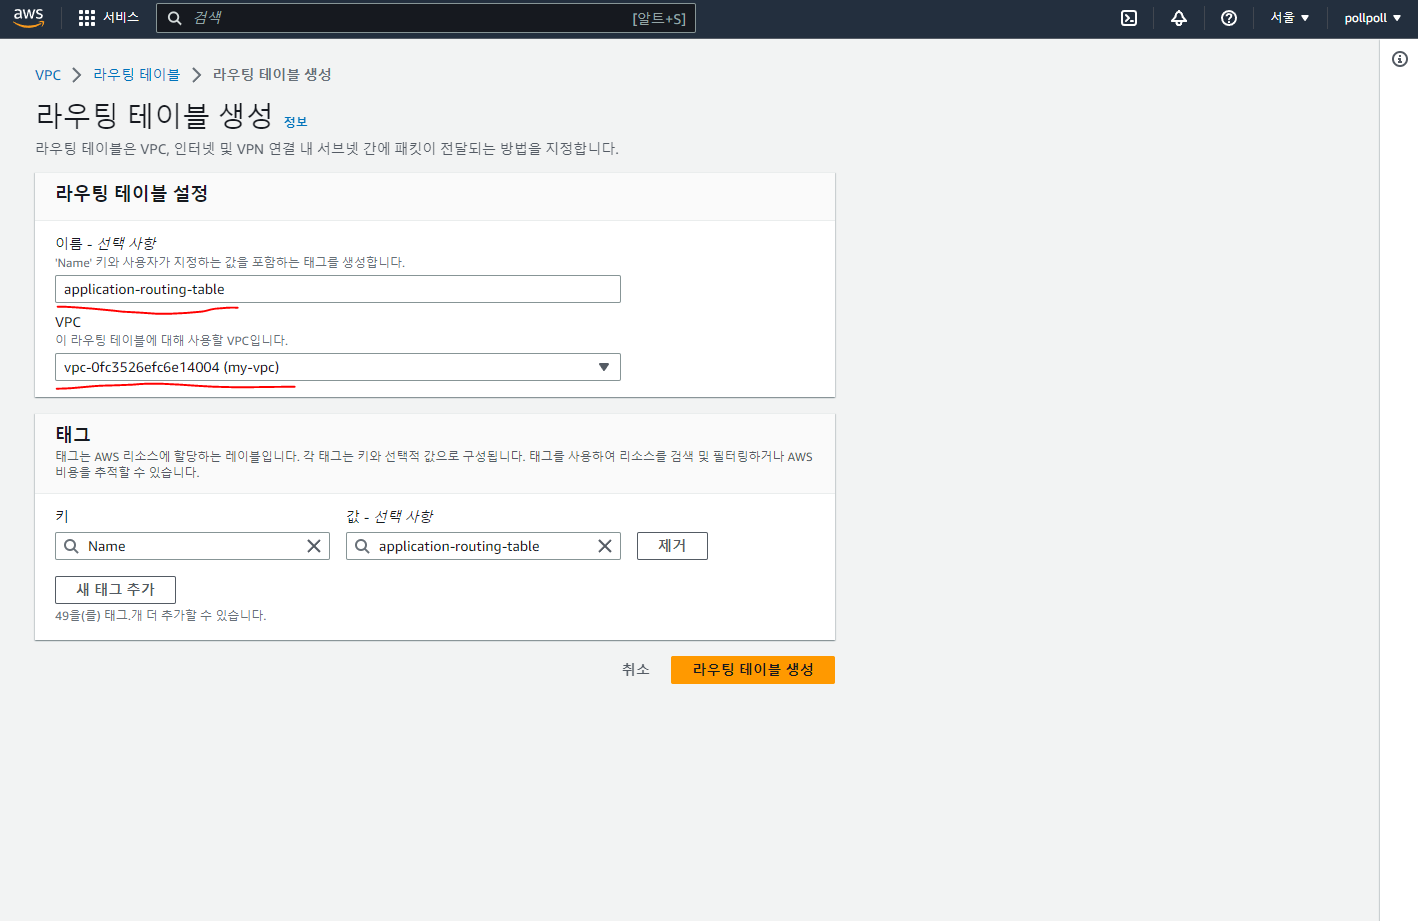
라우팅 테이블도 만드는건 아주 쉽습니다. 이름과 VPC만 선택해주면 됩니다.
우리는 두개의 서브넷을 가지고 있기 때문에 database-routing-table이라는 라우팅 테이블도 하나 더 만들어줍니다. 그럼 이렇게 두개의 라우팅 테이블을 볼 수 있습니다.
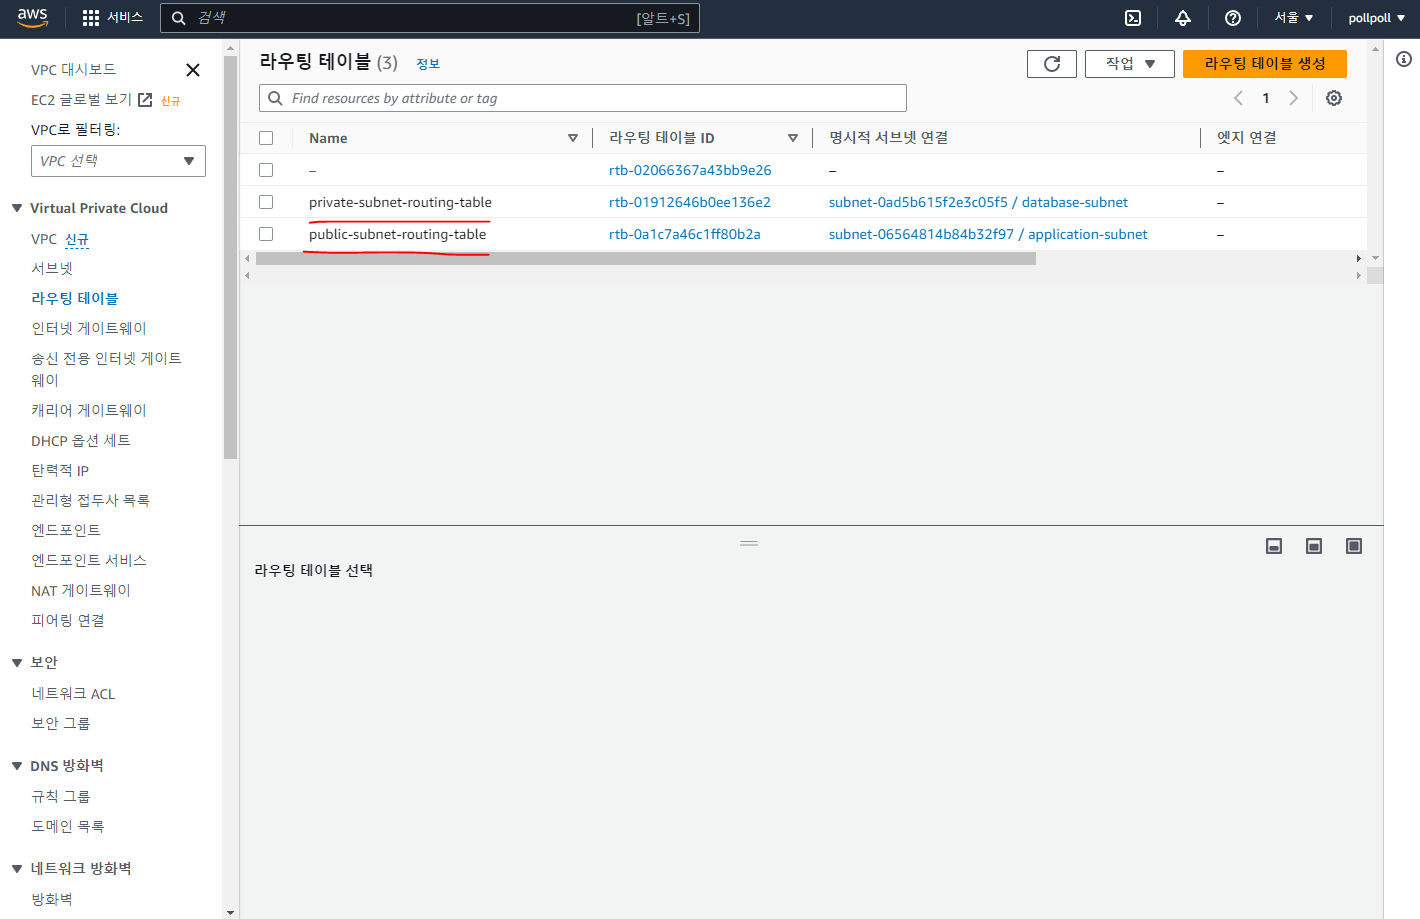
이제 각각의 라우팅 설정을 해주도록 하겠습니다.
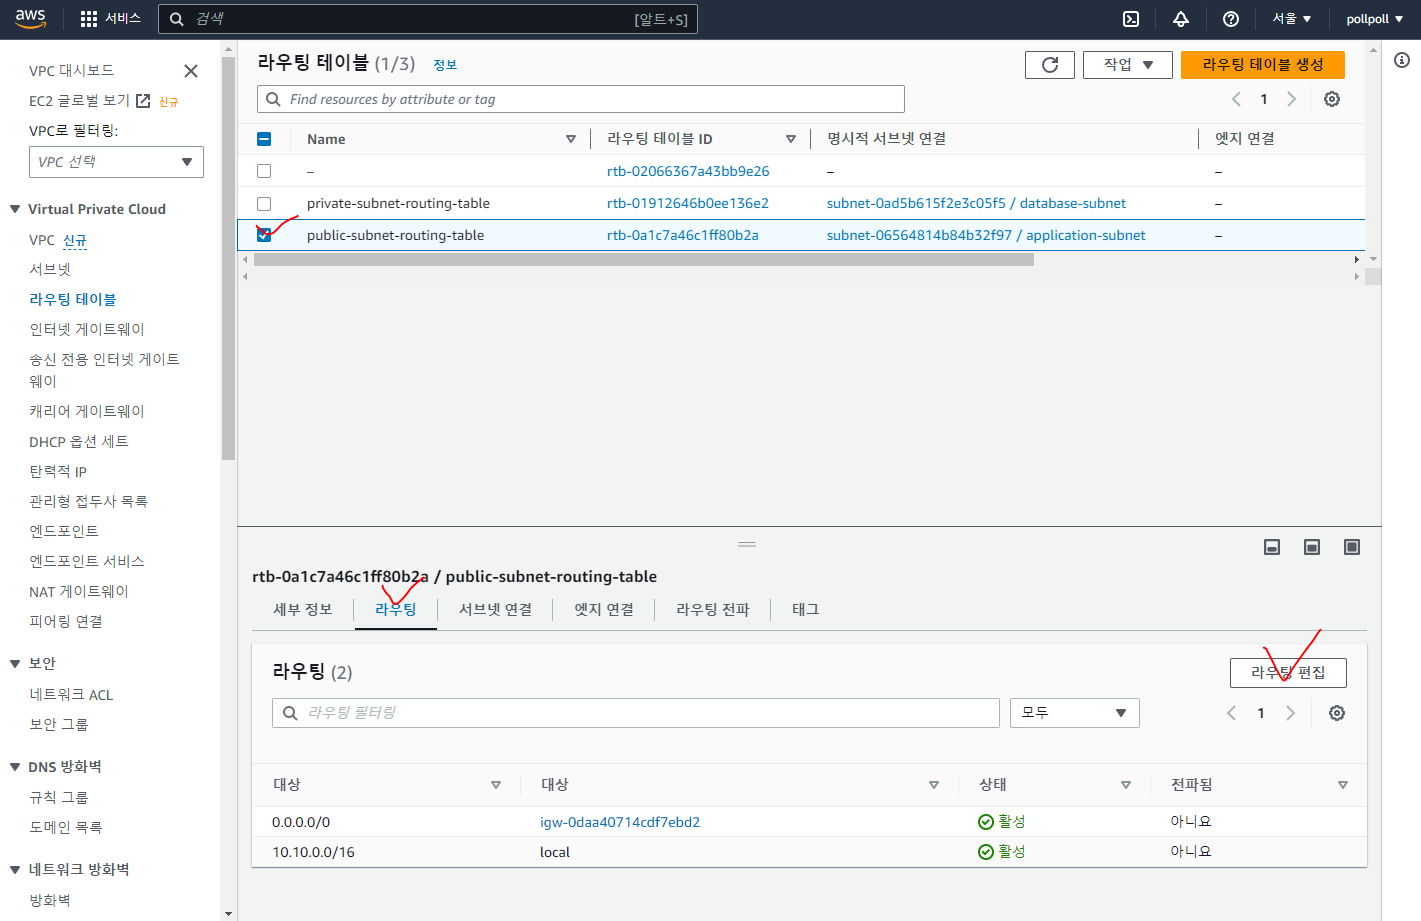
먼저 public subnet에 연결할 라우팅 테이블의 라우팅을 설정해줄겁니다. 여기서 헷갈리시면 안됩니다! public subnet에 연결될 라우팅입니다. 잘 보고 선택해주셔야합니다.
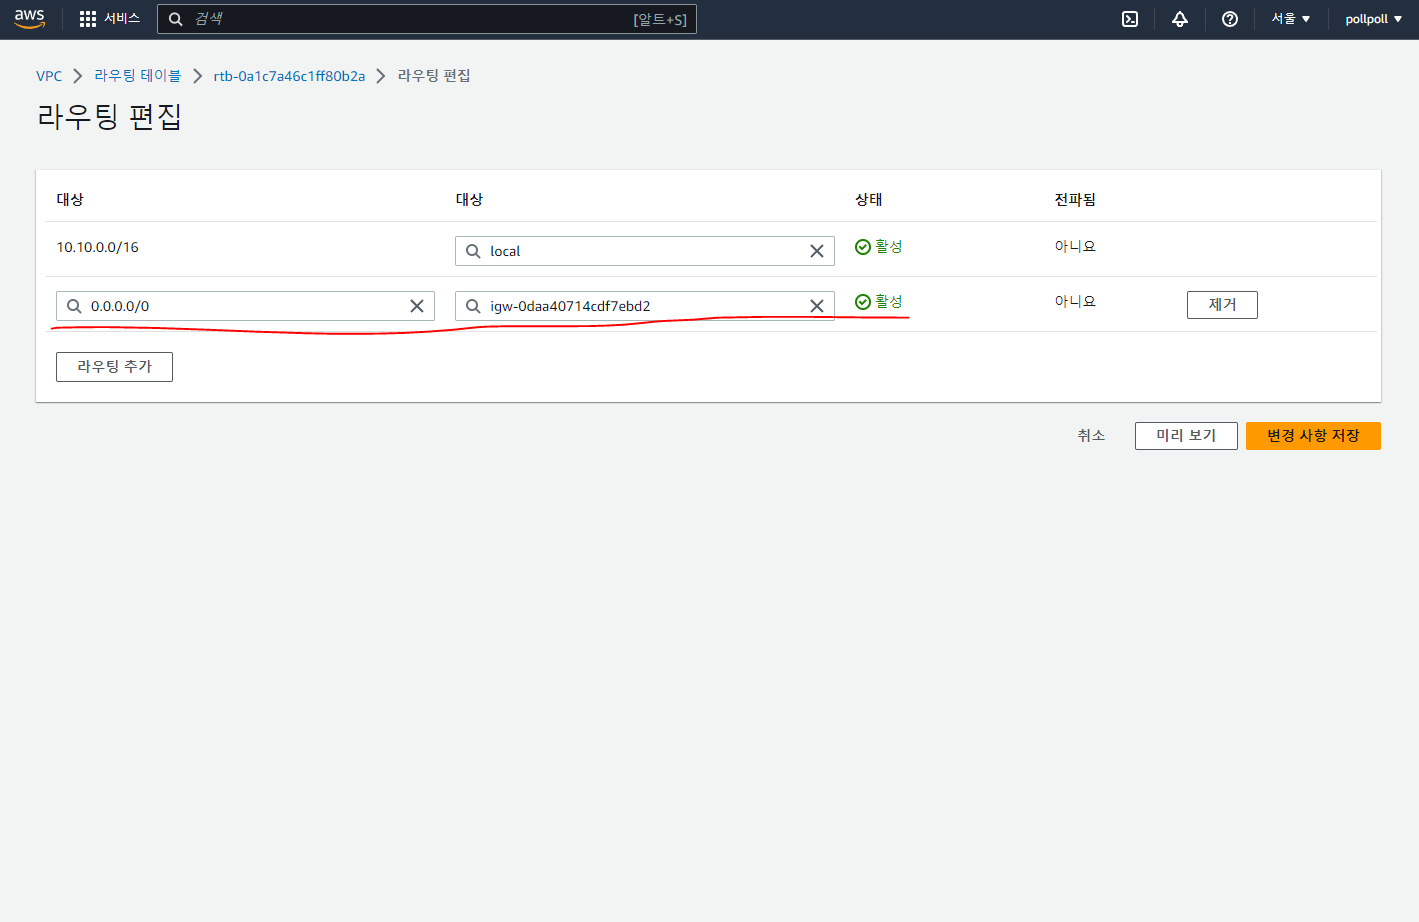
대상에 igw를 치시면 우리가 만든 인터넷 게이트웨이가 뜨게 됩니다. 그걸 선택해주면 됩니다.
이 라우팅 테이블의 뜻은 "10.10.0.0/16으로 들어오는 요청을 제외한 모든 요청을 인터넷 게이트웨이로 전달해라" 라는 설정입니다.
private subnet의 라우팅 테이블을 설정하기 전에 먼저 NAT 게이트웨이를 만들고 오겠습니다.
5. NAT 게이트웨이 생성
왼쪽 카테고리에서 NAT 게이트웨이를 클릭하고 "NAT 게이트웨이 생성" 버튼을 클릭합니다.
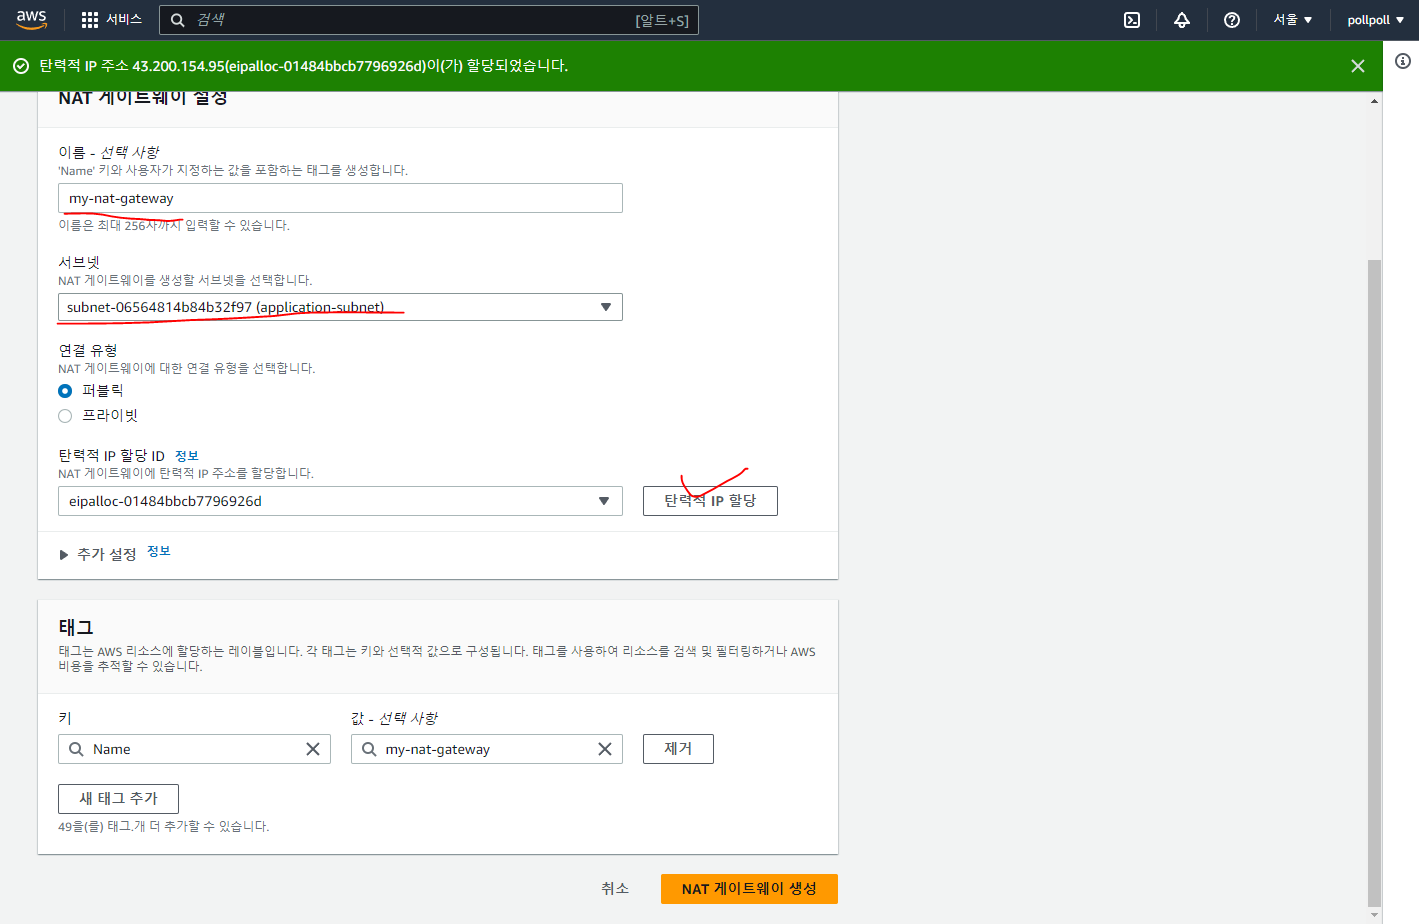
NAT 게이트웨이는 이름을 입력하고 서브넷을 public subnet으로 연결해야합니다.
NAT 게이트웨이는 private subnet이 외부 네트워크 통신을 가능하도록 하게 만들어주는 시스템이라 private subnet을 선택해야할 것 같지만 NAT 게이트웨이는 인터넷 게이트웨이와 통신해야하기 때문에 public subnet이랑 연결해야합니다.
앞서 우리는 public subnet 라우팅 테이블에 인터넷 게이트웨이를 연결했습니다. 그것을 기억하시면 조금 더 이해하기가 쉬울겁니다.
또한, NAT 게이트웨이를 만들기 위해서는 탄력적 IP가 필요합니다. AWS에선 탄력적 IP를 EIP라고도 부르니 다른 곳에서 EIP라는 것을 보면 당황하지마시고 탄력적 IP구나 생각하시면 됩니다.
주의!!!
NAT 게이트웨이는 정말 많은 돈이 듭니다. AWS의 내부적인 통신 (Inbound)에 대해서는 아무런 비용이 발생하지 않습니다. 때문에 내부적으로 스트레스 테스트를 진행해도 되는 이유이기도 하죠.
하지만 외부적인 통신 (Outbound)에 대해서는 비용이 발생하게 됩니다. NAT 게이트웨이는 private subnet으로부터 외부로 네트워크 통신을 진행하게 됩니다.
왜냐하면 private subnet에서 외부 네트워크와 통신해야 하기 때문이죠.
때문에 NAT 게이트웨이는 프리티어가 아니라면 실습만 해보시고 바로 삭제하는 것을 추천드립니다.
그럼 private subnet을 영원히 외부 네트워크와 통신하지 못하는데요?
맞습니다. 때문에 우리는 추후에 NAT 게이트웨이를 AWS에서 설정하는 것이 아니라 EC2 인스턴스를 NAT 게이트웨이로 설정하는 방법에 대해서 알아볼 것입니다.
이어서 보겠습니다. NAT 게이트웨이를 만들고 조금 있다보면 상태가 Available로 바뀌게 됩니다.
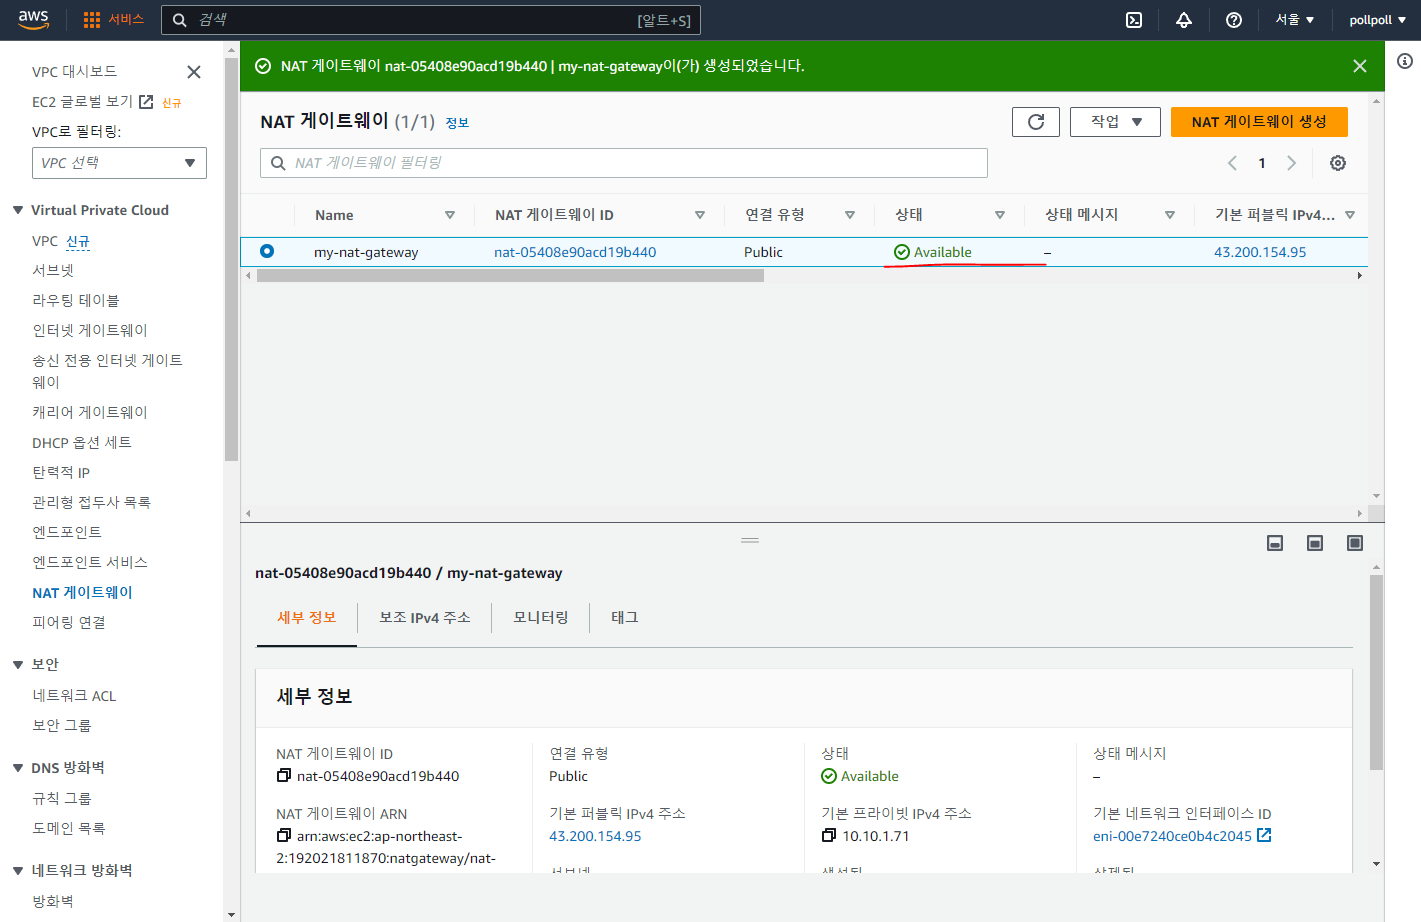
6. private subnet의 라우팅 테이블 설정
이제 다시 왼쪽 카테고리의 라우팅 테이블로 가줍니다.
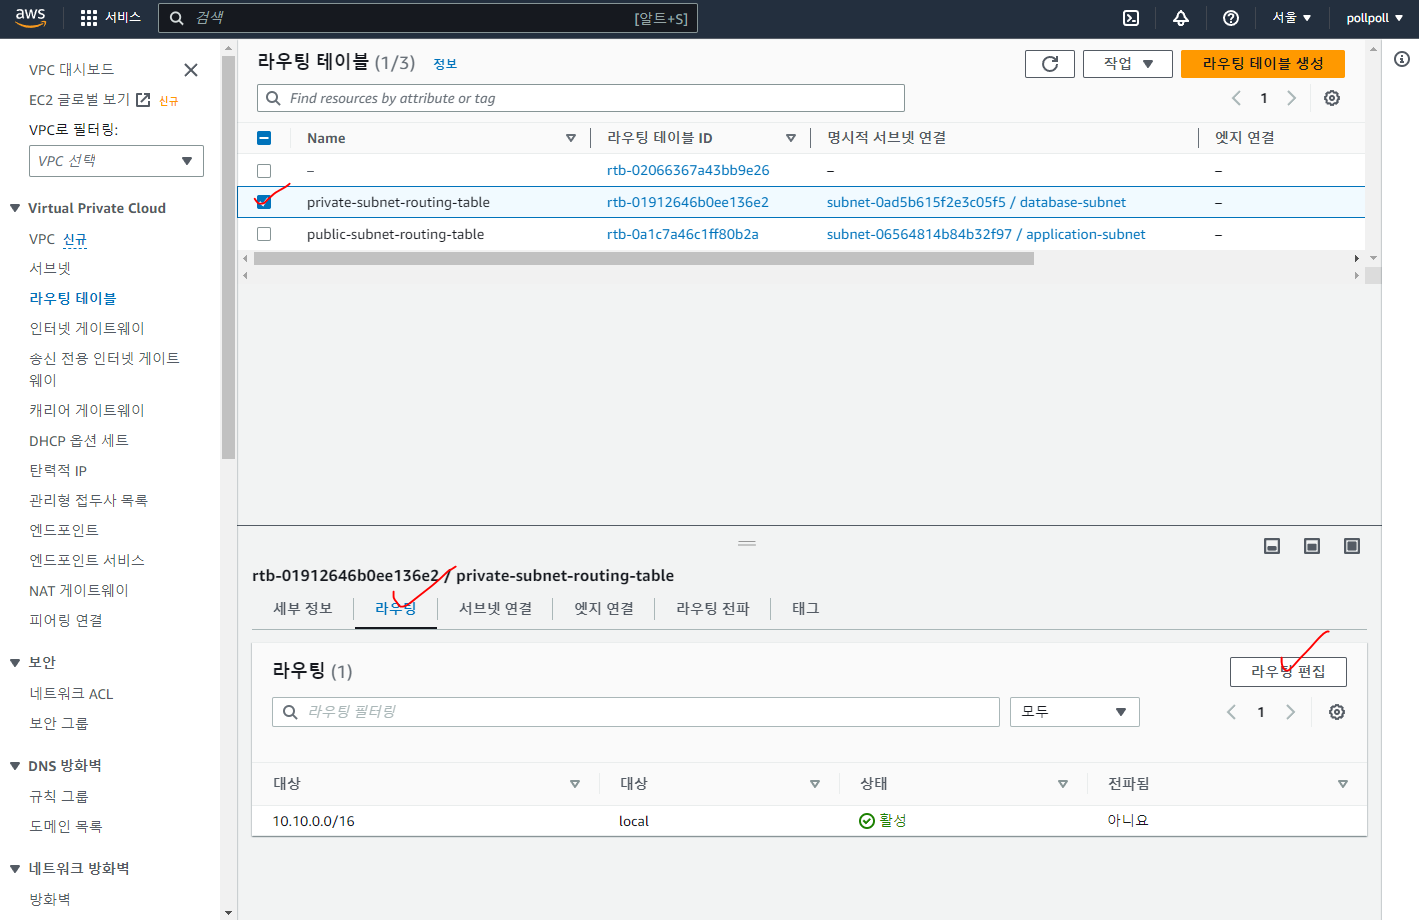
라우팅 탭에서 라우팅 편집에 들어간 다음
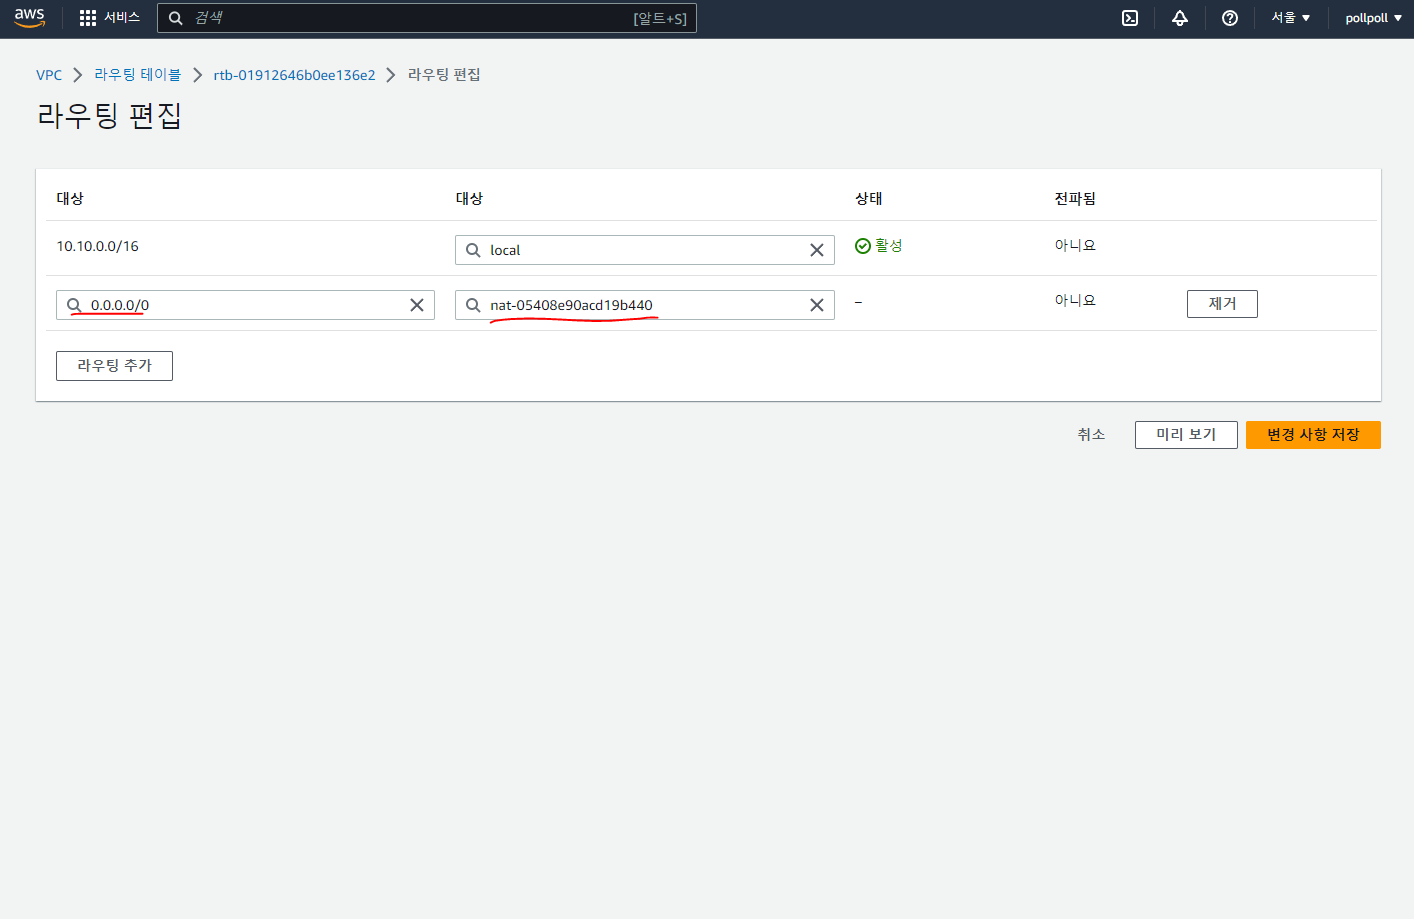
모든 요청에 대해 NAT 게이트웨이를 설정해줍니다. 이 라우팅 테이블의 뜻은 위에서와 마찬가지로 10.10.0.0/16으로 들어오는 요청을 제외한 모든 요청을 NAT 게이트웨이로 가게 하는 설정입니다.
이제 마지막으로 각각의 라우팅 테이블과 서브넷을 연결해주면 끝입니다.
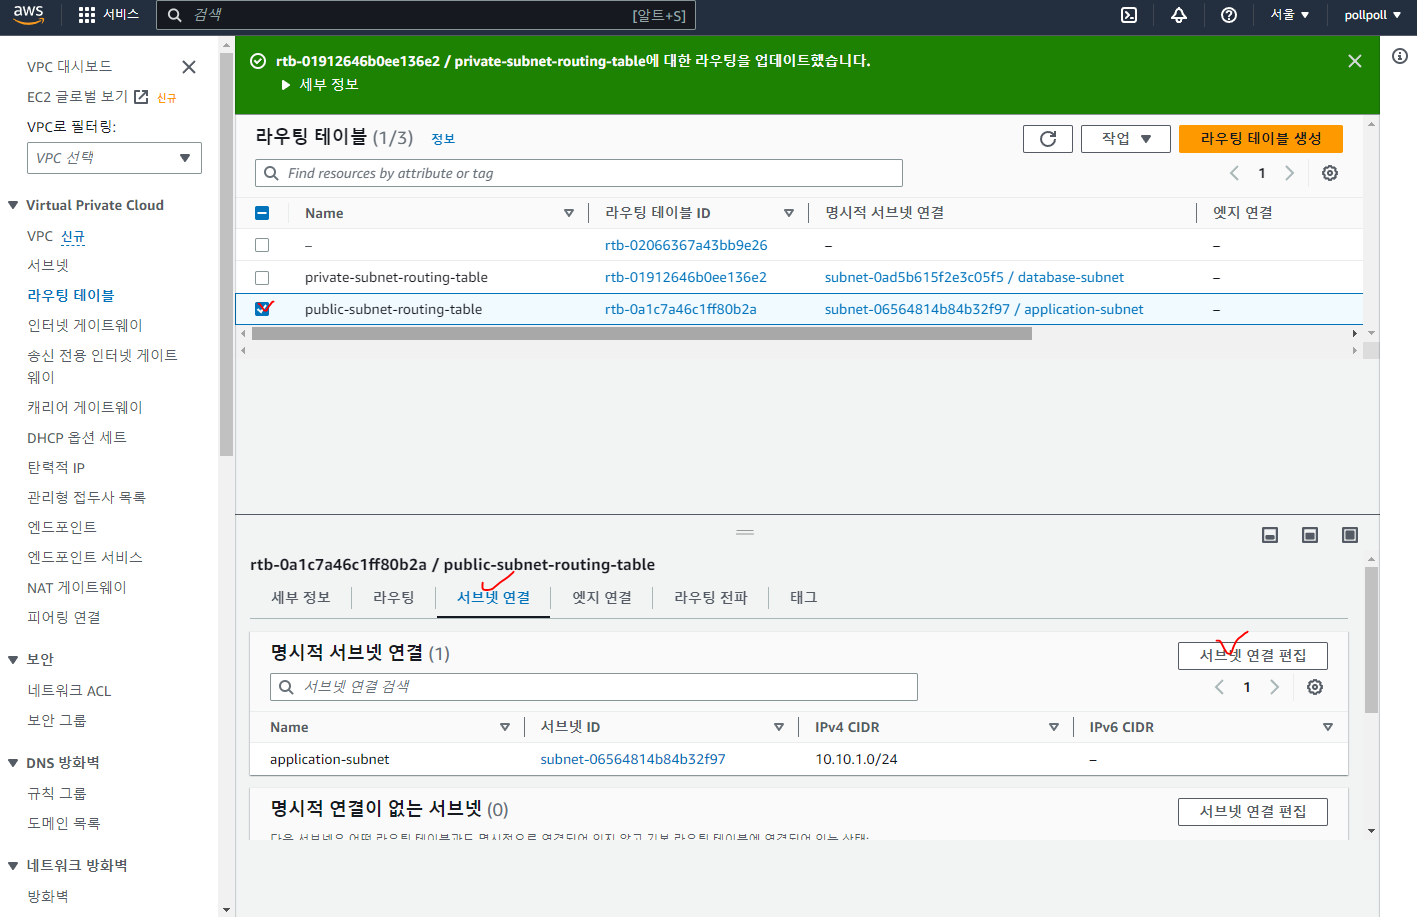
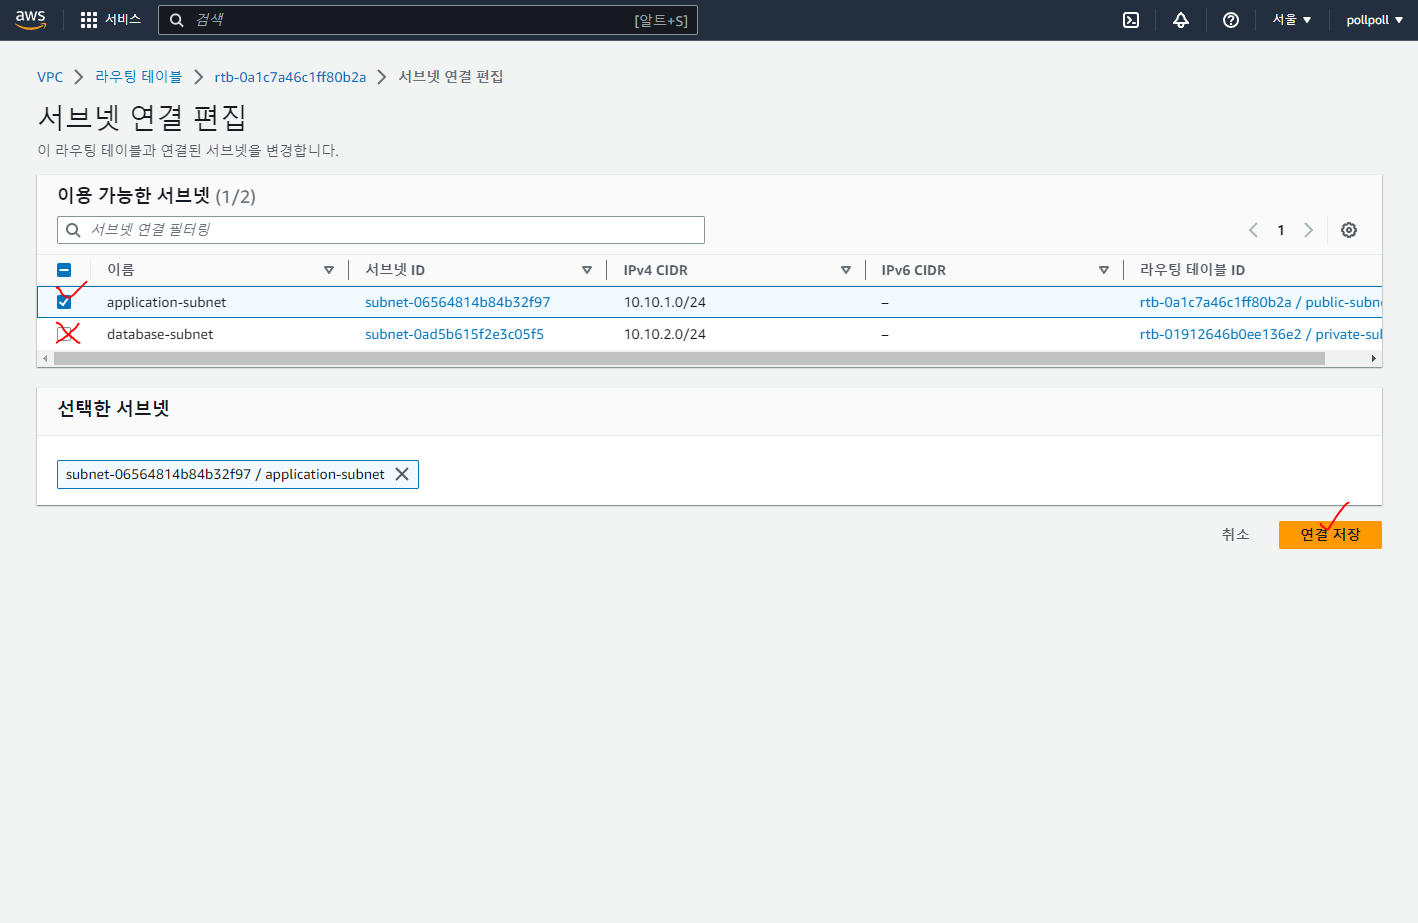
해당 라우팅 테이블은 public subnet의 라우팅 테이블입니다. 이 라우팅 테이블은 어떤 설정을 하고 있었죠?
맞습니다. 인터넷 게이트웨이와 연결되어 외부 네트워크 통신이 가능합니다. private subnet은 외부와 연결되어있지 않고 public subnet을 통해서만 연결할 수 있도록 할겁니다.
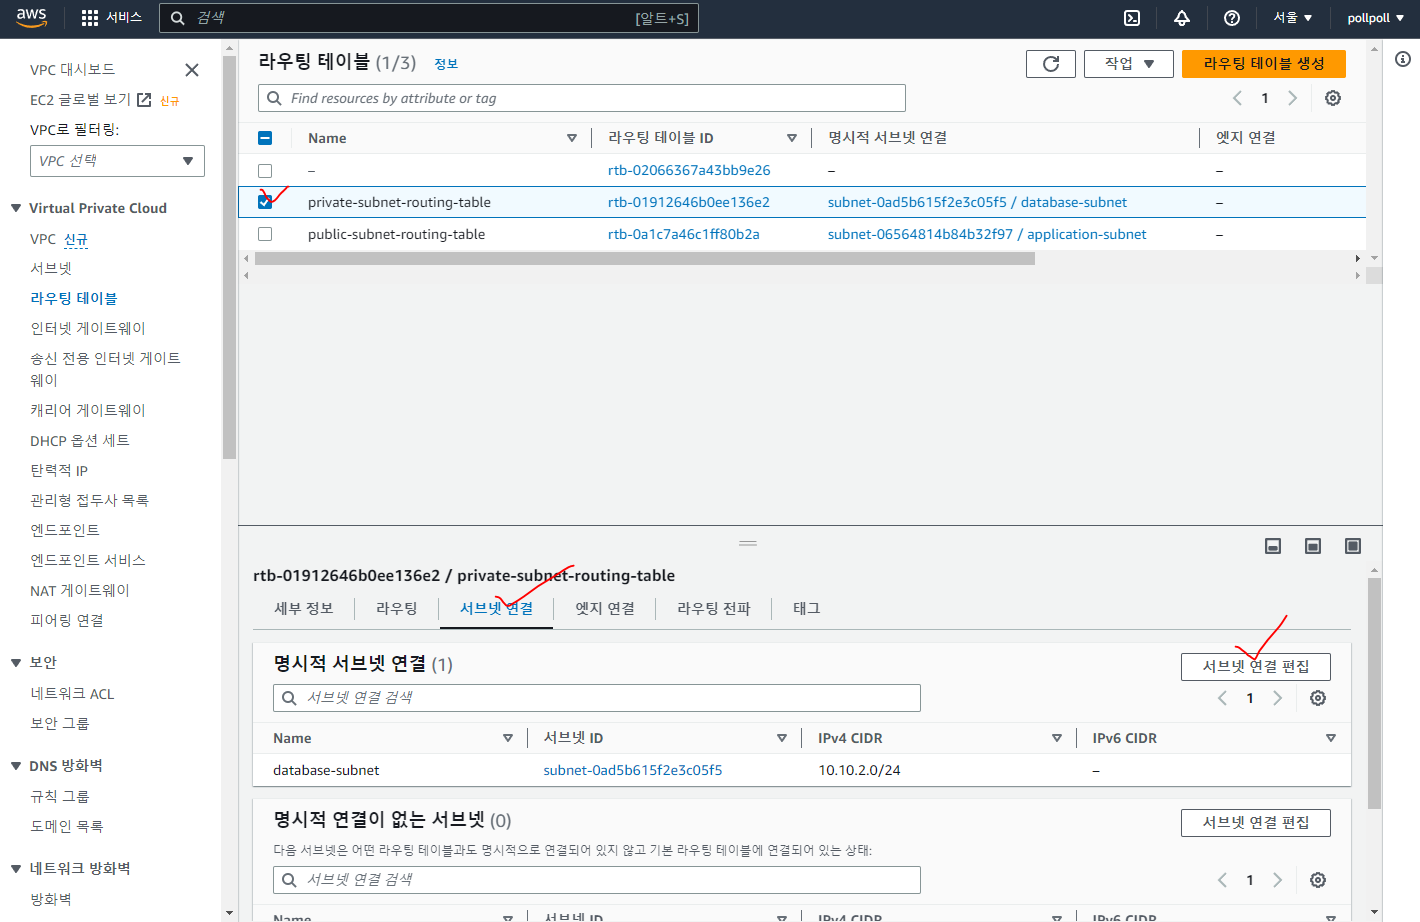
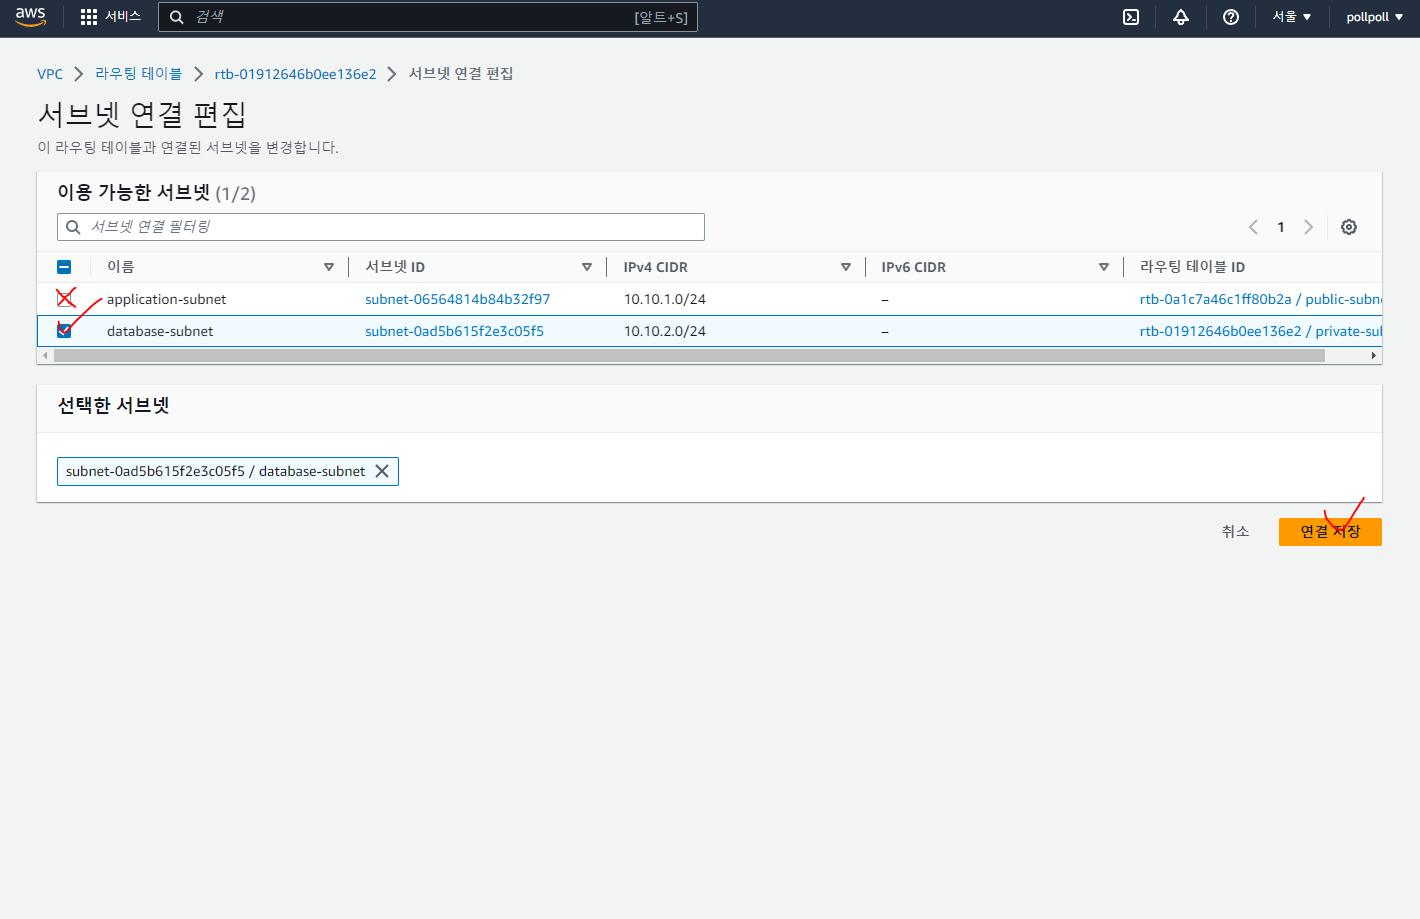
이 상황이 어떻게 된건지 도식화로 정리해보겠습니다.
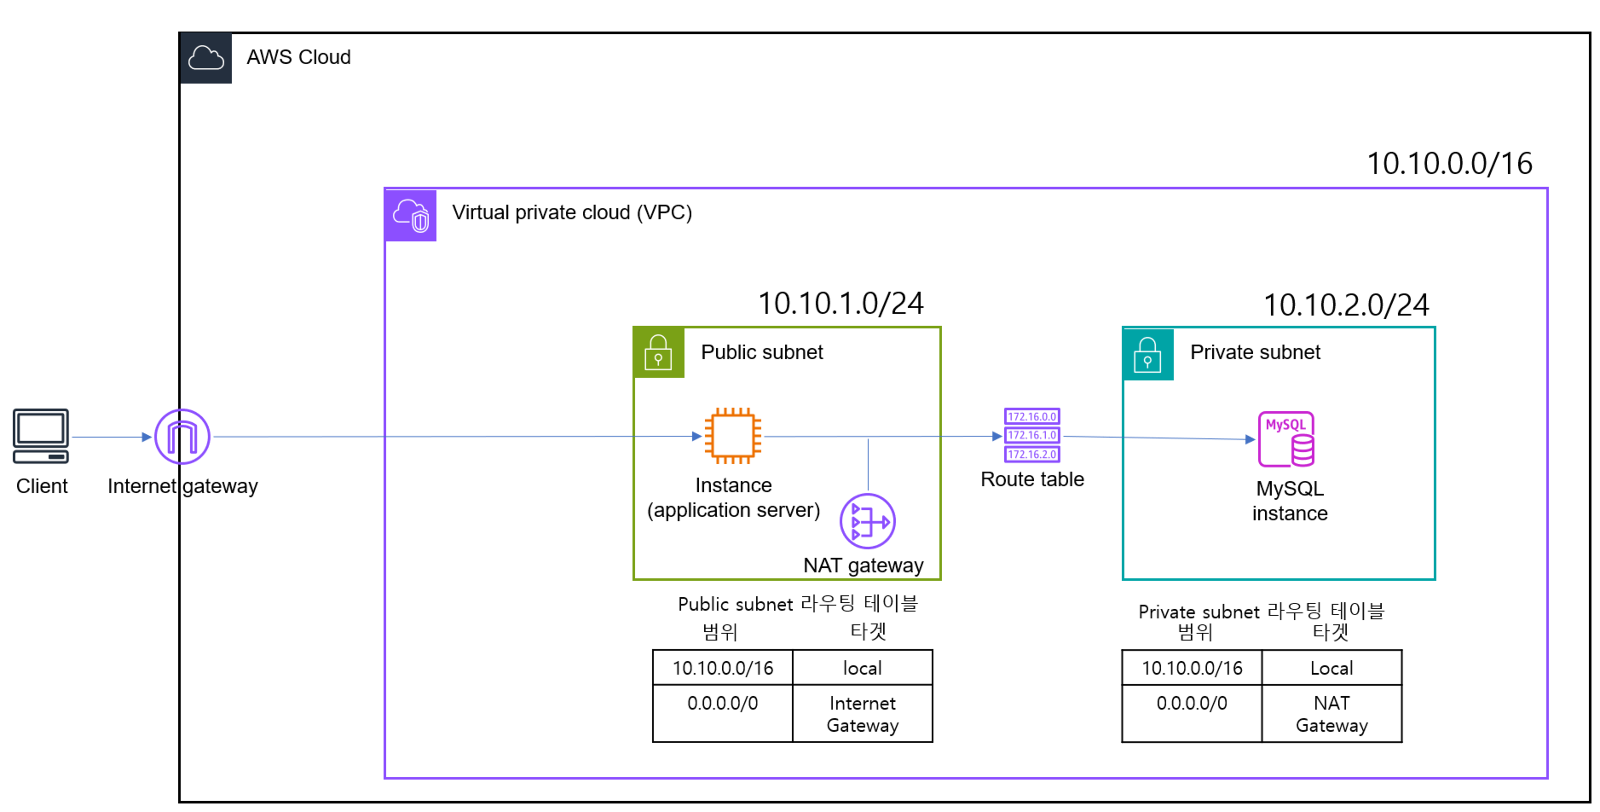
마치며
자 이렇게 해서 AWS의 설정을 모두 마무리지었습니다. 이제 다음 포스팅에선 EC2 인스턴스를 통해 직접 public subnet과 private subnet에 연결해보도록 하겠습니다.
다음 포스팅
https://coding-review.tistory.com/453
데이터베이스 서버와 애플리케이션 서버를 분리해보자 : 실전2 (EC2 생성)
이전 포스팅에서 AWS 설정을 마무리지었습니다. 이번엔 public subnet에 애플리케이션 서버를 두고 private subnet에 데이터베이스 서버를 둬보겠습니다.
이전 포스팅과 이어지는 포스팅입니다.
https://coding-review.tistory.com/452
EC2 연결
1. 보안 그룹 생성
EC2를 만들기 전에 EC2에 연결할 보안그룹을 먼저 생성해주도록 하겠습니다.
EC2 페이지에서 왼쪽 카테고리에 보안 그룹이 있습니다. 보안 그룹을 클릭하고 "보안 그룹 생성"을 클릭합니다.
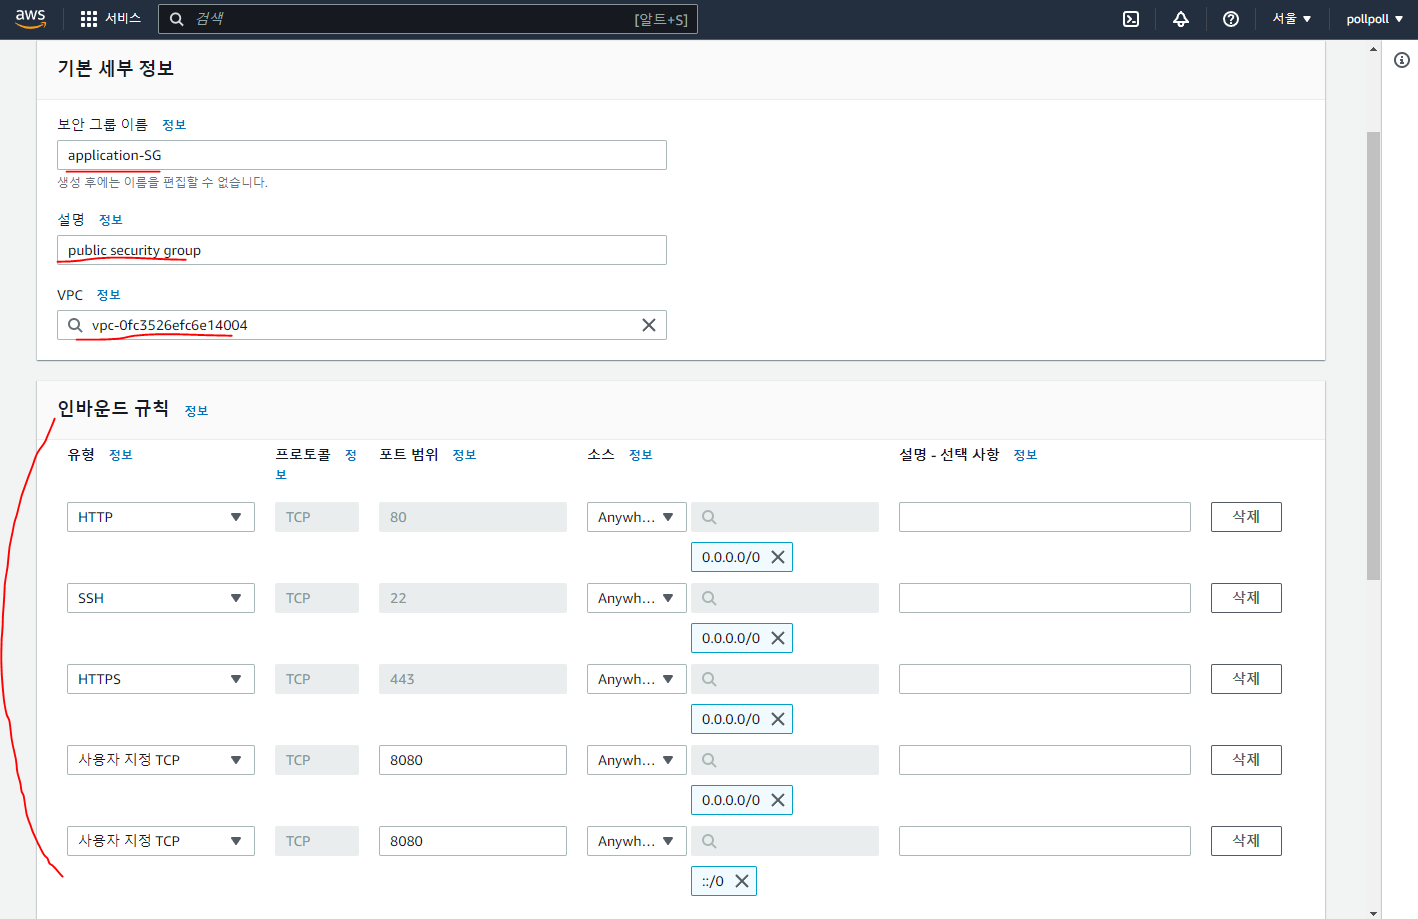
보안 그룹 이름, 설명을 적으시고 VPC는 우리가 만든 VPC를 선택해야합니다.
그리고 인바운드 규칙에 웹 요청인 HTTP와 HTTPS 그리고 Putty를 이용해 들어가기위해 SSH 포트도 열어주고 저는 스프링을 공부하기 때문에 스프링에서 사용하는 대표적인 포트인 8080포트를 열어줬습니다.
이제 데이터베이스 보안 그룹을 생성해봅시다.
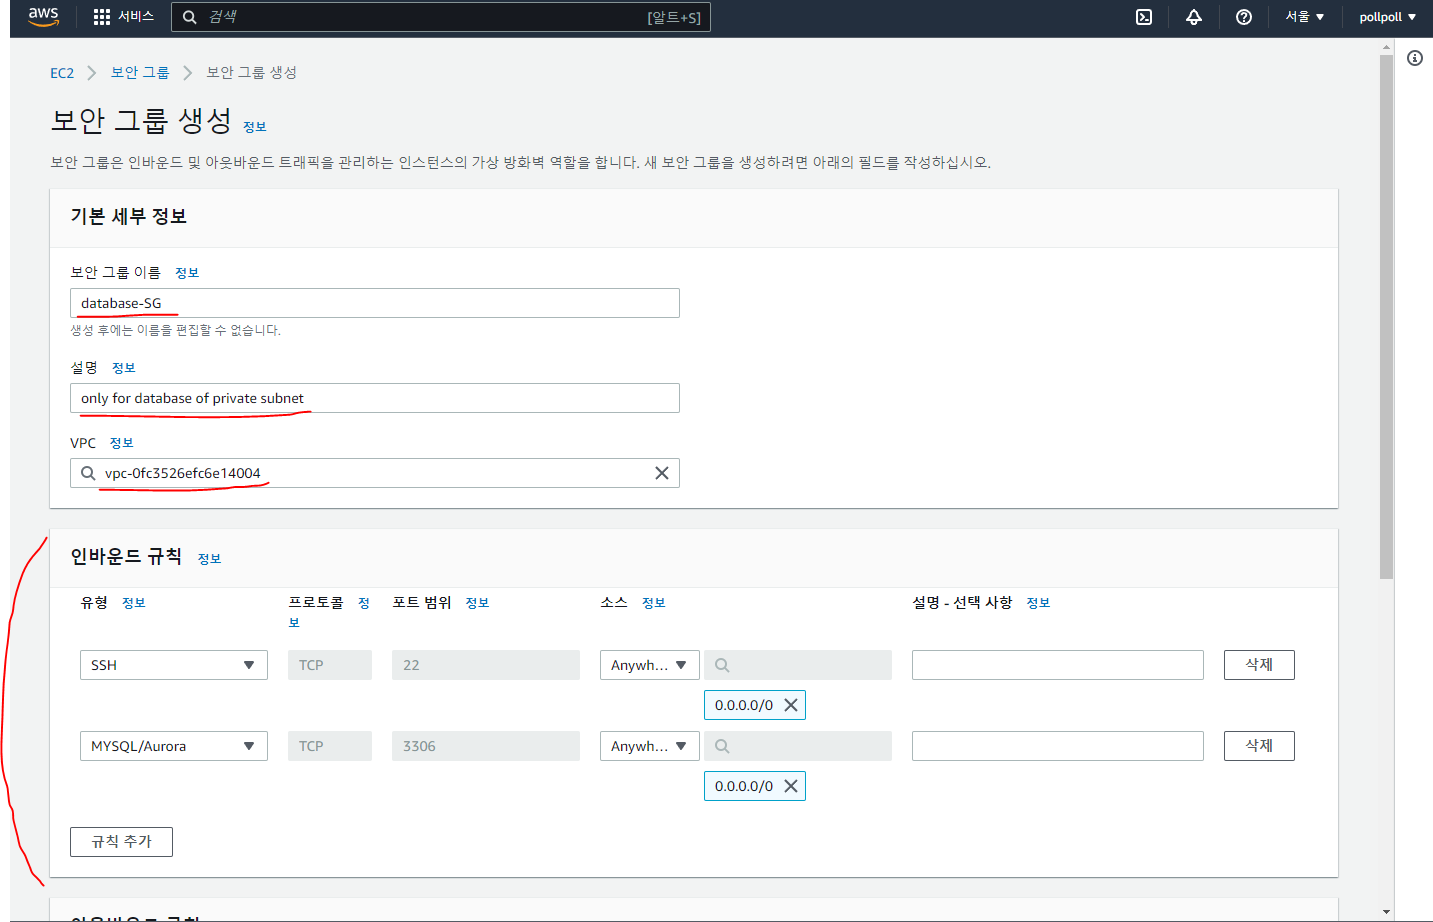
보안 그룹 이름과 설명을 적고, 앞서 설정한 것과 마찬가지로 우리가 만든 VPC를 설정해야합니다.
그리고 인바운드 규칙을 SSH와 저는 MySQL을 사용할 것이기 때문에 3306포트를 열어주도록 하겠습니다.
자 이제 EC2 인스턴스를 만들어보죠
2. application server EC2 생성
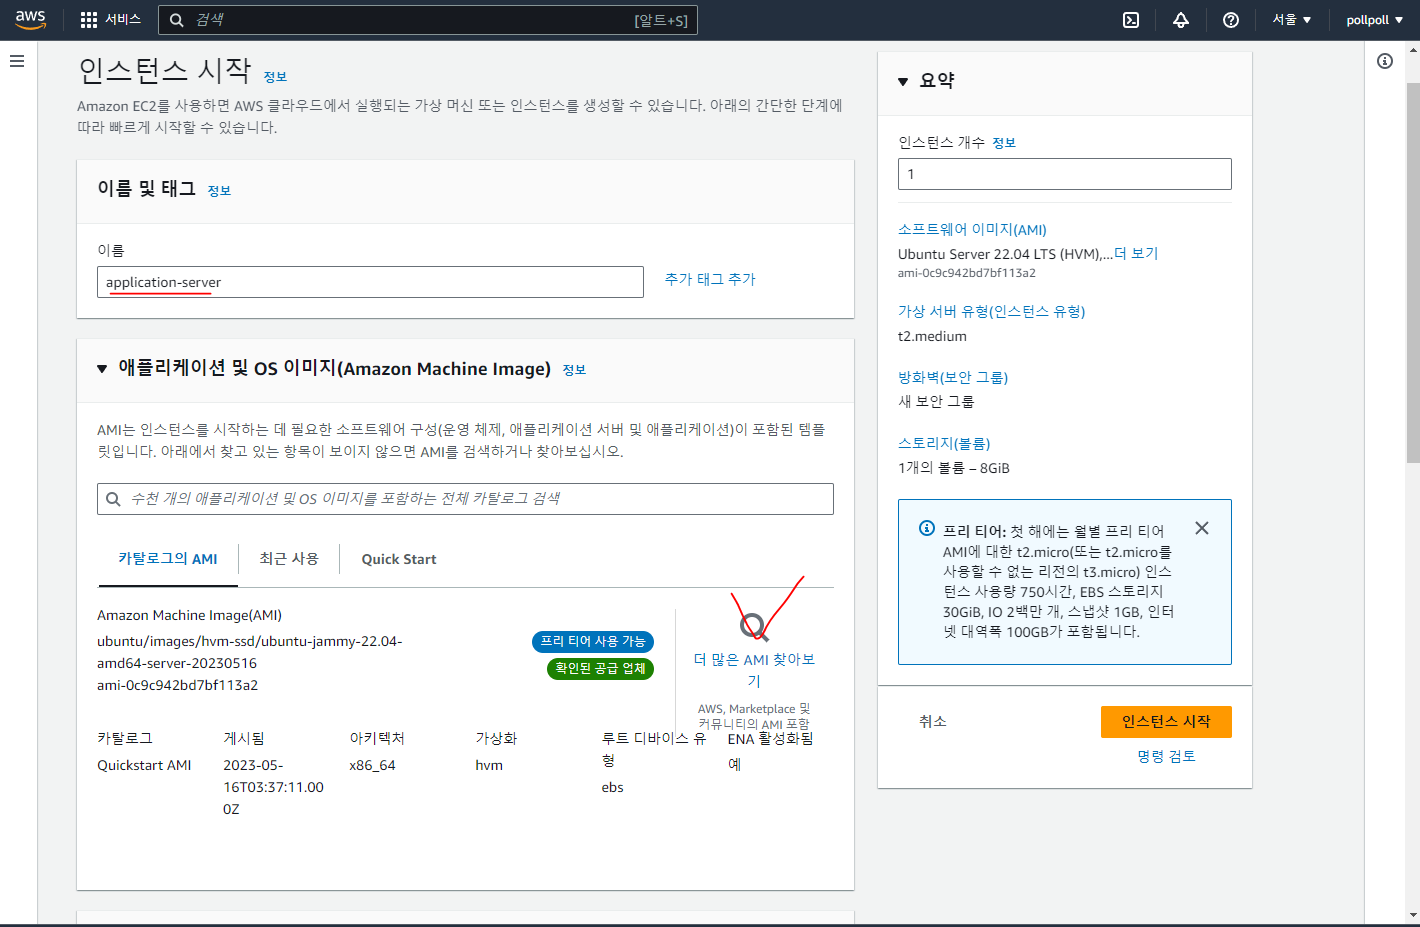
먼저 public subnet에 연결될 application server를 만들어줍니다. AMI는 Ubuntu 22.0.4 LTS 버전을 선택했습니다.
인스턴스는 medium을 선택했습니다. 도커를 사용할 것이기 때문에 medium은 사용해야 렉이 걸리지 않습니다.
물론 medium은 한 달 기준 5만5천원정도 비용이 발생합니다. 때문에 실습하고 갖다버릴 인스턴스입니다...
그리고 키 페어를 생성합니다.
저는 Putty를 사용할 것이기 때문에 ppk를 만들어줍니다.
여기서 pem 키와 ppk 키의 차이를 잠깐 설명하고 넘어가자면 pem은 private key이고 ppk는 public key입니다.
이제 우리가 만든 VPC와 서브넷을 연결해줄겁니다.
맨 처음엔 네트워크 설정이 닫혀있는데 이걸 열어주시고 편집을 눌러줍니다.
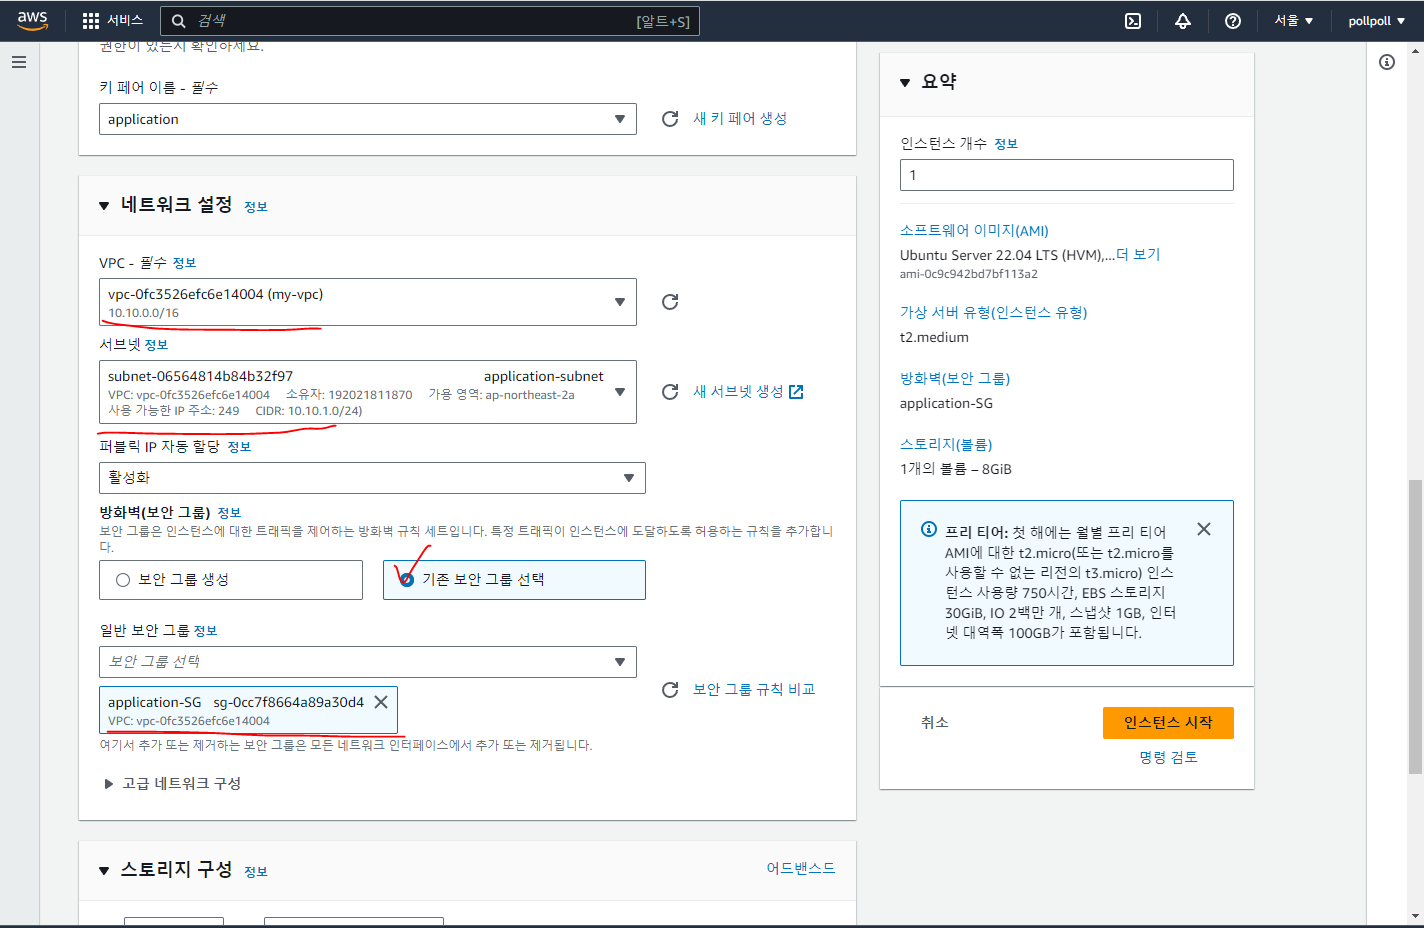
VPC를 우리가 만든 VPC로 선택하고 서브넷은 public subnet을 연결합니다.
그리고 방금 만든 application-SG를 선택합니다.
여기서 다시 정리하자면 application-SG는 웹 요청을 위한 HTTP, HTTPS 그리고 Putty로의 접속을 위한 SSH, 스프링 프로젝트를 위한 8080포트를 열어줬습니다.
3. database server EC2 생성
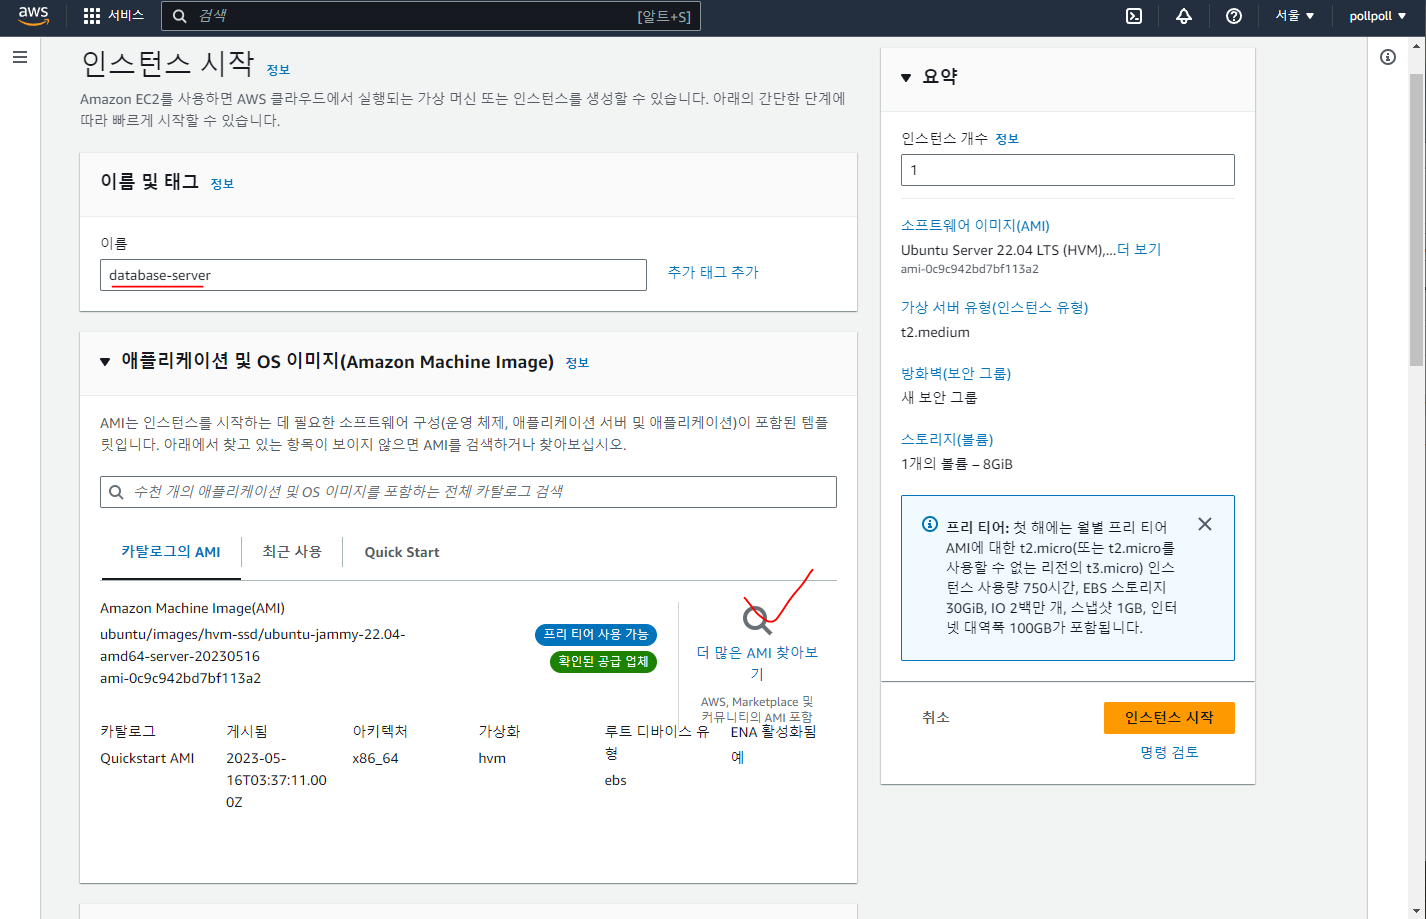
이름을 입력하고 AMI는 Ubuntu 22.0.4 LTS 버전을 선택했습니다.
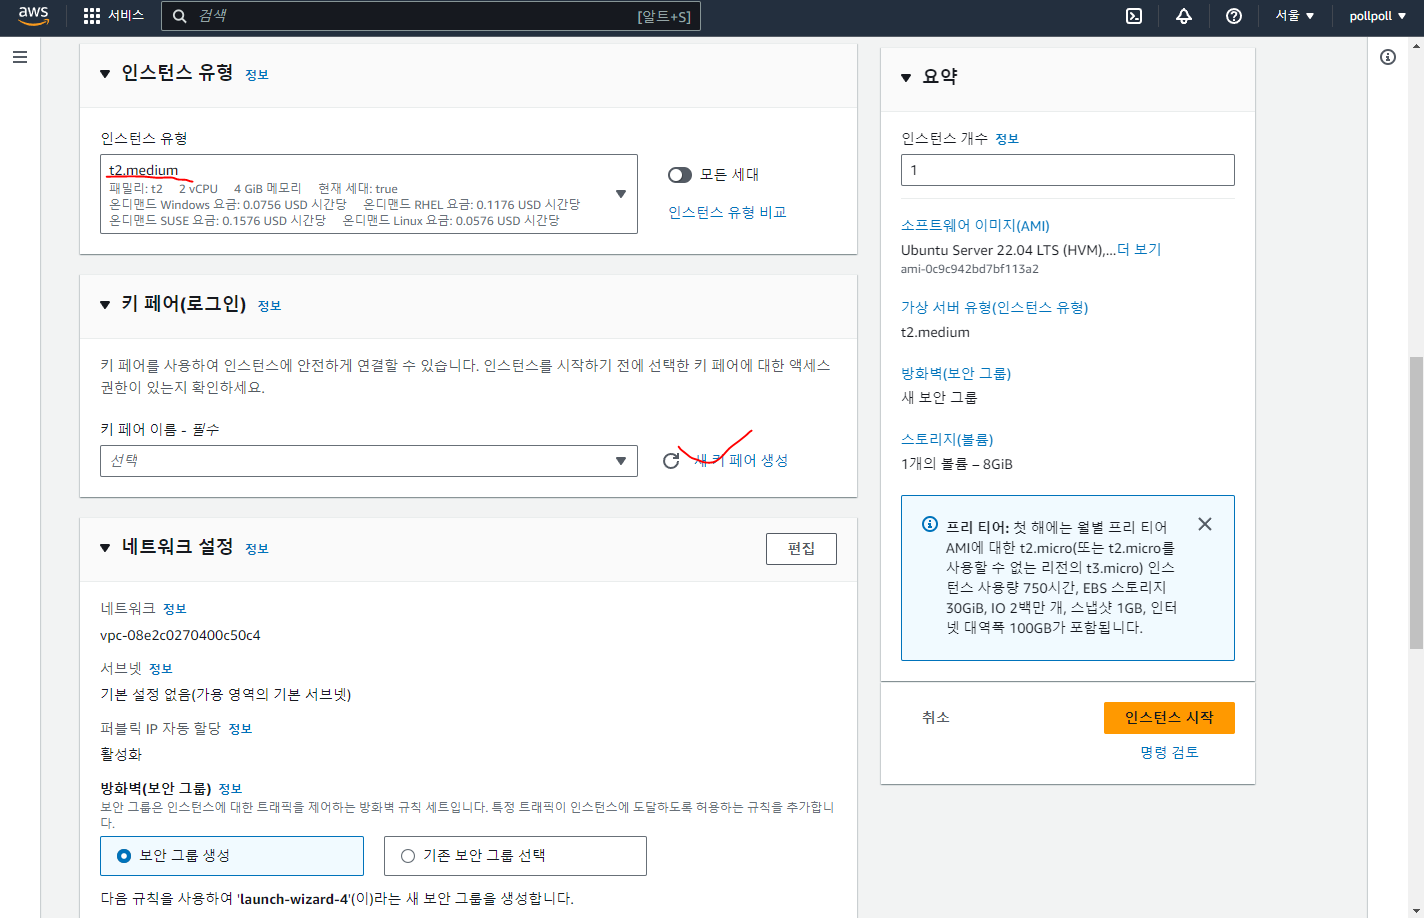
인스턴스도 medium을 선택합니다. 도커를 사용할 것이기 때문이죠.
새 키페어를 만들어봅시다.
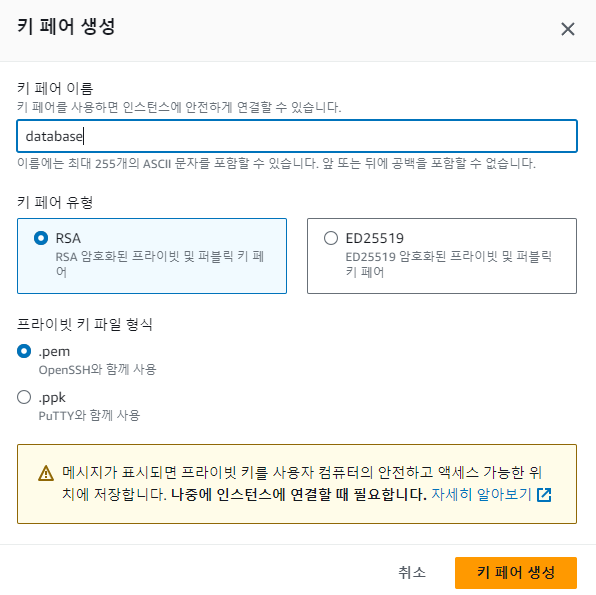
앞서 pem 키와 ppk 키의 차이에 대해서 설명해드렸죠?
키의 특성 때문에 우리는 private subnet에서 운영할 EC2 인스턴스인 데이터베이스 서버의 키를 private 하게 관리해야합니다.
pem 키를 선택하고 키를 생성해줍니다.
그리고 이번에도 마찬가지로 네트워크 설정을 펼쳐주시고 편집을 누릅니다.
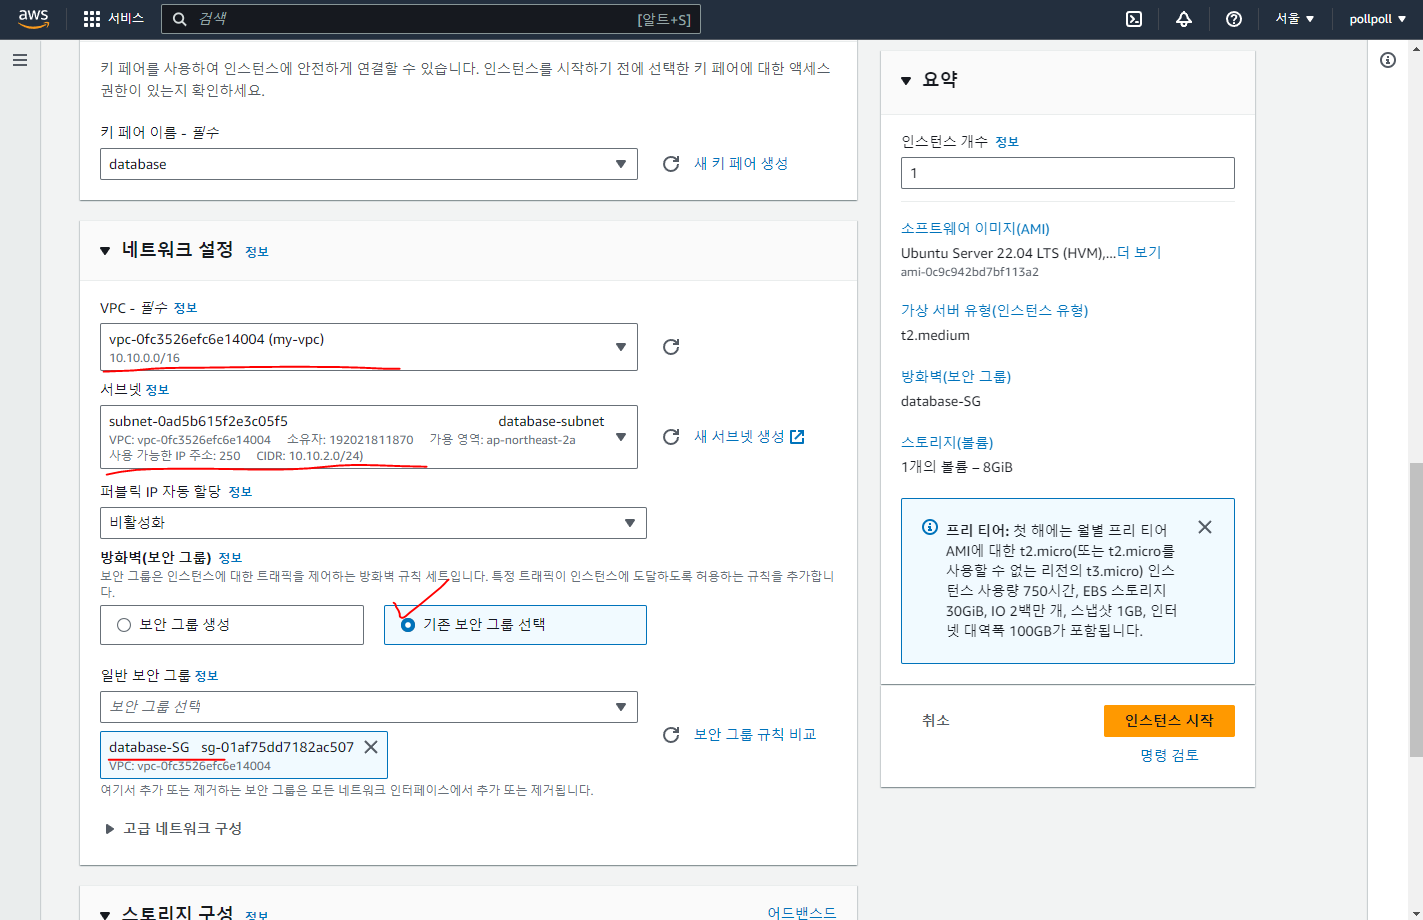
VPC는 우리가 만든 VPC를 선택하고 서브넷은 database-subnet을 선택합니다.
그리고 보안 그룹은 앞서 만들었던 database-SG를 선택합니다.
여기서 다시 정리해보자면 database-SG는 Putty를 이용하기위해 SSH 포트와 MySQL을 위한 3306 포트를 열어두었습니다.
포스팅이 너무 길어져서 EC2 연결은 다음 포스팅에서 다루도록 하겠습니다.
다음 포스팅
https://coding-review.tistory.com/454
데이터베이스 서버와 애플리케이션 서버를 분리해보자 : 실전3 (EC2 연결)
앞선 포스팅에서 우리는 EC2 인스턴스를 생성했습니다. 이제 우리는 EC2 인스턴스에 접속해보도록 하겠습니다.
이전 포스팅과 연결되는 포스팅입니다.
https://coding-review.tistory.com/453
바로 시작해보죠
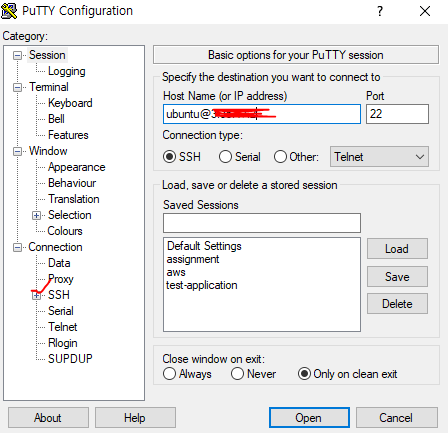
PuTTY를 키고 Host Name에는 application-server 인스턴스의 퍼블릭 IPv4 주소를 입력해줍니다. 그리고 SSH 탭에 들어가서 Auth로 들어갑니다.
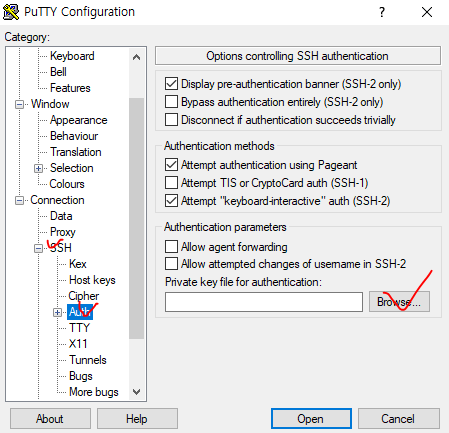
우리가 아까 만들었던 키 페어인 ppk 키를 연결합니다.
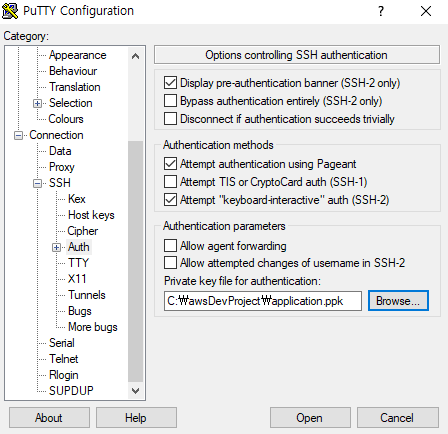
그리고 Open을 누르면?
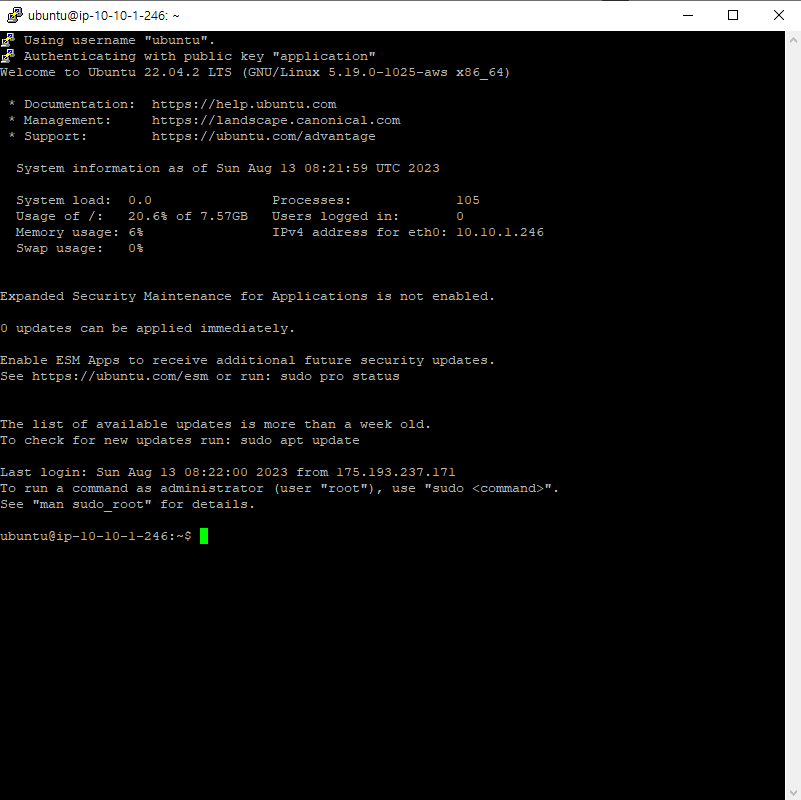
자 연결이 되었습니다. 이제 이 public subnet을 통해 private subnet으로 들어갈겁니다.
그러려면 필요한 것이 이전에 우리가 만든 키 페어인 pem 키가 필요합니다.
EC2 인스턴스로 pem키를 가져오는 방법에 여러가지 방법이 있습니다. FTP를 사용하는 방법이 있고 S3를 이용하는 방법이 있습니다.
저는 비교적 간단하다고 생각했던 S3를 이용해서 가져와보도록 하겠습니다.
먼저 AWS CLI를 다운받아야합니다.
$ curl "https://awscli.amazonaws.com/awscli-exe-linux-x86_64.zip" -o "awscliv2.zip"
$ unzip awscliv2.zip
$ sudo ./aws/install
$ aws --version
aws-cli/2.7.9 Python/3.9.11 Linux/5.13.0-51-generic exe/x86_64.ubuntu.20 prompt/off
$ rm -f awscliv2.zip # 설치 되었으면 zip 파일은 지워주도록 합시다. 용량이 넉넉하지 않으니..
이렇게 AWS 자원에 접근할 준비가 되었습니다.
그리고 aws 설정을 진행해줘야합니다.
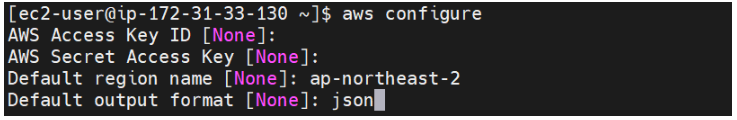
Access key와 Secret Access key는 IAM을 만들 때 받았던 credential입니다. 여기선 IAM과 관련된 내용을 포스팅하기 조금 그렇기 때문에 나중에 다른 포스팅으로 찾아뵙도록 하겠습니다.
이제 S3에 우리가 만들었던 pem키를 업로드합니다.
S3에 관련된 내용도 해당 포스팅과 결이 달라서 다른 포스팅으로 찾아뵙도록 하겠습니다.
S3에 업로드 하고, S3 URI를 복사합니다.
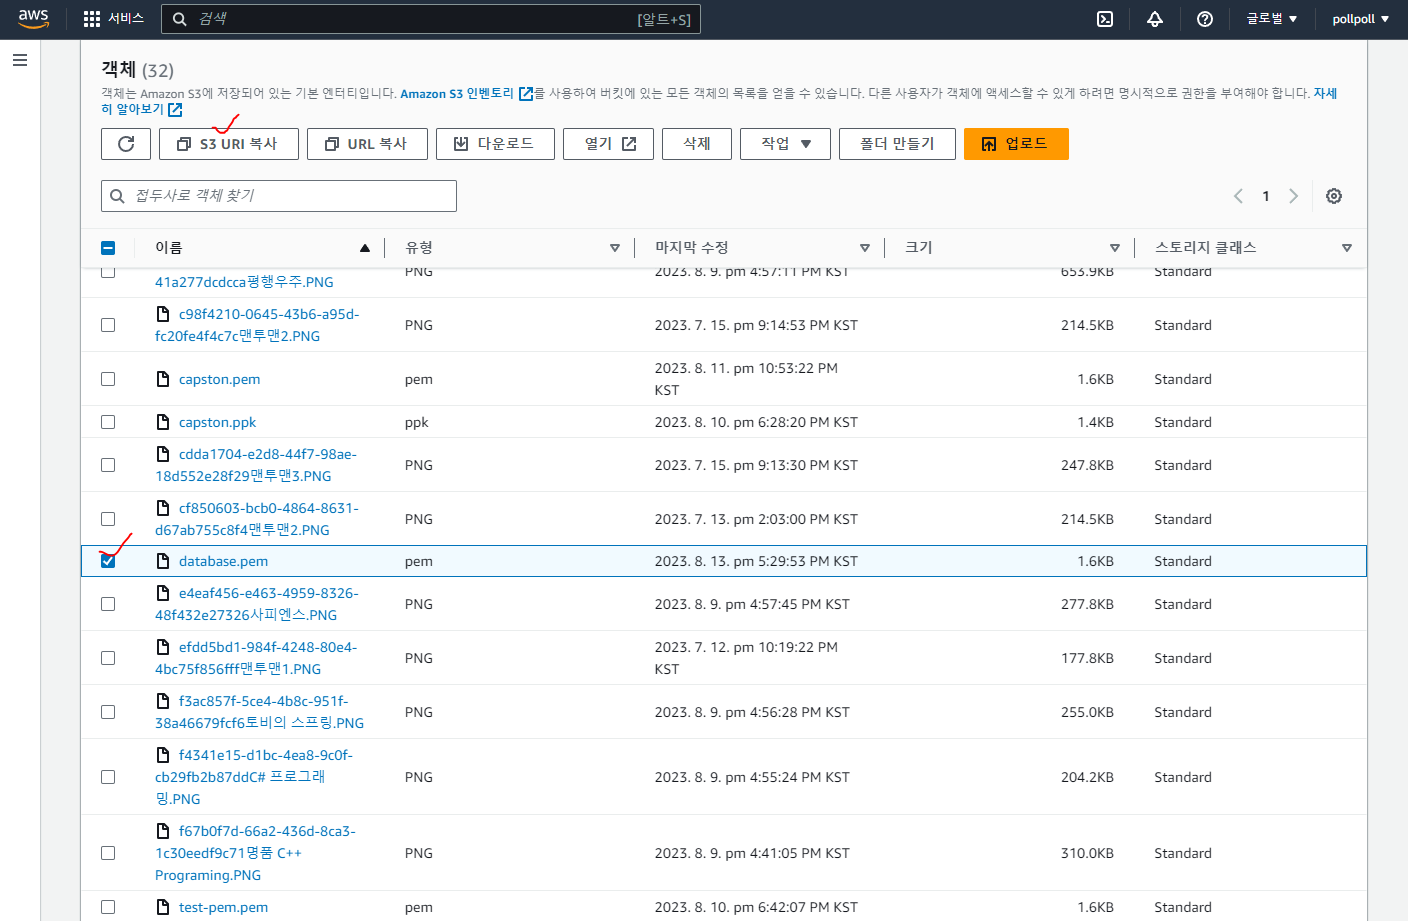
그리고 다시 PyTTY로 돌아와서
해당 명령어를 적습니다.
$ aws s3 cp <아까 복사했던 S3 URI> ./database.pem
그럼 다운로드가 됩니다.
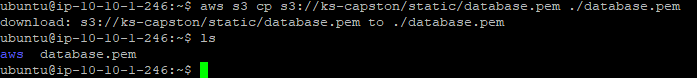
이제 다운받은 pem키의 권한을 조금 낮춰주겠습니다.
$ sudo chmod 400 ./database.pem
그리고 이제 private subnet으로 접근해보겠습니다.
$ ssh -i database.pem ubuntu@<database-server의 private IPv4>
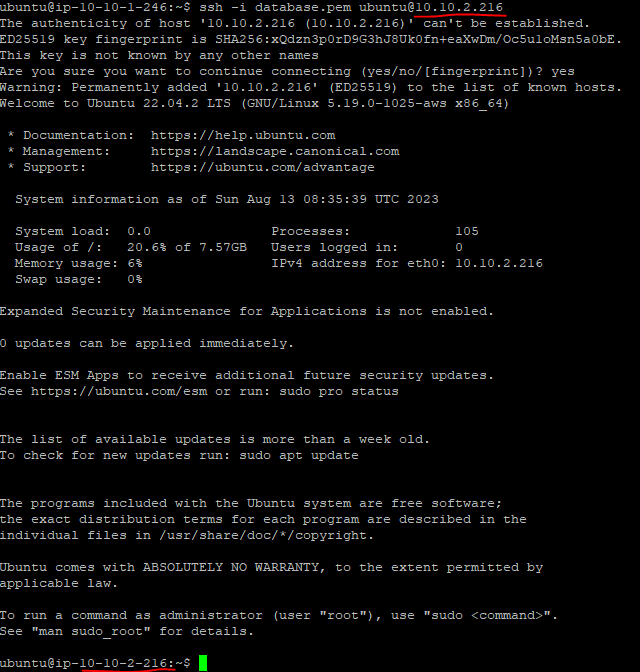
우리가 요청한 밑줄 친 부분을 보시면 우리가 요청한 private IPv4에 잘 접속한 것을 알 수 있습니다.
그리고 ls 같은 명령어를 쳐보면 우리가 아까 다운 받았던 aws cli나 pem 키가 없는 것을 보아하니 정말 다른 서브넷에 접속한 것임을 알 수 있습니다.
이제 다음 포스팅에선 MySQL을 설치하고 DBeaver와 연결해보겠습니다.
다음 포스팅
https://coding-review.tistory.com/455
데이터베이스 서버와 애플리케이션 서버를 분리해보자 : 실전4 (MySQL 설치, DBeaver 연결)
우리는 앞서 private subnet에 접근하는데 성공했습니다. 이제 여기에 도커와 MySQL을 설치하고 외부 연결 서비스인 DBeaver에 연결해보도록 하겠습니다.
이전 포스팅과 이어지는 포스팅입니다.
https://coding-review.tistory.com/454
도커로 MySQL 띄우기
우선 도커와 도커 컴포즈를 다운받습니다.
$ sudo apt-get update
$ sudo apt-get install docker
$ sudo apt-get install docker-compose
우리가 만약 NAT 게이트웨이를 설정하지 않았다면 위의 명령어는 에러를 내뱉습니다.
NAT 게이트웨이를 통해 외부 네트워크 통신이 가능했기 때문에 가능한 명령어입니다.
이제 MySQL을 컨테이너로 띄워보죠.
$ (sudo) docker pull mysql:8.0.33
$ mkdir docker
$ cd docker
$ vim docker-compose-mysql.yml
docker 이미지를 풀링하는데 만약 에러가 뜬다면 sudo를 붙여서 한번 도전해보세요!
이제 docker-compose 를 만들어봅시다.
version: "3.8"
services:
db:
image: mysql:8.0.33
container_name: mysql-container
ports:
- "3306:3306"
environment:
MYSQL_ROOT_PASSWORD: "password"
command:
- --character-set-server=utf8mb4
- --collation-server=utf8mb4_unicode_ci
volumes:
- /Users/ks/datadir:/var/lib/mysql
이렇게 만들어 두고 이제 실행해서 컨테이너를 띄워보죠.
$ sudo docker-compose -f ./docker-compose-mysql.yml up -d
이렇게 MySQL을 띄웠습니다.
이제 사용자를 만들고 연결이 진짜 됐는지 확인하기위한 테스트 데이터베이스를 하나 만들고 DBeaver로 접속해보겠습니다.
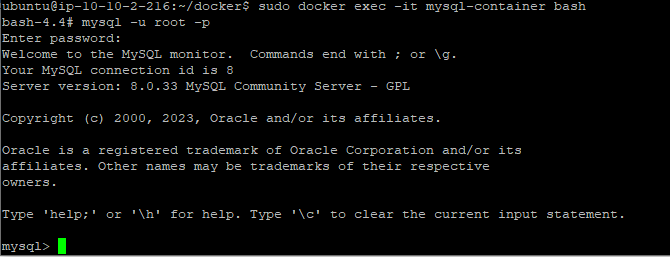
패스워드는 아까 우리가 만든 yml 파일에서 만든 password입니다.
mysql> CREATE USER 'test'@'%' IDENTIFIED BY 'password';
Query OK, 0 rows affected (0.00 sec)
mysql> GRANT ALL PRIVILEGES ON *.* TO 'test'@'%';
Query OK, 0 rows affected (0.00 sec)
mysql> flush privileges;
Query OK, 0 rows affected (0.00 sec)
이렇게 사용자를 만들어두고 데이터베이스를 하나 만들어보죠
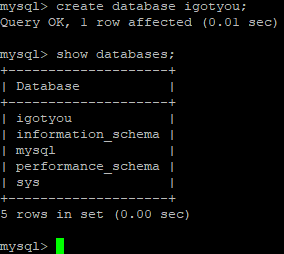
좀 특이한 이름을 지어야 이따 DBeaver에 연결했을 때 바로 알 수 있을 것 같아서 특이한 이름을 하나 만들었습니다.
자 이제 DBeaver로 가보죠.
DBeaver 연결
왼쪽위 연결 버튼을 클릭하고 MySQL을 선택합니다.
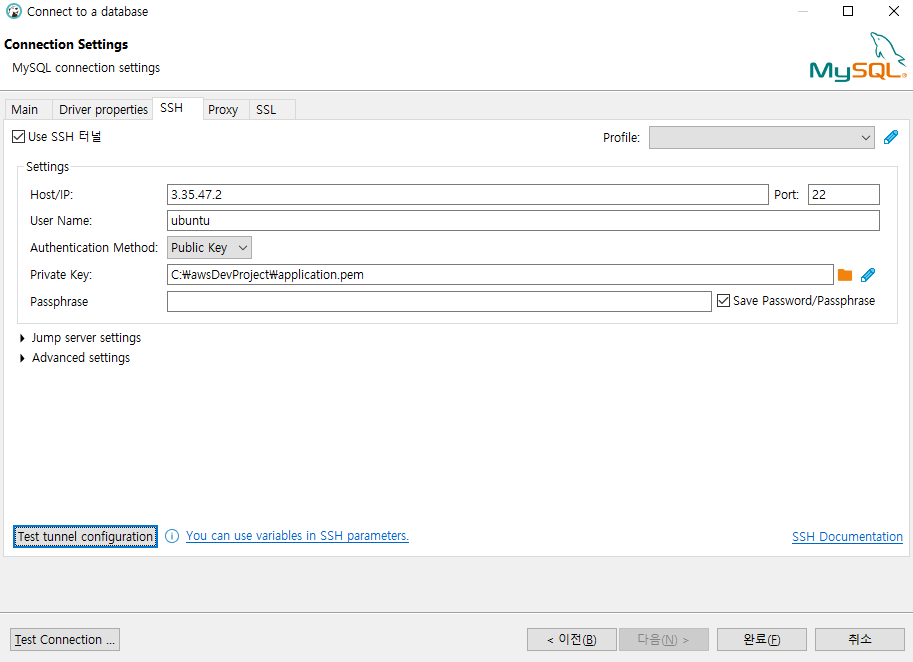
SSH 탭에서 다음과 같이 입력합니다.
1. Use SSH 체크
2. Host/IP 에 우리가 만든 application-server EC2 인스턴스의 퍼블릭 IPv4를 입력합니다.
3. User Name 에 우리는 Ubuntu 22.0.4 LTS 버전이기 때문에 ubuntu를 입력합니다. 만약 아마존 리눅스라면 ec2-user를 입력합니다.
4. Authentication Method 를 Public Key로 바꿔주고
5. Private Key에 우리의 ppk 키를 pem 키로 변환한 뒤 pem 키를 입력합니다.
여기서 잠깐! ppk 를 pem으로 변환하는 방법
PuTTY를 설치했다면 puttygen이라는 exe 파일이 있을겁니다. 우리는 puttygen을 이용해 ppk 를 pem으로 바꿀겁니다.
Load를 누르고 우리의 application.ppk 파일을 선택합니다.
이렇게 선택이 되었고 위의 메뉴에서 Conversions에서 Export Open SSH Key를 클릭합니다.
모두 예를 누르고 원하는 이름을 입력합니다. 저는 application.pem 으로 만들었습니다.
그럼 이렇게 pem 키가 만들어집니다.
이걸 DBeaver Private Key에 넣어줍니다.
Test tunnel configuration을 눌러보면 Connected가 잘 보입니다. 만약 Auth fail이 뜬다면 DBeaver 버전업을 하셔야합니다.
그리고 다시 Main으로 돌아옵니다.
1. Server Host 에는 우리의 database-server의 프라이빗 IPv4를 입력합니다.
2. Username에는 이전에 MySQL 컨테이너 내부에서 create user 'test'@'%' identifed 'password'; 를 기억하시면 됩니다.
3. Password에는 identified 뒤에 적었던 password를 입력하면 됩니다.
이제 Test Connection 을 클릭하면?
어? 이건 뭐죠?
이건 allowPublicKeyRetrieval을 True로 설정해주지 않아서 그렇습니다.
바로 이부분입니다. 위의 Driver properties 의 저부분을 TRUE로 바꿔줍니다.
바꾸고 Test Connection을 누르면?
이렇게 잘 연결된 것을 볼 수 있습니다.
이제 우리가 만들었던 igotyou 데이터베이스가 있는지 확인해봐야죠!
잘 있군요.
마치며
자 이렇게 길고도 긴 여정이 끝났습니다.
우리는 VPC와 서브넷, 라우터와 라우팅 테이블, 인터넷 게이트웨이, NAT 게이트웨이에 대해서 개념적으로 알아봤고, 실전을 통해 데이터베이스 서버와 애플리케이션 서버를 분리했습니다.
스프링하고 연결하는건 정말 어렵지 않기 때문에 포스팅하지 않았습니다. 스프링하고의 연결은 application.yml 파일에 datasource 부분의 url을
jdbc:mysql://<database-server의 프라이빗 IPv4>:3306/<데이터베이스 이름>?serverTimezon=UTC&characterEncoding=UTF-8
이렇게 적어주면 됩니다.
어? 스프링 프로젝트는 어떻게 private subnet에 접근할 수 있는건가요?
그것은 바로 스프링 프로젝트 자체가 public subnet에 위치하고 있기 때문입니다. 기억을 잘 떠올려보면 우리가 private subnet에 접근하기 위해 어떤 절차를 거쳤었죠?
맞습니다. pem 키를 가지고 프라이빗 IPv4에 접근했습니다. public subnet에서는 프라이빗 IPv4 주소만 알고 있으면 언제든지 라우팅 테이블을 통해 접근이 가능합니다.
우리는 private subnet의 라우팅 테이블을 SSH 통신이 가능하게끔 22포트를 열어줬고 MySQL을 사용할 것이기 때문에 3306 포트를 열어줬었죠?
때문에 public subnet에 존재하고있는 스프링 프로젝트는 프라이빗 IPv4와 3306 포트만 알고 있으면 언제든지 접근할 수 있습니다.
이 방식은 우리가 DBeaver로 private subnet에 위치하고 있는 데이터베이스에 연결한 것과 같은 이치입니다.
자 이렇게 긴 여정을 끝내도록 하겠습니다. 블로그 포스팅만 거의 4시간 가까이 걸렸네요.
정말 긴 글 읽어주셔서 감사합니다. 오늘도 즐거운 하루 되세요~
세션 Authentication 객체로 관리하기
요즘 공부할게 딱히 없을 때 포트폴리오로 작성했던 사이드프로젝트 온라인 쇼핑몰의 고도화를 진행하고 있습니다.
고도화라고 해봐야 별게 없지만... 버전을 4버전까지 업그레이드 하면서 대부분 성능개선 혹은 인프라적인 개선이 이루어졌습니다.
블로그 카테고리 "사이드 프로젝트" 부분을 참고해주세요!
하지만 코드는 2년전에 작성한 그대로 유지하고 있어서 굉장히 비효율적인 코드라던가 확장에 유연하지 않다던가하는 문제가 있었습니다.
이번 리팩토링은 세션 관리를 Authentication 객체를 이용해서 관리하도록 변경하였습니다.
기존 코드를 먼저 보시죠!
if (loginId == null)) {
User findUser = cacheRepository.findUserAtCache(username);
Comment comment = new Comment(null, findUser, findItem, form.getComment(), imageUrl);
saveComment = commentRepository.save(comment);
}
if (userEmail == null) {
Member findMember = cacheRepository.findMemberAtCache(username);
Comment comment = new Comment(findMember, null, findItem, form.getComment(), imageUrl);
saveComment = commentRepository.save(comment);
}
이건 댓글과 관련된 Service 레벨 코드인데 저는 소셜 로그인 사용자와 일반 로그인 사용자를 분리해서 관리하고 있기 때문에 이렇게 둘로 나눠서 조건문을 넣어야 했습니다.
때문에 일반 로그인 회원 테이블인 Member 테이블에 소셜 로그인 사용자를 동시에 관리하는 방향으로 리팩토링을 진행했습니다.
더불어, 로그인시 세션에 loginId, userEmail 을 저장하여 일반 로그인 사용자는 userEmail 세션 값이 null 인 점을 이용해 로직을 구현하게 되었습니다.
하지만 이러한 null 체크는 안티 패턴이라는 얘기를 듣고 이런 패턴을 리팩토링하기로 마음먹었습니다.
MemberRole memberRole = roleService.whatIsRole(authentication);
UserDetails principal = (UserDetails) authentication.getPrincipal();
String username = principal.getUsername();
if (isRoleMember(memberRole)) {
findMember = cacheRepository.findMemberAtCache(username);
myBucket = temporaryOrderService.findTOrderListByMemberId(findMember.getId());
totalAmount = findTotalAmountByMemberId(findMember.getId());
role = findMember.getRole();
}
private boolean isRoleMember(MemberRole memberRole) {
return memberRole.equals(MemberRole.ROLE_MEMBER) || memberRole.equals(MemberRole.ROLE_SOCIAL);
}
@Service
public class WhatIsRoleService {
public MemberRole whatIsRole(Authentication authentication) {
boolean isRoleMember = authentication.getAuthorities().stream().anyMatch(role -> role.equals(MemberRole.ROLE_MEMBER));
boolean isRoleSocial = authentication.getAuthorities().stream().anyMatch(role -> role.equals(MemberRole.ROLE_SOCIAL));
if (isRoleMember) {
return MemberRole.ROLE_MEMBER;
}
else if (isRoleSocial) {
return MemberRole.ROLE_SOCIAL;
}
return MemberRole.ROLE_MEMBER;
}
}
이제 세션으로 관리하는 것이 아닌 Authentication 객체를 이용해 사용자를 분류하고 알맞는 로직을 실행할 수 있게 되었습니다.
이중 for 문 stream API 로 깔끔하게 정리하기
이번에 눈에 들어온 그지같은 코드는 바로 이중 for문입니다.
우선 리팩토링 전 코드부터 보시죠.
package com.hello.capston.service;
import com.hello.capston.entity.*;
import com.hello.capston.repository.ItemDetailRepository;
import com.hello.capston.repository.OrderItemRepository;
import lombok.RequiredArgsConstructor;
import lombok.extern.slf4j.Slf4j;
import org.hibernate.TransactionException;
import org.springframework.security.core.parameters.P;
import org.springframework.stereotype.Service;
import org.springframework.transaction.annotation.Isolation;
import org.springframework.transaction.annotation.Transactional;
import java.util.Comparator;
import java.util.List;
import java.util.Map;
import java.util.concurrent.ConcurrentHashMap;
@Service
@RequiredArgsConstructor
@Slf4j
public class OrderItemService {
private final OrderItemRepository orderItemRepository;
private final ItemDetailRepository itemDetailRepository;
private boolean flag = true;
private Map<String, String> map = new ConcurrentHashMap<>();
@Transactional
public Map<String, String> saveUsingTemporaryOrder(List<TemporaryOrder> tOrder, Order order) {
for (TemporaryOrder temporaryOrder : tOrder) {
Item findItem = temporaryOrder.getBucket().getItem();
OrderItem orderItem = new OrderItem(findItem, order, temporaryOrder.getPrice(), temporaryOrder.getCount());
// 아래의 코드에서 락이 걸렸기 때문에 다음으로 못넘어감
// 때문에 최종적으로 save() 메서드가 호출되는 곳이 동시성 문제에서 해결될 수 있음
List<ItemDetail> findItemDetail = itemDetailRepository.findByItemId(findItem.getId());
try {
for (ItemDetail itemDetail : findItemDetail) {
if (temporaryOrder.getSize().equals(itemDetail.getSize()) && itemDetail.getStock() > 0) {
itemDetail.changeStock(temporaryOrder.getCount());
itemDetailRepository.save(itemDetail);
}
else if (temporaryOrder.getSize().equals(itemDetail.getSize()) && itemDetail.getStock() <= 0) {
flag = false;
}
}
if (flag) {
orderItemRepository.save(orderItem);
}
else {
throw new TransactionException("상품의 재고가 없습니다.");
}
} catch (TransactionException e) {
map.put("message", "상품의 재고가 없습니다.");
}
}
return map;
}
}
저는 이중 for문이 필요한 곳에서는 사용되어야한다고 생각합니다만... 문제는 읽기가 굉장히 힘들다는 점이 문제가 됩니다.
물론 stream API도 읽기 힘든건 마찬가지입니다. 하지만 요즘 드는 생각은 들여쓰기는 최대한 줄이는 것이 코드를 보기 편하다는 것을 깨달았습니다. (개인적인 생각입니다.)
그래서 이 이중 for문으로 들여쓰기가 마구 되어있는 코드를 최대한 깔끔하게 다듬어보았습니다.
package com.hello.capston.service;
import com.hello.capston.entity.*;
import com.hello.capston.repository.ItemDetailRepository;
import com.hello.capston.repository.OrderItemRepository;
import lombok.RequiredArgsConstructor;
import lombok.extern.slf4j.Slf4j;
import org.hibernate.TransactionException;
import org.springframework.security.core.parameters.P;
import org.springframework.stereotype.Service;
import org.springframework.transaction.annotation.Isolation;
import org.springframework.transaction.annotation.Transactional;
import java.util.Comparator;
import java.util.List;
import java.util.Map;
import java.util.concurrent.ConcurrentHashMap;
@Service
@RequiredArgsConstructor
@Slf4j
public class OrderItemService {
private final OrderItemRepository orderItemRepository;
private final ItemDetailRepository itemDetailRepository;
private boolean flag = true;
private Map<String, String> map = new ConcurrentHashMap<>();
@Transactional
public Map<String, String> saveUsingTemporaryOrder(List<TemporaryOrder> tOrder, Order order) {
for (TemporaryOrder temporaryOrder : tOrder) {
Item findItem = temporaryOrder.getBucket().getItem();
OrderItem orderItem = new OrderItem(findItem, order, temporaryOrder.getPrice(), temporaryOrder.getCount());
// 아래의 코드에서 락이 걸렸기 때문에 다음으로 못넘어감
// 때문에 최종적으로 save() 메서드가 호출되는 곳이 동시성 문제에서 해결될 수 있음
List<ItemDetail> findItemDetail = itemDetailRepository.findByItemId(findItem.getId());
ItemDetail itemDetailWithFilter =
findItemDetail.stream()
.filter(itemDetail -> temporaryOrder.getSize().equals(itemDetail.getSize()))
.findAny()
.orElse(new ItemDetail());
if (itemStockIsOverZero(itemDetailWithFilter)) {
itemDetailWithFilter.changeStock(temporaryOrder.getCount());
itemDetailRepository.save(itemDetailWithFilter);
}
else {
flag = false;
}
if (flag) {
orderItemRepository.save(orderItem);
}
else {
map.put("message", "상품의 재고가 없습니다.");
}
}
return map;
}
private boolean itemStockIsOverZero(ItemDetail itemDetailWithFilter) {
return itemDetailWithFilter.getStock() > 0;
}
}
해당 코드를 리팩토링하는 김에 그지같이 되어있던 예외처리도 깔끔하게 바꿨습니다.
이 코드 이외에도 제 프로젝트에 많은 부분을 깔끔하게 리팩토링 하였습니다.
다형성을 이용해 if else 블럭 추상화하기
취준때 개발했던 온라인쇼핑몰 프로젝트는 약 2년전에 개발한만큼 돌아가게만 만든 경향이 있는 코드들입니다.
읽기 힘든 코드는 물론이고 확장성을 고려하지않은 구조가 많았습니다.
제 프로젝트에서 문제가 된 부분을 단순화해서 보여드리고 어떻게 리팩토링 하였는지 포스팅해보려고합니다.
if else 블럭을 추상화?
한번 이런 상황을 가정해보도록 하겠습니다.
우리 프로젝트는 관리자 (ADMIN), 매니저 (MANAGER), 일반회원 (MEMBER)에 따라 할인이나 결제에 대한 정책이 다르게 설정되어있습니다.
때문에, 할인정책에서도 관리자, 매니저, 일반회원인지를 확인하고 정책을 적용해야하고 결제정책 또한 마찬가지입니다. 그 결과 제 코드는 이런 방식으로 짜게되었습니다.
@Service
public class PaymentService {
public void payment(MemberRole role) {
if (role.equals(MemberRole.ROLE_ADMIN)) {
// payment logic for admin
}
else if (role.equals(MemberRole.ROLE_MEMBER)) {
// payment logic for manager
}
else {
// payment logic for member
}
}
}
@Service
public class DiscountService {
public void discount(MemberRole role) {
if (role.equals(MemberRole.ROLE_ADMIN)) {
// discount logic for admin
}
else if (role.equals(MemberRole.ROLE_MANAGER)) {
// discount logic for manager
}
else {
// discount logic for member
}
}
}
이런 코드를 우리 프로젝트에 처음 투입된 사람이 본다면 어떨까요? 직관적이긴 할겁니다. 아 할인정책을 역할에 맞게 적용하고, 결제정책도 역할에 맞게~ 음음 이해했어.
하지만 이런 상황은 문제가 있습니다.
• if else 블럭 안에 있는 로직이 길어지면 이해하기 힘들다. (심각도 : 낮음)
• if else 문이 사실 안에 내용만 다르고 조건문은 항상 고정 => if else 문이 중복됨 (심각도 : 중간)
• 만약 새로운 역할이 추가되면 모든 정책에 else if 문을 추가하여 코드를 수정해야함 (심각도 : 높음)
특히 3번이 왜 문제인가 살펴보면 객체지향의 5대원칙 SOLID 중 OCP를 위배하는 상황입니다.
리팩토링
이제 이 상황을 해결해보도록하겠습니다.
먼저 모든 정책을 관리하는 인터페이스를 하나 만들어줍니다.
public interface Policy {
void discountPolicy();
void paymentPolicy();
}
그리고 각 역할에 맞는 구현체를 만들어줄겁니다.
@Slf4j
public class AdminPolicy implements Policy {
@Override
public void discountPolicy() {
log.info("admin discount policy call");
}
@Override
public void paymentPolicy() {
log.info("admin payment policy call");
}
}
@Slf4j
public class ManagerPolicy implements Policy {
@Override
public void discountPolicy() {
log.info("manager discount policy call");
}
@Override
public void paymentPolicy() {
log.info("manager payment policy call");
}
}
@Slf4j
public class MemberPolicy implements Policy {
@Override
public void discountPolicy() {
log.info("member discount policy call");
}
@Override
public void paymentPolicy() {
log.info("member payment policy call");
}
}
그리고 각 Service 코드들을 수정해보겠습니다.
@Service
public class PaymentService {
public void payment(MemberRole role) {
Policy policy = getPolicy(role);
policy.paymentPolicy();
}
private Policy getPolicy(MemberRole role) {
if (role.equals(MemberRole.ROLE_ADMIN)) {
return new AdminPolicy();
}
else if (role.equals(MemberRole.ROLE_MANAGER)) {
return new ManagerPolicy();
}
else {
return new MemberPolicy();
}
}
}
@Service
public class DiscountService {
public void discount(MemberRole role) {
Policy policy = getPolicy(role);
policy.discountPolicy();
}
private Policy getPolicy(MemberRole role) {
if (role.equals(MemberRole.ROLE_ADMIN)) {
return new AdminPolicy();
}
else if (role.equals(MemberRole.ROLE_MANAGER)) {
return new ManagerPolicy();
}
else {
return new MemberPolicy();
}
}
}
자 그런데 getPolicy도 결국 각 역할에 맞게 Policy를 선택하는거 아니겠습니까? 그럼 이것도 스프링 빈으로 관리해보도록 하겠습니다.
@Component
public class PolicyManager {
public Policy policy(MemberRole role) {
if (role.equals(MemberRole.ROLE_ADMIN)) {
return new AdminPolicy();
}
else if (role.equals(MemberRole.ROLE_MANAGER)) {
return new ManagerPolicy();
}
else {
return new MemberPolicy();
}
}
}
그럼 코드가 이렇게 바뀝니다.
@Service
@RequiredArgsConstructor
public class DiscountService {
private final PolicyManager policyManager;
public void discount(MemberRole role) {
Policy policy = policyManager.policy(role);
policy.discountPolicy();
}
}
@Service
@RequiredArgsConstructor
public class PaymentService {
private final PolicyManager policyManager;
public void payment(MemberRole role) {
Policy policy = policyManager.policy(role);
policy.paymentPolicy();
}
}
의존성은 기존엔 이렇게
리팩토링 후 이렇게 바뀌었습니다.
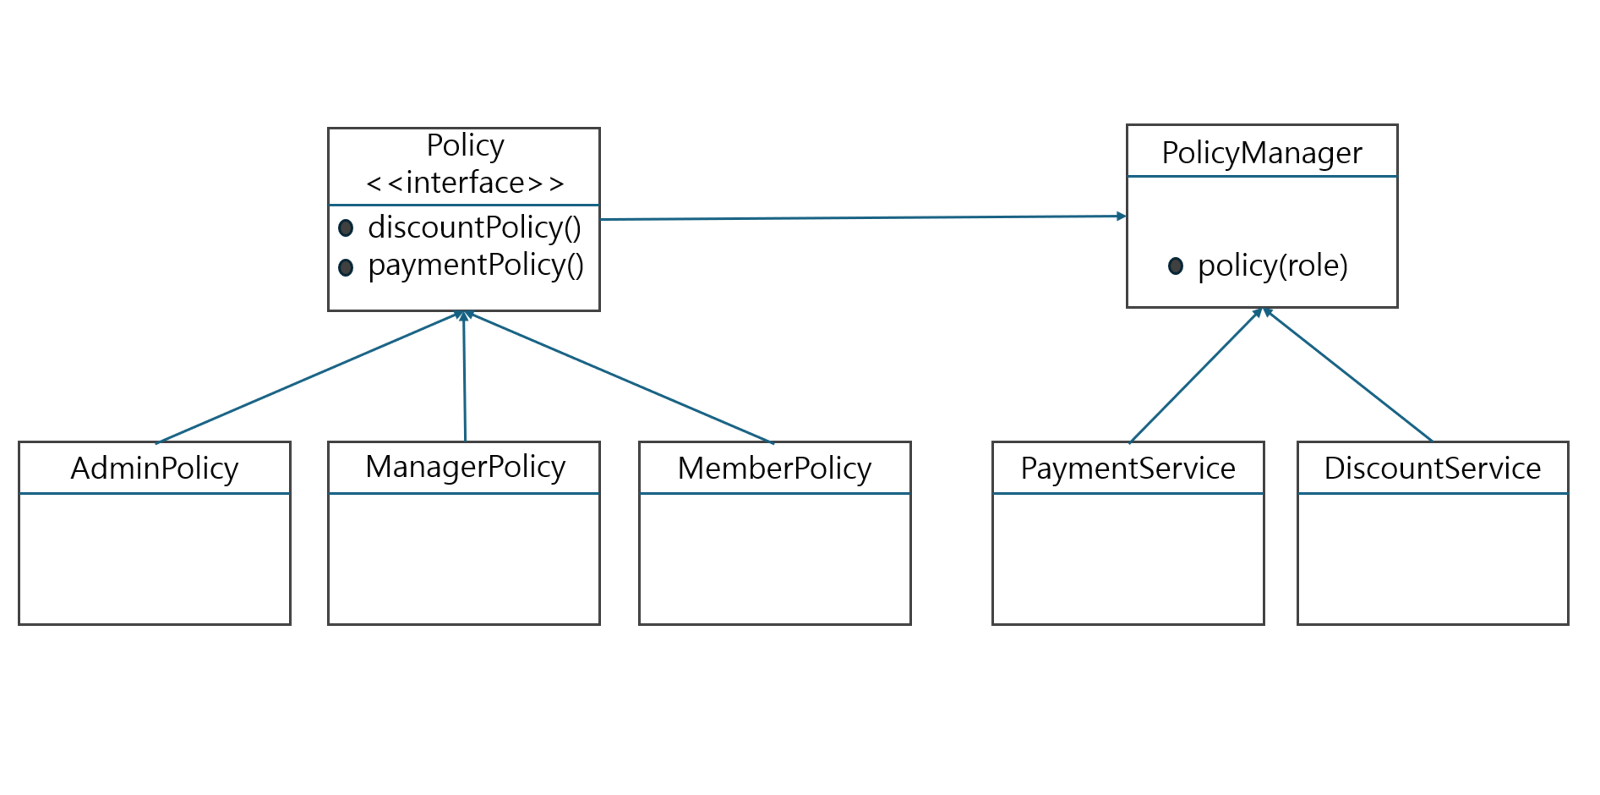
이렇게 리팩토링이 끝나게됩니다.
이렇게 추상화하는 방식에는 장단점이 있습니다.
• 장점
의존성을 분리할 수 있습니다. 이말은 Service 로직은 해당 비즈니스 로직만 호출하는 것이지 역할에 따라 비즈니스 로직을 다르게 적용하는 것은 Policy 라는 인터페이스에게 위임하는 것이죠. 이로인해 Service 계층은 PolicyManager가 뭐하는 친구인지 몰라도됩니다.
• 만약 새로운 정책, 예를 들어 환불정책이 추가된다면 Policy 인터페이스에서 refundPolicy() 라는 메서드만 추가해주고 각 구현체에서 구현해주기만하면 됩니다.
• 만약 새로운 역할이 추가된다면 Policy 를 의존하는 새로운 클래스를 추가하여 관리하면 됩니다. 만약 그렇게 된다면 Service 로직에는 그 어떤 변화도 주지 않고 확장할 수 있는 것이죠.
• 단점
일단 인터페이스로 구현되어있는걸 보게되면 속이 답답해집니다. 어디서 어떤 구현체를 쓰는지 찾아야되는 상황이 오죠... 이 코드를 제가 구현했으면 어디서 어떤 로직을 호출하는지 다 알고있으니 괜찮은데 만약 이 프로젝트에 새로운 사람이 투입된다면 이 코드를 이해하기위해 리팩토링 이전보다 더 많은 시간을 사용해야 할 것입니다.
• 예를들어 새로운 정책인 환불정책이 추가된다면 인터페이스에 refundPolicy() 라는 메서드가 추가될 것이고 그럼 인터페이스의 구현체인 각 역할에서 환불에 대한 추가적인 코드 작업이 있어 개발하는 속도가 굉장히 느려집니다.
이 상황은 어느 것이 더 좋다라고 딱 잘라 말하기 힘들겁니다. 일단 코드가 깔끔해보이고 유지보수하기 좋은 쪽은 후자일 것 같긴합니다. 또한, 객체지향의 원칙을 딱딱 지켜 만들었기 때문에 조금 더 이상적인 코드라고 할 수 있겠네요.
하지만 빠르게 마감시간에 맞춰야하거나 역할이나 정책같이 추가될 수 있는 것이 아니라 죽었다 깨어나도 추가될 일 없는 것들은 굳이 추상화할 필요가 없죠.
때문에 이런 경우 개발 초기엔 빠르게 개발하는 것이 중요하기 때문에 리팩토링 전처럼 개발하고 후에 확장성이 중요해질 때 리팩토링 하는 것이 좋을 것 같습니다.
추상화와 그 과정에서 무거워지는 책임 (SOLID 중 SRP)
오늘도 사이드 프로젝트를 리팩토링하면서 시간을 보내고 있었습니다. 얼마전 if-else 블록의 중복으로인해 추상화하는 방법을 깨달아서 이 방법으로 추상화를 진행했습니다.
그 결과 이렇게 코드를 줄일 수 있었죠.
이랬던 코드들이
이렇게 바뀌었습니다.
https://coding-review.tistory.com/487
리팩토링 방법은 위의 링크와 같은 방식으로 처리했습니다.
리팩토링으로 SRP와 OCP를 동시에 지킬 수 있게 되었습니다. 저는 객체지향 프로그래밍에서 가장 중요한 것은 SRP와 OCP 그리고 그 다음이 ISP 그 다음이 LSP와 DIP라고 생각합니다.
왜냐하면 DIP는 대부분의 프레임워크가 구현해주는 것이라 크게 의미 없다고 생각하고, LSP는 상속과 관련된 원칙이라 아직 상속을 강하게 사용한 적이 없는 저는 딱히 중요성을 느끼지 못했습니다.
ISP는 인터페이스를 사용하다보면 점점 인터페이스를 쪼개야하는 상황이 오게 되는데 이때 종종 상기하면서 적용하는 부분입니다.
때문에 단일 책임 원칙 (SRP), 개방 폐쇄 원칙 (OCP) 이 두개만 지켜주면 웬만한 코드는 다 유연해지고 확장성이 높아집니다.
위의 코드 예시에서도 리팩토링 전에는 lookUpPayment라는 결제 부분에서 역할 (MemberRole)에 따라 로직이 다르기 때문에 역할을 구분짓는 책임 (if - else 블록) 그리고 결제하는 책임 (원래 본인책임) 이렇게 두개가 혼재되어있는 상황이었습니다.
또한, 새로운 정책이 추가되는 경우 (물론 그럴일은 없지만), 예를 들어 Manager가 추가된다면 결제 로직에 또 다시 if 문을 넣어서 추가해줘야하기 때문에 OCP에도 위배됩니다.
그래서 리팩토링을 진행했고 역할에 따라 다른 정책을 부여하는 PolicyManager라는 클래스로 책임을 분리했습니다. 그리고 결제 로직에선 결제만 진행하도록 SRP와 OCP를 모두 지켰습니다.
그러는 과정에서 고민이 생겼습니다.
@Component
@RequiredArgsConstructor
public class PolicyManager {
// dependency for all
private final CacheRepository cacheRepository;
// dependency for coupon
private final MemberWhoGetCouponRepository memberWhoGetCouponRepository;
private final CouponRepository couponRepository;
private final TemporaryOrderService temporaryOrderService;
// dependency for payment
private final OrderItemRepository orderItemRepository;
private final BucketRepository bucketRepository;
private final TemporaryOrderRepository temporaryOrderRepository;
private final ItemDetailRepository itemDetailRepository;
private final CheckStockUtils checkStockUtils;
public CouponPolicy couponPolicy(MemberRole role) {
if (role.equals(MemberRole.ROLE_SOCIAL)) {
return new UserCouponPolicy(cacheRepository, memberWhoGetCouponRepository);
}
else {
return new MemberCouponPolicy(cacheRepository, memberWhoGetCouponRepository, couponRepository, temporaryOrderService);
}
}
public PaymentPolicy paymentPolicy(MemberRole role) {
if (role.equals(MemberRole.ROLE_SOCIAL)) {
return new UserPaymentPolicy(cacheRepository, orderItemRepository, bucketRepository, temporaryOrderRepository, itemDetailRepository, memberWhoGetCouponRepository, checkStockUtils);
}
else {
return new MemberPaymentPolicy(cacheRepository, orderItemRepository, bucketRepository, temporaryOrderRepository, itemDetailRepository, memberWhoGetCouponRepository, checkStockUtils);
}
}
}
PolicyManager의 코드입니다.
PolicyManager의 책임이 굉장히 무거워진 것을 느꼈습니다. 만약 할인이라던가, 환불이라던가 이런 정책들이 추가되면 PolicyManager의 책임이 지금보다 더 무거워질 것입니다.
GPT는 전략패턴을 이용해서 PolicyManager를 한번 더 추상화하라고 추천해줬습니다.
하지만 아직 그렇게 리팩토링을 하진 않았습니다. 이 고민은 조금 더 생각해보고 결정하려고 합니다. 그렇게 생각한 이유는 다음과 같습니다.
• 요즘 GPT가 멍청하다.
이 부분은 동의하실지 모르겠지만 앞전에 했던 얘기를 까먹는다거나, 내 질문을 잘못 이해하고 그게 아니라고 설명해줘도 또 같은 말을 반복하는 상황이 요즘들어 잦아졌습니다.
GPT5를 더 똑똑하다고 생각하게 만들기위해 GPT4의 성능을 낮추는 것이 아닌가싶을 정도로 GPT4를 처음 사용했던 1년전과 다른 느낌을 받았습니다.
• 추상화를 한번 더?
만약 제 코드를 처음 보는 사람이 결제 로직을 확인하고 싶어서 리팩토링된 깔끔한 코드에서 구현체로 들어가고싶은 상황이라고 가정해보도록 하겠습니다.
그럼 총 세번의 이동이 필요합니다. PaymentService => 추상화된 PolicyManager (한번) => PolicyManager (두번) => 구현체인 lookUpPayment (세번) 로 들어갑니다.
저는 세번 이상 들어가는 것을 지양하는 코드 컨벤션을 가지고 있습니다. 다시 돌아올 때 굉장히 힘들더라구요..
• 책임이 무거워지는 것이지 SRP를 위배하진 않는다.
책임이 무거운 것은 맞습니다. 하지만 여전히 PolicyManager는 정책을 정하는 책임 단 한가지만 가지고 있습니다.
이걸 추상화한다고 한들 코드를 읽기 쉬워질까? 객체를 지향하고 있나? 이에 대한 답을 뚜렷하게 낼 수 없었습니다.
• 무거워진다고 뭐가 문제라도?
문제는 없습니다. 오히려 DIP를 계속 지키고 있는 것이죠.
마치며
이 부분은 조금 더 공부를 하고 어떻게 해결해야할지 고민해보겠습니다. 애초에 해결해야하는 문제인가에 대해서도 진지하게 고민해보겠습니다.
for 문과 여러개의 if 문이 중첩된 코드 StreamAPI로 정리하기
코드를 리팩토링 하는 과정에서 Collection에 담긴 내용을 if문 두개로 중첩해서 걸러내는 로직이 있었습니다.
로직을 간단하게 설명하자면 사용자가 장바구니에 담은 상품의 사이즈와 데이터베이스에 존재하는 상품의 사이즈 중 같은 것을 찾고 (ex. 장바구니에 105사이즈를 담았다면 데이터베이스에 105사이즈를 검사함)
찾은 것 중에 재고를 비교해서 장바구니에 선택한 수량이 데이터베이스에 남아있는 수량보다 많은 경우 (ex. 장바구니에 2개를 넣고 결제하려는데 데이터베이스엔 1개밖에 없는 경우) 를 비교해서
만약 그런 상황이라면 재고가 남아있지 않는다는 메시지를 띄워주기위해 설계한 로직입니다.
들여쓰기가 세번 이상 되었기 때문에 리팩토링 해야겠다고 생각했고 StreamAPI를 이용해서 깔끔하게 리팩토링 하였습니다.
stream()을 이용해 for문을 없애고 두번의 filter를 이용해 두번의 중첩 if문을 짧게 줄였습니다.
그리고 해당되는 것이 하나라도 있으면 (findAny) 가져오고 없으면 null을 반환하여 처리하였습니다.
Redis for Client Side Caching으로 응답시간 개선하기
사이드 프로젝트인 온라인 쇼핑몰에 Redis를 이용해 Client Side Caching을 적용했습니다.
Redis 6에 추가된 RESP3 프로토콜을 사용했고 Redis Client인 Spring Boot에서 CacheFront<K, V> 를 이용해 클라이언트 사이드 캐싱을 구현할 수 있었습니다.
wrk2를 이용해 API 테스트를 진행했습니다.
• 스레드 개수 : 8개
• 동시 연결 : 50개
• 지속 시간 : 60초
• 초당 요청 수 : 1000개
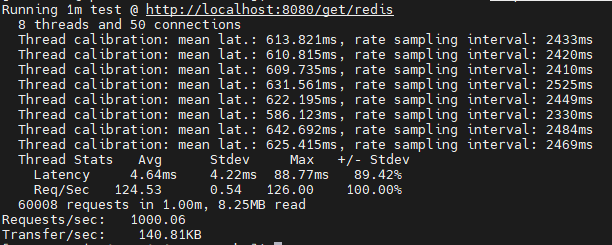
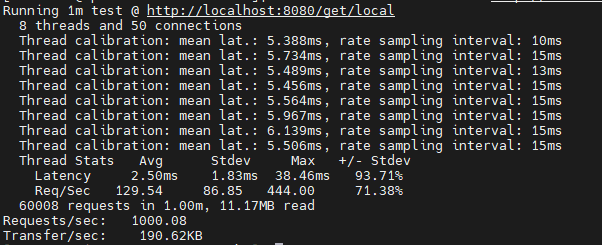
성능 개선
동일한 기준에서 테스트를 진행했을 때 Redis를 순수하게 이용했을 때와 local caching을 이용했고, 이로인해 Latency는 평균 80% 최대 130% 개선하였고, throughput은 평균 4% 최대 250% 개선하였습니다.
이로 인해 얻은 것
기존 프로젝트에서 RDBMS에서 처리하던 요청을 Redis로 사용하는 것도 성능적인 측면에서 큰 개선을 이뤄냈지만 Redis를 사용하는 것보다 local cache를 사용함으로써 평균적인 성능을 개선할 수 있다는 것에서 크게 놀라게 되었습니다.
서버의 개수를 늘리거나 컴퓨팅 성능을 좋게 만드는 것 이외에 코드를 개선함으로써 서버의 응답시간과 처리량을 늘렸다는 것에서 좋은 공부가 되었습니다.
블로그 포스팅
https://coding-review.tistory.com/524
https://coding-review.tistory.com/525
JPA Pessimistic Lock을 Redis 분산락으로 교체하기
기존 프로젝트에서 동시성 문제가 발생하였고 이를 JPA의 비관적 락으로 해결하였습니다. 하지만 비관적락이 RDBMS로 하여금 락킹 매커니즘을 관리하기위해 커넥션을 생성하고 이때문에 RDBMS에 부하가 발생한다는 문제가 발생했습니다.
해결방법으로 Redis의 라이브러리인 Redisson을 이용해 분산 락을 구현했습니다. 기존에 사용하던 Lettuce는 스핀락의 개념으로 Redis에 lock을 지속적으로 확인해야 하기 때문에 RDBMS의 부하가 그대로 Redis로 몰린다는 단점이 있었습니다. 때문에 Redisson을 사용하게 되었습니다.
wrk2로 부하 테스트를 진행하였고 docker로 컨테이너를 모니터링 하여 테스트를 진행했습니다.
특징
• RDBMS는 MySQL을 사용하였습니다.
• 스레드는 8개, 동시 커넥션 수는 50개, 시간은 60초, 초당 요청 수는 1000개로 고정하고 같은 환경에서 테스트를 진행했습니다.
• CPU점유율은 Docker 모니터링을 활용했습니다.
• MySQL의 pessimistic lock과 Redis의 distributed lock에 대한 확연한 차이를 위해 동일한 쿼리를 사용했고 컬럼에 인덱스를 설정하였습니다.
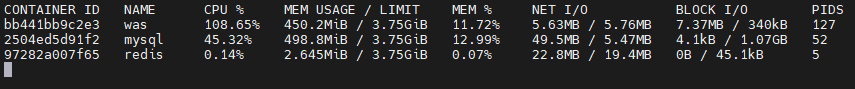

전체적인 부하는 비슷하고 기존 Pessimistic Lock을 사용했을 때 MySQL에 부하가 많이 몰리는 반면 Redis의 Distributed Lock을 사용했을 때는 MySQL의 부하가 줄고 Redis가 부하를 나눠 담당하는 것을 볼 수 있습니다.
이로인해 얻은 것
기존 방식은 MySQL의 부하가 몰려 서버의 장애 상황을 야기한다면 개선한 방식은 Redis가 부하를 분산시켜 락킹 매커니즘으로인한 MySQL의 커넥션 풀의 불안정성을 개선하였습니다.
이로인해 다양한 동시성 문제에 대해 MySQL의 안정성을 끌어올릴 수 있었습니다.
블로그 글
https://coding-review.tistory.com/527
Redis를 이용해 대기열 만들기
백엔드에서 가장 난이도 있기로 소문난 특정 지점에 트래픽이 몰리는 상황을 대비하여 Redis를 이용해 대기열을 만들었습니다.
https://coding-review.tistory.com/530
제 프로젝트는 온라인 쇼핑몰인만큼 블랙프라이데이나 콜라보 이벤트를 하는 경우 트래픽이 몰리는 것을 대비하여 대기열을 만들었습니다.
이번 대기열을 이용해 애플리케이션 서버 부하와 RDBMS의 부하를 획기적으로 줄일 수 있을 것으로 예상됩니다.
또한, 클라이언트단에서 대기열을 웹소켓으로 수시로 확인하게 하여 사용자에게 답답함을 어느정도 해소시킬 수 있을 것으로 예상됩니다.
이번 개선으로 얻은 것
특정 지점에 트래픽이 몰리는 상황을 대비해 서버의 안정성을 높이게 되었습니다. 또한, 애플리케이션 서버와 데이터베이스 서버의 부하를 줄일 수 있어 서버가 수용가능한 트래픽만을 처리할 수 있게 되었습니다.
개발적으로 얻은 것은 Redis의 다양한 사용법과 WebSocket의 사용입니다. 이번 프로젝트를 통해 Redis를 이용해 다양한 기능들을 구현할 수 있었고 WebSocket으로 사용자 경험을 높이는 경험을 하게 되었습니다.
Redis Sentinel로 고가용성 유지하기 (with Slack)
기존 ver.2에서 Redis를 도입해 RDBMS의 부하를 30퍼센트 줄여 문제점을 개선하였습니다. 하지만 읽기 요청이 많아지면 Redis에 큰 무리가 가게 되고 Redis가 standalone 상태에서 다운되면 뒤에 있는 RDBMS도 다운될 가능성이 있습니다.
때문에 Redis의 고가용성을 유지하는 것이 새로운 과제가 되었고 이번 ver.6에서 Redis Sentinel을 이용해 문제를 해결하게 되었습니다.
왜 Sentinel이었나?
Redis에 고가용성을 위한 옵션으로 Sentinel과 Cluster가 존재합니다. 둘 중 Sharding이 지원되는 Cluster가 상위호환이지만 Sentinel을 선택하게 되었습니다.
Sentinel을 선택한 이유는 우선 첫번째로 프로젝트에 Sharding이 필요할지 감이 안잡혔기 때문입니다. MongoDB 공식 문서에서 NoSQL의 특징 중 수평확장의 대표주자인 Sharding에 대해서 설명할 때 다음과 같이 언급한 바 있습니다.
"Sharding은 최후의 최후까지 선택하지 않았으면 좋겠다"
그 이유로 MongoDB에선 Sharding으로 분산된 데이터를 관리하는 비용이 기존 방식에 비해 어마어마하게 높아지기 때문이라고 하였습니다.
제 프로젝트의 컨셉이 이용자가 100만명, 1000만명이 되면 어떤 문제가 발생할까에 대한 사고실험에 가까운 프로젝트이지만 실제로 제가 100만명, 1000만명의 트래픽을 받아본 적이 없기 때문에 Sharding이 필요할 정도가 어느정도인지 감을 잡지 못해서 Sentinel을 선택했습니다.
Sentinel로 얻은 것
Sentinel에서 기본적으로 마스터-슬레이브 구조에서 replica를 둘 수 있다는 점에서 읽기 연산에 대한 부하를 분산할 수 있다는 점에서 기존 프로젝트에 비해 높은 안정성을 보여줄 것으로 기대하고 있습니다.
또한, 마스터노드가 다운되었을 때 데이터가 유실될 수 있는 상황에서 Sentinel의 모니터링 시스템과 슬레이브에서 마스터로 승격하는 시스템덕분에 데이터 유실을 최대한 방지할 수 있게 되었습니다.
이뿐아니라 Sentinel에서 기본적으로 제공하는 Notification을 이용해 슬랙과 연동하여 마스터노드의 장애 상황을 실시간으로 알람을 받을 수 있는 환경을 구축했습니다.
아쉬운 점
조금 아쉬운 점은 마스터노드의 장애 이후 슬레이브가 마스터로 승격되는 시간이 금방 되는 경우도 있었지만 오래 걸릴땐 5분이상 걸리는 것이 조금 아쉬운 점으로 남았습니다.
이를 해결하기 위해 슬레이브 노드를 지정해 대기시켜 Sentinel이 sdown에 대한 알람이 오면 바로 설정을 변경하여 마스터 노드로 승격시키는 방법을 고려해봤습니다만 슬레이브 노드의 장애 상황에는 상황이 더 복잡해질 것을 우려해 해당 방식을 폐기되었습니다.
캡스톤 디자인 : 중고거래 사이트 (개요)
교수님께서 1학기만 캡스톤디자인 하는 것 처럼 말씀하셔서 2학기는 없을 줄 알았는데 2학기도 있었네요... 좀 난감하긴 하지만 한번 해보겠습니다.
1. 왜 중고거래 사이트인지?
생각보다 아주 간단한 이유입니다. 바로 채팅 기능에 대해서 공부해보고 싶었기 때문이죠. 채팅 기능을 구현하려면 웹 소캣을 써야한다는 사실은 알고 있었습니다. 하지만, 웹 소캣을 한번도 안써봤고 한번쯤 써보고싶어서 선택했습니다. 또한, docker에 대해서도 공부해보고 싶어서 겸사겸사 선택했습니다.(docker와 중고거래 사이트를 선택한 이유는 전혀 관계없습니다.)
그럼 카톡은 왜 아니냐. 라고 하신다면 카톡처럼 채팅기능만 들어가있는 (물론 채팅말고도 엄청나게 많은걸 지원한다는걸 알고있습니다. 하지만, 주 기능이 채팅이라 저렇게 말한것이니 오해없으시길 바라겠습니다.) 프로젝트는 하고싶지 않았습니다. 채팅이 부기능이고 다른 추가적인 것도 있으면 좋겠다는 생각에 중고거래 사이트를 선택했습니다.
중고거래 사이트 중고나라나 당근마켓도 많은데 굳이 고른 이유가 있나? 라고 하신다면 그런 이유는 없습니다. 그냥 채팅에 대해서 한번쯤 만들어보고 싶었고 채팅에 걸맞는 프로젝트가 중고거래 사이트이기 때문이라고 말할 수 있을 것 같습니다.
2. 구현에 필요한 기술
IDEA : IntelliJ, VS code
프론트엔드 : html, css, js, Vue.js(필요하다면 공부할 예정입니다.)
언어 : Java (jdk 11)
백엔드 : Springboot, Gradle
DB : MySQL
ORM : Spring Data JPA
배포 : aws ec2, docker, kubernetes(마지막 단계에 도입 예정입니다.)
OS : windows 10, Ubuntu Linux 22.04
사진 업로드 : aws S3
3. 대략적인 기능
• 1대1 채팅
• 채팅 오면 알람
• 이미지 업로드
• 로그인
• 회원가입
캡스톤 디자인 : 중고거래 사이트 (1) 채팅 구현
우선 가장 중요한 채팅 기능을 만들어봤습니다.
웹 소캣 중에서도 SocketJS와 STOMP 프로토콜을 이용해 만들었습니다. 코드는 구글에서 검색해서 복붙했지만 디비에 입력하기 위해서 코드를 많이 수정하긴 했습니다. 따라 만드시려면 SocketJS와 STOMP프로토콜의 대략적인 이해는 필요하다고 생각합니다.(완전히 다 이해하진 않더라도 어떻게 굴러가는지는 이해해야 한다는 소리입니다.)
그리고 중요했던게 채팅 치는 순간 나와 상대방을 구별하는 방법이 필요했습니다. 카톡만 하더라도 나는 노란색 상대방은 흰색 이렇게 정해져있기 때문에 그냥 일자로 쭉 뽑을게 아니었기 때문에 구별해야했습니다.
문제는 웹 소켓에 연결해서 하는 채팅은 자바스크립트로 구별이 가능했지만 이미 디비에 저장되어있는 채팅은 어떻게 구별할지 난감했습니다.
처음엔 identifier이라는 칼럼을 넣어서 채팅방을 개설한 사람이면 1 아니면 0 이런식으로 했더니 나한테는 색이 잘 입혀지는데 상대방 입장에서는 색이 안바뀌고 고정되는 현상이 발생했습니다.
10시간을 고민한 끝에 다음과 같이 해결했습니다.
<div id="msgArea" class="col">
<div class="col-6" th:each="messages : ${messages}">
<div th:classappend="${messages.writer} == ${session.loginId} ? 'alert alert-secondary' : 'alert alert-warning'">
<b th:text="|${messages.writeTime} ${messages.room.member.loginId} : ${messages.message}|"></b>
</div>
</div>
</div>
해결하고 보니 너무 간단하게 풀려서 좀 어이없었지만 채팅 기능을 처음 구현하는것이기 때문에 한 삽질이라고 생각하면서 넘어갔습니다.
https://velog.io/@burub3/webSocket-STOMP-%EC%82%AC%EC%9A%A9%ED%95%B4%EC%84%9C-%EC%B1%84%ED%8C%85%ED%94%84%EB%A1%9C%EA%B7%B8%EB%9E%A8-%EB%A7%8C%EB%93%A4%EA%B8%B0
https://dev-gorany.tistory.com/235
위의 분의 코드를 보고 만들었습니다. 하지만 ChatRoomRepository가 디비에 연결하는게 아니고 Map에 연결했기 때문에 수정이 필요합니다. 또한 Repsitory가 Service의 역할도 대신하고 있기 때문에 이 부분 또한 분리해야 합니다.
그래서 결과물을 보시죠
캡스톤 디자인 : 중고거래 사이트 (2) 채팅 시 jwt 인증토큰으로 인증
메세지를 보내기 전에 jwt 인증토큰을 검증해서 검증된 사용자만 채팅을 칠 수 있게 만들었습니다.
jwt 인증토큰을 만들고 검증하는 코드는 다 만들었는데 jwt 인증토큰을 헤더에 어떻게 담는지 몰라서 한참을 헤맸습니다. 헤더에서 jwt 인증토큰을 꺼내와야 한다는데 헤더에 어떻게 하는건지 원...
그래서 그냥 컨트롤러에서 response 객체를 받아와서 setHeader로 집어넣었습니다. (이렇게 하는거 맞나?)
https://kukekyakya.tistory.com/12
위의 포스팅을 참고하였습니다.
캡스톤 디자인 : 중고거래 사이트 (3) 채팅 실시간 알람
실시간 알람은 원래 하려고 한게 아닌데 주변인들한테 지금 내가 채팅프로그램을 만들고있는데 실시간 알람이 있으면 좋겠냐 없으면 좋겠냐 물어봤을 때 전부 다 있어야 할거같다고 해서 만들었습니다.
처음에 계획은 axios를 이용해 /chat/get_room_id 라는 url로 접근해 현재 내가 갖고있는 채팅방의 roomId를 자바스크립트 배열에 저장하고 배열에 있는 값을 꺼내서 for문을 돌려 모두 subscribe 연결을 하려고 했습니다.
근데 자바스크립트의 비동기 문제 때문에 값을 저장하기 전에 subscribe로 연결되어버려서 자바스크립트 배열에 값이 텅텅 비어있는 상황이 연출되었습니다. 그래서 async await 를 이용해 순서를 바로잡는데에는 성공했지만... 웹 소켓 connect가 안되는 현상이 발생했습니다.
Opening Web Socket... 에서 멈춰있는 로그를 보면서 구글링을 엄청나게 했던 것 같습니다. 영어로도 검색해보고 한글로도 검색해보고 별에별짓을 다해봤는데 저와 같은 상황인 사람이 한명도 없어서 이틀동안 삽질한게 너무 현타와서 접으려던 찰나에 어? 그냥 디비에서 꺼내와서 모델로 프론트에 넘겨주면 되나? axios를 쓰지 않고도 할 수 있을거같은 느낌이 들었습니다.
그래서 디비에서 꺼내와서 모델에 담아서 자바스크립트 배열에 바로 넣고 콘솔에 찍어보니 데이터가 잘 들어가있는 모습을 확인할 수 있었습니다.
그렇게 만든 채팅 실시간 알람을 영상으로 확인해보시죠
참고한 레퍼런스는 없습니다. stomp 프로토콜을 이용한 채팅을 응용한 버전입니다.
캡스톤 중고마켓 중도하차
잘 되다가 STOMP 프로토콜 통신이 안되는 이슈가 발생했습니다...
구글링도 하루종일 해보고 스택오버플로우에도 질문을 올려봤지만 해결하지 못했습니다.
그래도 영상으로 남겨놨으니 한번 구현해본것으로 만족하도록 하겠습니다. 언젠가 한번 소켓통신으로 채팅을 구현하는게 자그만 목표였는데 이뤄내서 만족스럽습니다.
사실 정말 아쉬운데... 구현해본것으로 마무리짓도록 하겠습니다.
다음 캡스톤은 정해놨습니다. 다음 캡스톤은 로그인 패턴 + 스프링 배치 공부로 개발자 커뮤니티 사이트를 하도록 하겠습니다.